MiniMax H3 晨报 2026-10-04|首推 5tar5ystem MMH3 Character Sheet Builder
本期审阅 13 个 H3 新版本。首推用 ref2va 从自有照片 / 视频 / 音频生成角色设定表的 Character Sheet Builder 节点包;另有按参考视频动作和镜头换角色的 BUNNY 动作迁移工作流、迪士尼黄金时代动画风格 LoRA、微缩超现实风格 Tiny Things,以及一句提示词出原创歌曲加两场景 MV 的 YuE2 × H3 工作流(依赖重)。一个只有角色自述的人物 LoRA 和一个缺 H3 细节的通用工作流合集已降为仅收录。
# 贞贞的AI雷达 · MiniMax H3 · 2026-10-04 晨报
本期 **14** 个新版本:强烈推荐 1 · 推荐 3 · 可关注 6 · 仅收录 4
> **编辑按语** 本期审阅 13 个 H3 新版本。首推用 ref2va 从自有照片 / 视频 / 音频生成角色设定表的 Character Sheet Builder 节点包;另有按参考视频动作和镜头换角色的 BUNNY 动作迁移工作流、迪士尼黄金时代动画风格 LoRA、微缩超现实风格 Tiny Things,以及一句提示词出原创歌曲加两场景 MV 的 YuE2 × H3 工作流(依赖重)。一个只有角色自述的人物 LoRA 和一个缺 H3 细节的通用工作流合集已降为仅收录。
## 强烈推荐(1)
### 【S】[5tar5ystem MMH3 Character Sheet Builder · v1.1.0](https://civitai.com/models/2982722?modelVersionId=3381358)
*工作流 · 新模型 · 作者 Data5555 · 发布 10-04 07:58 · 下载 52*
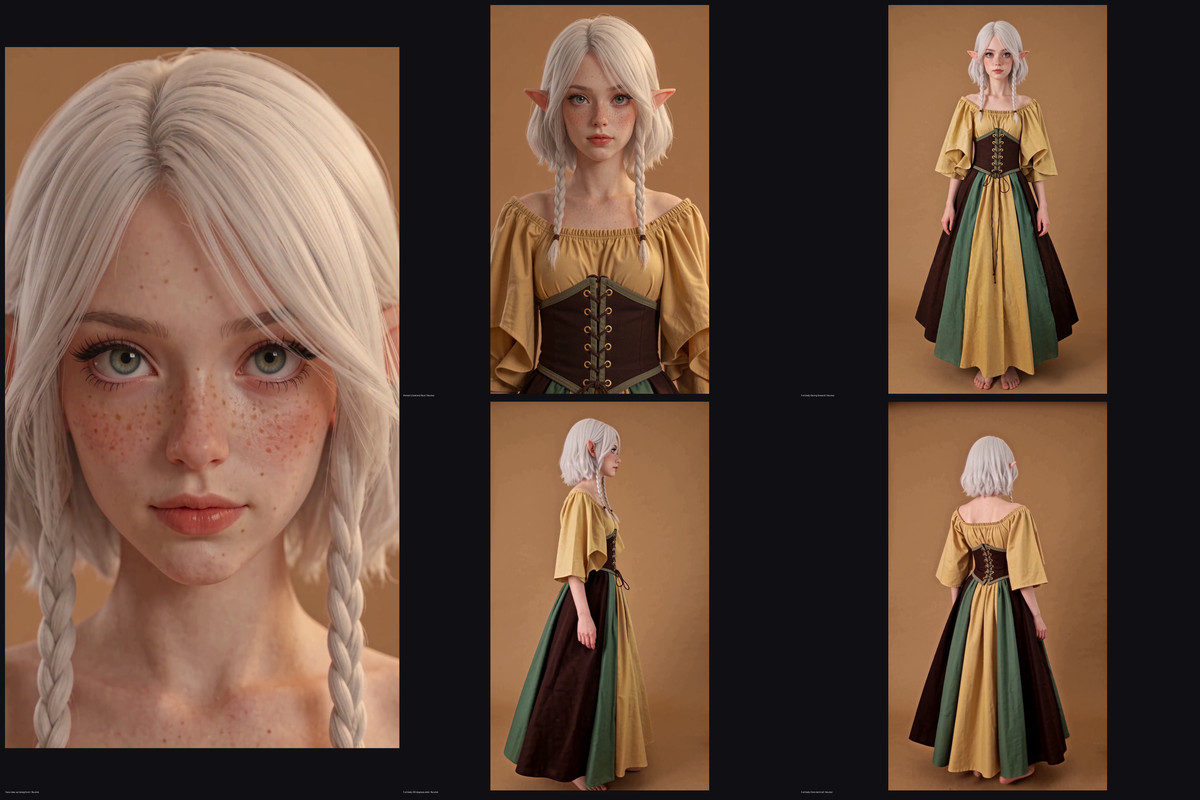
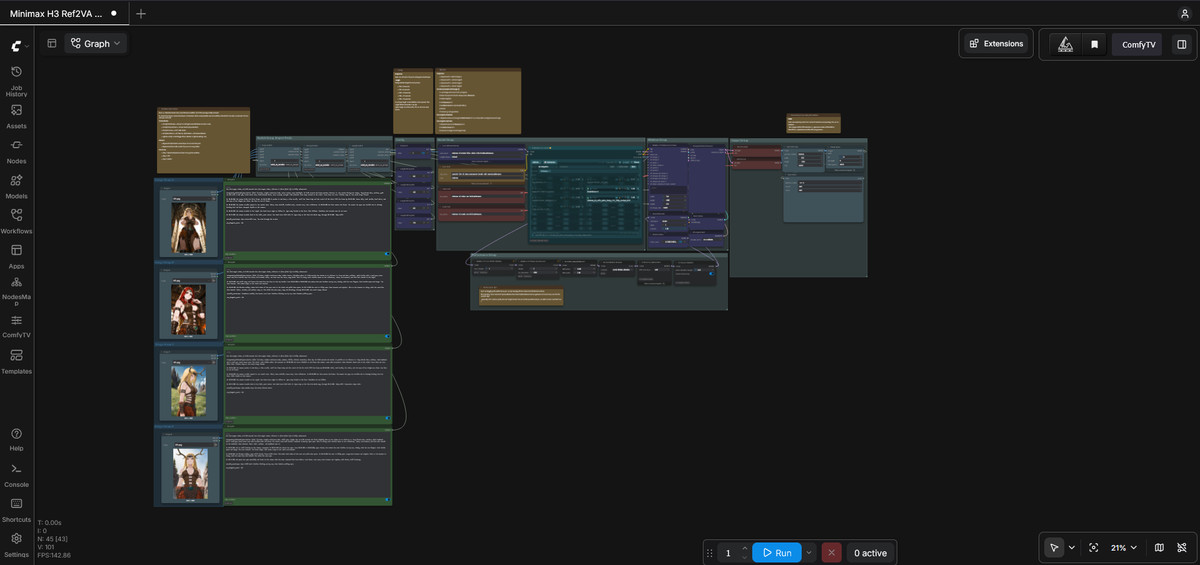
H3 角色设定表生成器(自定义节点 + 现成工作流):把你已有的照片、视频、音频作为 ref2va 参考,勾选要的视角、姿势、表情,生成一张拼好的角色设定表,可再作为单张参考图喂回 ref2va。
**配图**
**推荐理由**
- 服务角色一致性:先做设定表再生成视频。每个参考可写角色说明(如“脸和头发”“身体和衣服”“这个声音”),每个格子只用它需要的参考,一张图管身份、另一张管服装
- 可选 15 种视角、13 种姿势、20 种表情;格子之间用潜空间续接(Latent Continuation)保持同一人物;渲染前可在 Prompt 页看到每格的完整提示词,不占 GPU
- 单格不满意可换种子只重渲这一格;挑帧和重新拼图不耗 GPU;可对不该提供脸的参考自动 / 手动模糊人脸
- v1.1.0 新增导出角色设定表和带音频的 RefMod;发布约 4 小时 52 次下载,3 张示例图
**怎么用**
- ComfyUI-Manager 搜索 MMH3 Character Sheet(发布者 5tar5ystem)安装,重启后强制刷新浏览器,拖入附带工作流;除此之外不需要其他节点包
- 模型:官方 minimax_h3_ref2va_pruned_int8_convrot(20–30 步)或社区 TURBO 模型(8 步,节点默认值),官方 Qwen3-VL 文本编码器(nvfp4 版),视频 VAE + 音频 VAE(音频 VAE 必需)
- 作者建议每格 22 帧最适合截静帧;用 TURBO 模型时不要再叠 turbo LoRA,ref2va 下跳过缓存 / Spectrum 节点
**风险与限制**
- 人脸模糊需要额外的 face_yolov8m.pt 和 ultralytics、opencv 包;实时预览条在 CPU 上解码,大格子时只显示少量帧
- 只有静态示例图,没有视频示例;节点包为 GPL-3.0
## 推荐(3)
### 【A】[Disney Golden Age Style · Golden Age Animation](https://civitai.com/models/1913233?modelVersionId=3380759)
*LoRA · 移植 · 作者 Corruptedcupid · 发布 10-04 01:57 · 下载 202*
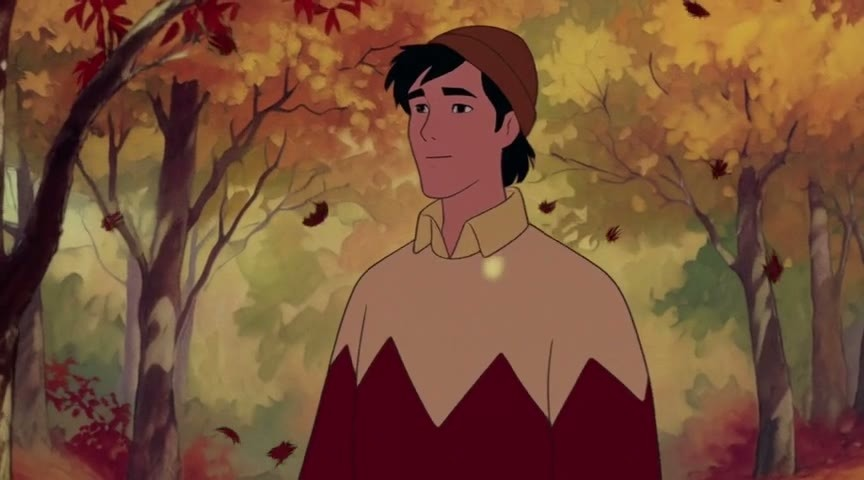
迪士尼黄金时代(1937–1942)手绘动画风格 LoRA 的 H3 版:作者用《白雪公主》《木偶奇遇记》《幻想曲》《小飞象》《小鹿斑比》的片段训练。
**配图**
**推荐理由**
- 服务复古手绘动画短片;作者写明 H3 V1 用 95 段片段训练,V2 会加素材
- 从作者的 Illustrious、ZImageTurbo、Flux.2 Klein 等版本移植,整个模型累计 8617 次下载;本版 6 段示例视频,发布约 10 小时 202 次下载、43 赞
**怎么用**
- 触发词「DGGA」;作者未给强度和步数
- 说明里的角色标签(SnowWhite、WizardMickey、DDumbo、FawnBambi 等)和 disneyanimal 动物标签是写给 Illustrious 版的,H3 版是否通用作者未说明
**风险与限制**
- 迪士尼版权画风和角色,商用有风险(许可允许出图、出租)
- H3 版说明只有一行,用法要靠示例摸索;另有 2 个示例被隐藏
**触发词**:`DGGA`
### 【A】[BUNNY H3 Ref2VA Motion Transfer · v1.0](https://civitai.com/models/2982001?modelVersionId=3380450)
*工作流 · 新模型 · 作者 FourBunny · 发布 10-03 23:32 · 下载 237*
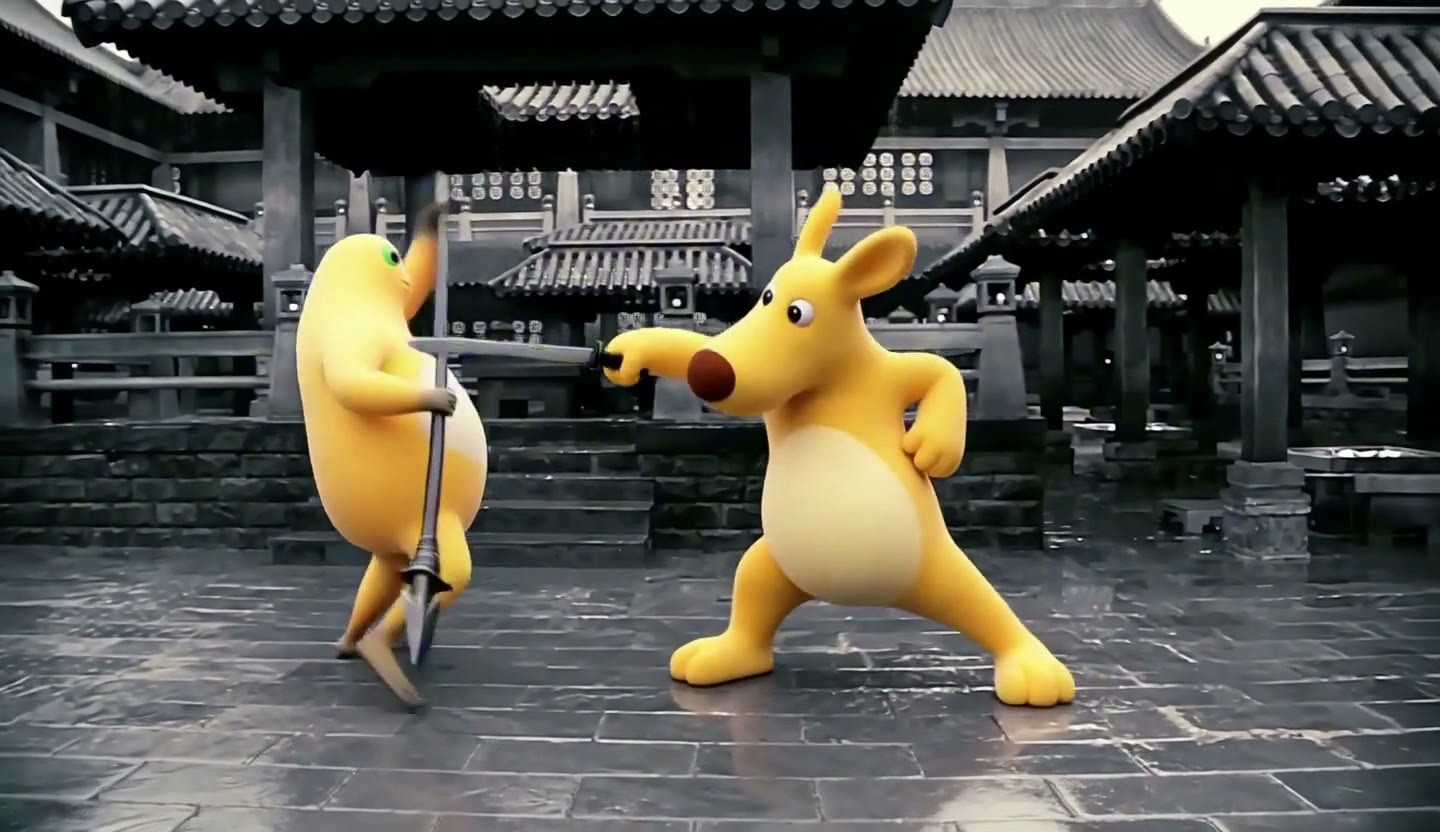
H3 ref2va 动作迁移工作流:给一段参考视频和目标角色图,按原视频的动作、运镜、剪辑和节奏把人物换成你的角色,两遍生成(第二遍潜空间放大)。
**配图**
**推荐理由**
- 服务换角色重演:打斗、翻滚等复杂动作片段的角色替换;自动转 24 FPS、自动识别横竖屏,参考视频可选 720p / 480p 短边
- 附一个写提示词用的 AI 助手 skill:读视频后按 H3 六段式(subject_definitions、summary、retention_analysis 等)写好提示词
- 说明写得很诚实:帧数按 17n + 5 向下取整,结尾最多丢 16 帧;原视频音轨不会作为 H3 音频参考;快速交叉和遮挡会让角色身份混乱
- 发布约 12 小时 237 次下载
**怎么用**
- 导入 JSON,源视频放进 BUNNY | Source video (24 fps),角色图按顺序放进各参考图组,提示词里的 <Picture N> 要和图片顺序对应
- 所用模型:hybrid fl2va/ref2va int8 底模、qwen3vl 文本编码器、LightX2V ref2v 8 步 Turbo LoRA、H3 潜空间放大模型、Motion_RepairV2 动作修复 LoRA;节点需 VideoHelperSuite、KJNodes、Easy-Use、MiniMax H3 Latent Upscaler、SageAttention
- 作者建议参考片段控制在 10 秒内,镜头切换密集的片段拆开分别生成
**风险与限制**
- 只有 1 段可见示例视频,另有 6 个被隐藏;作者称只检查了结构和连线,未在全新环境验证过出片
- 布局里有一个找不到公开安装地址的分组控制节点,缺失时需手动删除;说明里带 RunningHub 邀请链接
### 【A】[Tiny Things · v1.0 MiniMax H3](https://civitai.com/models/2313869?modelVersionId=3380774)
*LoRA · 移植 · 作者 Daalis · 发布 10-04 02:12 · 下载 132*
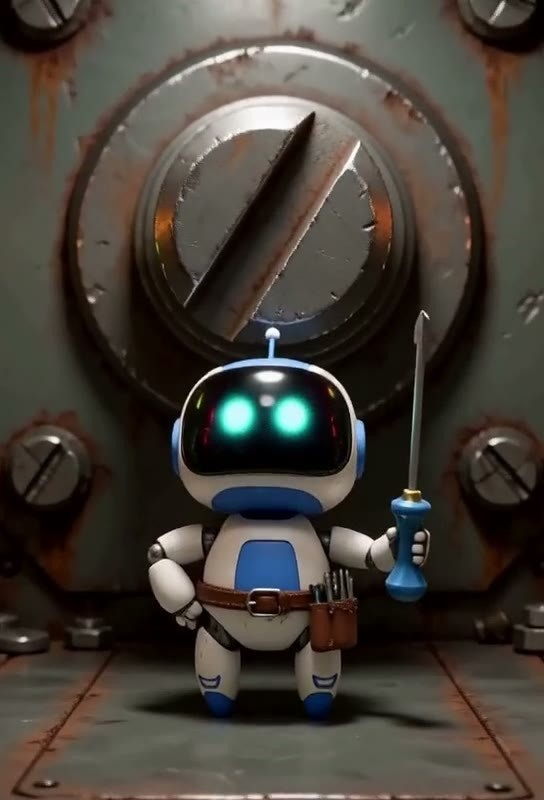
Tiny Things 微缩超现实风格 LoRA 的 H3 版:把主体变得极小、像瓷偶 / 缝制 / 金属丝做成的手工微缩物,放在空旷安静的大环境里,强调裂纹、纤维、锈和灰尘等材质。
**配图**
**推荐理由**
- 服务微缩摄影感、诗意忧郁风的概念短片;作者称 H3 版是同样的“微小感”,只是变成动画
- 用法写清楚:触发词、推荐强度 1.0、可用 0.5 – 1.5,并给了一长串辅助提示词(macro photography、extreme scale contrast、porcelain、stitched fabric、shallow depth of field 等)
- 作者在 Krea 2、Illustrious、ZImageTurbo 等多个基模都有版本,整个模型累计 4096 次下载
**怎么用**
- 触发词「TinyDaal」,强度 1.0,范围 0.5 – 1.5;作者称简单构图、主体清楚时风格最明显;作者未给步数
**风险与限制**
- 强度和提示词建议是通用说明,不是针对 H3 写的;H3 版只有 1 段可见示例,另有 3 个被隐藏
- 作者自己说风格常常偏玩偶化;商用只允许出图和站内出租
**触发词**:`TinyDaal`
## 可关注(6)
### 【B】[Minimax H3 - Refmod + Reference - 2 Pass Latent Upscale Workflow · v2.0](https://civitai.com/models/2980016?modelVersionId=3380757)
*工作流 · 版本更新 · 作者 rmanb2 · 发布 10-04 01:53 · 下载 90*
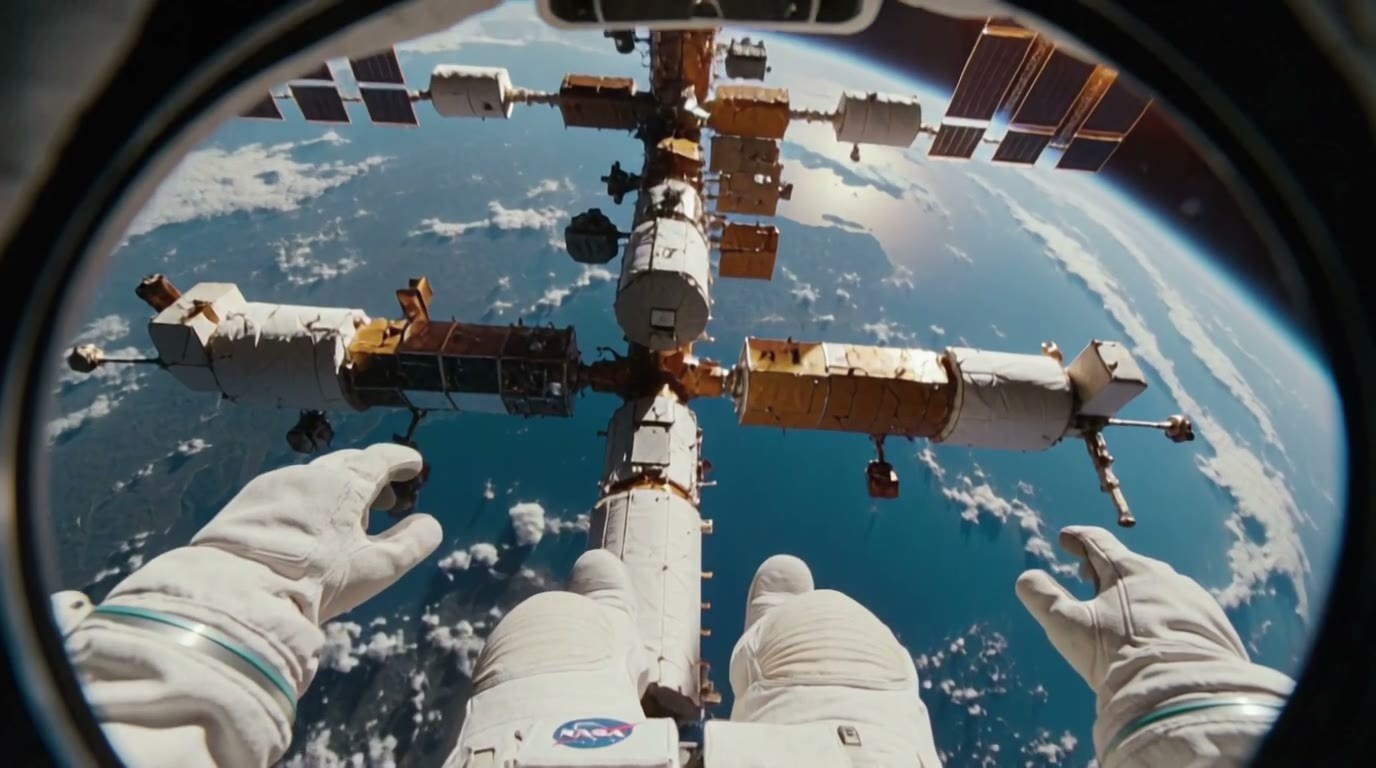
作者测试 LoRA 用的 H3 RefMod + 参考图工作流 v2.0:新版改用 Banodoco Discord 社区分享的流程并接进原工作流,主打速度。
**配图**
**推荐理由**
- 相比上一版:换成社区流程,作者称在 5090 上 1mp、7 秒视频约 60s;因为够快,v2.0 没有加潜空间放大(可自行加)
- 上一版是两遍潜空间放大版,作者称在 5090 上 0.9 mp、60fps 的 7 秒成片约 60-80s
**怎么用**
- 导入 JSON 工作流;作者用的 DLSS 节点是 Linux 环境,Windows 可换原生 dlss5 节点或直接跳过;作者未给模型清单和步数
**风险与限制**
- 模型名仍写“2 Pass Latent Upscale”,但 v2.0 实际没有潜空间放大
- 作者自己说画面元素多时细节会糊;只有 1 段可见示例,另有 2 个被隐藏
### 【B】[Minimax H3: t2va (T2V) – Polyhedron: Goth Girls · v1.0](https://civitai.com/models/2981783?modelVersionId=3380197)
*LoRA · 新模型 · 作者 Polyhedron\_AI · 发布 10-03 21:58 · 下载 170*
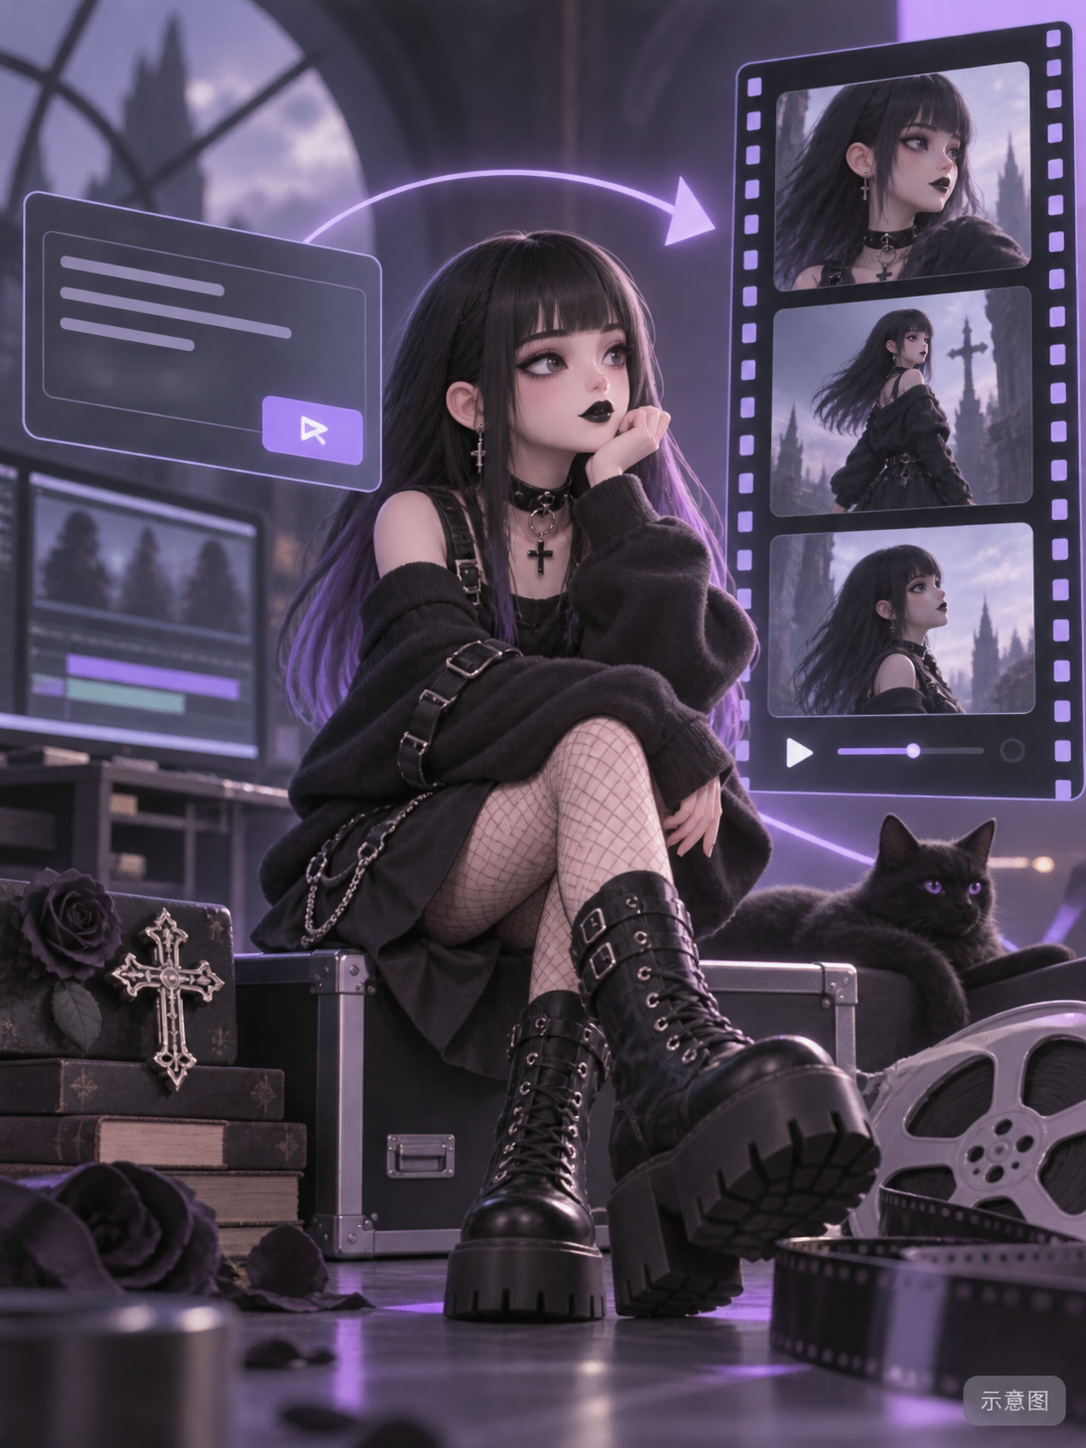
哥特女孩风格 / 人物 LoRA(文生视频):黑色项圈、齐刘海、黑唇膏、渔网袜、厚底靴、十字吊坠这一套哥特造型,作者称强度 1.0 就能完全覆盖底模风格。
**配图**
**推荐理由**
- 作者称这款 LoRA 较强,开着加速模型也能压住“塑料皮肤”问题
- 作者同时更新了自己的 Polyhedron Suite 节点包,支持 minimax_h3_hyperflow_8step 及 Ref2VA / FL2VA Acc-8Step 模型;作者在 RTX 5060 Ti 16 GB 上 90 帧(3.75 秒)约 4 分钟,不含 ESRGAN 放大
**怎么用**
- 触发词「go8th」,可配合登记的 black choker、blunt bangs、black lipstick、fishnet stockings、platform boots、cross pendant;强度 1.0,作者称无需其他 LoRA
- 作者主力底模为 Minimax-h3_Singularity_ref2va_Pruned_v1.3_int8;工作流和带提示词的示例在作者 Patreon
**风险与限制**
- 没有可展示的示例(4 个被隐藏),效果无法预览
- 许可不允许任何商用;完整工作流放在 Patreon
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
**触发词**:`go8th`、`black choker`、`blunt bangs`、`black lipstick`、`fishnet stockings`、`platform boots`、`cross pendant`
### 【B】[H3 LickLips V1 · h3LicklipsV1](https://civitai.com/models/2982306?modelVersionId=3380827)
*LoRA · 新模型 · 作者 CyberCream · 发布 10-04 11:12 · 下载 23*
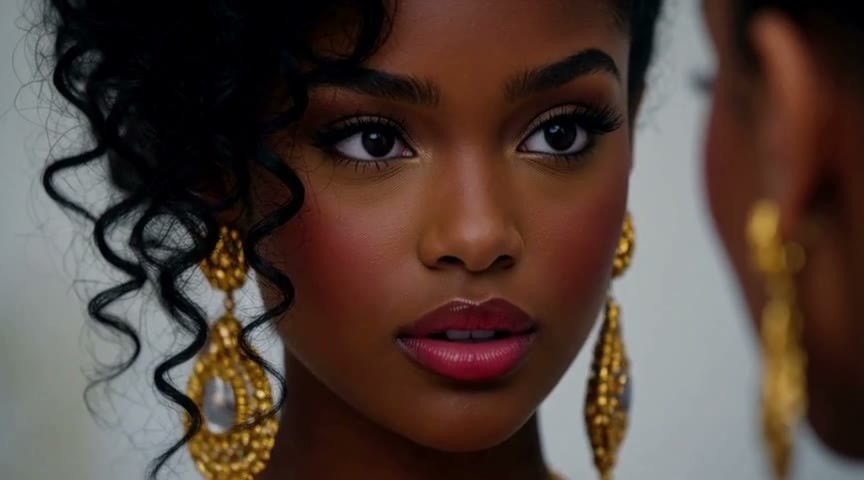
舔嘴唇 + 微笑的单一动作 LoRA:让女性角色做“舔自己嘴唇(再笑)”这个表情动作。
**配图**
**推荐理由**
- 动作很具体,作者给出了训练时用的两句提示词,可直接照抄;2 段示例视频,全部可见
**怎么用**
- 提示词用「A stunningly gorgeous girl licks her own lips and smiles.」或去掉 and smiles;强度 1(作者写 STR=1);无登记触发词,作者未给步数
**风险与限制**
- 用途很窄,说明只有两句;作者称用自己以前做的素材训练,未说明数据量
- 发布不到 1 小时,统计参考价值低
### 【B】[One prompt → one song → a two-scene music video (YuE2 × MiniMax H3) · v2.9](https://civitai.com/models/2975051?modelVersionId=3380252)
*工作流 · 新模型 · 作者 koyan0418439 · 发布 10-03 22:42 · 下载 62*
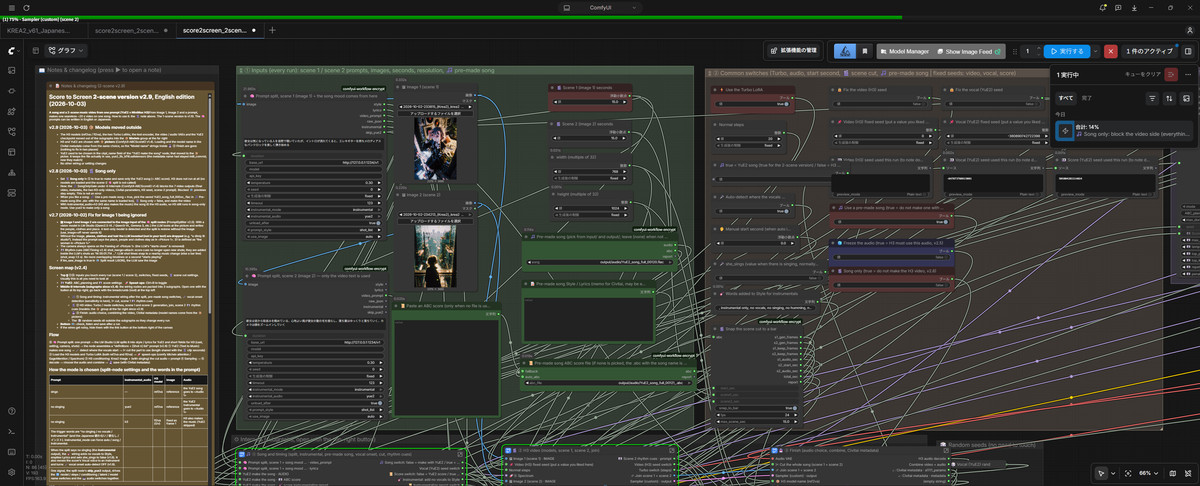
Score to Screen 工作流 v2.9:写一段提示词、选两张图,先用 YuE2 生成一首原创歌曲,再用 H3 ref2va 生成约 20 秒的两场景 MV,人物对口型,场景切换卡在小节线上。
> 做音乐类短片的思路值得参考,但先确认本机能同时装下 YuE2、H3 和一个 LLM。
**配图**
**推荐理由**
- 方向独特:本地 LLM(LM Studio)把提示词拆成 YuE2 风格标签 + 歌词和 H3 视频提示词;YuE2 同时写 ABC 乐谱,工作流读取速度、拍号、和弦转成 H3 提示词里的定时动作提示
- 细节多:用 demucs 检测人声起点自动跳过前奏;写 Instrumental. 可做纯音乐并让人物闭嘴;可复用以前的歌只重做视频;MP4 带 Civitai 元数据
- v2.9 相比 v2.6:场景图会发给视觉 LLM 描述人物和场景(v2.7);新增只生成歌曲的开关(v2.8);模型集中到右侧 📦 Models 组(v2.9);附英文版工作流
**怎么用**
- 把附带的 4 个自定义节点文件夹放进 custom_nodes(需 pip install demucs),启动 LM Studio 服务并开 JIT 加载;模型需 H3 ref2va + fl2va、两个 Turbo LoRA、qwen3vl 文本编码器、视频 / 音频 VAE 和 yue2_3b_int8_convrot
- 每段最长 15 秒,分辨率有倍数和短边上限要求(见作者说明);作者建议草稿开 Turbo LoRA、成片关掉
**风险与限制**
- 依赖重:要同时跑 LM Studio 本地 LLM、YuE2 和 H3,自带节点更新频繁需同步
- 只有 1 张示例图、没有示例视频;作者提醒 H3 难以处理弹钢琴等手指细节
### 【B】[Personal Minimax H3 Ref2VA Workflows · Minimax H3 Ref2VA Main](https://civitai.com/models/2980782?modelVersionId=3378936)
*工作流 · 新模型 · 作者 Maelstrom\_ · 发布 10-04 10:31 · 下载 19*
作者自用的简洁 H3 ref2va 主工作流:1 段参考视频 + 最多 4 张参考图,可存 4 组提示词切换使用,全分辨率读图、低分辨率生成再放大回原尺寸。
**配图**
**推荐理由**
- 面向不喜欢复杂 LLM 节点和连线堆叠的用户;默认开启性能优化节点
- 同一模型页另有一个 Sequence 版本,可用 4 张图各配提示词和时长连续跑 4 个任务
**怎么用**
- 从 Manager 安装 Impact Pack、KJNodes、H3 Optimizations、Fantastic LoRAs;作者用 Nodes 2.0 界面
- 用 Prompt Switch 的 select 选当前提示词框;底模、文本编码器需换成自己的文件,作者不提供配置建议
**风险与限制**
- 没有可展示的示例(2 个被隐藏),版本说明只写“See Description”
- 作者明说不讲系统配置和参数推荐
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
### 【B】[My Minimax H3 workflow · v1.0](https://civitai.com/models/2981881?modelVersionId=3380311)
*工作流 · 新模型 · 作者 n980a · 发布 10-03 22:37 · 下载 49*
偏循环视频的 H3 图生视频工作流:按原图横竖自动设定 4:3 视频方向,可关掉音频缩短生成时间,可删掉最后一帧方便首尾衔接成循环。
**配图**
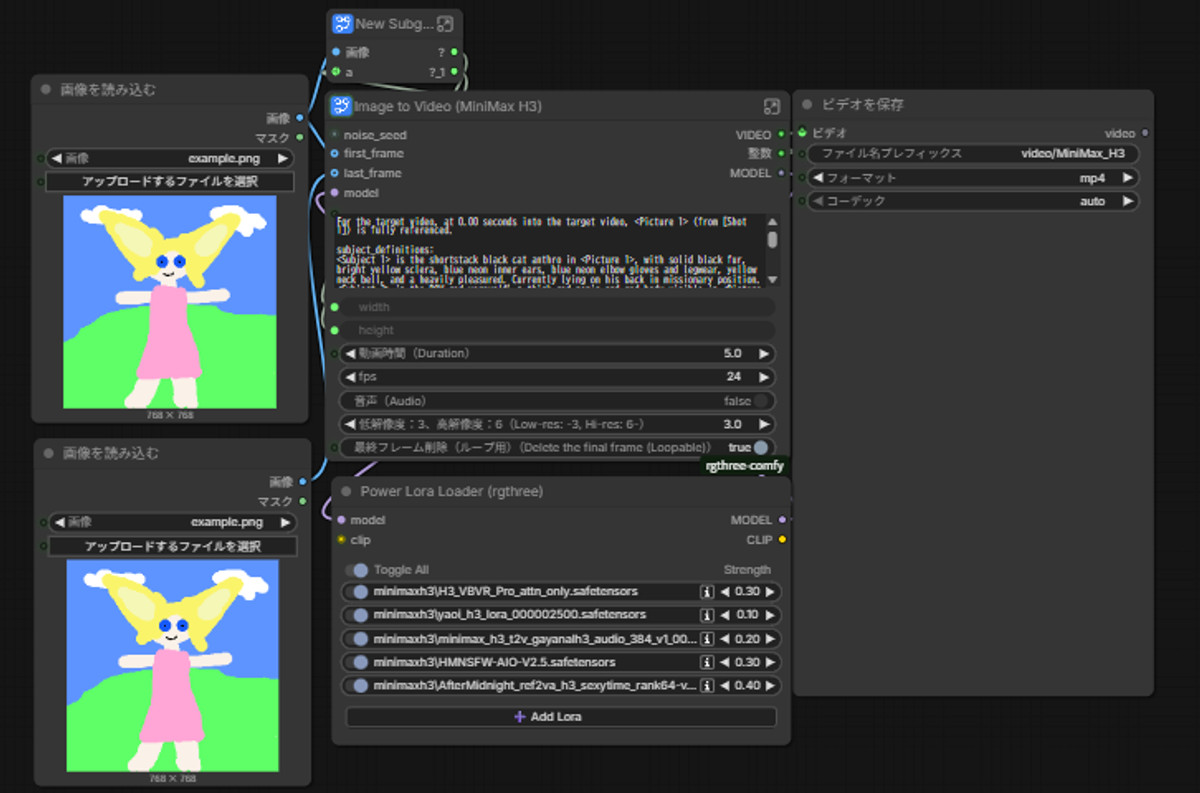
**推荐理由**
- 服务做循环动图 / 短循环视频的需求;默认开启 Semantic Bridge,LoRA 选择区放在显眼位置
- 说明有英文和日文两版
**怎么用**
- 需开启 ck-attention;画幅固定 4:3,要改需手动调数字;底模、VAE 和 LoRA 需自己准备,作者未给步数
**风险与限制**
- 作者称用了很多自定义节点但没有列出清单,需要自己补;只有 1 张示例图、没有视频示例
## 仅收录(4)
- [Lonecat's Simple Workflows (MiniMax H3, Krea 2, Qwen 2.1, ZIT, Klein\_9b, Illustrious, Flux, Wan2.2, Qwen Image Edit) · Simple MiniMax V2.0](https://civitai.com/models/2600919?modelVersionId=3381144) — 工作流:Lonecat 简易工作流合集里的 H3 版 V2.0:面向 ComfyUI 新手、分区清楚带注释,新版加了按电脑配置推荐优化项的 Model Optimizer 和预览窗口。
- [Agata · MiniMax H3 (Text2Video)](https://civitai.com/models/2324498?modelVersionId=3380764) — LoRA:原创 AI 角色 Agata(月光人像摄影师人设)的 H3 文生视频 LoRA,从作者的 Krea 2 / ZImageTurbo 版本移植。
- [Personal Minimax H3 Ref2VA Workflows · MinimaxH3 Ref2VA Sequence](https://civitai.com/models/2980782?modelVersionId=3378948) — 工作流:I don't like LLM crap, overlapping nodes, over complication or anything that makes a workflow look like it was inspired by a setup in Satisfactory or Factorio.
- [minimax\_1pass\_videomodel · v1.0](https://civitai.com/models/2982925?modelVersionId=3381627) — 工作流:Small warning : This is my first worfklow, and I am sorry, I cannot help you with errors. Use ChatGPT or any other LLM to help u solve them.
---
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 10-03 20:31 → 10-04 11:36(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。