MiniMax H3 晚报 2026-10-07|首推 Restore Enhance Improve
本期审阅 9 个 H3 新版本。首推 Nugus 的 Restore Enhance Improve:把画质差的视频接到默认 ref2va 工作流的视频参考上,强度 1.0 配作者给的提示词,重新生成一版去块状压缩、去噪、去模糊的高清版本,是本期下载最快的版本。其他亮点:LongTake 长视频工作流 v1.3(Refine 第二遍改用 H3 潜空间放大,作者称每段更快、脸更清楚,并支持角色设定图参考)、Motion Speed 速度滑杆 v1.1(降低对构图的干扰,权重改成 -8 到 8 的新刻度)、70–80 年代复古奇幻电影风格 LoRA Forgotten World's。Sparse
# 贞贞的AI雷达 · MiniMax H3 · 2026-10-07 晚报
本期 **9** 个新版本:强烈推荐 1 · 推荐 3 · 可关注 1 · 仅收录 4
> **编辑按语** 本期审阅 9 个 H3 新版本。首推 Nugus 的 Restore Enhance Improve:把画质差的视频接到默认 ref2va 工作流的视频参考上,强度 1.0 配作者给的提示词,重新生成一版去块状压缩、去噪、去模糊的高清版本,是本期下载最快的版本。其他亮点:LongTake 长视频工作流 v1.3(Refine 第二遍改用 H3 潜空间放大,作者称每段更快、脸更清楚,并支持角色设定图参考)、Motion Speed 速度滑杆 v1.1(降低对构图的干扰,权重改成 -8 到 8 的新刻度)、70–80 年代复古奇幻电影风格 LoRA Forgotten World's。SparseRef15 Hybrid 新出的 INT4 版没有任何版本说明,降为可关注;Arianna Belrose、Lilia Belwyn、Rogue 是常规角色 LoRA,Goblin Girl 的 H3 版是付费移植且没有 H3 专门说明,均为仅收录。
## 强烈推荐(1)
### 【S】[Restore Enhance Improve · v1.0](https://civitai.com/models/2989135?modelVersionId=3389308)
*LoRA · 新模型 · 作者 Nugus · 发布 10-07 13:38 · 下载 695*
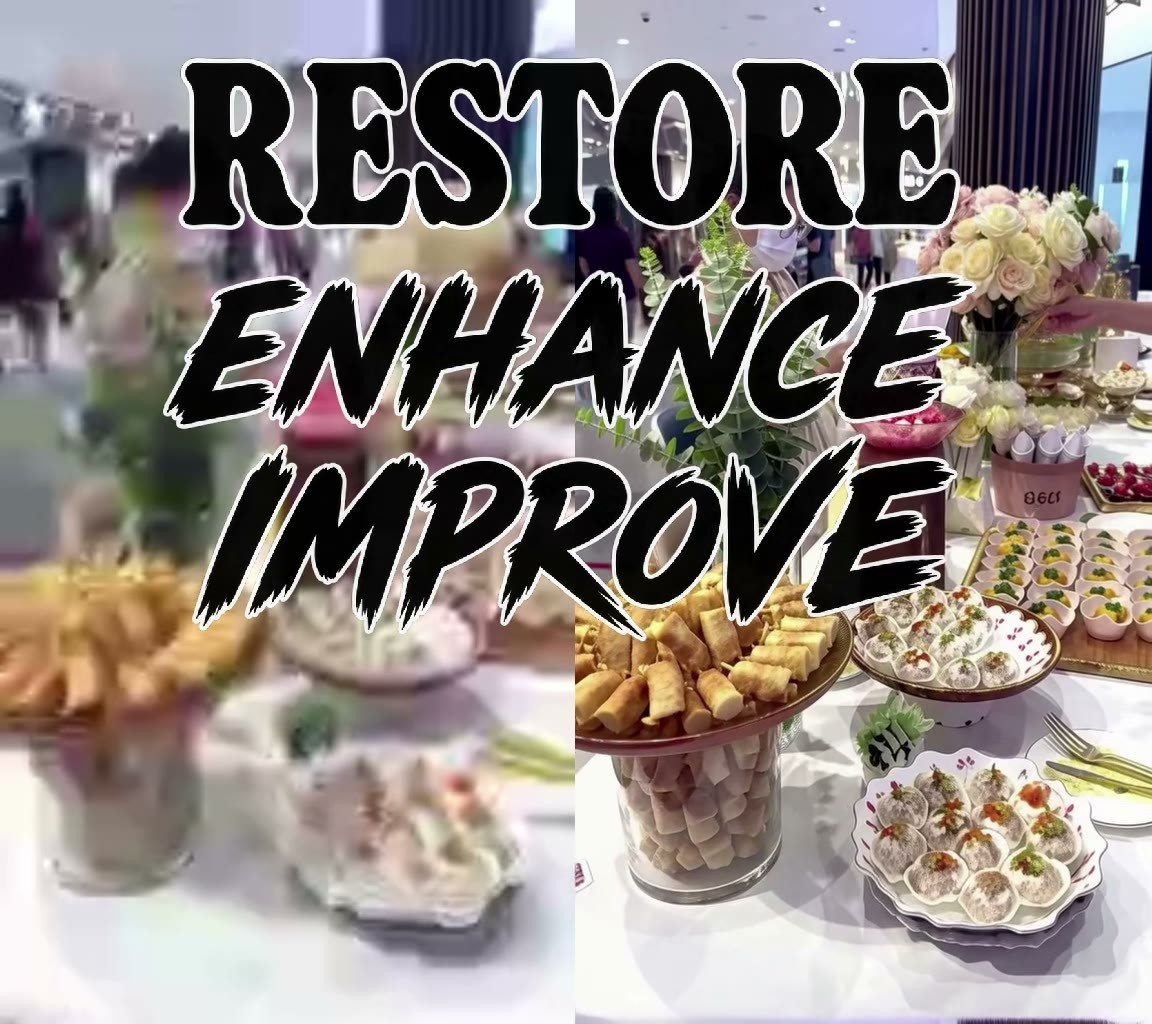
视频修复 LoRA:把低画质视频(马赛克、块状压缩、压缩噪点、模糊)作为参考视频喂给 H3 的 ref2va,重新生成一版保留原场景、颜色和动作的清晰版本,不只是放大。
> 适合先拿一段几秒的压缩素材试:保持比例、只提高输出分辨率,看人物面部是否被改。
**配图**
**推荐理由**
- 服务视频到视频的修复 / 增强:旧素材、被平台压缩过的片段、低分辨率生成结果都可以先过一遍再用;作者称能同时去掉块状伪影、压缩噪点和模糊
- 不需要专门工作流,用默认 ref2va 工作流即可;强度、接线方式、画幅规则和提示词作者都写明了,照做门槛低
- 附 2 段可见示例视频;发布 11 小时 695 次下载、57 赞,下载速度高于近 7 天 99% 的 H3 模型,免费下载
**怎么用**
- 默认 ref2va 工作流加载 LoRA,强度 1.0;把待修复视频接到视频参考(原视频有音频就一并接上)
- latent 尺寸比例必须和输入视频一致;可以输出更高分辨率,但比例不变(输入 9:16 就输出 9:16)
- 提示词用作者给的原句:Restore this video to high visual quality by recovering fine detail and reducing pixelation, block artifacts, and compression noise while preserving the original scene, natural colors, and motion.
- 无触发词;步数作者未给,按默认 ref2va 工作流设置
**风险与限制**
- 本质是重新生成而不是逐像素修复,细节(尤其人脸、文字)可能被改写;示例视频没有附提示词和原片对照说明,另有 3 个示例被隐藏
- 作者没说明单次能处理多长的输入、长视频是否要分段,也没写训练数据
- 许可不允许二次衍生,商用只允许出图和站内出租
## 推荐(3)
### 【A】[Minimax H3 Forgotten World's Retro Fantasy · Forgotten World's H3](https://civitai.com/models/2988830?modelVersionId=3388934)
*LoRA · 新模型 · 作者 Granddyser · 发布 10-07 09:01 · 下载 282*
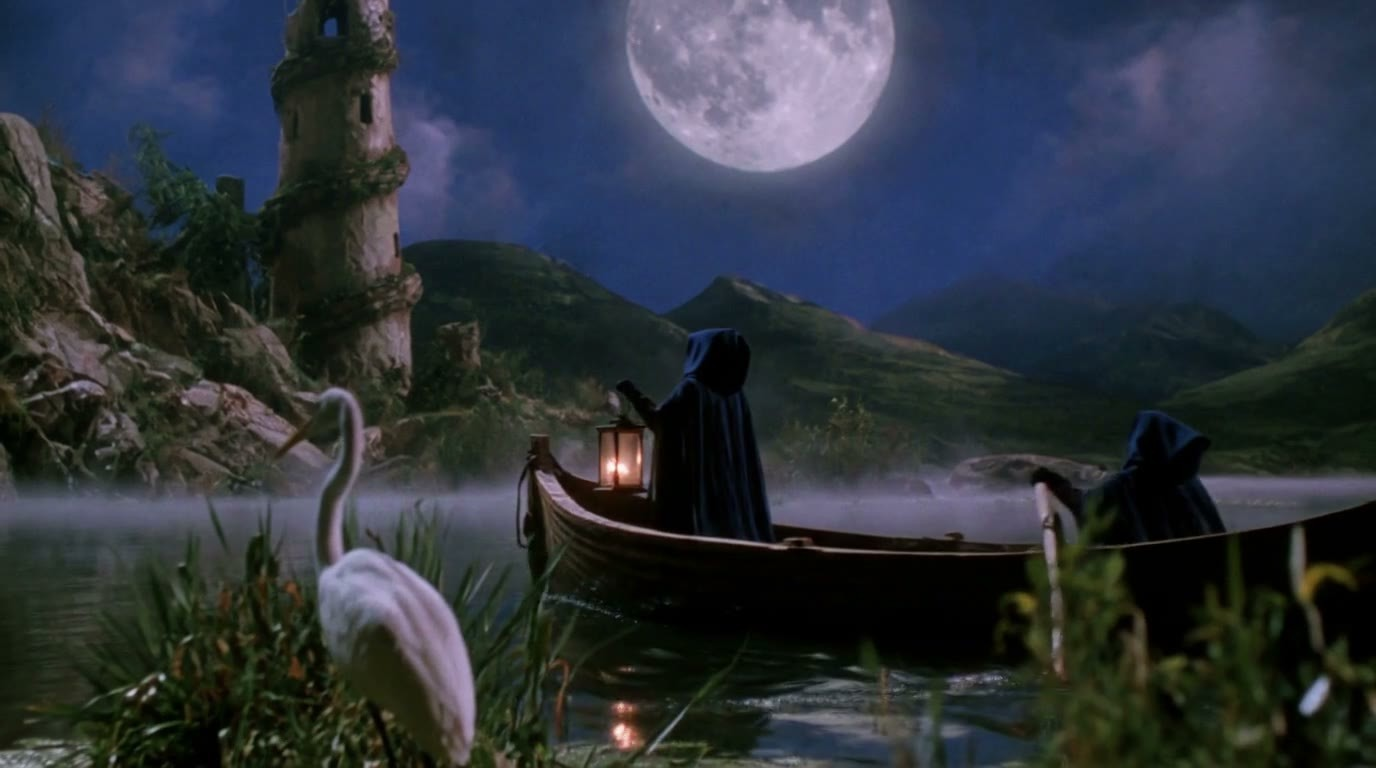
70–80 年代复古奇幻电影风格 LoRA:把画面往老式冒险奇幻片的视觉语言推——实景服装、舞台布景、手绘背景(matte painting)、怪异生物、古代遗迹和不完美的胶片质感,而不只是加颗粒和复古调色。
**配图**
**推荐理由**
- 服务文生视频的复古奇幻 / 黑暗奇幻 / 复古科幻题材:精灵、骑士、巫师、神话生物、沙漠王国、失落文明、异星风景,作者称也可以把这种老电影质感用到科幻或超现实题材
- 3 段可见示例视频都附提示词(1376×768 横屏);发布 16 小时 282 次下载、37 赞,免费,许可允许出图和出租,可二次衍生
**怎么用**
- 可选触发词 retr0Fantasy(作者称不加也能起作用,取决于提示词和工作流)
- 用 16:9 横屏;作者说 9:16 竖屏目前不推荐
- 强度和步数作者未给;作者说工作流在附带材料里,但本版文件只有两个权重,工作流可能嵌在示例视频里,需自行确认
**风险与限制**
- 作者标为实验性,称结果随提示词、采样器、LoRA 强度和工作流变化很大,更像创作工具而不是稳定预设
- 版本里有两个同大小、不同哈希的权重(retro-fantasy-step00003750 和 retro-fantasy),作者没说明区别和该用哪个;FP32 文件较大
- 强度、步数没有给出;另有 7 个示例被隐藏
### 【A】[Motion-Speed-MMH3-SLIDER · v1.1](https://civitai.com/models/2985458?modelVersionId=3389300)
*LoRA · 版本更新 · 作者 make676767 · 发布 10-07 14:14 · 下载 455*
Motion Speed 动作速度滑杆 LoRA 的 v1.1(作者在模型卡里也称 V2):仍是用正负权重控制动作快慢,本版降低了对画面取景和构图的影响,并换成 -8 到 8、默认 4 的新权重刻度。
> 从上一版升级的话旧权重要重调:同一种子跑 -6 / 0 / 4 / 6 对照,先找自己工作流里的有效区间。
**配图**
**推荐理由**
- 相比上一版改了三处:作者称对整体取景 / 构图的干扰更小;权重刻度重做(最小 -8、最大 8、默认 4,作者说低于 4 基本等于没加 LoRA,高于 4 可能大幅改变画面);新增参考视频生成(ref2v)工作流的用法示例
- 服务需要调动作节奏的文生 / 参考生视频:正权重加快打斗、奔跑、快速运镜,负权重做慢动作、子弹时间
- 文件从上一版约 4 MB 缩小到 183 KB;本版发布 10 小时 455 次下载、40 赞,整个模型累计 1425 次下载
**怎么用**
- 无需触发词;作者推荐默认权重 4,可调范围 -8 到 8
- 上一版的 ±0.5 到 ±4.0 区间不再适用:按作者说明,v1.1 在 4 以下几乎不起作用,需要明显变速时往 4 以上加
- 步数和配套设置作者未给
**风险与限制**
- 可见示例只有 1 段(3840×2160,无提示词),另有 3 个被隐藏;作者说新增了 ref2v 示例,但可见部分看不出用法
- 作者只说明了“4 以下基本无效果”,没说负方向是否同样以 -4 为界,也没说哪一侧对应加速 / 减速是否与上一版一致
- 大权重下画面和音频是否崩坏仍看不出;训练方式未说明
### 【A】[MiniMax H3 LongTake — long videos clip by clip | character swap, style transfer, retexture · v1.3](https://civitai.com/models/2942000?modelVersionId=3389390)
*工作流 · 版本更新 · 作者 mark90it · 发布 10-07 15:11 · 下载 130*
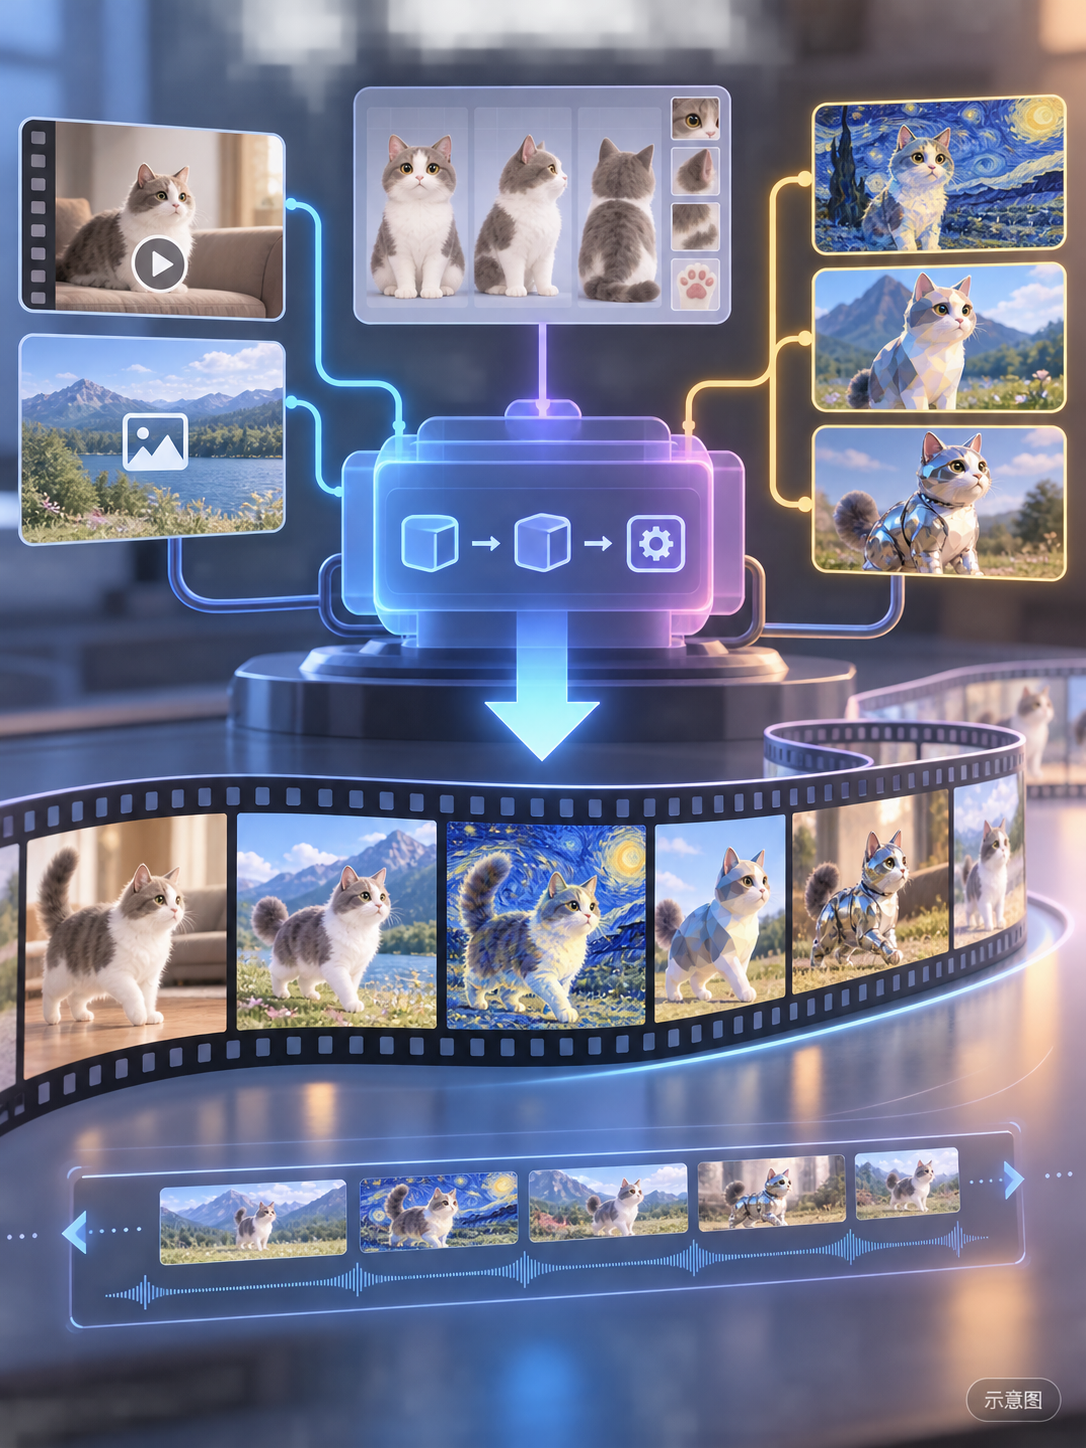
LongTake 长视频工作流 v1.3:把任意长度的源视频或一张图逐段生成成长视频(换角色、风格迁移、局部换材质、图生长视频);本版让 Refine 第二遍改用 H3 潜空间放大,并支持角色设定图作额外身份参考。
**配图**
**推荐理由**
- 服务长视频:源视频切段逐段渲染、用上一段的潜变量尾帧接缝,支持断点续跑和单段重做;i2v 工作流用一张图做首帧、每 5 秒一段提示词生成长视频
- v1.3 主要变化:Refine 第二遍默认直接放大潜变量,不再解码—缩放—重编码;作者称同参考同种子下每段 253 s 对比原来 375 s,脸部清晰度 222 对 85,身份不变,手部 +60 %
- 新增 frames_from = mp4,可以对已在像素层面修过脸或调过色的片段再做 Refine;character_sheet 输入(节点 1.2.0 起)可在图片 + 脸部参考之外再加多视图设定图,作者称在一段较难的 15 s 测试里身份相似度下限从 0.16 提到 0.26
- 修复:新版 ComfyUI 动态显存下同一会话第二次运行会越来越慢直到卡死;dry_run 时 Refine 和 Stitch 会停下而不是误拼同名旧项目;i2v 工作流 Stitch 的 audio_file 默认值校验失败
- 节点包 MIT 开源,免费下载;本版发布 10 小时 130 次下载,整个模型累计 1126 次下载
**怎么用**
- 先在 ComfyUI-Manager 把 ComfyUI-H3-LongTake 节点包更新到 1.3.0 以上,再导入 zip 里的 4 个工作流(各带 README 说明)
- 要用潜空间放大:另装 Comfyui_Minimax_h3_latent_Upscaler 节点包,把 minimax_h3_latent_upscaler_3d_fp16.safetensors 放进 models/latent_upscale_models;缺了会自动退回旧的像素放大并在报告里提示
- 模型:ref2va 主模型 + minimax_h3_ref2v_turbo_4step_v0.1_comfyui_bf16 加速 LoRA(4 步);无参考的 i2v 用 fl2va 主模型 + minimax_h3_fl2v_lightx2v_turbo_4step_v0.1_comfy
- 流程:先 dry_run 看切段计划,再只跑两段检查身份和接缝,最后跑完整段落并解除 Stitch 节点静音拼接成片
**风险与限制**
- 本版 4 个示例全部被隐藏,没有可见示例;作者称本版画廊复用 v1.1 的 08_i2v.mp4
- 这是工作流 + 自定义节点,不是新权重;依赖较多:H3 官方 ref2va / fl2va 模型、Qwen3-VL 文本编码器(作者称约 25 GB,放在内存里)、视频与音频 VAE、Turbo LoRA,风格迁移还要 NRDX 的 StyleTransfer LoRA
- 作者给的速度参考(模型卡总说明,非本版):16 GB 显卡 544×960 下每 5 秒片段约 4 分 40 秒,约一小时出一分钟视频
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
## 可关注(1)
### 【B】[MiniMax H3\_SparseRef15\_Hybrid · Pruned\_INT4](https://civitai.com/models/2900456?modelVersionId=3389072)
*底模 / Checkpoint · 版本更新 · 作者 Aki7777777 · 发布 10-07 13:44 · 下载 46*
SparseRef15 Hybrid 底模的新 INT4 量化版:一个以 FL2VA(首尾帧)为基础、在 50 个主 transformer 块中的 15 个通过 AdaLN 稀疏注入 Ref2VA 的混合底模,目标是长段多片段生成中角色不漂移;本版把体积压到 11.7 GB。
**配图**
**推荐理由**
- 服务多片段长视频里的角色一致性:作者称该系列在人物转身、短暂离开正脸、连续很多段之后仍能保持身份,同时保留 FL2VA 的动作自由度和场景表现
- 相比同系列的 INT8、Partial-INT8 和未量化的 BF 版本,INT4 文件明显更小,面向显存更紧的机器;整个模型累计 6787 次下载、309 赞
- 附 1 段可见示例视频(832×1248,带提示词)
**怎么用**
- 替换 H3 底模加载(11.7 GB · INT4 · SafeTensor)
- 作者强调它不是原生 Ref2V 模型:要配为 FL2VA 训练的 LoRA,不要用 Ref2V 的 LoRA
- 步数、CFG、需要的加载节点作者未给
**风险与限制**
- 作者未写更新说明:INT4 版没有任何版本描述,量化方式、相对 INT8 的画质 / 参考强度损失、需要什么加载节点都没交代
- 模型卡里的长段稳定性说法(例如 21 段连续生成几乎不漂移)是针对 Partial-INT8 版写的,不能直接套到 INT4 上;作者另称更强的参考会降低场景自由度
- 作者标为实验性;本版只有 1 段可见示例,另有 1 个被隐藏;同系列 INT8 版文件约 19.5 GB
## 仅收录(4)
- [Arianna Belrose · MiniMax H3 (Text2Video)](https://civitai.com/models/2988551?modelVersionId=3388565) — LoRA:原创虚拟人物 Arianna Belrose(意大利米兰的家族企业经理人设定)的角色 LoRA,H3 文生视频版本;说明全是人物背景故事,没有使用信息。
- [Rogue, X-men 92 (Minimax h3, Illustrious) · Rogue, Minimax H3](https://civitai.com/models/1710151?modelVersionId=3389184) — LoRA:92 版《X 战警》动画中 Rogue(罗古)的角色 LoRA,从同模型页的 Illustrious 图像版移植到 H3,模仿原动画的画风。
- [Lilia Belwyn · MiniMax H3 (Text2Video)](https://civitai.com/models/2988545?modelVersionId=3388558) — LoRA:原创虚拟人物 Lilia Belwyn(布鲁日的百合花艺师设定)的角色 LoRA,H3 文生视频版本;说明全是人物设定,没有使用信息。
- [Goblin Girl Transformation \[Anima | Krea 2 | Illustrious | Pony | SD 1.5\] · MiniMax H3](https://civitai.com/models/623639?modelVersionId=3388961) — LoRA:“哥布林化”概念 LoRA 的 H3 移植版:把角色变成绿皮肤、尖长耳、矮个子的哥布林女孩;此前已有 Krea 2、Anima、Illustrious、Pony、SD 1.5 图像版。
---
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 10-07 09:00 → 10-07 21:00(北京时间),回填期。推荐理由经编辑审阅;下载量只代表关注度。