MiniMax H3 晨报 2026-10-21|首推 Tap to Screen — MiniMax H3 lip-sync MV on your own song (1–4 scenes, timeline)
本期审阅 8 个 H3 新版本。首推 Tap to Screen(H3 Timeline 4)工作流:用自己的歌加 1–4 张图做对口型 MV,边放歌边按键切镜、标出开唱区间,每段歌作为 <Audio 1> 交给 H3 对口型,维持 A;没有一段示例视频,所以不给 S。Stefan Falkok 的四合一工作流 v3.5 加了 Veda 稀疏注意力加速节点,维持 B;Minimax.. simple v4 改成手动分批续接长视频、作者自认界面难懂,由 A 降为 B;Eto_OC、Tess Buchanan 两个角色 LoRA 说明单薄或示例被隐藏,降为 C。
# 贞贞的AI雷达 · MiniMax H3 · 2026-10-21 晨报
本期 **8** 个新版本:强烈推荐 0 · 推荐 1 · 可关注 3 · 仅收录 4
> **编辑按语** 本期审阅 8 个 H3 新版本。首推 Tap to Screen(H3 Timeline 4)工作流:用自己的歌加 1–4 张图做对口型 MV,边放歌边按键切镜、标出开唱区间,每段歌作为 <Audio 1> 交给 H3 对口型,维持 A;没有一段示例视频,所以不给 S。Stefan Falkok 的四合一工作流 v3.5 加了 Veda 稀疏注意力加速节点,维持 B;Minimax.. simple v4 改成手动分批续接长视频、作者自认界面难懂,由 A 降为 B;Eto_OC、Tess Buchanan 两个角色 LoRA 说明单薄或示例被隐藏,降为 C。
## 推荐(1)
### 【A】[Tap to Screen — MiniMax H3 lip-sync MV on your own song (1–4 scenes, timeline) · v1.0](https://civitai.com/models/3011810?modelVersionId=3418189)
*工作流 · 新模型 · 作者 koyan0418439 · 发布 10-20 22:22 · 下载 50*
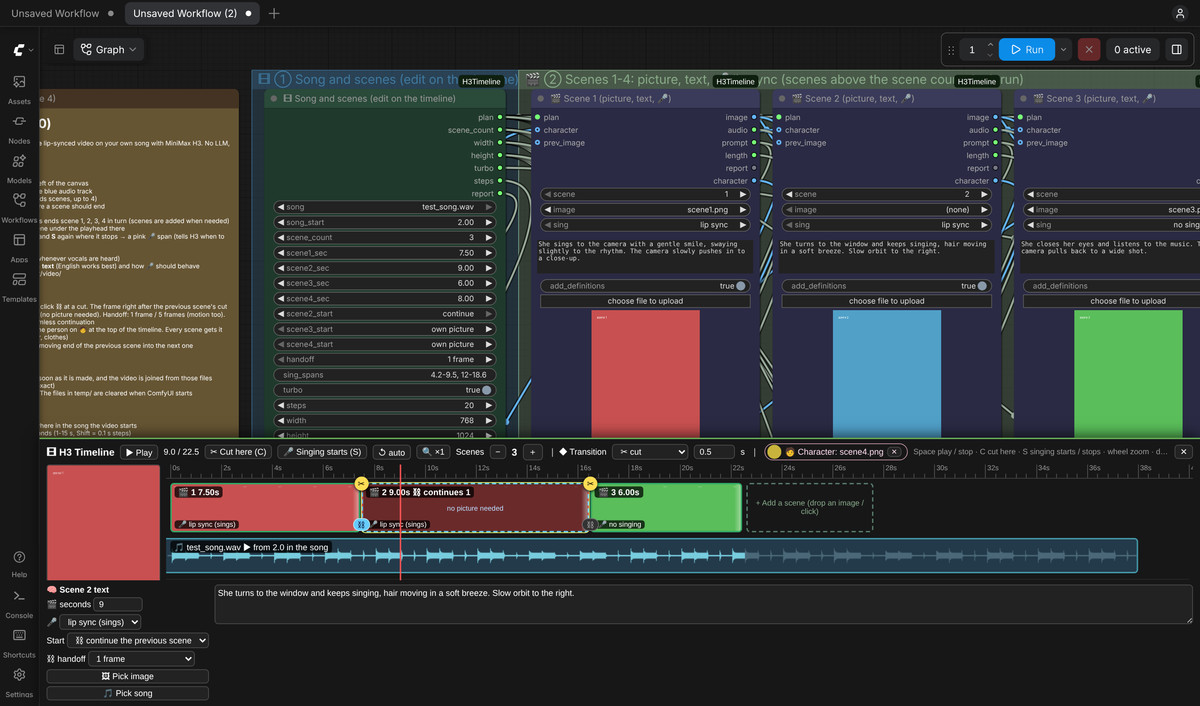
Tap to Screen(H3 Timeline 4):用自己的歌加 1–4 张图,在 ComfyUI 里做 H3 对口型 MV 的工作流——边放歌边按键切镜头、标出哪里开唱,每段歌直接作为 <Audio 1> 交给 H3 对口型。
> 适合先用一首歌的副歌做 2 个场景、一处“接上一段”,验证对口型和衔接后再扩到 4 段。
**配图**
**推荐理由**
- 新能力:作者自带一个时间线编辑器节点,在 ComfyUI 页面底部看着波形放歌,按 C 在当前位置切镜、按 S 标记开唱 / 停唱,H3 只在标出的区间里对口型;没标就听到人声就唱
- 服务音频驱动的参考图生视频:最多 4 个场景、每段 1–15 s;一张人物图喂给所有场景保持同一人物,切点处可一键“接上一段”(用上一段切点后的那帧作下一段首帧),转场有硬切、交叉淡化、黑场、白场
- 作者称内存只需一个场景的量,即便 4 × 15 s 也是如此(每段生成完就存盘、最后拼接);<Picture 1> / <Audio 1> 定义和带时间点的对口型提示会自动加进你的文字;不用 LLM、不用 YuE2、不用乐谱
- 附日文版和英文版工作流,只需装一个自定义节点文件夹;免费,许可允许出图、售卖;发布 11 小时 50 次下载、6 赞
**怎么用**
- 把压缩包里的 custom_nodes/ComfyUI-H3Timeline 复制进 ComfyUI 的 custom_nodes,重启并强制刷新页面,再把 workflows 里的工作流拖进画布;需要新版 ComfyUI(内置 H3 节点)
- 配套模型:H3 ref2va 主模型(int8 版)、minimax_h3_ref2v_turbo_4step_v0.1 Turbo LoRA(4 步)、Qwen3-VL 文本编码器、H3 视频 VAE 和音频 VAE,完整文件名和放置目录见模型卡
- 操作:点画布左下角时间线按钮 → 把歌拖到音轨 → 每个片段拖一张图 → 空格播放、C 切镜、S 标开唱 / 停唱 → 在时间线下方给每个场景写文字(作者建议英文)→ 运行,成片在 output/video;拖片段右边缘调长度(按住 Shift 以 0.1 s 为步长)
**风险与限制**
- 没有一段示例视频,只有 1 张图,对口型准确度、跨场景人物一致性都无从预览
- 完整模型卡写明:成片声音默认比画面晚 0.2 秒(作者称 H3 动作略滞后于声音,可用 av_shift 调);每个场景的临时文件最多约 0.9 GB,存在 temp/h3tl,需要留足磁盘
- 加速 attention 节点面向 N 卡 / A 卡,不兼容时要改成 pytorch attention;单段仍受 H3 15 秒上限限制,本工具未运行
## 可关注(3)
### 【B】[Minimax.. simple · v4 Beta](https://civitai.com/models/2847150?modelVersionId=3418581)
*工作流 · 版本更新 · 作者 sy0ww4bb1984 · 发布 10-21 02:10 · 下载 39*
Minimax.. simple v4 Beta:H3 参考图生视频 + 续写加长 + 分批放大的整套工作流,本版把各段之间的串联改成“存 latent、下一批再手动载入”,作者称是为了让配置较低的机器也能跑长视频。
**配图**
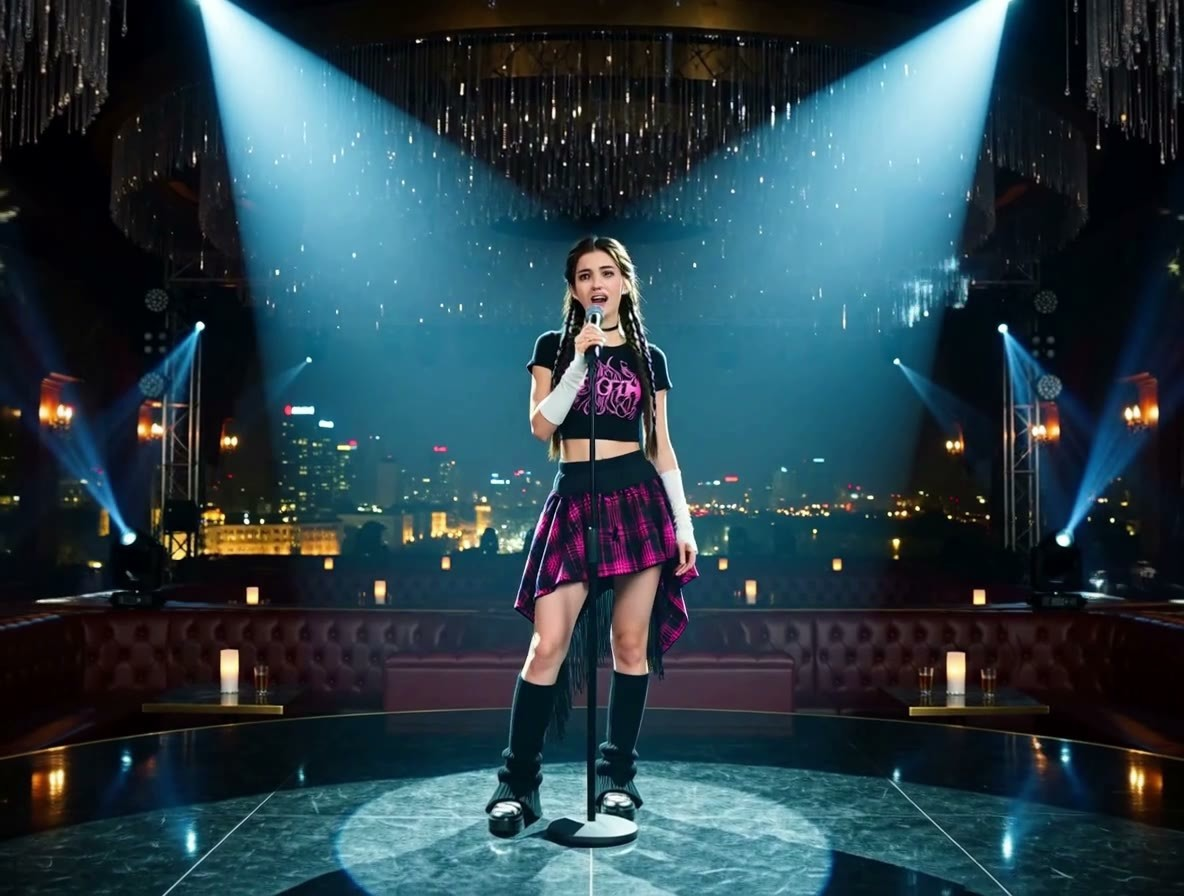
**推荐理由**
- 版本更新:上一版(v3.1)把多批生成直接串在一条流程里;v4 改为每批保存 latent,下一批手动载入继续,工作流体积比之前小很多
- 本版分成 4 个采样组:基础视频、续写延长、放大、批量放大;服务参考图生视频、长视频续写和低分辨率长视频分批放大
- 作者在模型卡给出的做法:用 Kijai 的 Ref2VA 加速 LoRA,强度 0.4-1.0;单段 5-15 秒,作者称 1MP 下 300 帧;续写靠提示词承接上一段视频的最后 8 帧
- 免费,许可允许出图、售卖;整个模型累计 2377 次下载、49 赞,本版发布 7 小时 39 次下载;附 2 段示例视频(均带提示词)
**怎么用**
- 下载 minimaxSimple_v4Beta.zip(17 MB)导入 ComfyUI,依次跑基础视频组 → 续写组 → 放大组;每跑完一批,要自己把上一批输出的 latent 载入下一批
- 加速 LoRA 用 MiniMax-H3-Ref2VA-Acc-8Step(Kijai 的 H3 实验仓库),强度 0.4-1.0;所需自定义节点作者未列清单,导入后按缺失提示补
**风险与限制**
- 作者自己说 Beta 是指界面:不直观,图里的注释是他零散的想法,“不知道别人能不能看懂”,本版是在测试别人能否用起来
- 更新说明与模型卡第一段重复,没写各采样组的具体参数;另有 2 个敏感级示例已隐藏;本工具未运行
### 【B】[MiniMax H3 Workflows (T2V, I2V, First-Last-Frame, Ref2V) with SageAttention + Turbo Lora + VEDA Attention (x1.7-x2 boost)) · v3.5 (Veda Speed Boost)](https://civitai.com/models/2831550?modelVersionId=3418773)
*工作流 · 版本更新 · 作者 Stefan\_Falkok · 发布 10-21 04:09 · 下载 78*
Stefan Falkok 的 H3 全套工作流(文生视频、图生视频、首尾帧、参考图生视频)v3.5:新加 Veda 稀疏注意力加速节点并给出两个配套模型的下载链接,作者称生成速度提升 1.7–2 倍,同时删掉了缓存节点。
**配图**
**推荐理由**
- 版本更新:加入 Veda Speed Boost 生成节点,配两个 Veda 预览版 fp8 模型(文生音视频用的 t2va_veda_8nfe_600step 和参考图生音视频用的 r2va_veda),作者称速度提升 x1.7-x2;删除缓存节点;更新了推荐的 Turbo LoRA 列表
- 一个压缩包覆盖文生视频、图生视频、首尾帧、参考图生视频四种任务,适合已经在用这套工作流、想缩短出片时间的人
- 免费;系列累计 10001 次下载、195 赞,本版发布 5 小时 78 次下载
**怎么用**
- 下载 minimaxH3WorkflowsT2VI2VFirstLastFrame_v35VedaSpeedBoost.zip(70 KB),从模型卡链接下载 minimax_h3_t2va_veda_8nfe_600step_preview_fp8.safetensors 和 minimax_h3_r2va_veda_preview_fp8.safetensors,放到 ComfyUI/models/veda/
- 其余 H3 模型从 Comfy-Org 的 MiniMax-H3 仓库下载;作者另给了 Heretic 版 Qwen3-VL-32B 文本编码器(int8 / nvfp4)链接;步数、采样器以工作流内设置为准,作者未在说明里写
**风险与限制**
- 加速倍数是作者称,没有同参数对比;Veda 模型名里标着 preview,画质是否有损失未说明
- 可见示例为 0(3 个敏感级示例已隐藏);许可不允许商用;本工具未运行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
### 【B】[2L Psycaldelic clown world · MiniMax H3](https://civitai.com/models/2596508?modelVersionId=3419099)
*LoRA · 移植 · 作者 2lab · 发布 10-21 08:03 · 下载 9*
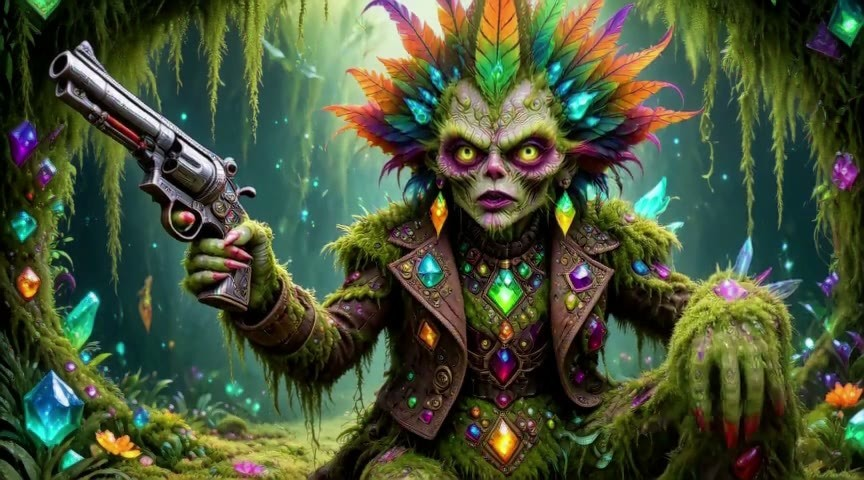
2L Psycaldelic clown world 的 H3 移植版:概念 LoRA,把画面里的人物或其他主体变成类人小丑造型;作者称男性主体偏恐怖小丑,女性主体偏蓬裙、厚底高跟靴、高礼帽的造型。
**配图**
**推荐理由**
- 移植:同一模型下已有 SDXL 1.0、Illustrious、ZImageTurbo 版本,H3 版让这个小丑化概念能直接用在文生视频 / 图生视频里
- 作者称这个 LoRA 作用很强,大多数主体都会被改成类人小丑
- 附 1 段示例视频;免费,许可允许出图;整个模型累计 123 次下载
**怎么用**
- 在 H3 工作流里加载 2l-pcw-minimax-h3-base-epoch-03.safetensors(296 MB · BF16),无触发词,提示词里写主体即可;强度、步数作者未给
- 模型卡说 Illustrious 版要在提示词里写 makeup 效果才好,H3 版是否同样需要作者未说
**风险与限制**
- H3 版说明只有一句“只是试试”,文件名显示是第 3 轮的权重,而其他底模版本用的是第 10 轮,训练可能不充分
## 仅收录(4)
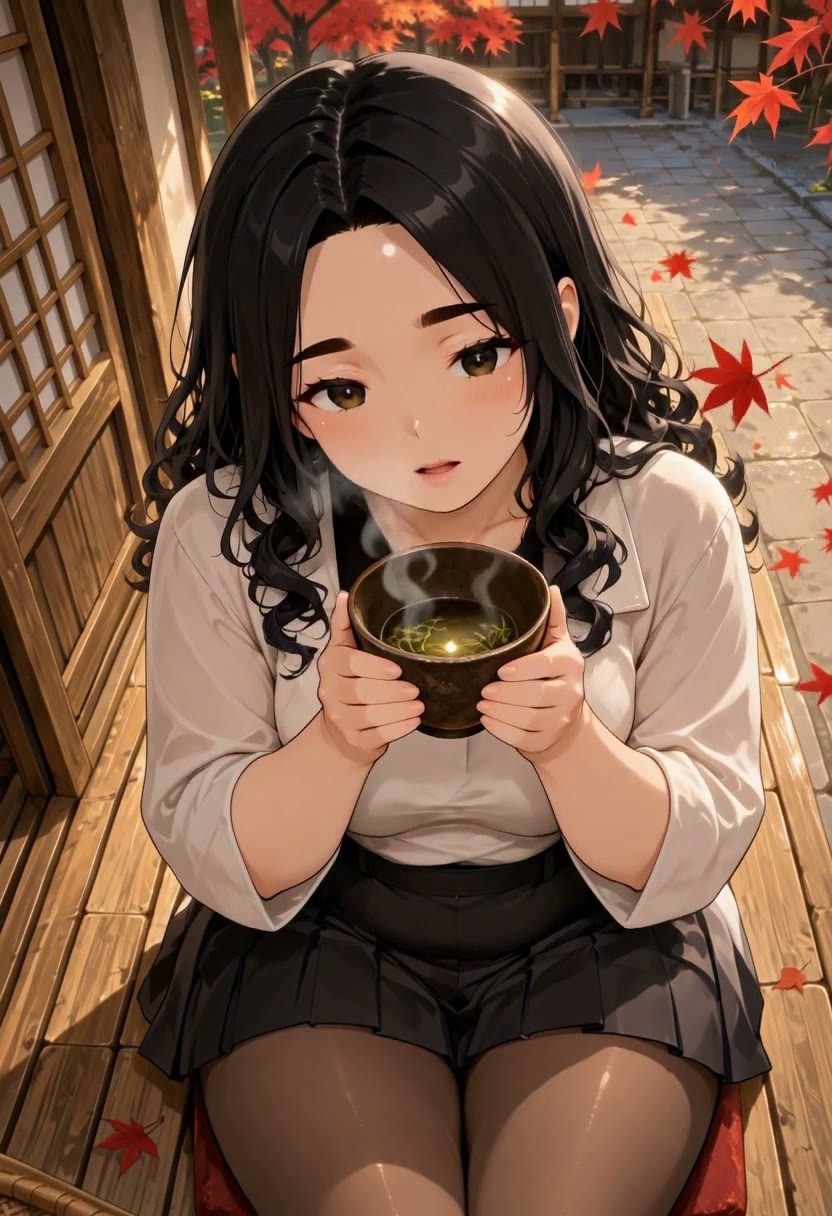
- [Eto\_OC · v1.0](https://civitai.com/models/3011845?modelVersionId=3418235) — LoRA:Eto_OC:作者为自己的原创角色训练的 H3 人物 LoRA,作者要求强度设 0.30。
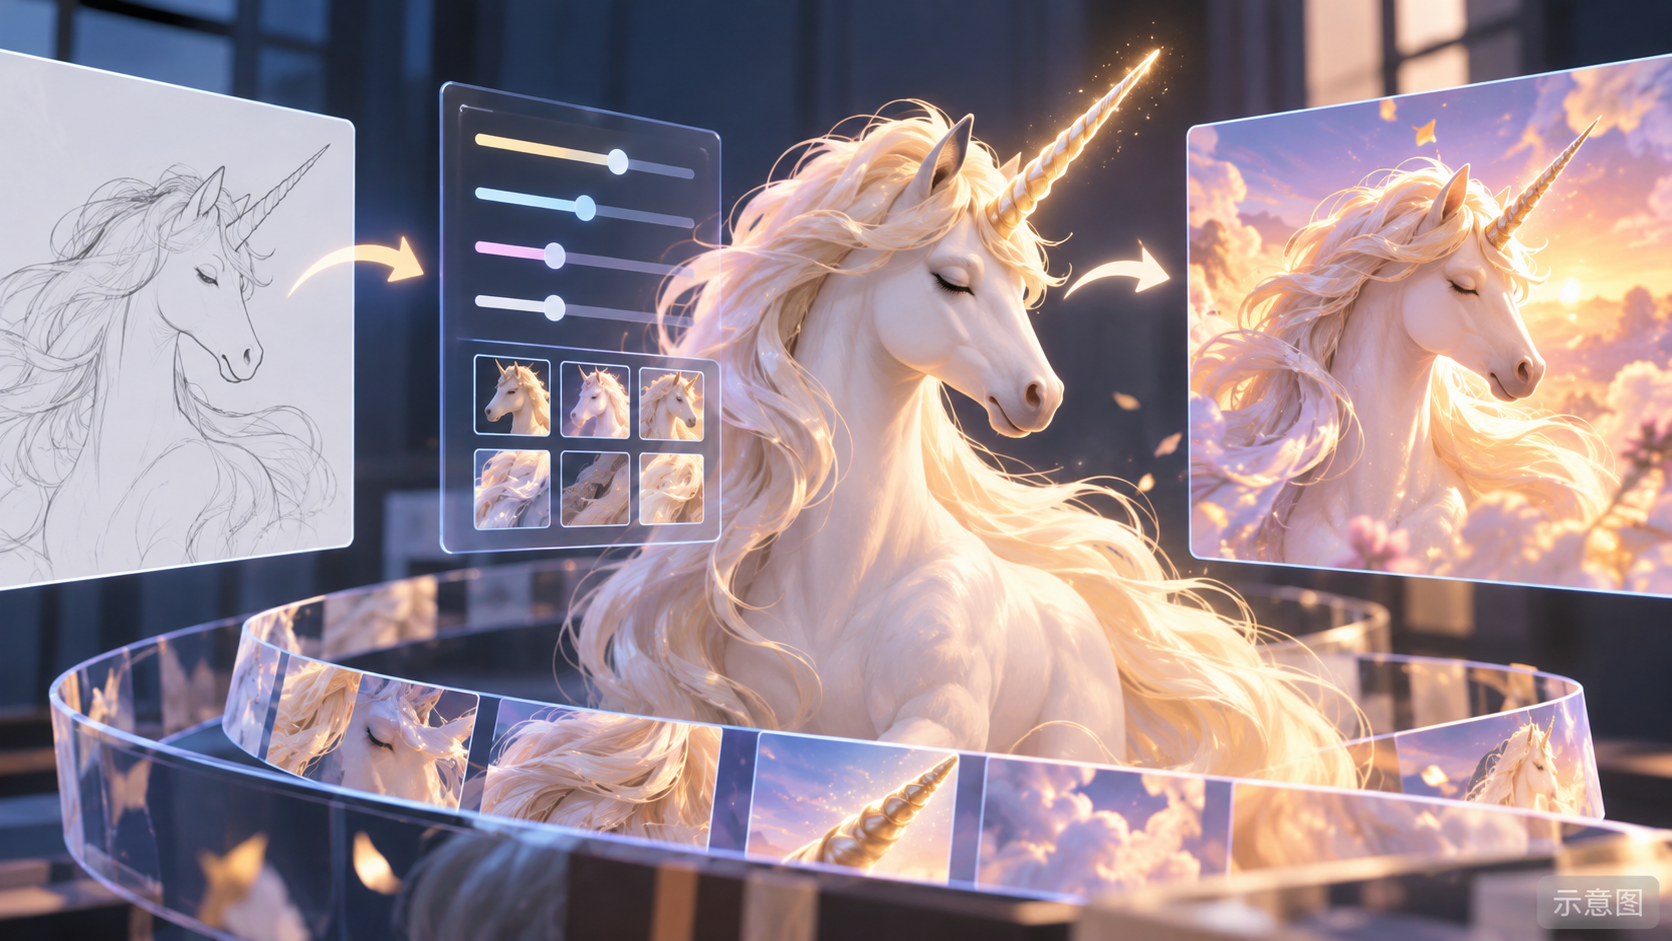
- [Tess Buchanan · v1.0 H3](https://civitai.com/models/2966147?modelVersionId=3418610) — LoRA:Tess Buchanan 的 H3 版:作者原创的独角兽女孩角色(额头带角的人形),用触发词 tesslora 在 H3 视频里固定她的外观,从同名 Krea 2 版移植。
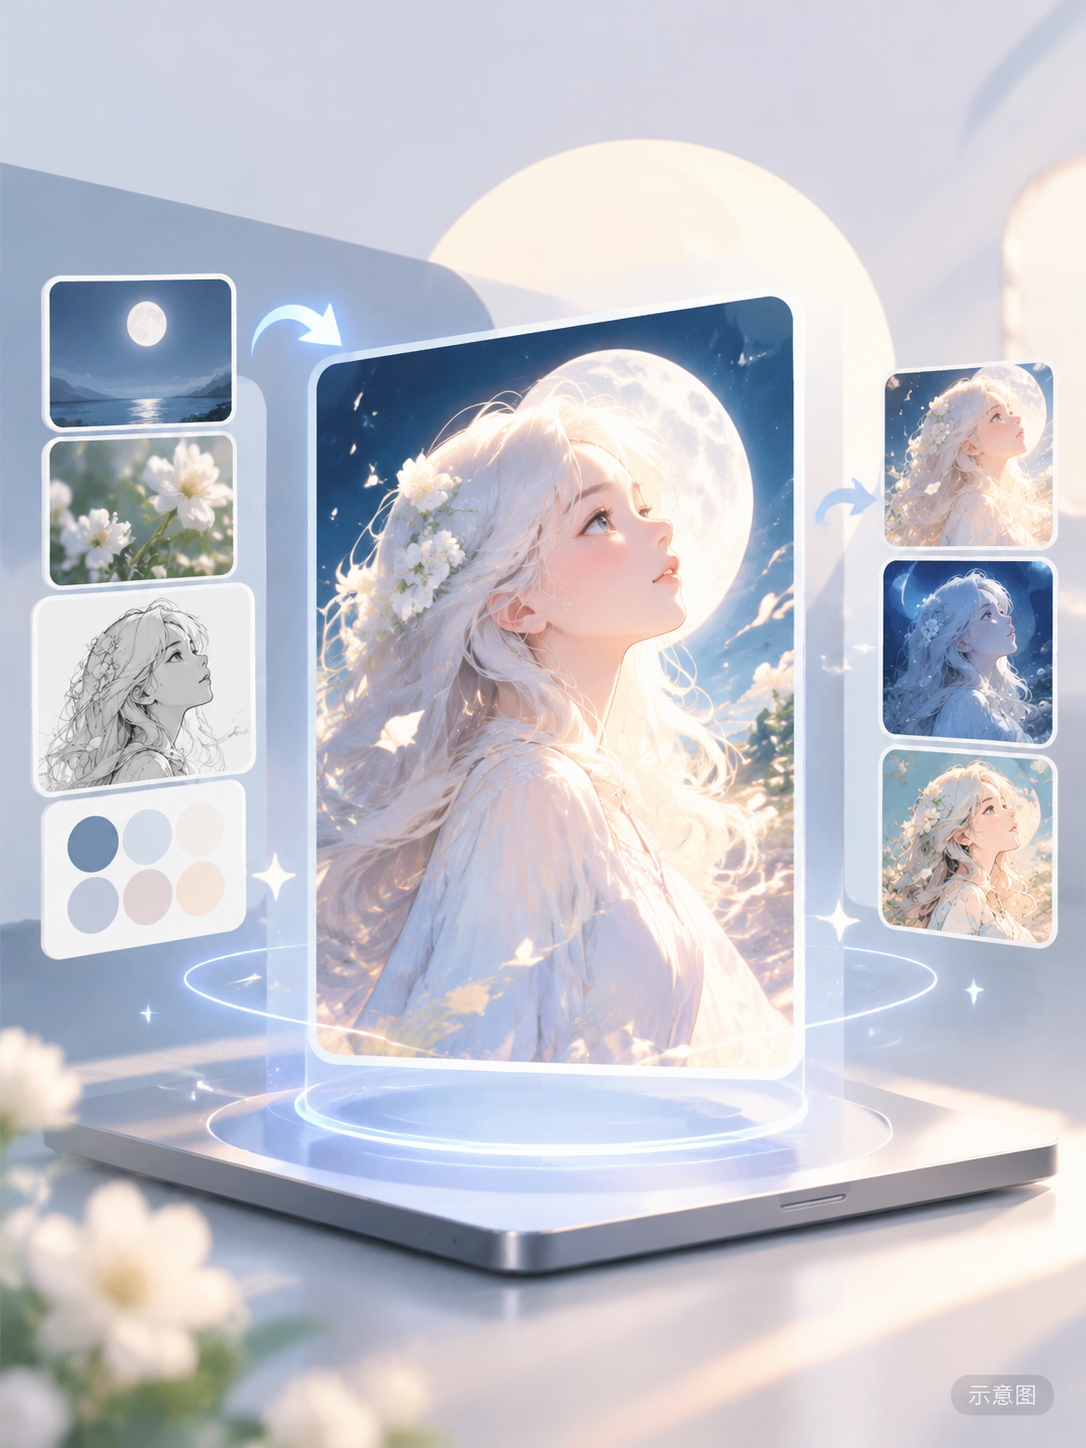
- [Joanna WhiteMoon · MiniMaxH3](https://civitai.com/models/2802854?modelVersionId=3418433) — LoRA:Joanna WhiteMoon 的 H3 版:作者虚构的蒸汽朋克图书馆“幽灵档案员”女性角色,用来在 H3 视频里固定她的长相和天鹅绒外套、银饰、雪纺裙这类装扮。
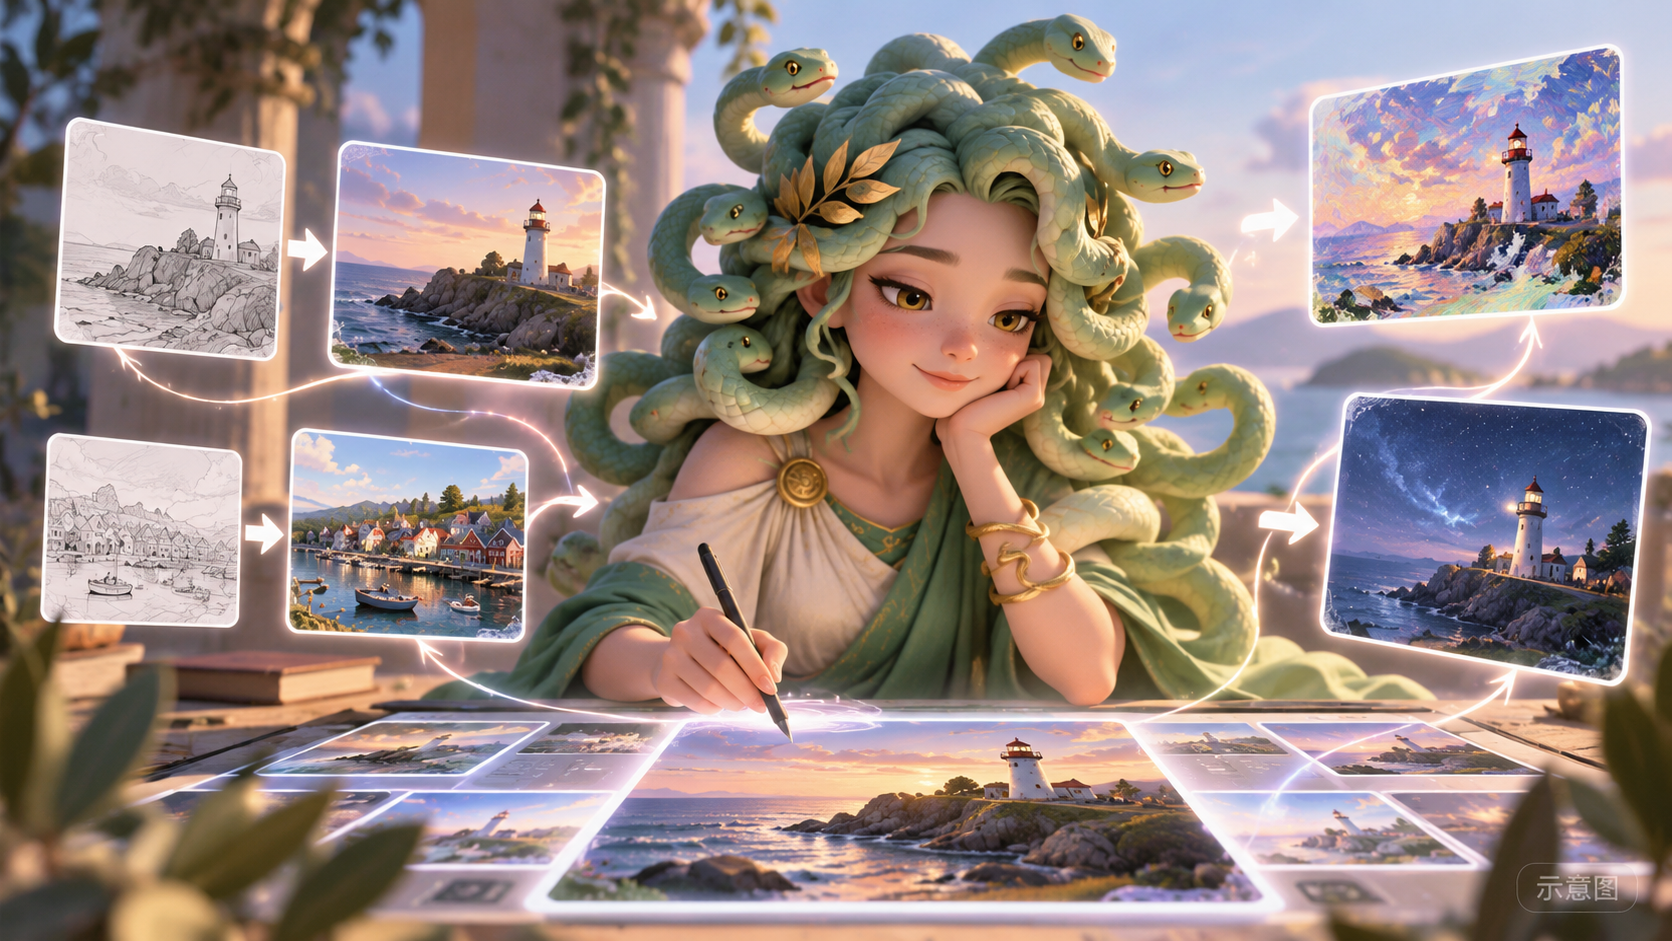
- [Madison Ceto · v1.0 H3](https://civitai.com/models/2934231?modelVersionId=3418191) — LoRA:Madison Ceto 的 H3 版:作者原创的蛇发女妖角色(头发是一群活蛇),用触发词 maddielora 在 H3 视频里固定她的外观,从 Krea 2 / ZImageTurbo 版移植。
---
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 10-20 20:31 → 10-21 09:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。