MiniMax H3 晨报 2026-10-05|首推 MiniMax H3 360 Orbit
本期审阅 20 个 H3 新版本。首推 AusBoss 的 360 Orbit v1.1:一张照片生成绕主体一整圈、首尾相接可循环的环绕镜头,新版加了“周围环境”输入,纯色背景下不再像原地自转。长视频工作流集中更新:SEED HUNTER v2.5 加入台词 / 声音克隆,LongForge v4.7 可复用参考素材并新增接缝检查,Dual Segment 让 16 GB 显卡一次跑两段,Dasiwa Xtra v1.5 一键切换 Native / Turbo。风格类有片场幕后花絮、80 年代奇幻片和迪士尼文艺复兴画风 V2。几个只有角色设定或说明近乎为空的角色 LoRA、付费且无可见示例的潜
# 贞贞的AI雷达 · MiniMax H3 · 2026-10-05 晨报
本期 **20** 个新版本:强烈推荐 1 · 推荐 9 · 可关注 3 · 仅收录 7
> **编辑按语** 本期审阅 20 个 H3 新版本。首推 AusBoss 的 360 Orbit v1.1:一张照片生成绕主体一整圈、首尾相接可循环的环绕镜头,新版加了“周围环境”输入,纯色背景下不再像原地自转。长视频工作流集中更新:SEED HUNTER v2.5 加入台词 / 声音克隆,LongForge v4.7 可复用参考素材并新增接缝检查,Dual Segment 让 16 GB 显卡一次跑两段,Dasiwa Xtra v1.5 一键切换 Native / Turbo。风格类有片场幕后花絮、80 年代奇幻片和迪士尼文艺复兴画风 V2。几个只有角色设定或说明近乎为空的角色 LoRA、付费且无可见示例的潜水面罩 LoRA 降为仅收录。
## 强烈推荐(1)
### 【S】[MiniMax H3 360 Orbit · v1.1](https://civitai.com/models/2976490?modelVersionId=3384201)
*工作流 · 版本更新 · 作者 AusBoss · 发布 10-05 07:09 · 下载 115*
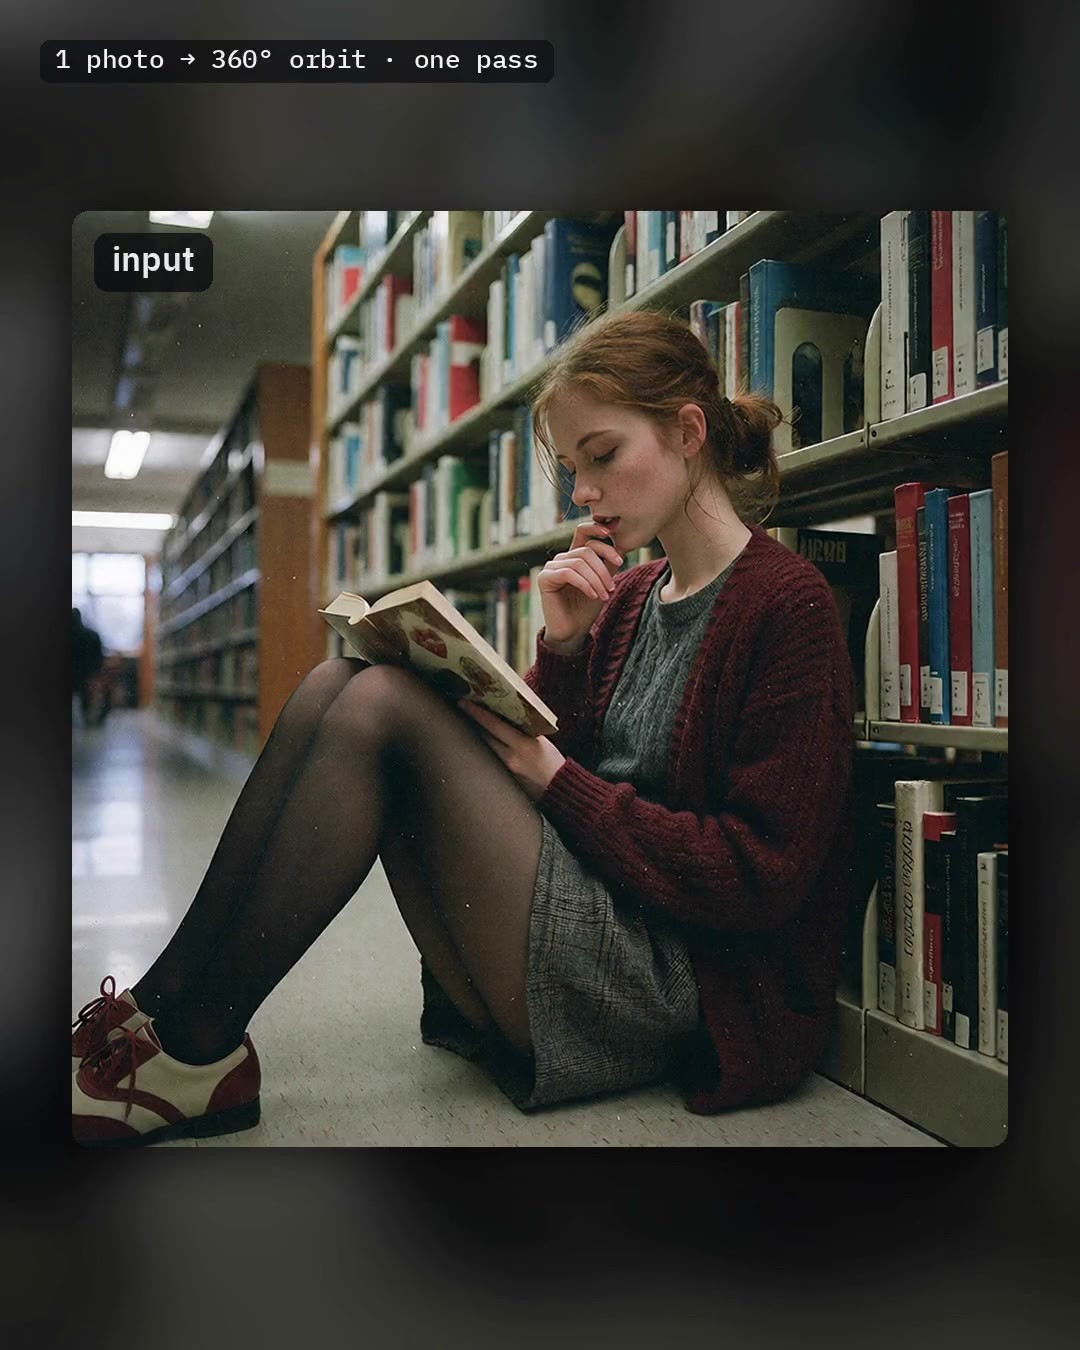
AusBoss 的单图 360° 环绕镜头工作流 v1.1:载入一张照片,用 pablodawson 的 360 Orbit LoRA 让镜头绕主体转一整圈;同一张图作首帧和尾帧,所以片段首尾相接、可循环(无声)。
**配图**
**推荐理由**
- 服务首尾帧(FL2V)环绕展示:人物定妆、服装展示、可循环的封面短片;不用写提示词,工作流自动套用 LoRA 卡片自带的提示词
- v1.1 新增“What is around them”输入框:纯色墙或影棚背景下,原来的效果像人在原地自转,写两句周围环境后镜头会有东西可“经过”,作者称在他试过的三张纯背景照片上都有效;框留空时提示词与 v1.0 相同
- v1.1 改为经 Image Crop + Rotate + Pad 载入,片段跟随照片比例,不再有 v1.0 那种可能被画进画面的白边;点 1:1 可切回 LoRA 训练用的方形(黑边或裁切)
- 默认开启 4 步 turbo LoRA,作者称比 LoRA 卡片的 28 步快约 4 倍;发布约 8 小时 115 次下载,整个模型累计 754 次下载,2 段视频 + 1 张图示例
**怎么用**
- 需要 AusBoss nodes 2.5.0 以上(ComfyUI-Manager 搜索 AusBoss,已装的先更新);模型:H3 首尾帧模型 minimax_h3_fl2va_pruned_int8_convrot(CUDA 13 以外的环境作者建议用 fp8_scaled 版)、Qwen3-VL nvfp4 文本编码器、H3 视频 VAE、360 Orbit LoRA(minimax_h3_flf2v_lora_v1)和 4 步 turbo LoRA
- 载入照片、选秒数(默认 4 秒,作者称背景比 3 秒干净)、可选填周围环境,然后 Run
- 要更高质量:关掉 turbo 行,把 Film the orbit 的步数改为 28、shift_video 改为 12(作者称约慢 4 倍);但纯背景照片建议保持 turbo,作者称 28 步时背景会发平
- 镜头转到背后又原路返回时换种子重跑
**风险与限制**
- 作者说明 360 Orbit LoRA 只用少量方形的人物短片训练,非人物主体和非方形比例都超出训练范围;照片看不到的部分(如衣服背面)会被模型编造,眨眼等小动作可能混入
- 作者转述 MiniMax H3 社区许可:适用地区不含欧盟、英国、韩国和美国,生成内容同样受限;年收入超过 2000 万美元的商业产品需 MiniMax 书面许可
- 依赖模型体积大(主模型和文本编码器都在 15 GB 以上)
## 推荐(9)
### 【A】[Minimax H3 SEED HUNTER - Latent Upscaler + Seamless Video Continuation + Speedups + Ref Mods · v2.5](https://civitai.com/models/2881362?modelVersionId=3383710)
*工作流 · 版本更新 · 作者 foxydits · 发布 10-05 03:36 · 下载 433*
foxydits 的“全家桶”电影制作工作流 v2.5:先出 3 条低分辨率预览、挑中一条再走潜空间放大定稿,集成视频续接、自定义音频、RefMods 和插帧;本版加入台词 / 声音克隆工具。
**配图**
**推荐理由**
- 服务需要反复挑种子的短片创作:先低成本抽 3 个候选再放大,避免每次都跑全分辨率;可选插帧把 24 FPS 提到 48–60
- v2.5 新增 Dialogue / Voice Clone 工具,一次生成 3 条台词读法供生成时使用,作者称开关它不需要卸载 H3;Block/Sparse attention 可分别在第一遍和第二遍开关,第一遍默认更快
- v2.5 重新排布了界面(作者称很多人嫌原版太挤),所有模型 / 节点 / LoRA 资源改为可点击链接,修复了 rgthree 开关在新版 ComfyUI 下随机开关的问题
- 第 5 个版本,整个模型累计 26510 次下载;本版发布约 11 小时 433 次下载、34 赞
**怎么用**
- 部分节点太新、ComfyUI-Manager 装不上,需手动安装:H3 Latent Upscaler 节点和放大模型(放入 latent_upscale_models,作者提醒文件改名后要在工作流里重新选一次)、Pixaroma 节点组、H3 Prompt IDE、MiniMaxH3-PromptBuilder 资源加载器、MiniMaxH3Mod(RefMods)
- 加速 LoRA:作者推荐 Kijai 的 DMAD 4 步 LoRA(FL2VA / REF2VA 通用,强度 1.0、8 步);旧的 silver turbo LoRA 强度 1.0 用 6–8 步、0.6–0.8 用 8–10 步
- 作者另推荐 Kijai 的 int8 视频 VAE 提速;Model Preview Override 预览默认关闭(作者称会拖慢生成)
**风险与限制**
- 声音克隆工具用什么模型、怎么接入,卡片里作者未说明
- 手动依赖多,上手门槛高;可见示例只有 1 段视频 + 2 张图,另有 9 个敏感级示例被隐藏
- 说明里夹带 Discord 和 Patreon(含 敏感内容 付费频道)推广链接
### 【A】[Perfect Setting \[Minima H3\] · V1](https://civitai.com/models/2982835?modelVersionId=3381506)
*LoRA · 新模型 · 作者 CitronLegacy · 发布 10-05 03:51 · 下载 121*
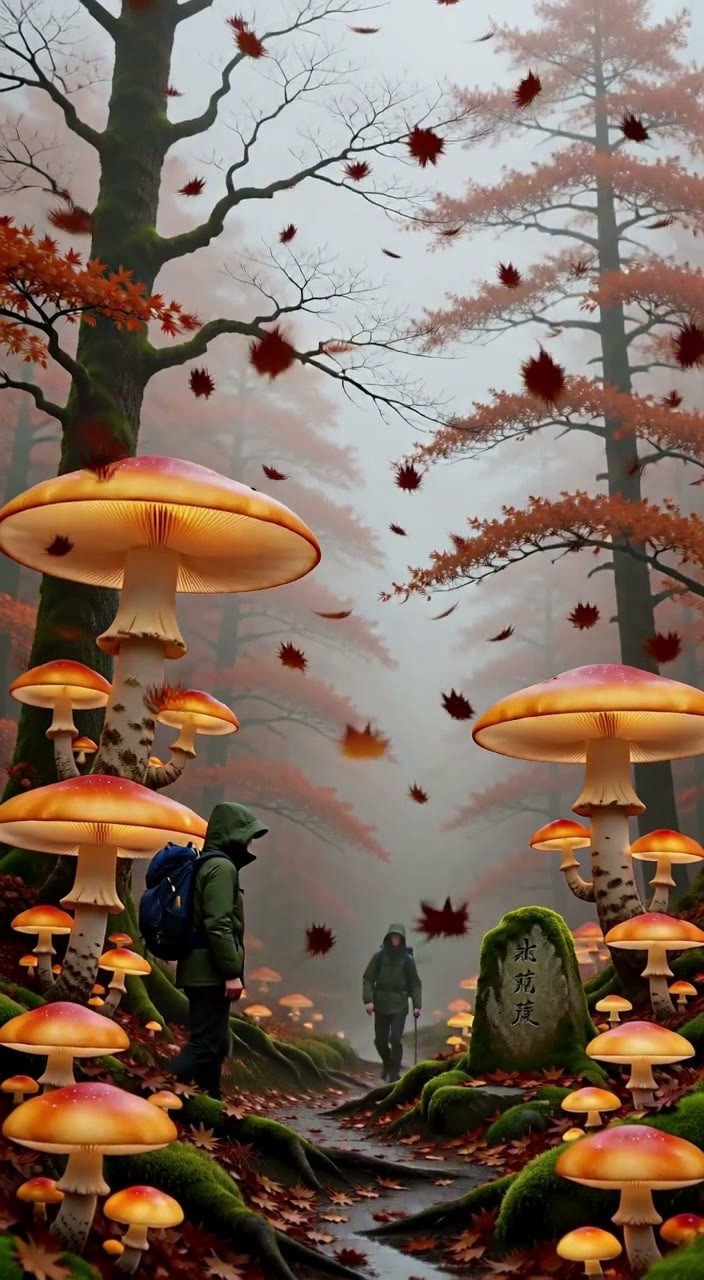
CitronLegacy 的场景 / 背景风格 LoRA:目标是用更短的提示词生成高质量的场景和背景画面。
**配图**
**推荐理由**
- 服务空镜、环境建立镜头、风景背景的文生视频;作者称用视频 + 短描述训练,把质量和风格“烘进”权重,减少堆提示词
- 16 段可见示例视频,是本期前半部分示例最多的 LoRA;发布约 11 小时 121 次下载、15 赞
**怎么用**
- 提示词开头写触发词「c1tr0nL4nd,」;作者未给强度和步数
**风险与限制**
- 说明只有两句,没说训练了哪类场景、画风偏向哪种,只能看示例判断
- 许可不允许发布衍生模型;另有 4 个敏感级示例被隐藏
**触发词**:`c1tr0nL4nd,`
### 【A】[1980s Fantasy Movies Lora · v1.0 - Minimax H3 FL2V](https://civitai.com/models/1386261?modelVersionId=3383151)
*LoRA · 移植 · 作者 neph1 · 发布 10-05 00:02 · 下载 258*
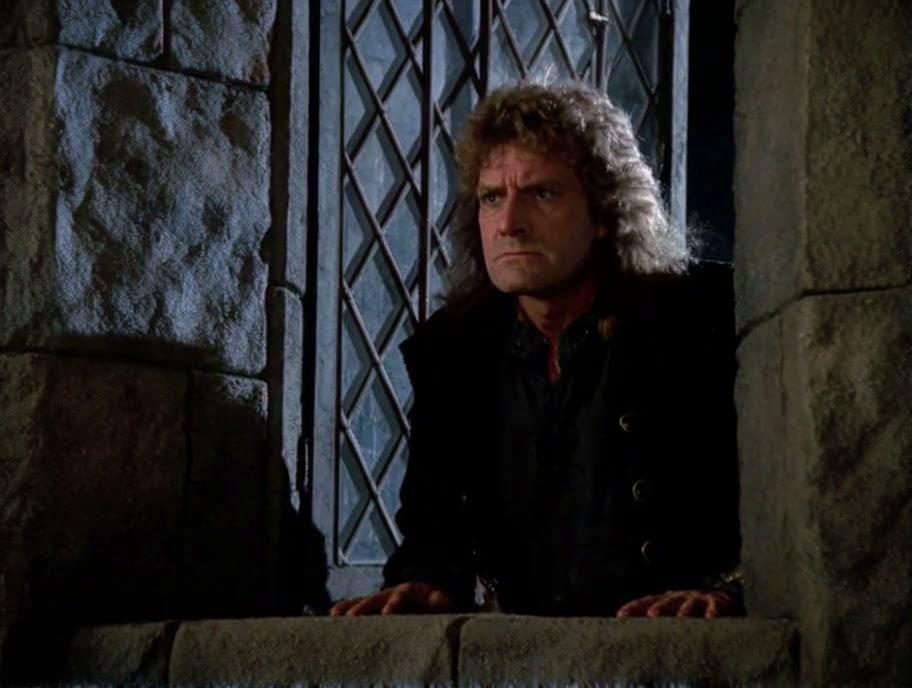
neph1 的 1980 年代奇幻电影风格 LoRA 的 H3 首尾帧(FL2V)版:复刻 80 年代奇幻片的胶片质感、布景和造型。
**配图**
**推荐理由**
- 服务复古奇幻短片(巫师、洞窟、遗迹之类);从作者的 Hunyuan Video、Wan 2.2 和 ZImageTurbo 版移植,整个模型累计 4380 次下载、14 条评论
- 作者称 H3 版是他最“手工”的一个:从最有希望的检查点回退重训直到满意,也是数据集最大的一版
- 本版发布约 15 小时 258 次下载、21 赞;2 段可见示例视频
**怎么用**
- 版本名标为 FL2V,按首尾帧工作流加载;未登记触发词
- H3 版作者未给强度和步数——卡片里的“25 步 15/10、强度 0.8”是 Wan 2.2 版的设置,不要照搬;作者给的训练集提示词样例是长段场景描述,可参照这种写法
**风险与限制**
- 旧版说明提到打斗场景容易出现肢体扭曲、高分辨率下风格变弱,H3 版是否仍有此问题作者未说明
- H3 版没有单独的使用说明;另有 5 个敏感级示例被隐藏
### 【A】[BTS Movie Set · MiniMax H3](https://civitai.com/models/2941912?modelVersionId=3383773)
*LoRA · 移植 · 作者 Solricks · 发布 10-05 05:59 · 下载 134*
“电影片场幕后花絮”概念 LoRA 的 H3 版:生成带绿幕 / 蓝幕、摄影摇臂、灯光架、剧组人员和监视器的片场画面。
**配图**
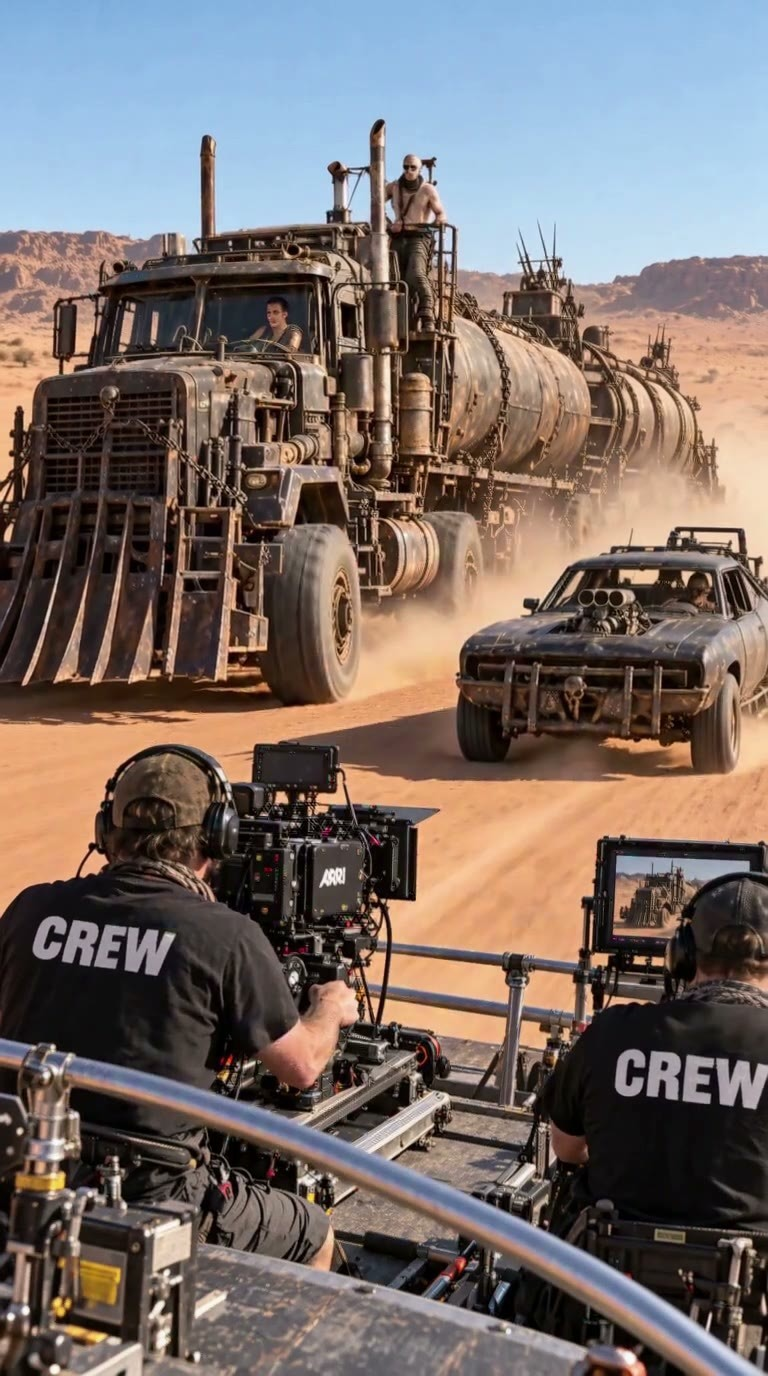
**推荐理由**
- 服务“拍摄现场”题材:幕后花絮风短片、把角色放进片场的反差镜头;作者称文生视频和图生视频都支持
- 从作者的 LTXV 2.5 版移植,整个模型累计 338 次下载;本版发布约 9 小时 134 次下载
- 参数齐:触发词、强度区间和一组辅助关键词都给了
**怎么用**
- 触发词「btssetstyle」,LoRA 强度 0.8–1.0;作者未给步数
- 作者建议加 green screen、cinematic lighting grid、camera rig、dolly tracks、movie set crew、director monitor、studio atmosphere 等关键词
**风险与限制**
- 只有 1 段可见示例视频,另有 4 个敏感级示例被隐藏
- 权重为 FP32(约 569 MB,比同类 BF16 LoRA 大一倍);许可只允许站内出租,不允许出图售卖和衍生发布
**触发词**:`btssetstyle`
### 【A】[Minimax H3 Studio | T2V | I2V | REF2V | Beginner Friendly · v1.0](https://civitai.com/models/2984640?modelVersionId=3383752)
*工作流 · 新模型 · 作者 LowQualityEnjoyer · 发布 10-05 07:00 · 下载 87*
面向新手的 H3 一体化工作流:同一张图里切换文生视频、图生视频(可加尾帧)和参考生视频(REF2V),用一个融合 turbo 模型 8 步出片,每次只输出一个视频文件。
**配图**
**推荐理由**
- 服务想少折腾的入门用户:选模式后直接排队;没素材的可选节点默认静音(灰色),用到再开
- 参数写得具体:时长 5–15 秒,分辨率不超过 0.98 MP(1344×768),日常用 0.8 MP 更快;SeedVR2 和 X2 Detail 放大 / 细化是开关,关掉即原始输出
- 作者称按 16 GB 显卡搭建并测试;发布约 8 小时 87 次下载,许可宽松(可售卖、可衍生)
**怎么用**
- T2V 只写提示词;I2V 取消 First Frame 静音,要尾帧再开 Use Last Frame;REF2V 加图片并在提示词里写 <Picture 1>、<Picture 2>,用参考视频时同时取消 Reference Video 和 Unpack Reference Video 的静音并写 <Video 1>
- 模型下载链接和所用自定义节点列在工作流内部,卡片上未写是哪个融合 turbo 模型
**风险与限制**
- 只有 1 段可见示例视频,另有 6 个敏感级示例被隐藏
- 依赖清单只在工作流里,下载前无法核对
### 【A】[MiniMax H3 LongForge FL2VA & REF2VA (LONG VIDEO) · FL2VA & REF2VA v4.7](https://civitai.com/models/2926029?modelVersionId=3384152)
*工作流 · 版本更新 · 作者 AIBOB1199 · 发布 10-05 06:36 · 下载 103*
LongForge 长视频工作流 v4.7:在一个 ComfyUI 项目里分场景生成、续接、检查接缝并导出带音频的 H3 长视频,场景之间传递视频和音频潜空间上下文以保持动作、运镜、外观和声音连贯。
**配图**
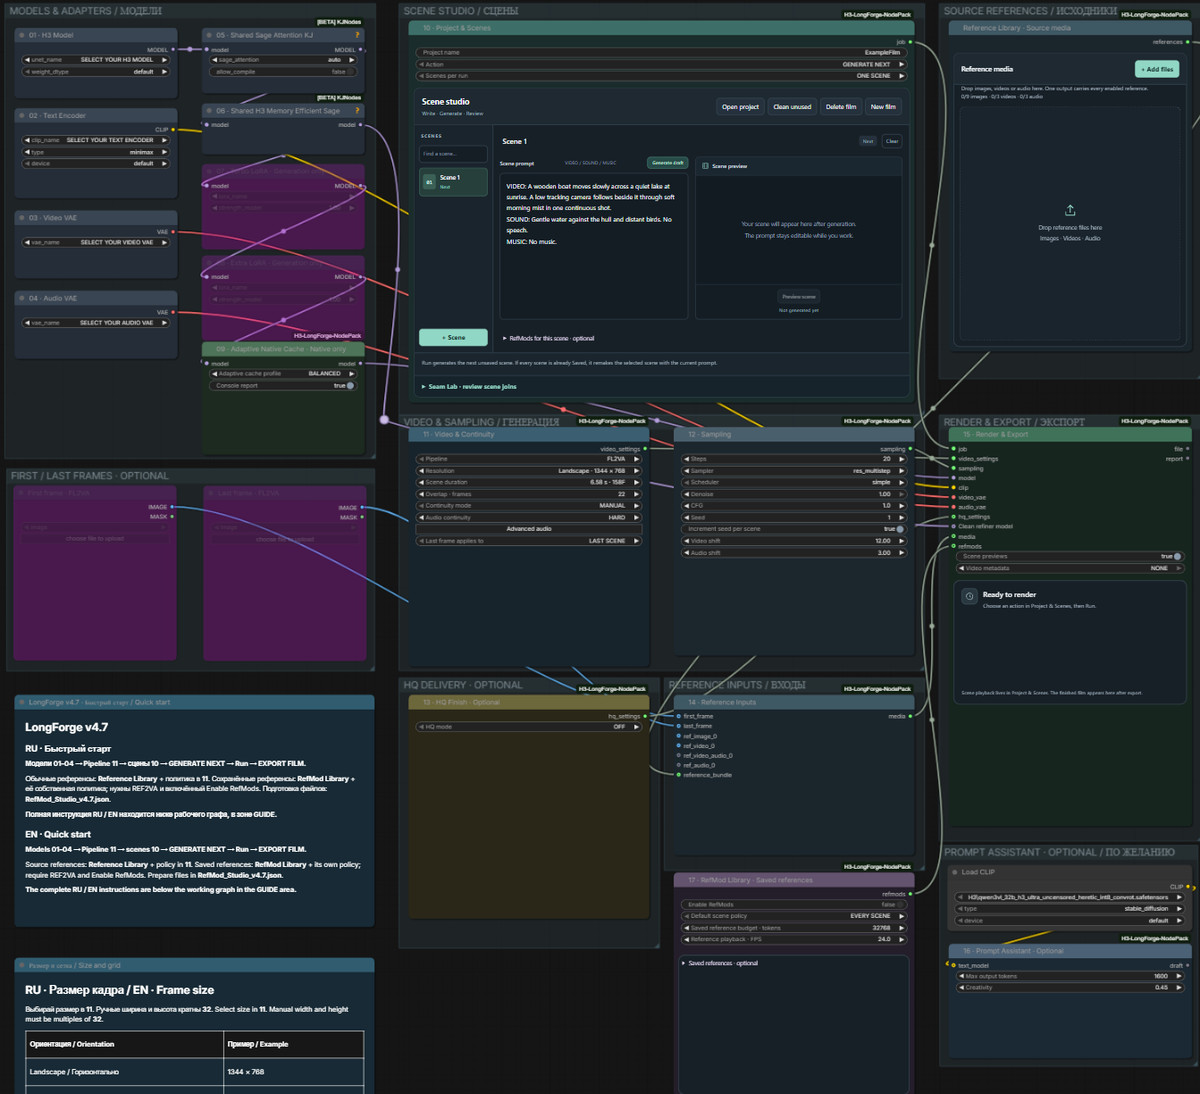
**推荐理由**
- 服务多场景长片:FL2VA / REF2VA 都支持,项目持久保存,可预览、重生成、出变体、调整待生成场景顺序;音频连续性有 OFF / HARD / SOFT 三档,SOFT 可选 100 / 200 ms 过渡
- 相比上一版 v4.0:新增 Saved RefMods(把图片 / 视频 / 音频参考存成 .safetensors 复用,不再需要单独的 RefMod 节点包)和一个统一的 RefMod Studio 工作流;可按场景选择参考;新增 Seam Lab,可循环播放、逐帧查看接缝并对比备选版本
- 其他改进:Prompt Assistant 兼容性修复、延迟的服务器回复不会再覆盖别的项目或新草稿;工作流内置俄英双语说明
- 第 7 个版本,整个模型累计 2582 次下载;本版发布约 8 小时 103 次下载
**怎么用**
- 关闭 ComfyUI,用新的 ComfyUI-H3-LongForge-NodePack 替换 custom_nodes 下的旧文件夹(保留已存项目),重启后 Ctrl+F5 刷新,打开主工作流
- 选好 H3 模型、文本编码器、视频 VAE 和音频 VAE,Pipeline 与模型匹配;给项目起名、写各场景提示词,用 GENERATE NEXT 逐场景生成,EXPORT FILM 拼片导出
- 主工作流默认 FL2VA、1344 × 768、158 帧、22 帧重叠、HARD 音频连续;用 Turbo 等少步数加速时保持 Native Cache 旁路
- 依赖:支持原生 H3 和 V3 节点 API 的 ComfyUI、FFmpeg、KJNodes、SageAttention;Gemma 4 提示词助手和 H3 潜空间放大为可选
**风险与限制**
- 版本说明栏为空,更新内容只能从模型说明的“What's new since v4.0”读到
- 没有可见示例视频,只有 2 张图(另有 4 个敏感级示例被隐藏);作者称参考保真度、提速和接缝效果取决于模型与设置
- 说明里附有加密货币打赏地址
### 【A】[MiniMax H3 Dual Segment — Split Sampler + Ultimate Upscale · v2.0](https://civitai.com/models/2984987?modelVersionId=3384166)
*工作流 · 新模型 · 作者 jorge325cabrio · 发布 10-05 06:41 · 下载 69*
面向 16 GB 显存的 H3 两段式长视频工作流:先在低分辨率跑前几步去噪、放大潜空间后再高分辨率精修,每段后接 MMH3 Ultimate Upscale,两段之间用 Motion Context 接续画面和声音。
**配图**
**推荐理由**
- 服务中端显卡上的长视频 / 高清成片:作者称在 16 GB 显存上约 42 分钟生成一段连续 40 秒的 Full HD 视频
- 两段生成在同一个工作流里完成,第 2 段可单独重试(从保存的第 1 段上下文重新生成),不用整条重跑;原生音频贯穿 Split Sampler、Motion Context 和放大三个阶段
- 多参考输入走 Deno H3 reference 节点:角色、脸、服装、场景、音频参考按顺序放进一个入口;可见控件只留提示词、参考、种子、分辨率、时长和采样设置,内部连线已折叠
- 本版 v2.0 作者称改进了音频通路;发布 8 小时 69 次下载、3 赞
**怎么用**
- 导入 minimaxH3DualSegmentSplit_v20.json,只改可见控件;作者提醒不要改动内部的采样、音频、Motion Context 和 Ultimate 连线
- 需要 Deno H3 reference 节点和 MMH3 Ultimate Upscale;完整节点 / 模型清单、步数和采样器作者未给
**风险与限制**
- 作者自称是第一个从零搭的工作流、属实验性质,速度和稳定性只在作者的 16 GB 配置上验证过
- 唯一一张示例是静态图,没有视频示例可预览成片质量
### 【A】[Minimax H3 Dasiwa Xtra - Experimental Optimizations · v1.5](https://civitai.com/models/2861921?modelVersionId=3384527)
*工作流 · 版本更新 · 作者 NegativeMeta · 发布 10-05 10:19 · 下载 25*
DaSiWa H3 工作流的扩展版 v1.5:在 T2VA / I2VA / FL2VA / REF2VA 四种模式上加了 Native / Turbo 4 / Turbo 8 一键切换、稀疏注意力、续写视频(从片段或上次保存的潜空间)、色彩迁移和多种放大后处理。
**配图**
**推荐理由**
- 相比上一版:合并原版 DaSiWa 的新结构,提示词统一交给 MiniMax H3 Director 节点(支持按顺序的图 / 视频 / 音频参考,每个参考可单独写提示);Turbo 4 / Turbo 8 会自动挑对应的 FL2VA 或 REF2VA Turbo LoRA、步数和视频 / 音频 shift
- 修正了调度器与 guider 使用的 shift 不一致的问题,作者推荐 sa_solver + simple 作为三种加速模式的起点;新增 Sparse Attention(失败时回退到 dense),Sparse 和 Spectrum 两个开关在所有加速模式下独立生效
- 续写可选“上传片段”或“直接接上次保存的 H3 音视频潜空间”:片段续写只取最后 39 帧尾部,后者免去重新解码 / 编码;Color Match 换成 Color Transfer,默认强度 0.55,可上传固定参考图防止多段续写色偏
- 说明极完整:注意力后端对照表、加速预设表、作者本地 Native / Turbo 速度对比、所需节点包和模型的目录结构都写明;整个模型累计 1749 次下载、54 赞
**怎么用**
- 导入 minimaxH3DasiwaXtra_v15.json;在 Settings 里选 Attention(作者推荐 Kitchen 起步)和 Acceleration(Native / Turbo 4 / Turbo 8);选了 Turbo 就不要在主 LoRA 加载器里再开 Turbo LoRA
- 采样建议 sa_solver + simple;续写用 Native AddGuide 时作者建议上下文从 22 帧起步
- 需要 ComfyUI-DaSiWa-Nodes、KJNodes、rgthree-comfy、Easy-Use、Spectrum-MiniMax-H3、H3-Motion-Context-MultiRef、NegativeMeta Toolbox、MiniMax H3 Latent Upscaler、MMH3-UltimateUpscale 等节点包,以及 fl2va / ref2va int8 底模、qwen3vl 文本编码器(nvfp4 版)、视频与音频 VAE
**风险与限制**
- 作者坦言:新版 Spectrum / Sparse 开关和修好的 MMH3 放大分支尚未在这个工作流文件里完整跑通验证,速度对比只是单机单场景结果
- 依赖很重(ComfyUI 需 v0.37.0 以上 + 9 个节点包 + FFmpeg);两个示例均为敏感级被隐藏,无法预览成片
- FL2VA 8 步预设用的是旧的 544p 版 Turbo LoRA,分辨率需相应设置
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
### 【A】[Disney Style - Renaissance Era · Minimax H3 - V2](https://civitai.com/models/2784600?modelVersionId=3383970)
*LoRA · 版本更新 · 作者 kermitfrog1202 · 发布 10-05 05:29 · 下载 316*
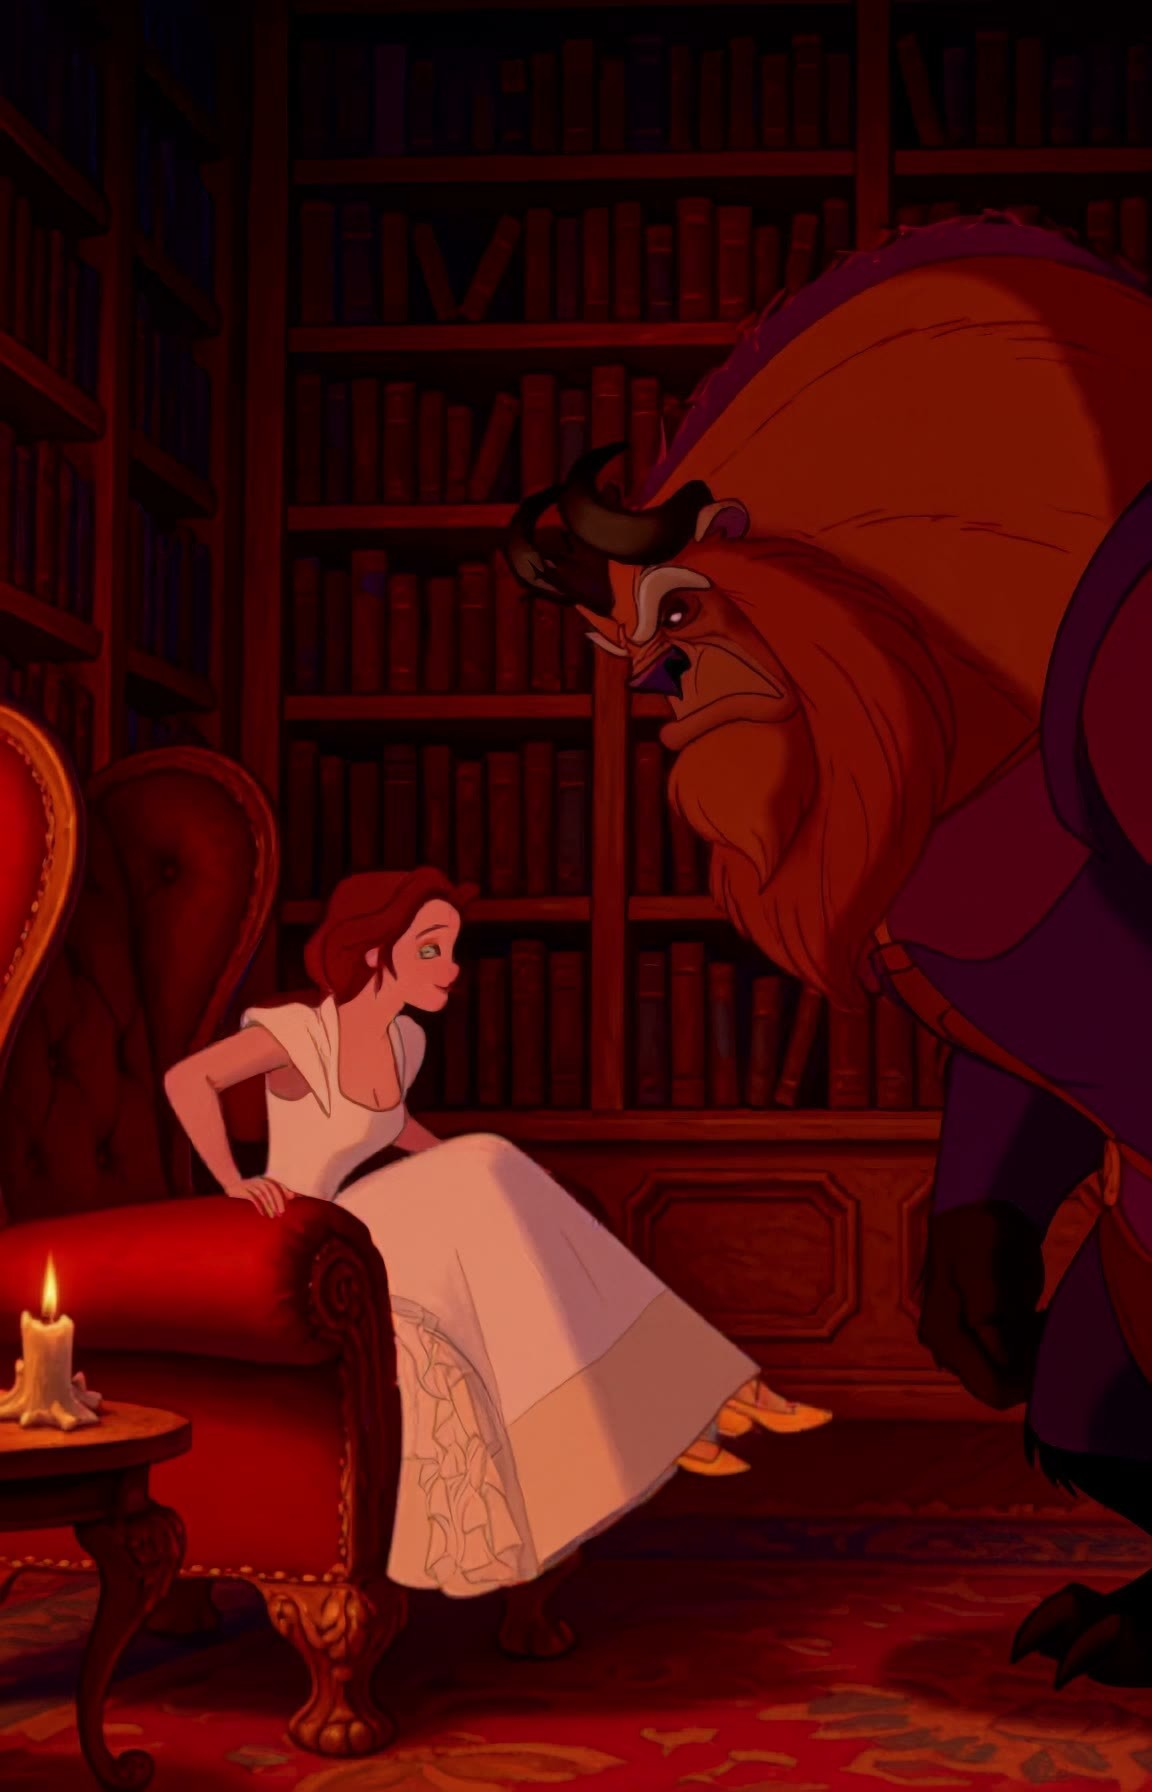
迪士尼“文艺复兴时期”手绘动画画风 LoRA 的 H3 第二版:作者在训练集里加入了视频片段。
**配图**
**推荐理由**
- 服务迪士尼文艺复兴时期风格的动画短片;本版唯一的更新说明是“训练集加入了视频片段”,这是 H3 视频 LoRA 在动态上可能改善的关键
- 同模型还有 Krea 2 版和第一个 H3 版,整个模型累计 3708 次下载、213 赞;本版发布 9 小时 316 次下载、26 赞,下载速度居本期前列
- 1 段可见竖版示例视频
**怎么用**
- 作者写的触发句「In the style of Disney animation」;H3 版未登记触发词,强度和步数作者未给
**风险与限制**
- 说明只有两行,没有强度、步数或与上一版的效果对比;另有 7 个示例被隐藏
- 迪士尼版权画风,许可不允许二创,商用只允许站内出租
## 可关注(3)
### 【B】[MiniMax H3 Keyframes with MultiGPU, Sage/Kitchen Attn, LoRAManager, Impact Wildcard Processor and DaSiWa Enhanced Video Combine · MiniMaxH3MGPUKeyframeV1.0](https://civitai.com/models/2985044?modelVersionId=3384241)
*工作流 · 新模型 · 作者 DivideBiZero · 发布 10-05 07:40 · 下载 32*
面向多显卡用户的 H3 关键帧(Keyframes)实验工作流,附一个让文本编码器留在第二张显卡上的包装节点。
**配图**
**推荐理由**
- 核心是自带的 H3 Keyframes (keep TE) 节点:原版 ComfyUI-H3-Multishot 的 Keyframes 节点编码后会把文本编码器挪到内存并清理主卡显存,在文本编码器单独放一张卡(MultiGPU / DisTorch)时会导致每次都重载模型;新节点加了 keep_text_encoder(默认开)和 vram_cleanup(默认关)两个开关,且是调用原节点而非修改,原包更新仍可生效
- 集成 LoRA Manager、H3 Multishot Sampler、MultiGPU 加载器、多种 Sage / Kitchen 注意力选项、Impact 通配符提示词、DaSiWa 视频合成;输入端有首帧、6 张参考图和 3 路音频
- 5 段可见示例视频,作者称示例里嵌有工作流
**怎么用**
- 把附带 zip 里的 H3-Keyframes-KeepTE 文件夹解压到 custom_nodes,需先装 ComfyUI-H3-Multishot
- 步数、采样器、CFG 请按所用模型的说明设;作者称不同模型档位的建议设置写在工作流的注释节点里,卡片上未给
**风险与限制**
- 作者明说不是入门、不是低显存工作流;不含放大和插帧(作者另用单独工作流);非标准模型需自己找
- 适用面窄:主要价值在多显卡配置;许可要求署名、不允许发布衍生;发布约 7 小时 32 次下载,另有 12 个敏感级示例被隐藏
### 【B】[Minimax H3 Turbo | REF2VA | FL2VA | Hybrid · turbo-4step-DH-v1](https://civitai.com/models/2929860?modelVersionId=3383490)
*LoRA · 版本更新 · 作者 Darksidewalker · 发布 10-05 02:05 · 下载 528*
Darksidewalker 的 H3 加速(turbo)LoRA 新分支:把 Kijai / Silver 的 DMAD 4 步蒸馏与 Hyperflow 融合,Rank 256,用于 4 步出片。
**配图**
**推荐理由**
- 服务想把 H3 采样压到 4 步的用户;作者称 DMAD 是画面稳定、音频尚可的新 4 步蒸馏,加入 Hyperflow 后能视场景稳定动作,并压低 DMAD 偶尔粗糙或过响的音频
- 和上一版 turbo-multistep-v2(Hyperflow + EMA 融合、4–8 步、Shift 6/3)不同,本版底子换成 DMAD,推荐 4 步、Shift 12/3
- 整个模型累计 7311 次下载、38 条评论;本版发布约 13 小时 528 次下载、40 赞,是本期前半部分下载最多的版本
**怎么用**
- 4 步(作者称可以更多),采样器 Euler + simple 或 Euler + beta,Shift 12/3;不需要触发词
- 作者称前代版本在 fl2va、i2va、ref2va 和混合(hybrid)模型上都可用,本版的模式兼容性卡片未单独说明
**风险与限制**
- 没有可见示例(唯一示例为敏感级、已隐藏),加速后的画质和音质无法预览
- 作者标为实验性融合;只提供 Rank 256 一个规格,文件比前代的低 rank 版大;许可不允许售卖
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
### 【B】[SSS Rank Minimax H3 (Smooth, Slow, Sync) · v1.0](https://civitai.com/models/2985070?modelVersionId=3384273)
*LoRA · 新模型 · 作者 Felldude · 发布 10-05 07:54 · 下载 287*
让动作变慢、变顺的 H3 运动 LoRA,并可配合输入音频做口型 / 节奏同步(SSS = Smooth、Slow、Sync)。
**配图**
**推荐理由**
- 服务动作过快、抖动的片段:作者称不用写提示词,换种子也能稳定出慢而顺的动作;不限写实 / 卡通等题材
- 作者建议配合音频输入使用,以获得同步效果
- 发布 7 小时 287 次下载、17 赞,下载速度居本期前列
**怎么用**
- 加载 LoRA 后配合音频参考输入;无触发词,强度和步数作者未给
**风险与限制**
- 作者提醒:如果没有接入音频或提示词没指明声音,大多数情况下会把成片的音频去掉
- 没有可见示例(3 个均为敏感级被隐藏),慢化效果无法预览;说明只有四行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
## 仅收录(7)
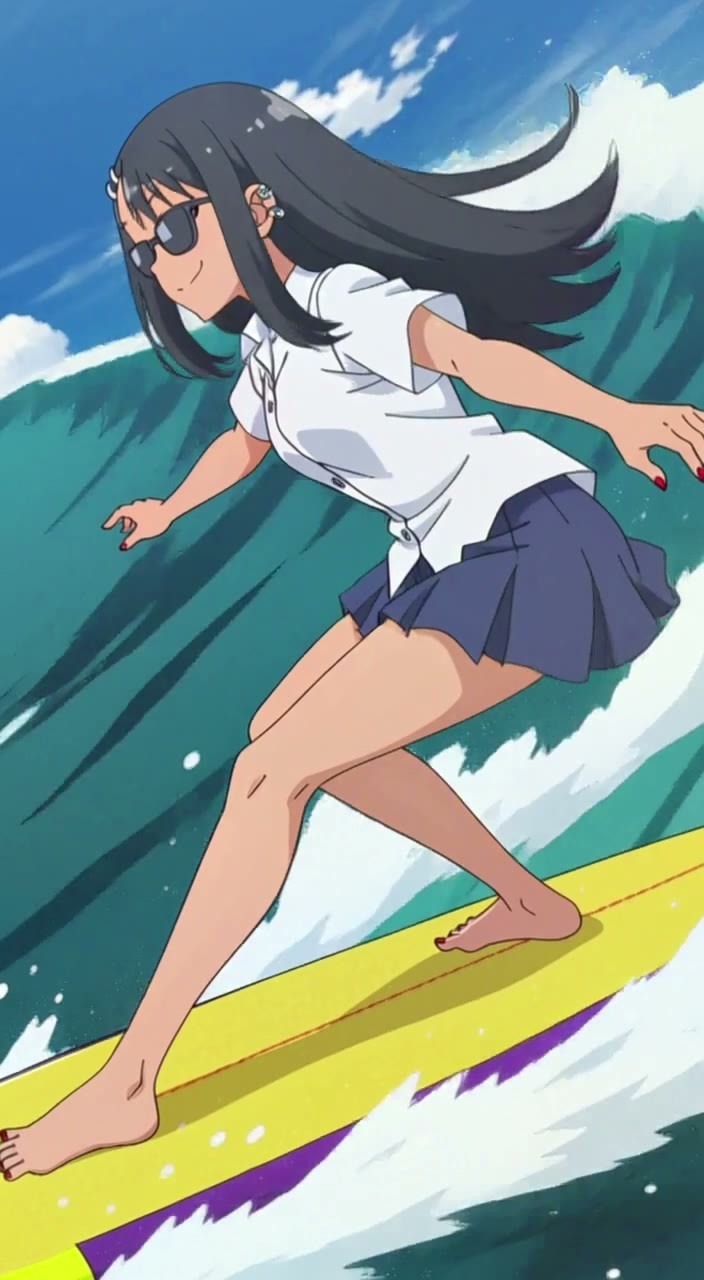
- [Nagatoro Hayase | 長瀞 早瀬 (Ijiranaide, Nagatoro-san) \[Minimax H3\] · v1.0](https://civitai.com/models/2985264?modelVersionId=3384509) — LoRA:动画《不要欺负我,长瀞同学》女主角长瀞早濑的角色 LoRA(H3 版)。
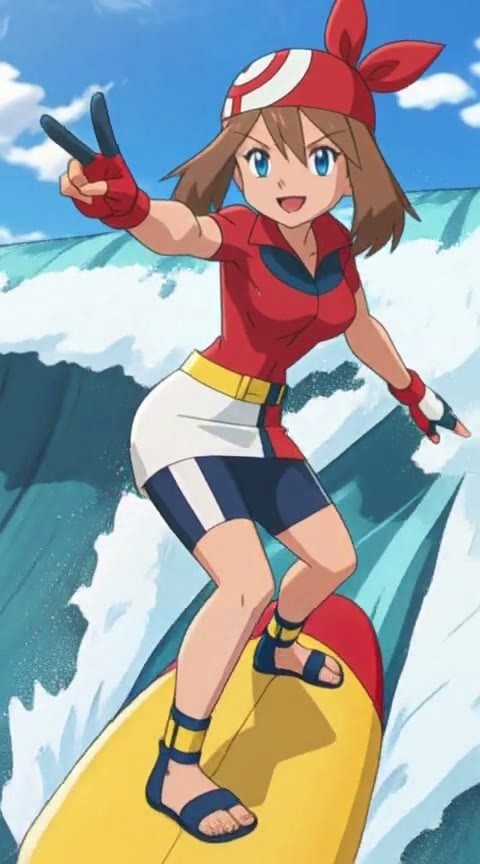
- [May: Its gonna be May | ハルカ (Pokemon) \[H3\] · v1.0](https://civitai.com/models/2985164?modelVersionId=3384388) — LoRA:《宝可梦》角色小遥(May)的动画版角色 LoRA(H3 版)。
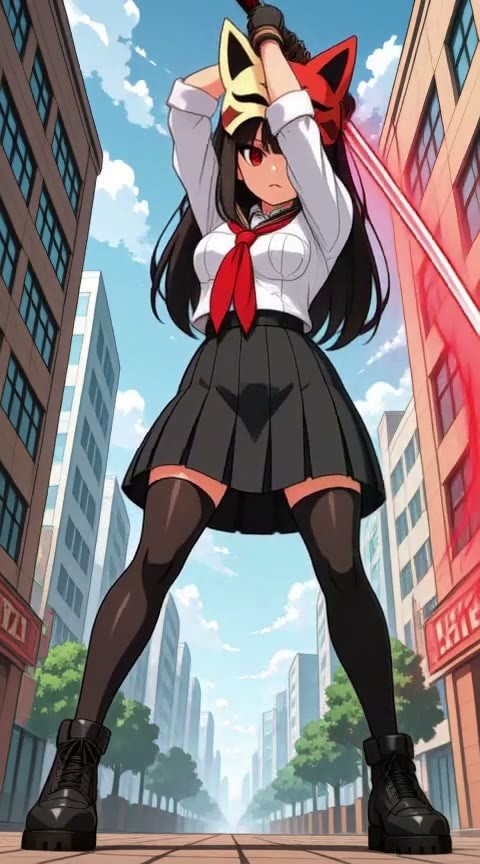
- [Buzz Me (Concept) \[H3\] · v1.0](https://civitai.com/models/2985357?modelVersionId=3384615) — LoRA:CitronLegacy 做着玩的概念 / 角色 LoRA,名字取自 Civitai 站内货币 Buzz;具体生成什么角色或效果作者未说明。
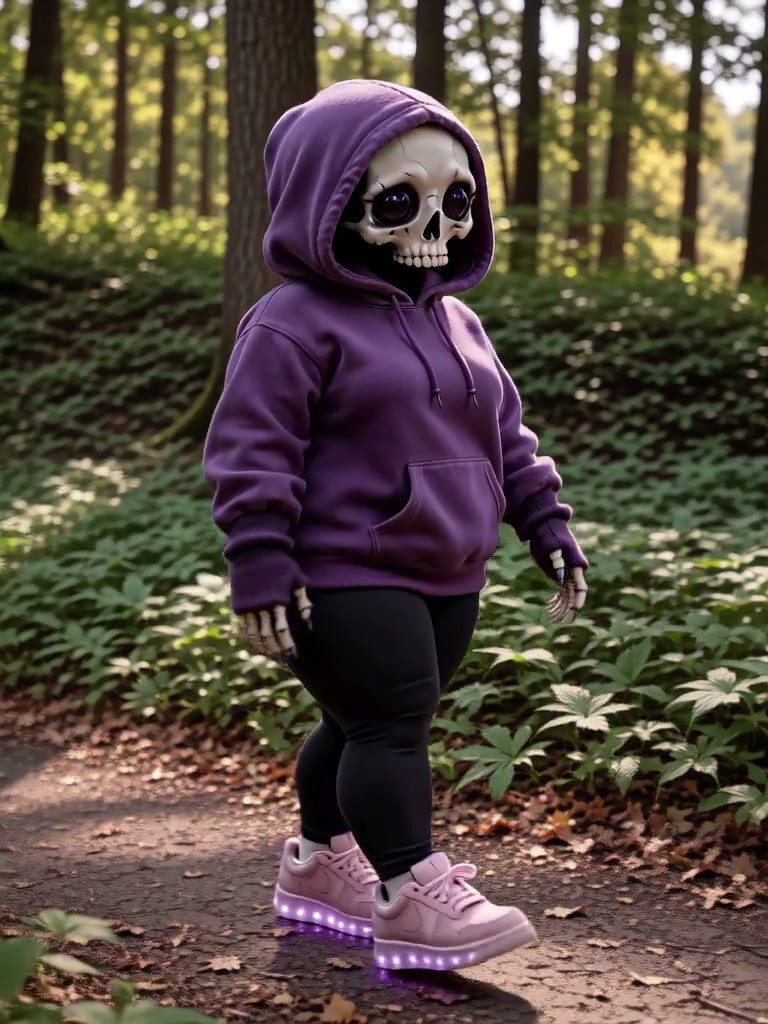
- [Thannie Franklyn · v1.0 H3](https://civitai.com/models/2980621?modelVersionId=3384102) — LoRA:原创角色 Thannie Franklyn 的 H3 角色 LoRA:一个活着的骷髅女孩,身高四英尺,爱穿超大毛衣、可爱帽子和 LED 鞋底的粉彩运动鞋。
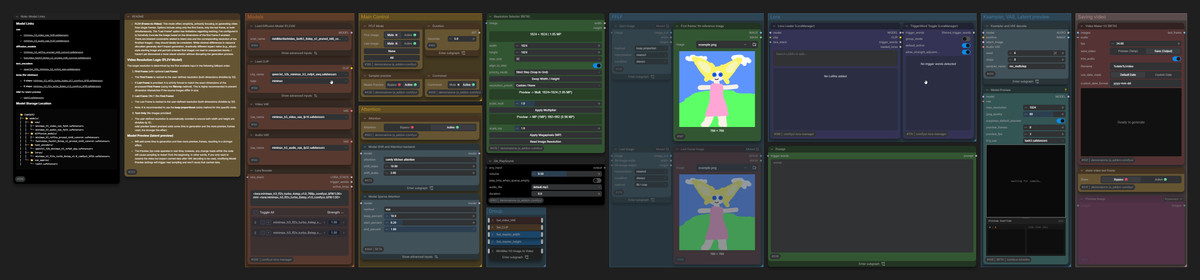
- [MiniMax-H3/Fastvideo FL2V/REF2V · v1.2 Fastvideo/only FL2VA](https://civitai.com/models/2913219?modelVersionId=3383288) — 工作流:DemonAlone 的 H3 简易工作流“只做 FL2VA(首尾帧)”分支 v1.2:本版主要是去掉 rgthree 依赖、调整注意力连线。
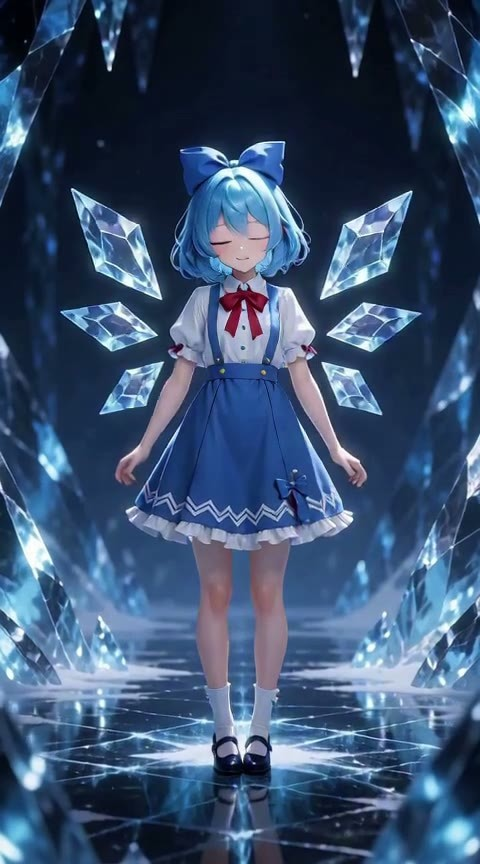
- [KreLuminA · H3-v1.1](https://civitai.com/models/2935404?modelVersionId=3382983) — LoRA:KreLuminA 半写实人物光效画风 LoRA 的 H3 版:作者用 Krea 2 生成的带高光、镜头光晕的半写实图片训练,提供 500 步和 1500 步两个权重。
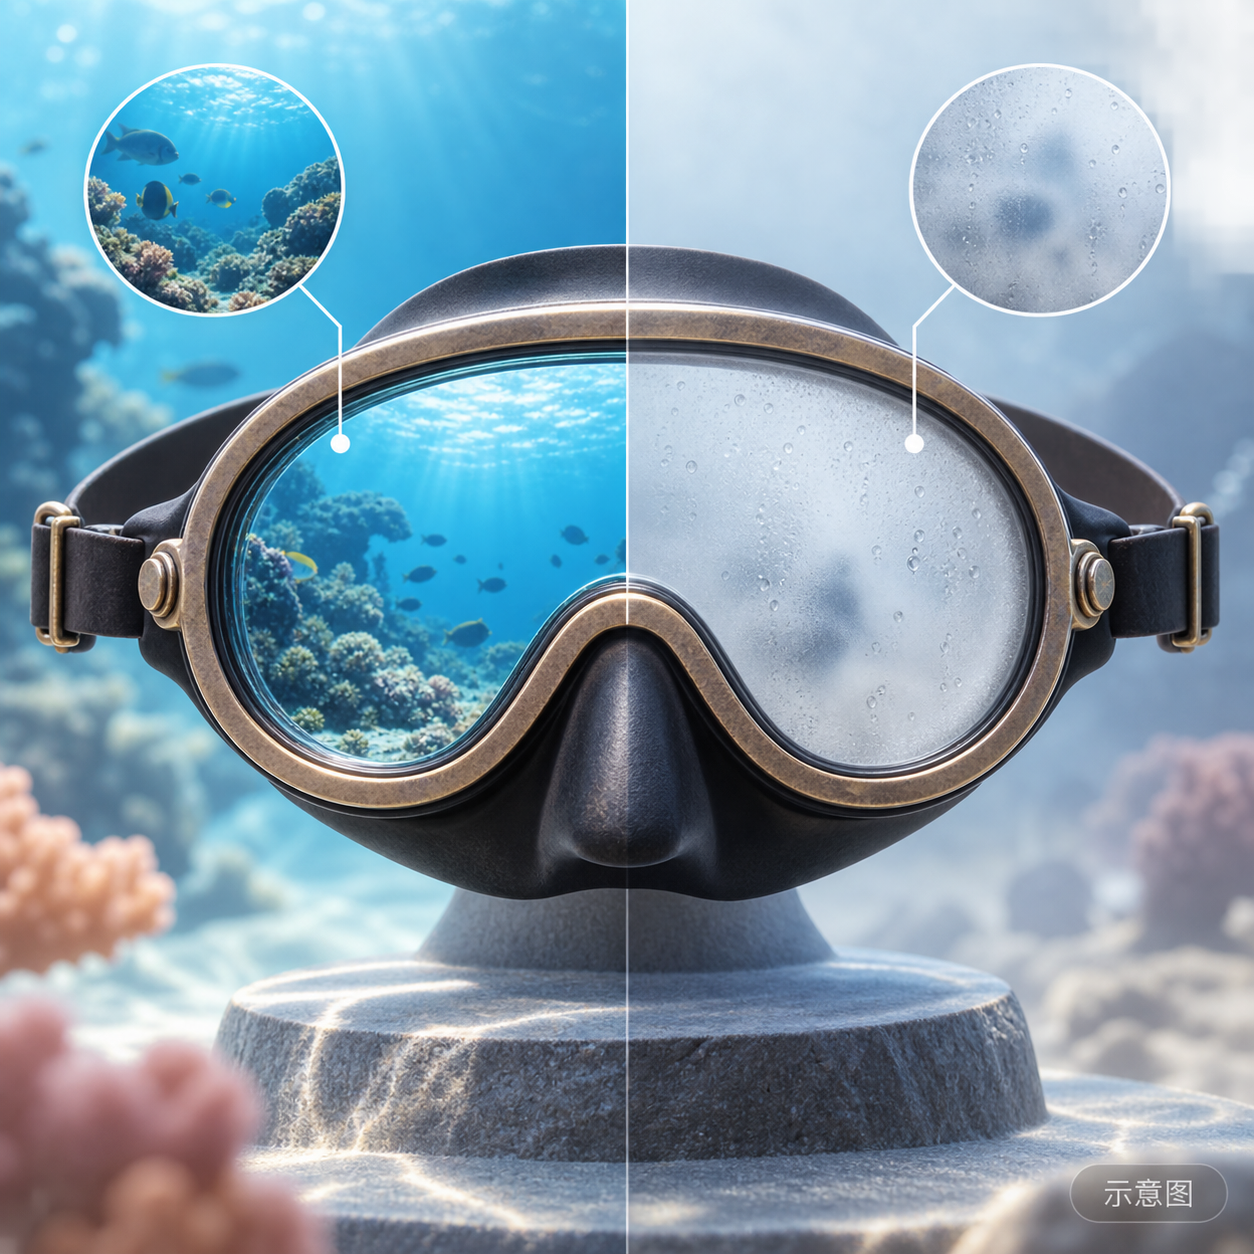
- [Oval dive mask · Oval dive mask, MinimaxH3](https://civitai.com/models/1108000?modelVersionId=3384375) — LoRA:椭圆形潜水面罩(复古单窗潜水镜)服装道具 LoRA 的 H3 版,加提示词 fogged glass 可让镜片起雾。
---
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 10-04 20:31 → 10-05 14:42(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。