MiniMax H3 晚报 2026-10-22|首推 16mm Found Footage
本期审阅 8 个 H3 新版本。首推 merkelmux292 的 16mm Found Footage:把 H3 视频变成 16 毫米黑白胶片“伪纪录片”质感(真实胶片颗粒、压暗但可读的阴影、灯光光晕、手持纪实感),触发词、分场景强度、提示词写法和编码建议都写全,由 A 升为 S。Score to Screen v6.0(YuE2 作曲 × H3 多场景 MV)新增“接续上一镜头”和主角参考图,Minimax.. simple V4 是参考生视频 + 分批延长 + 放大的工具流更新,均维持 A;FastH3-Omni 只是指向外部量化权重的工作流 JSON、作者自己说加载兼容性未验证,由 A
# 贞贞的AI雷达 · MiniMax H3 · 2026-10-22 晚报
本期 **8** 个新版本:强烈推荐 1 · 推荐 2 · 可关注 3 · 仅收录 2
> **编辑按语** 本期审阅 8 个 H3 新版本。首推 merkelmux292 的 16mm Found Footage:把 H3 视频变成 16 毫米黑白胶片“伪纪录片”质感(真实胶片颗粒、压暗但可读的阴影、灯光光晕、手持纪实感),触发词、分场景强度、提示词写法和编码建议都写全,由 A 升为 S。Score to Screen v6.0(YuE2 作曲 × H3 多场景 MV)新增“接续上一镜头”和主角参考图,Minimax.. simple V4 是参考生视频 + 分批延长 + 放大的工具流更新,均维持 A;FastH3-Omni 只是指向外部量化权重的工作流 JSON、作者自己说加载兼容性未验证,由 A 降为 B;三只眼概念 LoRA 说明只有表情符号,由 A 降为 B;Busansuji RefMod 与 a66 是常规人物 / 角色件,定 C。
## 强烈推荐(1)
### 【S】[16mm Found Footage · v1.0](https://civitai.com/models/3015094?modelVersionId=3422417)
*LoRA · 新模型 · 作者 merkelmux292 · 发布 10-22 20:51 · 下载 7*
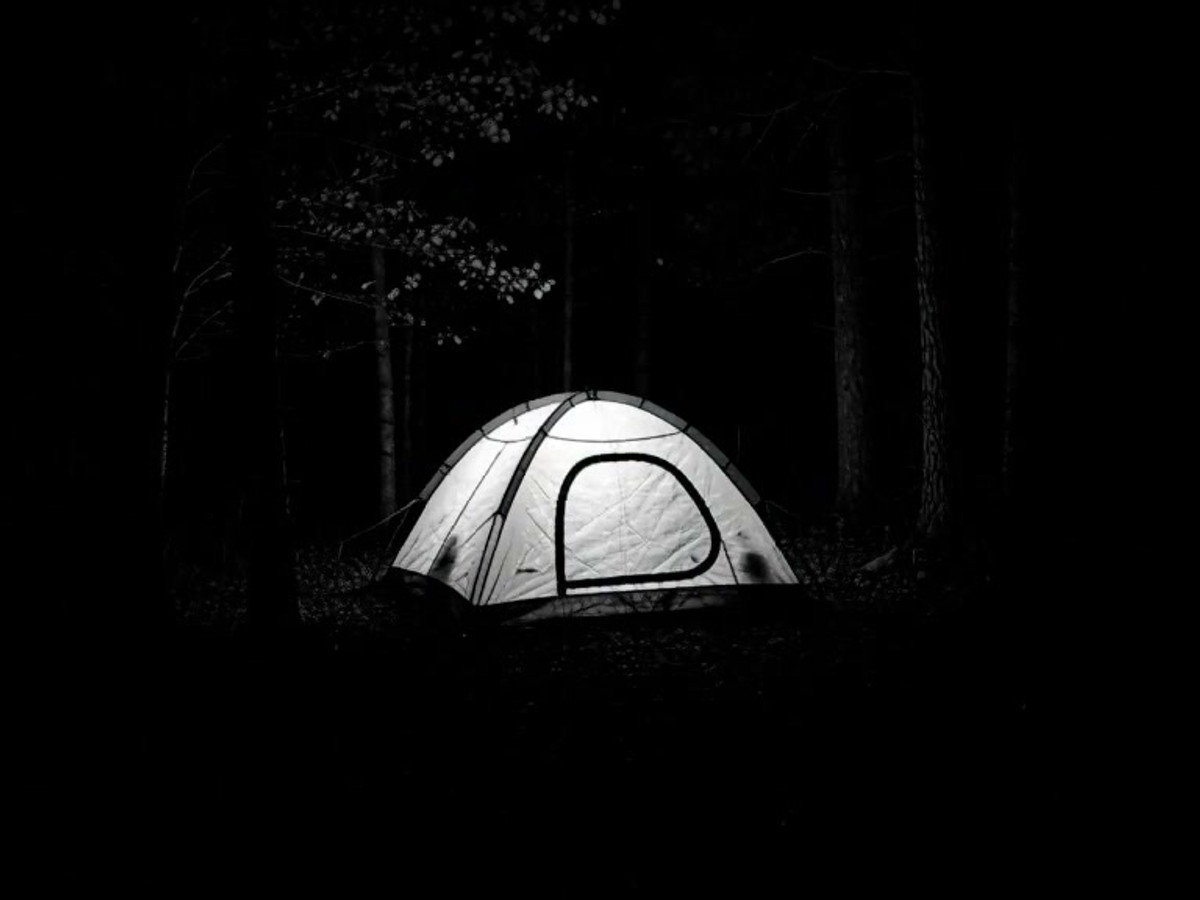
merkelmux292 的 H3 画风 LoRA:把视频渲染成 16 毫米黑白胶片拍的“伪纪录片 / 荒野探险恐怖片”质感——真实胶片颗粒、压暗但还能看清的阴影、灯光周围的光晕、四角发软、全景深无虚化。
> 由 A 升为 S:用途单一而明确,触发词、分场景强度、提示词写法、避坑和导出编码都给全,示例全部可见;唯一硬限制是不可商用。
**配图**
**推荐理由**
- 新模型:作者称颗粒不是模拟噪点,而是从真实胶片扫描里提取后移植的,会像银盐颗粒那样结团;光学上偏软(16 毫米而非数码的锐利),但保持全景深、不出背景虚化
- 服务 H3 文生视频 / 图生视频里的恐怖、悬疑、纪录片题材:夜里手电筒照亮的林间小路、内部亮着的帐篷、阴天泥泞树林、手持跟拍和低头看地面的主观镜头
- 能照做:触发词 foundfootage16 放在每条提示词开头;作者按场景给了强度(白天 / 明亮室内 0.8,夜景、手电、深黑 0.9 – 1.0),并给了 3 条完整示例提示词和推荐 / 避免的词(用 soft 16mm optics、deep focus、handheld,避开 bokeh、shallow depth of field)
- 训练信息公开:作者称是 H3 单帧模式训练,rank 16、3500 步,数据含 45 帧真实 16 毫米黑白胶片画面;只作用于画面,生成的音频不受影响
- 附 6 段视频 + 1 张图示例,全部可见;免费,发布不到 1 小时(下载数还不能说明什么)
**怎么用**
- 加载 16mm-found-footage-v1.safetensors(284 MB · FP32),提示词以 foundfootage16 开头,用自然句子描述画面而非堆关键词
- 强度:白天 / 亮室内 0.8;夜景、手电、深黑场景 0.9 – 1.0;作者称超过约 1.1 颗粒会在帧间碎裂、看起来像下毛毛雨
- 亮度写进提示词(例如“手电光照亮小路和最近的树”),不要写 brighter exposure,作者称那会压平光线衰减
- 导出时颗粒最先被编码器抹掉:作者建议 CRF ≤ 16 并加 -tune grain,或导出帧自行编码;镜头晃动没有练进去,需要另配手持 / 抖动镜头控制 LoRA;步数、CFG 作者未给
**风险与限制**
- 许可不允许任何商用(出图、出租、售卖都未勾选)
- 作者称因为用静帧训练,颗粒较重时帧与帧之间会轻微闪烁;数据集 165 张里有 120 张是合成渲染图(作者在完整模型卡里说明),题材集中在树林 / 夜景,其他场景的表现未知
- 触发词只写在说明里,Civitai 的触发词字段为空,部分前端不会自动填入
- 作者明确要求不要用它复刻可辨认的真人、真实事件或逐镜头翻拍现成影像
## 推荐(2)
### 【A】[Minimax.. simple · V4](https://civitai.com/models/2847150?modelVersionId=3421594)
*工作流 · 版本更新 · 作者 sy0ww4bb1984 · 发布 10-22 11:10 · 下载 46*
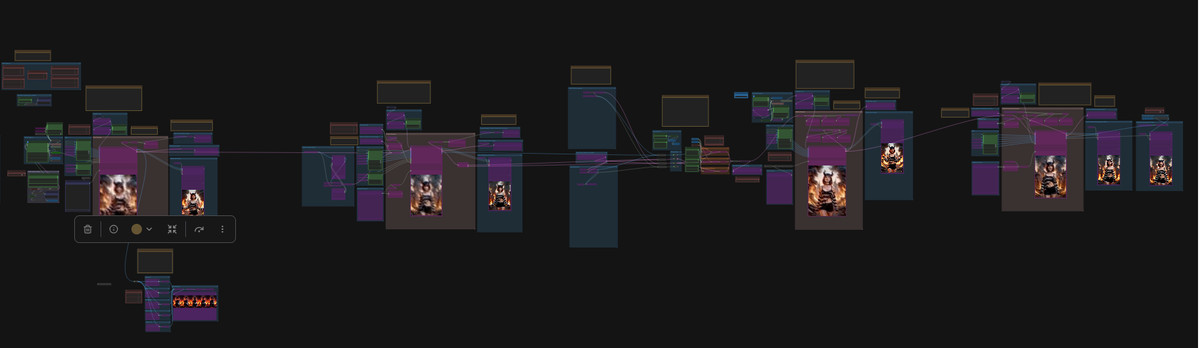
sy0ww4bb1984 的 H3 工具工作流 V4:参考图生视频 + 分批延长(音频同步)+ 分批放大,三段可串联也可单独用;本版主要是好用性改进。
> 维持 A:更新内容具体、长视频延长 + 放大的路线清楚;作者自列的已知 bug 尚未修完。
**配图**
**推荐理由**
- 版本更新(V4 相比 v3.1):恢复部分“菊花链”串联让流程能一路跑到底;只有延长超过 2 批时才需要保存 latent;放大段改为追加衔接以保持接缝;新增 Beta57 的 8 / 6 / 4 步 sigma 选项;加了总开关一键开关各段;修小 bug;补了 4 个分组的用法说明
- 服务 H3 长视频:作者称参考生视频段支持 6 张图、3 段音频参考,每一批都能单独换 LoRA、提示词、种子和参考;音频可由 H3 生成也可载入现成音乐 / 对白同步
- 放大段可以独立使用:载入任意已有视频或保存的 latent 分批放大,作者称这样配置较低的机器也能放大
- 免费、许可宽松;整个工作流已更新到第 14 个版本,累计 2479 次下载、50 赞(只代表关注度)
**怎么用**
- 解压 minimaxSimple_v4.zip(20 MB)导入 ComfyUI,按说明补齐自定义节点和 H3 模型;用总开关决定启用生成 / 延长 / 放大哪几段
- 长度按帧数而不是秒数设置,作者称工作流会自动把帧数和重叠限制在 H3 能正确处理的范围
- 低步数可选 Beta57 的 8、6、4 步 sigma;其他采样参数沿用工作流默认,作者未在本版说明里另给
**风险与限制**
- 作者在说明里列了“待修复”问题:延长分组的主渲染预览音频不对,延长子图内一个 trim 节点的除法方向需要手动改
- 依赖的节点与模型需自行核对,本工具未运行;开启预览会强制解码分段、拖慢速度
- 只有 1 张可见示例(2 个敏感级已隐藏),看不到延长 / 放大的成片效果
### 【A】[One prompt → one song → a two-scene music video (YuE2 × MiniMax H3) · v6.0](https://civitai.com/models/2975051?modelVersionId=3421468)
*工作流 · 版本更新 · 作者 koyan0418439 · 发布 10-22 09:30 · 下载 53*
koyan0418439 的“Score to Screen”ComfyUI 工作流 v6.0:一条提示词由本地 LLM 拆成歌词 / 曲风标签和分镜提示词,YuE2 作曲、H3 按歌曲生成多场景音乐视频;本版让后面的场景能直接“接着上一镜头拍”。
> 维持 A:更新内容具体(接续镜头 + 主角一致性 + 低内存),安装步骤写得细;依赖多、只有一张示例图,所以不给 S。
**配图**
**推荐理由**
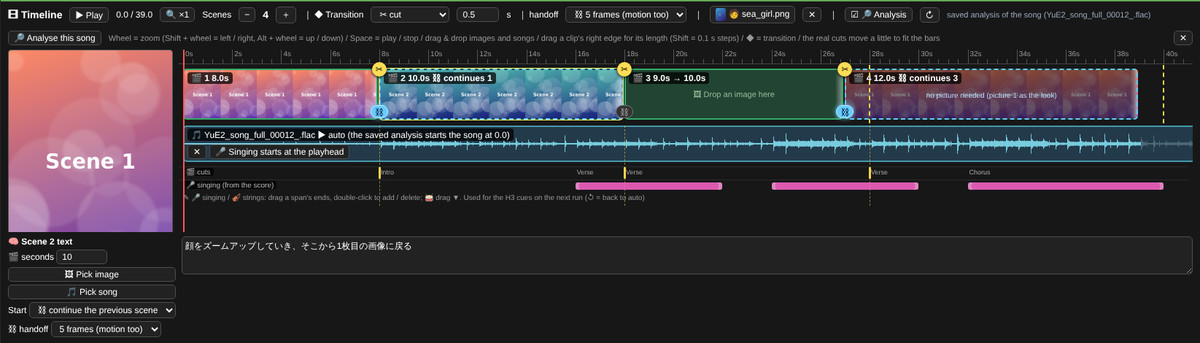
- 版本更新(相比 v5.9):场景 2–4 可选“接续”——把上一场景切点后一帧作为 H3 的首帧(H3 自带的 Add Guide),人物位置、姿势、地点和光线延续,交接可选 1 帧(默认)或 5 帧(还带上运动方向);接续的场景不需要单独的图
- 新增“主角参考图”:选一张脸、发型、服装清楚的人物图,每个场景都作为 <Picture 2> 传入并要求保持同一人物;作者建议和“接续”一起用,单靠接续多场景后脸会轻微漂移
- 降低内存:每个场景解码后立即写成文件,最后逐帧拼接成 mp4;超分在拼接时按 24 帧一批进行;交叉溶解转场现在会让上一场景在溶解时继续运动
- 服务“先有歌、再出 MV”的完整流程:作曲、歌词、对口型 / 乐器动作提示、多场景剪辑和转场都在一个工作流里;时间轴界面可拖图、拖歌、改场景时长
- 免费、许可宽松;整个工作流累计 982 次下载、47 赞、5 条评论(只代表关注度)
**怎么用**
- 解压 onePromptOneSongATwoScene_v60.zip(633 KB),把 custom_nodes/ 里的文件夹复制进 ComfyUI/custom_nodes/——作者强调这些节点 ComfyUI Manager 搜不到是正常的
- 视频保存节点要用 diodiogod 的 ComfyUI-Video-Saver(Manager 里用“Install via Git URL”装),不要装同名的纯图片版 ComfyUI-Image-Saver
- 本地 LLM:把 GGUF 放进 ComfyUI/models/LLM/ 并选中,首次运行会自动下载默认的 Qwen3-VL 视觉模型和 llama-server;也可用 Hugging Face 或 LM Studio
- 在时间轴上点每个切点下的 ⛓ 开关切换“接续 / 独立起图”,主角图用 🧑 按钮或单独分组上传;H3 采样参数沿用工作流内设置
**风险与限制**
- 依赖很重:YuE2、H3、本地 LLM、自带的若干自定义节点和外部视频保存节点都要装齐,本工具未运行
- 作者自称是个人实验、不是成品,部分功能“可能不按预期工作”
- 标题仍写“two-scene”,实际支持到 4 个场景;只有 1 张示例图,看不到成片效果
## 可关注(3)
### 【B】[FastH3-Omni · v1.0](https://civitai.com/models/3014489?modelVersionId=3421625)
*工作流 · 新模型 · 作者 realrebelai · 发布 10-22 11:36 · 下载 47*
realrebelai 发布的 FastH3 Omni 8 步参考生视频(带同步音频)ComfyUI 工作流,配套作者放在 Hugging Face 上的未剪枝 GGUF / ConvRot 量化权重;Civitai 上的文件只是 38 KB 的工作流 JSON。
> 由 A 降为 B:低显存跑 FastH3 Omni 的方向有用、安装说明详细,但真正的权重在站外、上传状态和加载兼容性作者自己都标了“未确认”。
**配图**
**推荐理由**
- 新工具:FastVideo 的 FastH3 Omni 是 H3 的 8 步蒸馏版,输入文本加按顺序编号的图片 / 视频 / 音频参考,输出带同步音频的视频;作者把完整(未剪枝)BF16 权重量化成 GGUF(Q2_K / Q3_K_S / Q4_K_M)和 INT8、W4A8 ConvRot 格式,想给显存较小的机器用
- 服务 H3 参考生视频(Ref2VA):提示词里用 <Picture 1>、<Video 1>、<Audio 1> 这类标签引用参考素材
- 参数来自上游说明:8 步、guidance 1.0,官方工作流里视频 shift 12.0、音频 shift 3.0
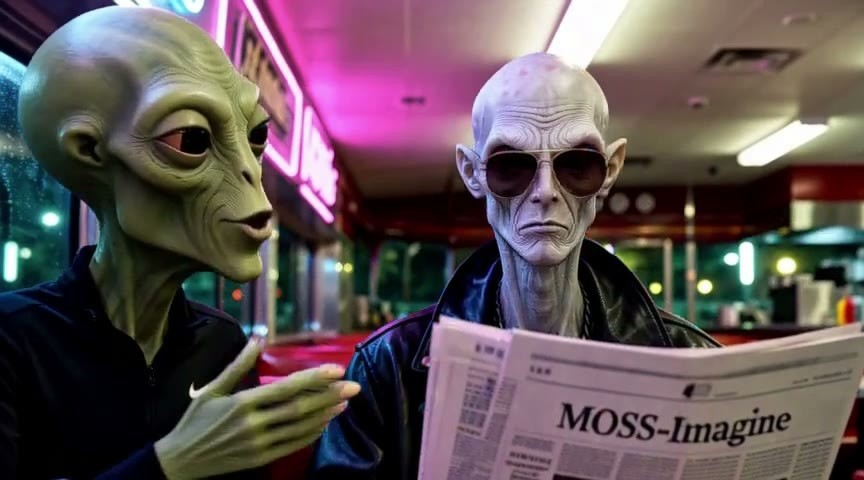
- 附 2 段视频示例;免费、许可宽松;发布约 9 小时 47 次下载(只代表关注度)
**怎么用**
- 导入 fasth3Omni_v10.json(38 KB);到作者 Hugging Face 仓库(realrebelai/FastH3-Omni_GGUFs)按显存选一种格式下载,量化权重不在 Civitai 文件里
- ConvRot safetensors 放 ComfyUI/models/diffusion_models/;GGUF 需要支持 minimax_h3 架构的 GGUF 加载器,放在加载器扫描的目录(常见是 models/unet/),不能用普通 safetensors 加载器
- 文本编码器(需带视觉能力的 Qwen3-VL)、视频 VAE、音频 VAE 不含在权重里,要从官方 FastH3 Omni ComfyUI 发布里另下;8 步、guidance 1.0、视频 shift 12.0、音频 shift 3.0
**风险与限制**
- 作者自己说明:表格是“计划的文件命名”,哪些格式真正上传了要去仓库 Files 页核对;原生加载器和 GGUF 加载器的兼容性没有被转换日志证实
- 作者给的只是权重重建误差,不是画质评测,明确说仍需与 BF16 做画面和音频对比;Q2_K 画质损失风险最大
- 作者提醒:权重文件小不代表整个生成能装进同样大小的显存,文本编码器、VAE、注意力缓存都要额外显存;按 ComfyUI 文档需较新版本(0.36.0 以上)
- Civitai 本体不是新权重;未剪枝版不一定能直接替换官方剪枝版,加载方式要自行确认
### 【B】[Triclops - three eyes - Minimax H3 · FL2VA v1.0](https://civitai.com/models/3014712?modelVersionId=3421909)
*LoRA · 新模型 · 作者 2\_as\_1 · 发布 10-22 20:10 · 下载 12*
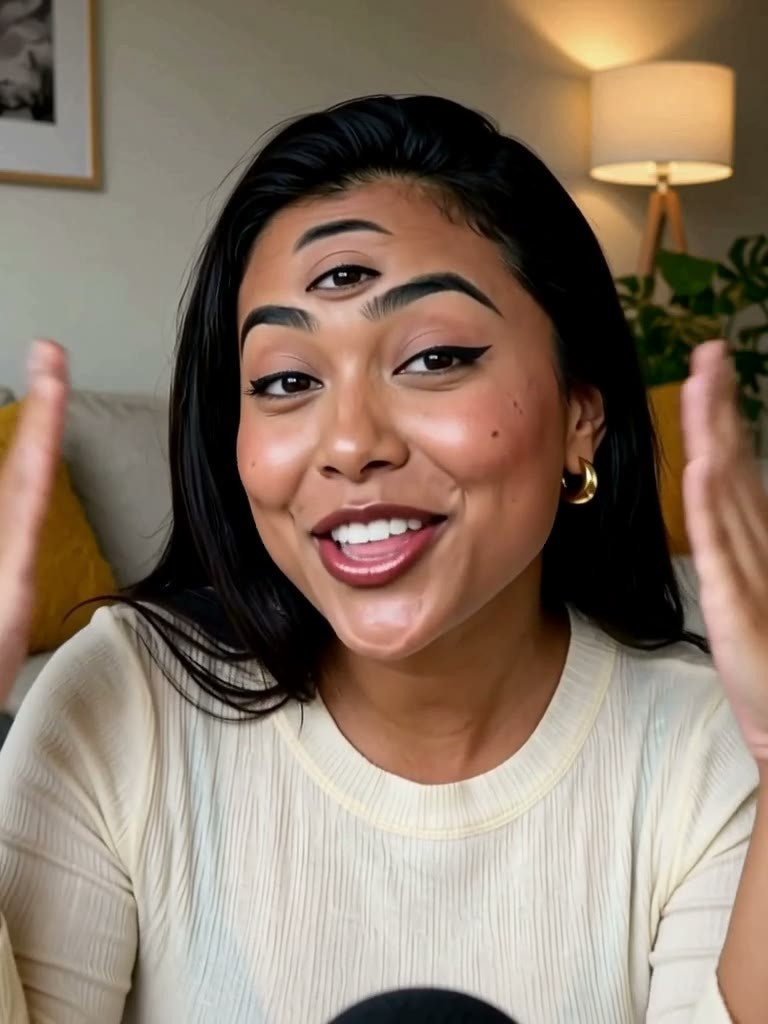
2_as_1 的“三只眼”概念 LoRA 的 H3 版:让人物额头上多出第三只眼睛,触发词 three-eyed。
> 由 A 降为 B:概念清楚、示例够看,但完全没有用法说明,用途也很窄。
**配图**
**推荐理由**
- 新模型:一个很窄的奇幻 / 怪诞概念——给角色加第三只眼;同一作者同时发了 Qwen 编辑版和 MOSS 版
- 服务 H3 视频里的奇幻生物、外星人、恐怖角色设定;版本名 FL2VA 暗示面向首尾帧生视频(带音频),但作者没有解释
- 附 6 段视频示例;免费、许可宽松
**怎么用**
- 加载 triclops-v2-minimax_h3-v3.e03000.safetensors(74 MB · BF16),提示词写触发词 three-eyed
- 强度、步数、首尾帧还是文生视频的用法作者未给,只能从示例视频反推
**风险与限制**
- 说明只有三个眼睛表情符号,没有任何文字用法
- 2 个敏感级示例已隐藏;发布不到 1 小时,下载数还不能说明什么
**触发词**:`three-eyed`
### 【B】[Underwater Sunlight Caustics & Ocean Refraction Slider (Avatar 2 Style) · v1.0](https://civitai.com/models/3014895?modelVersionId=3422144)
*LoRA · 新模型 · 作者 make676767 · 发布 10-22 17:53 · 下载 84*
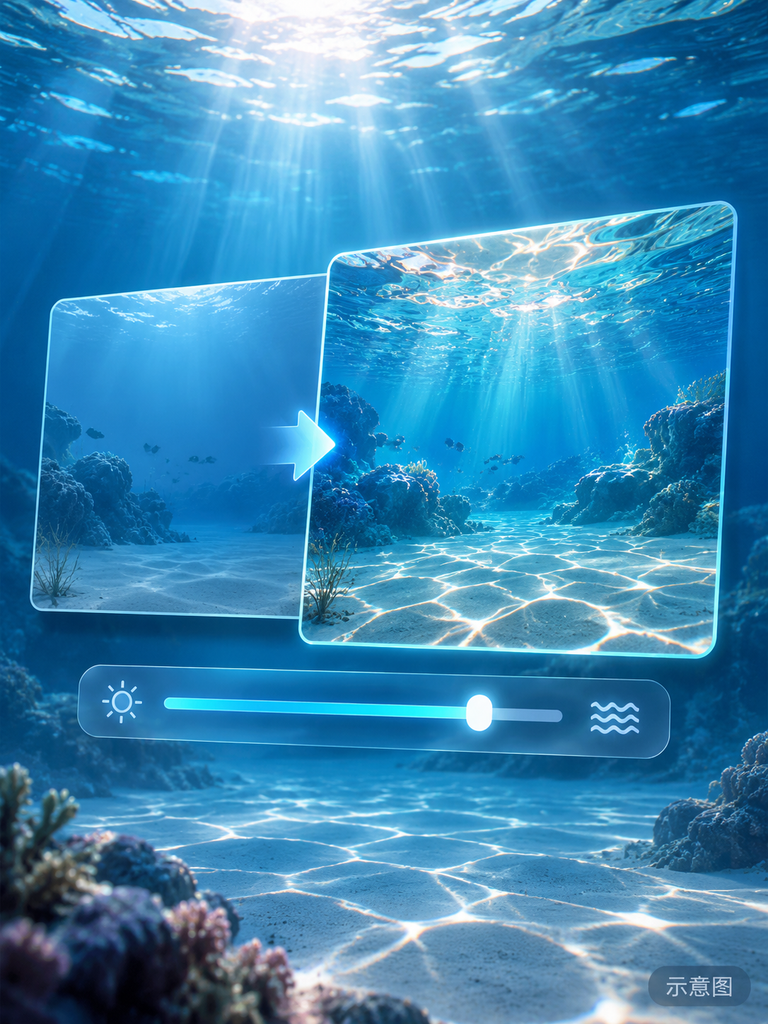
make676767 的水下“焦散光”滑杆 LoRA:正值在水下场景里加上阳光穿过水面形成的金色流动光网,打在人物湿润皮肤、海洋生物和沙底上;负值去掉光网,变成阴天或深海那种平淡浑浊的漫射光。
> 维持 B:参数和引导词都很齐,但可见示例为零,无法判断实际效果。
**配图**
**推荐理由**
- 新模型:可正可负的概念滑杆,控制的是一个具体的光学现象(水下焦散 / 折射),不改题材和人物
- 服务 H3 文生视频 / 图生视频里的海底、潟湖、珊瑚礁、潜水和出水镜头;负值方向作者建议用于深渊、暴风雨海、室内水箱
- 参数写得清楚:推荐 +2.0 ~ +3.5,可调范围 -5.0 ~ +5.0;无需触发词,作者给了正向 / 负向引导词(如 sharp dynamic underwater sunlight caustics / flat uniform diffuse underwater lighting, zero caustics)和完整的 T2V / I2V 示例提示词
- 免费;发布约 3 小时 84 次下载、9 赞,下载速度很快(只代表关注度)
**怎么用**
- 加载 underwater_caustics_slider_mmh3_v1.safetensors(7 MB · BF16),无需触发词
- 要光网:强度 +2.0 ~ +3.5,并在提示词里加正向引导词;要平淡深海:-2.0 ~ -5.0,配负向引导词
- 步数、CFG 作者未给
**风险与限制**
- 示例均为敏感级(2 个已隐藏),没有任何可见示例能确认效果
- 名称和示例提示词直接套用《阿凡达:水之道》的电影风格与角色设定,商用时注意 IP 问题;许可要求署名、不允许售卖
- 作者在完整说明里还给了日常微调档 +1.0 ~ +2.0;推荐强度偏高,与其他 LoRA 叠加时容易互相干扰
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
## 仅收录(2)
- [Busansuji Korean Woman Aesthetics H3 RefMod · v1.0](https://civitai.com/models/3014486?modelVersionId=3421623) — LoRA:2929dance 的 H3 “RefMod”(不是 LoRA):把一种韩国女性人物外貌风格(来自 ZXTOPOWER 的 Wan2.2 LoRA “Busansuji”)做成 H3 参考模块。
- [a66 · v1](https://civitai.com/models/3015049?modelVersionId=3422352) — LoRA:fanofthefate748 的角色 LoRA“a66”:说明只有名字本身,角色是谁、做什么都没写。
---
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 10-22 08:31 → 10-22 21:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。