Radar IA de Zhenzhen · MiniMax H3 · Édition du soir 2026-11-10
Cette édition présente 10 nouvelles versions : fortement recommandées 1 · recommandées 1 · à suivre 4 · incluses uniquement 4
Note de l'éditeur Cette édition examine 11 nouvelles versions de H3, dont 1 S, 1 A, 4 B et 5 C. Première recommandation : H3 Continuity Studio, un pack de nœuds pour la timeline ComfyUI qui assemble des séquences continues en une seule ligne temporelle, capable de « mémoriser » les images sélectionnées dans les segments précédents pour les intégrer aux plans suivants, avec également une intégration possible à Codex / Claude Code. La catégorie A est un LoRA vidéo réaliste offrant une vue de la Terre depuis l'orbite basse terrestre, accompagné de 2 vidéos visibles et d'exemples de prompts. Deux LoRAs CROWN pour les mains / photos spontanées au téléphone possèdent des paramètres complets mais aucun exemple visible, et la provenance des données d'entraînement est incertaine ; le curseur de vitesse du gel est payant ; deux LoRAs de doublage de personnages impliquent des voix de personnages de jeux vidéo, classés B / C ; un seul lien externe pour un LoRA d'action de combat, un modèle de base intégré int8 dont la description ne comporte que deux phrases, et deux LoRAs de personnages originaux classés C.
Fortement recommandés (1)
【S】H3 Continuity Studio - ComfyUI Timeline, Story and Visual Memory pour MiniMax H3 · v0.20.0
Workflow · Nouveau modèle · Auteur KadoBOT · Publié le 11-10 19:25 · Téléchargements 30
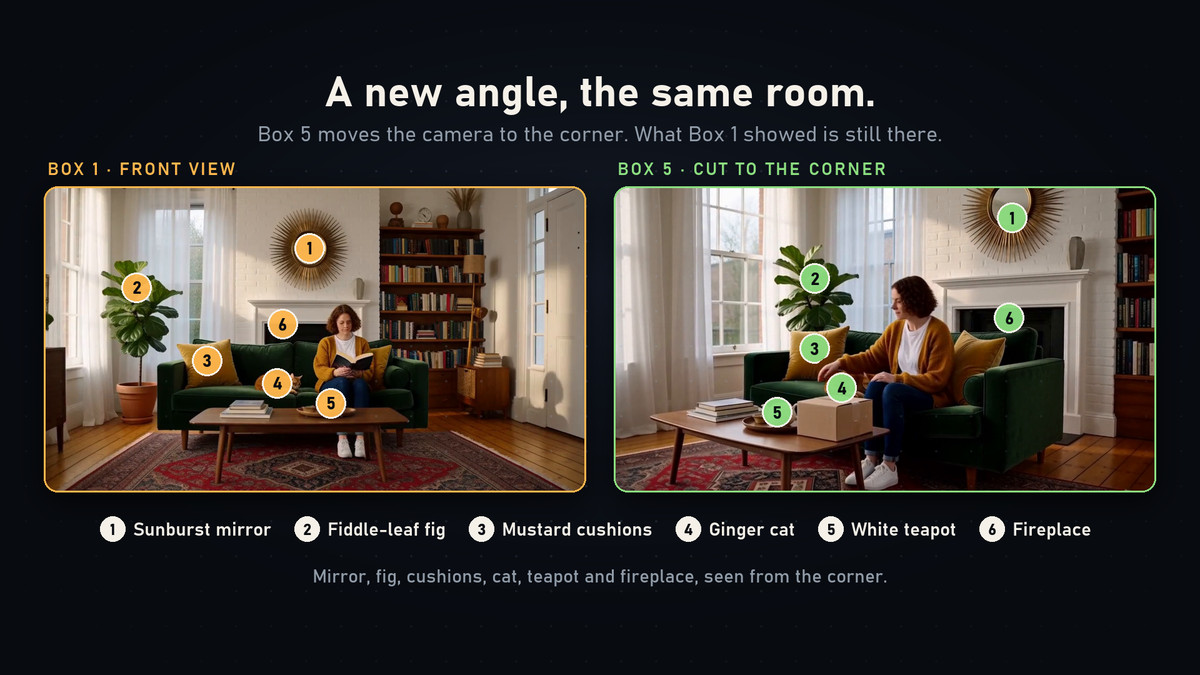
Pack de nœuds ComfyUI pour H3 : organisez les séquences via une timeline et intégrez le contexte aux segments suivants, la « mémoire visuelle » permet d'importer les images sélectionnées dans les segments précédents vers les plans ultérieurs ; inclut également des interfaces pour l'écriture de scénarios, les images de référence et l'édition de la timeline.
Il est conseillé de tester d'abord la continuité avec de courts segments, puis d'allonger la timeline une fois la transition confirmée.
Illustrations
Raisons de la recommandation
- Nouveau modèle (nouvelle page Civitai, version v0.20.0) : sert aux courts métrages multi-plans et aux scénarios continus nécessitant de maintenir la même scène et les mêmes personnages entre les plans pour la génération vidéo à partir de texte.
- L'auteur affirme que la mémoire visuelle permet de récupérer les images précédemment sélectionnées même après l'insertion d'un plan extérieur ou un changement d'angle de caméra ; H3 Story peut planifier et écrire dans la timeline via n'importe quelle interface compatible OpenAI (locale ou cloud).
- Cette version ajoute des outils MCP et des compétences H3, permettant à Codex / Claude Code de piloter Studio via un adaptateur stdio indépendant.
- Les étapes d'installation sont complètes, le code source est sous licence MIT, GitHub propose un guide utilisateur et une vidéo de démonstration ; 3 images d'exemple visibles.
Comment l'utiliser
- Décompressez dans ComfyUI/custom_nodes/ (ou clonez le dépôt GitHub), exécutez pip install -r requirements.txt avec le Python intégré à ComfyUI, redémarrez puis chargez examples/h3_story_studio.json, sélectionnez votre propre modèle H3, l'encodeur de texte et le VAE dans le chargeur.
- Dans Timeline Studio, ajoutez des segments, écrivez les prompts, rendez d'abord le premier segment, puis ajoutez un autre segment défini comme « continu » pour le rendre et vérifier la transition ; la fonction Story nécessite une configuration séparée de l'interface du modèle de langage.
- L'auteur ne fournit pas les paramètres de génération tels que le nombre d'étapes d'échantillonnage ou la résolution, cela dépend du modèle H3 et du workflow choisis.
Risques et limitations
- N'inclut pas les poids des modèles ; nécessite une version récente de ComfyUI capable d'exécuter H3, le nœud Context Windows exige une version de ComfyUI intégrant le nœud central H3 Context Windows.
- Si Story est connecté à une interface externe, il enverra le texte du scénario et (si activé) les images de référence à ce service, attention à la confidentialité et aux coûts.
- La « cohérence maintenue après changement d'angle » est une affirmation de l'auteur ; les exemples visibles sont des captures d'écran, aucune vidéo générée n'est jointe sur cette page ; nouvellement publié, nombre de likes 0.
Recommandés (1)
【A】Earth from ISS | Low Earth Orbit | Planetary view | H3 Minimax LoRA · v1
LoRA · Nouveau modèle · Auteur NOLIM_AI · Publié le 11-10 15:06 · Téléchargements 59
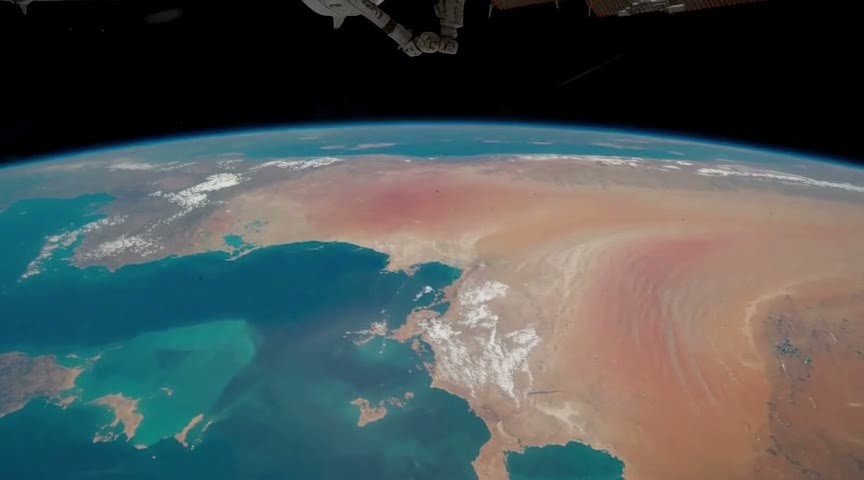
LoRA vidéo réaliste offrant une vue de la Terre depuis l'orbite basse terrestre : horizon courbe, fine couche d'atmosphère bleue, océans bleu profond, nappes de nuages et côtes désertiques, fond spatial noir, avec possibilité d'inclure des structures de vaisseau spatial dans un coin de l'image.
Peut servir pour les plans aériens d'introduction ou les transitions : courbe de la Terre avec premier plan de vaisseau spatial.
Illustrations
Raisons de la recommandation
- Nouveau modèle ; sert aux plans de la Terre depuis la Station spatiale internationale et aux plans aériens planétaires de style documentaire spatial, l'objectif de l'auteur est un rendu réaliste à la NASA plutôt qu'une planète en 3D.
- L'auteur fournit un prompt d'exemple complet (filmé depuis un satellite ou un vaisseau, horizon courbe, bras robotique du vaisseau visible en haut à droite, fond spatial noir).
- 2 vidéos d'exemple visibles.
Comment l'utiliser
- Suivez la structure du prompt d'exemple de l'auteur, décrivez en phrases longues la courbure de l'horizon, la distribution des océans et des nuages ainsi que les structures de vaisseau dans l'image ; l'auteur ne fournit pas de mot-clé déclencheur.
- L'auteur ne fournit pas l'intensité, le nombre d'étapes ni le CFG.
Risques et limitations
- La description porte principalement sur l'intention créative et le coût d'entraînement, sans aucun paramètre ; 2 exemples supplémentaires sont masqués.
- Ne couvre que ce type de vue de la Terre depuis l'orbite basse, sujet très spécifique.
À suivre (4)
【B】CROWN Perfect 5-Finger Hands, Eye Catchlights & Human Anatomy Booster | MiniMax H3 · v1.0 - True768P VideoOnly r64
LoRA · Nouveau modèle · Auteur NineCrowns · Publié le 11-10 10:21 · Téléchargements 167
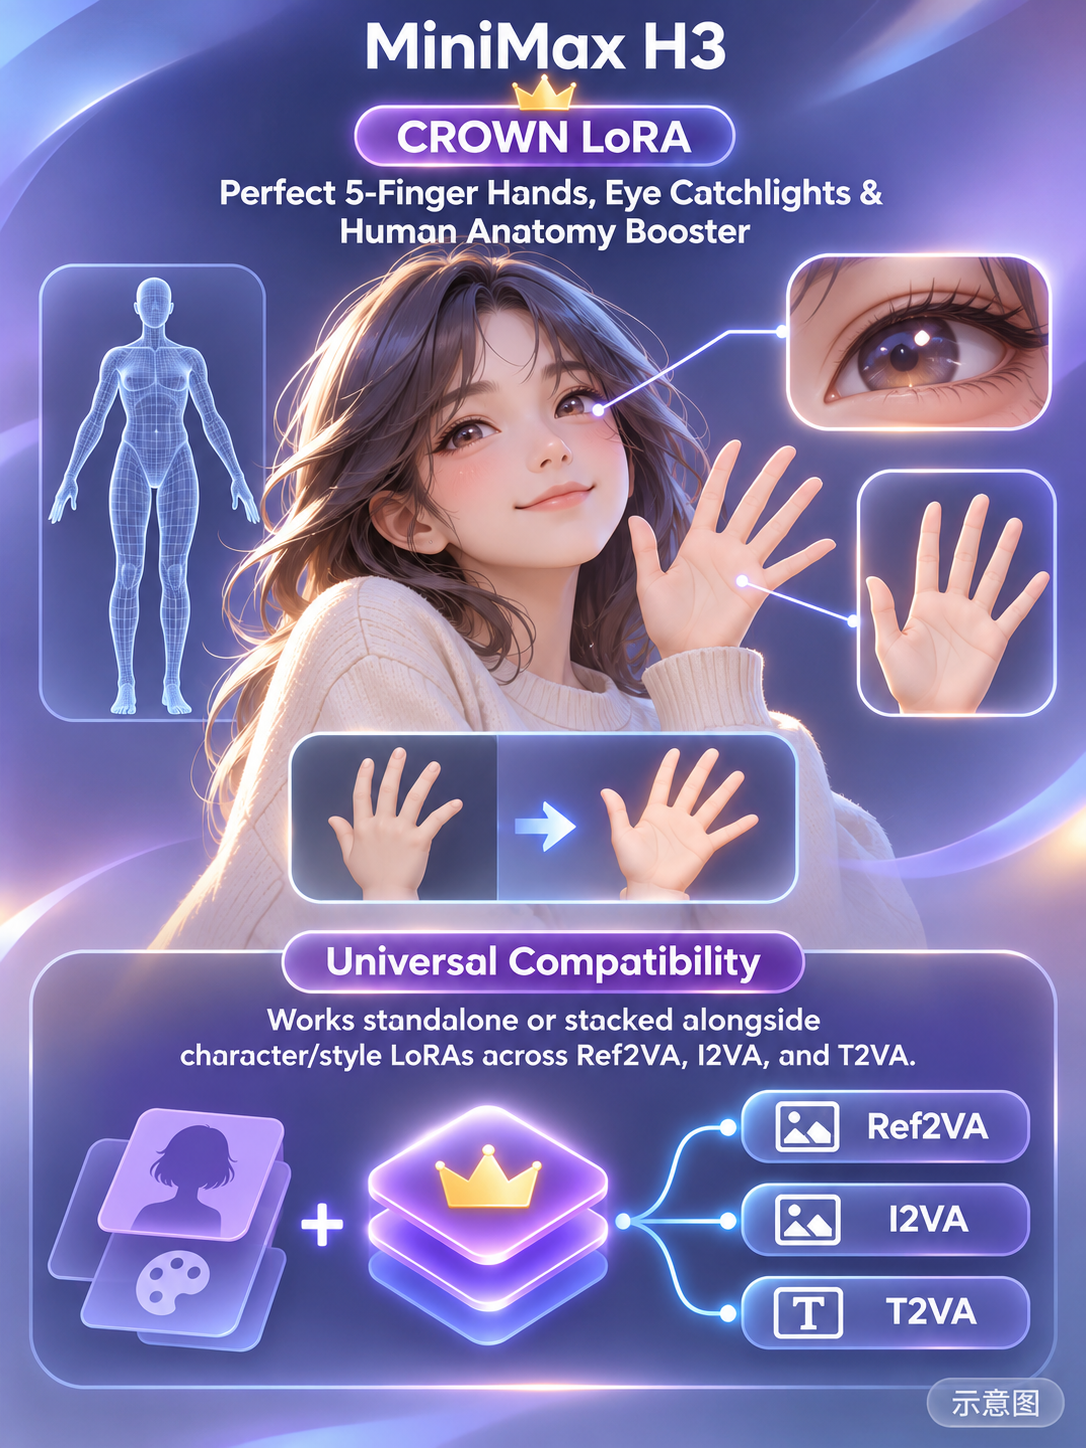
LoRA d'amélioration des détails humains : l'auteur affirme qu'il permet de maintenir cinq doigts distincts, des phalanges et des ongles nets dans les gestes rapides, tout en renforçant les reflets oculaires et le clignement naturel.
Illustrations
Raisons de la recommandation
- Nouveau modèle ; cible les traînées de mains, les doigts multiples/fusionnés et le regard terne dans les gros plans d'actions comme les danses gestuelles, les cœurs faits avec les mains, les saluts ou les visages tenus entre les mains pour H3.
- L'auteur fournit une configuration de test complète : 768×1344 (ou 1344×768), 25 étapes, euler + beta, CFG 1.0, MiniMaxH3SigmaShift (shift_video 12.0, shift_audio 3.0), intensité recommandée 0.70–0.80.
- L'auteur affirme qu'il fonctionne avec Ref2VA / I2VA / T2VA, utilisable seul ou combiné à des LoRAs de personnages ou de style.
Comment l'utiliser
- Ajoutez le mot-clé déclencheur crown_perfect_hands_eyes au prompt, intensité 0.70–0.80.
- Le modèle de base testé par l'auteur est minimax_h3_ref2va_bf16 + encodeur de texte qwen3vl_32b + VAE vidéo fp32 ; 25 étapes, euler + beta, CFG 1.0.
Risques et limitations
- Aucun exemple visible (1 masqués), l'effet de correction des mains ne peut être vérifié sur la page, tout est affirmé par l'auteur.
- L'auteur affirme que les données d'entraînement sont des vidéos réelles de danses gestuelles issues de Douyin / TikTok, la licence des données n'est pas précisée.
- L'image de la carte est un schéma généré par IA, non le résultat réel du modèle ; l'auteur ne propose aucun exemple public de niveau standard.
Mot-clé déclencheur : crown_perfect_hands_eyes
【B】CROWN InstaGirl & TikTok Raw iPhone Candid Deep-Focus Realism | MiniMax H3 · v1.0 - True768P VideoOnly r64
LoRA · Nouveau modèle · Auteur NineCrowns · Publié le 11-10 10:20 · Téléchargements 131
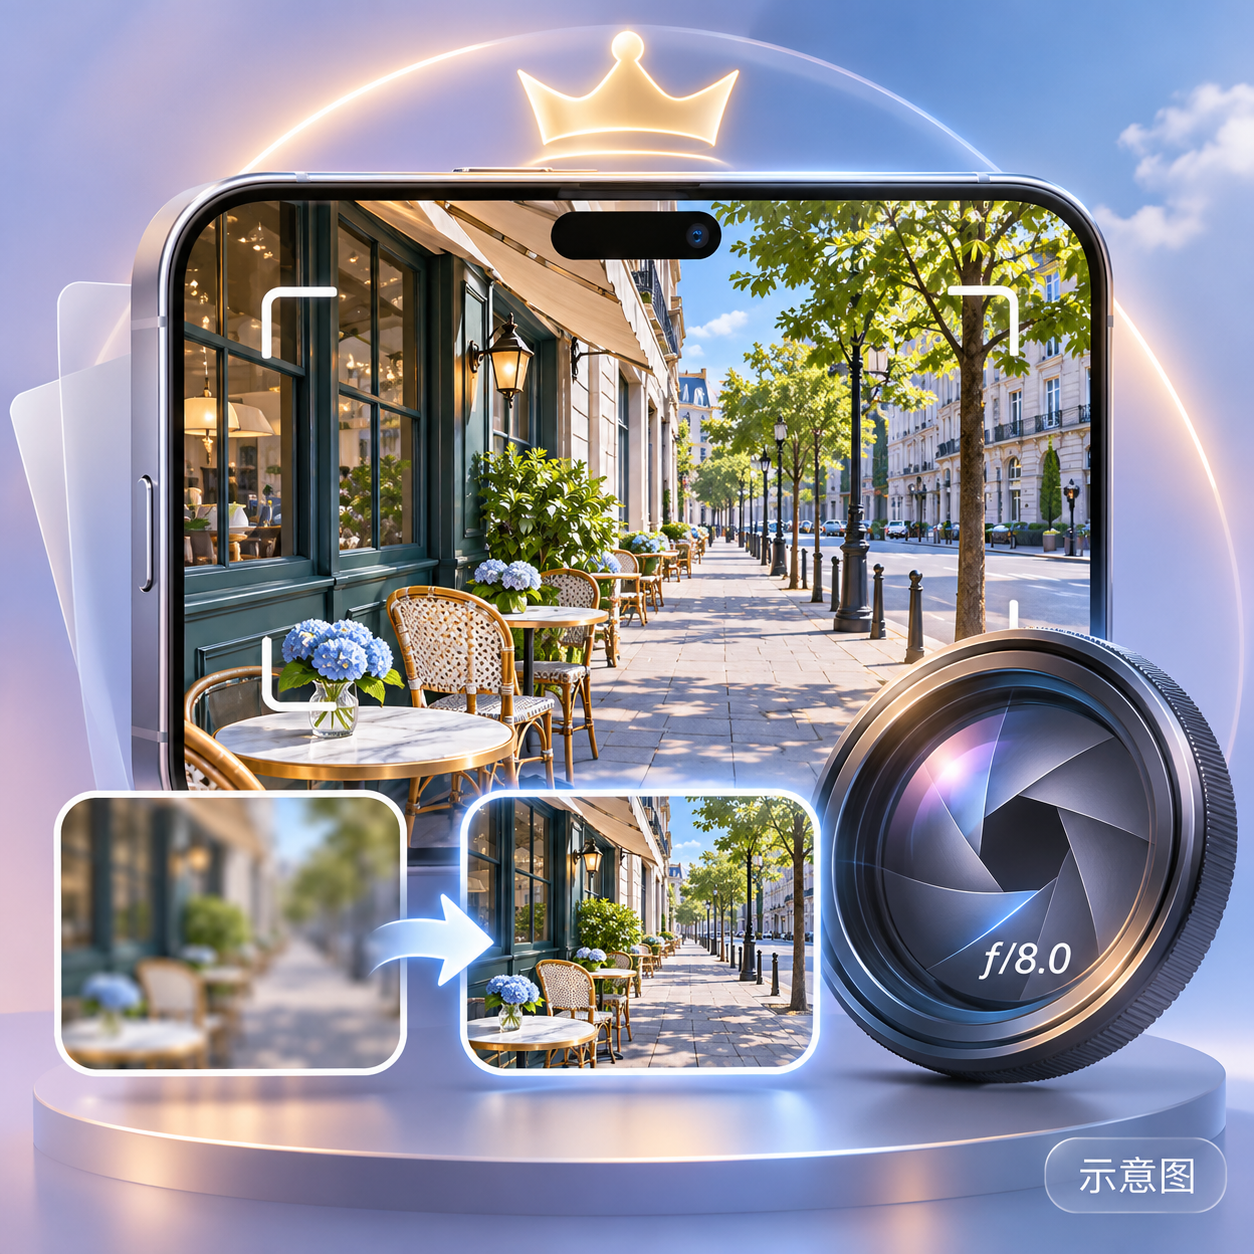
LoRA de réalisme photo spontanée au téléphone : l'auteur affirme qu'il supprime la lumière de studio par défaut de H3, la peau brillante et le flou d'arrière-plan à grande ouverture, pour adopter une profondeur de champ totale, une peau mate et une lumière naturelle de fenêtre / jour, offrant un rendu vertical de tenue décontractée.
Illustrations
Raisons de la recommandation
- Nouveau modèle ; sert aux vidéos verticales de présentation OOTD, photos spontanées en rue / intérieur nécessitant un rendu « comme pris par l'appareil photo natif du téléphone ».
- L'auteur affirme que les murs, meubles et décors urbains restent nets du début à la fin, et gère la perspective des profils à 45°.
- Les paramètres sont identiques au LoRA de mains du même auteur : 768×1344, 25 étapes, euler + beta, CFG 1.0, intensité recommandée 0.70–0.80.
Comment l'utiliser
- Ajoutez le mot-clé déclencheur crown_instagirl_real au prompt, intensité 0.70–0.80 ; fonctionne avec Ref2VA / I2VA / T2VA.
- Réglez MiniMaxH3SigmaShift sur shift_video 12.0, shift_audio 3.0.
Risques et limitations
- Aucun exemple visible (1 masqués), tous les effets sont affirmés par l'auteur.
- L'auteur affirme avoir entraîné le modèle avec des vidéos spontanées réelles de Douyin / TikTok, la licence des données n'est pas précisée ; le rendu ressemble à des photos d'influenceurs réels, attention aux usages liés au droit à l'image.
- L'image de la carte est un schéma généré par IA, non le résultat réel du modèle ; l'auteur ne propose aucun exemple public de niveau standard.
Mot-clé déclencheur : crown_instagirl_real
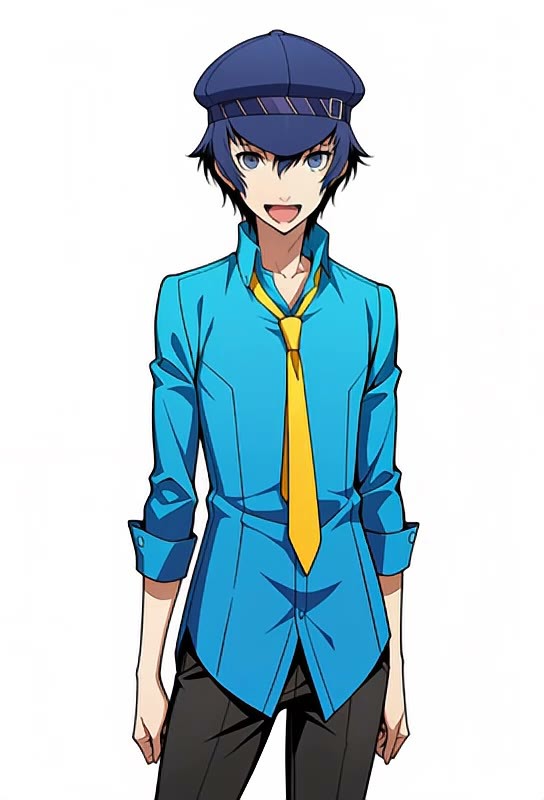
【B】Naoto Shirogane Voice - Persona 4 - Audio Only [Minimax H3] · Minimax H3 v1.0
LoRA · Nouveau modèle · Auteur OneMoreLurker · Publié le 11-10 11:13 · Téléchargements 49
LoRA de doublage audio pur : entraîné sur les voix japonaises de Naoto Shirogane dans Persona 4 Golden, permettant à H3 de générer des dialogues avec la voix de ce personnage.
Illustrations
Raisons de la recommandation
- Nouveau modèle ; sert à ajouter des dialogues en japonais avec la voix correspondante aux vidéos de personnages, l'auteur affirme que les données couvrent diverses émotions comme la timidité, la nervosité, la confiance et la joie.
- L'auteur fournit la syntaxe des sous-titres d'entraînement : Naoto says "……", les dialogues sont en japonais ; il est possible d'utiliser des dialogues en anglais, mais l'auteur estime qu'ils différeront du doublage officiel anglais.
- 3 vidéos d'exemple visibles.
Comment l'utiliser
- Écrivez le prompt au format Naoto says "<dialogue japonais>" ; l'auteur ne fournit pas le mot-clé déclencheur, l'intensité ni le nombre d'étapes.
Risques et limitations
- L'auteur admet que cette version n'a pas totalement capturé le timbre neutre du personnage, prévoyant un réentraînement ultérieur.
- Entraîné sur les doublages de personnages de jeux vidéo, la voix appartient à l'acteur original, vérifiez les droits avant toute utilisation publique ou commerciale.
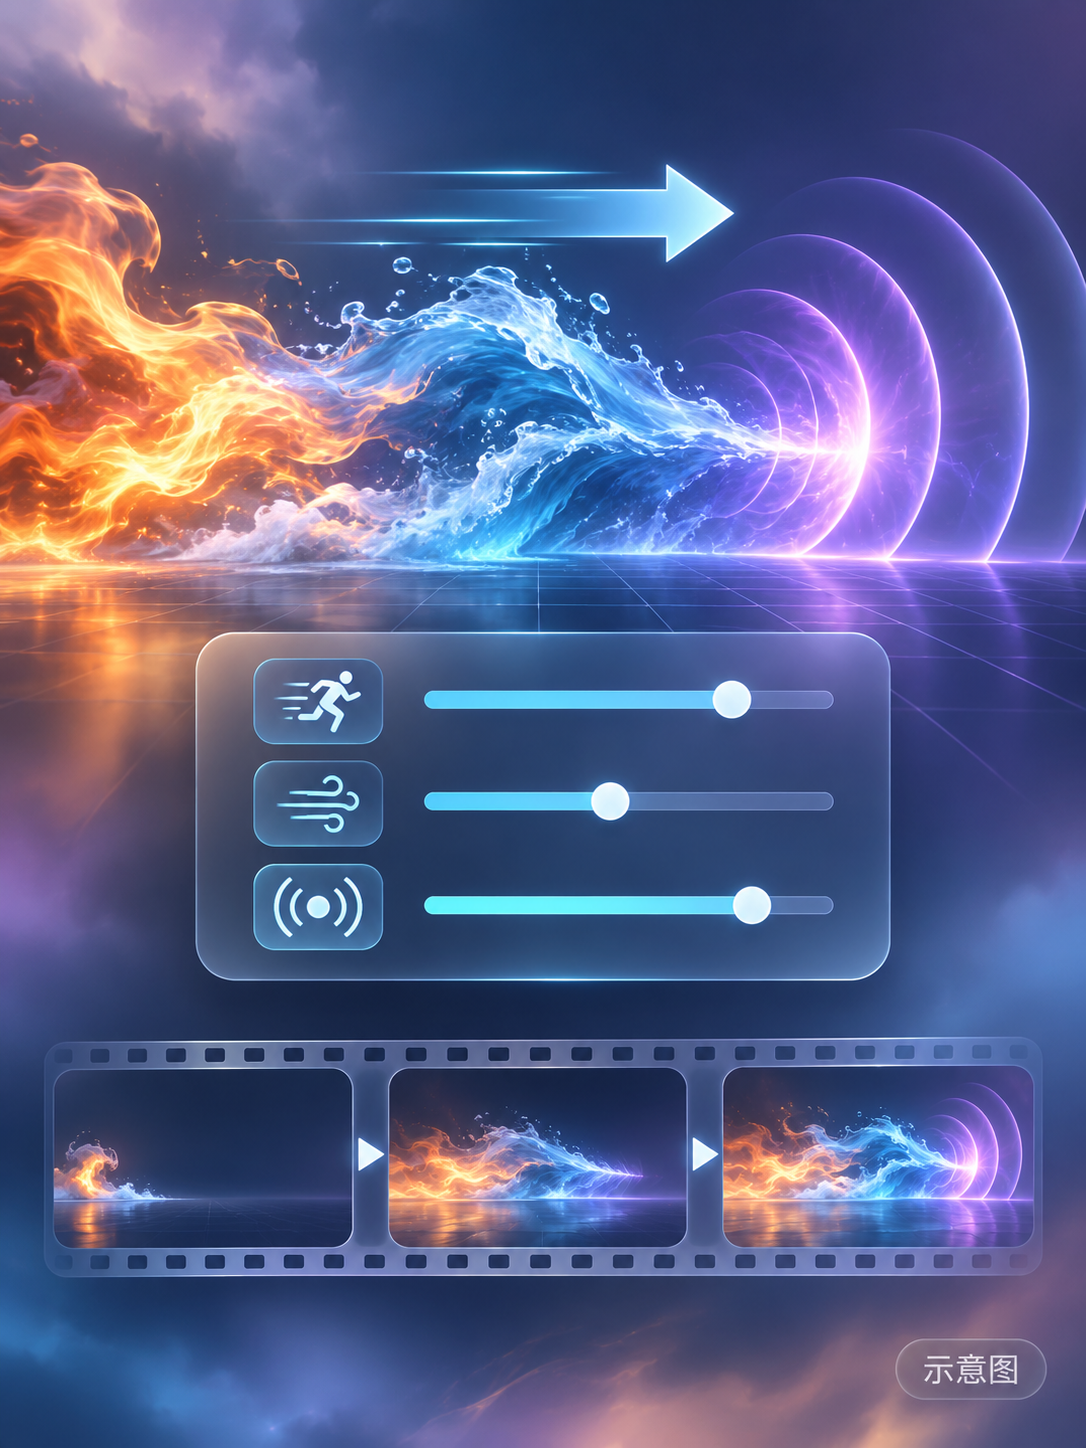
【B】KinetiX Elemental VFX Suite · KinetiX Freeze Speed
LoRA · Mise à jour de version · Auteur make676767 · Publié le 11-10 18:21 · Téléchargements 3 · Payant
LoRA de curseur de vitesse de propagation du gel : les valeurs positives accélèrent la progression du front de gel sur le sol, l'eau et les bâtiments, les valeurs négatives ralentissent la congélation ; l'auteur affirme que cela ne modifie pas la taille des cristaux de glace ni le visage, les vêtements ou la posture des personnages.
Illustrations
Raisons de la recommandation
- Mise à jour de la version (même page de kit d'effets KinetiX, la version précédente concernait le curseur de propagation des flammes) : cette version ajoute un contrôle du débit de la glace
- Les paliers d'intensité sont clairement définis : +1.0 ~ +2.0 pour une propagation rapide, +2.0 ~ +5.0 pour un gel instantané, 0 étant le réglage par défaut du modèle de base, -1.0 ~ -2.0 pour une progression lente, et -2.0 ~ -5.0 pour un gel extrêmement lent
- Trois prompts prêts à l'emploi sont fournis pour les vagues de glace au sol, le gel lent d'un château et la congélation figée en plein combat, accompagnés d'une archive compressée contenant les ressources du workflow
Comment l'utiliser
- Aucun mot-clé déclencheur n'est nécessaire ; définissez une valeur positive dans strength_model pour accélérer et une valeur négative pour ralentir, puis commencez avec les trois prompts de scène fournis par l'auteur
Risques et limitations
- Téléchargement payant ; l'exemple visible est 0 (4 sont masqués)
- Le nom de fichier indiqué dans la description ne correspond pas au nom de fichier réel
- L'image d'illustration sur la carte est générée par IA et ne représente pas le rendu réel du modèle ; l'auteur ne propose aucun exemple public de niveau standard
Inclus uniquement (4)
- KinetiX Combat Semantic Bridge (MiniMax-H3) · v1.0 — LoRA : un LoRA d'action H3 nommé « Pont sémantique de combat ». D'après son nom et le titre du lien externe, il est destiné à ajouter des mouvements de combat réalistes aux scènes de bagarre, mais la page du modèle ne fournit aucune explication.
- Kasumi Yoshizawa Voice - Persona 5 - Audio Only [Minimax H3] · Minimax H3 v2.0 — LoRA : deuxième version du LoRA de doublage japonais pour Kasumi Yoshizawa dans « Persona 5 Royal ». L'auteur indique avoir réduit le bruit de fond « sifflant » de V1.
- Dr. Octavia Incirrina M.D. · v1.0 H3 — LoRA : un LoRA de personnage original créé par l'auteur, représentant une médecin pieuvre, porté depuis la version Krea 2 vers H3 ; la description est presque entièrement consacrée à l'histoire du personnage.
- minimax_h3-tyc-zs05-ltxqnorm-int8-convrot · v1.0 — UNet : un modèle de base ComfyUI int8 en fichier unique. L'auteur affirme être parti des poids officiels H3 BF16, avoir effectué des modifications, puis quantifié le tout en une seule fois, sans mélanger de modèles de base intégrés tiers.
Données : API publique Civitai (modèle de base MiniMax H3), période d'inclusion du 11-10 08:31 au 11-10 21:01 (heure de Pékin). Les recommandations ont été revues par la rédaction ; le nombre de téléchargements reflète uniquement l'attention portée.