Radar IA de Zhenzhen · Qwen Image 2.1 · 2026-11-02 Bulletin du matin
Cette édition présente 3 nouvelles versions : fortement recommandé 0 · recommandé 0 · à suivre 2 · inclus uniquement 1
Note de l'éditeur Examen de 3 nouvelles versions de Qwen 2.1 dans cette édition ; parmi elles, deux workflows AIKSK portaient uniquement l'étiquette de modèle de base « Qwen », mais leur nom et les fichiers de modèle utilisés étaient bien 2.1, confirmant leur inclusion. En tête : le transfert de pose universel de CafeAVA : deux workflows d'édition multi-images permettant d'intégrer des personnages dans des poses individuelles ou à deux, à partir d'une image de pose et d'une à deux images de personnage. La documentation des prompts est très complète, mais aucun exemple visuel n'est disponible, d'où la note B maintenue. Le workflow de fusion de composition produit d'AIKSK détaille clairement deux approches : une haute qualité en 40 étapes et une rapide en 20+6 étapes, passant ainsi de C à B ; le workflow de pose Pose Studio du même auteur chevauche le transfert de pose et utilise une version plus ancienne du LoRA de pose, restant donc à C.
À suivre (2)
【B】CafeAVA | Transfert de pose universel pour Qwen Image 2.1 · v1.0
Workflow · Nouveau modèle · Auteur omidtj · Publié le 11-02 06:35 · Téléchargements 33
Deux workflows ComfyUI d'édition multi-images pour Qwen Image 2.1 : fournissez une référence de pose (image de pose ou photo) et une à deux images de personnage pour intégrer les personnages dans des poses individuelles ou à deux.
Note B maintenue : l'utilisation et la rédaction des prompts sont les plus complètes de cette édition, mais il n'y a pas d'exemples visuels et le workflow dépend d'un LoRA de pose externe et de sources d'images de pose.
Illustration
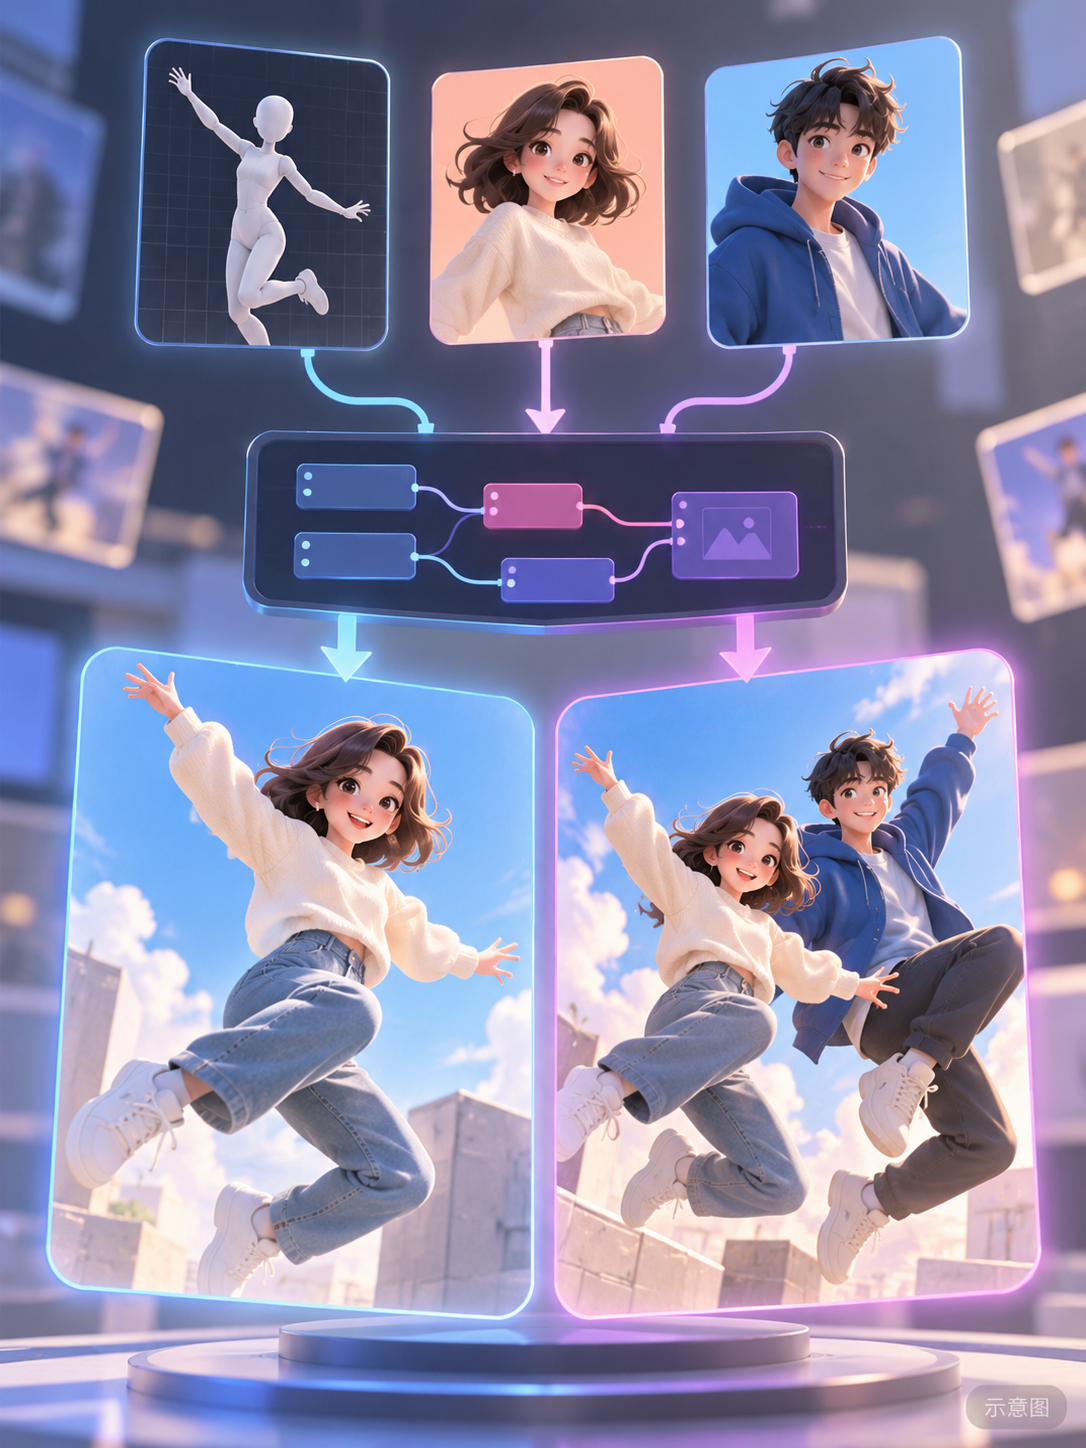
Raisons de la recommandation
- Nouveau modèle (workflow, pas de nouveaux poids) : repose sur le LoRA de poses VNCCS PoseStudio V2 de MIUProject (intensité 1.0) et sur le nœud de codage multi-images TextEncodeQwenImage21 de 2.1 ; la version Simple comprend 13 nœuds et une seule génération, tandis que la version Enhanced en compte 25, ajoutant le contrôle du ratio d'aspect et du nombre de pixels, le remplissage des images de pose, un agrandissement et une netteté optionnels, ainsi qu'une comparaison entre l'image originale et l'image améliorée
- Utilisation détaillée : placez l'image de pose dans image1, le personnage 1 dans image2 et le personnage 2 dans image3 ; commencez le prompt en précisant quelle image correspond à quelle personne dans la pose, l'auteur fournit des exemples de formulations pour gauche/droite, avant/arrière, assis sur les genoux, avec accessoires, etc., et rappelle que les supports tels que les chaises et les lits doivent être mentionnés dans le prompt
- Par défaut : 25 étapes, CFG 1, Euler, simple, l'auteur précise qu'il ne s'agit que d'un point de départ ; selon ses tests locaux, la version en précision complète de 2.1 produit les images les plus nettes, tandis que Turbo et INT8 ConvRot génèrent également des résultats ; gratuit ; 33 téléchargements (indiquant uniquement le niveau d'intérêt)
Comment l'utiliser
- Décompressez cafeavaUniversalPose_v10.zip (12 Ko) et glissez le JSON Simple ou Enhanced dans ComfyUI ; préparez le modèle 2.1, l'encodeur de texte Qwen3-VL 8B, le VAE et VNCCS_QI2_PoseStudioV2.safetensors ; la version Enhanced nécessite également les nœuds ResolutionSelector, l'agrandissement Comfyroll, 4x-UltraSharpV2, Lucy Sharpen, l'amélioration DLSS5 et le comparateur rgthree
- Mode solo : placez une seule image de personnage et modifiez le prompt pour décrire une seule personne ; dans la version Enhanced, il suffit de contourner le nœud de chargement de image3 et le nœud de mise à l'échelle correspondant pour valider la connexion
- Les images de pose doivent être obtenues individuellement sur le site original indiqué par l'auteur, qui interdit la republication et les packs
Risques et limitations
- Aucun exemple visuel disponible (4 exemples de niveau sensible masqués)
- Le chemin amélioré est un post-traitement ; l'auteur avertit qu'il peut légèrement altérer la texture et l'identité ; la faisabilité dépend des nœuds locaux et des noms de fichiers de modèle
- La licence exige l'attribution et interdit la vente ; cette entrée n'a pas été exécutée
- L'illustration de la carte est un schéma généré par IA, non le résultat réel du modèle ; l'auteur ne propose pas d'exemples publics de niveau standard
【B】Qwen Image 2.1 Fusion de composition produit : approches qualité en 40 étapes et rapide Viggle · v1.0
Workflow · Nouveau modèle · Auteur AIKSK · Publié le 11-02 01:43 · Téléchargements 11
Workflow de fusion de composition produit pour Qwen Image 2.1 par AIKSK : entrez une image de composition produit déjà assemblée avec son arrière-plan, effectuez d'abord un agrandissement UltraSharp, réduisez à environ 4 MP, puis utilisez 2.1 pour redessiner et harmoniser la lumière et l'ombre ; le workflow compare deux approches intégrées : haute qualité en 40 étapes et rapide Viggle en 20+6 étapes.
Passage de C à B : la fusion de produits e-commerce répond à un besoin clair, et la composition des deux approches est bien documentée ; les points perdus concernent l'absence d'exemples et le fait que l'auteur n'a pas effectué de vérification personnelle.
Illustration
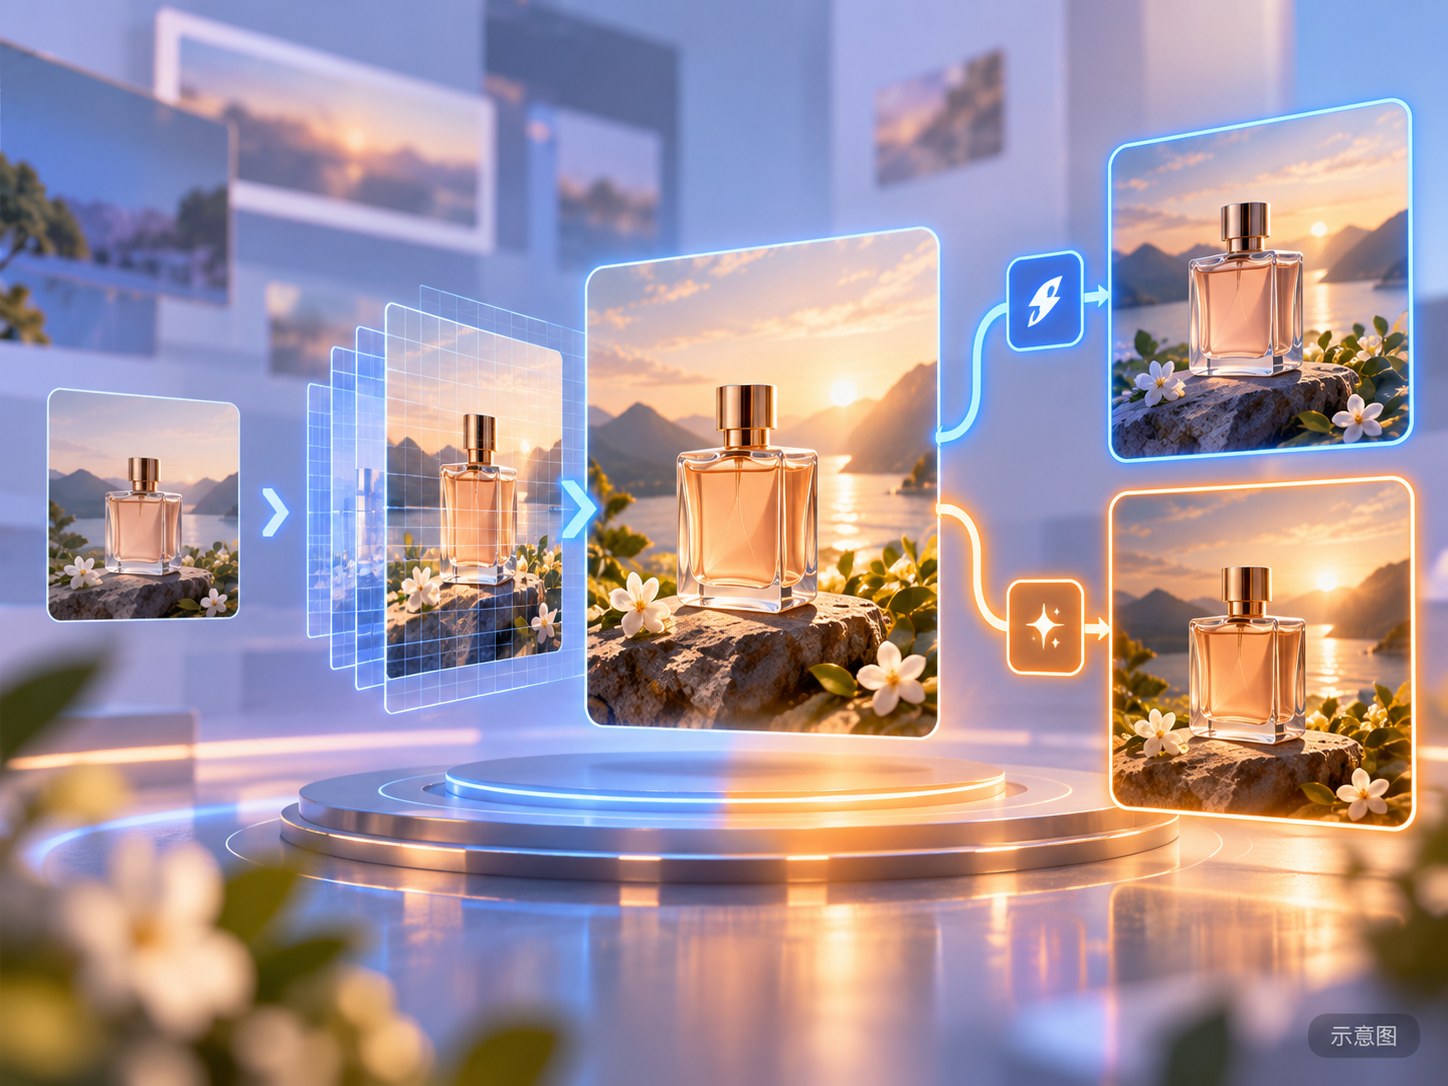
Raisons de la recommandation
- Nouveau modèle : l'étiquette du modèle de base indique uniquement « Qwen », mais le nom et les fichiers de modèle (qwen_image_2.1_bf16 / int8, LoRA viggle turbo Qwen-Image-2.1) sont bien destinés à 2.1, d'où son inclusion sous 2.1 ; destiné aux images de produits e-commerce, il fusionne le produit détouré et l'arrière-plan en une seule image
- Composition des deux approches clairement définie : approche standard avec modèle de base BF16 → LoRA C2 → échantillonnage ; approche rapide avec modèle de base INT8 → LoRA C2 → échantillonnage suivi d'une branche de continuation avec le LoRA Viggle de 6 étapes, où le FluxGuidance de la seconde condition positive est 6 (et non le CFG d'échantillonnage) ; un comparateur affiche les sorties des deux approches
- Gratuit ; aucun exemple visuel disponible (1 exemples de niveau sensible masqués) ; 32 nœuds ; 11 téléchargements (indiquant uniquement le niveau d'intérêt)
Comment l'utiliser
- Importez qwenImage21ProductComposite_v10.json (1148 Ko), préparez vous-même une image de composition assemblée (le workflow n'assemble pas automatiquement le produit et l'arrière-plan) et vérifiez le prompt 626 lié à l'encodeur
- Modèles : qwen_image_2.1_bf16 ou int8_convrot, qwen3vl_8b_int8_convrot, qwen_image_2.1_vae_bf16, LoRA Qwenimag21_c2-st2000, LoRA Viggle turbo v0.2.1 de 6 étapes et 4x-UltraSharpV2
Risques et limitations
- L'approche rapide est indiquée par l'auteur comme 20+6 ; la gestion du bruit et de la graine lors de la continuation de l'échantillonnage n'est pas confirmée ; les modèles de base, LoRA et paramètres de guidage diffèrent entre les deux approches, ce n'est donc pas une simple comparaison de nombre d'étapes
- L'auteur déclare n'avoir effectué ni inférence ni vérification de qualité ; l'image de couverture n'est pas un résultat vérifié ; la licence interdit l'usage commercial et les dérivés
- Cette entrée n'a pas été exécutée
- L'illustration de la carte est un schéma généré par IA, non le résultat réel du modèle ; l'auteur ne propose pas d'exemples publics de niveau standard
Inclus uniquement (1)
- Qwen Image 2.1 Directeur de pose de personnage (VNCCS Pose Studio) · v1.0 — Workflow : workflow de pose de personnage pour Qwen Image 2.1 par AIKSK : configurez la pose dans l'éditeur VNCCS Pose Studio comme image1, utilisez l'apparence du personnage comme référence dans image2, et générez une image du personnage dans cette pose.
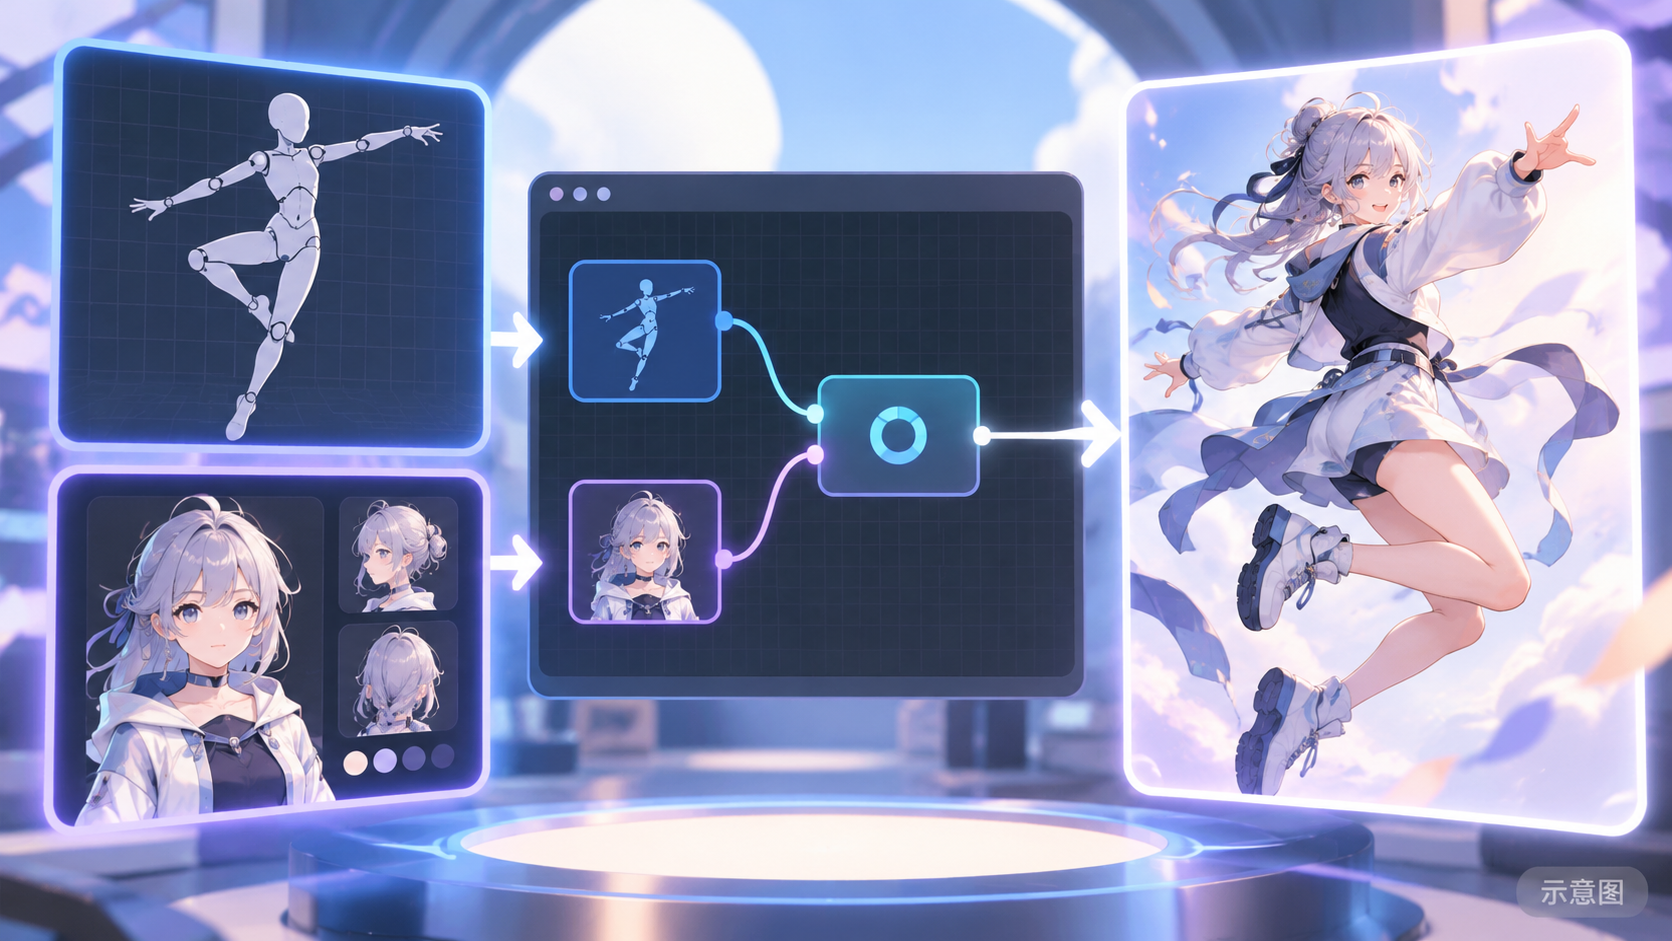
Données : API publique Civitai (modèle de base Qwen 2.1), période d'inclusion du 11-01 20:31 au 11-02 10:45 (heure de Pékin). Les recommandations ont été revues par l'équipe éditoriale ; le nombre de téléchargements reflète uniquement le niveau d'intérêt.