貞貞のAIレーダー · MiniMax H3 · 2026-11-17 朝刊
今期は 13 件の新バージョンです。強くおすすめ 1 件 · おすすめ 3 件 · 注目 2 件 · 収録のみ 7 件
編集者によるコメント 今期は H3 の新バージョン 13 件をレビューしました。S が 1 件、A が 3 件、B が 2 件、C が 7 件です。おすすめは The_frizzy1 による 12GB キャラクター置換ワークフローです。自分の動画とキャラクター画像1枚を使い、画面内の人物を置き換えつつ元の動きと音声は保持し、5 秒ごとにループして全長を処理します。ComfyUI のネイティブノードのみを使用します。AusBoss の Pika 人物置換と Pika Remix の2つのワークフローが同時に更新され、デフォルトで有効なアテンション高速化スイッチが追加されました。作者によれば約2倍高速とのことです。SillyBilly101 のリファレンス動画生成ワークフローには、複数リファレンスから静止画を合成するブランチ版が登場しました。mo_akkakk が一挙に公開した動画から動画へ、部分再描画、トリミング再描画、Ripple 編集の 4 件のワークフローは、説明が1文とチュートリアルへの外部リンクのみで、説明が不十分またはサンプルがすべて非表示のキャラクター/アクション LoRA 3 件とともに C に分類されました。低ポリゴンスタイルの LoRA はサンプルが多いものの有料のため B に分類されました。
強くおすすめ(1)
【S】MiniMax H3 Character Swap 12GB — あなたの動画+キャラクター画像1枚、任意のクリップ長、クリップ自体の音 · v1.1.0
ワークフロー · 新モデル · 作者 The_frizzy1 · 公開 11-17 01:00 · ダウンロード 77
12 GB の GPU で動作する H3 キャラクター置換 ComfyUI ワークフローです。動画1本とキャラクター画像1枚を入力すると、同じ動画内の人物がそのキャラクターに置き換わり、動きやリズムは変わらないまま、元の動画の音声を戻すことができます。長い動画は約 5 秒ごとにループして処理します。
画像
おすすめ理由
- 新機能:作者によれば、Higgsfield の Genjutsu によるキャラクター置換のアイデアをローカル環境に移植したもので、各セグメントが前のセグメントの末尾 22 フレームから継続生成されるため、動画の長さは単一の生成制限を受けません
- ComfyUI のネイティブノードのみを使用(Start Loop / End Loop を含む)し、カスタムノードのインストールは不要です。作者は RTX 3060 12 GB + 32 GB メモリ環境で動作確認済みで、VRAM ピークは 11892 MiB です
- 本バージョン v1.1.0 では、すべての設定と 6 個のモデルローダーが1つのメインノードに集約されました。作者は説明内で 6 個のモデルファイルのダウンロード先と配置ディレクトリをすべて記載しています
- 無料で、ワークフローは MIT ライセンスです。公開 8 時間で 77 回のダウンロードがあり、これは注目度を示すものです
使い方
- The_frizzy1_h3-character-swap-12gb_v1.1.0.json をインポートします。ComfyUI 0.39 以上が必要です。H3 の ref2va int8 メインモデル、Ref2V Turbo 4 ステップ LoRA、テキストエンコーダー、動画/音声 VAE、および akatz-ai の Character Swap LoRA(実際に人物置換を行うファイル)をダウンロードしてください
- メインノードで「誰を置き換えるか」を一文で入力します(その人物の服装を明確に記述)。Seconds を 0 に設定すると全長を処理し、数値を入力すると冒頭のみを処理します。Turbo を有効にすると 4 ステップ、無効にすると 20 ステップです。「元の音声を保持」を有効にすると元の動画の音声が戻ります
- 作者はキャラクター設定画像(正面、背面、顔)の入力を推奨しています
リスクと制限
- 非常に遅い:作者によれば、0.4 MP で Turbo 有効時に約 7 秒の動画を 3060 で処理すると 11–12 分、Turbo 無効で 20 ステップの場合、単一セグメント 5 秒で約 35 分かかります。0.4 MP を超えるとメモリにオーバーフローします
- 公開されているサンプルは 3 枚の静止画のみで動画はなく、14 件のサンプルは非表示です。一度に1人しか置き換えられず、ハードカットのある動画では混乱が生じます。作者は架空のキャラクターのみを置き換え、実在の人物の顔は置き換えないよう注意を促しています
- H3 と Character Swap LoRA は MiniMax H3 Community License に従うため、商用利用前にライセンスを自分で確認する必要があります。作者はバージョン履歴欄を記載しておらず、変更点は総合説明内にのみ記載されています
おすすめ(3)
【A】MiniMax H3 Pika Person Swap | High + Low VRAM, 8 GB+ · v1.2
ワークフロー · バージョン更新 · 作者 AusBoss · 公開 11-17 02:59 · ダウンロード 120
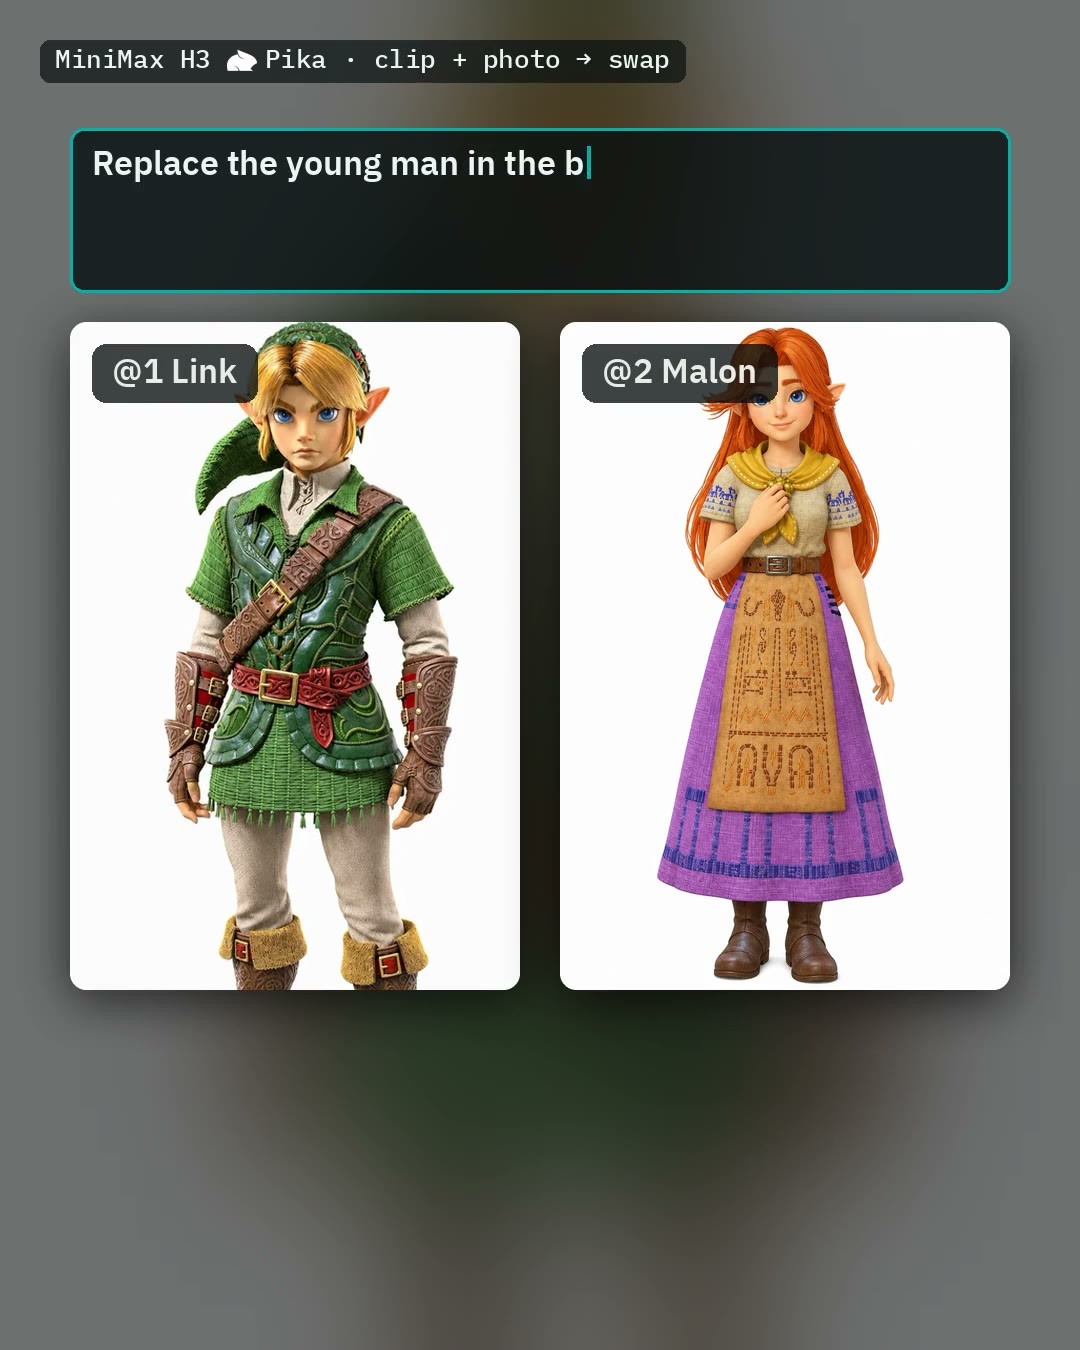
AusBoss の H3 人物置換ワークフロー v1.2 です。写真内の人物をあなたの動画クリップに組み込み、シーン、動き、カメラワーク、音声はそのまま維持します。本バージョンでは高速化スイッチが追加され、複数人の置換にも対応しました。
画像
おすすめ理由
- バージョン更新:デフォルトで有効な kitchen attention スイッチが追加され、ComfyUI 標準の Model Attention Backend ノードを使用します。作者によれば約2倍高速(5090 で1ステップあたり 23 秒から 11 秒に短縮)とのことです。RTX 20 / RX 7000 以前のカードは元の速度で動作します。説明に Picture 2–4 の接続方法が追記され、複数人の置換が可能になりました。有効にするとガイドと3つの入力欄が表示されます
- 動画の人物置換向け:クリップは1カットに切り出し、最長 10 秒です。24 GB 以上なら High VRAM、それ未満なら Low VRAM(より小さいメインモデルと VAE を使用)を選択します
- 2 本のサンプル動画と 1 枚のサンプル画像が付属しています。作者は別途、各実行時の写真、クリップ、設定、プロンプトを公開する外部リンクページを用意しています。モデルページ全体で 2562 回のダウンロード、14 件のコメントがあります
使い方
- まず AusBoss nodes を 2.25.2 以上、ComfyUI を 0.38.0 以上にアップグレードしてください。H3 ref2va メインモデル、テキストエンコーダー、動画/音声 VAE、Pika H3 Flex LoRA が必要です
- クリップを Video - Your clip に、新しい人物の写真を Picture 1 に配置します。プロンプトは2行で、1行目は「Replace the man in the red shirt with @1.」のように書き、2行目は @1 の髪型、顔、服装を記述します
- Describe @1 for me を有効にすると、ワークフローが写真から2行目を自動生成します。SeedVR2 スイッチで拡大とシャープニングを行えます
リスクと制限
- 作者によれば、Describe @1 for me を有効にすると1回の実行で約 60 GB のシステムメモリを消費するため、64 GB 未満の環境では手動での入力を推奨します。顔が小さすぎる場合や常に後ろを向いている場合は、髪型と服装のみが置換される可能性があります
- 2行目を記述しない場合、人物置換が遅延したり発生しなかったりすることがあります。本ツールは動作確認されておらず、AusBoss のカスタムノードパッケージに依存します
【A】MiniMax H3 Pika Remix | High + Low VRAM, 8 GB+ · v1.1
ワークフロー · バージョン更新 · 作者 AusBoss · 公開 11-17 04:59 · ダウンロード 78
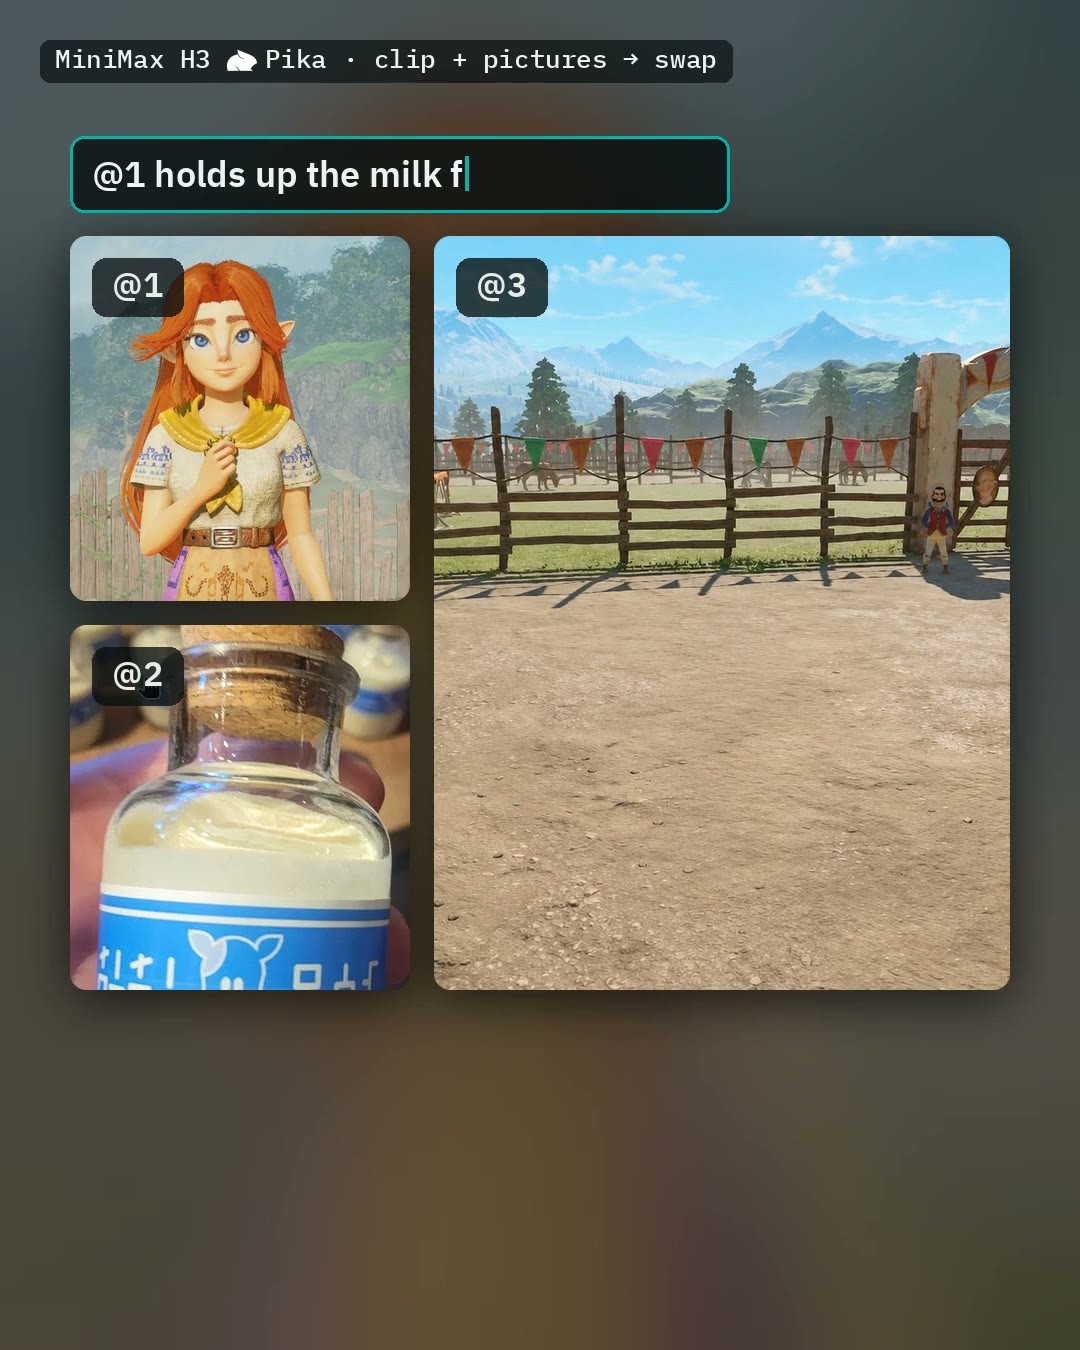
AusBoss の H3 マルチリファレンスワークフロー Pika Remix v1.1 です。最大 4 枚の画像と 1 本の動画を組み合わせ、各画像を人物、シーン、服装、または物体として指定してリファレンス動画生成を行ったり、既存動画の人物置換、一部の変更、動きの模倣、続きの生成を行ったりできます。本バージョンでは高速化スイッチが追加されました。
画像
おすすめ理由
- バージョン更新:デフォルトで有効な kitchen attention スイッチが追加され、ComfyUI 標準の Model Attention Backend ノードを使用します。作者によれば約2倍高速で、追加のインストールは不要です
- 1つのワークフローで多様なリファレンスタスクに対応:自分のシーン、2人の同框、着せ替え、ダンスの動きの模倣、動画の人物置換、動画内の一部変更、続きの生成など。High VRAM は 24 GB 以上、Low VRAM は 8 から 24 GB です
- 1 本のサンプル動画と 1 枚のサンプル画像が付属しています。作者は各実行時の完全な設定を公開する外部リンクページを用意しています。無料で、ライセンスでは出力画像の作成と販売が許可されています
使い方
- Picture 1 に画像を配置し、H3 Prompt Writer でその役割を選択します。各要素を1行ずつ記述し、@1 で Picture 1 を参照します。例:「@1 walks to the window and looks out」。Seconds で長さを指定します
- Pika LoRA の強度は 1 のままにし、Turbo や Lightning LoRA を追加しないでください。AusBoss nodes 2.25.2 以上が必要です。8 GB の GPU では ComfyUI 0.45 以上、Auto prompt には 0.42.0 以上が必要です
- 人物置換のみを行う場合は、同じ作者によるより軽量な Person Swap ワークフローを使用してください
リスクと制限
- 作者は、人物置換、シーン変更、物体追加を同時に行うと失敗しやすいと注意を促しており、一度に1箇所のみ変更することを推奨しています。8 GB 環境では約 32 GB のシステムメモリが必要で、作者は 12 秒のクリップでメモリ不足が発生したとテスト結果を報告しています
- AusBoss のカスタムノードパッケージに依存し、モデルファイルが多いです。本ツールは動作確認されていません
【A】MiniMax H3 ref2va/fl2va + Reference to image creation fast workflow · v3.0_ImageGen
ワークフロー · バージョン更新 · 作者 SillyBilly101 · 公開 11-16 21:13 · ダウンロード 22
SillyBilly101 の高速動画生成ワークフロー v3.0 の画像生成ブランチです。H3 のリファレンス動画生成で 2 秒の動画を生成し、その最初のフレームと最後のフレームを画像として保存することで、複数のリファレンス画像内のキャラクター、服装、武器、ポーズを1枚の静止画に合成します。
画像
おすすめ理由
- バージョン更新:同じページの v3.0 は動画版ですが、本バージョンは同じセットアップを静止画生成用に調整したもので、最大 9 枚の画像と 3 本の動画をリファレンスとして受け付けます。カウントは行いませんが、動画の長さは引き続きチェックされます
- 複数リファレンスからの定着画像やキャラクター設定画像などのタスクに対応し、別の画像モデルを起動する必要がありません。v3.0 のセグメント化されたプロンプト入力と解像度オプション(メガピクセル、カスタム幅/高さ、または最初の画像/動画のサイズを引き継ぐ)を引き継いでいます
- 2 枚のサンプル画像が付属しています。無料で、ライセンスでは出力画像の作成と販売が許可されています
使い方
- H3_FastGen_RefImg_V3.json をインポートし、通常の ref2va 動画と同じ書き方でプロンプトを作成しますが、カットは1つだけ記述し、still、static、does not move などの語句を用いて画面を静止させます
- int8-convrot メインモデル、4 Step LoRA(必ずプルーニング版であること)、latent upscaler と Impact Pack、KJ Nodes、Dynamic Prompts などのノードパッケージが必要です。完全なリストはモデルページを参照してください
リスクと制限
- 作者による更新説明はありません(バージョン説明欄は空で、変更点は総合説明に記載されています)。5 件のサンプルは非表示です
- 依存ノードが多く、そのうち MiniMax H3 Audio T8、YC Nodes MiniMax H3、Selflift Avatar は手動インストールが必要です。作者は Selflift Avatar の最新コミットに問題があるためロールバックが必要だと注意を促しています。本ツールでは動作確認を行っていません
注目すべき項目(2)
【B】H3 Multi First-to-Last-Frame: Automated, Looping · v2.0
ワークフロー · バージョン更新 · 作者 qdr1en · 公開 11-17 04:43 · ダウンロード数 59
Wan 2.2 から H3 の先頭・末尾フレームモデルへ移植された、バッチ処理による先頭・末尾フレームの長尺動画ワークフロー v2.0 です。フォルダから一連のキーフレームを読み込み、隣接する2枚の間で自動的に先頭・末尾フレーム生成を実行し、長いカットシーケンスとして結合します。ループ再生も可能です。本バージョンでは、セグメント間の動きを接続するためのノードが追加されました。
画像
推奨理由
- バージョン更新:H3 Motion Context ノードが新規追加され、セグメント間の遷移を滑らかにします(軽量ノードパッケージで、追加の Python 依存関係はありません)。フレーム補間は GIMM から RIFE に変更され、デフォルトでは無効になっています。RTX Video Super Resolution によるアップスケーリングも追加されました
- ポートレート写真セットや、キーフレームを長編動画へ変換する用途に最適:全体のプロンプトに加え、セグメントごとのプロンプト(各行が1つのセグメントに対応)を設定できます。各セグメントのフレーム数は 17n+5 の形式で設定し、一般的には 22、39 または 56 が使用されます
- パラメータが詳細に提供されています:作者は fl2v Turbo を 4 ステップ、LoRA 強度 0.80 で使用しており、8 ステップで最も良い結果が得られると述べています。公開後 4 時間で 59 回のダウンロードがあり、これは注目度を示すものです
使い方
- Load Images From Folder でキーフレームフォルダを指定し、load_image_cap と start_index を設定します。幅と高さは 32 の倍数である必要があります。Looping Video を true に設定すると、最後の画像を最初の画像へ接続するために1セグメント多く生成されます
- H3 Motion Context の context_length には、遷移に使用するフレーム数を設定します。必須ノードは ComfyUI-Easy-Use、KJNodes、VideoHelperSuite、H3-Motion-Context です
リスクと制限
- 表示可能なサンプルは 0 件です(5 件は非表示のため)、遷移効果をプレビューすることはできません
- 各セグメントは個別に生成されるため、H3 が生成する音声は一貫性がありません。作者は音声出力を無効化し、外部音声を読み込むように変更しました。画像が多い場合はメモリを大量に消費します
- ライセンスにより派生モデルの公開は禁止されており、商用利用は画像出力とサイト内でのレンタルのみ許可されています
- カードに表示されている画像は AI で生成された概念図であり、モデルの実際の出力結果ではありません。作者による一般レベルの公開サンプルはありません
【B】LowPolyStyle [Minimax / MOSS / Krea2 / SD] · Minimax v1.0
LoRA · ポート · 作者 TeraWatt · 公開 11-17 06:42 · ダウンロード数 0 · 有料
TeraWatt のローポリゴン(Low Poly)スタイル LoRA の H3 版です。被写体やシーンを幾何学的な面ブロックで構成し、造型を簡略化して角張った 3D ローポリスタイルに仕上げます。トリガーワードは LowPolyStyle_TeraWatt です。
画像
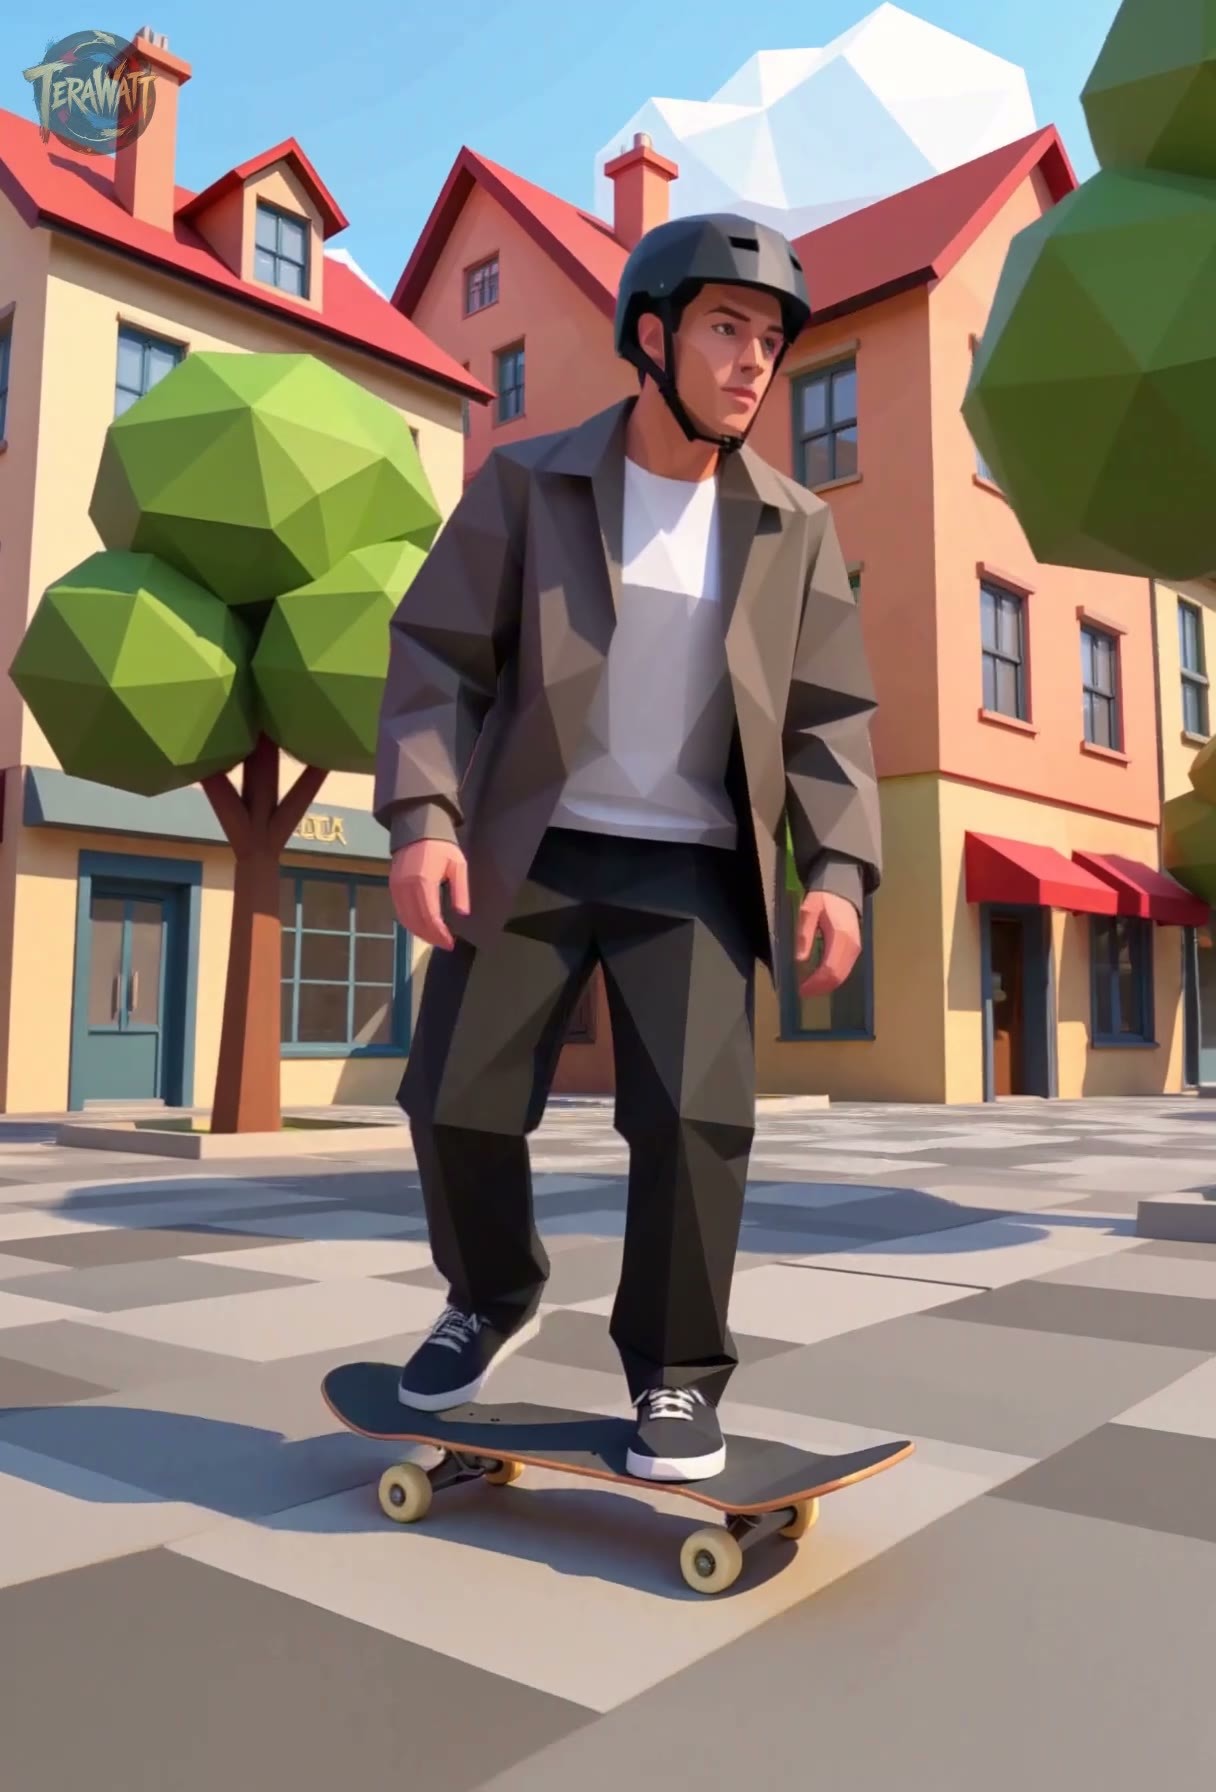
推奨理由
- ポート:同じページには MOSS Image、Krea 2、Illustrious、Pony、SDXL 版があり、H3 版は同一スタイルの動画バージョンです。作者によると、H3 のサンプルはすべてテキストから動画への生成モードで作成されています
- ローポリゲームアセット、スタイル化されたキャラクターやシーン、ローポリゴンアニメーション短編に最適です
- プレビュー用の 16 本のサンプル動画が付属しています
使い方
- LowPolyStyle_TeraWatt_Minimax.safetensors(BF16)を読み込み、プロンプトにトリガーワード LowPolyStyle_TeraWatt を記述します
- 強度やステップ数については作者から提供されていません
リスクと制限
- 有料ダウンロードです(永久課金)。H3 版と画像版の違いについて、作者からの説明はありません
- 3 件のサンプルが非表示です
トリガーワード:LowPolyStyle_TeraWatt
収録のみ(7)
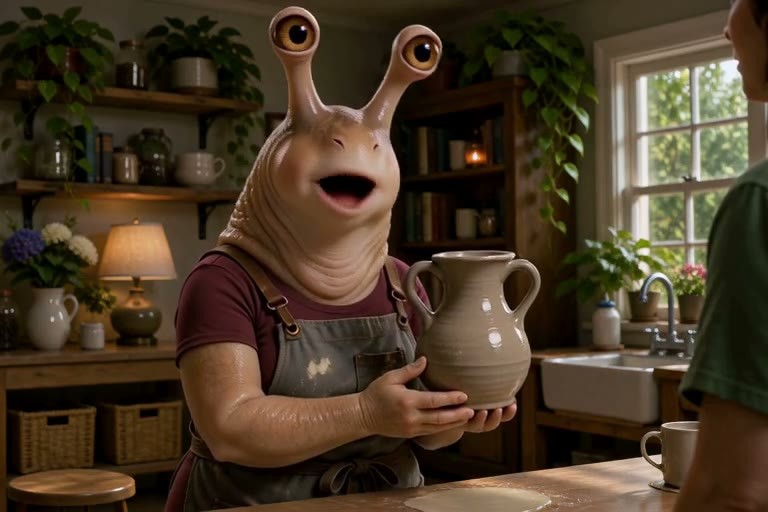
- Erin Day · v1.0 H3 — LoRA:MikoGoblin のオリジナル架空キャラクター Erin Day(ナメクジのような外見の陶芸家)のキャラクター LoRA の H3 版です。トリガーワードは erinlora です。
- Alicja NordhavenLove · MiniMaxH3 — LoRA:MisterMR のオリジナル架空女性キャラクター Alicja NordhavenLove のキャラクター LoRA の H3 版です。作者は実在の人物ではないと明記しています。
- MiniMax H3 Video to Video Workflow · v4.0 — ワークフロー:mo_akkakk による H3 の動画から動画への変換(動画編集)ComfyUI ワークフロー v4.0 です。ファイル名からは単一ステージの動画編集フローであることがわかりますが、具体的な手法は作者の YouTube チュートリアルでのみ説明されています。
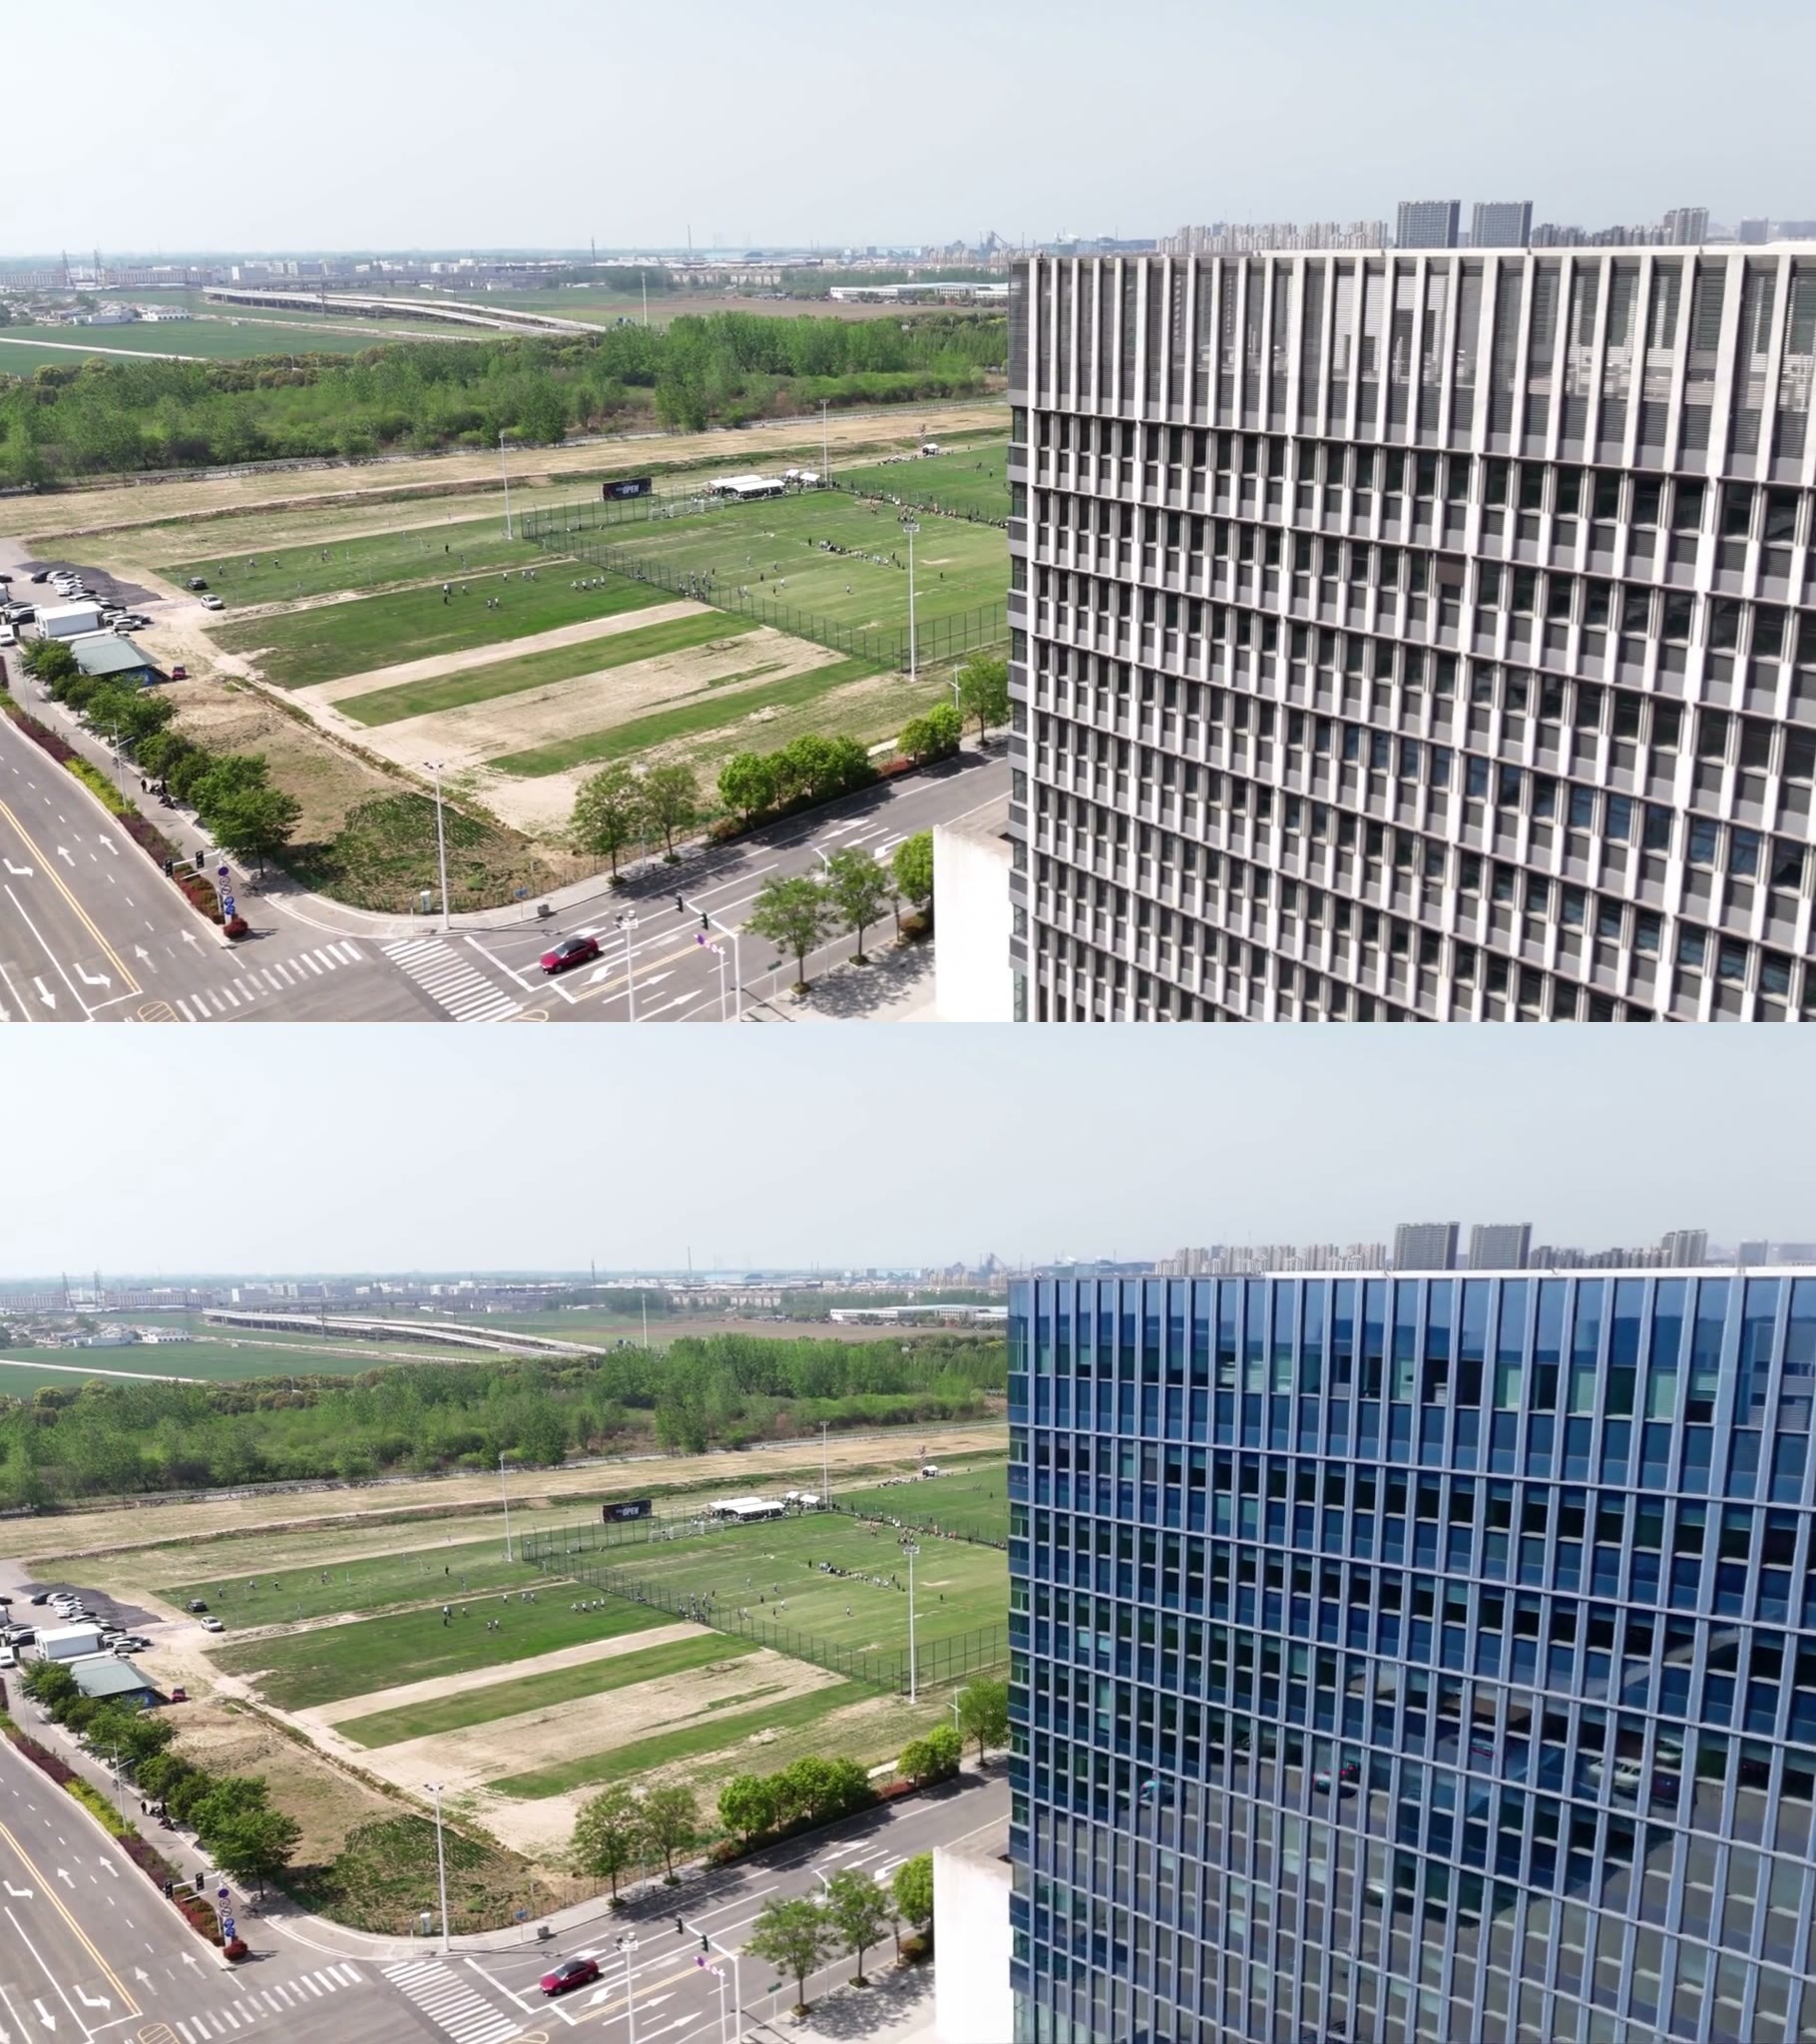
- MiniMax_H3_Inpaitning_1STG · v1.0 — ワークフロー:mo_akkakk による H3 の動画インペインティング(局部再描画)ComfyUI ワークフローです。説明はタイトルと「ビデオチュートリアルはこちら」という一文のみです。
- MiniMax_H3_Inpaitning_cropping_1STG · v1.0 — ワークフロー:mo_akkakk による H3 の動画インペインティングとクロップを組み合わせた ComfyUI ワークフローです。名称からは、まず局部領域を切り出してから再描画を行うことが推測されますが、説明はタイトルとチュートリアルリンクのみです。
- Minimax-H3_Video_Editing_Ripple · v1.0 — ワークフロー:mo_akkakk による Ripple LoRA を使用した H3 動画編集 ComfyUI ワークフローです。説明は一文とチュートリアルリンクのみです。
- Clear Chair Step on Plushie, Foot Crush · Minimax — LoRA:ネット上の「透明な椅子でぬいぐるみを踏む」ショート動画のネタを再現したアクション LoRA です。透明な椅子の下からアングルを撮り、椅子の上にあるぬいぐるみを足で踏みつぶす動作を生成します。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-16 20:31 → 11-17 09:01(北京時間)。推奨理由は編集者によるレビュー済みです。ダウンロード数は注目度を表すに過ぎません。