貞貞のAIレーダー · MiniMax H3 Image · 2026-11-11 朝刊
今期の 10 件の新バージョン:強くおすすめ 1 件 · おすすめ 1 件 · 注目 4 件 · 収録のみ 4 件
編集者按 H3 Image 特集第1回:10 件の新バージョンをレビューし、S評価 1 件、A評価 1 件、B評価 4 件、C評価 4 件としました。初回のおすすめは AusBoss によるテキスト生成画像+画像編集ワークフローです:一文で 16 MP の画像を生成したり、平易な言葉で画像を編集したりでき、さらに最大7枚の参考画像を追加可能で、Fast モードでは 2 ステップで画像を出力します。Comfy 公式にない fp8 / NVFP4 / GGUF の補完量子化パックは A 評価としました。tsolful の INT8 / INT6 量子化は、公式の int8 / w4a8 との違いが説明されていないため B 評価に下げ、INT4 は C 評価としました。説明が空欄または一文のみの3つのワークフローは C 評価としました。これらの項目は 11-11 の朝刊で H3 特集にて既にレビュー済みであり、本特集でも同じ結論を踏襲しています。
強くおすすめ(1)
【S】MiniMax H3 Image Generate + Edit | 16 MP, 8 枚 · v1.0
ワークフロー · 新モデル · 作者 AusBoss · 公開 11-11 08:31 · ダウンロード 220
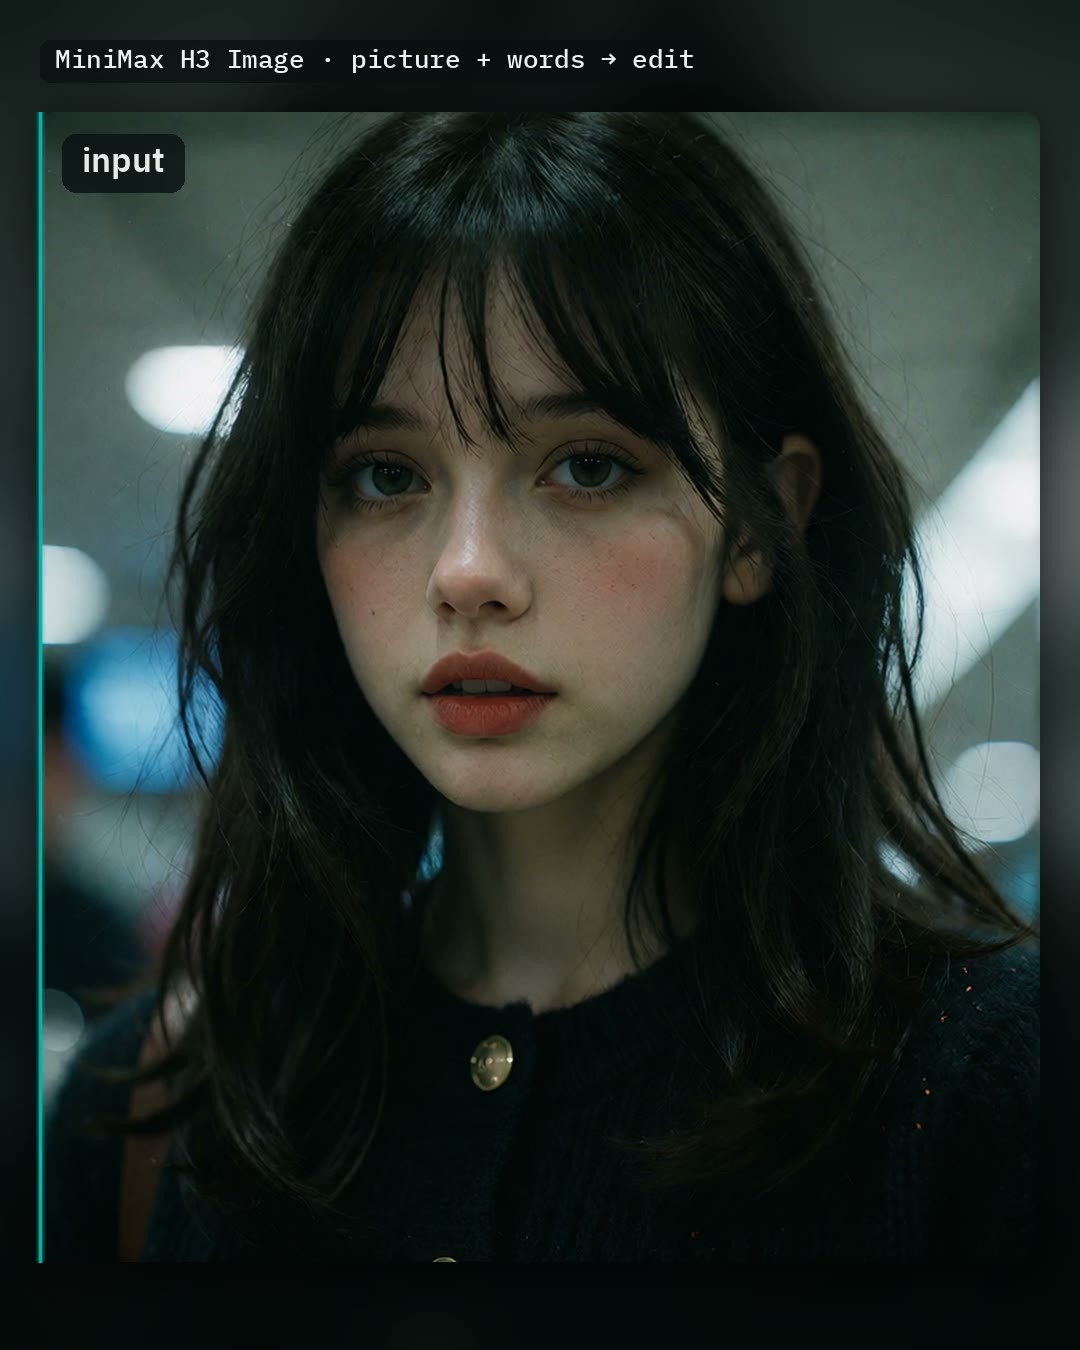
MiniMax H3 Image(H3 の画像版)の ComfyUI 用テキスト生成画像+画像編集ワークフロー:一文で 16 MP の画像を生成したり、平易な言葉で画像を編集したりでき、編集時には最大7枚の参考画像を追加し、各画像から何を抽出するかを指定できます。
H3 Image 公開後、生成、編集、複数画像参照、アップスケールを一つにまとめ、テストバージョン番号も明記した初のワークフローであり、H3 Image の入門テンプレートとして適しています。
添付画像
おすすめ理由
- 新モデル(ワークフローであり、新しい重みファイルではない);H3 Image のテキスト生成画像、指示による画像編集、複数画像参照合成に対応。例:「画像 2 のジャケットを画像 1 の人物に着せる」
- 作者はテスト環境(ComfyUI master ブランチ commit ede4e5f + AusBoss nodes 2.22.0、2種類のVRAM環境で動作確認済み)を明記し、必要なモデルファイル、配置ディレクトリ、サイズを個別に列挙しています:High VRAM 用には int8 ConvRot ベースモデル(21.0 GB)、Low VRAM 用には w4a8(12.5 GB)を使用し、共通で Qwen3-VL 32B nvfp4 テキストエンコーダと H3 Image VAE を使用します
- スイッチが充実:Auto prompt は小型モデルで数語を長い説明に拡張します;Size は 4 MP / 16 MP で切り替え可能;Fast は pDMD 2 ステップ LoRA を使用し、6 ステップを 2 ステップに短縮;オプションで SeedVR2 を使用し、4 MP の結果を2倍にアップスケール可能
- 作者によれば、RTX 5090 で新しい 16 MP 画像の生成は約 22 秒、16 MP 画像の編集は約 35 秒;1 本の動画 + 6 枚の表示可能なサンプル画像
使い方
- まず ComfyUI を 0.44.0 以降のバージョンに更新し、AusBoss nodes を 2.22.0 に更新してから、ワークフローをドラッグ&ドロップして直接 Run します。デフォルトで完全なプロンプトが含まれています
- 自分で画像を生成する場合:完全な長い説明を書くか、Auto prompt を有効にして数語だけ入力します;画像を編集する場合:Edit a picture を有効にし、画像を読み込んで変更内容(例:「Make it snow.」)を書きます;参考画像は picture 2 から picture 8 まで順に接続し、プロンプト内で「picture 2」と名指しします
- 画面に表示させたい文字は引用符で囲みます;プロンプトが既に完全な場合は Auto prompt を無効にします(作者によれば、開始プロンプトを書き換えると手が乱れるため);ポスターやカバーを作成する際は Fast を有効にしないでください
リスクと制限
- H3 Image の新機能サポート(11-10 に ComfyUI に統合)と AusBoss 独自ノードに依存しており、古いバージョンの ComfyUI では動作しません;全モデルセット(ベースモデル + 32B テキストエンコーダ + オプションのプロンプト拡張モデル、高速化 LoRA、SeedVR2)のダウンロードサイズは非常に大きいです
- MiniMax-H3-Image コミュニティライセンス:Comfy 量子化作者の転述によると、EU、英国、韓国、米国はカバーされておらず、成果物を他のAIモデルの改善に使用することは禁止されています。年間収入が 100 万ドルを超える場合やホスティングサービスを行う場合は別途許可が必要です
- 所要時間の数値は作者の申告によるものです
おすすめ(1)
【A】Minimax H3 Image Quants - comfy-native - fp8_scaled / nvfp4 / GGUF Q6 / Q4 / Q3 / Q2_mix · v1.0
ベースモデル / Checkpoint · 新モデル · 作者 Thasmodius · 公開 11-11 07:19 · ダウンロード 72
H3 Image ベースモデルの補完精度パック:Comfy 公式リポジトリにない fp8 scaled、NVFP4、および GGUF Q6_K / Q4_K / Q3_K / Q2_K 混合量子化を含み、拡散モデルのみを収録しています。
添付画像
おすすめ理由
- 新モデル(量子化重み);RTX 40 / 50 または任意のGPUで H3 Image のテキスト生成画像や画像編集を実行したいが、公式の bf16 を収めるVRAMが不足しているユーザー向け
- 各段階の用途が明確に記述されています:fp8 scaled 21.0 GB は RTX 40 / 50 用;NVFP4 12.5 GB は RTX 50 でネイティブ実行時のみで最速(作者によれば、RTX PRO 6000 で 2048x2048 約 3.4 steps/s、fp8 約 2.1 steps/s);GGUF Q6_K 17.5 GB、Q4_K 12.5 GB、Q3_K 10.0 GB は任意のGPU用;Q2_K mix 9.25 GB は実験段階で、作者によれば画質が明らかにぼやけます
- 作者は量子化範囲が Comfy 公式の int8 / w4a8 と同じ(同じく 200 個の transformer 層、重みの 95.8% を占める)であることを説明し、残りは公式の bf16 のまま変更なしとし、HF 上の比較ページも提供しています;8 枚の表示可能なサンプル画像
使い方
- ComfyUI 0.44 以降が必要;ComfyUI 標準の「MiniMax H3 Image」テンプレートを開き、Load Diffusion Model でファイルを選択します;テンプレート設定は 6 ステップ、euler、simple、cfg 1 のままにします
- テキストエンコーダ qwen3vl_32b_minimax_h3_nvfp4_awq(または int8 convrot)と VAE は Comfy-Org の MiniMax-H3-Image リポジトリから取得します
- GGUF を使用する場合、ロードノードを Unet Loader (GGUF) に変更し、事前に ComfyUI-GGUF にパッチを適用する必要があります(作者が提供する patch スクリプトを実行するか、手動で loader.py の IMG_ARCH_LIST に "minimax_h3" を追加)。これを行わないと Unexpected architecture type エラーが発生します
- 作者によれば、モデルは 4–20 MP の間で最も効果が高く、低解像度では性能が低下するため、長く詳細な英語のプロンプトを使用する必要があります
リスクと制限
- MiniMax-H3-Image コミュニティライセンス:作者の原文には、ライセンスが EU、英国、韓国、米国をカバーしていないことが明記されています;モデルおよび成果物を他のAIモデルの改善に使用することは禁止されています;年間収入が 100 万ドルを超える場合やホスティングサービスを行う場合は、事前に MiniMax の書面による許可が必要です;商用製品には MiniMax-H3-Image と明記する必要があります
- GGUF はまだ上流にマージされていないパッチに依存しています;2 個のサンプルは非表示です
注目(4)
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT8
ベースモデル / Checkpoint · 新モデル · 作者 tsolful · 公開 11-11 07:17 · ダウンロード 91
H3 Image ベースモデルの INT8 ConvRot(W8A8)量子化版で、サイズは 19.54 GB です。作者は3段階の量子化におけるデフォルトの選択肢として推奨しています。
添付画像
おすすめ理由
- 新モデル(量子化重み、同ページに INT6 / INT4 の2段階も存在);公式の bf16(40.2 GB)を収めるVRAMがない H3 Image ユーザー向け。作者によればほぼ無損失で、RTX 30 系以上の INT8 テンソルコアを使用します
- 作者は敏感な層(入出力、変調、埋め込み、出力ヘッド)は BF16 のままにしていることを説明し、H3 Image の使い方も明確にしています:画像を接続しない場合はテキスト生成画像(デフォルト 2048×2048)、image_1 から画像を接続する場合は画像編集 / 参照生成となり、プロンプト内で <Picture 1> などを用いて名指しします
- 3 枚の表示可能なサンプル画像
使い方
- 6 ステップ、CFG 1、公式 PDD サンプラーを推奨;作者自身は Euler_ancestral / simple で 6 ステップを使用;ネガティブプロンプトは使用しません
- H3 Image をネイティブサポートする ComfyUI が必要(MiniMax H3 Image Conditioning ノードまたは公式テンプレートを使用);テキストエンコーダは H3 動画版と共通の Qwen3-VL を使用;VAE は minimax_h3_image_vae_fp16 を使用する必要があり、動画用 VAE は使用不可;画像編集時は VAE を接続する必要があります
リスクと制限
- Comfy-Org の公式リポジトリでは int8 ConvRot バージョン(minimax_h3_image_pruned_int8_convrot)が提供されています。本ファイルはサイズがほぼ同じですがハッシュ値が異なり、作者は独自に量子化したのか再パッケージしたのか、また公式版との違いについては説明していません
- MiniMax-H3-Image のコミュニティライセンスには地域および用途に関する別の制限があります。1 件のサンプルは非表示です
【B】H3 Image w/ Pose Studio + Other Advanced Features [FoxFurEssence] · v1.0
ワークフロー · 新モデル · 作者 foxydits · 公開 11-11 08:56 · ダウンロード数 333
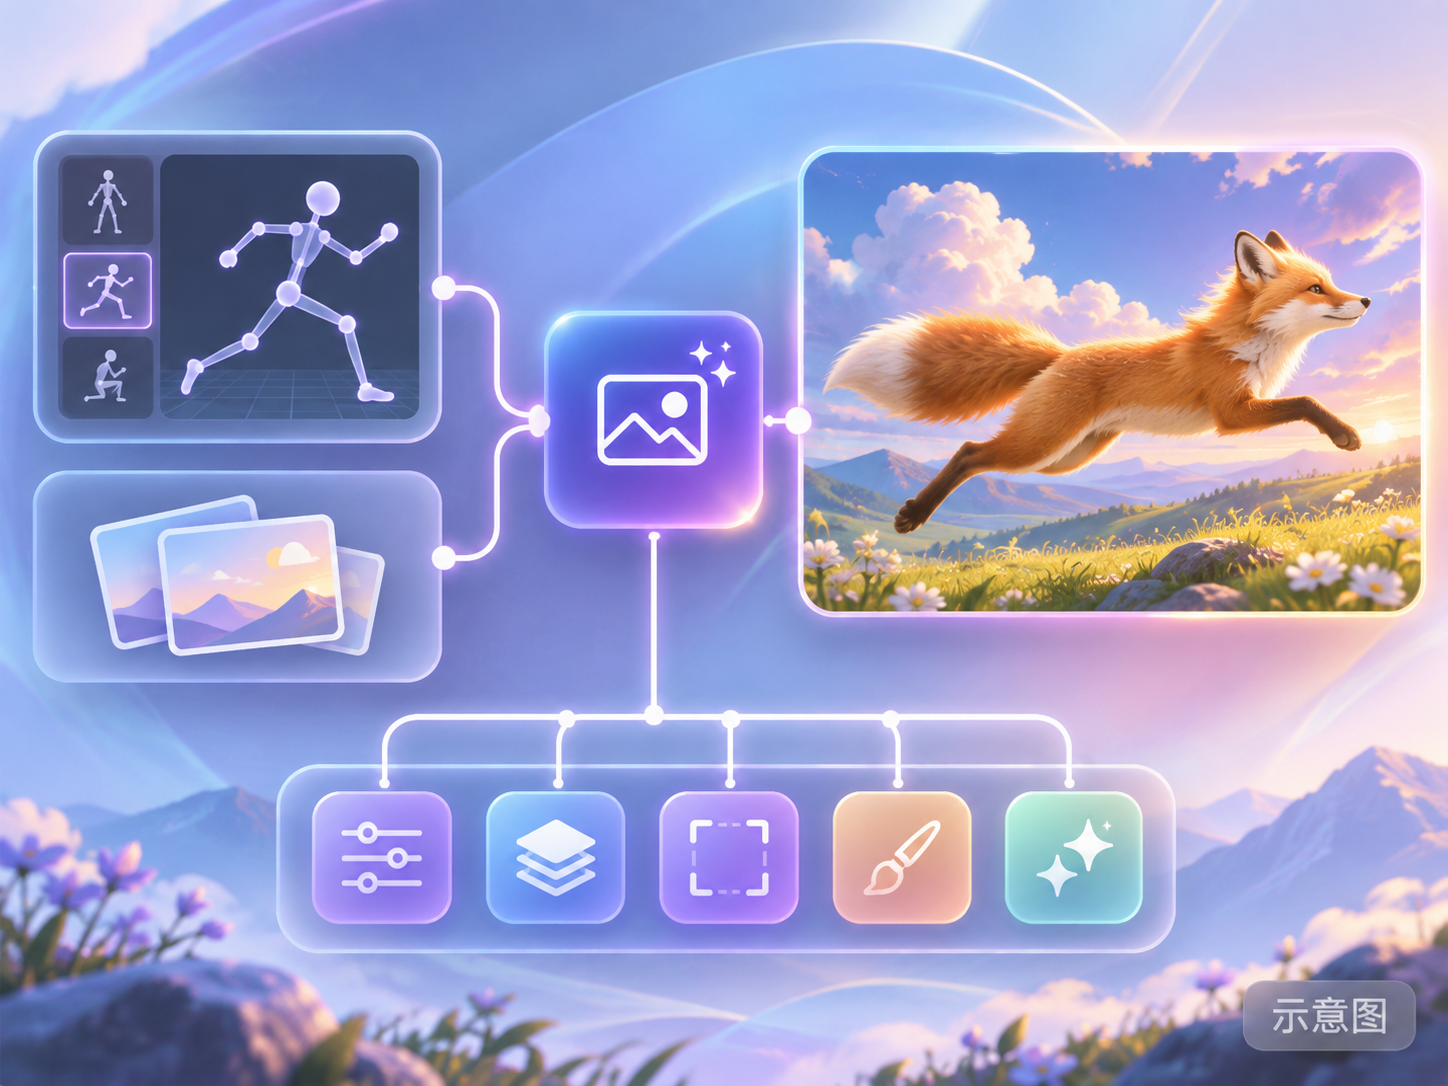
H3 Image の多機能ワークフロー:テキストから画像生成 / 画像から画像生成 / 最大 9 枚の参照画像による生成に対応し、オン・オフ可能な Pose Studio(ポーズスタジオ)を内蔵しています。さらに動画からフレームを切り出して参照画像として使用することも可能です。
関連画像
推奨理由
- 新モデル(ワークフロー):作者は特に新しい H3 Image 用であり、H3 Video 用ではないと明記しています。キャラクターイラストや絵コンテのキャラ設定など、ポーズ制御と複数参照画像が必要な画像生成に向いています
- 機能が明確です:Pose Studio の切り替えはワークフローの変更なしで可能です。複数ソースからの画像比較機能、詳細なプロンプトテンプレート、Ref Loader で動画を読み込みフレームを選択後「Use Frame」をクリックすると参照画像として使用できます
- すべてのモデルへの直接リンクが提供されています:H3 Image int8 ConvRot ベースモデル(21 GB)、Qwen3-VL 32B int8 テキストエンコーダー(25.28 GB)、Qwen3.5 9B プロンプト拡張モデル(6.84 GB)、および H3 Image VAE
使い方
- 作者のリンクから4つのモデルをダウンロードし、diffusion_models / text_encoders / vae フォルダに配置して JSON をインポートします。サンプリングステップ数と CFG は作者が指定していないため(テンプレートのデフォルト値を使用)
リスクと制限
- 表示可能なサンプルがありません(5 件が非表示)。ライセンスには商用利用権に関する記載がありません
- 説明の後半は作者のコミュニティへの宣伝です
- カード画像は AI で生成された概要図であり、モデルの実際の出力結果ではありません。作者による公開済みの通常レベルのサンプルはありません
【B】Lonecat’s Simple Speed Boost 🚀 Workflows | 简易加速工作流 (MiniMax H3, Krea 2, Qwen 2.1, ZIT, Klein_9b, Illustrious, Flux, Wan2.2, Qwen Image Edit) · Simple Minimax Image 🖼️
ワークフロー · ポート · 作者 lonecatone23 · 公開 11-11 11:45 · ダウンロード数 22
Lonecat の簡易ワークフローコレクションに追加された H3 Image バージョン(Simple Minimax Image):コメント付きの H3 Image 参照画像生成ワークフローで、作者は肌の質感を改善するために skin master ノードを追加しました。
関連画像
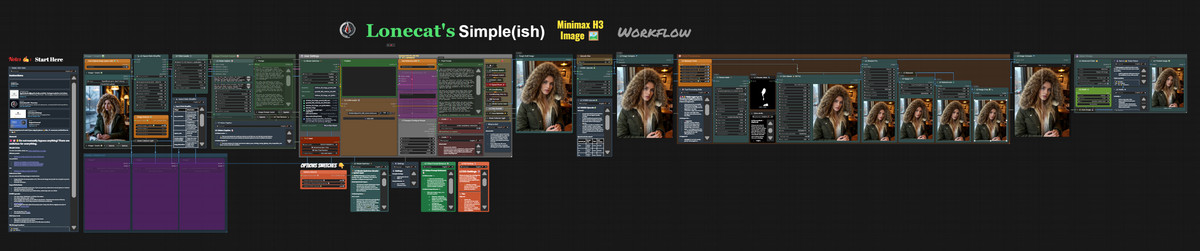
推奨理由
- バージョン更新(コレクションの新バージョン。前回の H3 バージョンは動画用の Simple MiniMax V2.1 でした):更新内容は2文のみで、基本ワークフローであり、元の画質が悪かったため skin master を追加したと説明されています
- コレクションの位置づけは、ComfyUI 初心者向けにカテゴリー分けされ、コメント付きで簡略化されたものです。作者のノードパックは GitHub で無料で提供されており、コメントは中国語に対応しています
- 2 枚の表示可能なサンプル画像があります。コレクション全体のダウンロード数は 31258 回であり、このコレクションが注目を集めていることを示しています
使い方
- JSON をインポートします(ファイル名 Simple MiniMax H3 Image Ref V1.0)。ノードが不足している場合は、作者の GitHub から lonecatone23 のノードパックをインストールしてください。サンプリングステップ数や CFG などは作者が指定していません
リスクと制限
- コレクションページの機能リスト(ControlNet、I2I、Speed Boost、ディテール修復)はコレクション全体のものであり、この H3 Image バージョンに具体的にどの機能が備わっているかは明確ではありません
- 説明が非常に短いです
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT6
ベースモデル / Checkpoint · バージョン更新 · 作者 tsolful · 公開 11-11 07:30 · ダウンロード数 9
同じページの H3 Image INT6(W6A8)量子化バージョンで、サイズは 15.61 GB です。INT8 と INT4 の中間に位置し、Comfy 公式リポジトリにはこの精度のバージョンはありません。
関連画像
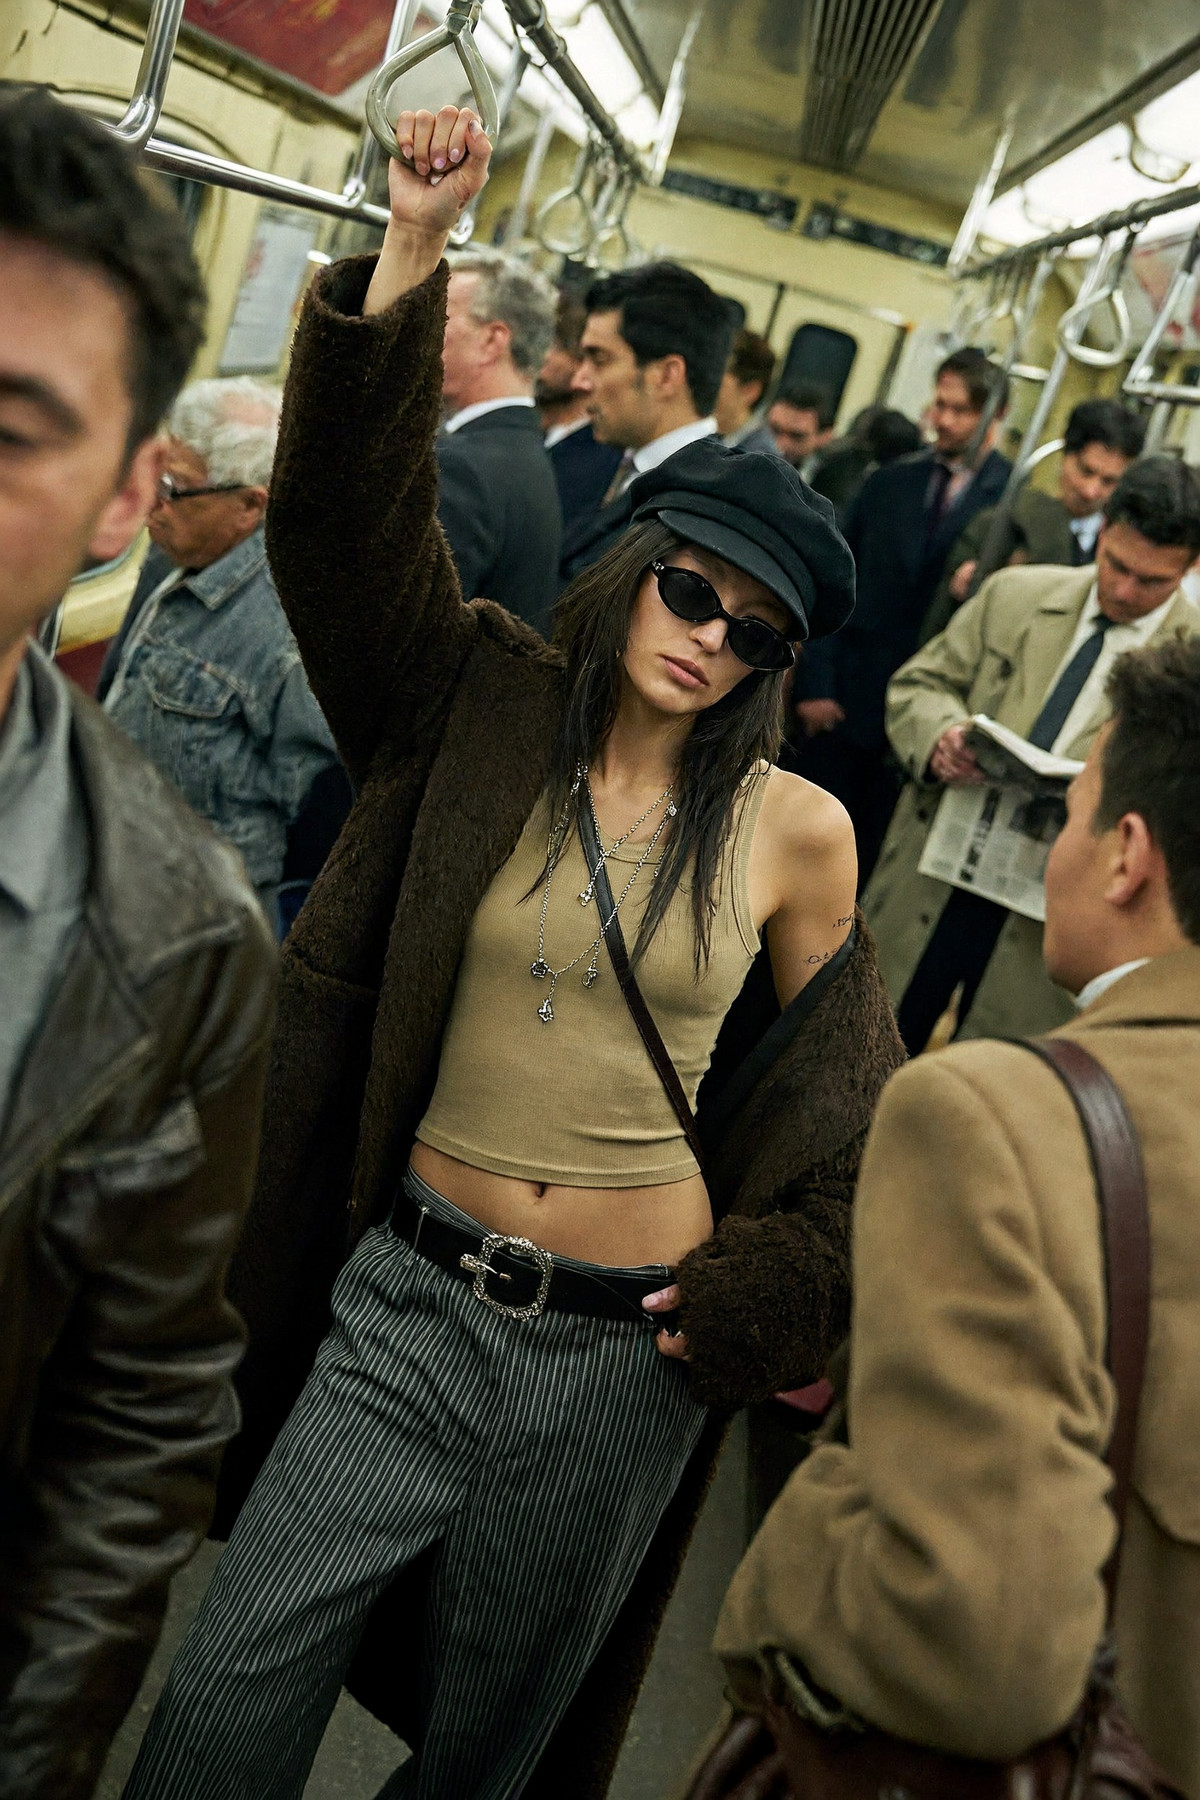
推奨理由
- バージョン更新(同ページの 2 番目のバージョン。INT8 とは並列の精度オプションであり、改良版ではありません):INT8 ではわずかにメモリが足りない GPU 向けです。作者によれば、INT8 より明らかにサイズが小さく、画質の劣化は小さいとのことです
- comfy-kitchen の PR #191 にある W6A8 カーネルパスに依存しています。1 枚の表示可能なサンプル画像があります
使い方
- 設定は INT8 と同じです:6 ステップ、CFG 1、公式 PDD サンプラー(作者は Euler_ancestral / simple を 6 ステップで使用)。テキストエンコーダーは H3 Video バージョンと共通で、VAE は H3 Image 専用の VAE を使用します
リスクと制限
- 作者は更新説明を書いていません(このバージョンは単に別の精度オプションです)
- W6A8 カーネルは comfy-kitchen のマージ未確定の PR に由来するため、ComfyUI のバージョンが適切でないと動作しない可能性があります。サンプルは 1 枚のみです。MiniMax-H3-Image のコミュニティライセンスには地域および用途に関する別の制限があります
収録のみ(4)
- (prevent melting faces)MiniMax H3-Image base workflow · base workflow — ワークフロー:「顔の崩壊防止」と名付けられた H3 Image の基本画像生成ワークフロー。モデルページの説明は句点1つだけです。
- Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT4 — ベースモデル / Checkpoint:同ページの H3 Image INT4(W4A8 GPTQ)量子化バージョンで、サイズは 12.77 GB です。3つの精度オプション中最小であり、VRAM の節約のみで速度向上はありません。
- mini max image - BETTER RESULTS workflow - very nice quality with FASTER prompt upsampler · v1.0 — ワークフロー:Qwen 2.1 の画像生成ワークフローを H3 Image 用に調整したシンプルなワークフローで、名称にはより高速なプロンプト拡張機能が備わっていることが示されています。
- MiniMax-H3-Image · v1.0 — ワークフロー:MiniMax-H3-Image と名付けられた画像生成ワークフローで、説明はタイトルと「v1」のみです。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-10 00:03 → 11-11 16:03(北京時間)。推奨理由は編集者によるレビュー済みです。ダウンロード数は単に注目度を示すものです。