貞貞のAIレーダー · MiniMax H3 Image · 2026-11-12 朝刊
今号の 4 個の新バージョン:強く推奨 1 · 推奨 2 · 注目 1 · 収録のみ 0
編集者按 今号では 4 個の H3 Image 新バージョンをレビューしました。すべてワークフローまたはベースモデルの再パッケージであり、新しい LoRA はありません。初推は LatentJack の H3 Image Studio V2.2 です。1つのワークフローでテキストから画像生成、複数参照画像による画像編集、写真から深度マップへの変換による構図ガイドが可能で、LCM ステップ数は 6、最大解像度は約 20 MP です。AusBoss ワークフロー v1.1 では、画像編集モードでも自動プロンプト拡張が利用可能になり、フル INT8 ベースモデルは、ComfyUI ネイティブ環境で動作しなかった qkv 並べ替えの問題を解決しました。これらはすべて A ランクです。Onyx の簡易デュアルワークフローは表示可能なサンプルが 1 枚のみであるため、B ランクとしました。
強く推奨(1)
【S】Simple Minimax H3 Image 生成/画像編集ワークフロー · V2.2
ワークフロー · 新モデル · 作者 LatentJack · 公開 11-12 07:21 · ダウンロード数 24
H3 Image の統合型 ComfyUI ワークフロー:テキストから画像生成、最大15枚の参照画像を用いた画像編集、さらに写真から深度マップへの変換による構図ガイドに対応し、デフォルトで LCM ステップ数は 6 です。
参照画像の番号は「有効化」された入力に連動します。スイッチを変更した場合は、プロンプト内の Picture 番号を再確認してください。
画像
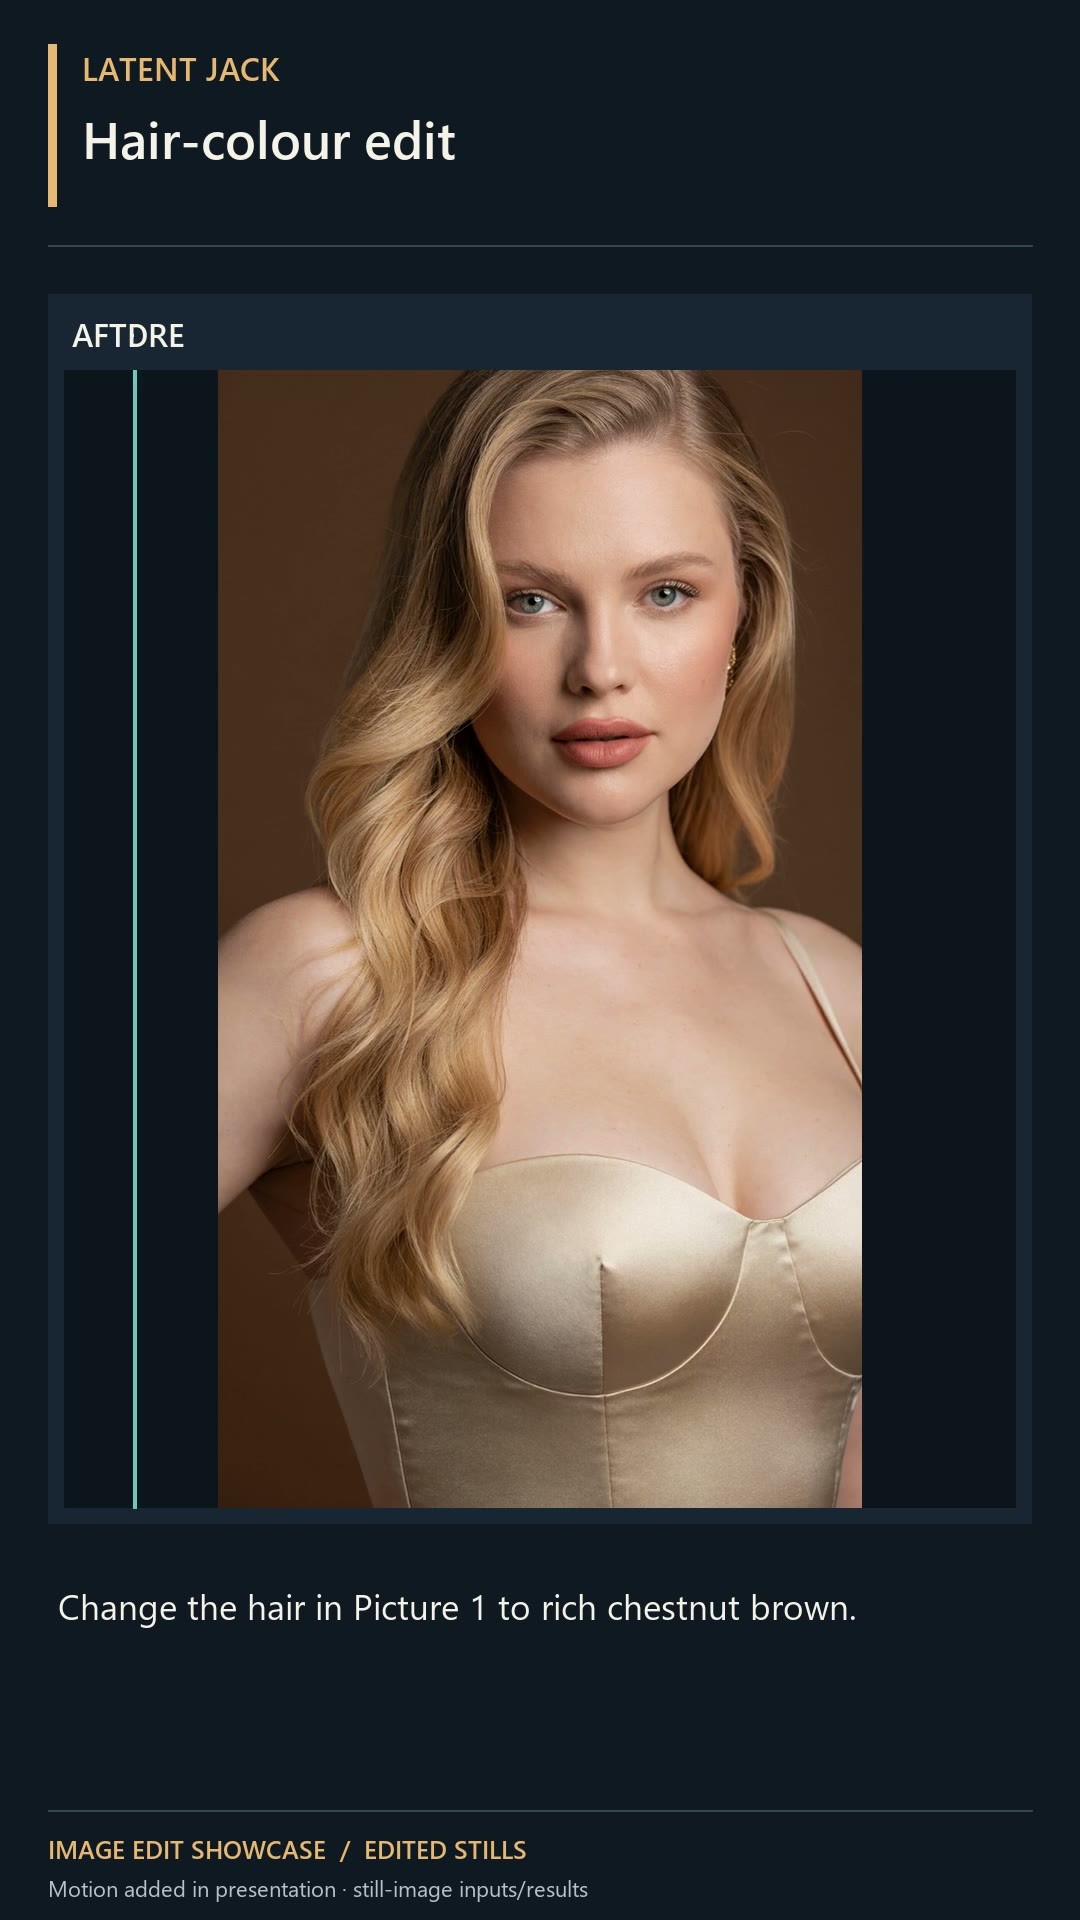
推奨理由
- 1つのワークフローで3つの用途をカバー:純粋なテキストから画像生成、参照画像に基づく画像編集(服の着せ替え、2人の合成など)、および Depth Anything V2 Large を使用して写真を深度マップに変換し構図を固定
- 説明が非常に詳細:サンプリングパラメータ(SamplerLCM、s_noise 1.1 → 0.9、simple スケジューラ、6 ステップ、CFG 1)、メガピクセル単位のサイズ選択、参照画像の番号付けルール(有効化された入力のみを <Picture 1>、<Picture 2> として再番号付け)など、すべてスクリーンショット付きで解説
- 2 本の動画 + 16 枚の表示可能なサンプル;ダウンロードパッケージは MIT ライセンスのワークフロー JSON と、必要な2つの補助ノードフォルダを含む
使い方
- 解凍後ワークフローをインポートし、作者の指示第 8 節に従って外部ノードパッケージとモデル(重みはパッケージに含まれていません)をインストール
- デフォルトは SamplerLCM、simple、Steps 6、CFG 1、Denoise 1;まず人物/顔/目のリファイナをオフにしてベース画像を生成し、その後個別に有効化して試行
- 画像編集時は参照画像サブグラフで対応する入力の Include picture を有効化し、ポジティブプロンプトで各画像から何を取得するか明確に記述;深度ガイドが必要な場合は Enable depth guide を有効化
リスクと制限
- 人物/顔/目のリファイナは作者により実験的とされており、デフォルトで無効
- 作者のサンプルは RTX 5090 32 GB でローカル生成されており、他のGPUのVRAM要件を保証するものではないと明確に述べられている;高解像度や複数参照画像はより多くのVRAMを消費
- 2 件のセンシティブレベルのサンプルは非表示
推奨(2)
【A】MiniMax H3 Image 生成 + 編集 | 16 MP, 8 画像 · v1.1
ワークフロー · バージョン更新 · 作者 AusBoss · 公開 11-12 07:12 · ダウンロード数 47
AusBoss の H3 Image 生成 + 編集ワークフロー v1.1:自動プロンプト拡張(Auto prompt)が画像編集モードでも利用可能になり、接続された各画像を確認した上で修正説明を生成します。
画像
推奨理由
- バージョン更新:v1.0 の Auto prompt はテキストから画像生成のみに対応していましたが、v1.1 では画像編集時にも利用可能に——数語(例:「vampire」「winter」)を入力すると、メイン画像とすべての参照画像を確認した上で完全な修正説明を生成;Auto prompt を無効にした場合、同じ設定での出力は v1.0 と完全に一致
- ワークフロー一式:4 MP / 16 MP の2段階サイズ、画像編集では最大 7 枚の参照画像を追加可能、Fast モードでは pDMD 2 ステップ LoRA を使用、オプションで SeedVR2 を使用して 4 MP の結果を2倍にアップスケール
- 依存関係が完全に記載:高/低VRAMの2種類のベースモデル、テキストエンコーダ、VAE、Auto prompt 用の小型モデル、2 ステップ LoRA と SeedVR2 のそれぞれの配置ディレクトリが列挙されている
使い方
- まず ComfyUI(H3 Image サポートが追加された 2026-11-10 以降のバージョンが必要)と AusBoss ノード(作者は 2.23.0 を使用)を更新し、ワークフローを ComfyUI にドラッグして直接 Run
- 画像編集:Edit a picture を有効化し、画像を読み込んで修正内容を記述;参照画像は Write the prompt の picture 2 以降に接続し、プロンプト内で「picture 2」と明示的に言及
- Fast モードでは 6 ステップではなく 2 ステップを実行;作者は Fast モードでは構図がタイトになりがちで、小さな文字がエラーになりやすいと警告しており、ポスターやカバーには使用しないよう推奨
リスクと制限
- 依存モデルが多く容量も大きく、作者が列挙した高VRAMベースモデルとエンコーダだけで数十 GB 必要
- 作者は Auto prompt が画像編集時に大きな変更を加える可能性があると述べており、小さく精密な修正を行いたい場合は無効にすべき
- 動画は 1 本 + サンプル画像は 1 枚のみ
【A】MiniMax H3-Image フル INT8 (ComfyUI 用 QKV 修正版) · v1.0
ベースモデル / Checkpoint · 新モデル · 作者 xiaoyueblandon205 · 公開 11-12 01:25 · ダウンロード数 53
オリジナルのフル(非プルーニング)MiniMax H3-Image 33.1B の INT8 重みで、qkv_proj を並べ替えることで、フルモデルを ComfyUI ネイティブノードで直接実行可能にしました。
画像
推奨理由
- 具体的な問題を解決:オリジナルの qkv_proj は各アテンションヘッドごとにインターリーブ配置されていましたが、作者はこれを連続配置に並べ替えたため、コード変更やカスタムノード作成なしにフルモデルをロード可能
- 一般的なプルーニング版とは異なり、これは非プルーニングのフルパラメータで、INT8 に量子化;テキストから画像生成と最大 16 枚の参照画像を用いた画像編集に対応
- 作者がパラメータを提供:6 ステップ、guidance 1.0、ネイティブ 16MP、CFG とネガティブプロンプトは不要;11 枚の表示可能なサンプル
使い方
- models/diffusion_models に配置し、ComfyUI ネイティブの H3 Image フローでロードして、元のベースモデルを置き換え
- 6 ステップ、guidance 1.0、ネガティブプロンプトは記述しない;解像度はネイティブの 16MP に設定
リスクと制限
- 単一ファイルで 31.7 GB あり、VRAM とディスク容量の要件が高く、作者は必要な VRAM 量を明記していない
- 公式重みの量子化再パッケージであり、新規学習ではない;ライセンスは MiniMax H3-Image コミュニティライセンスに準拠
- 5 件のセンシティブレベルのサンプルは非表示
注目(1)
【B】Minimax H3 Image T2I & I2I 簡易ワークフロー 1girl · v1.0
ワークフロー · 新モデル · 作者 OnyxAI · 公開 11-12 02:53 · ダウンロード数 108
Onyx の2つの H3 Image 簡易ワークフロー(テキストから画像生成、最大 4 枚の参照画像を用いた画像編集)は、ネイティブノードと CRT フィルムグレインのみを使用し、スマートフォンで直接撮影したような写実的な写真を目標としています。
画像
推奨理由
- 2つのワークフローを分離:テキストから画像生成は英語の説明を直接記述;画像編集は <Picture 1> などの記法で参照画像を引用し、服、シーン、ポーズの変更時に人物を保持、公式プロンプト拡張スイッチを内蔵
- 作者のパラメータ:6 ステップ、CFG 1、16 MP 3:4、Comfy Kitchen attention で高速化、HDR VAE + CRT グレインでスマートフォン写真の質感を再現
使い方
- ComfyUI 0.45.0+ と ComfyUI Manager の CRT Post-Process Suite が必要;モデルダウンロードリンクはワークフロー左側の説明ノードに記載
- 6 ステップ、CFG 1、デフォルト 16 MP 3:4、調整可能
リスクと制限
- 表示可能なサンプルは 1 枚のみ(別途 2 枚のセンシティブレベルは非表示)、スマートフォンの写実効果は作者の主張
- 今号の他の2つの H3 Image ワークフローと機能が重複しており、優位性は主にノード数の少なさ
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-11 21:03 → 11-12 09:33(北京時間)。推奨理由は編集者によるレビュー済み;ダウンロード数は注目度を表すのみ。