ジェンジェンの AI レーダー · MiniMax H3 Image · 2026-11-15 朝刊
今号の新バージョン 4 件:強く推奨 0 · 推奨 1 · 注目すべきもの 2 · 収録のみ 1
編集者による注釈 今号では H3 Image の新バージョンを 4 件レビューし、A ランクが 1 件、B ランクが 2 件、C ランクが 1 件でした。初推薦は AI インフルエンサー 12GB ワークフロー集です:12 GB の GPU で H3 Image ネイティブノードを使い、まずキャラクターを作成し、次に同じ顔を新しいシーンに配置します。作者はモデルファイルと設置パスをすべて記載しています。視覚的プロンプト拡張機能を備えたワンクリックインストーラー v2.0 は、LLM 指示とプリセットスタイルのみを変更しており、サンプルが 1 枚しかないため B ランクに下げました。Fyre キャラクター LoRA は完全なトレーニング設定を添付しているため B ランクです。説明が一文のみの入門ワークフローは C ランクです。
推奨(1)
【A】AI Influencer 12GB — 4 ワークフロー:キャラクター作成、新規シーンでの同一顔維持、Viggle Remake スワップ、MiniMax H3 ビデオ · v1.0.0
ワークフロー · 新モデル · 作者 The_frizzy1 · 公開日 11-15 03:11 · ダウンロード数 31
4 つのワークフロー集:H3 Image のテキストから画像生成機能で架空のキャラクターを作成し、クローズアップとプロンプトを使って同じ顔を新しいシーンに配置します。さらに、Viggle Remake による人物交換と、H3 の画像から動画生成を行う 2 つのビデオワークフローも含まれています。
サンプル画像
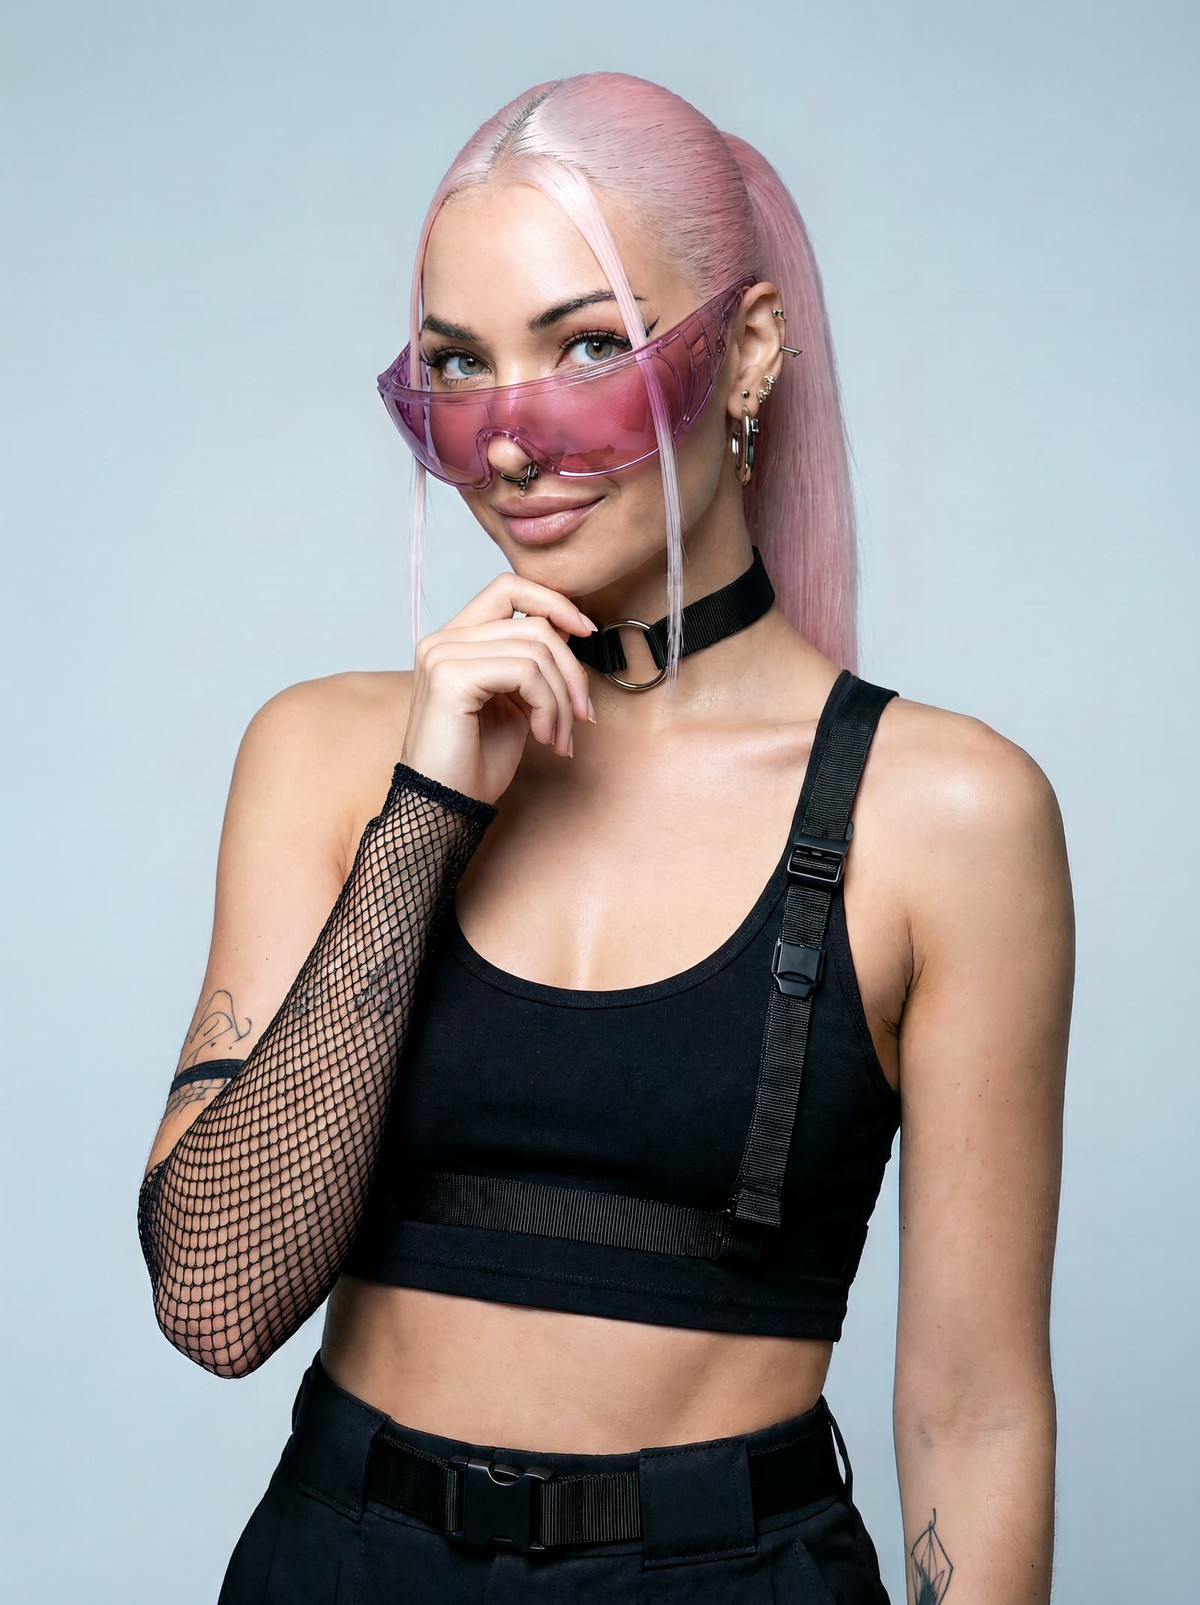
推奨理由
- 「同一キャラクターを複数シーンで出力する」ニーズに対応:ワークフロー 1 と 2 は ComfyUI ネイティブノードのみを使用しており、画像のみを投稿するアカウントであればこの 2 つで十分です
- 作者は RTX 3060 12 GB でテスト済みと述べており、ピーク VRAM は 11.6 GB です。ComfyUI バージョン 0.45 以降が必要です(旧バージョンには H3 Image ノードがありません)
- 再現可能:モデルカードにファイル名、サイズ、ダウンロード URL、設置ディレクトリが個別に記載されており、圧縮パッケージには動画で使用されたすべてのプロンプトが含まれています。GitHub にはステップバイステップのガイドもあります
使い方
- ワークフロー 1 と 2 には 3 個のファイルが必要です:minimax_h3_image_pruned_w4a8(diffusion_models)、qwen3vl_32b_minimax_h3_nvfp4_awq(text_encoders)、minimax_h3_image_vae_fp16(vae)
- キャラクター作成時は、写真の説明を書くように人物、髪型、アクセサリー、服装、場所、照明、カメラアングルを記述します。作者は長いプロンプトの方が良いと述べています
- ワークフロー 3 には Viggle ノードパッケージが必要です。ワークフロー 4 では、公式の minimax_h3_fl2v_turbo_8step 加速 LoRA を使用して画像から動画生成を行います
リスクと制限
- 表示可能なサンプルは 2 枚のみで、3 枚は非表示です。ページ内容は混在しています
- ビデオ部分のモデルは非常に大きく(単一の拡散モデルで約 21 GB)、システムメモリ使用量のピークは 16–22 GB です
- ワークフローは MIT ライセンスですが、H3 / H3 Image の重みは MiniMax コミュニティライセンスであり、商用利用前に自分で確認する必要があります
注目すべきもの(2)
【B】検閲なしの視覚機能付き H3 Image(インストーラー + ワークフロー) · v2.0
ワークフロー · バージョン更新 · 作者 Torque · 公開日 11-14 22:16 · ダウンロード数 131
H3 Image の Windows ワンクリックインストーラー + ワークフロー:1 つのワークフローでテキストから画像生成と、最大 15 枚の画像を用いた複数参照編集を同時に行い、プロンプト拡張モデルは「画像を見る」ことができます。
サンプル画像
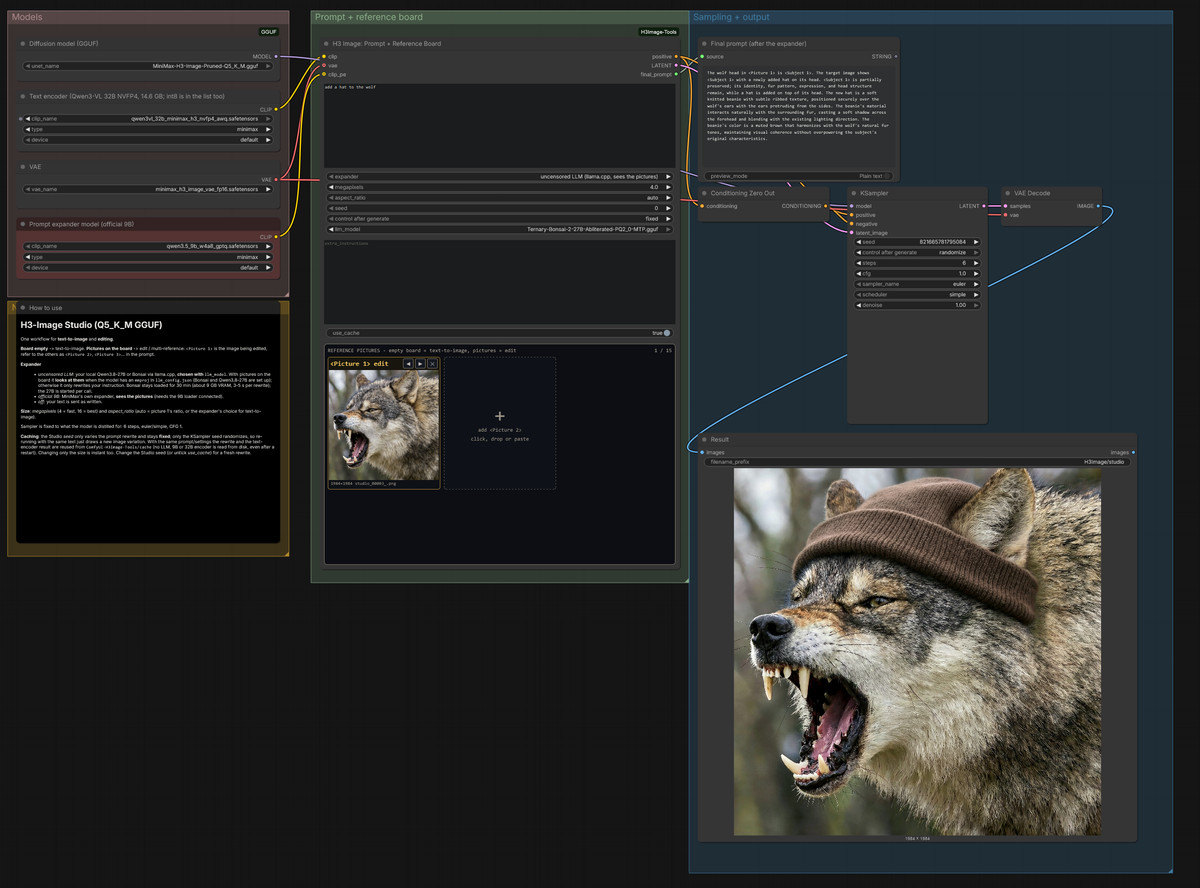
推奨理由
- バージョン更新:作者は「LLM 指示の改善とプリセットスタイルの追加」のみを記載しています
- 機能:リファレンスボード上の画像は自動的に <Picture N> とラベル付けされ、拡張器が画像を見た後に短いプロンプトを長い説明に拡張します。公式の 9B 拡張器または 27B の Bonsai LLM を選択可能です
- インストーラーは VRAM に応じて GGUF 量子化を自動的に選択し(24 GB 以上では Q5_K_M)、RTX 50 シリーズでは NVFP4 テキストエンコーダーを使用し、それ以外では int8 を使用します
使い方
- 解凍後、Install_H3Image.bat を実行し、ライセンスを読んで YES と入力します。インストール完了後、Start_H3Image.bat を実行し、ワークフローブラウザ(W)で H3Image_Studio を読み込みます
- リファレンスボードが空であればテキストから画像生成となり、画像を配置すれば編集モードになります。約 56 GB の空きディスク容量が必要です
リスクと制限
- 作者は「vibe coded」と自称しており、インストールスクリプトは ComfyUI v0.45.0 ポータブル版の固定セットと大量のモデル(約 40 GB、Bonsai を含むと約 49 GB)をダウンロードします
- RTX 5090 32 GB でのみテスト済みです。表示可能なサンプルは 1 枚のみです
- 名称の「uncensored vision」は、拡張モデルがコンテンツフィルタリングを行わないことを指しますが、作者はこれ以上説明していません
【B】Fyre(架空キャラクター) · h3-image-v01
LoRA · ポート · 作者 jandordoe · 公開日 11-14 23:49 · ダウンロード数 32
赤毛でそばかすのある架空の女性キャラクター Fyre の H3 Image キャラクター LoKr です。完全な ai-toolkit トレーニング設定を添付しており、H3 Image でキャラクターをトレーニングする際の参考として使用できます。
サンプル画像
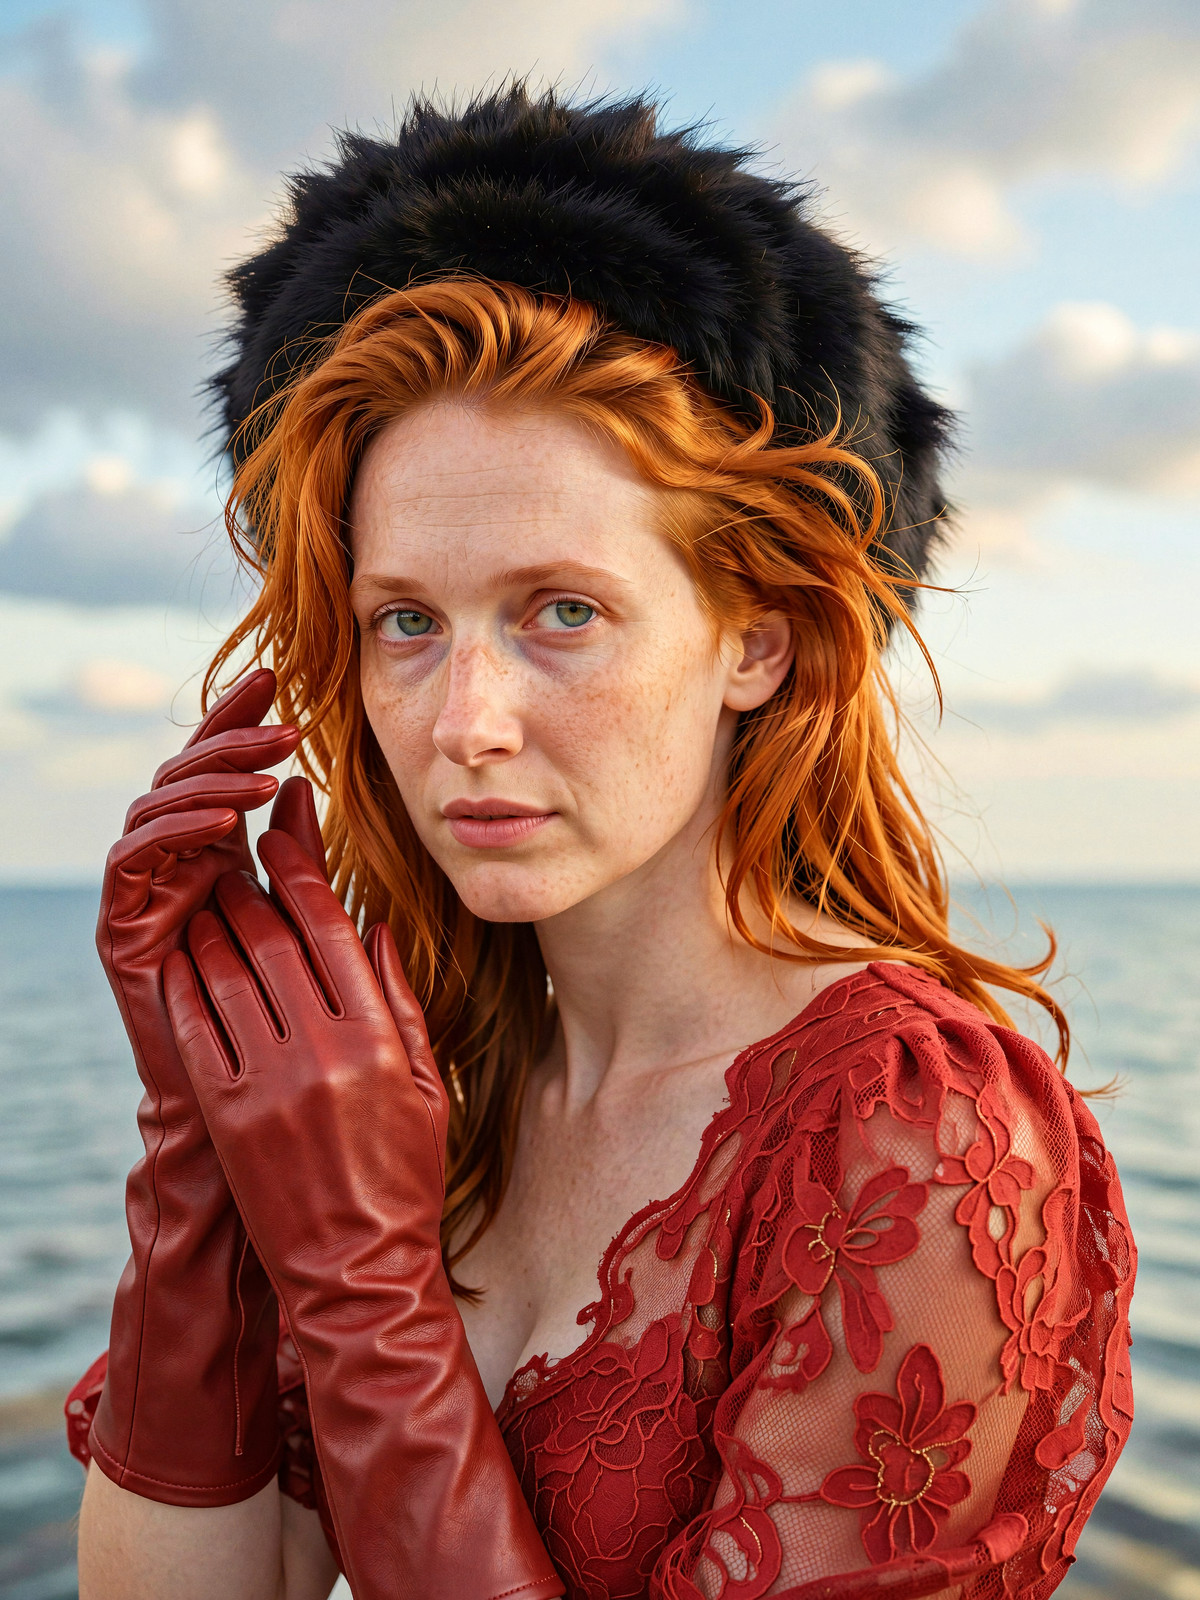
推奨理由
- ポート:同一キャラクターにはすでに MOSS、Qwen 2.1、Krea 2、Wan 2.2 などのバージョンがあります。H3 Image バージョンは ai-toolkit + Ostris トレーニングアダプターを使用して 3,000 ステップでトレーニングされました
- トレーニングパラメータがすべて記載されています:lokr factor 4、automagic v3、LR 0.0005、EMA 0.98。設定ファイル config-h3-image-v01.yml が添付されています
- 作者は 2,000 ステップで既に良好な類似度に達しており、3,000 ステップではわずかに向上すると述べています
使い方
- トリガーワード:Fyre。強度、ステップ数、CFG については作者から提供されていません
リスクと制限
- トレーニング画像は 20 枚の Klein 9b 生成画像です。作者はサンプルを選別していないと説明しており、少なくとも 2 枚に解剖学的な問題があります
- 1 枚のサンプルが表示可能で、10 枚が非表示です。重みサイズは約 2.3 GB で、一般的なキャラクター LoRA よりもはるかに大きいです
- 通常の架空人物 LoRA であり、トレーニング設定以外に特別な機能はありません
トリガーワード:Fyre
収録のみ(1)
- Wikked MiniMax H3 Image ワークフロー · v1.0 — ワークフロー:作者は H3 Image の入門用シンプルなテキストから画像生成ワークフローであると述べています。
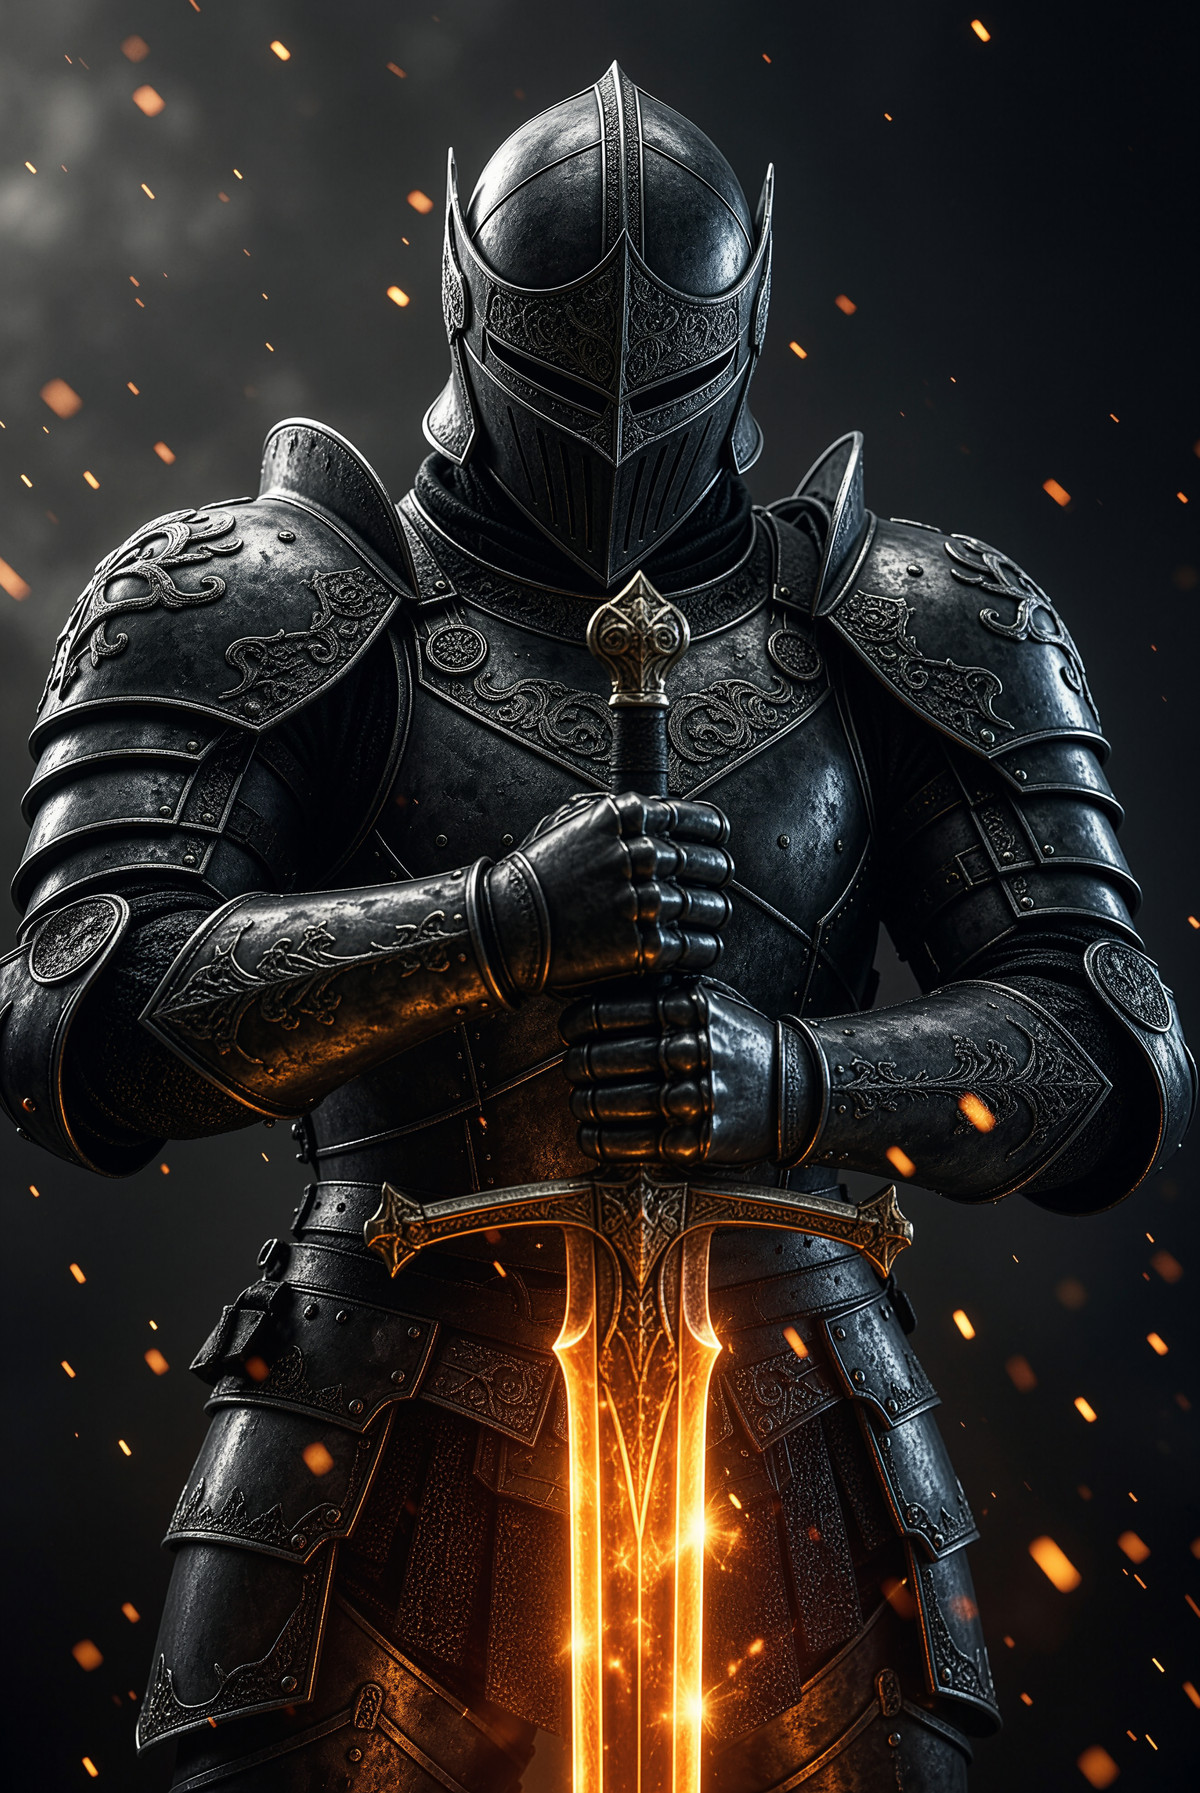
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-14 20:31 → 11-15 09:01(北京時間)。推奨理由は編集者によるレビュー済みです。ダウンロード数は注目度を表すに過ぎません。