貞貞のAIレーダー · MiniMax H3 Image · 2026-11-17 朝刊
今号の 6 個の新バージョン:強く推奨 1 · 推奨 1 · 注目 1 · 収録のみ 3
編集者按 今号では 6 個の H3 Image 新バージョンをレビューしました。すべてワークフローであり、新しい重みはありません:S が 1 個、A が 1 個、B が 1 個、C が 3 個。初推しは bambushu のシード選択ワークフロー v3.0 です。まず 4 MP で素早くシードを選び、選んだ画像を参考にして 16 MP で再レンダリングし、撮影メディアのドロップダウンメニューで顔が過度にシャープな HDR 感を抑えます。作者は操作手順、速度、既知の失敗パターンを提供しています。mo_akkakk が同じバッチでアップロードした「全体画像編集」と「マスクによる局所再描画」の 2 つのワークフローは、グラフ構造がほぼ同じで、違いはマスクの拡張、トリミング、貼り戻しの部分のみです。マスク版は B、全体画像版は C に分類しました。リアルタイムプレビュー付きの基本テキスト生成画像は、自動 S から A に格下げしました。「Free Lite」は $39 の有料パッケージへの集客用版で、2048×2048 の基本テキスト生成画像のみを含み、自動 A から C に格下げしました。「Improve WF」v2.0 の更新説明は「FIX MORE」のみで、C に分類しました。
強く推奨(1)
【S】MiniMax H3 Image: Seed Hunter + medium picker (ComfyUI) · v3.0
ワークフロー · 新モデル · 作者 bambushu · 公開 11-16 21:31 · ダウンロード 66
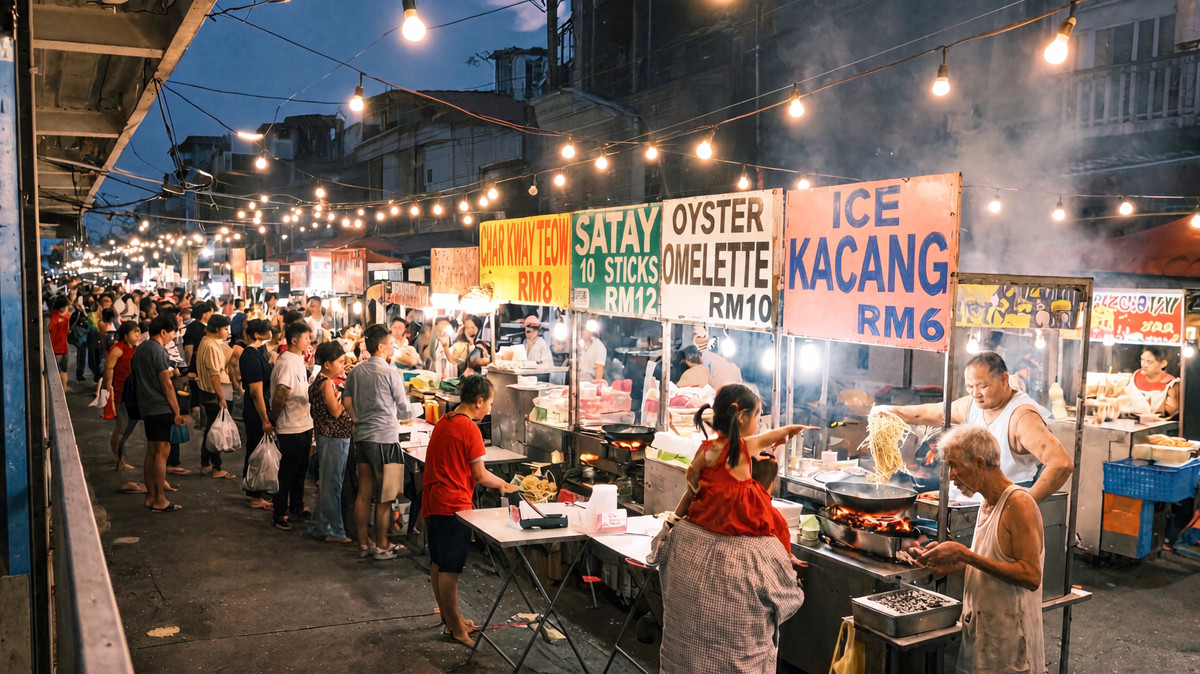
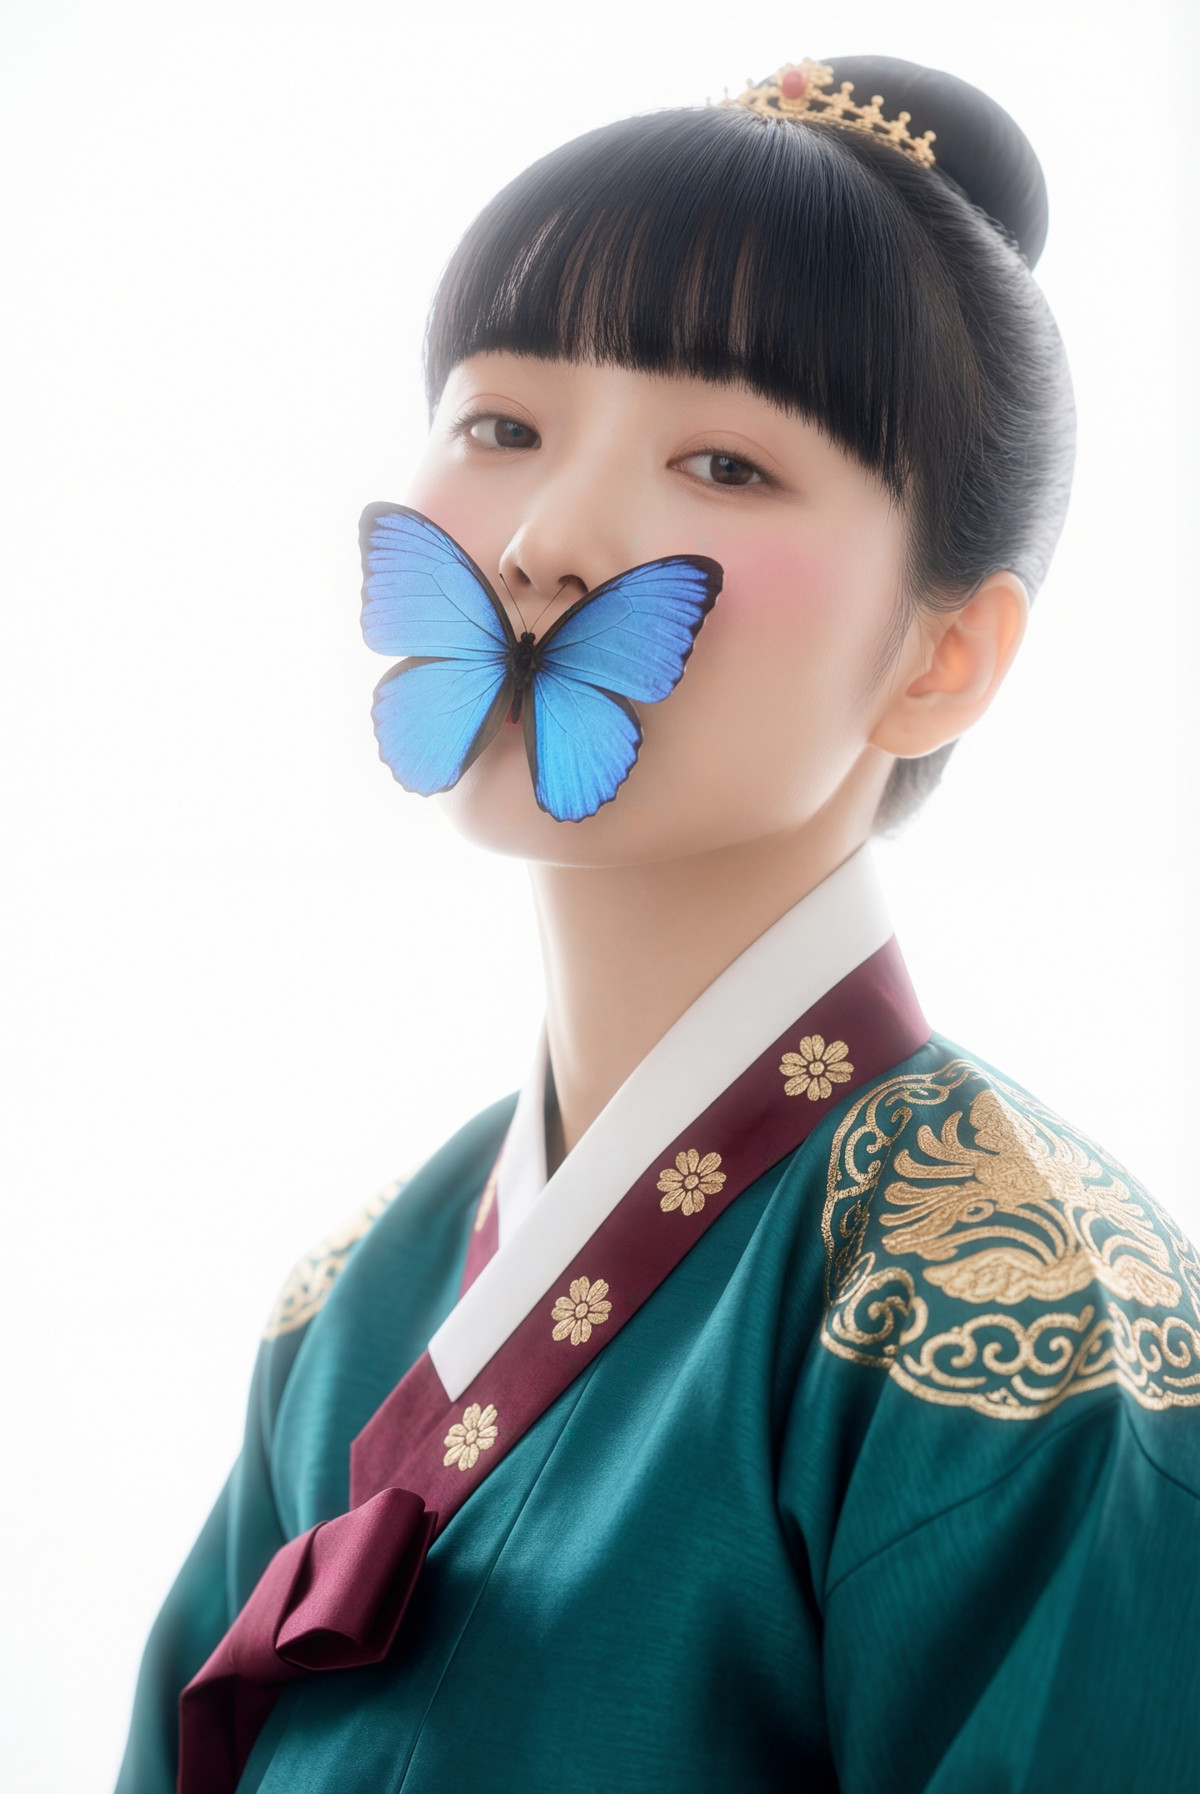
H3 Image のシード選択ワークフロー v3.0 です。まず 4 MP で複数のシードを実行して構図を選び、選んだ画像を <Picture 1> として完全なプロンプトとともに 16 MP で再レンダリングします。さらに「撮影メディア」のドロップダウンメニューがあり、H3 Image がメディアを指定しない場合に顔が過度にシャープになる HDR 感を抑えます。ComfyUI のネイティブノードのみを使用しています。
今号のリアルタイムプレビュー付き基本テキスト生成画像ワークフローと比較して見てください。一方は「効率的に画像を選ぶ方法」を解決し、もう一方は「生成中の進捗確認と、肌への塗りつぶしを防ぐためのサンプラー変更」を解決します。
画像
推奨理由
- 具体的な問題を解決:作者によると、H3 Image はサイズを変更すると同じシードでも同じ画像にならず、「小さい画像で良いシードを選んでから拡大する」ことができないため、選んだ小さい画像を参考にして再レンダリングする方式に変更しました。構図、人物、テキストは引き継がれ、16 MP のステップでディテールを補完し、完全なプロンプトで小さな誤りを修正することもできます。
- メニュードロップダウンでは、35mm フィルム、フルサイズデジタル、スマホ自撮り、スマホメインカメラ、または「なし」を選択できます。作者によると、フィルムの肌色が最も自然で、スマホのオプションは UGC スタイルの写真に適しています。イラスト、ポスター、スタジオ撮影の商品画像は「なし」を選択し、自分でメディアを指定してください。
- v3.0 は公式の ComfyUI テンプレートに基づいて再構築され、コアノードのみを使用しています。作者は RTX PRO 4500(32 GB)と 57 GB メモリでテストし、各 4 MP のシード選択に約 6.5 秒、各 16 MP の最終画像生成に約 75 秒かかると報告しています。ComfyUI はメモリから 21 GB のモデルをストリーミングロードすると述べています。
- 10 個のシナリオのデモを添付(このページでは 6 枚表示)。各シナリオのプロンプト、アスペクト比、4 個の候補シード、最終選択は demos.json に記載されています。無料であり、ライセンスは画像の出力と販売を許可しています。
使い方
- まずメディアを選択してからシナリオを記述します。画面に表示するテキストは二重引用符で囲み、pores、8k、hyper-detailed などの肌やシャープネスに関する単語は書かないでください。アスペクト比を選択します。
- Run ボタン横の数字を 4 に設定し、シードを increment に設定して 1 ラウンド実行すると、hunt_s<シード> が 4 枚得られます。気に入ったシードを戻して fixed に設定し、「4 · FINAL」グループタイトルをクリックして Ctrl+M で有効化し、再度実行して 16 MP を出力します。次のシード選択の前に、再度 Ctrl+M でそのグループを無効化し、シードを increment に戻します。
- モデルは Hugging Face の Comfy-Org から入手します:minimax_h3_image_pruned_int8_convrot(21 GB)、qwen3vl_32b_minimax_h3_int8_convrot テキストエンコーダー、fp16 VAE。
リスクと制限
- 作者が列挙した既知の問題:衣服の小さなロゴの文字が乱れる、本棚の背表紙の一部が文字化けする、群衆内の遠くの小さな顔は 16 MP でもぼやける。ラベルに「plain」と書くと空白になるため、具体的な文字を書く必要があります。選択した画像内のテキストエラーは最終画像に引き継がれます。
- 完全なモデルカードには、ComfyUI master の 2026-11-12 以降が必要と明記されています。48 GB の Mac では、1 プロセス内で 21 GB のモデルと 25 GB のテキストエンコーダーを同時に収めることができません。64 GB 以上は未テストです。
- モデルは一度に 1 枚しか出力できず、シード選択はバッチではなくキューによる単発実行です。2 個の例は非表示になっています。
- 同じページの v1、v2 は、H3 ビデオモデルを単一フレームエディタとして使用した旧方式です。作者によると、GitHub リポジトリは非公開になっており、Mac 用ソリューションが依存するファイルは古くなっています。
推奨(1)
【A】Simple Txt2Img with Preview — H3 Image Workflow · v1.0
ワークフロー · 新モデル · 作者 spacejumper2021824 · 公開 11-16 21:52 · ダウンロード 57
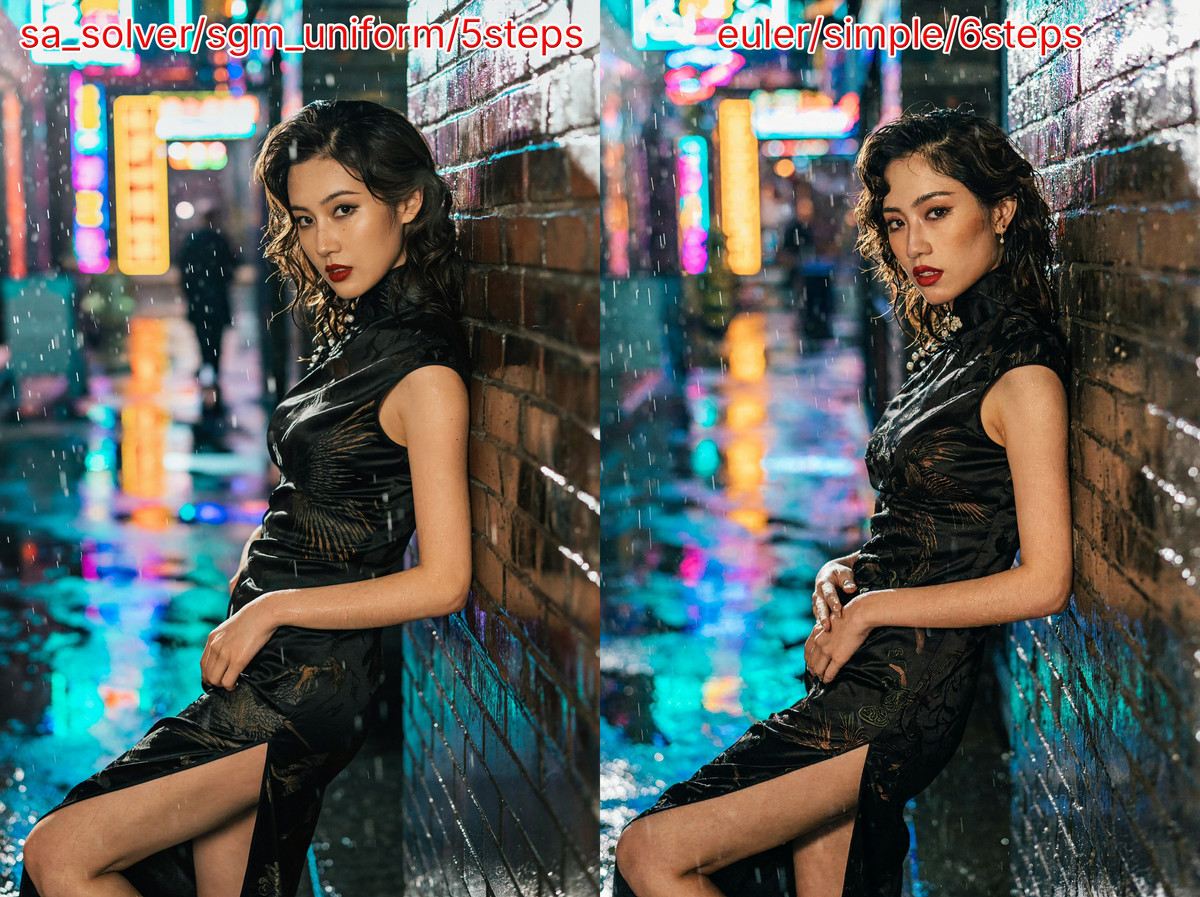
H3 Image の基本テキスト生成画像 ComfyUI ワークフローに、リアルタイムプレビューを追加しました。KJNodes の ModelPreviewOverrideKJ と taeh3_image 小型 VAE を使用し、サンプリング中に画面の進行状況を確認できます。
画像
推奨理由
- リアルタイムプレビューにより、16 MP のような生成に時間がかかる単一画像でも、デコード完了を待たずに途中で停止するかどうかを判断できます。
- 作者は 2 種類のサンプリングを提供しています。公式推奨は euler / simple 6 ステップ。作者自身の推奨は sa_solver + sgm_uniform 5 ステップ、cfg=1、denoise=1 で、画像のノイズが強い場合や写実的な肌が平滑化・ぼやけた場合に切り替えるよう推奨しています。
- 必要なモデル、カスタムノード、配置ディレクトリが明確に記載されています。4 枚のサンプル画像を添付。無料であり、ライセンスは画像の出力と販売を許可しています。
使い方
- Manager から ComfyUI-KJNodes と rgthree-comfy をインストールします。minimax_h3_image_pruned_int8_convrot(約 21 GB)、qwen3vl_32b_minimax_h3_int8_convrot、minimax_h3_image_vae_fp16 をダウンロードし、taeh3_image.safetensors(4.96 MB)を models/vae_approx/ に配置します。これがないとプレビューノードでエラーが発生します。
- デフォルトは 4096×4096(16 MP、1:1)で、ResolutionSelector ノードでサイズを変更します。ワークフローには Power Lora Loader が含まれており、LoRA を直接適用できます。
リスクと制限
- 本質的には基本テキスト生成画像のグラフ構造にプレビューを追加したもので、新しい機能はありません。sa_solver の 5 ステップが公式設定より優れているのは作者の個人的な推奨であり、並列比較はありません。
- VRAM 要件は作者によって記載されていません。2 個のセンシティブな例は非表示になっています。
注目(1)
【B】minimax_h3_image_edit_masking_cropping (Inpainting) · v1.0
ワークフロー · 新モデル · 作者 mo_akkakk · 公開 11-17 01:00 · ダウンロード 70
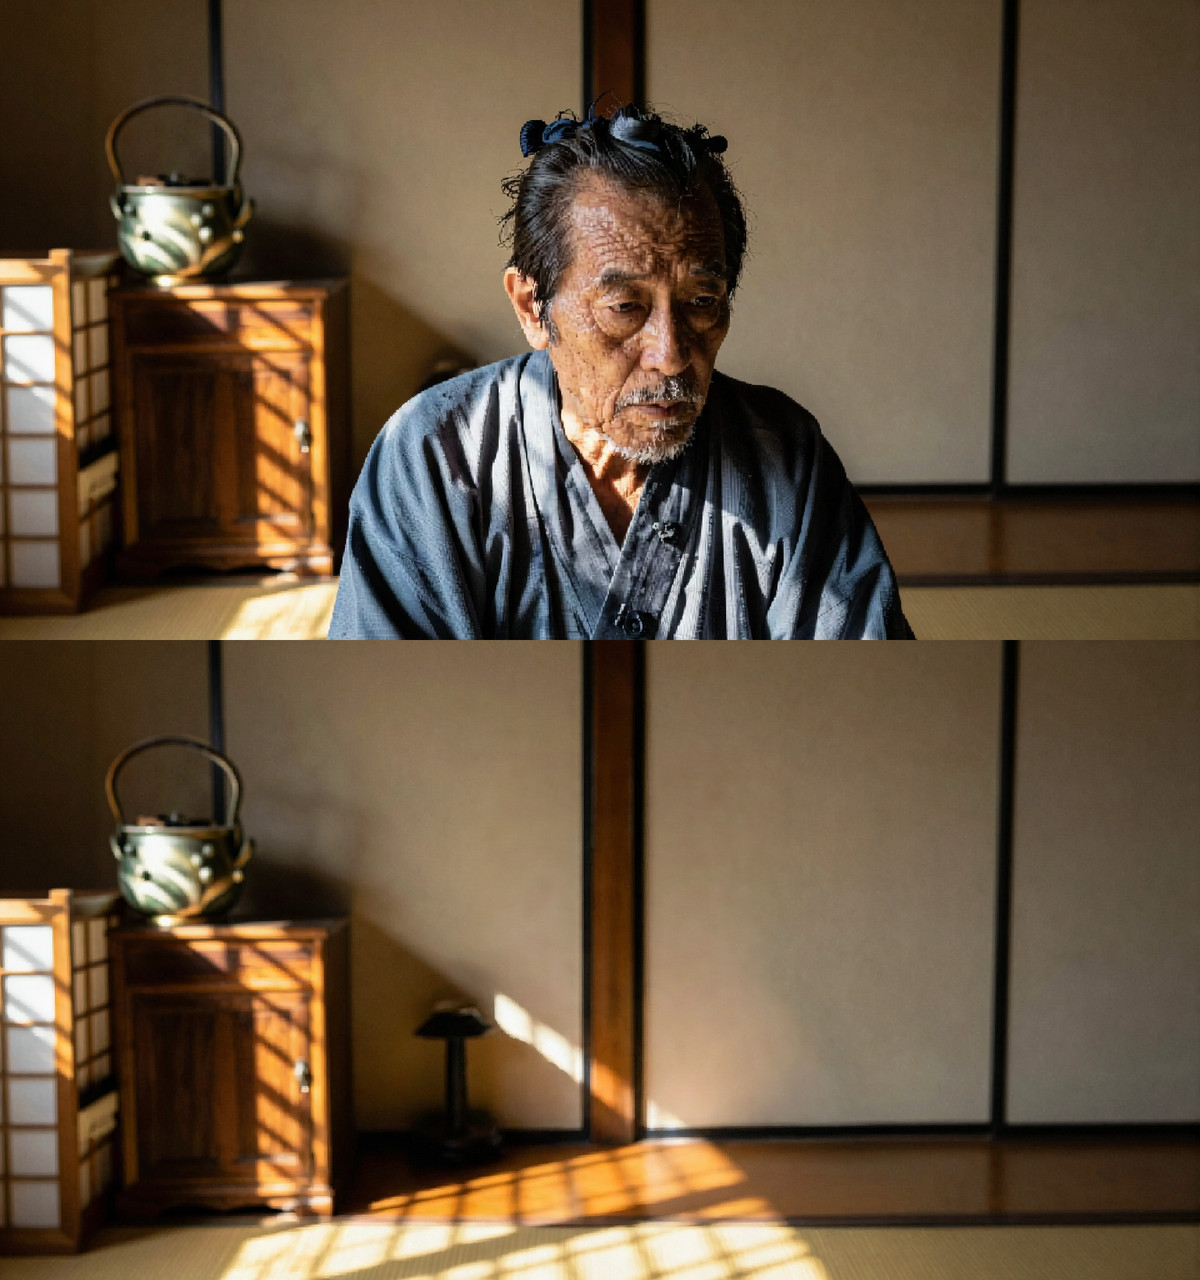
mo_akkakk の H3 Image 局所再描画(inpainting)ワークフローです。元画像にマスクを描き、指示を一文記述すると、ワークフローがマスクを拡張・ぼかし、マスクに基づいて局所をトリミングして再描画し、元画像に貼り戻します。塗った領域のみが変更されます。
画像
推奨理由
- 同じ作者が同じバッチでアップロードした minimax_h3_image_edit とは同じグラフ構造(同じモデル読み込み、指示入力、3 個の参考画像スロット、デフォルトで無効なプロンプト拡張グループ)ですが、マスクの拡張、トリミング、貼り戻しの部分が追加されており、サンプラーが euler から euler_ancestral に変更されています。
- 画面の一部のみを変更したい編集に適しています。例えば、人物や物の除去、部分着せ替えなど。ワークフローに組み込まれたサンプル指示は "remove woman and her reflection" です。
- 公開 8 時間で 70 回のダウンロードを記録し、今号の H3 Image で最もダウンロードされたバージョンです。無料であり、ライセンスは画像の出力と販売を許可しています。
使い方
- LoadImage 上で ComfyUI のマスクエディタを使用して変更したい領域を描き、Prompt グループに編集指示を記述します。追加の参考画像が必要な場合は、IMG-02 / IMG-03 グループを有効にします。
- KJNodes、rgthree、comfyui_essentials、masquerade-nodes、maskvidexperiments(トリミング/貼り戻しノード)、was-ns、ComfyMath に依存します。モデルは H3 Image int8 拡散モデル、Qwen3-VL 32B テキストエンコーダー(デフォルトでは NVFP4 量子化版が指定されています)、fp16 VAE です。ステップ数などのパラメータは作者の説明には記載されていません。
リスクと制限
- 作者の説明は一文のみで、使い方とパラメータはワークフローを開いて確認する必要があります。7 個のカスタムノードパッケージに依存しており、そのうち maskvidexperiments は比較的珍しいものです。
- テキストエンコーダーのデフォルトは NVFP4 版であり、Blackwell 以外の GPU では int8 版に変更する必要があるかもしれません。サンプルは 1 枚のみです。
収録のみ(3)
- H3-Image ワークフロー — 無料 Lite T2I (MiniMax H3, 16 MP, 6 ステップ) — ComfyUI · v1.0 — ワークフロー:有料の H3 Image ワークフローパック($39)の無料トライアル版:基本的なテキストから画像生成(6 ステップ、CFG 1、2048×2048)のみを含み、複数参照画像編集、プロンプト拡張、高速ドラフト作成などは有料のフルバージョンに含まれます。
- H3-IMG T2I Improve WF · v2.0 — ワークフロー:kennedysworks による H3 Image テキストから画像生成の「改良」ワークフロー第3版:作者は Reddit 上の修正手法を統合し、H3 Image の出力画像のぼやけやディテールの欠落を軽減すると述べています。v2.0 の説明は「FIX MORE」のみです。
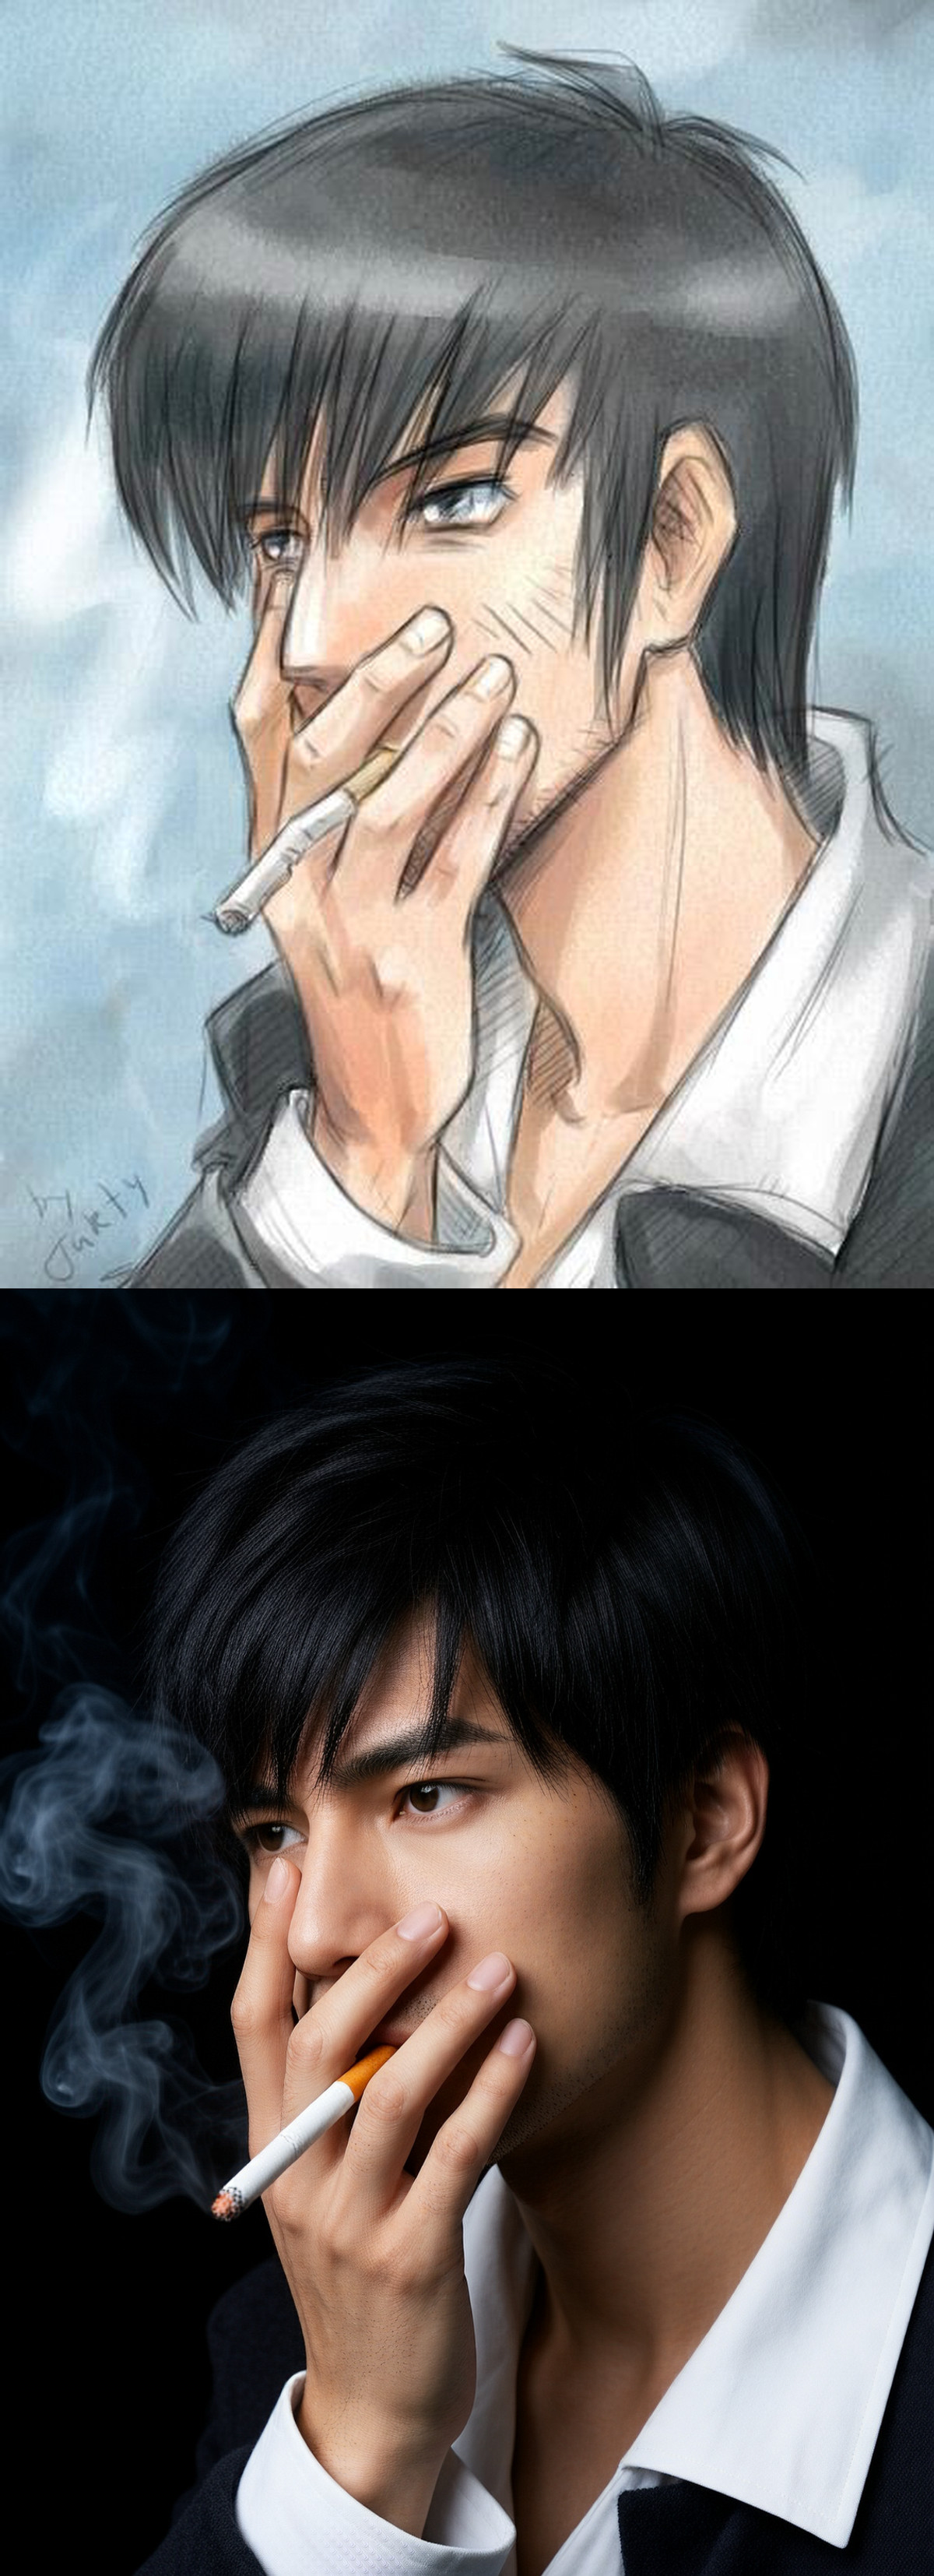
- minimax_h3_image_edit · v1.0 — ワークフロー:mo_akkakk による H3 Image 全体画像編集ワークフロー:1枚の画像を読み込み(さらに2枚の参照画像を有効化可能)、1つの編集指示で画像全体を変更し、結果を元画像と左右に並べて比較します。作者の説明は1文のみです。
データ:Civitai 公開 API(基盤モデル MiniMax H3)、収集期間 11-16 20:31 → 11-17 09:01(北京時間)。推奨理由は編集者によるレビュー済み。ダウンロード数は注目度を示すに過ぎません。