貞貞のAIレーダー · MiniMax H3 Image · 2026-11-21 朝刊
今号の新バージョンは 5 件:強く推奨 1 · 推奨 0 · 注目可 2 · 収録のみ 2
編集者按語 今号では H3 Image の新バージョンを 5 件レビューし、S評価が 1 件、B評価が 2 件、C評価が 2 件でした。初回推奨は AusBoss の Generate + Edit v1.2 です:画像編集時に変更を要求していない部分を自動的にロックし、マスクを描く必要がありません。さらにノイズ除去オプションと 8 MP サイズを追加しており、必要なノードバージョンやスイッチの使い方も明確に記載されています。ぼやけた写真を 16 MP で再構築するワークフローは用途が明確ですが、表示可能なサンプルがなく、ベースモデルが誤って Flux.1 D と表記されています。女性ボディビル体型コンセプト LoRA はパラメータが揃っていますが、サンプルがすべて非表示のため、これら2件は B評価としました。Free Lite テキスト生成画像は有料ワークフローパックの無料集客版で更新説明がなく、Makaria は通常の架空人物 LoRA であるため、これらは C評価としました。除外はありません。
強く推奨(1)
【S】MiniMax H3 Image Generate + Edit | 16 MP, 8 枚 · v1.2
ワークフロー · バージョン更新 · 作者 AusBoss · 公開日 11-21 02:53 · ダウンロード数 266
AusBoss の MiniMax H3 Image テキスト生成画像 + 編集ワークフローです。v1.2 では Edit Lock が追加され、編集時に指示していない部分はそのまま保持され、マスクを描く必要がありません。さらにノイズ除去オプションと 8 MP サイズが追加されました。
画像
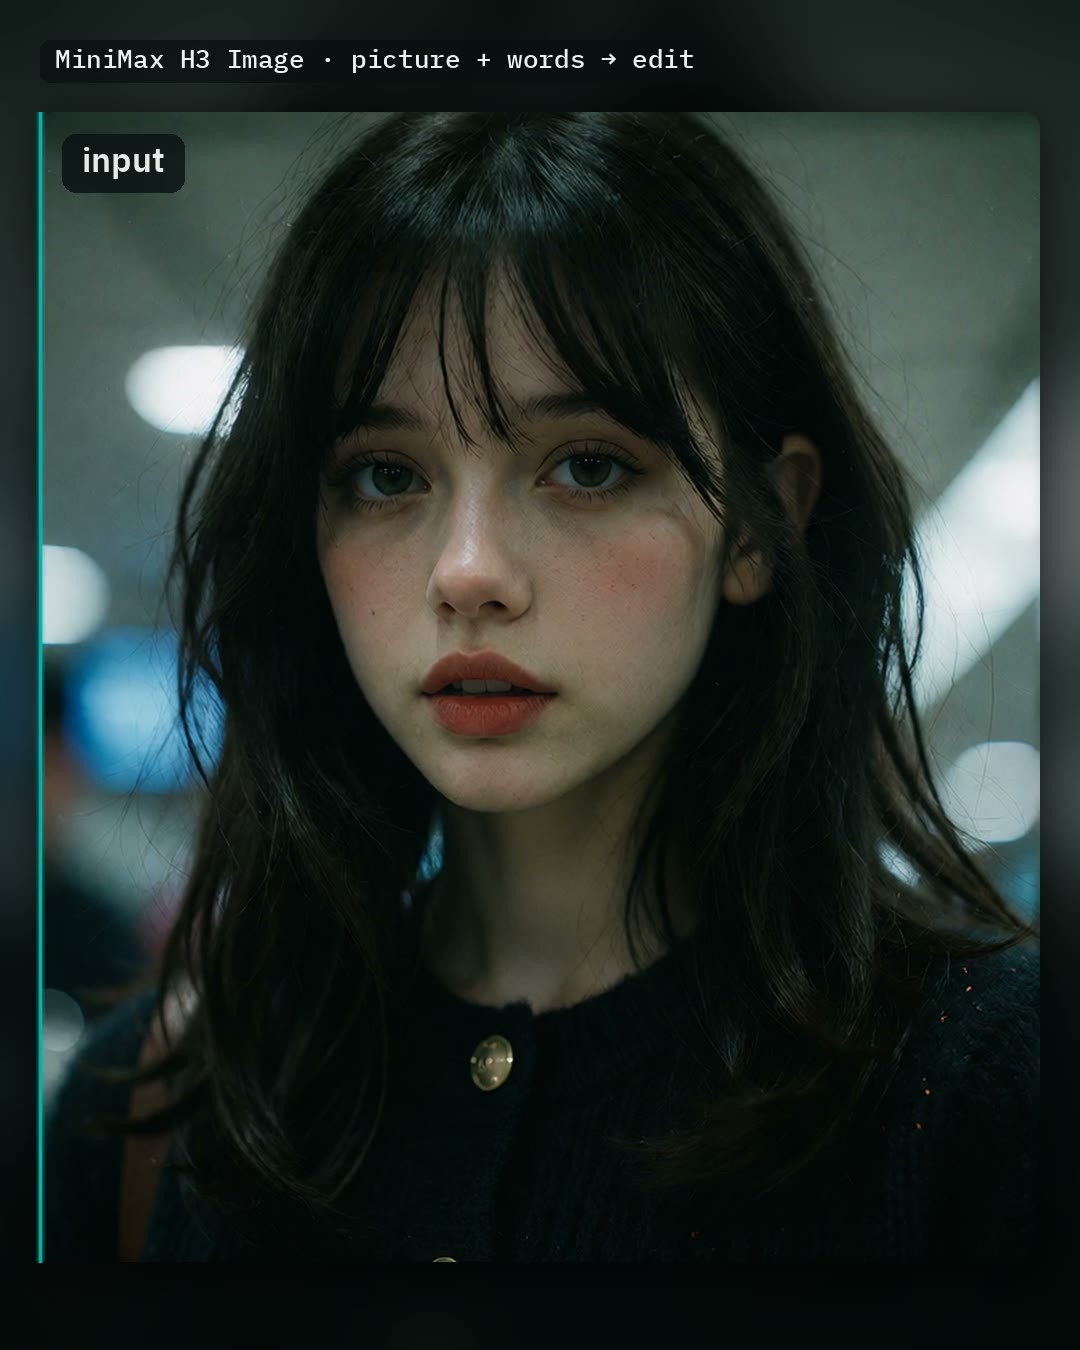
推奨理由
- バージョン更新:Edit Lock はデフォルトで有効で、指示した部分のみを変更します。全体スタイル変更、ライティング変更、雨追加などのグローバルな変更時には自動的に解除され、元画像のどの程度が保持されたかを示す数値が表示されます
- Grain cleanup(Off / Light / Medium / Strong)を新規追加:肌、髪、石などの微細なノイズを取り除きます。処理時間は増加せず、デフォルトはオフです。サイズ設定に 4 MP と 16 MP の間に 8 MP を追加し、VRAM が少ないカードでの編集を高速化しました
- 既存機能:一言での画像編集、Auto prompt で数語を長いプロンプトに拡張(v1.1 以降は編集時にも使用可能で、接続されたすべての画像を参照します)、最大 7 枚の参考画像を追加し番号で指定可能。モデルページ全体のダウンロード数は 3530 回、本バージョン公開後 6 時間で 266 回のダウンロード(注目度を示すのみ)
使い方
- まず ComfyUI を 0.45、AusBoss nodes を 2.26.3 以上へ更新してください。ワークフローをドラッグして直接 Run を実行すると、完全なプロンプトが読み込まれた状態で開きます
- 編集:「Edit a picture」を開き、画像を読み込み、「Make it snow.」などの変更内容と、保持すべき部分を明確に記述します。参考画像は picture 2 から順に picture 8 まで接続し、プロンプトには「Put the jacket from picture 2 on the woman in picture 1.」のように記述します
- 複数画像合成による新規生成:「Edit a picture」をオフにし、Latent Size でアスペクト比を選択、picture 2 から画像を接続します(この場合、プロンプト内では picture 2 は Picture 1 と呼ばれます)。Auto prompt はオフにします
- Size で 4 / 8 / 16 MP を選択。Fast モードでは akhaliq の pDMD LoRA を使用し、6 ステップの代わりに 2 ステップで実行します。Upscale the result では SeedVR2 を使用して 4 MP の結果を2倍に拡大します
リスクと制限
- 作者によると、Edit Lock がオンの場合、変更が一部欠ける可能性があるため、オフにして再実行する必要があります。Fast モードは構図が詰まりやすく、小さな文字が誤りやすいので、ポスターや表紙には使用しないでください。ノイズ除去は細部をわずかに変更する可能性があります
- 完全な機能にはメインモデル、テキストエンコーダー、VAE、プロンプトモデル、pDMD LoRA、SeedVR2 の2ファイルのダウンロードが必要です。メインモデルの int8 版は約 21 GB です(他に約 12.5 GB の低VRAM用 w4a8 版があります)。作者の速度データは RTX 5090 で測定されたものです
- サンプルは動画 1 本 + 画像 1 枚のみです。ワークフローのライセンスはサイト内レンタルのみを含み、ベースモデルは MiniMax-H3-Image コミュニティライセンスの制約を受けます
注目可(2)
【B】Women's IFBB Wellness Muscle [Flux / MOSS / Krea 2/H3 Image] · v1.0 H3 Image
LoRA · ポート · 作者 TestingAiImages · 公開日 11-21 05:12 · ダウンロード数 26
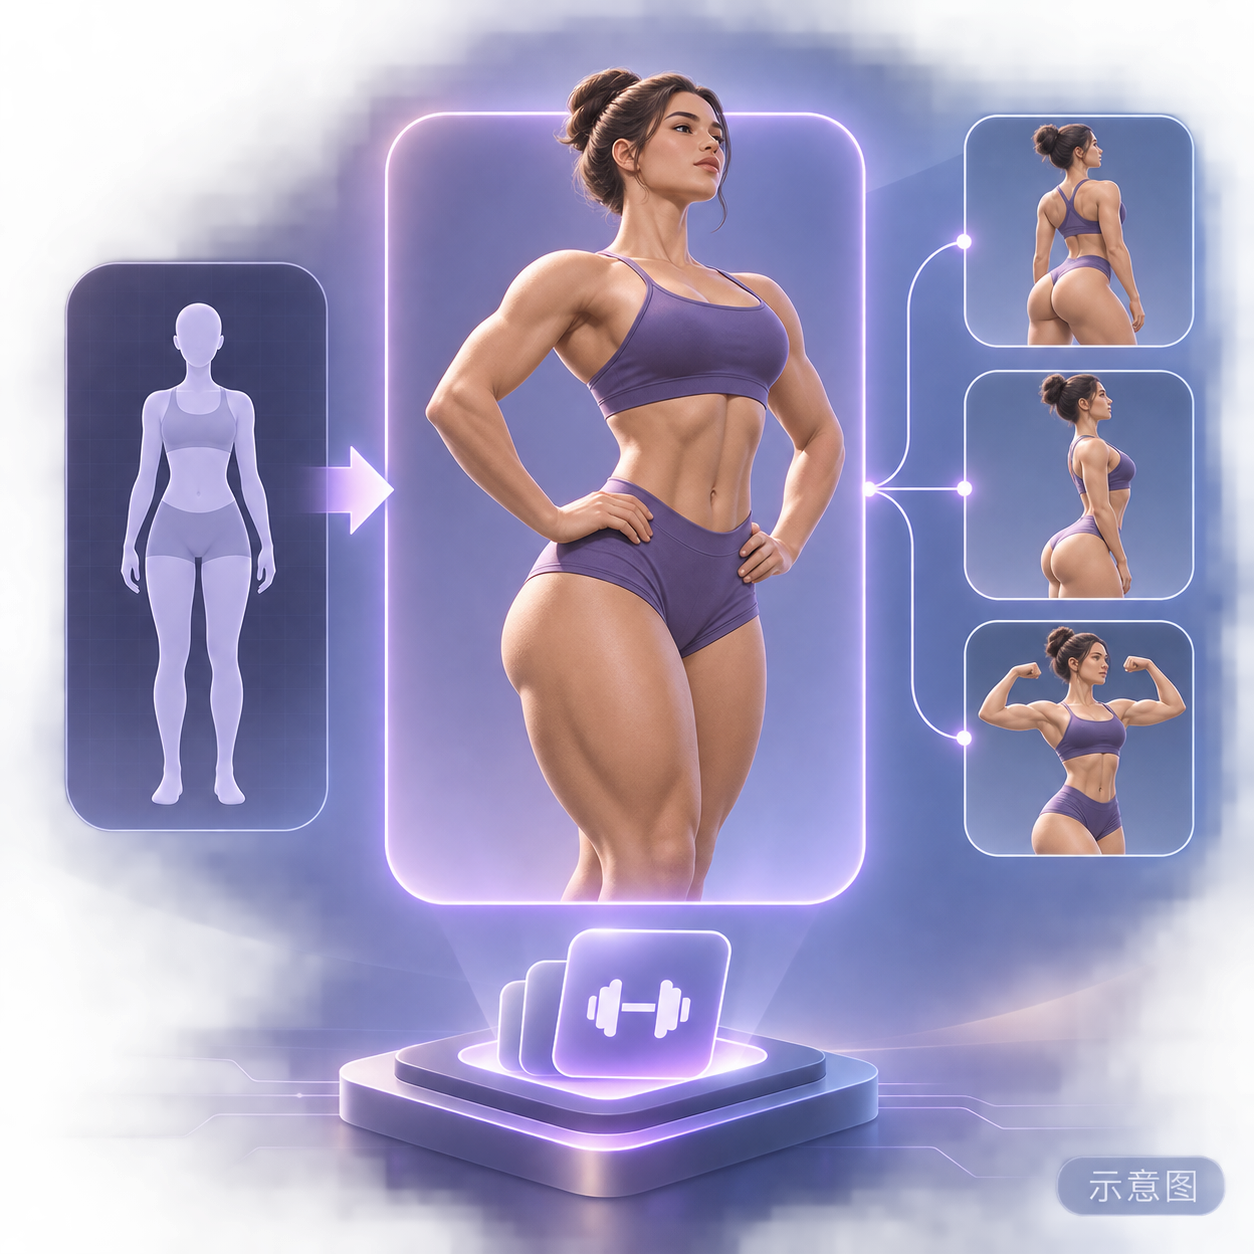
IFBB Wellness 部門の女性ボディビル体型のコンセプト LoRA です:上半身はコンパクトで引き締まり、下半身(臀部・脚、大腿四頭筋、ハムストリングス、ふくらはぎ)は筋肉が豊かで、筋繊維、血管、リアルな皮膚質感を備えています。複数ベースモデルページにおける H3 Image 版です。
画像
推奨理由
- ポート:同ページには既に Flux.2 Klein 9B、MOSS、Krea 2 版があり、モデルページ全体のダウンロード数は 2813 回です。H3 Image 版は H3 Image 専用に訓練されており、モデルカードには H3 固有のプロンプトルールとパラメータが個別に記載されています
- 説明が詳細:トリガーワードは冒頭の一文に含め、タグではなく完全な英文の撮影説明を使用します。ハードトップライト、サイドライト、または掠めるような陽光で筋肉の分離を強調し、全身ショットでは f/5.6 または f/8 を指定して前後のピントを合わせます
- 作者は最終画像を H3 ネイティブの約 16 MP(4K)で出力することを強調しており、2K は構図の確認のみに使用します。フィットネス / ボディビル人像、女性スーパーヒーローのキャラクター設定向けです
使い方
- トリガーワードは wellness_physique です。冒頭の一文に a muscular woman を含めると最も強く活性化します
- LoRA 強度は 0.75–0.95 で、0.80 から開始します。クローズアップではやや下げ、より太い下半身を望む場合は 0.95 へ増やします
- ネイティブ設定は 6 ステップ、CFG 1.0 です。ネガティブプロンプトや (word:1.2) の重み付け記法は無効です。全身ショットには 3:4 または 2:3 の縦長比率を使用し、最終稿は 3552×4736 または 3360×5024 です。詳細なプロンプトを使用する場合は Prompt Enhance をオフにします
リスクと制限
- 表示可能なサンプルが1枚もありません(8 枚すべてがセンシティブレベルで非表示のため)、効果をプレビューできません
- 作者によると、訓練データはすべて実際の IFBB Wellness アスリートの写真であり、顔の匿名化処理済みですが、肖像権の許諾状況については記載されていません
- 作者は、量子化ベースモデル(NVFP4 / FP8 / W4A8)を使用する場合、LoRA 強度を維持するために ComfyUI を --disable-dynamic-vram で起動する必要があると指摘しています。作者はこのバージョンの更新説明を記載していません
- カード画像は AI 生成の概念図であり、モデルの実際の出力結果ではありません。作者には公開されているノーマルレベルのサンプルがありません
トリガーワード:wellness_physique
【B】MiniMax H3 Image: 6-Step 16MP Blur Reconstruction (ComfyUI) · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開日 11-21 04:35 · ダウンロード数 7
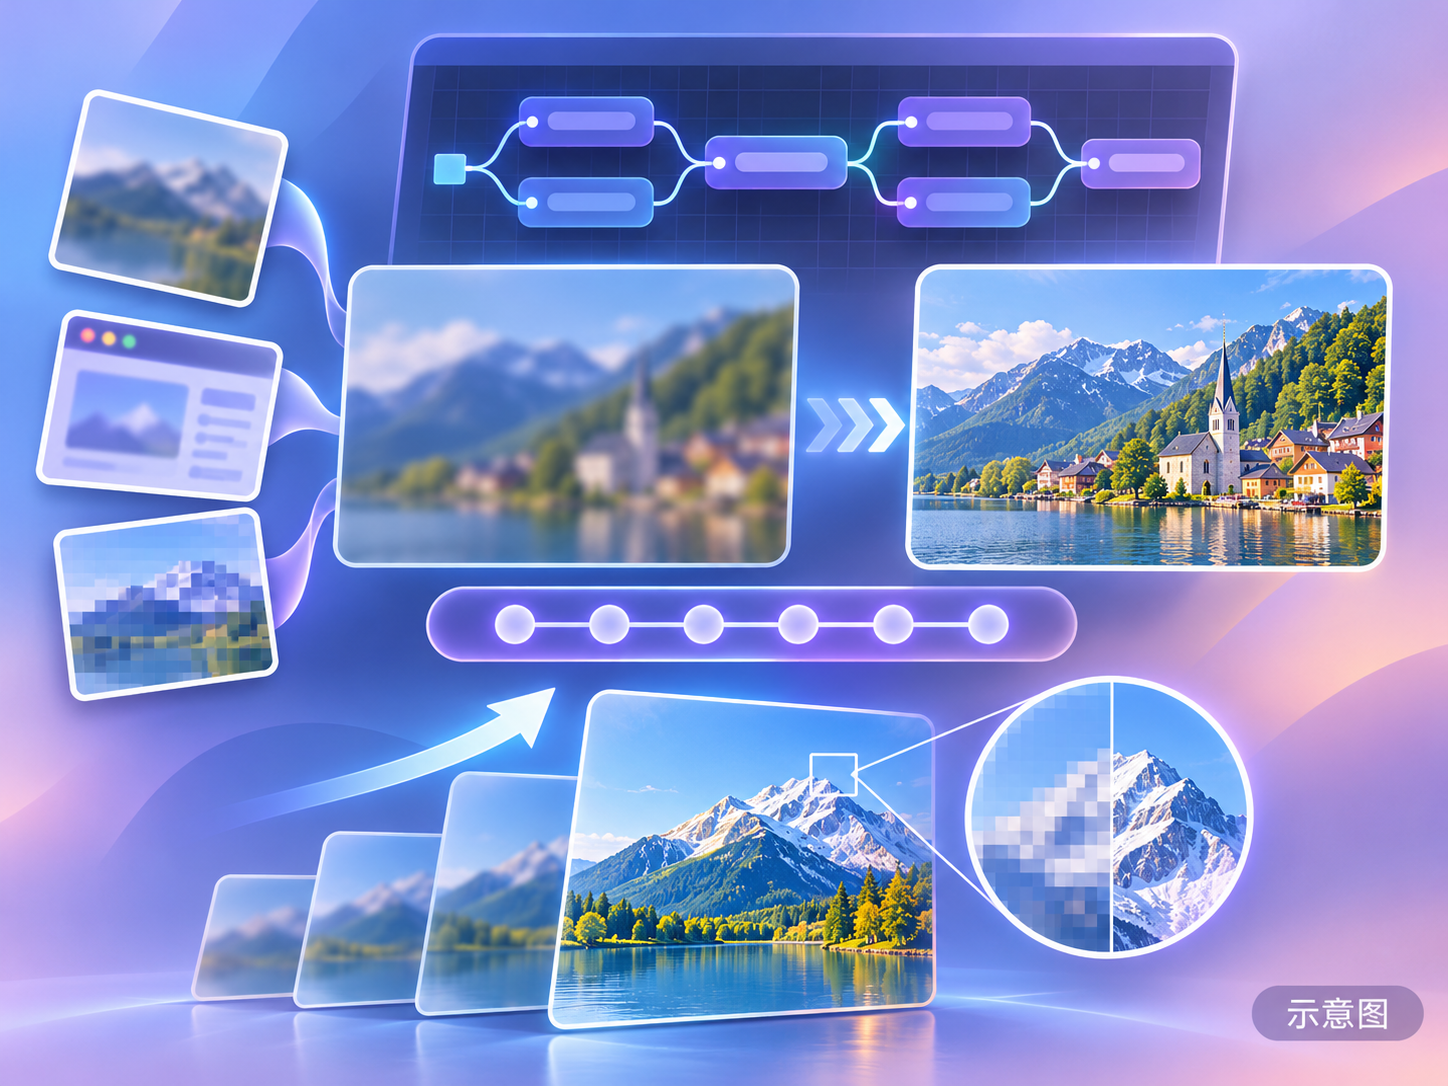
ぼやけた低解像度の写真やスクリーンショットを、H3 Image の編集チェーンで約 16 MP の鮮明な画像として「再描画」する ComfyUI ワークフローです。6 ステップでサンプリングを行い、単純な補間拡大ではありません。
画像
推奨理由
- 新モデル:元画像を条件として H3 Image 編集チェーンを実行し、高解像度で再サンプリングとデコードを行います。古い写真の修復、圧縮されたスクリーンショットの復元、動画から抽出したフレームの一枚ごとの再構築などに適しています
- 作者は限界を明記しています:入力に暗黙的に含まれる詳細のみを再構築し、存在しないものを捏造しません。重度の圧縮アーティファクトは「再解釈」される可能性があります。動画モデルではないため、フレームは一枚ずつ処理する必要があります
- ベースモデルタグは誤って Flux.1 D と表記されていますが、名称、説明、ファイル名はすべて H3 Image ワークフローであり、このセクションに分類しました
使い方
- H3 Image 関連ノードをインストールし、JSON を読み込み、元画像を接続します。デフォルトの 6 ステップを維持し(異なる詳細度を望む場合は変更)、SaveImage で約 16 MP の結果を出力します
- H3 Image の全重みが必要です。作者は4つのファイルが README に記載されていると述べていますが、モデルカードにはファイル名が記載されていません
リスクと制限
- 表示可能なサンプルがありません(唯一の 1 件は非表示)。修復前後の比較は作者の YouTube / Bilibili 動画でのみ確認できます。ダウンロードは 62 KB の JSON ファイルのみで、ファイル名内の中国語はアンダースコアに変換されています
- ライセンスにより、商用利用および派生物の作成は一切禁止されています。オンライン体験リンクには作者の招待コードが含まれています。説明テキストは全文が重複して記載されています
- カード画像は AI 生成の概念図であり、モデルの実際の出力結果ではありません。作者には公開されているノーマルレベルのサンプルがありません
収録のみ(2)
- H3-Image Workflows — Free Lite T2I (MiniMax H3, 16 MP, 6 Steps) — ComfyUI · v1.1 — ワークフロー:有料 H3 Image ワークフローパックの無料集客版です。基本的なテキスト生成画像ワークフロー(6 ステップ、CFG 1、2048×2048)のみを含み、複数参考画像編集、プロンプト拡張などは有料フルバージョンに含まれています。
- Makaria Silverstova (This person does not exist) · MiniMax H3 Image — LoRA:GPT で生成された、実在しない架空の女性 Makaria Silverstova(25 歳、黒髪)の人物 LoRA の H3 Image 版です。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-20 20:31 → 11-21 09:01(北京時間)。推奨理由は編集者によるレビュー済みです。ダウンロード数は注目度を示すのみです。