贞贞的AI雷达 · MiniMax H3 · 2026-11-10 晨报
本期 7 个新版本:强烈推荐 1 · 推荐 1 · 可关注 4 · 仅收录 1
编辑按语 本期审阅 7 个 H3 新版本,1 个 S、1 个 A、4 个 B、1 个 C。首推 H3MD Director 0.4.3:新增“无缝长视频”模式,把互相接续的镜头放在同一条时间线上一起渲染,并能只重绘成片里的几秒。A 是触发词 MdrnBty 的人像妆容美感 LoRA,本期下载最快,但说明只有几行。AMD 专用 Studio、口型同步工作流 Nova.2、Tap to Screen 内存补丁和泡沫水波风格 LoRA 列 B(没有可见生成示例、只验证过一种硬件或缺参数);只有角色故事、没有用法的外星人角色 LoRA 由 B 降为 C。
强烈推荐(1)
【S】H3MD Director 0.4 – seamless 2–3 min long videos with MiniMax H3 (CCW + simple workflow) · v0.4.3 CCW
工作流 · 版本更新 · 作者 1113800942188 · 发布 11-10 05:04 · 下载 45
H3 长视频 ComfyUI 节点包 H3MD Director 的 0.4.3 版:新增“无缝长视频”(CCW,链式上下文窗口),把互相接续的镜头放在同一条时间线上一起渲染,一次运行做出 2–3 分钟的多镜头 MV 或长镜头。
适合整首歌长度的 MV:先整条跑完,再用 Redraw 只修有问题的那几秒,不必整条重来。
配图
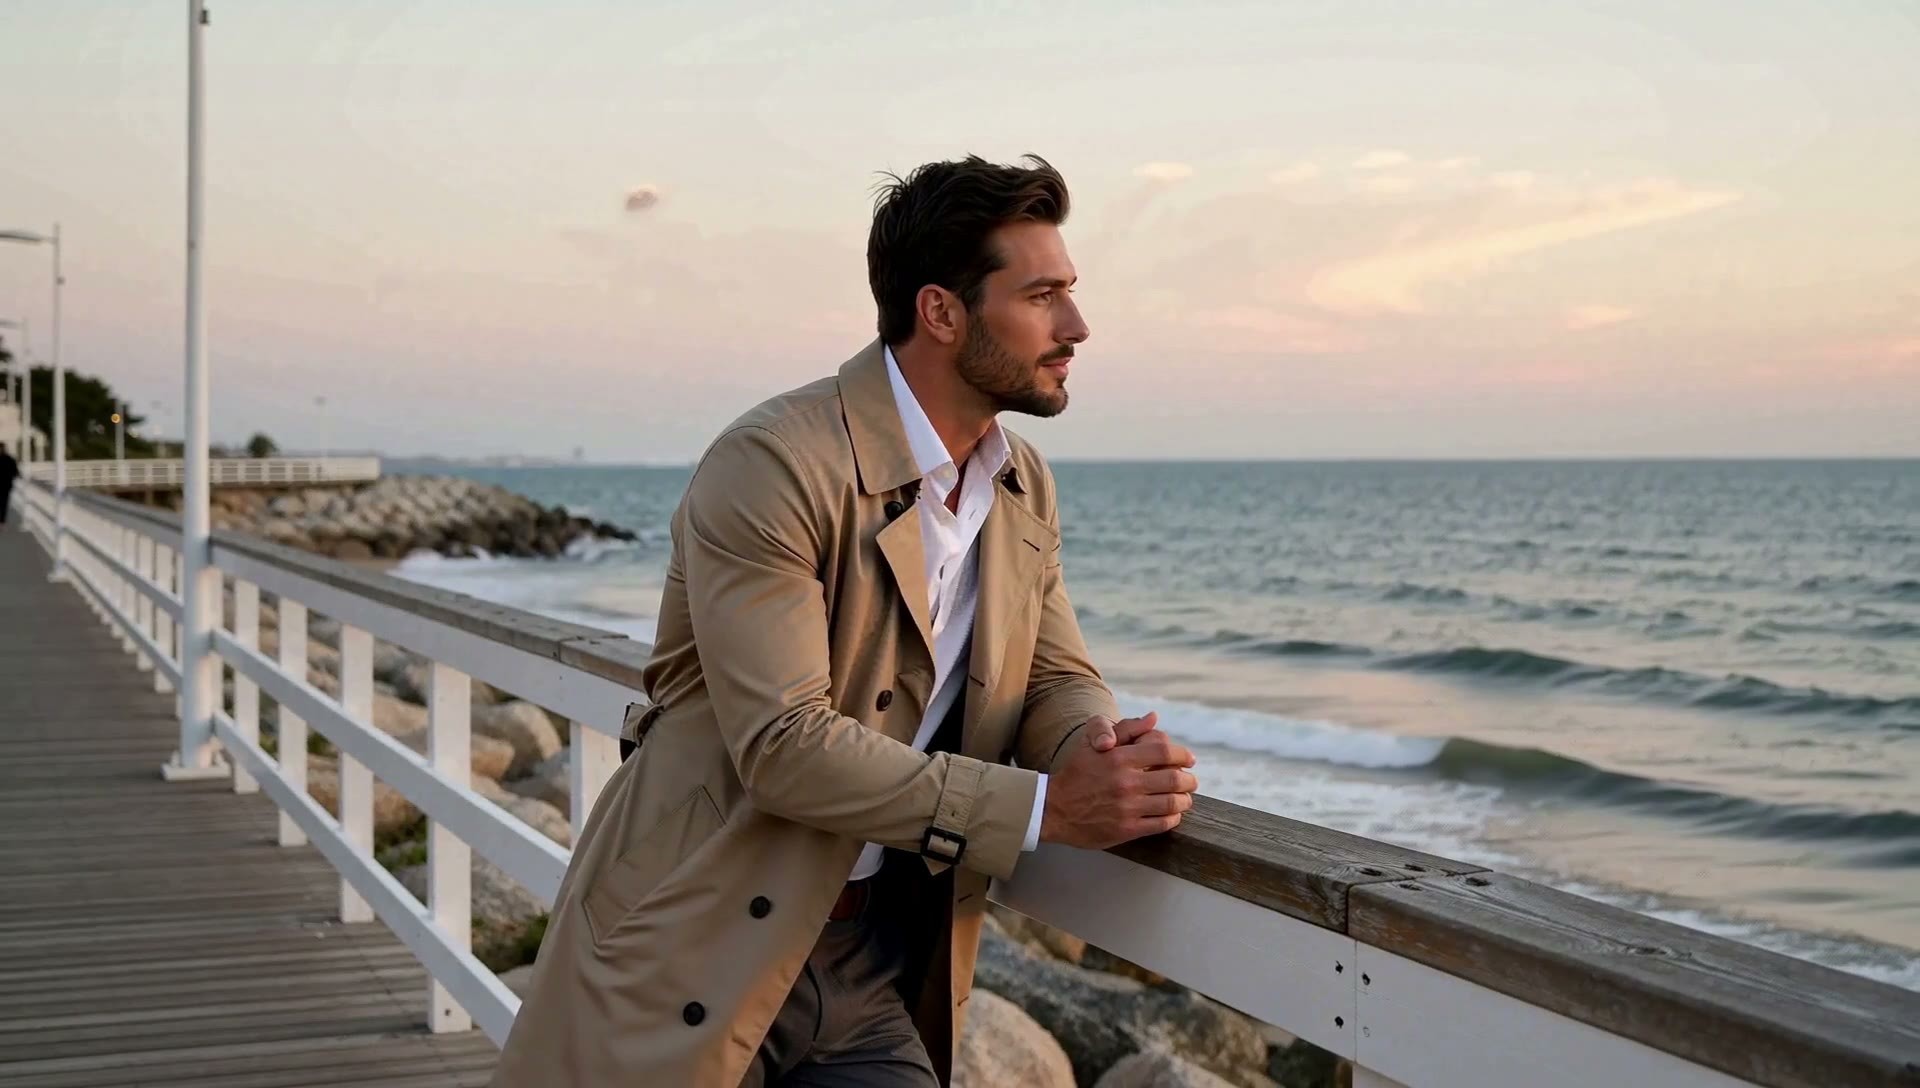
推荐理由
- 版本更新(本页上一版是 0.3.x 逐段模式):在 Director 上勾选 Seamless long video,接续的镜头在一条时间线上一起渲染,作者称没有分段接缝、段与段之间不漂移,硬切仍是干净的硬切;取消勾选即回到 0.3.x 逐段模式
- 作者解释与 ComfyUI 自带 Context Windows 的区别:自带方式对窗口重叠区取平均,画面变化大时会出现重影;CCW 按时间顺序跑窗口,每个窗口直接接管上一个窗口的重叠部分,不做平均
- 新增 H3MD Redraw / Preview 节点:可只出低清预览,或只重绘成片里的几秒(如 1:12-1:15),重绘前可改这个镜头的提示词或参考图,范围外的画面逐帧不变;补帧到 48 / 60 fps 时不再把硬切两侧的镜头混在一起
- 作者给了单机数据(RTX 5090 32 GB、64 GB 内存):1920×1088、10 个镜头分 3 组、48 fps 的 2 分 20 秒 MV 用时 2 小时 18 分,计算显存峰值 11.1 GB,比逐段渲染慢约 25%;重绘最后一个 18.6 秒的镜头用时 25 分 51 秒
- 0.4.3 本身的改动是 Control Panel 变轻:每个 LoRA 下拉框只在展开时才加载完整列表;附 2 段示例视频,整个模型页 330 次下载(只代表关注度)
怎么用
- 需要 ComfyUI 0.44 或更新版本才能用无缝模式(旧版本会明确提示);用 ComfyUI Manager 搜 H3MD Director 安装,或把 GitHub 仓库克隆进 custom_nodes,再把压缩包里的 H3MD Director simple.json 拖进画布
- 在 Director 面板逐个镜头设定时长、提示词、参考图和锁定音频,勾选 Seamless long video 后运行;要改某一段,在 Redraw / Preview 节点填时间范围单独重绘
- 作者的测试配置:int8 混合底模、32B int8 文本编码器、4 步 Turbo LoRA,低分辨率 6 步 + 高分辨率 3 步两段采样;示例工作流用 8 位帧缓存,1080p 每分钟约 9 GB(原来约 18 GB)
风险与限制
- 作者写明显存最低 16 GB、建议 24 GB 以上,目前只在 RTX 5090 上测过;整套模型约 55 GB,另需帧缓存空间
- 无缝模式比逐段渲染慢约 25%;“无接缝、不漂移”是作者称,本条未运行
- 节点代码为 AGPL-3.0,H3 权重另有许可;页面里的 RunningHub 链接是带邀请码的推广链接,且云端应用仍是旧的逐段版
推荐(1)
【A】Modern Beauty - MMH3 · MiniMax H3 - v3
LoRA · 新模型 · 作者 DuckyDuo · 发布 11-10 02:36 · 下载 227
人像妆容 / 美感 LoRA:作者称把 H3 默认的妆容和面部审美调成更“现代”的标准,触发词 MdrnBty。
配图
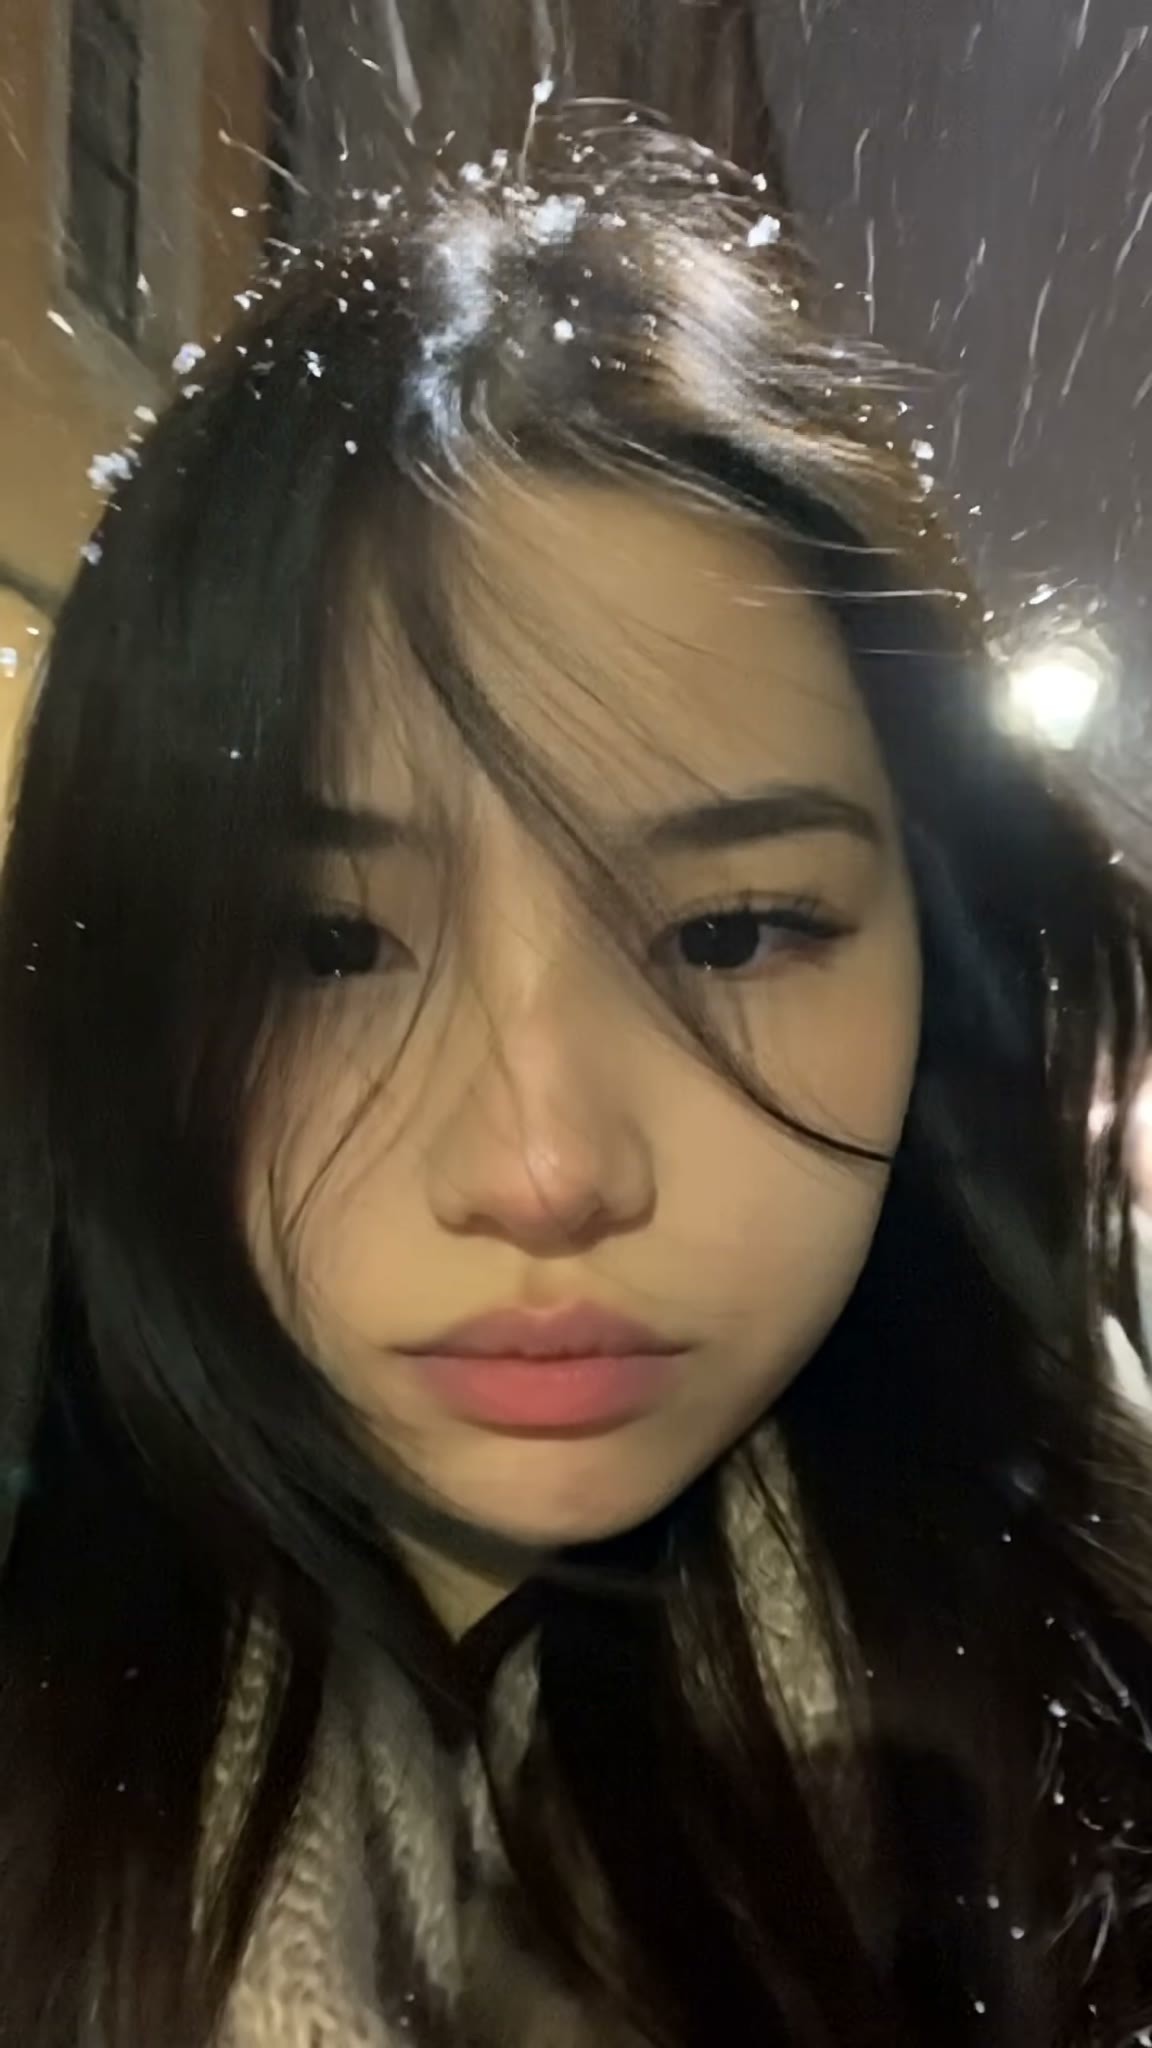
推荐理由
- 新模型(版本名 v3);服务人像特写的文生 / 图生视频,想让妆容和整体美感更贴近当下审美时叠加使用
- 作者称 v3 比 v2 多 80% 训练数据、多 80% 训练步数;v2 用了更大的数据集和更好的打标模型
- 用法给到触发词和强度上限;1 段视频 + 1 张图可见示例
- 发布 6 小时 227 次下载、15 赞,是本期下载最多的版本(只代表关注度)
怎么用
- 提示词加入 MdrnBty,强度低于 1.0(作者称 < 1.0 最合适);步数、采样器和配套模型作者未给
风险与限制
- 说明只有几行,没讲“现代妆容”具体改的是妆面、肤质还是脸型,需要看示例自己判断
- 本模型页只有这一个版本,说明里提到的 v1 / v2 不在本页,无法做前后对比
- 可见示例只有 2 个,另有 2 个敏感级示例被隐藏;许可不允许发布衍生模型,商用只允许站内出租
触发词:MdrnBty
可关注(4)
【B】MiniMax H3 — Studio AMD | EN / FR | ComfyUI · v1.1.3 — Community
工作流 · 新模型 · 作者 sylluck1207 · 发布 11-10 00:07 · 下载 22
面向 AMD 显卡的 H3 ComfyUI 一体化界面(英 / 法双语):在一个三步式 Studio 面板里切换 T2VA / I2VA / FL2VA / L2VA / Ref2VA 五种生成模式,内置模型下载指引。
配图
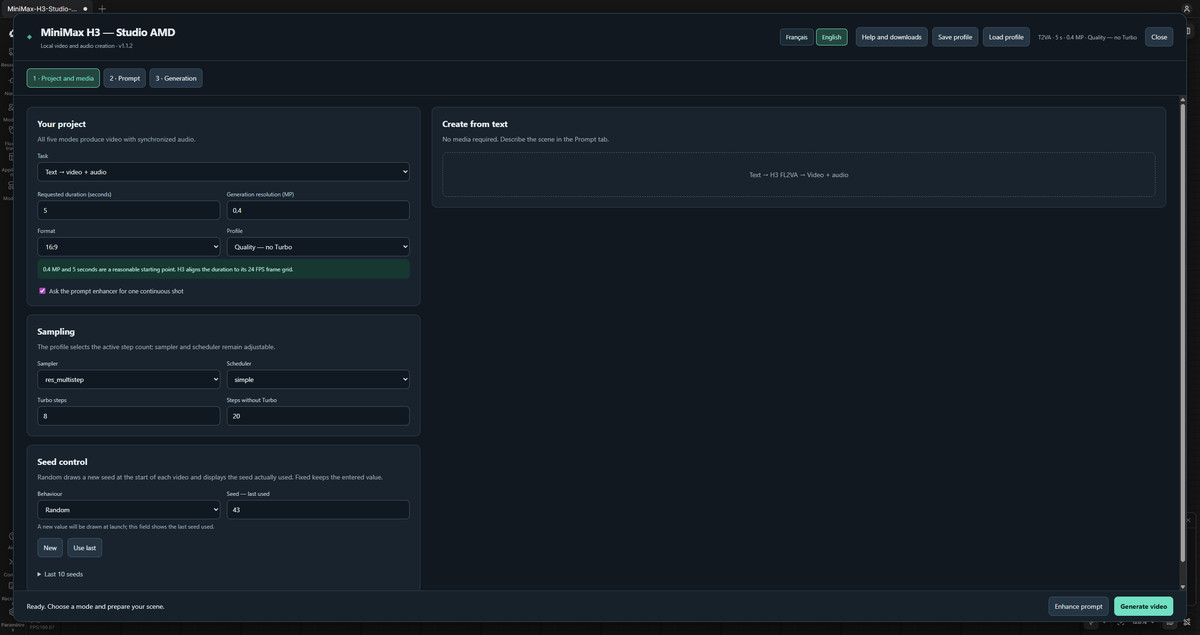
推荐理由
- 新模型;服务用 AMD 显卡(ROCm)在本地跑 H3 的人,文生、图生首帧、首尾帧过渡、尾帧引导和图 / 视频 / 音频参考生成共用一个界面
- 功能:可选用 Ollama 或本地 ComfyUI 模型按 H3 提示词格式改写提示词,改写结果可手动编辑;个人 LoRA、可选 Turbo,步数 / 采样器 / 调度器可调;可保存整套 Studio 配置
- 导出用 AMD AMF 编码 MP4(软件 H.264 兜底);可选图像 ×2 或 H3 潜空间 ×2 放大(二次采样);每次任务后自动卸载模型、清缓存;内置双语帮助列出模型下载链接、存放文件夹和缺失文件
怎么用
- 下载完整的 Community ZIP(单独的工作流 JSON 不够用),把内附扩展放进 custom_nodes,按 README 和模型下载指引放好权重,重启 ComfyUI 后载入工作流打开 Studio
- 需要自己先配好能用的 AMD PyTorch 环境,本包不安装驱动或 PyTorch,也不含模型权重;推荐步数和采样参数作者未给
风险与限制
- 作者只在一种配置上验证过:ComfyUI 0.43.2、Windows ROCm、RX 7900 XTX 24 GB、64 GB 内存,其他配置要自行验证;NVIDIA 版尚未提供
- 4 张示例都是界面截图,没有生成结果示例;另有 1 个敏感级示例被隐藏
- 作者自称新手、工作流借助 AI 开发;依赖自带扩展(GPL-3.0),本条未运行
【B】MiniMaxH3 Lipsync / TLF2VA · Nova.2
工作流 · 版本更新 · 作者 Rvage · 发布 11-10 00:39 · 下载 39
H3 一体化 ComfyUI 工作流 MMH3_Unified 的 Nova.2 版:用一张角色图对已有歌曲或对白做口型同步表演视频,或走原生 H3 从文字 / 图片生成带声音的视频;按场景分段渲染,可续跑、可从某一段起重做。
配图
推荐理由
- 版本更新:新增 Prompt Review,把开场和后续各场景的提示词放在一起显示,可暂停、原地修改后继续同一次运行;新增 Part Prompt Editor,可改已保存运行中某一段的提示词,在 Resume 时生效
- 可选的参考视频分析会找出镜头切点并描述其间动作,自动写分场提示词;也可全部手填时间点和提示词;另有可选的 YuE2 / MiniMax Music 3 配乐、歌词提取和动态字幕
- 存档机制完整:Resume 续跑未完成的运行,Restart part 从指定段起重做其后全部,Load 复用已存运行做字幕或重新导出,不必再采样
怎么用
- 先更新三个 Nova 节点包:Eclipse Nova 1.0.31、SmartLLM Nova 1.1.13、Smart Model Loader Nova 1.0.11;在 START HERE 选 Lip-sync 或 Native H3,并在模型加载器和 LoRA 预设里选对应预设(切换路径不会自动换预设)
- 画布保持 24 FPS;作者的口型示例用 Euler / beta、CFG 1、8 步并开启 Turbo LoRA(强度 1);第一次测试建议截一小段音频、关掉配乐和字幕、每次队列只生成一段,并开启 Disk + Keep in output 以便续跑
风险与限制
- 没有可见示例(1 个敏感级示例被隐藏),效果无从预览
- 依赖三个 Nova 节点包和多个可选节点包,模型清单很长;工作流打开时可能带着作者测试时的模型选择,需要逐项核对
- 许可不允许商用、不允许发布衍生作品;分析指令分 Standard / 敏感内容 两套
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
【B】Tap to Screen — MiniMax H3 lip-sync MV on your own song (1–4 scenes, timeline) · v1.3.1
工作流 · 版本更新 · 作者 koyan0418439 · 发布 11-10 06:08 · 下载 13
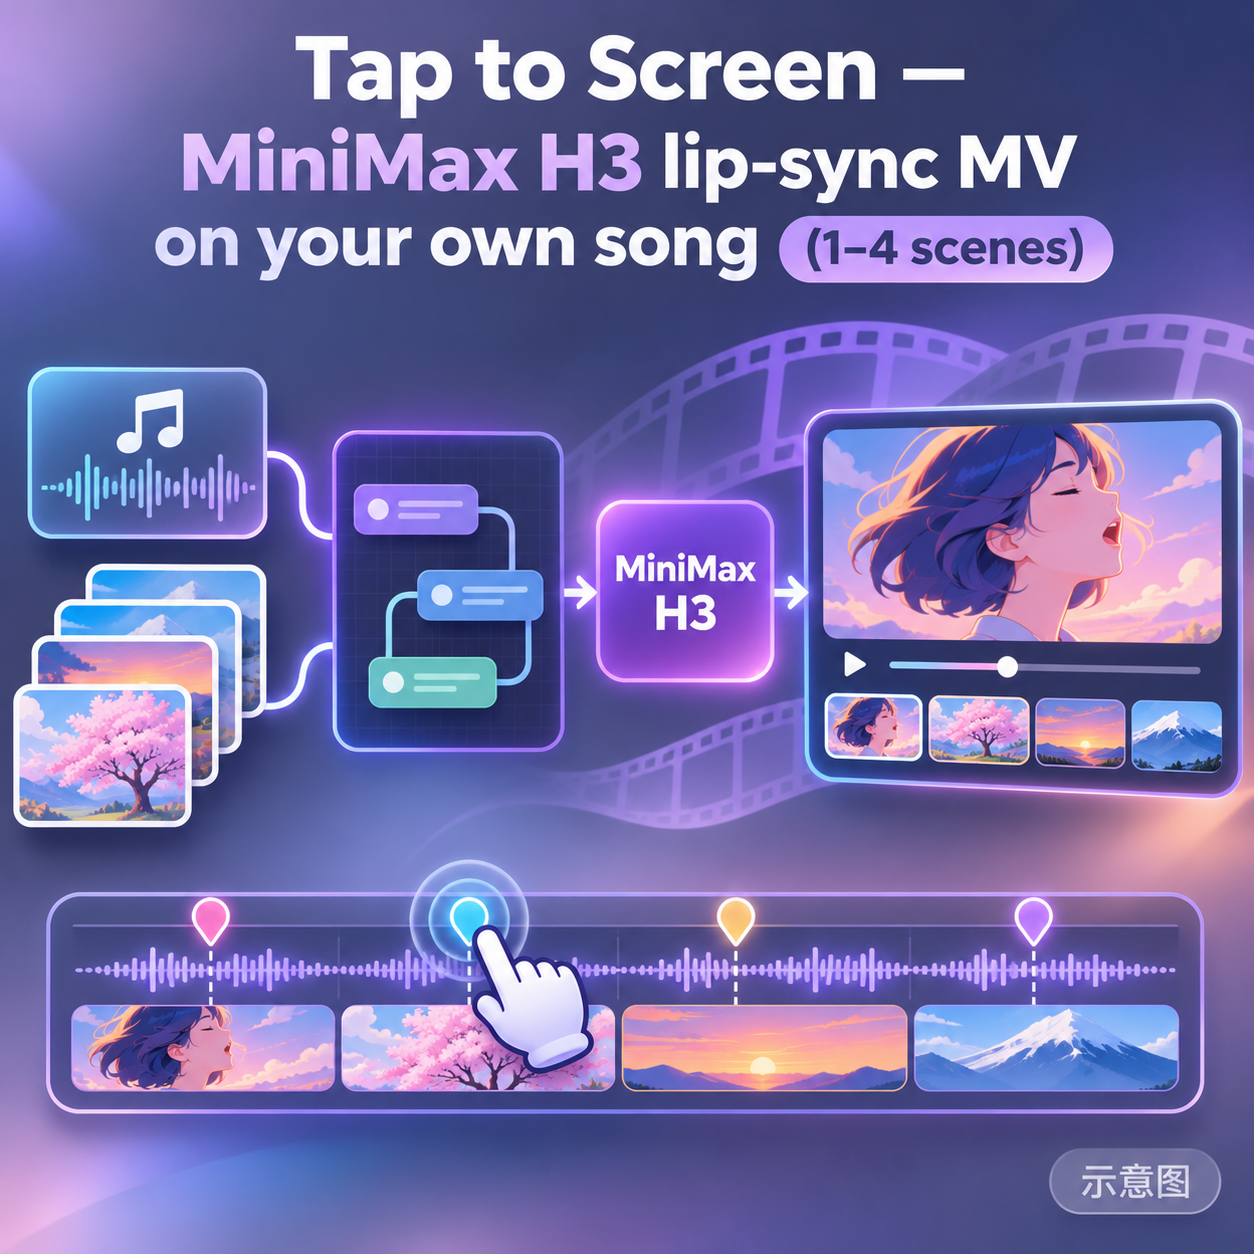
用自己的歌和几张图片做 H3 口型同步 MV 的 ComfyUI 工作流:在时间线上边播放边按键切镜头、标出演唱区间,每个场景对应的那段歌曲原样作为 H3 的音频输入。
配图
推荐理由
- 版本更新(v1.3.1,内存维护补丁,作者称成片做法不变):已完成场景的 latent 不再留在 ComfyUI 缓存里,改存为帧文件旁的 .latent.pt,需要重做时才读回;原先 64 个场景最多会多占约 2 GB 内存
- 解码节点新增 stream 选项,作者称边解码边写文件、画面逐字节一致、内存占用更小;场景编辑可一键删除最后一个场景,或多选后批量删除
- 工作流本身:多个角色各配图片和名字、按场景选谁出镜谁唱;场景首帧锁定到图片;“接续上一场景”让镜头连贯;只重做改动过的场景;转场可选硬切、交叉淡化、黑场、白场
- 整个模型页 331 次下载、24 赞、5 条评论(只代表关注度)
怎么用
- 把 custom_nodes/ComfyUI-H3Timeline 复制进 ComfyUI 的 custom_nodes,重启并刷新页面,再把 workflows 里的工作流拖入画布;点画布左下角的 Timeline 打开时间线
- 拖入歌曲和每个场景的图片,空格播放,按 C 在当前位置切场景、按 S 标出开始 / 结束演唱,在时间线下方写各场景的文字(作者称英文最好),然后 Run;成片存在 output/video/
- 解码选项 full 为默认,内存紧张时试 stream;单个场景最长 15 秒(H3 上限)
风险与限制
- 没有可见示例(1 个敏感级示例被隐藏),无法预览口型效果
- 本版是内存和编辑便利性补丁,没有新的生成能力;stream 解码作者说要在更多 GPU 上确认后才设为默认
- 依赖作者自己的 H3Timeline 节点,本条未运行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
【B】Water Foam World · MiniMaxH3
LoRA · 移植 · 作者 MisterMR · 发布 11-10 03:00 · 下载 33
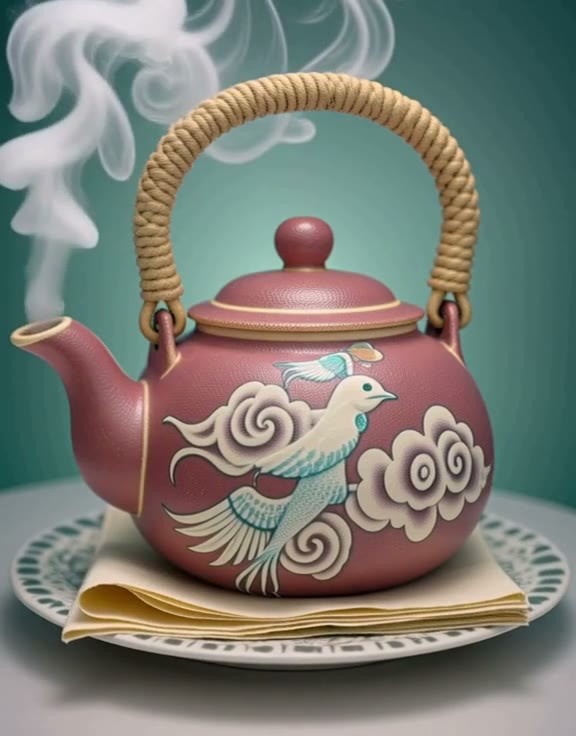
风格 LoRA:让物体被厚厚的白色泡沫包裹、内部或周围有青绿色水波流动,作者举的例子是泡沫做成的蘑菇台灯、泡沫边框里翻着海浪的显示器这类梦幻家居物件。
配图
推荐理由
- 移植版(同页另有 Krea 2、SD 1.5 版本);服务室内、产品类场景的超现实风格短视频
- 有 12 段示例视频,可以先看风格再决定
怎么用
- 作者未登记触发词,也未给强度、步数;可按模型卡描述在提示词里写白色泡沫包裹物体、青绿色水波等(是否必需作者未说明)
风险与限制
- 模型卡全是氛围描写,没有任何参数;H3 版没有版本说明,与 Krea 2 / SD 1.5 版的差别不明
- 有 8 个敏感级示例被隐藏;许可不允许发布衍生模型,商用只允许站内出租
仅收录(1)
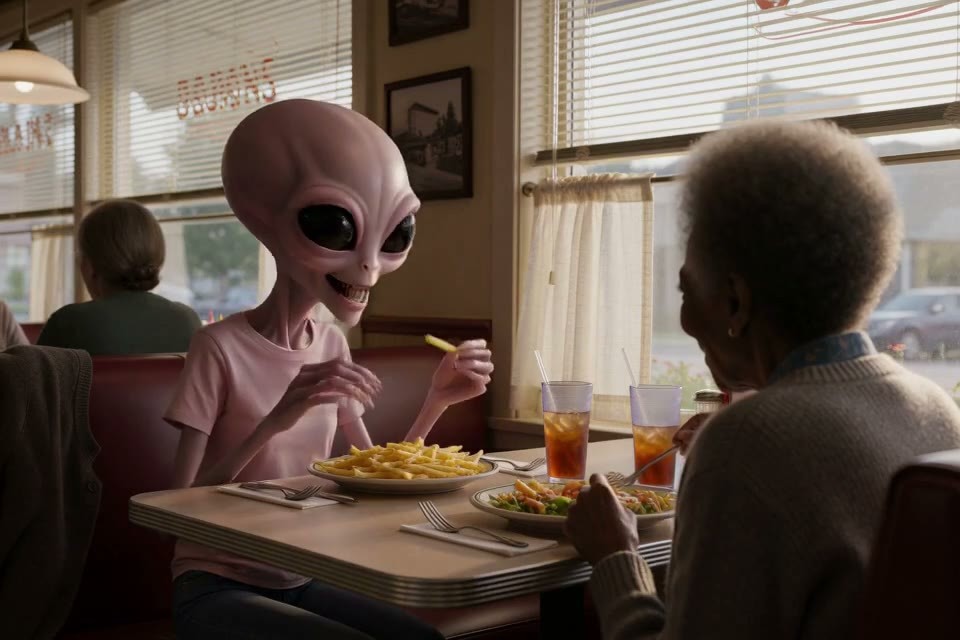
- Aevra Picard · v1.0 H3 — LoRA:原创外星人角色 LoRA:Aevra Picard,模型卡只有人物背景故事(全黑的大眼睛、没有鼻子、满嘴针状牙齿的外星移民),触发词 aevralora。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-09 20:31 → 11-10 09:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。