Radar IA de Zhenzhen · MiniMax H3 · Édition du soir 2026-11-20
Cette édition présente 13 nouvelles versions : fortement recommandées 1 · recommandées 2 · à suivre 4 · simplement répertoriées 6
Note de l'éditeur Cette édition a examiné 14 nouvelles versions de H3, dont 1 S, 2 A, 4 B et 6 C, avec 1 exclusions. Première recommandation : le curseur global de vent KinetiX : aucun mot-clé déclencheur n'est nécessaire, les valeurs positives font onduler capes, cheveux et végétation dans le sens du vent, tandis que les valeurs négatives créent une image totalement sans vent ; les intensités par paliers et les modèles de prompts sont fournis. Le style d'animation à traits épais Secret Squirrel et la correction du remplacement multi-personnages de H3MD Director 0.5.8 sont classés A ; les 5 workflows mis à jour le même jour par mo_akkakk ont des descriptions trop courtes, classés B / C. Le workflow en grille 3x3 de Qwen Image 2.1, incorrectement étiqueté comme H3, a été exclu (il relève du secteur Qwen 2.1).
Fortement recommandés (1)
【S】KinetiX Weather System Series · Global Wind Force V1.0
LoRA · Mise à jour de version · Auteur make676767 · Publié le 11-20 10:45 · Téléchargements 97
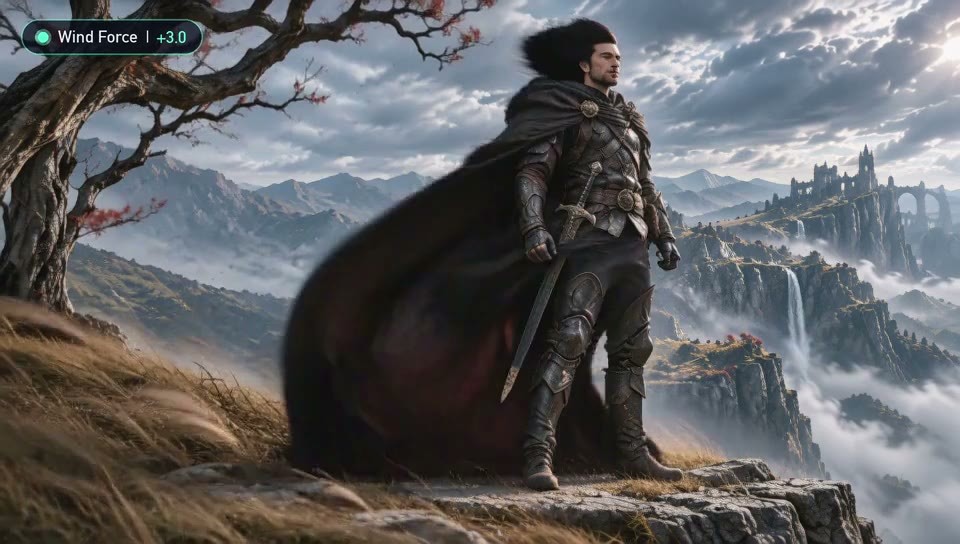
Un LoRA avec curseur global de vent, positif ou négatif : les valeurs positives font onduler capes, cheveux, végétation, drapeaux et rideaux dans la même direction sous l'effet du vent, tandis que les valeurs négatives créent une image totalement sans vent, avec des tissus tombant à la verticale.
Idéal pour effectuer un comparatif en trois paliers (-3 / 0 / +2.5) avec le même prompt, afin d'observer les changements sur les tissus et la végétation.
Illustrations
Raisons de la recommandation
- Nouveau membre de la série météo KinetiX (la page contient déjà grêle, brouillard volumétrique, pluie, cycle jour/nuit et neige) : cette version est un nouveau LoRA de contrôle du vent, et non une révision d'un ancien LoRA.
- Résout le problème du contrôle difficile de l'intensité du vent dans un même plan : l'auteur précise que seul le flux d'air est contrôlé, sans ajouter de poussière, de brouillard, de teinte jaunâtre ou d'assombrissement ; la position de la caméra, les bâtiments et la structure des personnages ne sont pas déformés.
- L'auteur fournit des intensités par paliers, deux groupes de fragments de prompts prêts à coller (positifs et négatifs), ainsi que trois modèles complets incluant les champs overall_soundscape / non_diegetic_music.
- 2 exemples vidéo visibles, gratuit, la licence autorise l'usage commercial et la vente.
Comment l'utiliser
- Aucun mot-clé déclencheur ; après chargement, définissez le poids : +0.8~+1.5 pour une brise légère, +2.0~+3.0 pour le point optimal de vent fort recommandé par l'auteur, +3.5~+5.0 pour un ouragan extrême, 0 correspond au défaut du modèle de base, -2.0~-5.0 pour une absence totale de vent.
- En positif, vous pouvez associer les prompts fierce directional wind gale, high-velocity aerodynamic wind pressure, billowing fabrics and windswept motion ; en négatif, utilisez des descriptions telles que dead calm windless atmosphere.
- Exemples de modèles fournis par l'auteur : guerrier sur une falaise +2.5, confrontation sur un toit +2.2, intérieur sans vent -3.0 ; les recettes de combinaison avec les curseurs tempête de sable, pluie torrentielle, foudre et tremblement de caméra de la même série sont disponibles dans la fiche modèle complète.
- L'auteur n'a pas indiqué le nombre d'étapes ni l'échantillonneur.
Risques et limitations
- L'archive workflow_resources jointe est marquée comme type de données d'entraînement ; l'analyse de sécurité n'est pas encore terminée.
- 5 exemples sont masqués.
- Le nom réel du fichier est _v1, alors que les descriptions et les recettes de combinaison mentionnent _v1.0 ; chargez le fichier selon son nom réel.
Recommandés (2)
【A】Secret Squirrel 1993 ArtStyle · triple zero
LoRA · Nouveau modèle · Auteur OrioTysumi · Publié le 11-20 15:24 · Téléchargements 39
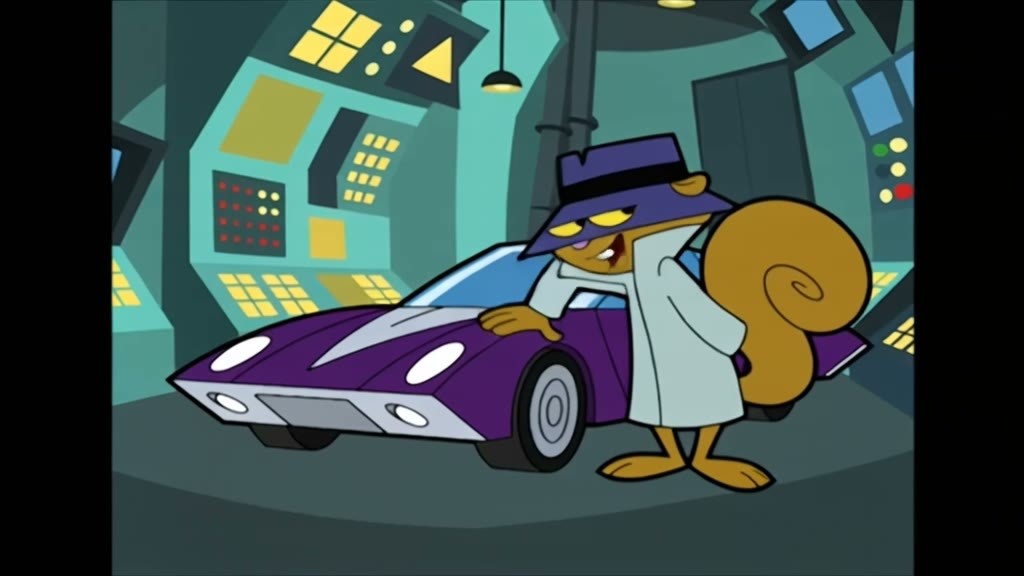
Un LoRA reproduisant le style d'animation Hanna-Barbera de 191993, avec contours noirs épais et aplats de couleurs, inspiré de la série « Super Secret Secret Squirrel ». L'auteur recommande d'utiliser la génération vidéo à partir d'une référence (R2VA) pour convertir vos propres images de personnages dans ce style.
Illustrations
Raisons de la recommandation
- Nouveau modèle : le service génère des vidéos à partir d'une référence en transformant les personnages dans le style des dessins animés télévisés aux traits épais des années 90 ; la génération vidéo à partir d'un texte (T2VA) fonctionne aussi, mais il faut réduire l'intensité.
- Les paramètres fournis par l'auteur sont complets : intensité, LoRA d'accélération associé, échantillonneur, planificateur, nombre d'étapes et mots-clés du prompt sont tous indiqués.
- 7 exemples vidéo visibles, téléchargement gratuit.
Comment l'utiliser
- En mode R2VA, intensité 1 ; en mode T2VA, réduisez à 0.5 ou moins, sinon le personnage portera aléatoirement le chapeau mou violet de Secret Squirrel.
- Associez-le au LoRA DMAD 4-step, avec l'échantillonneur er_sde, le planificateur beta et un nombre d'étapes de 6 ou 8.
- Aucun mot-clé déclencheur ; ajoutez dans le prompt 'thick-line animation style' ou '2D animated sequence with thick black outlines and flat colors'.
- Définissez la résolution de sortie sur 16:9, l'image effective sera proche de 4:3.
Risques et limitations
- Les vidéos d'entraînement n'ont pas été recadrées pour supprimer les bandes noires latérales, donc les images générées incluront des bandes noires à gauche et à droite (l'auteur l'a précisé) ; en choisissant 4:3, l'image effective sera proche de 1:1.
- 2 exemples sont masqués.
- Style d'animation sous licence copyright, la licence n'autorise que la location sur le site ; évaluez vous-même les risques de droits d'auteur pour un usage commercial.
【A】H3MD Director 0.5 – Vidéos de 2 à 3 min avec MiniMax H3 : remplacement multi-personnages, raffinement des visages en plan large, CCW sans couture · v0.5.8 correction du masque d'image clé
Workflow · Mise à jour de version · Auteur 1113800942188 · Publié le 11-20 11:09 · Téléchargements 81
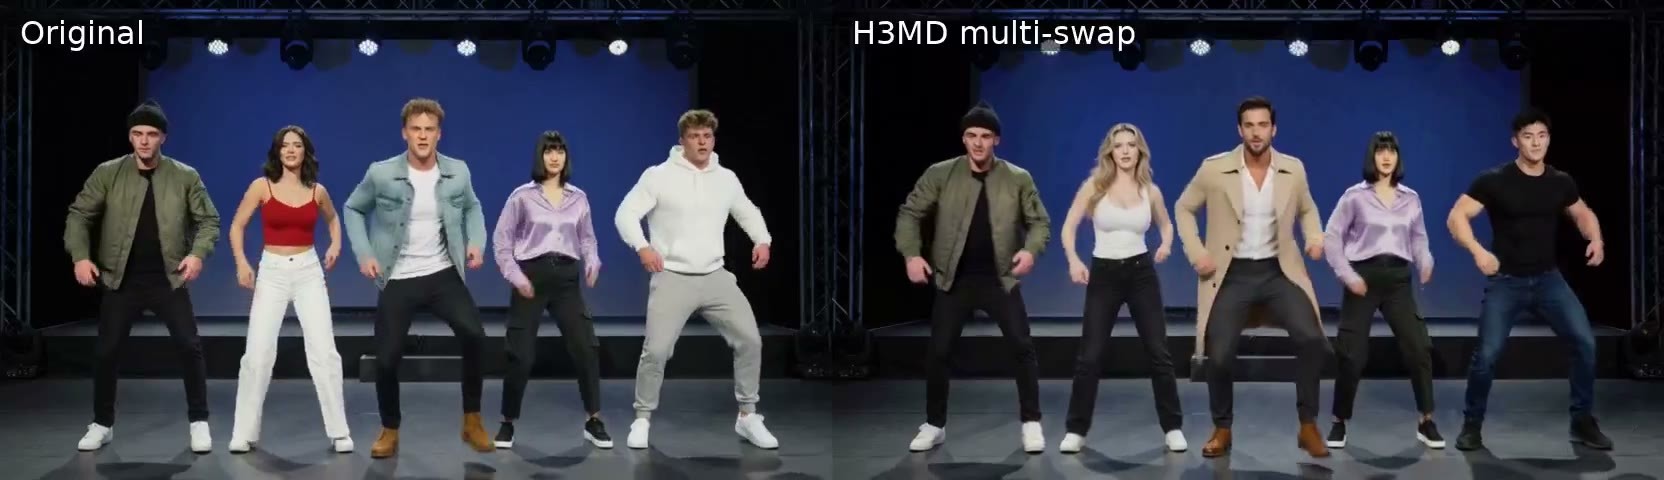
Une mise à jour mineure du pack de nœuds gratuit et open source H3MD Director pour les vidéos longues avec H3 : amélioration de l'étape de masque d'image clé pour le remplacement multi-personnages, ajout du nouveau nœud H3MD Keyframe 1b: Recast permettant de redessiner chaque personne individuellement.
Illustrations
Raisons de la recommandation
- Mise à jour de version : Recast redessine les personnages un par un, chaque découpe étant prise sur une image où « les personnes précédentes ont déjà été remplacées » ; ainsi, les perruques, oreilles, queues, grandes jupes, tabliers ou chaussettes résiduels lorsque l'ancien personnage était plus grand que le nouveau ne restent plus autour du nouveau personnage.
- Prepare identifie désormais les points de coupe de la vidéo originale et place au moins une image clé par plan, évitant de dessiner deux fois la même personne après une coupe.
- L'outil lui-même : génère en une seule passe dans ComfyUI avec H3 des vidéos longues de 2 à 3 minutes (un seul plan long ou une série de plans planifiés) ; depuis la version 0.5, il prend en charge le remplacement de 3 à 5 personnes dans une même vidéo et le raffinement des visages en plan large ; le workflow du pupitre de réalisation est inchangé, seuls les workflows d'images clés ont été modifiés.
Comment l'utiliser
- Mettez à jour les nœuds via ComfyUI Manager ou faites un git pull, puis utilisez le workflow Keyframe déjà adapté pour Recast dans l'archive.
- Le nouveau curseur mask_grow a une valeur par défaut de 0.25 ; si les personnages de la vidéo originale ont une grande corpulence (type cosplay), ajustez entre 0.3 et 0.35.
- L'auteur recommande de préciser dans chaque description de personnage les chaussures, l'habillement des jambes et ce qui n'est pas porté, par exemple "bare legs, black heels; no socks, no boots".
- Seuil de mémoire vidéo recommandé par l'auteur : à partir de 16 Go, idéalement plus de 24 Go ; l'option d'encodeur de texte 4B permet d'économiser de la mémoire.
Risques et limitations
- Cette version ne propose que 1 exemples visibles, 2 sont masqués.
- La fiche modèle complète indique qu'il faut ComfyUI 0.43 ou supérieur, et 0.44 ou supérieur pour les vidéos longues sans couture (CCW).
- Les nœuds sont sous licence AGPL-3.0, les poids H3 ne sont pas fournis avec le pack et ont une licence distincte ; la fiche modèle contient un lien de parrainage RunningHub.
À suivre (4)
【B】Minimax.. simple · v6 Tutorial beta
Workflow · Mise à jour de version · Auteur sy0ww4bb1984 · Publié le 11-20 14:39 · Téléchargements 32
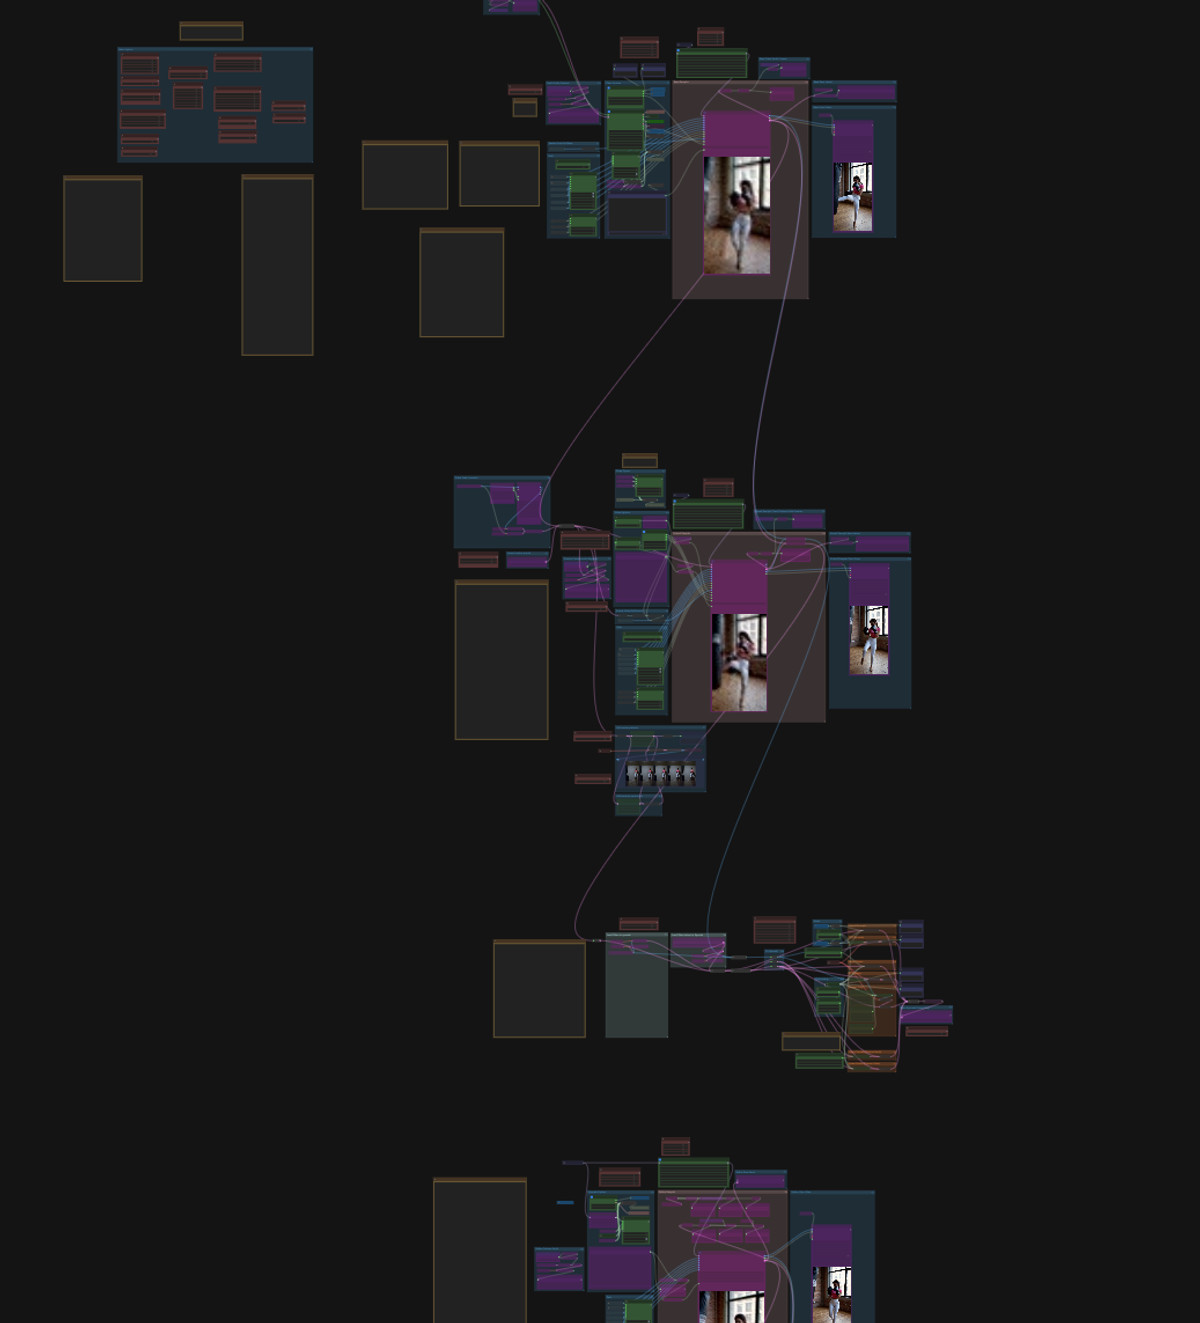
Version bêta v6 d'un workflow ComfyUI intégré pour H3 (génération vidéo à partir d'une référence, continuation par lots, agrandissement en deux étapes, remplacement de vidéo) : l'interface a été réorganisée en un format pédagogique en 5 étapes, et l'auteur a lui-même signalé les problèmes non résolus.
Illustrations
Raisons de la recommandation
- Mise à jour de version : l'interface est réorganisée en 5 étapes avec des explications ajoutées ; le commutateur de référence vidéo est plus facile à activer ; la fonction « Mémoires » (Memories) ne nécessite plus un point de coupure par défaut, elle est désormais mise en sourdine plutôt que court-circuitée.
- Les sigmas par défaut pour l'agrandissement en deux étapes sont passés de 0.65, 0.44, 0 à 0.72, 0.44, 0 ; comme le nœud d'agrandissement latent natif de ComfyUI produit des artefacts en blocs, le nœud d'agrandissement personnalisé de v5 a été réintroduit.
- Pour le remplacement de vidéo, l'auteur renvoie aux LoRA de remplacement de personnage / transfert de mouvement du projet Alissonerdx/Minimax-H3-ComfyUI, précisant que ces LoRA ne nécessitent pas de LoRA de distillation et fonctionnent en 8 étapes.
Comment l'utiliser
- Décompressez minimaxv6Tutorial.zip et exécutez chaque étape selon les instructions des 5 phases du workflow.
- Pour le remplacement de vidéo, utilisez Char swap 1.1 ; motion transfer tara permet aussi de changer l'arrière-plan ; l'auteur affirme que le remplacement est optimal avec une longueur de lot de 124 images.
- Pour les autres paramètres d'échantillonnage, consultez les valeurs par défaut dans le workflow.
Risques et limitations
- L'auteur se déclare en bêta : après une mise à jour de ComfyUI, le nœud ref2vid a ajouté des connexions d'usage inconnu, que l'auteur soupçonne d'interférer avec les images de référence ; l'agrandissement latent natif produit des artefacts en blocs.
- Seuls 1 exemples visibles (images), 7 sont masqués.
- Le workflow est volumineux, l'auteur affirme ne l'avoir testé que sur son propre ordinateur de milieu de gamme ; l'archive pèse environ 41 Mo, vérifiez le contenu vous-même avant utilisation.
【B】MiniMax H3_SparseRef15_Hybrid · Turbo V3.0_P-P_INT8_conv
Modèle de base / Checkpoint · Mise à jour de version · Auteur Aki7777777 · Publié le 11-20 16:58 · Téléchargements 65
La version Turbo V3.0 du modèle de base hybride expérimental SparseRef15 Hybrid pour H3 : un modèle complet quantisé en Pruned Partial-INT8, dont les notes de version indiquent une accélération en 4 étapes (démarrage à chaud QKVM), visant à maintenir la cohérence des références et la stabilité des séquences longues avec un faible nombre d'étapes.
Illustrations
Raisons de la recommandation
- Approche du modèle de base : basé sur FL2VA, l'influence AdaLN de Ref2VA est ajoutée de manière éparse uniquement sur 15 des 50 blocs transformer principaux, afin de conserver simultanément la liberté de mouvement de FL2VA et la cohérence des personnages de Ref2VA ; les auteurs affirment que la dérive des personnages est rare lors de générations longues en plusieurs segments
- Mise à jour de version : les auteurs indiquent que cette version accélérée conserve le style du modèle original, tout en réduisant le flou de l'image et en améliorant la stabilité des séquences longues
- Partial-INT8 : les grandes matrices d'attention / MLP sont converties en ConvRot INT8, tandis qu'AdaLN et la condition temporelle restent en FP32 ; un fichier de configuration du contexte d'action pour 13 segments de caméra continue est inclus dans cette version
Comment l'utiliser
- Remplacez le chargement du modèle de base H3, choisissez l'un des deux fichiers : partial-int8 ou partial-int8_convrot (les auteurs n'ont pas précisé la différence)
- Avertissement explicite des auteurs : ce n'est pas un modèle Ref2V natif, utilisez les LoRA entraînés pour FL2VA, et non ceux de Ref2V
- Utilisez 4 étapes selon les notes de version ; les paramètres CFG et l'échantillonneur ne sont pas fournis par les auteurs
- Peut être combiné avec le fichier H3_MotionContext_5Ch_13Clips_ContinuousCamera_Compact.json fourni pour effectuer des générations continues en plusieurs segments
Risques et limitations
- Aucun exemple visible (1 sont masqués)
- Le nom de la version est Turbo V3.0, mais les notes de version indiquent « Version 2.0 » et « LoRA en 4 étapes » ; les auteurs n'ont pas clarifié si le LoRA d'accélération a été fusionné dans le modèle de base, ni sa relation avec Turbo V1.0
- Les deux fichiers INT8 pèsent environ 20 Go chacun
- La fiche complète du modèle mentionne que pour cette série, une intensité de référence trop forte compresse la liberté scénique ; les intrigues nécessitant que les personnages quittent l'écran pendant longtemps ne conviennent pas bien
- L'image d'illustration de la fiche est un schéma généré par IA, et non le rendu réel du modèle ; les auteurs n'ont publié aucun exemple standard
【B】Minimax-H3_latent_upscaler · v2.0
Flux de travail · Mise à jour de version · Auteur mo_akkakk · Publié le 11-20 18:12 · Téléchargements 34
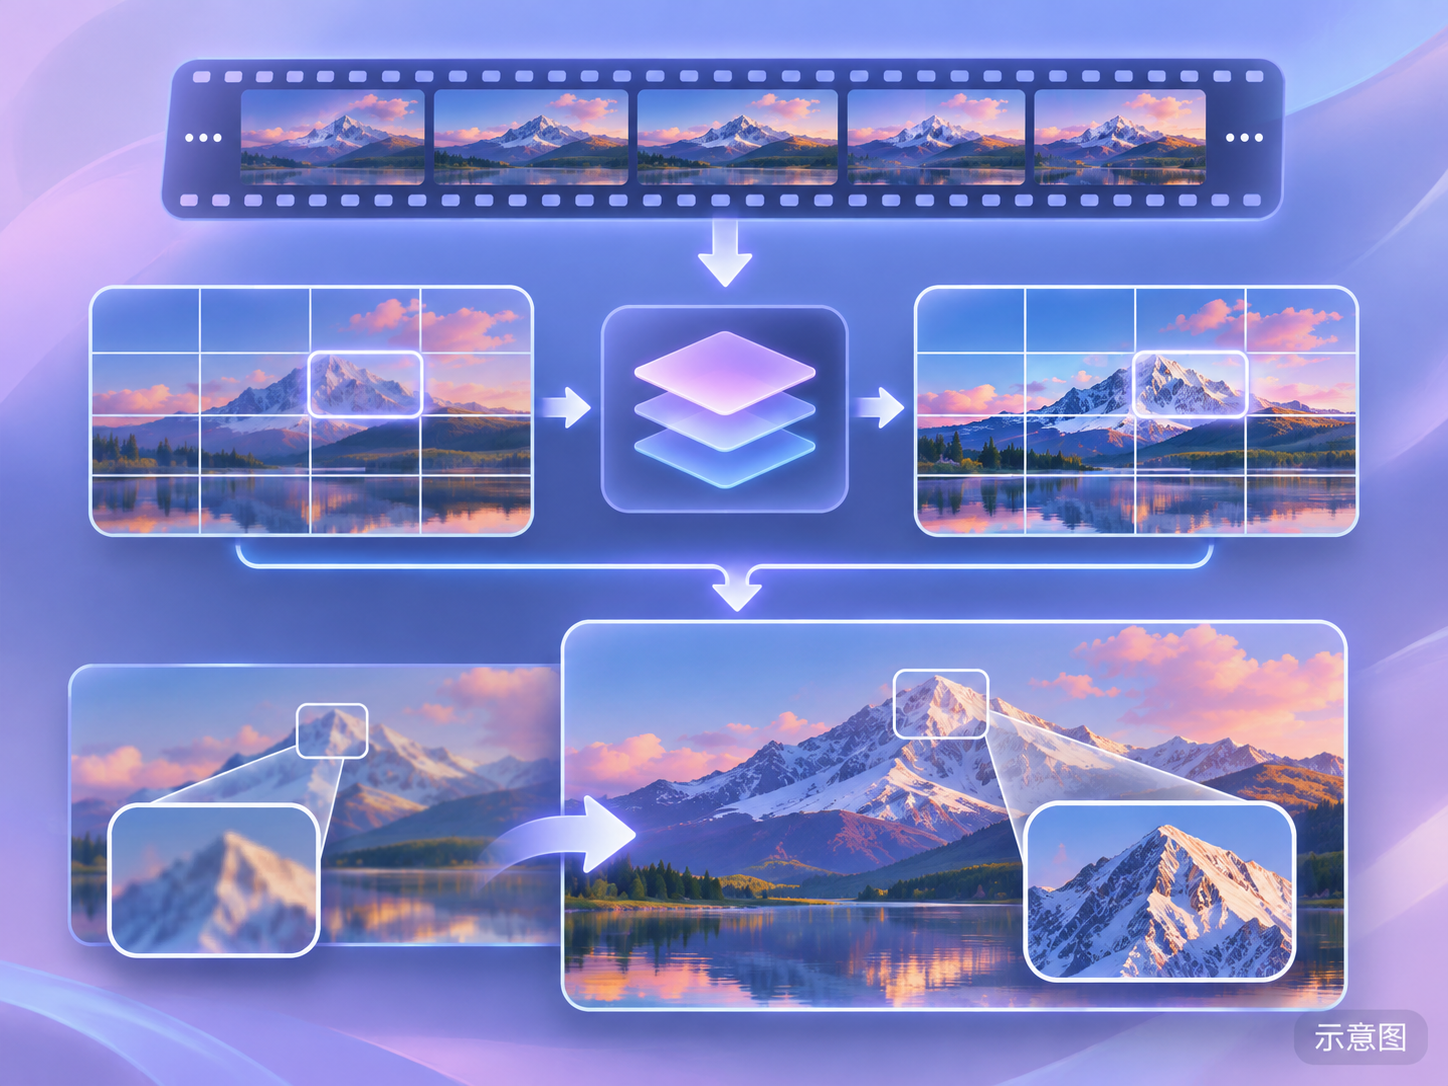
Workflow vidéo à vidéo H3 utilisant les nœuds de fenêtre temporelle / de découpage spatial créés par l'auteur : diviser l'image en tuiles et la durée en fenêtres temporelles pour une génération par lots, destiné au V2V haute résolution ou à l'agrandissement en seconde passe.
Illustration
Raisons de la recommandation
- Résout le problème de manque de mémoire vidéo pour les vidéos longues et le V2V haute résolution : génération par tuiles et fenêtres temporelles, l'auteur affirme que le transfert de mouvement reste précis, sans décalage ni fantômes.
- L'auteur indique qu'il est possible d'atteindre 2.5 MP dès la première passe sur une carte RTX disposant de 12 Go de mémoire vidéo.
- Peut également servir à l'agrandissement en seconde passe, en décomposant les vidéos longues haute résolution en tuiles et fenêtres pour le traitement.
Mode d'emploi
- Installez le paquet de nœuds comfyui-minimax-h3-temporal-window-spatial-tiles de mo-akkakk depuis Comfy Registry, puis chargez Minimax-H3_latent_upscaler.json.
- L'auteur ne fournit pas de valeurs recommandées pour la taille des tuiles, le chevauchement ou la longueur des fenêtres ; il joint un tutoriel YouTube.
Risques et limitations
- L'auteur n'a pas écrit de notes de mise à jour, il est donc difficile de savoir ce que la version v2.0 a changé par rapport à la précédente
- Aucun exemple visible (1 sont masqués)
- Il s'agit d'un JSON de workflow, pas de nouveaux poids
- L'image de la carte est un schéma généré par IA, et non le rendu réel du modèle ; l'auteur ne propose pas d'exemples publics de niveau standard
【B】Minimax-H3_Video_Editing_1STG_2Batchs · v3.0
Workflow · Mise à jour de version · Auteur mo_akkakk · Publié le 11-20 18:05 · Téléchargements 26
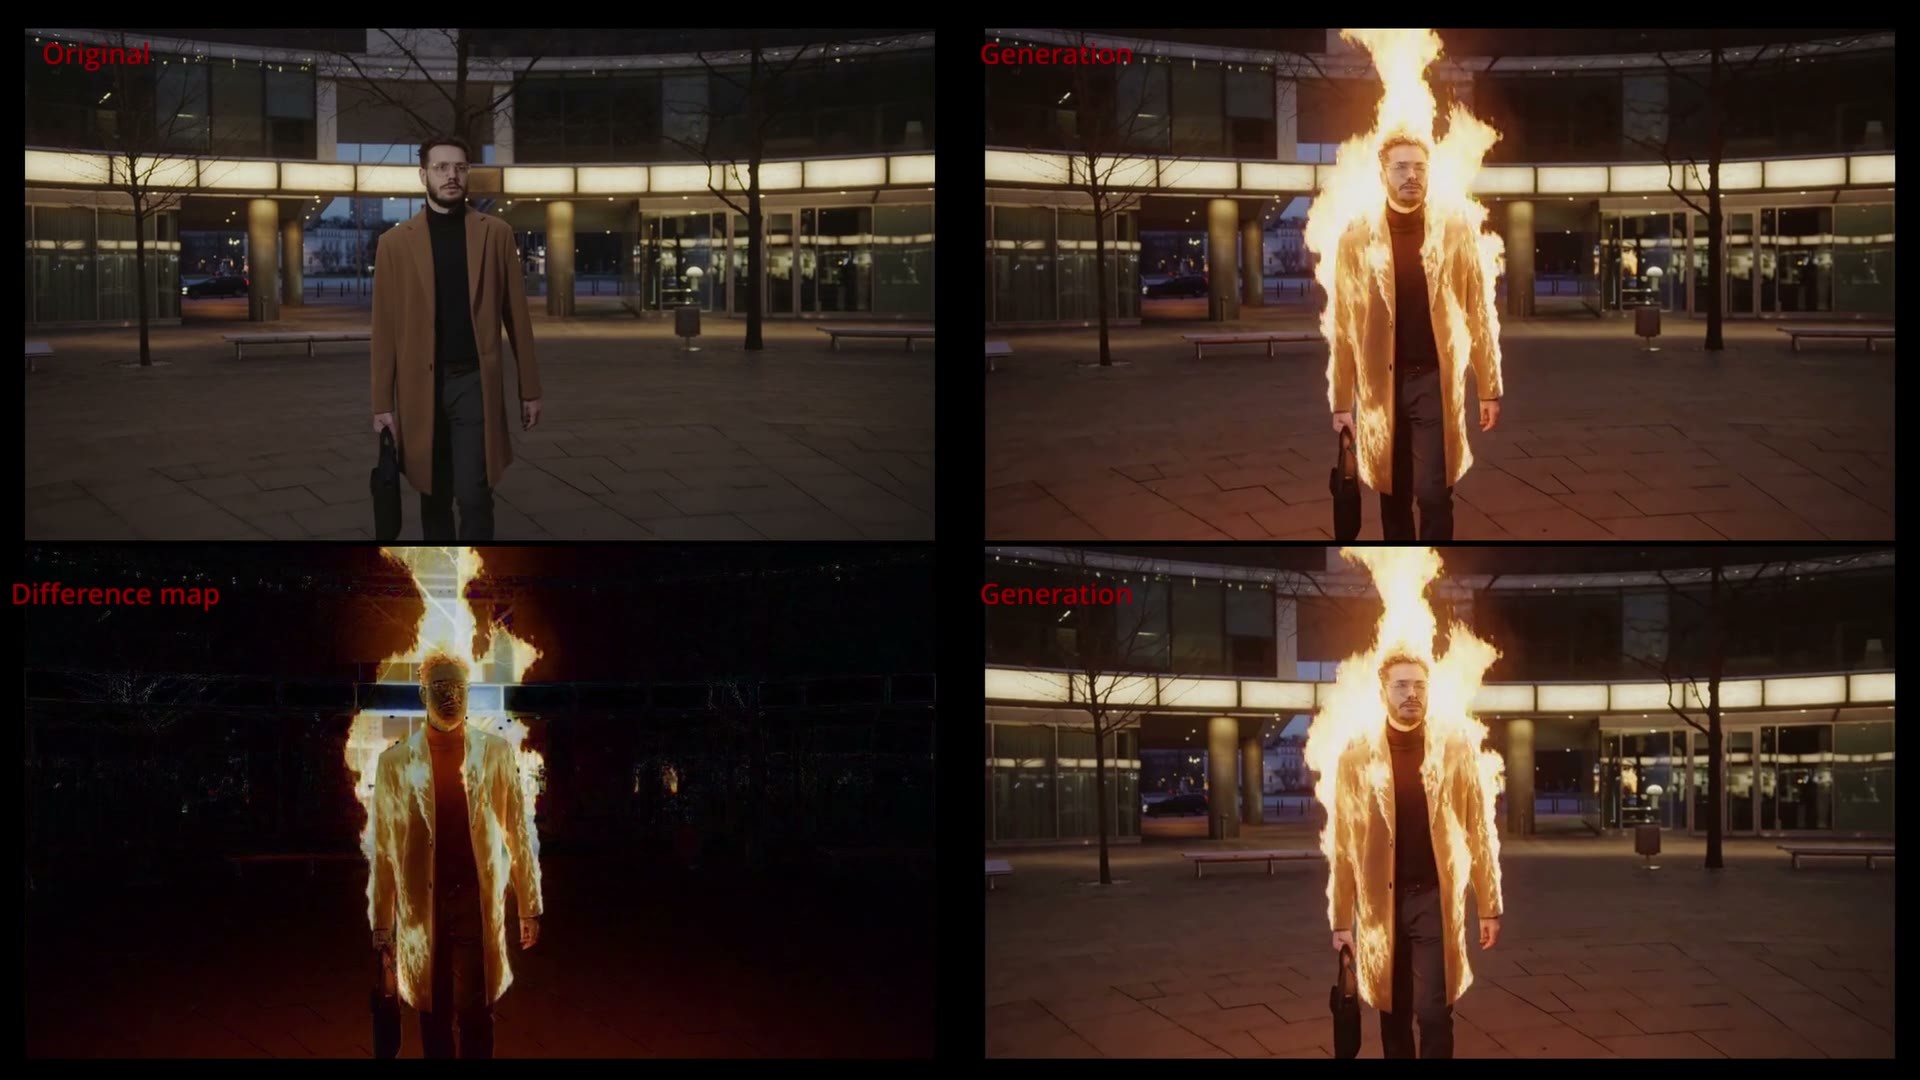
Un workflow d'édition vidéo (V2V) v3.0 qui divise un plan en deux lots de génération pour éviter de dépasser la limite maximale de tokens de H3.
Image illustrative
Raisons de la recommandation
- Conçu pour l'édition vidéo longue durée (vidéo à vidéo) : lorsque la génération en un seul lot atteint la limite de tokens, le processus est divisé en deux lots
- Mise à jour de version : l'auteur a simplement indiqué « amélioration du workflow et mise à jour des nœuds personnalisés »
- 1 exemples vidéo visibles sont disponibles, gratuits, accompagnés d'un tutoriel YouTube de l'auteur
Comment l'utiliser
- Chargez Minimax-H3_Video_Editing_1STG_2Batchs.json et installez les nœuds personnalisés manquants selon les invites affichées
- L'auteur ne précise pas comment diviser les deux lots ni le taux de chevauchement ; consultez la vidéo du tutoriel
Risques et limitations
- La description tient en une seule phrase, l'auteur n'a pas détaillé les modifications spécifiques
- Partage le même tutoriel vidéo que plusieurs autres workflows mis à jour par le même auteur le même jour
- Il s'agit d'un JSON de workflow, pas de nouveaux poids
Inclus uniquement (6)
- KinetiX Combat Semantic Bridge (MiniMax-H3) · LoL V2 — LoRA : Le LoRA « KinetiX Combat Semantic Bridge » pour LoL V2 : le nom fait référence à des actions de combat typiques de League of Legends, mais cette version de la carte du modèle ne fournit aucune explication sur les effets ou l'utilisation, il faut se fier aux articles externes de l'auteur.
- Rise Kujikawa Voice (Eng) - Persona 4 - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA : Un LoRA H3 entraîné uniquement sur la voix : basé sur des extraits du doublage anglais de Rise Kujikawa dans Persona 4, permettant aux personnages des vidéos générées de parler avec sa voix anglaise.
- MiniMax_H3_Inpaitning_1STG · v2.0 — Workflow : Un workflow ComfyUI en une seule étape pour l'inpainting vidéo H3 (v2.0), la carte du modèle ne contient que le titre et un lien vers le tutoriel vidéo.
- MiniMax H3 Video to Video Workflow · v5.0 — Workflow : La version v5.0 du workflow principal de vidéo à vidéo H3 par le même auteur (une seule étape, nom de fichier Minimax-H3_Video_Editing_1STG), cette mise à jour indique simplement « amélioration du workflow et mise à jour des nœuds personnalisés ».
- Minimax-H3_Video_Editing_Ripple · v2.0 — Workflow : Un workflow ComfyUI v2.0 pour l'édition vidéo H3 utilisant le LoRA Ripple, la carte du modèle ne contient qu'une phrase et un lien vers le tutoriel vidéo.
- MiniMax_H3_Inpaitning_cropping_1STG · v2.0 — Workflow : Un workflow d'inpainting vidéo H3 v2.0 incluant une étape de recadrage (Inpainting + cropping), la carte du modèle ne contient que le titre et un lien vers le tutoriel vidéo.
Données : API publique de Civitai (modèle de base MiniMax H3), période d'inclusion du 11-20 08:31 au 11-20 21:01 (heure de Pékin). Les raisons de la recommandation ont été vérifiées par la rédaction ; le nombre de téléchargements reflète uniquement l'intérêt porté.