貞貞のAIレーダー · MiniMax H3 · 2026-11-20 夕刊
今号の 13 件の新バージョン:強く推奨 1 件 · 推奨 2 件 · 注目 4 件 · 収録のみ 6 件
編集者による注釈 今号では H3 の新バージョン 14 件をレビューし、S 評価 1 件、A 評価 2 件、B 評価 4 件、C 評価 6 件と判定しました。除外は 1 件です。初公開の KinetiX グローバル風力スライダーは、トリガーワード不要で、正の値ではマント、髪、草木が風に揺れ、負の値では完全に無風の映像を生成します。強度の段階設定とプロンプトテンプレートも提供されています。Secret Squirrel の太線アニメーション画風と H3MD Director 0.5.8 のマルチキャラクター置換修正は A 評価としました。mo_akkakk が同日更新した 5 件のワークフローは説明が簡素すぎるため、B / C 評価としました。Qwen Image 2.1 の九宮格ワークフローは H3 と誤ってタグ付けされていたため除外しました(Qwen 2.1 セクションに分類)。
強く推奨(1)
【S】KinetiX Weather System Series · Global Wind Force V1.0
LoRA · バージョン更新 · 作者 make676767 · 公開 11-20 10:45 · ダウンロード数 97
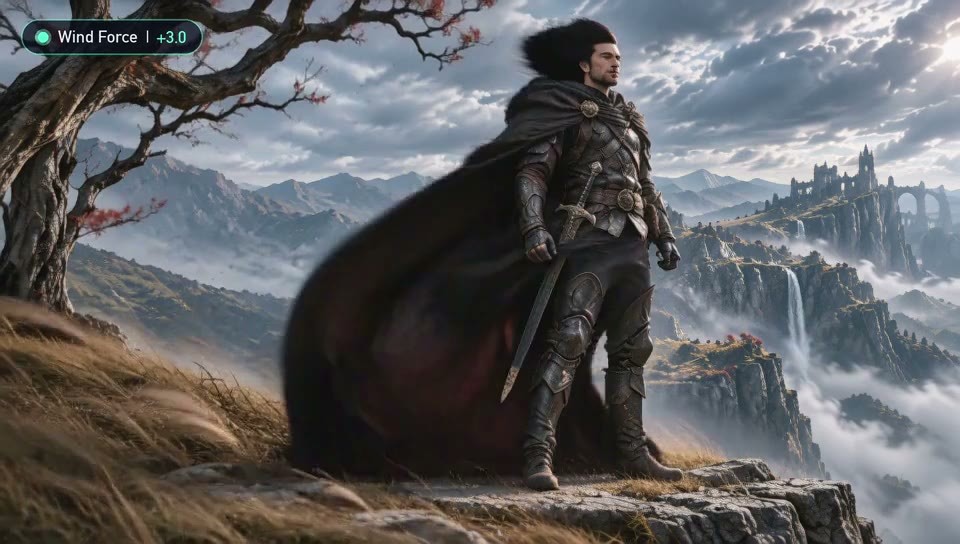
正負両方の値を設定できるグローバル風力スライダー LoRA:正の値ではマント、髪、草木、旗、カーテンが同じ方向に風で揺れ、負の値では映像が完全に無風となり、布地が垂直に垂れ下がります。
同じプロンプトで -3 / 0 / +2.5 の3段階を比較し、布地や草木の変化を確認するのに適しています。
画像
推奨理由
- KinetiX 天気シリーズの新メンバー(同ページには既にひょう、体積霧、雨、昼夜、雪があります)。このバージョンは新しい風力制御 LoRA であり、既存 LoRA の改訂版ではありません
- 「同じカット内で風の強弱を制御しにくい」という問題を解決:作者によれば、気流そのもののみを制御し、砂塵、霧、色調の黄色化や暗転は付随せず、カメラ位置、建物、人物の構造も歪みません
- 作者は強度の段階設定、正負それぞれのコピペ可能なプロンプトスニペット、および overall_soundscape / non_diegetic_music フィールドを含む3種類の完全なテンプレートを公開しています
- 2 本の動画サンプルが確認可能、無料、ライセンスは商用利用と販売を許可しています
使い方
- トリガーワードなし、読み込み後に重みを設定:+0.8~+1.5 で微風、+2.0~+3.0 で作者推奨の強風スイートスポット、+3.5~+5.0 で極端な暴風、0 でベースモデルのデフォルト、-2.0~-5.0 で完全な無風
- 正方向のプロンプトには fierce directional wind gale, high-velocity aerodynamic wind pressure, billowing fabrics and windswept motion を、負方向には dead calm windless atmosphere などの記述を併用
- 作者のテンプレート参考:崖上の戦士 +2.5、屋上での対峙 +2.2、室内の無風 -3.0;同シリーズの砂嵐、豪雨、雷鳴およびカメラシェイクスライダーとの組み合わせレシピは完全なモデルカードに記載
- ステップ数、サンプラーについては作者から指定なし
リスクと制限
- 添付の workflow_resources 圧縮ファイルは学習データタイプとしてマークされており、セキュリティスキャンは未完了です
- 5 件のサンプルが非表示です
- 実際のファイル名は _v1 ですが、説明と組み合わせレシピには _v1.0 と記載されています。実際のファイル名で読み込んでください
推奨(2)
【A】Secret Squirrel 1993 ArtStyle · triple zero
LoRA · 新モデル · 作者 OrioTysumi · 公開 11-20 15:24 · ダウンロード数 39
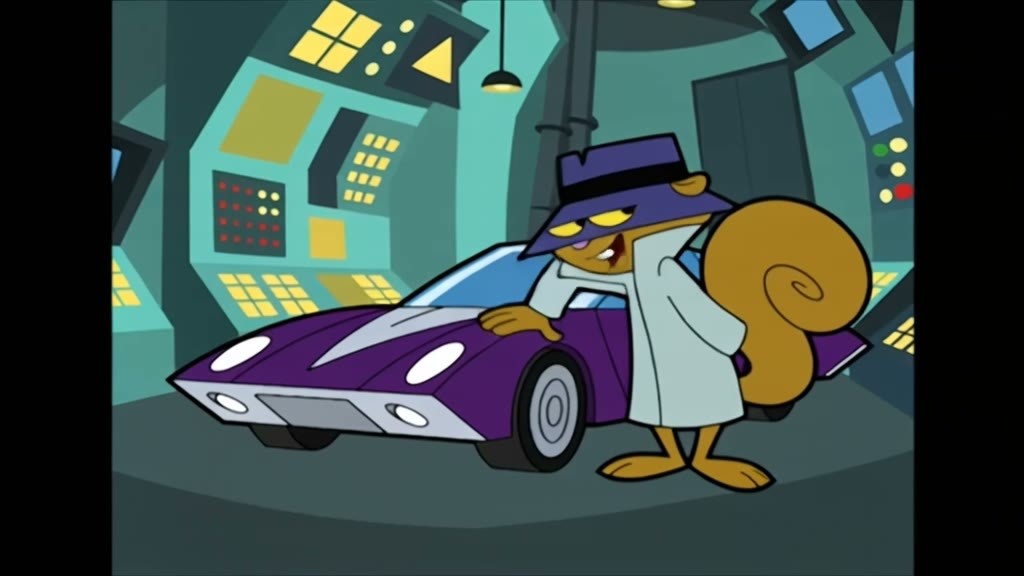
1993年の Hanna-Barbera アニメ『Super Secret Secret Squirrel』の太い黒縁、フラットカラーの画風 LoRA。作者は、自分のキャラクター参考画像をこの画風に変換するために、参考画像から動画を生成する機能(R2VA)の使用を推奨しています。
画像
推奨理由
- 新モデル:キャラクターを 90 年代の太線テレビアニメ風にする参考画像から動画を生成する機能を提供。テキストから動画を生成する機能(T2VA)でも使用可能ですが、強度を下げる必要があります
- 作者のパラメータ設定が充実:強度、併用する加速 LoRA、サンプラー、スケジューラー、ステップ数、プロンプトキーワードがすべて記載されています
- 7 本の動画サンプルが確認可能、無料ダウンロード
使い方
- R2VA モードの強度は 1;T2VA モードでは 0.5 以下に下げないと、キャラクターがランダムに Secret Squirrel の紫色のソフトフェルトハットをかぶってしまいます
- DMAD 4-step LoRA と併用し、サンプラーは er_sde、スケジューラーは beta、ステップ数は 6 または 8
- トリガーワードなし、プロンプトに 'thick-line animation style' または '2D animated sequence with thick black outlines and flat colors' を追加
- 出力解像度は 16:9 に設定、有効な映像領域は 4:3 に近づきます
リスクと制限
- 学習動画の左右の黒帯がトリミングされていないため、生成映像にも左右の黒帯が含まれます(作者が説明済み);4:3 を選択すると有効な映像領域は 1:1 に近づきます
- 2 件のサンプルが非表示です
- 著作権のあるアニメ画風であり、ライセンスはサイト内でのレンタルのみを許可しています。商用利用には著作権リスクを自己判断する必要があります
【A】H3MD Director 0.5 – 2–3 min videos with MiniMax H3: multi-character swap, wide-shot face refine, seamless CCW · v0.5.8 keyframe mask fix
ワークフロー · バージョン更新 · 作者 1113800942188 · 公開 11-20 11:09 · ダウンロード数 81
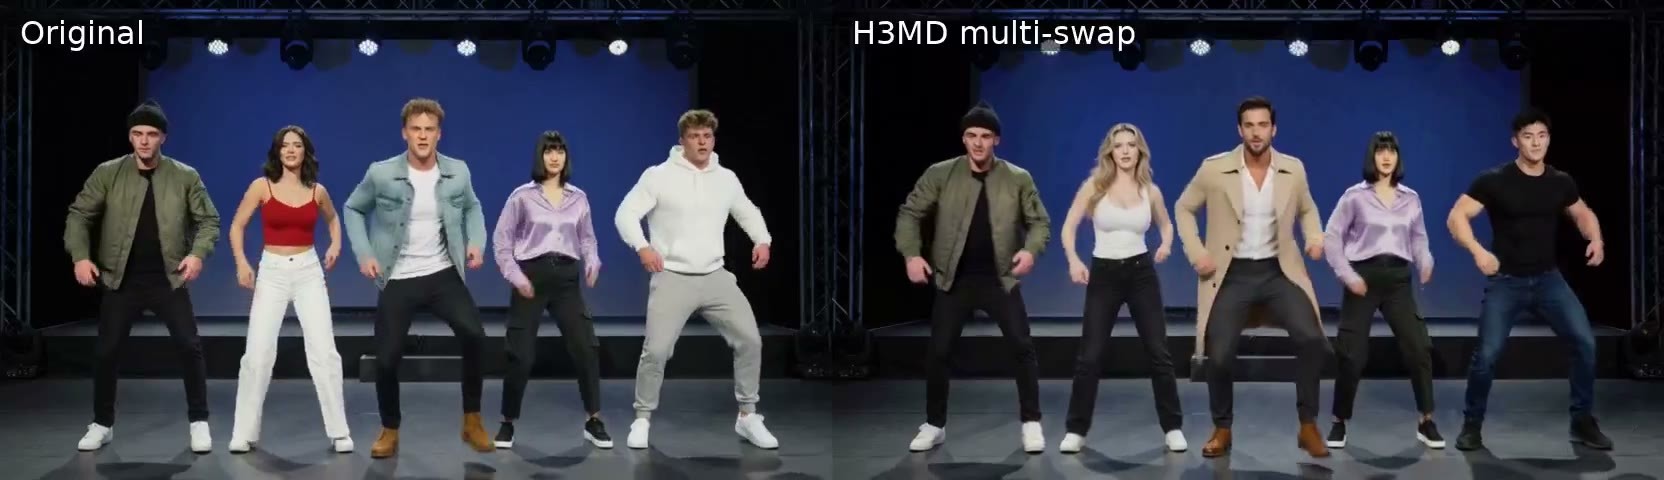
無料オープンソースの H3 長尺動画ノードパッケージ H3MD Director のマイナーバージョン:マルチキャラクター置換のキーフレームマスク手順を改善し、人物ごとに個別に再描画する H3MD Keyframe 1b: Recast ノードを追加しました。
画像
推奨理由
- バージョン更新:Recast で人物を個別に再描画し、各人物の切り抜きは「前の人物が既に置き換わった」フレームから取得されるため、元のキャラクターが新しいキャラクターより体格が大きい場合に残留するかつら、耳、尻尾、大きなスカート、エプロン、靴下などが新しい人物の周囲に残らなくなります
- Prepare は元の動画のカットポイントを特定し、各カットに少なくとも1つのキーフレームを配置するため、カット後に同じ人物が二重に描画されることがありません
- ツール自体:ComfyUI で H3 を使用して一度に 2–3 分の長尺動画(単一の長回しか、計画通りに配置された一連のカット)を生成可能。0.5 以降では、同一動画内での 3–5 人の置換と遠景の顔修正に対応。本バージョンのディレクターズワークフローは変更なし、キーフレームワークフローのみ修正
使い方
- ComfyUI Manager でノードを更新するか git pull を実行し、Recast を使用するように変更された圧縮ファイル内の Keyframe ワークフローを使用
- 新しいスライダー mask_grow のデフォルトは 0.25;元の動画の人物がコスプレのような大柄な体格の場合は 0.3–0.35 に調整
- 作者は、各キャラクターの説明に靴、脚部の着用状況、および着ていないものを明記することを推奨しています。例:"bare legs, black heels; no socks, no boots"
- 作者が示す VRAM 要件:16 GB 以上、推奨 24 GB 以上;4B テキストエンコーダーオプションで VRAM を節約可能
リスクと制限
- 本バージョンでは 1 件のサンプルのみが確認可能で、2 件は非表示です
- 完全なモデルカードには ComfyUI 0.43 以上が必要と明記されており、シームレスな長尺動画(CCW)には 0.44 以上が必要です
- ノードは AGPL-3.0 ライセンスであり、H3 の重みはパッケージに含まれず、別途ライセンスがあります;モデルカードには RunningHub の招待リベートリンクが含まれています
注目(4)
【B】Minimax.. simple · v6 Tutorial beta
ワークフロー · バージョン更新 · 作者 sy0ww4bb1984 · 公開 11-20 14:39 · ダウンロード数 32
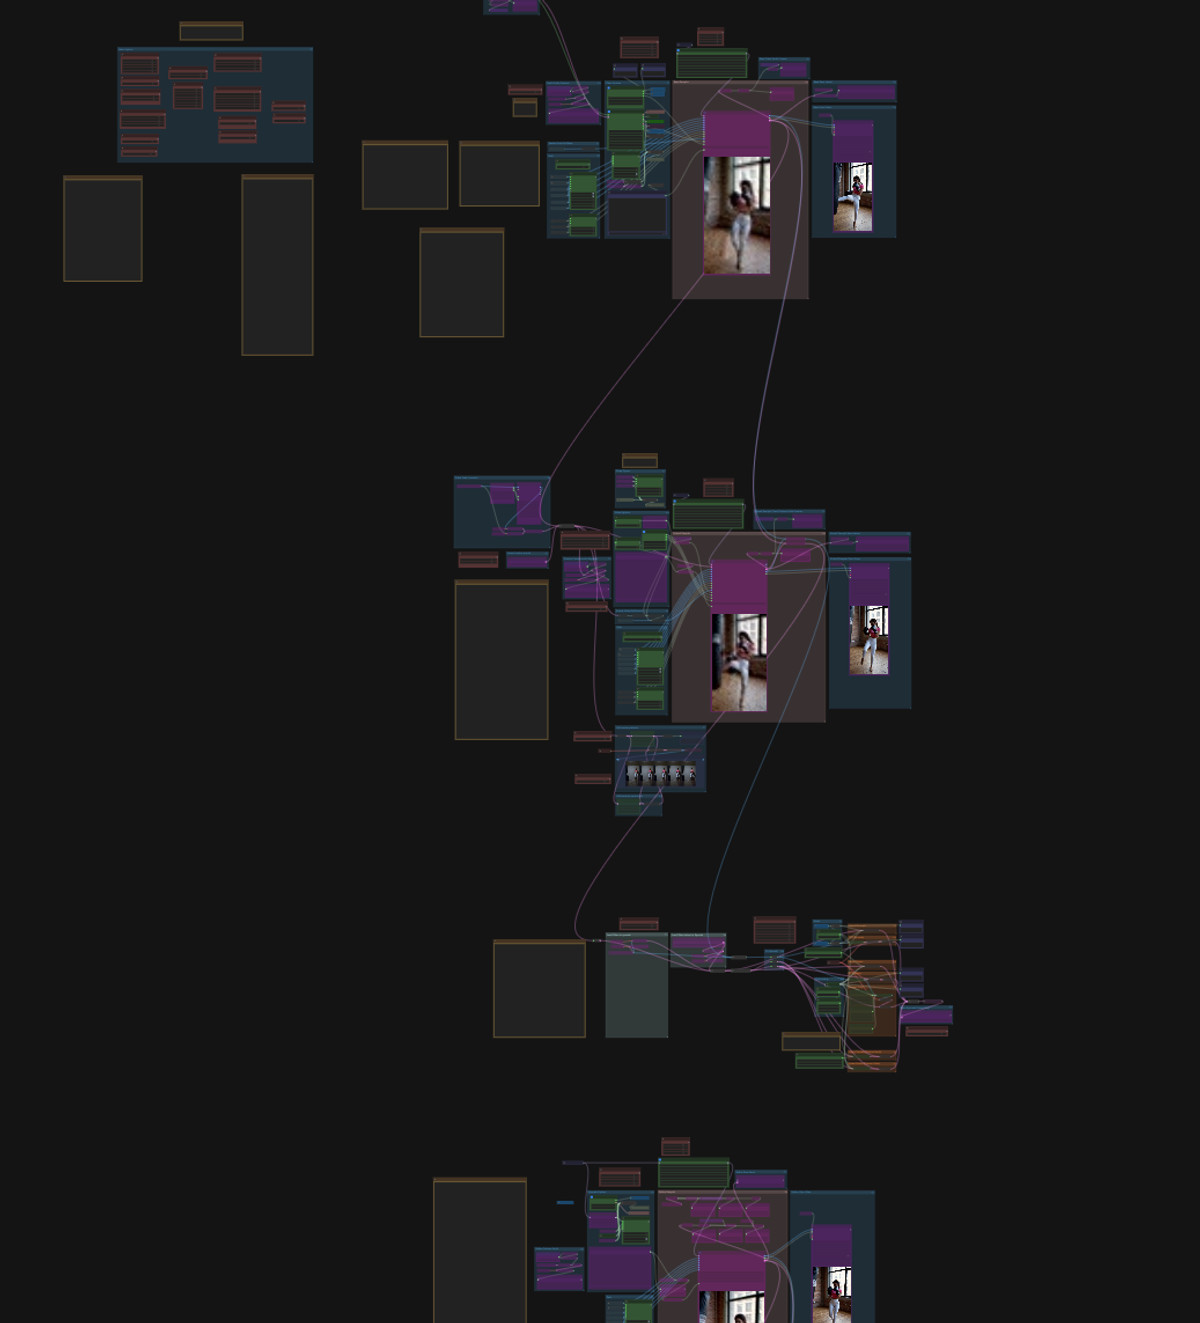
H3 一体化 ComfyUI ワークフロー(参考画像から動画生成、バッチ続き書き、2段階アップスケール、動画置換)の v6 ベータ版:インターフェースが 5 段階のチュートリアル形式レイアウトに変更され、作者が未解決の問題を明示しています。
画像
推奨理由
- バージョン更新:インターフェースを 5 段階に再配置し、説明を追加;動画参考スイッチの有効化が容易に;「記憶」(Memories)はデフォルトのカットポイントが不要になり、バイパスではなくミュートに変更
- 2段階アップスケールのデフォルト sigma を 0.65, 0.44, 0 から 0.72, 0.44, 0 に変更;ComfyUI ネイティブの潜在空間アップスケールノードでブロックノイズが発生するため、v5 のカスタムアップスケールノードを再追加
- 動画置換を行う際、作者は Alissonerdx/Minimax-H3-ComfyUI のキャラクター置換 / モーション転送 LoRA を参照しており、これらの LoRA は蒸留 LoRA を必要とせず、8 ステップで十分だと述べています
使い方
- minimaxv6Tutorial.zip を解凍し、ワークフロー内の 5 段階の説明に従ってセクションごとに実行
- 動画置換には Char swap 1.1 を使用;motion transfer tara は背景ごと置換可能;作者によれば、バッチ長 124 フレーム時に置換効果が最も良い
- その他のサンプリングパラメータはワークフロー内のデフォルト値を参照
リスクと制限
- 作者自身がベータ版と称している:ComfyUI 更新後、ref2vid ノードに用途不明の接続が追加され、作者は参考画像への干渉を懸念;ネイティブ潜在空間アップスケールでブロックノイズが発生
- 確認可能なサンプルは画像 1 枚のみで、7 件は非表示
- ワークフローは大容量で、作者は自身のミドルレンジPCでのみテスト済みと述べています;圧縮ファイルは約 41 MB あり、使用前に内容を自己確認してください
【B】MiniMax H3_SparseRef15_Hybrid · Turbo V3.0_P-P_INT8_conv
ベースモデル / Checkpoint · バージョン更新 · 作者 Aki7777777 · 公開 11-20 16:58 · ダウンロード数 65
実験的な H3 ハイブリッドベースモデル SparseRef15 Hybrid の Turbo V3.0:Pruned Partial-INT8 量子化されたフルモデル。バージョン説明には 4 ステップ高速化(QKVM ウォームスタート)と記載されており、低ステップ数での参考画像の一貫性と長尺シーケンスの安定性を維持することを目標としています。
画像
推奨理由
- ベースモデルの考え方:FL2VA を基盤とし、50 個のメイン transformer ブロックのうち 15 個にのみ Ref2VA の AdaLN の影響をスパースに追加することで、FL2VA の動きの自由度と Ref2VA のキャラクターの一貫性を同時に維持することを目指している。作者は、複数セグメントにわたる長い生成においてキャラクターのドリフトがほとんど発生しないと述べている
- バージョン更新:作者は、このバージョンの加速版は元のモデルのスタイルを保持しつつ、画面のぼやけを軽減し、長シーケンスの安定性を向上させると述べている
- Partial-INT8:大きなアテンション / MLP 行列を INT8 ConvRot に変換し、AdaLN と時間条件は FP32 を維持;同バージョンには 13 個の連続カメラワークのアクションコンテキスト設定ファイルが付属している
使い方
- H3 ベースモデルの読み込みを置き換え、partial-int8 と partial-int8_convrot の 2 つのファイルからいずれか 1 つを選択(違いは作者が記載していない)
- 作者は明確に注意を促している:これはネイティブの Ref2V モデルではないため、FL2VA 用に訓練された LoRA を使用し、Ref2V の LoRA は使用しないこと
- バージョンの説明に従って 4 ステップを使用;CFG、サンプラーは作者が提供していない
- 付属の H3_MotionContext_5Ch_13Clips_ContinuousCamera_Compact.json を使用して、複数セグメントの連続生成を行うことができる
リスクと制限
- 目に見えるサンプルがない(1 個が非表示)
- バージョン名は Turbo V3.0 だが、バージョン説明には「Version 2.0」と「4-step LoRA」と記載されている。加速用 LoRA がベースモデルに統合済みかどうか、また Turbo V1.0 との関係について作者は明確に説明していない
- 2 つの INT8 ファイルはそれぞれ約 20 GB
- 完全なモデルカードには、このシリーズの参照強度が強い場合、シーンの自由度が圧縮され、キャラクターが長時間画面外にいるプロットには適さないと記載されている
- カードの画像は AI 生成の概念図であり、モデルの実際の効果ではない;作者は公開されている一般レベルのサンプルを持っていない
【B】Minimax-H3_latent_upscaler · v2.0
ワークフロー · バージョン更新 · 作者 mo_akkakk · 公開 11-20 18:12 · ダウンロード 34
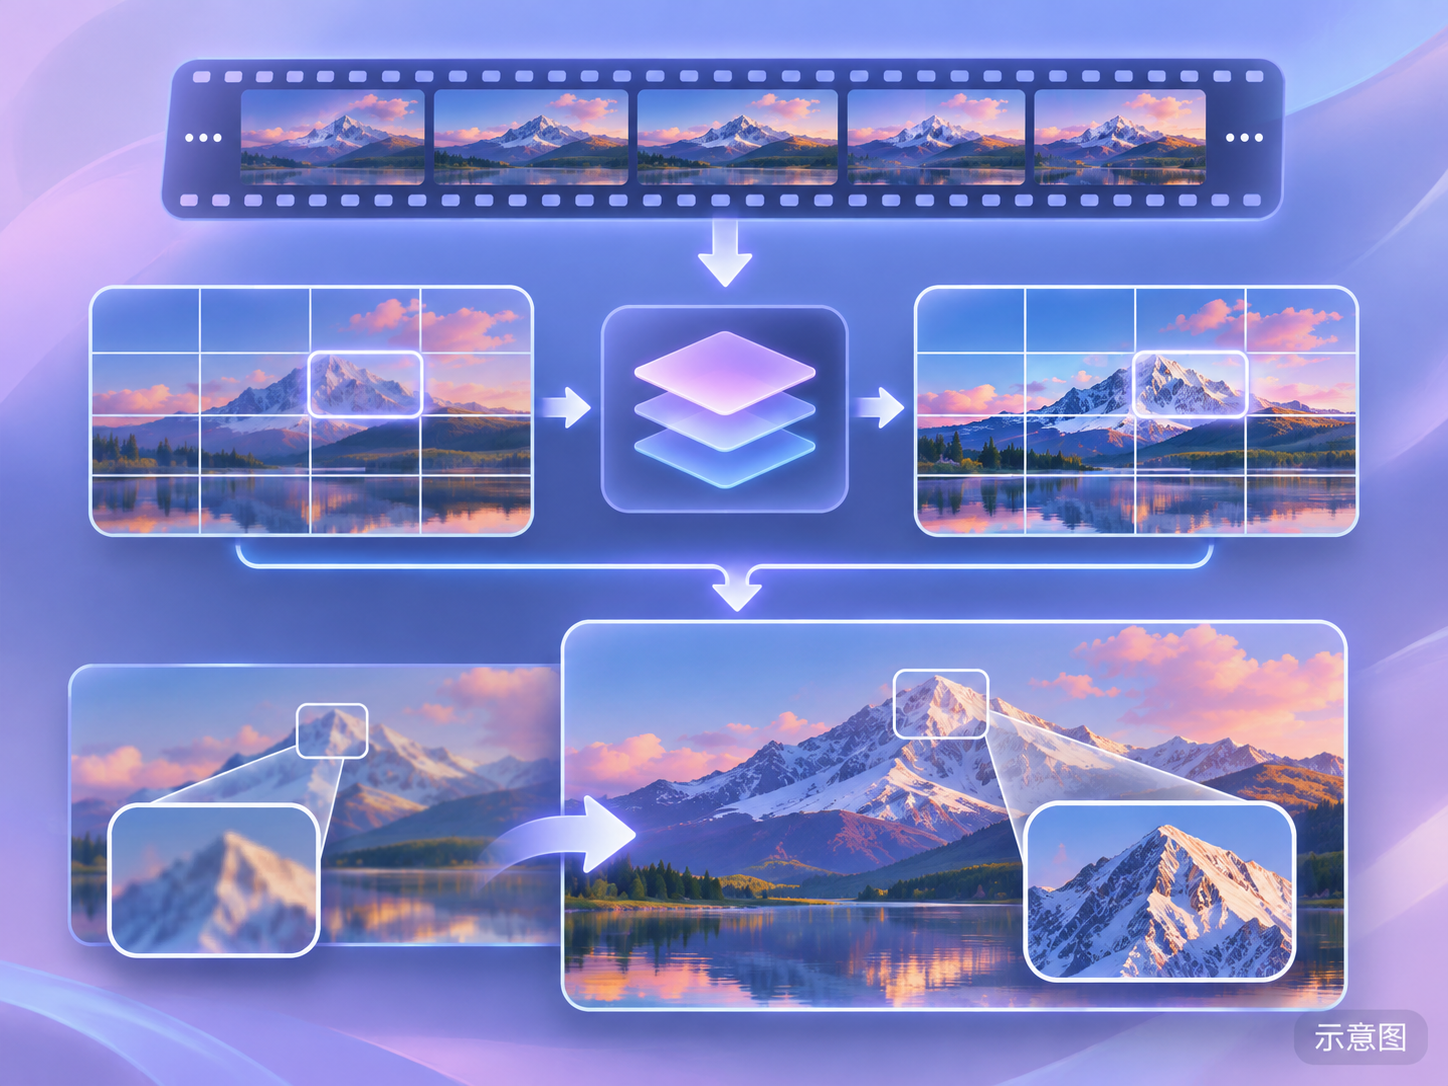
作者自作の時間ウィンドウ / 空間タイルノードと組み合わせた H3 の動画から動画へのワークフロー:画面をタイルに分割し、長さを時間ウィンドウに分割してバッチ生成することで、高解像度 V2V または第 2 段階のアップスケールに使用。
画像
推奨理由
- 長い動画、高解像度 V2V における VRAM 不足の問題を解決:タイル分割と時間ウィンドウによる生成で、作者はアクションの転移がずれたり、ゴースティングが発生したりしないと述べている
- 作者は、12GB の VRAM を搭載した RTX カードで、第 1 段階から 2.5 MP まで実行可能だと述べている
- 第 2 段階のアップスケールとしても使用可能で、高解像度の長い動画をタイルとウィンドウに分割して処理できる
使い方
- Comfy Registry から mo-akkakk の comfyui-minimax-h3-temporal-window-spatial-tiles ノードパッケージをインストールし、Minimax-H3_latent_upscaler.json を読み込む
- タイルサイズ、オーバーラップ、ウィンドウ長について作者は推奨値を提供していないが、YouTube チュートリアルを添付している
リスクと制限
- 作者は更新説明を記載しておらず、v2.0 が前バージョンから何を変更したのか不明
- 目に見えるサンプルがない(1 個が非表示)
- ワークフロー JSON であり、新しい重みではない
- カードの画像は AI 生成の概念図であり、モデルの実際の効果ではない;作者は公開されている一般レベルのサンプルを持っていない
【B】Minimax-H3_Video_Editing_1STG_2Batchs · v3.0
ワークフロー · バージョン更新 · 作者 mo_akkakk · 公開 11-20 18:05 · ダウンロード 26
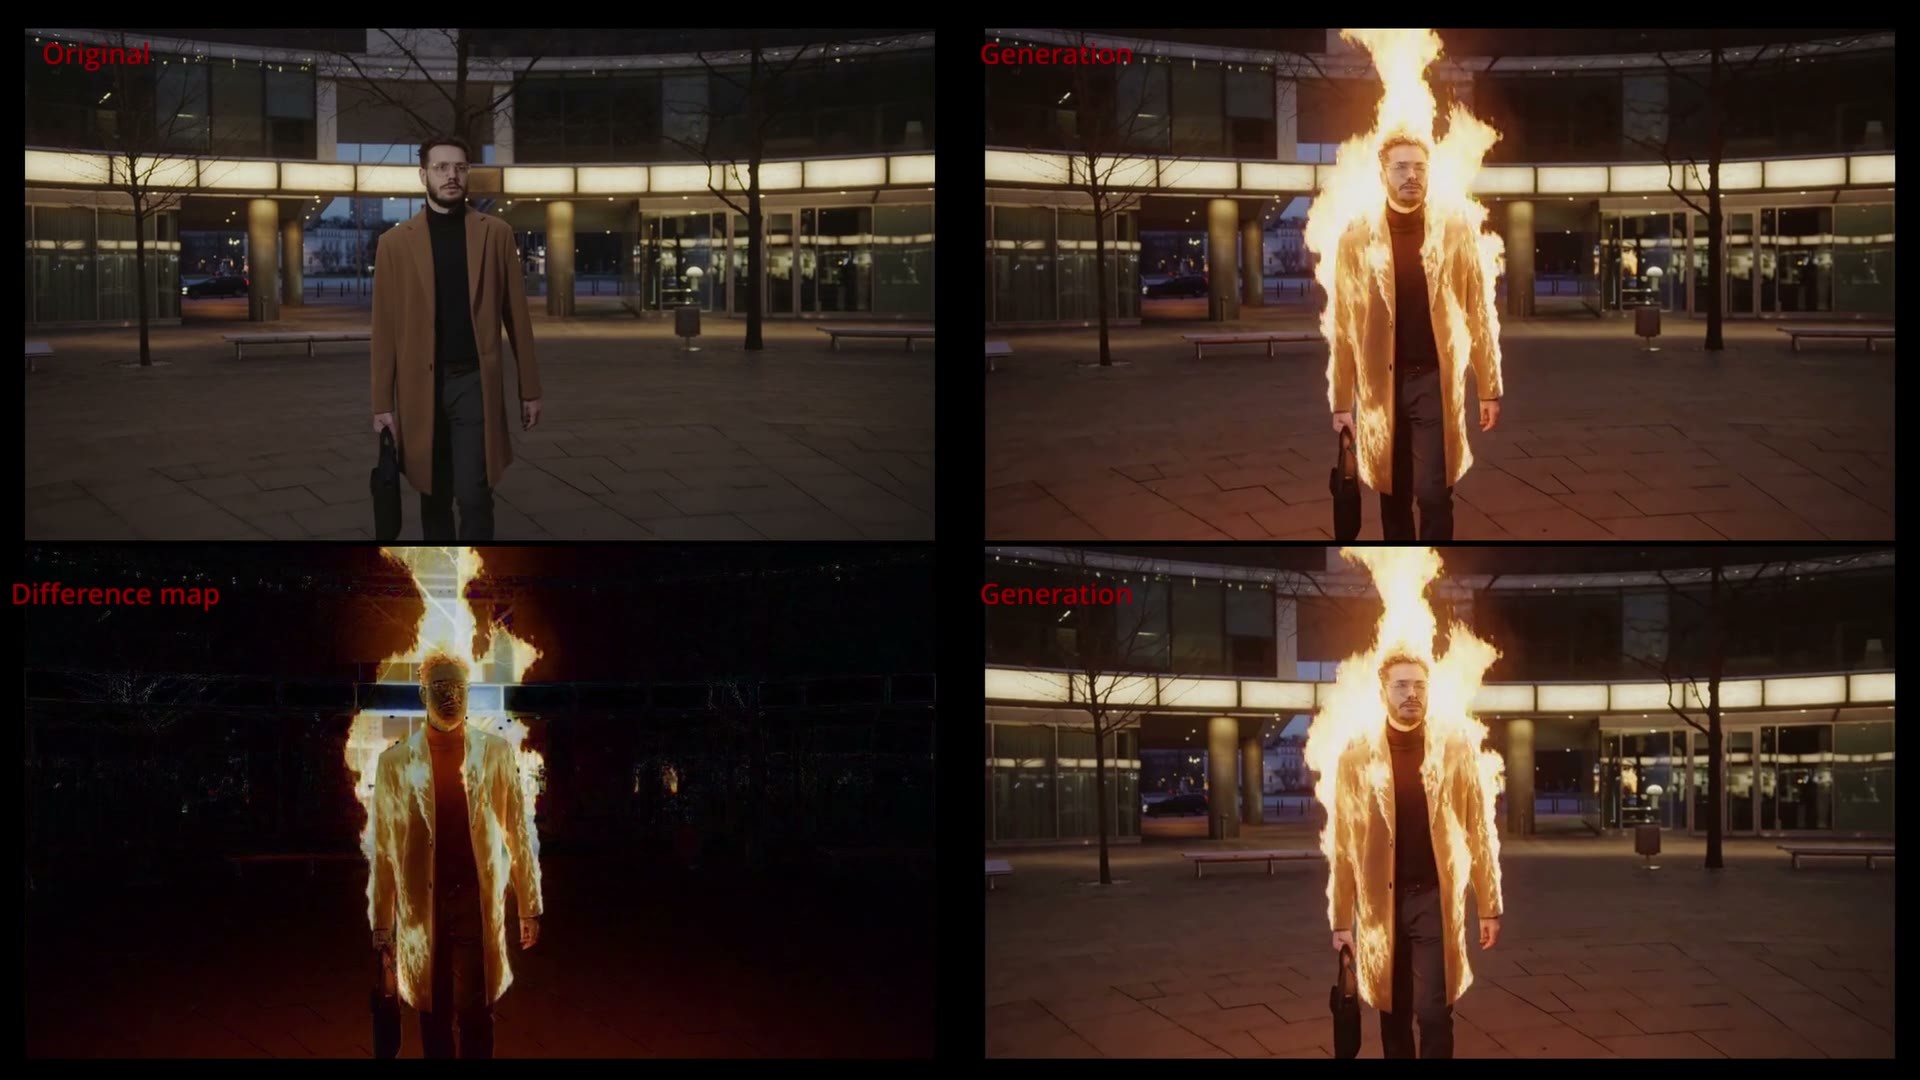
1 つのショットを 2 バッチに分割して生成し、H3 の最大トークン制限を超えないようにする動画編集(V2V)ワークフロー v3.0。
画像
推奨理由
- より長い動画から動画への編集に対応:単一バッチ生成でトークン上限に達する場合、2 バッチに分割して処理
- バージョン更新:作者は「ワークフロー強化、カスタムノード更新」とのみ記載
- 1 個の動画サンプルが確認可能、無料、作者の YouTube チュートリアルを添付
使い方
- Minimax-H3_Video_Editing_1STG_2Batchs.json を読み込み、不足しているというプロンプトに従ってカスタムノードを追加インストール
- 2 バッチの分割方法、オーバーラップ量について作者は提供していないため、チュートリアル動画を参照
リスクと制限
- 説明は一文のみで、具体的に何を変更したのか作者は記載していない
- 同日に同じ作者によって更新された他のいくつかのワークフローと、同じチュートリアル動画を共有している
- ワークフロー JSON であり、新しい重みではない
収録のみ(6)
- KinetiX Combat Semantic Bridge (MiniMax-H3) · LoL V2 — LoRA:KinetiX 戦闘セマンティックブリッジ LoRA の LoL V2:名前は『リーグ・オブ・レジェンド』風の戦闘アクションを指しているが、このバージョンのモデルカードには効果や使い方の説明が一切なく、作者の外部リンク記事に頼るしかない。
- Rise Kujikawa Voice (Eng) - Persona 4 - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA:音声のみを訓練した H3 LoRA:『ペルソナ4』の久慈川理世(Rise)の英語吹き替え音声断片で訓練し、生成動画内のキャラクターが彼女の英語の声で話すようにする。
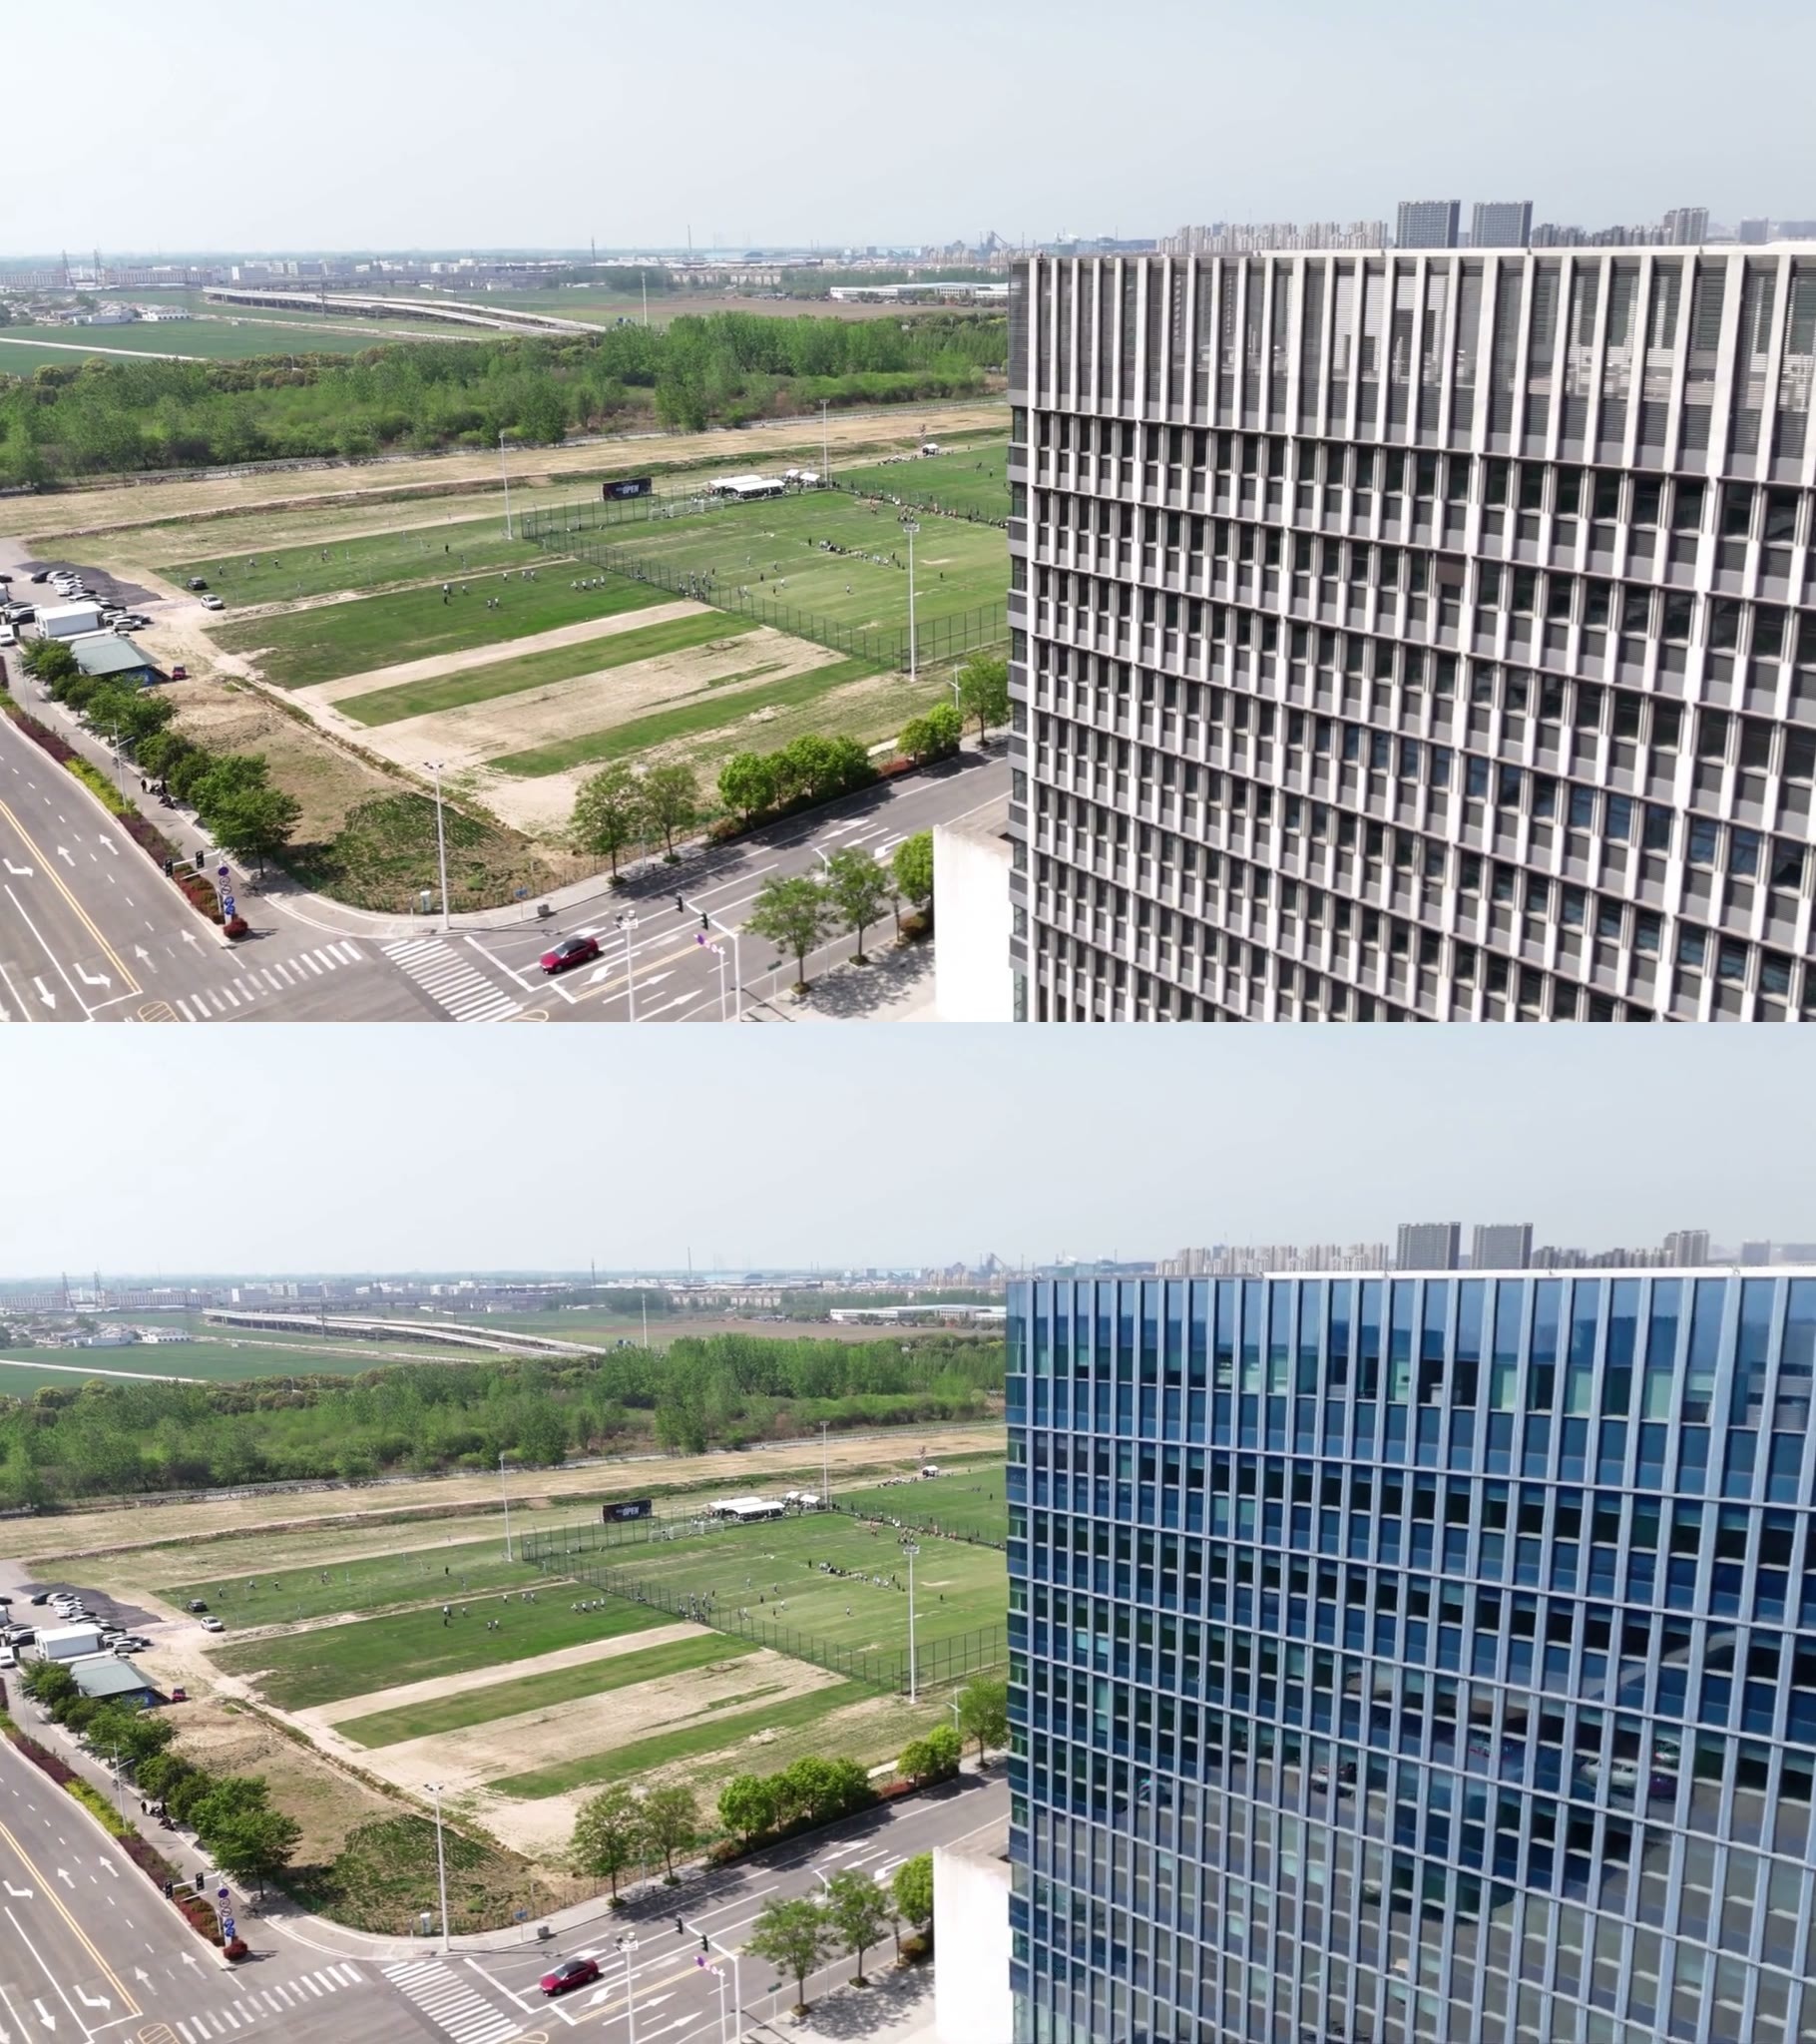
- MiniMax_H3_Inpaitning_1STG · v2.0 — ワークフロー:H3 動画の局所再描画(inpainting)の単一段階 ComfyUI ワークフロー v2.0、モデルカードにはタイトルとチュートリアル動画のみ。
- MiniMax H3 Video to Video Workflow · v5.0 — ワークフロー:同じ作者の H3 動画から動画へのメインワークフロー(単一段階、ファイル名 Minimax-H3_Video_Editing_1STG)の v5.0、このバージョンは「ワークフロー強化、カスタムノード更新」とのみ記載。
- Minimax-H3_Video_Editing_Ripple · v2.0 — ワークフロー:Ripple LoRA を使用した H3 動画編集の ComfyUI ワークフロー v2.0、モデルカードには一文とチュートリアル動画のみ。
- MiniMax_H3_Inpaitning_cropping_1STG · v2.0 — ワークフロー:クロップステップを含む H3 動画局所再描画ワークフロー v2.0(Inpainting + cropping)、モデルカードにはタイトルとチュートリアル動画のみ。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-20 08:31 → 11-20 21:01(北京時間)。推奨理由は編集者によるレビュー済み;ダウンロード数は注目度を表すに過ぎない。