Radar IA de Zhenzhen · MiniMax H3 Image · Bulletin du matin 2026-11-18
3 nouvelles versions cette semaine : fortement recommandé 0 · recommandé 1 · à suivre 0 · inclus uniquement 2
Note de l'éditeur Examen de 3 nouvelles versions de H3 Image, dont 1 classées A et 2 classées C. Première recommandation : le flux de travail TEKUA pour des poses et tenues aléatoires avec visage fixe : trois images de référence contrôlent respectivement la pose, la tenue, le visage et la coiffure ; à chaque exécution, une nouvelle série de poses et de tenues est tirée d'un dossier pour générer par lots des variantes du même personnage. Le modèle de texte Qwen3.5-9B « sans refus » (deux versions quantifiées INT8 / W4A8) n'est qu'une conversion quantifiée d'un modèle tiers, destinée à contourner les refus du modèle d'extension de prompts officiel ; les deux versions sont classées C.
Recommandations (1)
【A】Minimax-h3-image - Flux de travail avec pose et tenue aléatoires et visage fixe · v1.1
Flux de travail · Nouveau modèle · Auteur TEKUA · Publié le 11-17 21:50 · Téléchargements 102
Flux de travail ComfyUI à trois images de référence pour H3 Image (p-h3-image) : l'image de référence 1 contrôle la pose, 2 contrôle la tenue, et 3 contrôle le visage et la coiffure ; le visage est fixe, tandis que les poses et les tenues sont alternées par graine à partir de deux dossiers, permettant de générer en continu différentes tenues pour le même personnage.
Illustrations
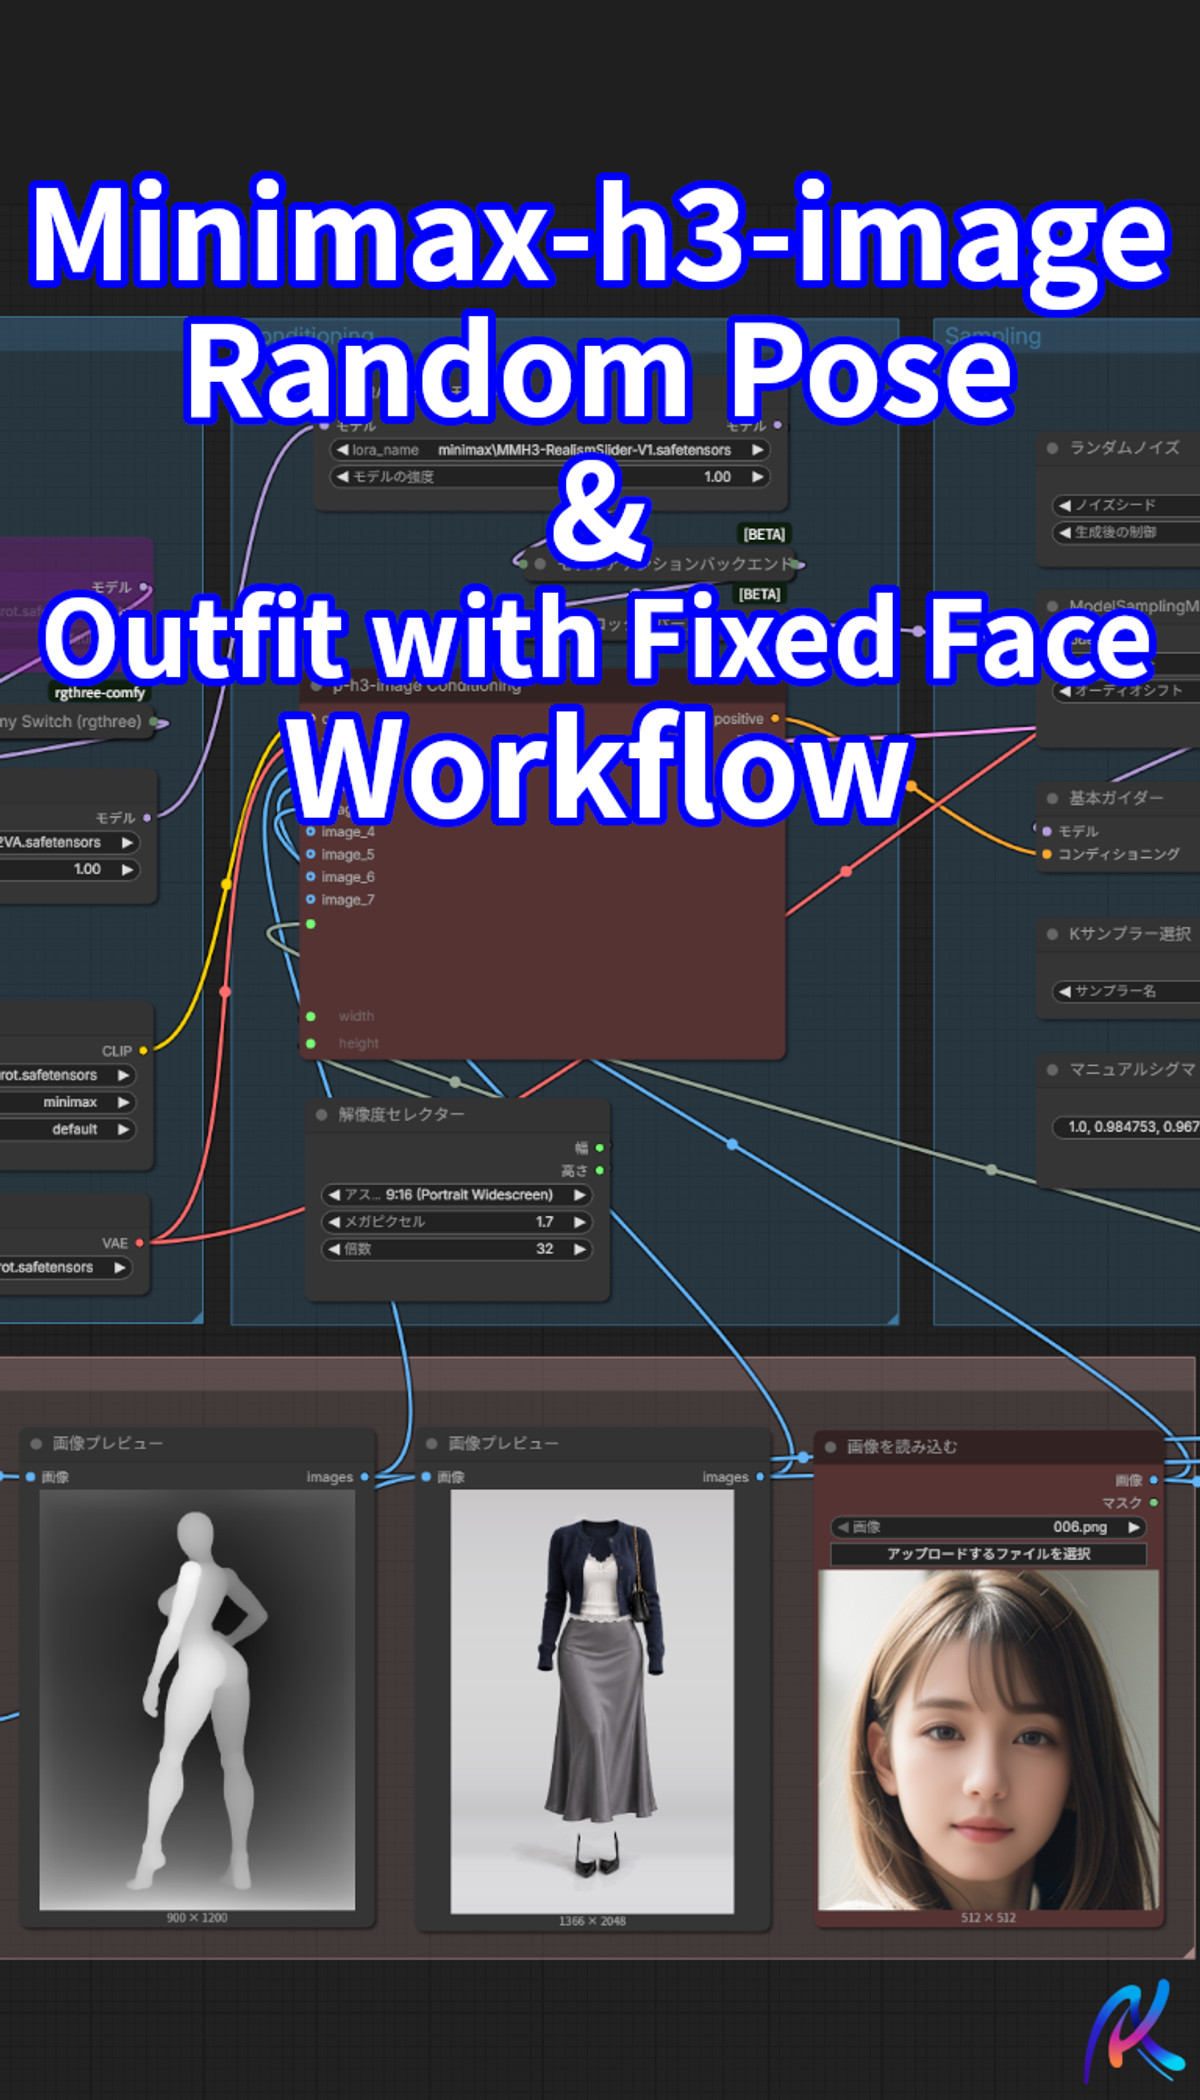
Raisons de la recommandation
- Idéal pour la génération par lots avec cohérence de personnage : création de fiches de personnage, collections de tenues, préparation de matériel multi-tenues pour des vidéos ou LoRA ultérieurs
- La v1.1 a supprimé les LoRA inactifs et ajouté un nœud de nettoyage de la mémoire
- La documentation inclut la liste des modèles, les compromis entre les deux modèles de diffusion (int8 pour la qualité, GGUF pour la vitesse), ainsi que les nœuds et chemins à modifier ; 4 images d'exemple sont visibles, et le tout est gratuit
Comment l'utiliser
- Après l'importation du JSON, utilisez ComfyUI Manager pour installer les nœuds manquants, notamment AITEC_Image_Loader du pack ComfyUI-AITECCAFE-Toolkit
- Modifiez les chemins des dossiers des deux nœuds AITEC_Image_Loader pour pointer vers vos propres dossiers d'images de poses et de tenues (les images doivent être fournies par l'utilisateur), et remplacez LoadImage par votre propre image de visage de personnage
- Le flux de travail inclut deux LoRA (changement de visage et réalisme) ; désactivez les nœuds LoraLoaderModelOnly correspondants si vous ne les utilisez pas ; les prompts de référence des personnages dans TextGenerateV2 peuvent être modifiés selon les besoins
Risques et limitations
- Les images de poses et de tenues ne sont pas fournies avec le flux de travail ; des erreurs surviendront si les dossiers sont vides ou si les chemins sont incorrects
- Dépendance à des packs de nœuds tiers ; les noms des nœuds peuvent varier selon la version de ComfyUI
- 3 exemples de niveau sensible ont été masqués
Inclus uniquement (2)
- Qwen3.5-9B-Heretic2.1 (TE&PE sans refus pour Moss Image, Qwen Image 2.1, Minimax H3 Image) · INT8 — Encodeur de texte : conversion en modèle de texte INT8 ConvRot de la version « sans refus » tierce de Qwen3.5-9B (Heretic 2.1) : utilisable comme encodeur de texte pour MOSS Image, ou comme modèle d'extension de prompts pour Qwen Image 2.1 et MiniMax H3 Image.
- Qwen3.5-9B-Heretic2.1 (TE&PE sans refus pour Moss Image, Qwen Image 2.1, Minimax H3 Image) · W4A8 — Encodeur de texte : version quantifiée W4A8 ConvRot du même modèle de texte Qwen3.5-9B « sans refus », plus petite que la version INT8, avec les mêmes usages : encodeur de texte pour MOSS Image ou modèle d'extension de prompts pour Qwen Image 2.1 / H3 Image.
Données : API publique Civitai (modèle de base MiniMax H3), fenêtre d'inclusion du 11-17 20:31 au 11-18 09:01 (heure de Pékin). Les raisons de recommandation ont été vérifiées par la rédaction ; le nombre de téléchargements reflète uniquement l'attention portée.