贞贞的AI雷达 · MiniMax H3 Image · 2026-11-18 晨报
本期 3 个新版本:强烈推荐 0 · 推荐 1 · 可关注 0 · 仅收录 2
编辑按语 本期审阅 3 个 H3 Image 新版本,1 个 A、2 个 C。首推 TEKUA 的固定脸随机姿势与服装工作流:三张参考图分别管姿势、服装、脸和发型,每次运行从文件夹里换一组姿势和服装,批量出同一角色的变体。去拒答版 Qwen3.5-9B 文本模型(INT8 / W4A8 两个量化版)只是第三方模型的量化转换,用途是绕过官方扩写模型的拒答,两版都列 C。
推荐(1)
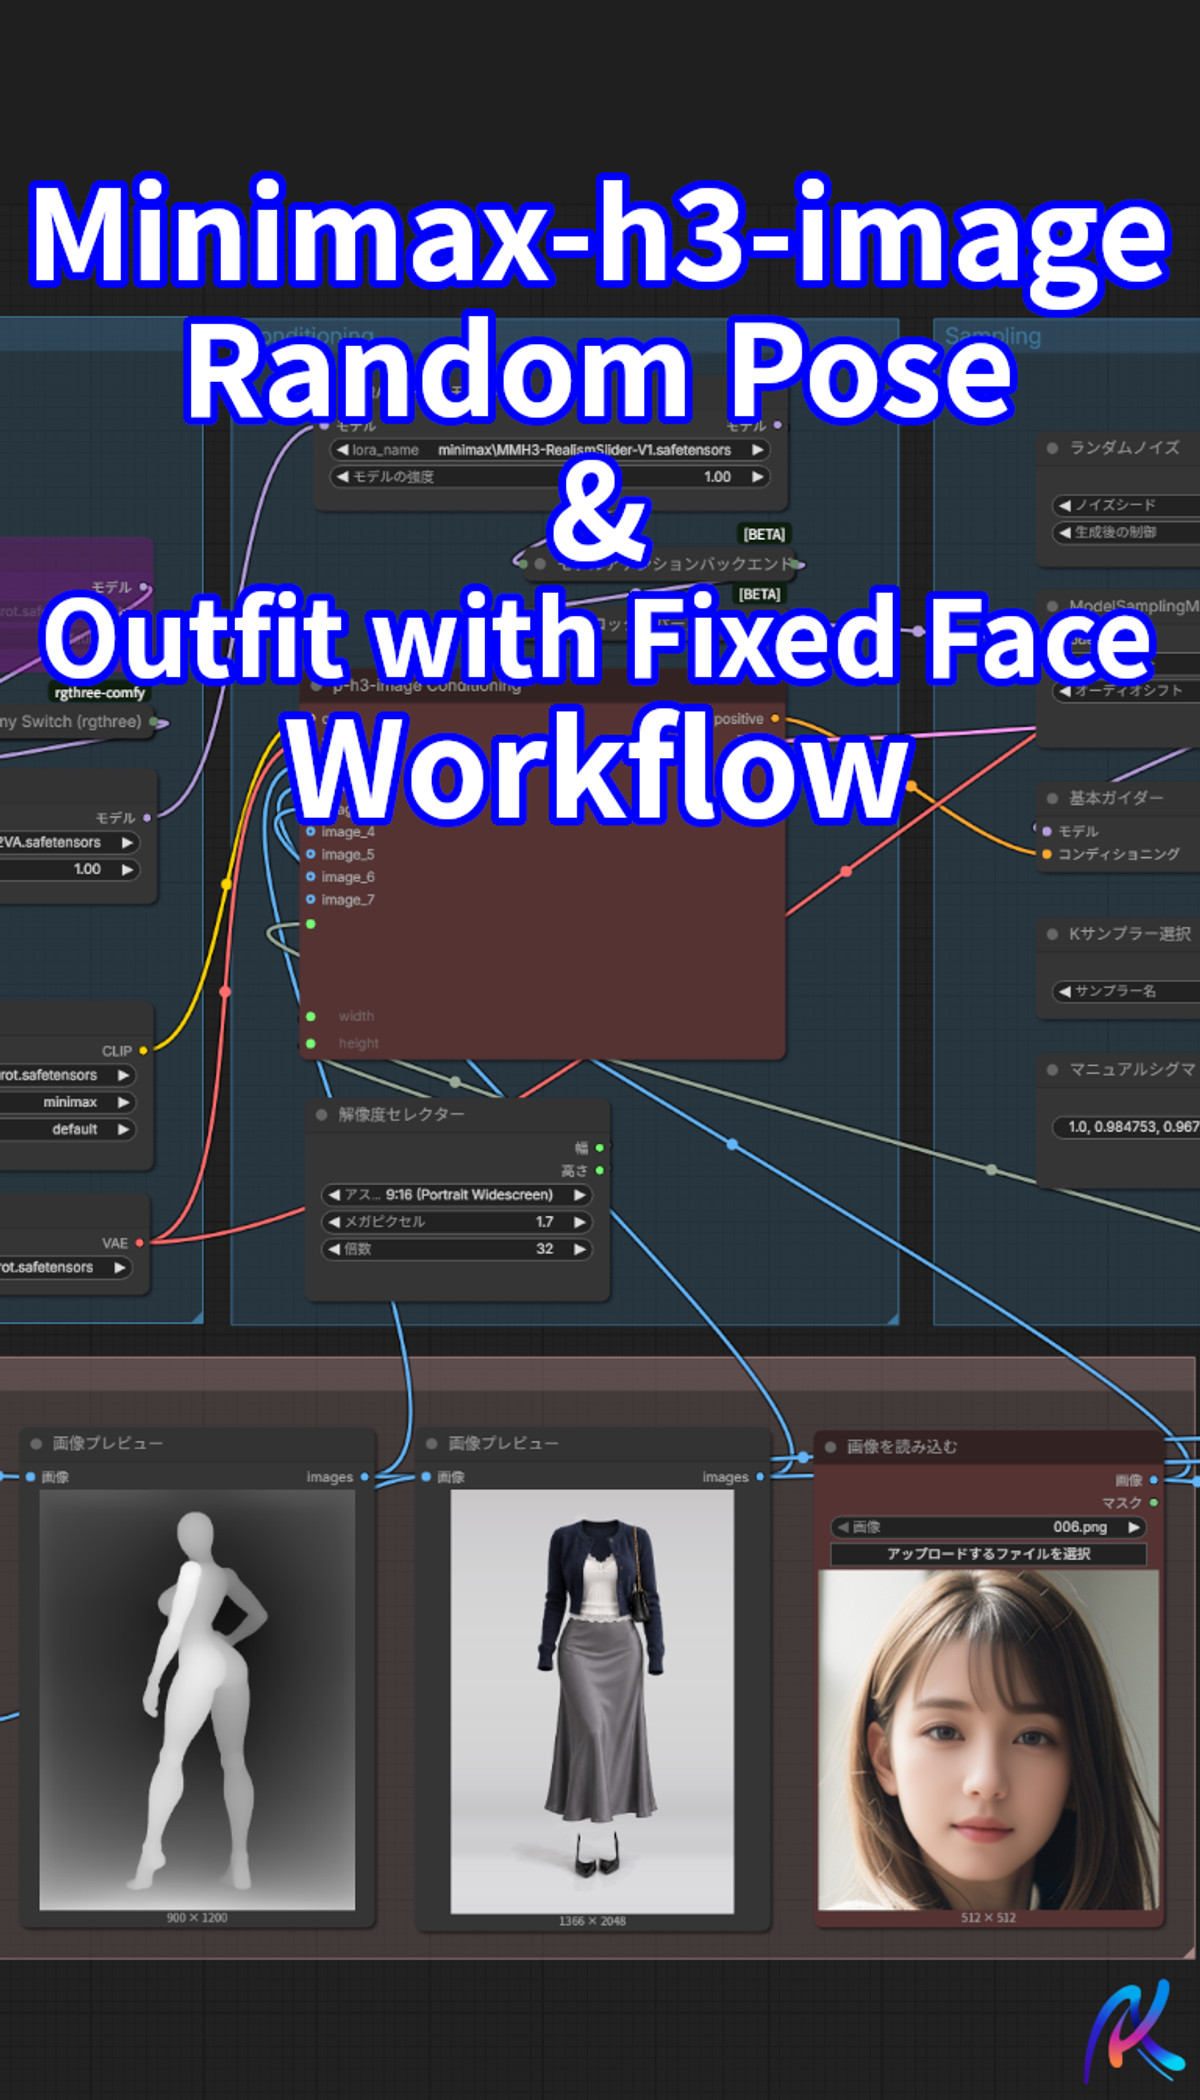
【A】Minimax-h3-image - Random Pose & Outfit with Fixed Face Workflow · v1.1
工作流 · 新模型 · 作者 TEKUA · 发布 11-17 21:50 · 下载 102
H3 Image(p-h3-image)的三参考图 ComfyUI 工作流:参考图 1 管姿势、2 管服装、3 管脸和发型;脸固定,姿势和服装从两个文件夹里按种子轮换,连续出同一角色的不同造型。
配图
推荐理由
- 服务角色一致性批量出图:做角色设定、换装合集、给后续视频或 LoRA 准备多造型素材
- v1.1 删掉了不起作用的 LoRA,加了清内存节点
- 说明写了模型清单、两种扩散模型的取舍(int8 质量优先、GGUF 速度优先)、节点和路径要改的地方;4 张示例图可见,免费
怎么用
- 导入 JSON 后用 ComfyUI Manager 补装缺的节点,关键是 ComfyUI-AITECCAFE-Toolkit 的 AITEC_Image_Loader
- 把两个 AITEC_Image_Loader 的文件夹路径改成自己的姿势图、服装图文件夹(图片要自己准备),LoadImage 换成自己的角色脸图
- 工作流里挂了换脸和写实滑杆两个 LoRA,不用就禁用对应的 LoraLoaderModelOnly 节点;TextGenerateV2 里的参考图角色提示词可按需改
风险与限制
- 姿势和服装图片不随工作流提供,文件夹为空或路径不对会报错
- 依赖第三方节点包,节点名可能随 ComfyUI 版本不同
- 3 个敏感级示例已隐藏
仅收录(2)
- Qwen3.5-9B-Heretic2.1 (Abliterated TE&PE for Moss Image, Qwen Image 2.1, Minimax H3 Image) · INT8 — 文本编码器:把第三方的去拒答版 Qwen3.5-9B(Heretic 2.1)转成 INT8 ConvRot 的文本模型:可当 MOSS Image 的文本编码器,或给 Qwen Image 2.1、MiniMax H3 Image 当提示词扩写模型。
- Qwen3.5-9B-Heretic2.1 (Abliterated TE&PE for Moss Image, Qwen Image 2.1, Minimax H3 Image) · W4A8 — 文本编码器:同一个去拒答版 Qwen3.5-9B 文本模型的 W4A8 ConvRot 量化版,比 INT8 版小,用途相同:MOSS Image 的文本编码器或 Qwen Image 2.1 / H3 Image 的提示词扩写模型。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-17 20:31 → 11-18 09:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。