Radar IA de Zhenzhen · Qwen Image 2.1 · Bulletin du matin 2026-11-21
Cette édition compte 4 nouvelles versions : fortement recommandées 2 · recommandées 1 · à suivre 0 · incluses uniquement 1
Note de l'éditeur Cette édition examine 4 nouvelles versions de Qwen 2.1, dont 2 classées S, 1 classées A et 1 classées C. Première recommandation : la version Qwen de Sint Albedo, qui génère des cartes albédo (diffuses) pour textures de jeux vidéo, tileables, sans éclairage et en vue de dessus orthogonale ; les mots-clés de déclenchement et les paramètres d'échantillonnage sont entièrement fournis. Le nom de version Qwen 1.0 correspond au numéro de version propre à ce LoRA ; la description de la version et le nom du fichier confirment tous deux qu'il est destiné à Qwen-Image 2.1. Le workflow AusBoss Génération + Édition v2.1 ajoute 5 entrées d'images de référence et corrige les dimensions de sortie, classé S ; Story Creator utilise Qwen 2.1 pour générer des images fixes, H3 pour produire des plans avec son et YuE2 pour la musique, créant une vidéo narrative complète à partir d'un scénario, classé A. Le LoRA de personnage YUL Girl Group ne fournit que le mot-clé de déclenchement, classé C ; aucune exclusion.
Fortement recommandées (2)
【S】Sint Albedo · Textures de jeu tileables - Krea/MOSS · Qwen 1.0
LoRA · Portage · Auteur AriaMaiven · Publié le 11-21 01:03 · Téléchargements 19
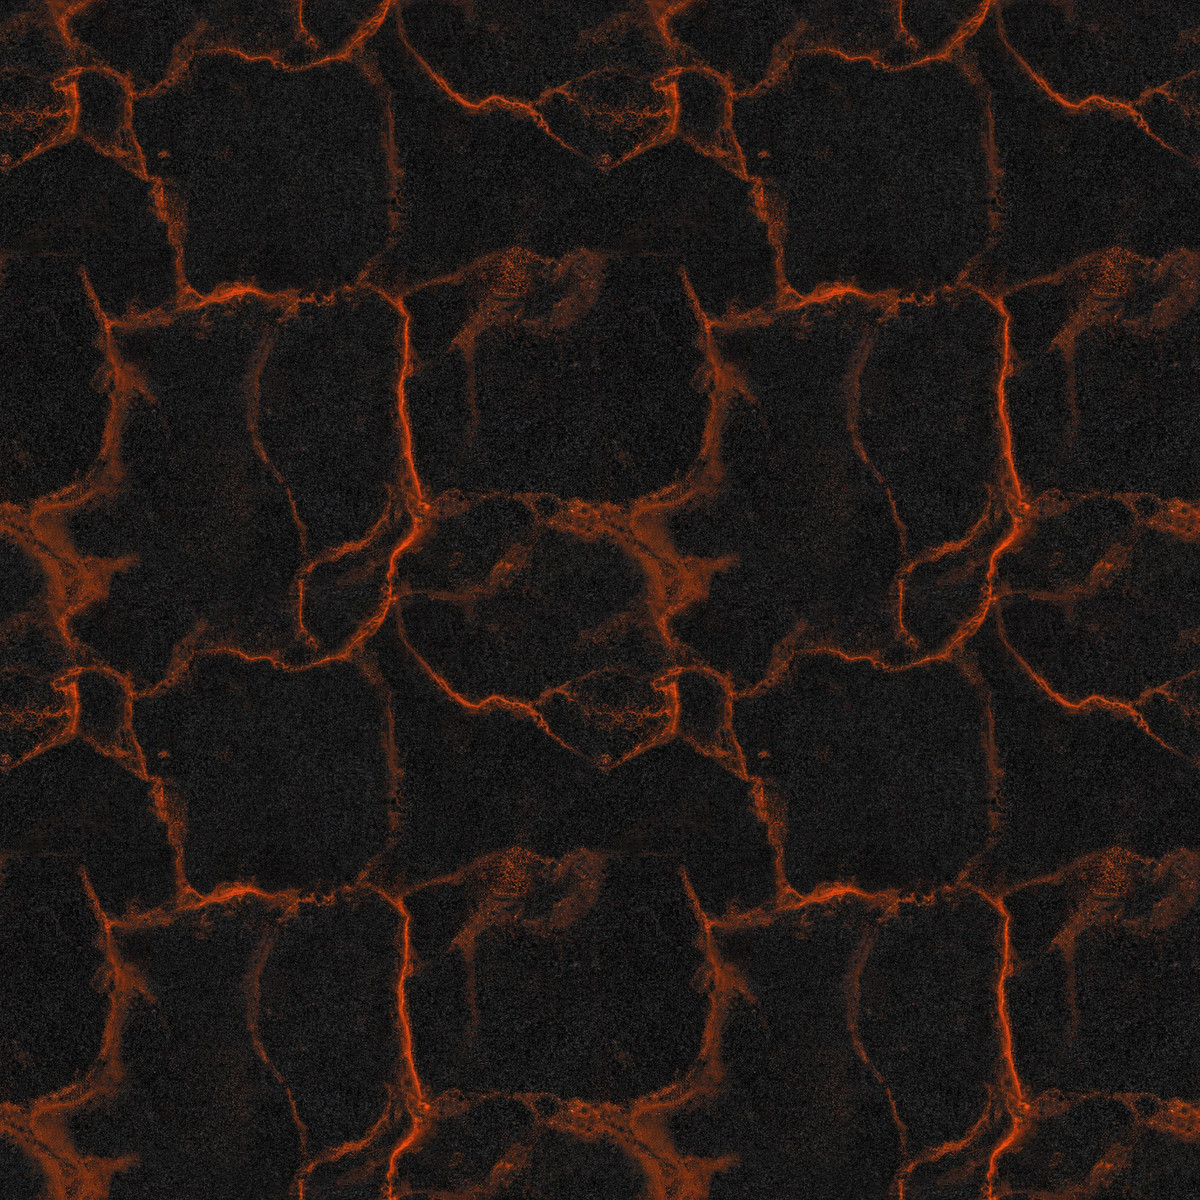
Transformez Qwen Image 2.1 en générateur de textures pour jeux vidéo : entrez une description de matériau et obtenez des cartes albédo (diffuses) en vue de dessus orthogonale, sans éclairage et tileables, plutôt que des photos de produits ; version Qwen 2.1 d'une page multi-modèles.
Illustrations
Raisons de la recommandation
- Portage : La page contient déjà des versions Krea 2, MOSS et Z-Image Turbo, avec un total de 452 téléchargements pour l'ensemble du modèle ; la version Qwen a été créée à la demande dans les commentaires, utilisant le même jeu de données et le même mot-clé de déclenchement, mais entraînée sur Qwen-Image 2.1 Base plutôt que Turbo (le nom de version Qwen 1.0 est le numéro de version propre au LoRA, le nom du fichier est sint-albedo-qwen21-v1)
- L'auteur précise les performances des coutures : lors d'un pavage en 2x2, la lave et la pierre sont sans couture même avec un zoom de 100% ; le bois, l'herbe et les plaques métalliques peuvent laisser une fine ligne à pleine échelle, mais un décalage et une correction (offset-and-heal) suffisent pour l'éliminer ; les motifs fins comme la maille de cotte de mailles deviennent flous et sombres, l'auteur recommande d'utiliser plutôt la version Krea
- Les textures elles-mêmes n'ont ni reflets, ni ombres, ni réflexions, la caméra est perpendiculaire sans perspective, permettant une intégration directe dans un moteur comme carte diffuse ; 7 exemples visibles
Comment l'utiliser
- Commencez le prompt par le mot-clé sintalbedo, puis décrivez le matériau et ses variations, par exemple : sintalbedo, chemin en pavés moussus, pierres grises arrondies avec mousse vert vif dans les interstices
- Force 1.0 ; l'auteur a testé avec Qwen-Image 2.1 int8 convrot, 30 étapes, er_sde / beta, CFG 1, en sortie 1024x1024, générant uniquement des images carrées
- L'échelle par défaut est petite (petits cailloux sur toute l'image, tissage fin), précisez l'échelle dans le prompt, par exemple : grandes pierres, gros plan, trois planches de largeur
Risques et limitations
- Hérite de la licence non commerciale Qwen Research License : l'auteur précise que la génération et l'apprentissage sont autorisés, mais la vente des images générées est interdite, ce qui exclut son utilisation dans des projets de jeux commerciaux
- Génère uniquement l'albédo ; les normales et les hauteurs doivent être créées avec vos propres outils, l'auteur recommande de dériver la rugosité en désaturant et inversant l'albédo, puis en ajustant à la plage correspondant au matériau
- Les formats larges rompent la répétition ; la republication ou l'utilisation des sorties pour entraîner d'autres modèles nécessite l'autorisation de l'auteur ; publié il y a environ 8 heures
Mot-clé de déclenchement : sintalbedo
【S】Qwen Image 2.1 Génération + Édition | Modèle complet, Prompt automatique · v2.1
Workflow · Mise à jour de version · Auteur AusBoss · Publié le 11-21 04:59 · Téléchargements 86
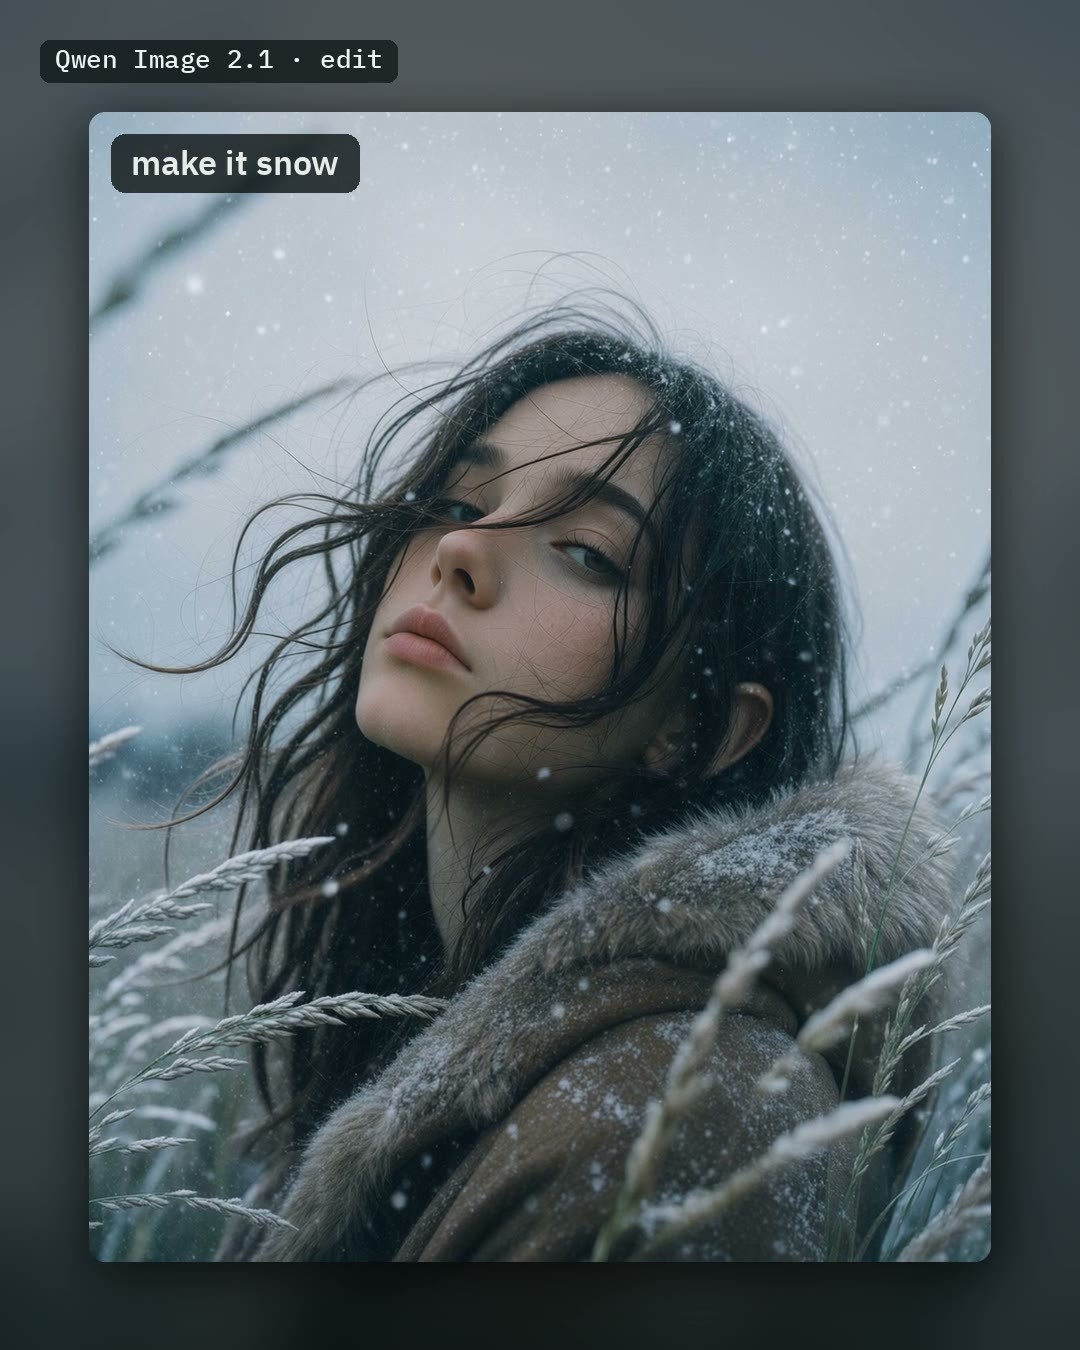
Le workflow de génération et d'édition pour le modèle complet Qwen Image 2.1 par AusBoss, la v2.1 ajoute cinq entrées d'images de référence (de picture 2 à picture 6) et permet aux résultats d'édition de conserver les dimensions de l'image originale.
Illustrations
Raisons de la recommandation
- Mise à jour de version : Le nœud "Write the prompt" dispose désormais de cinq entrées d'images, connectables à n'importe quel chargeur d'images pour référencer les images par numéro dans le prompt (par exemple, "put the jacket from image 2 on her"), utilisable tant pour la nouvelle génération que pour l'édition ; l'image originale chargée est l'image 1
- Correction des dimensions : Auparavant, une image de 1920x1080 revenait en 1920x1088, elle revient désormais dans ses dimensions d'origine ; les images dépassant 2 MP sont renvoyées à 2 MP en conservant le ratio, ajustable via le nouveau nœud "Your picture at Qwen's size" ; lors de l'activation de l'Upscale, l'agrandissement commence à partir de l'image complète générée par Qwen
- Conserve les quatre interrupteurs : Edit a picture (activé par défaut, ouvre également le LoRA Consistency de l'auteur avec une force de 0.5 pour maintenir l'alignement de la composition), Auto prompt, Upscale the result (LoRA Restore pour un réenregistrement par blocs jusqu'à 8 MP), Fast (LoRA Viggle Turbo en 6 étapes au lieu de 25, l'auteur indique environ trois fois plus rapide, légèrement moins net) ; la page du modèle totalise 6912 téléchargements
Comment l'utiliser
- Nécessite ComfyUI 0.38, AusBoss nodes 2.21.2 ou version ultérieure (recherchez AusBoss dans ComfyUI-Manager, mettez à jour si déjà installé)
- Modèles : modèle principal qwen_image_2.1_int8_convrot, encodeur de texte qwen3vl_8b_int8_convrot, vae qwen_image_2.1_vae_bf16 ; pour l'édition, utilisez le LoRA qwen-image-2.1-consistency, pour l'agrandissement le LoRA qwen-image-2.1-restore, pour le mode Fast le LoRA Viggle Turbo 6 étapes
- Pour l'édition, précisez clairement ce qui doit changer et ce qui doit rester identique, par exemple : "Change the black t-shirt to a red sweater. Keep everything else the same." ; lors d'un changement de style, ajustez la force Consistency à 1, pour changer les vêtements ou ajouter de la neige, une force de 0.5 suffit
Risques et limitations
- Le prompt automatique ne conserve que les numéros d'images, il n'examine pas les images de référence supplémentaires connectées
- Le corps de la fiche modèle n'a pas été mis à jour pour la v2.1 : il indique toujours "accepte une seule image", la version des nœuds est indiquée comme 2.15.0 (la description de version exige 2.21.2, faites foi de cette dernière), le journal des mises à jour s'arrête à v2.0
- L'agrandissement est un réenregistrement, les détails sont interpolés et les petits textes peuvent être mal orthographiés ; Qwen Image 2.1 et le LoRA Viggle Turbo sont tous deux limités à l'usage non commercial / recherche ; les exemples ne contiennent que 1 vidéos et 1 images
Recommandées (1)
【A】Story Creator 12GB — du scénario à une vidéo narrative complète : images fixes Qwen Image 2.1 + scènes MiniMax H3 avec voix + musique YuE2 · v1.4.0
Workflow · Nouveau modèle · Auteur The_frizzy1 · Publié le 11-21 01:00 · Téléchargements 19
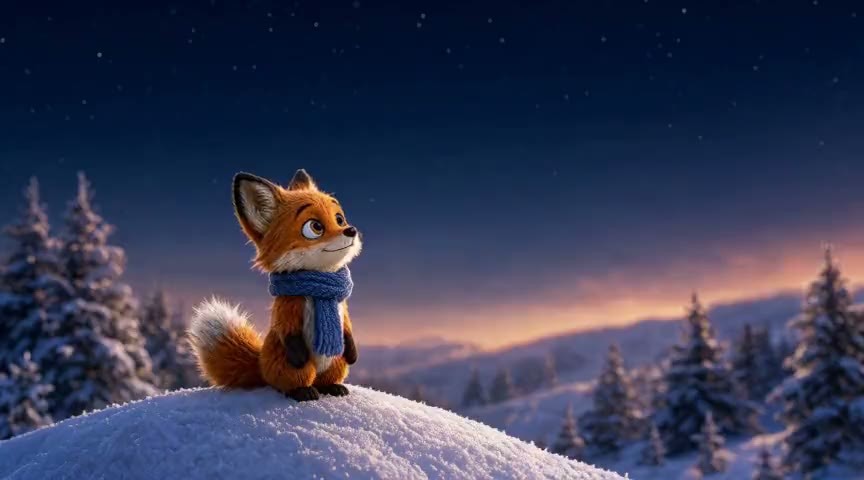
Un workflow ComfyUI qui génère directement une vidéo narrative complète à partir d'un scénario : Qwen Image 2.1 Turbo crée l'image du protagoniste et les images fixes de chaque scène, MiniMax H3 transforme les images fixes en plans avec voix off et dialogues, YuE2 génère la musique, et la narration utilise une voix unifiée.
Ce même workflow est également inclus dans la section MiniMax H3 ; du côté Qwen 2.1, il constitue un cas d'usage complet pour maintenir la cohérence du protagoniste via le mode édition.
Illustrations
Raisons de la recommandation
- Nouveau modèle : utilise uniquement les nœuds principaux de ComfyUI, l'auteur indique qu'il fonctionne sur une RTX 3060 avec 12 GB de VRAM + 32 GB de RAM (précisé comme testé réellement et non estimé)
- La méthode pour la cohérence des personnages est clairement décrite : Qwen génère d'abord une image du protagoniste, chaque image fixe de scène est une édition de celle-ci ; puis utilise Start Loop / End Loop pour exécuter H3 scène par scène avec un LoRA turbo de 8 étapes, les lignes de narration sont exécutées séparément via H3 pour ne récupérer que l'audio
- Le format du scénario est défini : WORLD: définit le style visuel global, [plan] décrit la cadrage et le mouvement de caméra, || suivi d'un texte est la voix off, || Nom: est un dialogue de personnage, [continue] fait se terminer cette scène avec l'image de la suivante ; inclut des instructions pour écrire le scénario et un exemple de script d'environ 5 minutes ; 2 vidéos et 6 images visibles
Comment l'utiliser
- ComfyUI 0.39 ou version ultérieure, aucun nœud personnalisé requis ; neuf fichiers de modèles au total : 3 pour les images fixes (qwen_image_2.1_turbo_int8_convrot, encodeur de texte qwen3vl_8b, Qwen VAE), 5 pour la vidéo (modèle principal H3 fl2va, LoRA turbo de 8 étapes, encodeur de texte, VAE vidéo, VAE audio), 1 pour la musique (YuE2)
- Rédigez le scénario avec un grand modèle de chat avant de le coller ; l'option intégrée "génération automatique de storyboard" est désactivée par défaut, l'auteur indique que les dialogues générés sont courts et vagues, et omettent parfois l'apparence des personnages secondaires
- Décrivez entièrement l'apparence des personnages secondaires à chaque apparition ; harmonisez le volume sonore de chaque scène dans un logiciel de montage final
Risques et limitations
- Lent : sur la RTX 3060 de l'auteur, une histoire de 1 minutes prend environ 43 minutes, une histoire de 5 minutes environ 3 heures 35 minutes (données v1.0 / v1.2), 5 minutes est une tâche qui dure toute la nuit ; la mémoire augmente d'environ 0.6 GB par scène, au-delà de 30 scènes il faut diviser en deux parties puis assembler
- Seule la cohérence du protagoniste est garantie ; les plans sur l'épaule et les personnages sortant du cadre sont sujets aux erreurs (le protagoniste apparaît deux fois ou deux personnages fusionnent) ; le son de chaque scène est généré séparément, avec des niveaux de volume incohérents
- Pour v1.4.0, l'auteur admet que le README n'a pas de journal des modifications et qu'il ignore ce qui a changé, les données de temps proviennent d'une version antérieure ; le workflow est sous licence MIT, mais Qwen Image 2.1 et YuE2 sont tous deux sous licence non commerciale ; il y a aussi 5 exemples sensibles masqués, le modèle de base est étiqueté comme Other
Inclus uniquement (1)
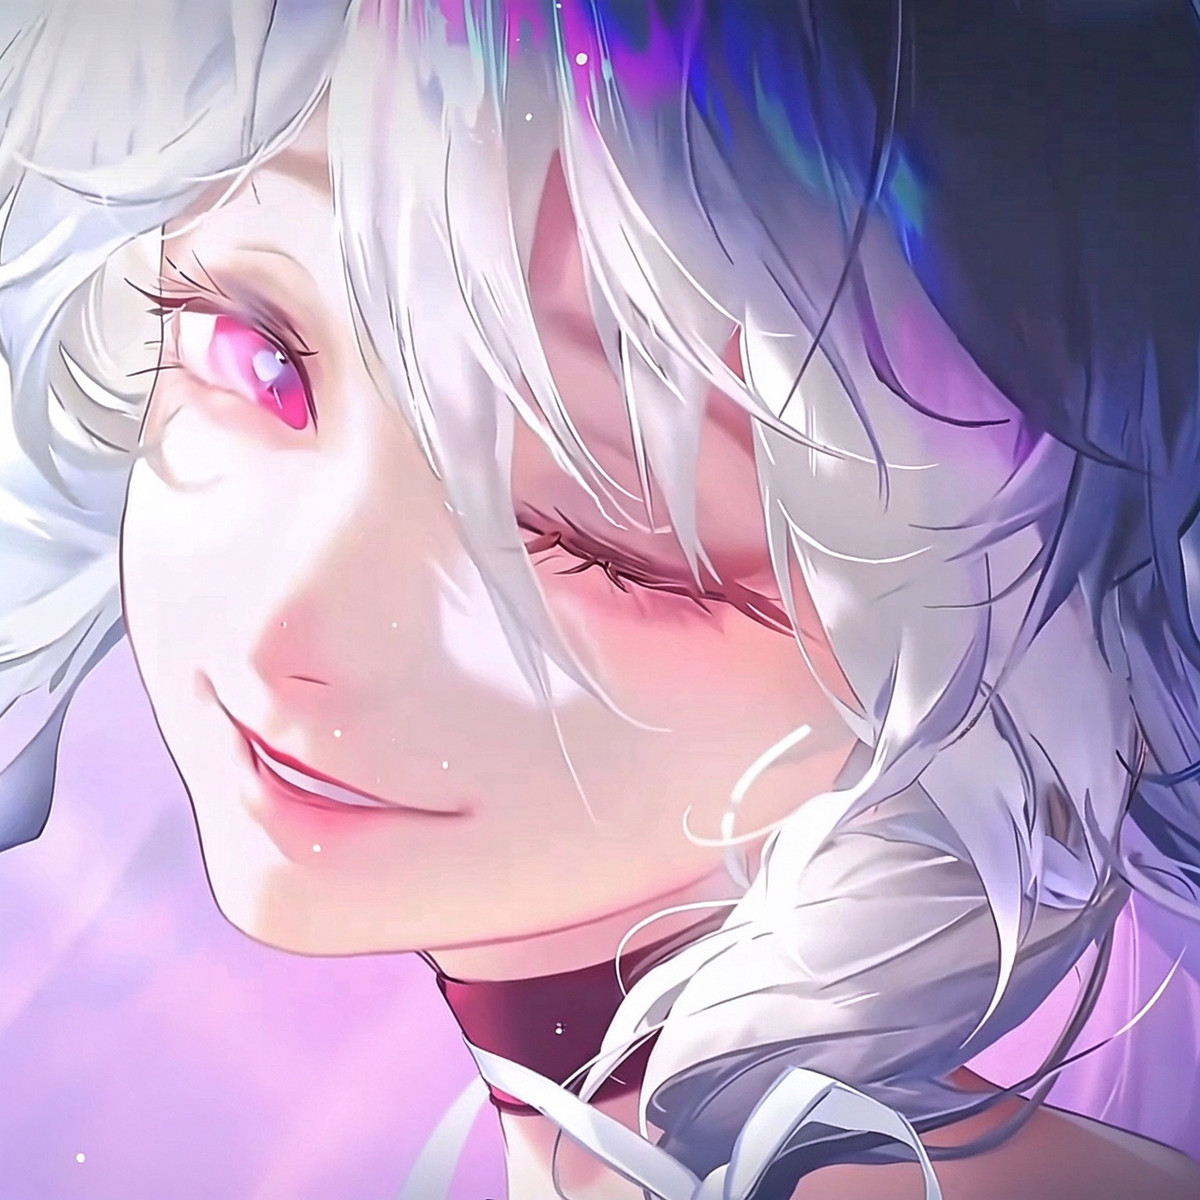
- YUL-GirlGroup-lora · Qwen2.1-YUL-012Linglingling1KMAX — LoRA : LoRA de personnage pour "Linglingling", membre du groupe virtuel féminin original YUL (cheveux gris argentés en queues de cheval doubles avec effets glitch arc-en-ciel aux pointes, portant un headband technologique lumineux en forme d'anneaux et oreilles de chat), version Qwen 2.1 de la série YUL Girl Group.
Données : API publique de Civitai (modèle de base Qwen 2.1), période d'inclusion 11-20 20:31 → 11-21 09:01 (heure de Pékin). Les recommandations ont été examinées par la rédaction ; le nombre de téléchargements reflète uniquement l'attention portée.