貞貞のAIレーダー · Qwen Image 2.1 · 2026-11-21 朝刊
今号の新バージョンは 4 個です:強く推奨 2 · 推奨 1 · 注目すべきもの 0 · 収録のみ 1
編集者によるコメント 今号では 4 個の Qwen 2.1 新バージョンをレビューし、S評価が 2 個、A評価が 1 個、C評価が 1 個でした。初推は Sint Albedo の Qwen 版です:シームレスにタイル状に敷き詰め可能で、ライティングなし、真上からの視点のゲーム用マテリアルのアルベド(拡散反射)テクスチャを生成します。トリガーワードとサンプリングパラメータが明記されています。バージョン名 Qwen 1.0 はこの LoRA 自体のバージョン番号であり、バージョン説明とファイル名の両方で Qwen-Image 2.1 用であることが確認されています。AusBoss の生成+編集ワークフロー v2.1 では参考画像入力が 5 個追加され、出力サイズが修正されたため S評価としました。Story Creator は Qwen 2.1 で静止画を生成し、H3 で音声付きのショットを作成し、YuE2 で音楽を付与して、脚本から完全なストーリー動画を作成するため A評価としました。YUL ガールズグループキャラクター LoRA はトリガーワードのみが提供されているため C評価としました。除外項目はありません。
強く推奨(2)
【S】Sint Albedo · Tileable Game Textures - Krea/MOSS · Qwen 1.0
LoRA · ポート · 作者 AriaMaiven · 公開 11-21 01:03 · ダウンロード数 19
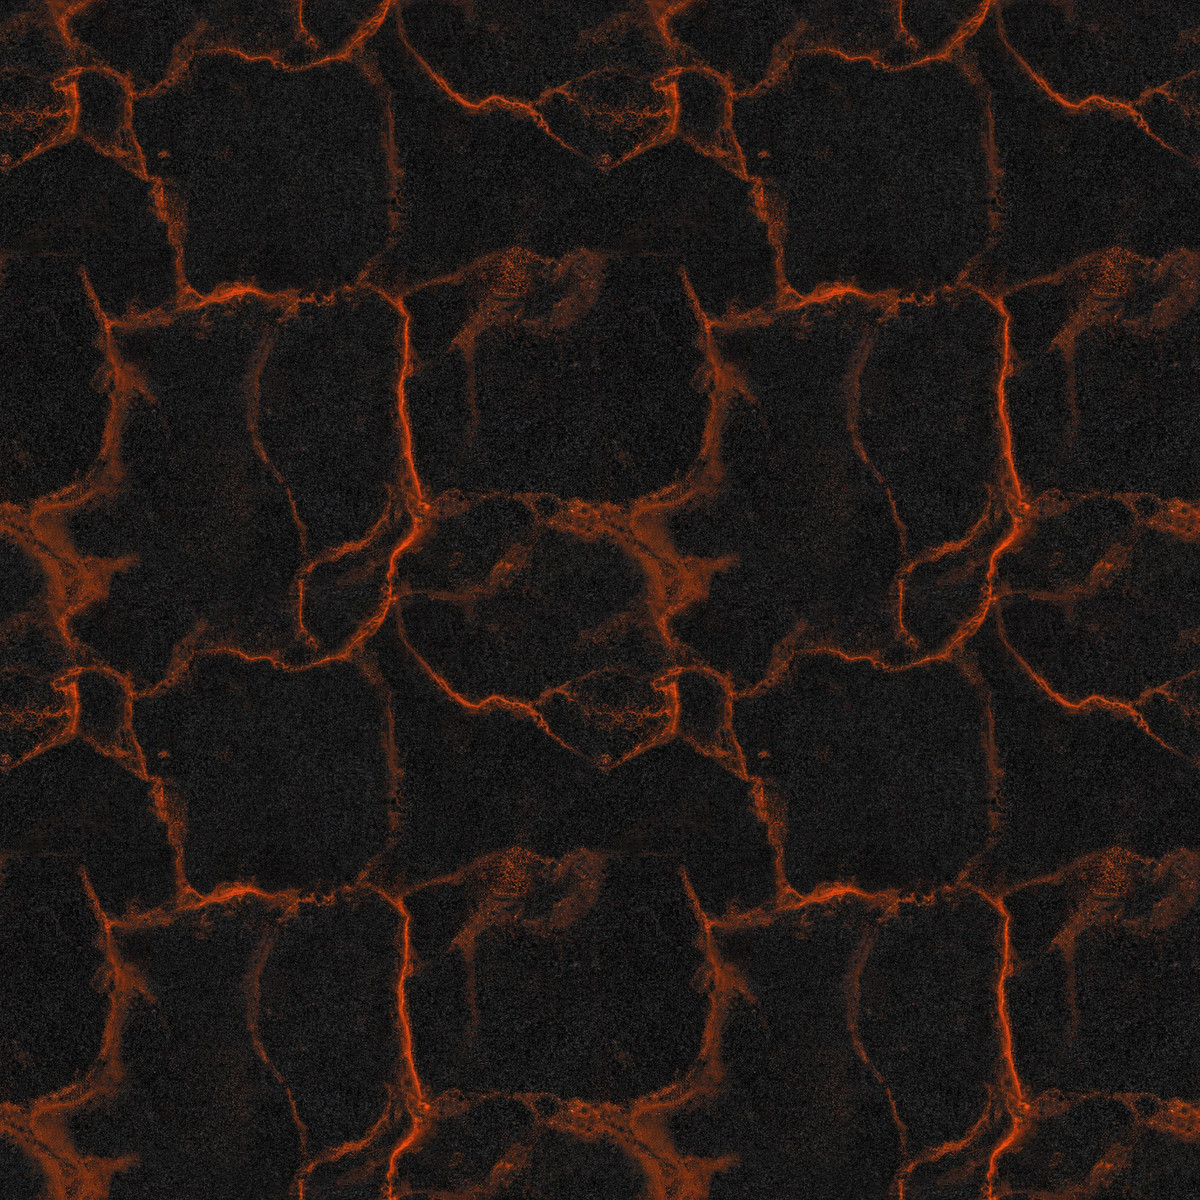
Qwen Image 2.1 をゲームテクスチャジェネレーターに変えます:マテリアルの説明を入力すると、プロダクト写真ではなく、真上からの視点でライティングなし、シームレスにタイル状に敷き詰め可能なアルベド(拡散反射)テクスチャを出力します。複数基盤モデルページにある Qwen 2.1 版です。
画像
推奨理由
- ポート:同じページにはすでに Krea 2、MOSS、Z-Image Turbo 版があり、モデルページ全体のダウンロード数は 452 回です。Qwen 版はコメント欄の要望に応えて作成され、同じデータセットとトリガーワードを使用し、Turbo ではなく Qwen-Image 2.1 Base で学習されています(バージョン名 Qwen 1.0 は LoRA 自体のバージョン番号で、ファイル名は sint-albedo-qwen21-v1 です)
- 作者は継ぎ目の挙動を明記しています:2x2 でタイル状に敷き詰めた場合、溶岩と石は 100% 倍の拡大でもシームレスです。木、草、金属板は最大拡大時に細い線が残る可能性がありますが、offset-and-heal を一度行うだけで除去できます。チェーンメイルのような細かい輪郭パターンは暗い編み目としてぼやけるため、作者は Krea 版の使用を推奨しています
- テクスチャ自体にはハイライト、影、反射が含まれず、カメラは垂直下向きで遠近感がないため、エンジン内で拡散反射マップとして直接使用できます。7 枚のサンプル画像が確認できます
使い方
- プロンプトの最初の単語に sintalbedo を書き、次にマテリアルとその中の変化する要素を記述します。例:sintalbedo, mossy cobblestone path, dark grey rounded stones with bright green moss in the gaps
- 強度は 1.0 です。作者は Qwen-Image 2.1 int8 convrot、ステップ数 30、er_sde / beta、CFG 1、サイズ 1024x1024 でテストし、正方形のみを出力しました
- デフォルトのスケールは小さめです(画面全体に小石や細かい編み目が表示される)。プロンプト内で large stones、close-up、three planks across などのようにスケールを明記してください
リスクと制限
- Qwen Research License の非商用条件を引き継いでいます:作者は生成と学習は可能ですが、出力画像の販売はできず、商業ゲームプロジェクトでは使用できないと明言しています
- アルベドのみを出力します。法線マップや高さマップは独自のツールで別途作成する必要があります。粗さマップについては、アルベドから色を除去し反転させた後、マテリアルに対応する範囲に圧縮することを作者は推奨しています
- 横長の画像では繰り返しパターンが崩れます。再掲載や他のモデルの学習に出力を使用する場合は作者の許可が必要です。公開から約 8 時間です
トリガーワード:sintalbedo
【S】Qwen Image 2.1 Generate + Edit | Full Model, Auto Prompt · v2.1
ワークフロー · バージョン更新 · 作者 AusBoss · 公開 11-21 04:59 · ダウンロード数 86
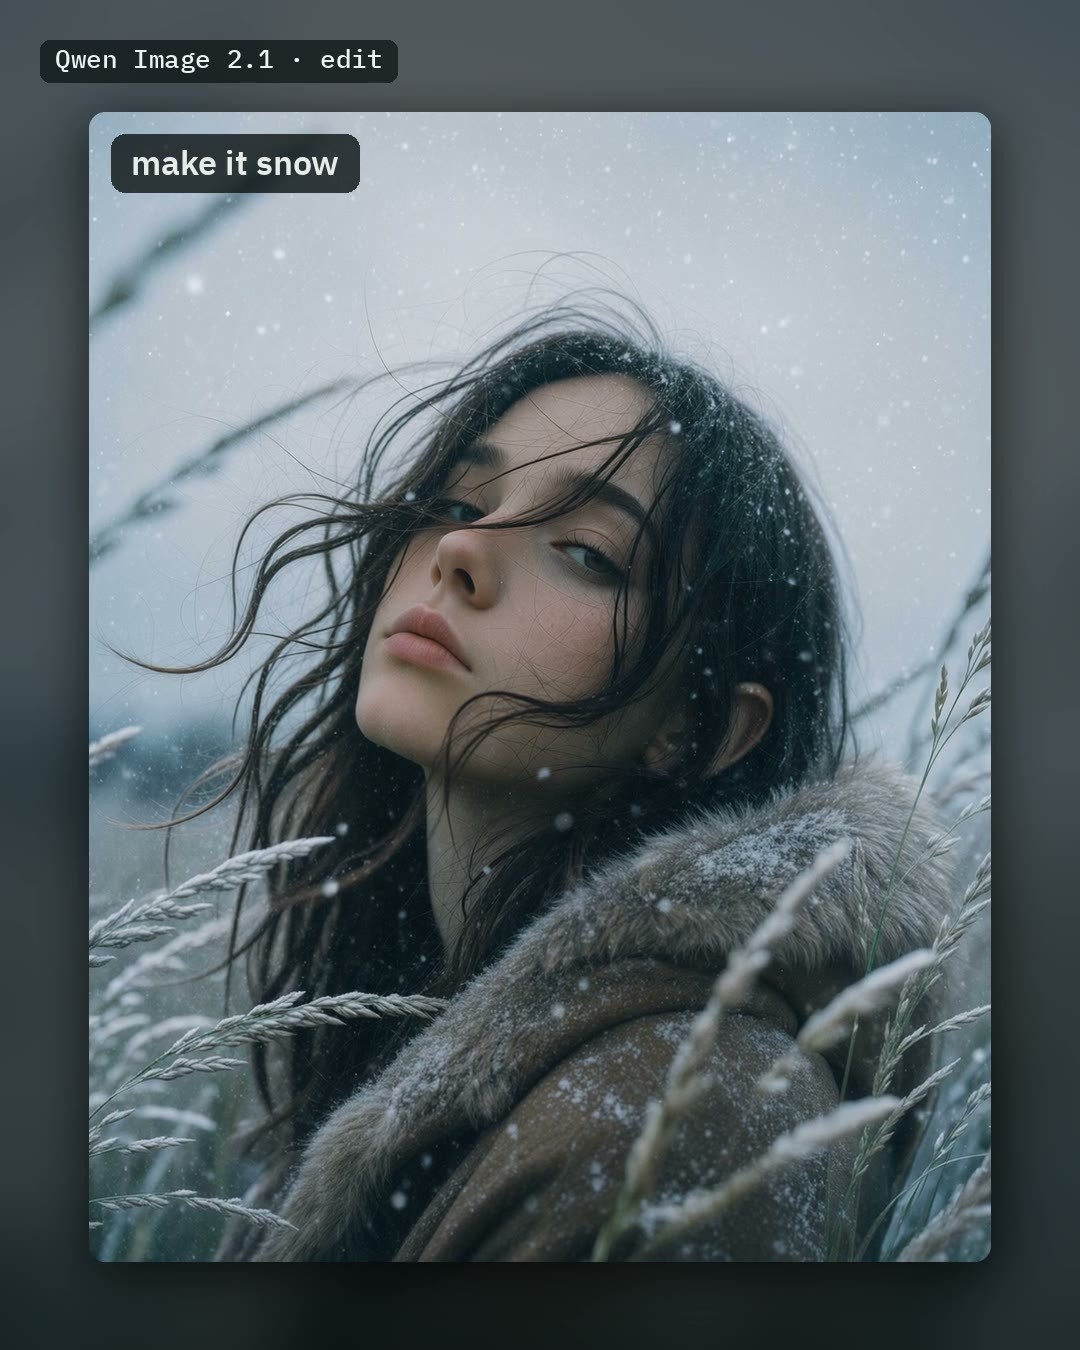
AusBoss の Qwen Image 2.1 フルモデル生成+画像編集ワークフローです。v2.1 では picture 2 から picture 6 までの5つの参考画像入力が追加され、編集結果が元の画像サイズを保持するようになりました。
画像
推奨理由
- バージョン更新:Write the prompt ノードに5つの画像入力が追加されました。任意の画像ローダーを接続した後、プロンプト内で番号で参照します(例:put the jacket from image 2 on her)。新規生成と編集の両方で使用でき、読み込まれた元画像は image 1 です
- サイズ修正:以前は 1920x1080 の画像が 1920x1088 で返ってきましたが、現在は元のサイズで返されます。2 MP を超える画像は元の比率で 2 MP に縮小され、新しいノード Your picture at Qwen's size で調整できます。Upscale を有効にした場合、Qwen が描画した完全な画像から拡大が始まります
- 4つのスイッチを引き続き使用します:Edit a picture(デフォルトオン、同時に 0.5 で作者の Consistency LoRA を開いて構図の整合性を保つ)、Auto prompt、Upscale the result(Restore LoRA でタイルごとに再描画し 8 MP に拡大)、Fast(Viggle Turbo LoRA で 25 ステップの代わりに 6 ステップを使用。作者は約3倍速く、ややぼやけると述べています)。モデルページ全体のダウンロード数は 6912 回です
使い方
- ComfyUI 0.38 と AusBoss nodes 2.21.2 以降が必要です(ComfyUI-Manager で AusBoss を検索し、インストール済みの場合は先に更新してください)
- モデル:qwen_image_2.1_int8_convrot メインモデル、qwen3vl_8b_int8_convrot テキストエンコーダー、qwen_image_2.1_vae_bf16。編集には qwen-image-2.1-consistency LoRA、拡大には qwen-image-2.1-restore LoRA、Fast には Viggle Turbo 6 ステップ LoRA を使用します
- 編集時には変更点と保持点を明確に記述します。例:“Change the black t-shirt to a red sweater. Keep everything else the same.” スタイルを変更する場合は Consistency を 1 に設定し、服の変更や雪の追加には 0.5 で十分です
リスクと制限
- Auto prompt は画像番号のみを引き継ぎ、追加で接続された参考画像の内容は参照しません
- モデルカードの本文が v2.1 に追いついていません:依然として「1枚の画像のみ受け付ける」と記載されており、ノードバージョンは 2.15.0 と書かれていますが(バージョン説明では 2.21.2 が要求されており、こちらを優先します)、更新履歴は v2.0 までしかありません
- 拡大は再描画であり、ディテールは補完に頼るため、小さな文字が誤って生成される可能性があります。Qwen Image 2.1 と Viggle Turbo LoRA はどちらも非商用/研究目的のみです。サンプルは動画 1 本と画像 1 枚のみです
推奨(1)
【A】Story Creator 12GB — script to a full story video: Qwen Image 2.1 stills + MiniMax H3 scenes with voices + YuE2 music · v1.4.0
ワークフロー · 新モデル · 作者 The_frizzy1 · 公開 11-21 01:00 · ダウンロード数 19
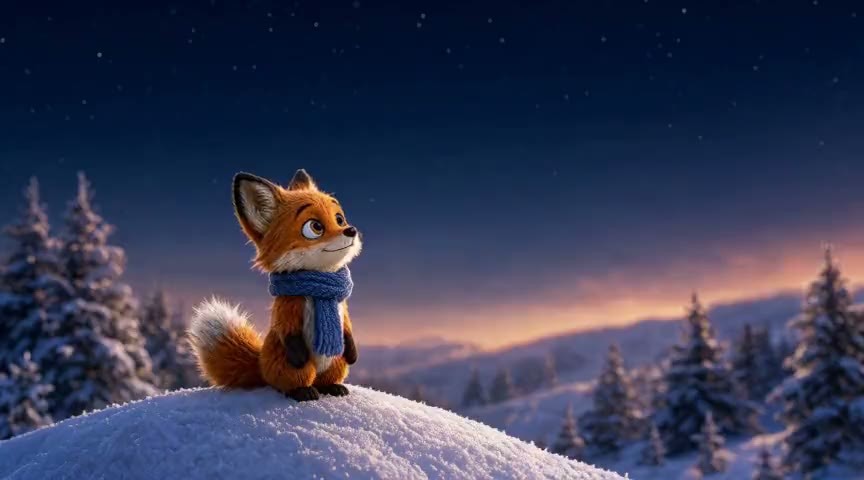
脚本から直接完全なストーリー動画を生成する ComfyUI ワークフローです。Qwen Image 2.1 Turbo で主人公の画像と各シーンの静止画を生成し、MiniMax H3 で静止画をセリフ付き音声のあるショットに変換し、YuE2 で音楽を生成します。ナレーションは統一された声で行われます。
同じワークフローは MiniMax H3 セクションにも収録されています。Qwen 2.1 の側では、編集モードを使用して主人公の一貫性を保つ完全なユースケースとして位置づけられています。
画像
推奨理由
- 新モデル:ComfyUI コアノードのみを使用し、作者は RTX 3060 12 GB + 32 GB メモリ環境での動作を確認したと述べています(推定ではなく実測値であることを明記しています)
- キャラクターの一貫性を保つ方法が明確に記述されています:Qwen で最初に主人公の画像を1枚生成し、各シーンの静止画はその画像に対する編集として行われます。その後、Start Loop / End Loop を使用してシーンごとに H3 と 8 ステップ turbo LoRA を実行します。ナレーション行は H3 を単独で実行して音声のみを取得します
- 脚本の形式が明確です:WORLD: で全編のスタイルを定義し、[ショット] で画角とカメラワークを指定し、|| の後はナレーション、|| 名前: はキャラクターのセリフ、[continue] はそのシーンを次のシーンの映像で終わらせます。脚本作成ガイドと約 5 分のサンプルスクリプトが添付されています。動画 2 本と画像 6 枚が確認できます
使い方
- ComfyUI 0.39 以上で動作し、カスタムノードは不要です。モデルファイルは合計9個あります。静止画用が3個(qwen_image_2.1_turbo_int8_convrot、qwen3vl_8b テキストエンコーダー、Qwen VAE)、動画用が5個(H3 fl2va メインモデル、8 ステップのターボ LoRA、テキストエンコーダー、動画VAE、音声VAE)、音楽用が1個(YuE2)です。
- 脚本は大きなチャットモデルで事前に作成してから貼り付けてください。組み込みの「自動絵コンテ作成」機能はデフォルトで無効になっており、作者によると、この機能が生成するセリフは短くて曖昧であり、さらに脇役の外見描写が欠落することがあるとのことです。
- 脇役が登場するたびに、その外見を完全に記述してください。完成した動画では、編集ソフトを使って各シーンの音量(ラウドネス)を統一してください。
リスクと制限
- 遅い:作者の RTX 3060 環境では、1 分のストーリーに約 43 分、5 分のストーリーに約 3 時間 35 分かかります(v1.0 / v1.2 のデータ)。5 分は徹夜作業になります。メモリ使用量はシーンごとに約 0.6 GB 増加し、30 シーンを超えると二分割して実行してから結合する必要があります
- 主人公のみ一貫性が保たれます。オーバーザショルダーショットや画面外に出るキャラクターではエラーが発生しやすいです(主人公が2回表示されたり、2人が融合したりします)。各シーンの音声は個別に生成されるため、音量が不揃いになります
- v1.4.0 について作者自身は README に更新履歴がなく、変更点が不明であると述べており、所要時間データは旧バージョンからのものです。ワークフロー自体は MIT ライセンスですが、Qwen Image 2.1 と YuE2 はどちらも非商用ライセンスです。さらに 5 個のセンシティブなサンプルが非表示になっており、基盤モデルは Other とマークされています
収録のみ(1)
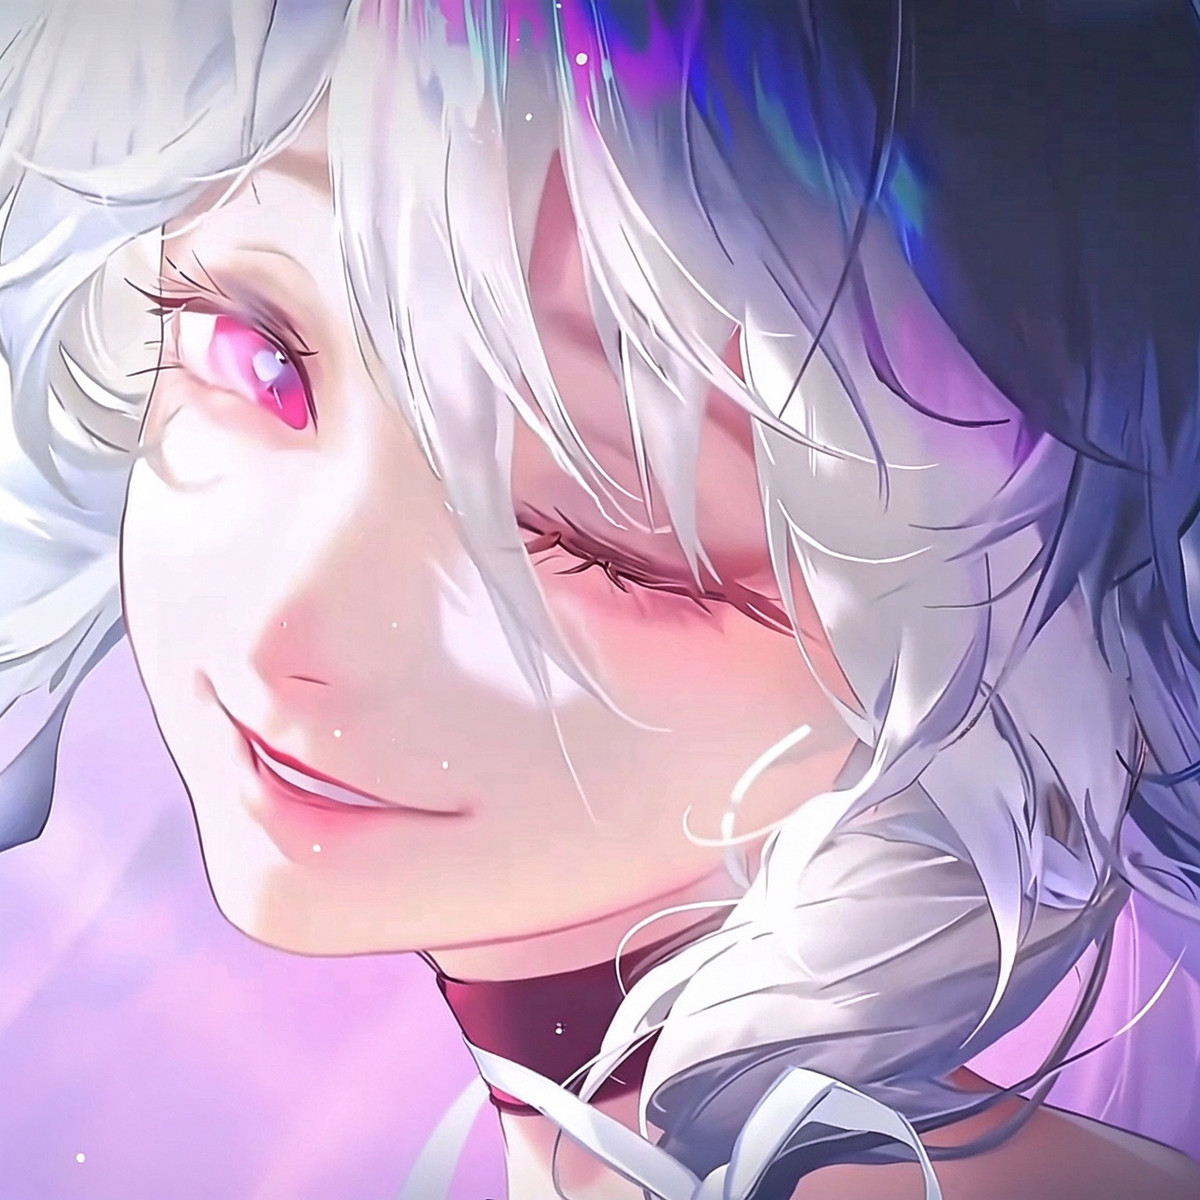
- YUL-GirlGroup-lora · Qwen2.1-YUL-012零零零1KMAX — LoRA:オリジナルバーチャルガールズグループメンバー「零零零」(銀灰色のツインテール、毛先に虹色のグリッチエフェクト、発光する円形猫耳テックヘッドギアを着用)のキャラクター LoRA です。YUL ガールズグループシリーズの Qwen 2.1 版です。
データ:Civitai 公開 API(基盤モデル Qwen 2.1)、収録期間 11-20 20:31 → 11-21 09:01(北京時間)。推奨理由は編集者によるレビュー済み。ダウンロード数は注目度を表すに過ぎない。