貞貞のAIレーダー · MiniMax H3 · 2026-11-04 朝刊
今号の 12 個の新バージョン:強く推奨 0 · 推奨 1 · 注目 6 · 収録のみ 5
編集後記 今号では 12 個の H3 新バージョンをレビューしました。初推しは Hybrid 統合ベースモデルです。FL2VA と Ref2VA をレイヤーごとに混合し、さらに DMAD と PDMD の2種類の蒸留を統合したもので、作者は 8 ステップで動画生成が可能で、加速用 LoRA の適用は不要と述べていますが、確認できるサンプルは 1 本のみで、サンプラーやワークフローの提供はありません。評価は A です。B ランクには、元動画のアクションやカメラワークを保持したキャラクター置換ワークフロー v2.0、Krea 2 から移植された段ボール手工芸風スタイル、動画公開前の技術的品質チェックツール、そして『ブラッククローバー』の英語音声と Persona の日本語キャラクター音声 LoRA 2種が含まれます。音声 LoRA については、強度パラメータがなく、声優の声の権利に関わるため、自動 A 判定から B に格下げしました。サンプルが少ない Persona 音声2種、説明が一文のみのワークフロー v2.0 2種、および通常の架空キャラクター LoRA は C 判定としました。
推奨(1)
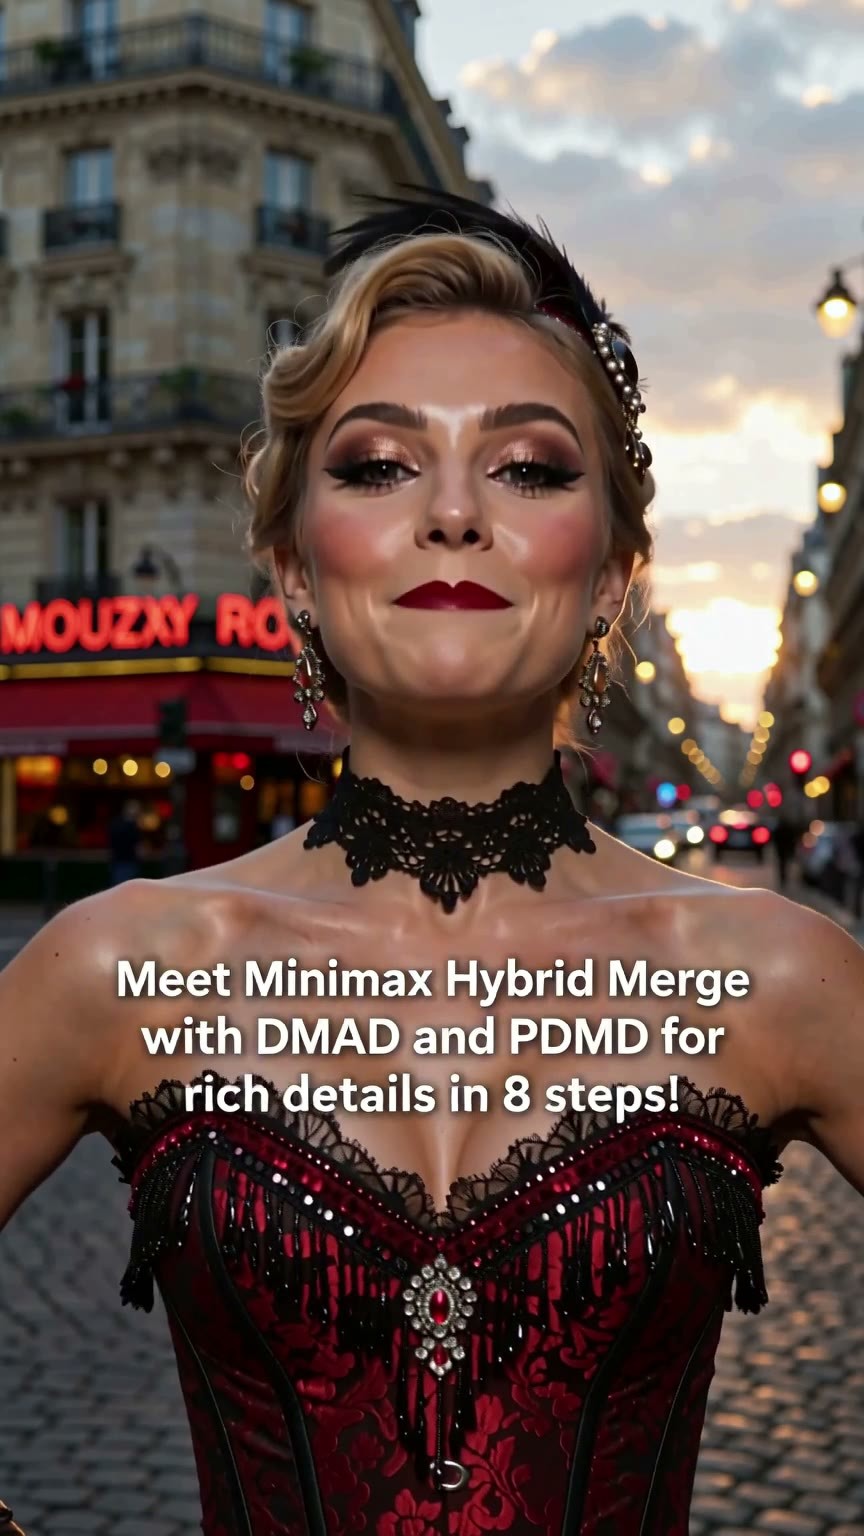
【A】MiniMax H3 Hybrid DMAD PDMD · MH3-Hybrid-DMAD-PDMD
ベースモデル / Checkpoint · 新モデル · 作者 0l1v1aR0551 · 公開 11-04 05:25 · ダウンロード数 124
H3 の FL2VA と Ref2VA の2つのベースモデルをレイヤーごとに混合し、さらに DMAD と PDMD の2種類の蒸留を焼き込んだ INT8 統合ベースモデルです。作者は 8 ステップで動画生成が可能で、加速用 LoRA の適用は不要と述べています。
本グループで唯一の新ベースモデルです。元の Ref2VA と同じ参考画像を用いて、暗部を比較検討することを推奨します。
画像
推奨理由
- 新モデル:元の2つのベースモデルそれぞれの弱点に対応しています。作者によれば、FL2VA はコントラストや肌色が良好ですが、複数画像や参考条件への追従性が弱く、Ref2VA は参考画像への追従性は良いものの、暗部が潰れやすく、暗い色の帯(バンディング)が発生します。本モデルでは 0–19 レイヤーはすべて FL2VA を使用し、20–34 レイヤーは3次平滑曲線で遷移させ、35–49 レイヤーは Ref2VA を使用しています。
- 蒸留を直接重みに統合:0.85 × DMAD(8 ステップ Critic 蒸留)+ 0.333 × PDMD v6(4-NFE 流蒸留)。作者は追加の LoRA 適用は不要と述べています。
- 参考画像からの動画生成、キャラクターの一貫性を保ちつつ FL2VA の画質の良さを維持したいシーン向け。INT8 ConvRot プルーニング量子化済みで、単一ファイルサイズは 19 GB 未満です。
- 公開後約 4 時間で 124 回のダウンロード、15 件のいいね(注目度の指標のみ)。無料であり、ライセンスでは画像出力、レンタル、販売、融合モデルの販売が許可されています。
使い方
- minimaxH3HybridDMAD_mh3HybridDMADPDMD.safetensors(INT8)をダウンロードし、H3 のベースモデルとして読み込みます。ステップ数は 8、加速用 LoRA は適用しません。
- サンプラー、CFG、解像度、および FL2VA と Ref2VA のどちらのノードフローを使用すべきかについては作者から提供されておらず、ワークフローの添付もありません。
リスクと制限
- 確認できるサンプルは 1 本の動画のみ(別途 1 本はセンシティブレベルのため非表示)。「画質の無損失」「深い参考追従」はすべて作者の主張であり、比較サンプルはありません。
- INT8 量子化統合モデルのため、この形式を読み込める ComfyUI ノードが必要です。作者は元の LoRA との互換性について説明していません。
- 初版であり、更新履歴はありません。本項目は動作確認を行っていません。
注目(6)
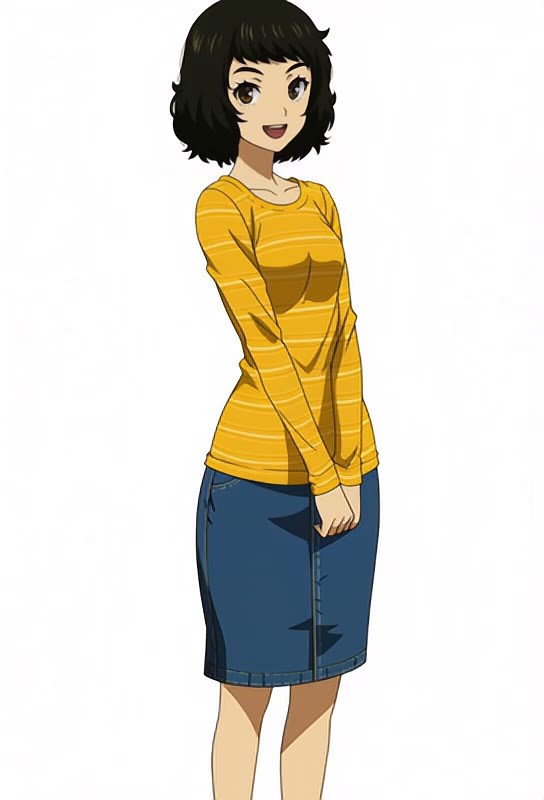
【B】Sadayo Kawakami Voice - Persona 5 - Audio Only [Minimax H3] · Minimax H3 v1.0
LoRA · 新モデル · 作者 OneMoreLurker · 公開 11-03 21:39 · ダウンロード数 73
『ペルソナ5 皇家版』の川上貞代の日本語音声 LoRA です。H3 が生成する話声のみに影響します。
画像
推奨理由
- 新モデル:ゲームの日本語吹き替え音声断片で学習されています。英語でアクションを記述し、日本語で台詞を記述します。作者は英語の台詞でも話せると述べていますが、公式の英語吹き替えとは似ていないと推測されます。
- 学習台詞は日常的で気遣う口調(相手が危険なことをしないよう促す、家事で困ったら呼んでほしいなど)が中心で、感情は照れ、緊張、自信、リラックス、喜び、興奮、親密さをカバーしています。
- このキャラクターの日本語の声が必要な音声付き動画向け。3 本のサンプル動画(別途 1 本は非表示)があり、同作者の今号の Persona 音声 LoRA 群の中では確認できるサンプル数が最も多いものの一つです。
- 無料。73 回のダウンロード(注目度の指標のみ)。
使い方
- H3 ワークフローで minimax-p5kawakami.safetensors を読み込み、学習フォーマットに従って Kawakami says "<日本語台詞>" と記述します。
- トリガーワードは登録されていません。強度、ステップ数は作者から提供されていません。
リスクと制限
- 音声のみであり、キャラクターの外見は別途設定が必要です。データはすべて日本語であり、英語を話した場合の効果は作者自身も確信を持っていません。
- 学習データは公式吹き替えであり、声優の声の権利に関わります。ライセンスでは販売が許可されていますが、商用利用は自己責任で評価してください。
- 1 件のセンシティブレベルのサンプルは非表示です。サンプルを確認していないため、音色の再現度は判断できません。本項目は動作確認を行っていません。
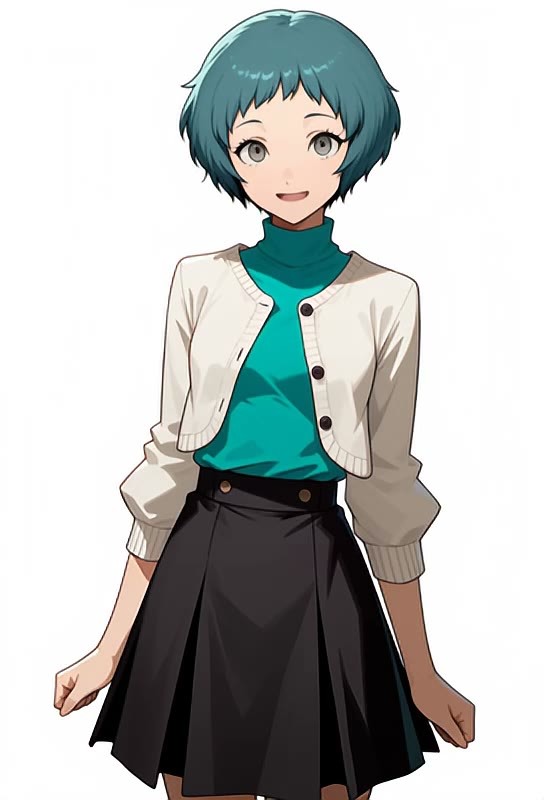
【B】Fuuka Yamagishi Voice - Persona 3 - Audio Only [Minimax H3] · Minimax H3 v1.0
LoRA · 新モデル · 作者 OneMoreLurker · 公開 11-04 08:28 · ダウンロード数 10
『ペルソナ3 Reload』の山岸風花の日本語音声 LoRA です。H3 が生成する話声のみに影響します。
画像
推奨理由
- 新モデル:Reload 版の日本語吹き替え音声断片で学習されています。英語で記述し、日本語で台詞を記述します。カードには3つのサンプル(謝罪、資料関数が多いと読みにくいという発言、付き合ってくれたことへの感謝)が記載されています。
- 感情のカバー範囲は同作者の Persona シリーズと一致しており、照れ、緊張、自信、リラックス、喜び、興奮、親密さをカバーしています。作者は英語の台詞も話せると述べていますが、公式の英語吹き替えと似ている保証はありません。
- このキャラクターの日本語の声が必要な音声付き動画向け。3 本のサンプル動画(別途 1 本は非表示)。
- 公開後 1 時間未満で 10 回のダウンロード、無料(注目度の指標のみ)。
使い方
- H3 ワークフローで minimax-p3fuuka.safetensors を読み込み、学習フォーマットに従って Fuuka says "<日本語台詞>" と記述します。
- トリガーワードは登録されていません。強度、ステップ数は作者から提供されていません。
リスクと制限
- 音声のみであり、キャラクターの外見は別途設定が必要です。データはすべて日本語です。
- 学習データは公式吹き替えであり、声優の声の権利に関わります。ライセンスでは販売が許可されていますが、商用利用は自己責任で評価してください。
- 公開直後であり、使用フィードバックはまだありません。サンプルを確認していないため、音色の再現度は判断できません。本項目は動作確認を行っていません。
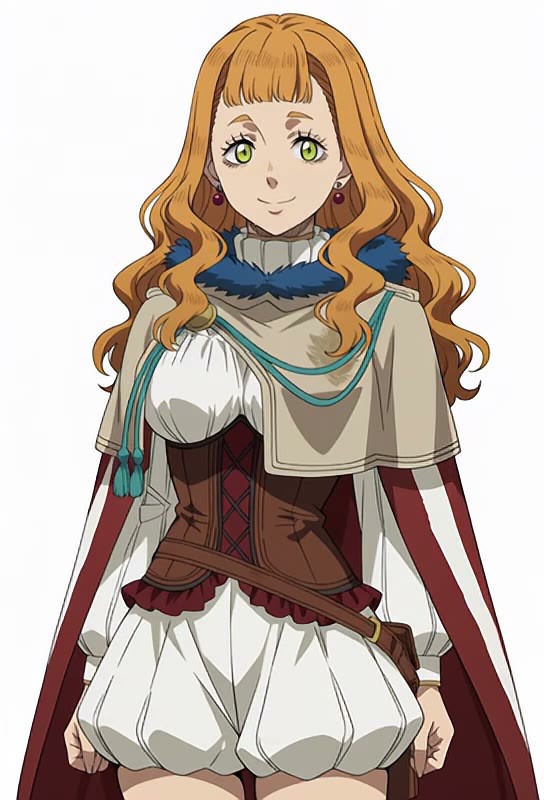
【B】Mimosa Vermillion Voice (Eng) - Black Clover - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0
LoRA · 新モデル · 作者 OneMoreLurker · 公開 11-03 21:24 · ダウンロード数 65
『ブラッククローバー』の Mimosa Vermillion の英語音声 LoRA です。H3 が生成する話声のみに影響し、映像には影響しません。
画像
推奨理由
- 新モデル:アニメの英語吹き替え音声断片で学習されています。アノテーションと転写はすべて英語であるため、英語の台詞をそのまま記述すれば学習データと一致します。この点は、同作者の日本語吹き替えベースの Persona 音声 LoRA 群とは異なります。
- 学習アノテーションには感情副詞が含まれており、例えば Mimosa shyly asks / excitedly says といった形式です。同様の書き方をプロンプトで指定することで、トーンを制御できます。作者が列挙した感情には、照れ、ツンデレ、自信、リラックス、喜び、興奮が含まれます。
- 固定されたキャラクターの声が必要な音声付き動画(同人短編ドラマ、キャラクターの台詞断片など)向け。本項目は受託制作作品です。
- 2 本のサンプル動画(別途 1 本は非表示)。無料。65 回のダウンロード(注目度の指標のみ)。
使い方
- H3 ワークフローで minimax-blackCloverMimosa.safetensors を読み込み、台詞を Mimosa says "……" または Mimosa shyly asks "……" の形式で記述します。
- トリガーワードは登録されていません。強度、ステップ数は作者から提供されていません。
リスクと制限
- 音声のみであり、キャラクターの外見は別途キャラクター LoRA や参考画像で設定する必要があります。
- 学習データは公式吹き替えであり、声優の声の権利に関わります。ライセンスでは販売が許可されていますが、商用利用は自己責任で評価してください。
- サンプルを確認していないため、音色の再現度は判断できません。本項目は動作確認を行っていません。
【B】mini max character replace - with turbo lora 4 steps · v2.0
ワークフロー · バージョン更新 · 作者 kimimorgam · 公開 11-04 07:09 · ダウンロード数 16
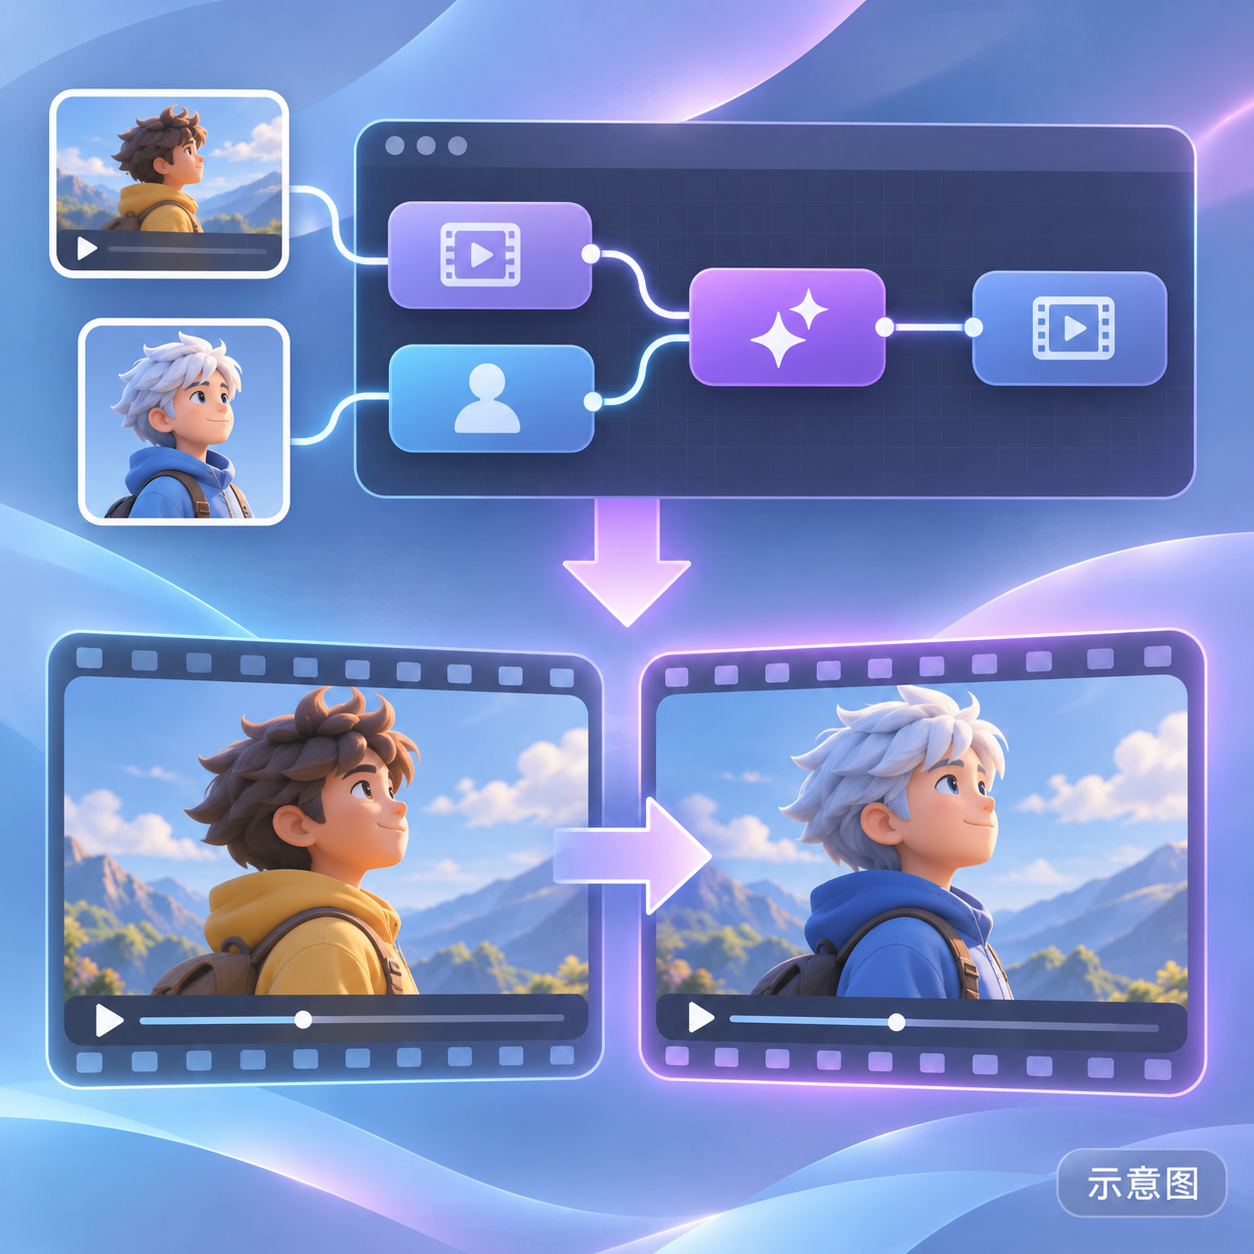
H3 キャラクター置換ワークフロー v2.0:元動画と新しいキャラクター画像を1枚与えると、元動画のアクション、カメラワーク、構図を保持しつつ、人物を参考画像のキャラクターに置き換えます。Turbo LoRA を使用し、4 ステップで動画を生成します。
画像
推奨理由
- バージョン更新:本バージョンの更新説明は「新しいワークフローで、効果は非常に良い」という一文のみで、具体的な変更点は記載されていません。前バージョン 1.1 では、長尺動画、長いコンテキスト、SAM マスク、および 5 秒ごとのセグメンテーションが追加されました。
- 動画のキャラクター置換向け:元動画がアクション、ポーズ、カメラワーク、リズム、シーン構図を提供し、キャラクター画像が新しいアイデンティティと外見を提供します。プロンプトはオプションで、微調整に使用できます。
- 作者は Turbo LoRA(プルーニング版)を使用し、4 ステップで生成することで、標準の 20 ステップフローよりも大幅に高速になると述べています。
- 無料。本バージョンのダウンロード数は 16 回、モデル全体のダウンロード数は 2680 回(注目度の指標のみ)。
使い方
- miniMaxCharacterReplace_v20.json(52 KB)をインポートします。ベースモデルには MiniMax H3 Ref2VA Pruned INT8 ConvRot を使用し、サンプリングには MiniMax H3 Turbo を使用、ステップ数は 4 です。
- 入力:元動画 + 新しいキャラクター参考画像 + オプションのプロンプト。SAM マスクなどのノードやモデルはワークフローに従って各自で補完する必要がありますが、作者はリストを提供していません。
リスクと制限
- 確認できるサンプルがなく(1 件は非表示)、置換効果を確認できません。
- 作者は v2.0 と 1.1 の具体的な変更点を書いておらず、モデルカードの本文は旧バージョンの説明のままです。
- 実写動画内の人物を置換することは肖像権に関わるため、素材の許諾を各自で確認する必要があります。本項目は動作確認を行っていません。
- カードの画像は AI 生成の概念図であり、モデルの実際の効果ではありません。作者は公開された一般レベルのサンプルを持っていません。
【B】Corrugated Cardboard [Krea2] · Minimax v1.0
LoRA · ポート · 作者 TeraWatt · 公開 11-03 22:38 · ダウンロード 0 · 有料
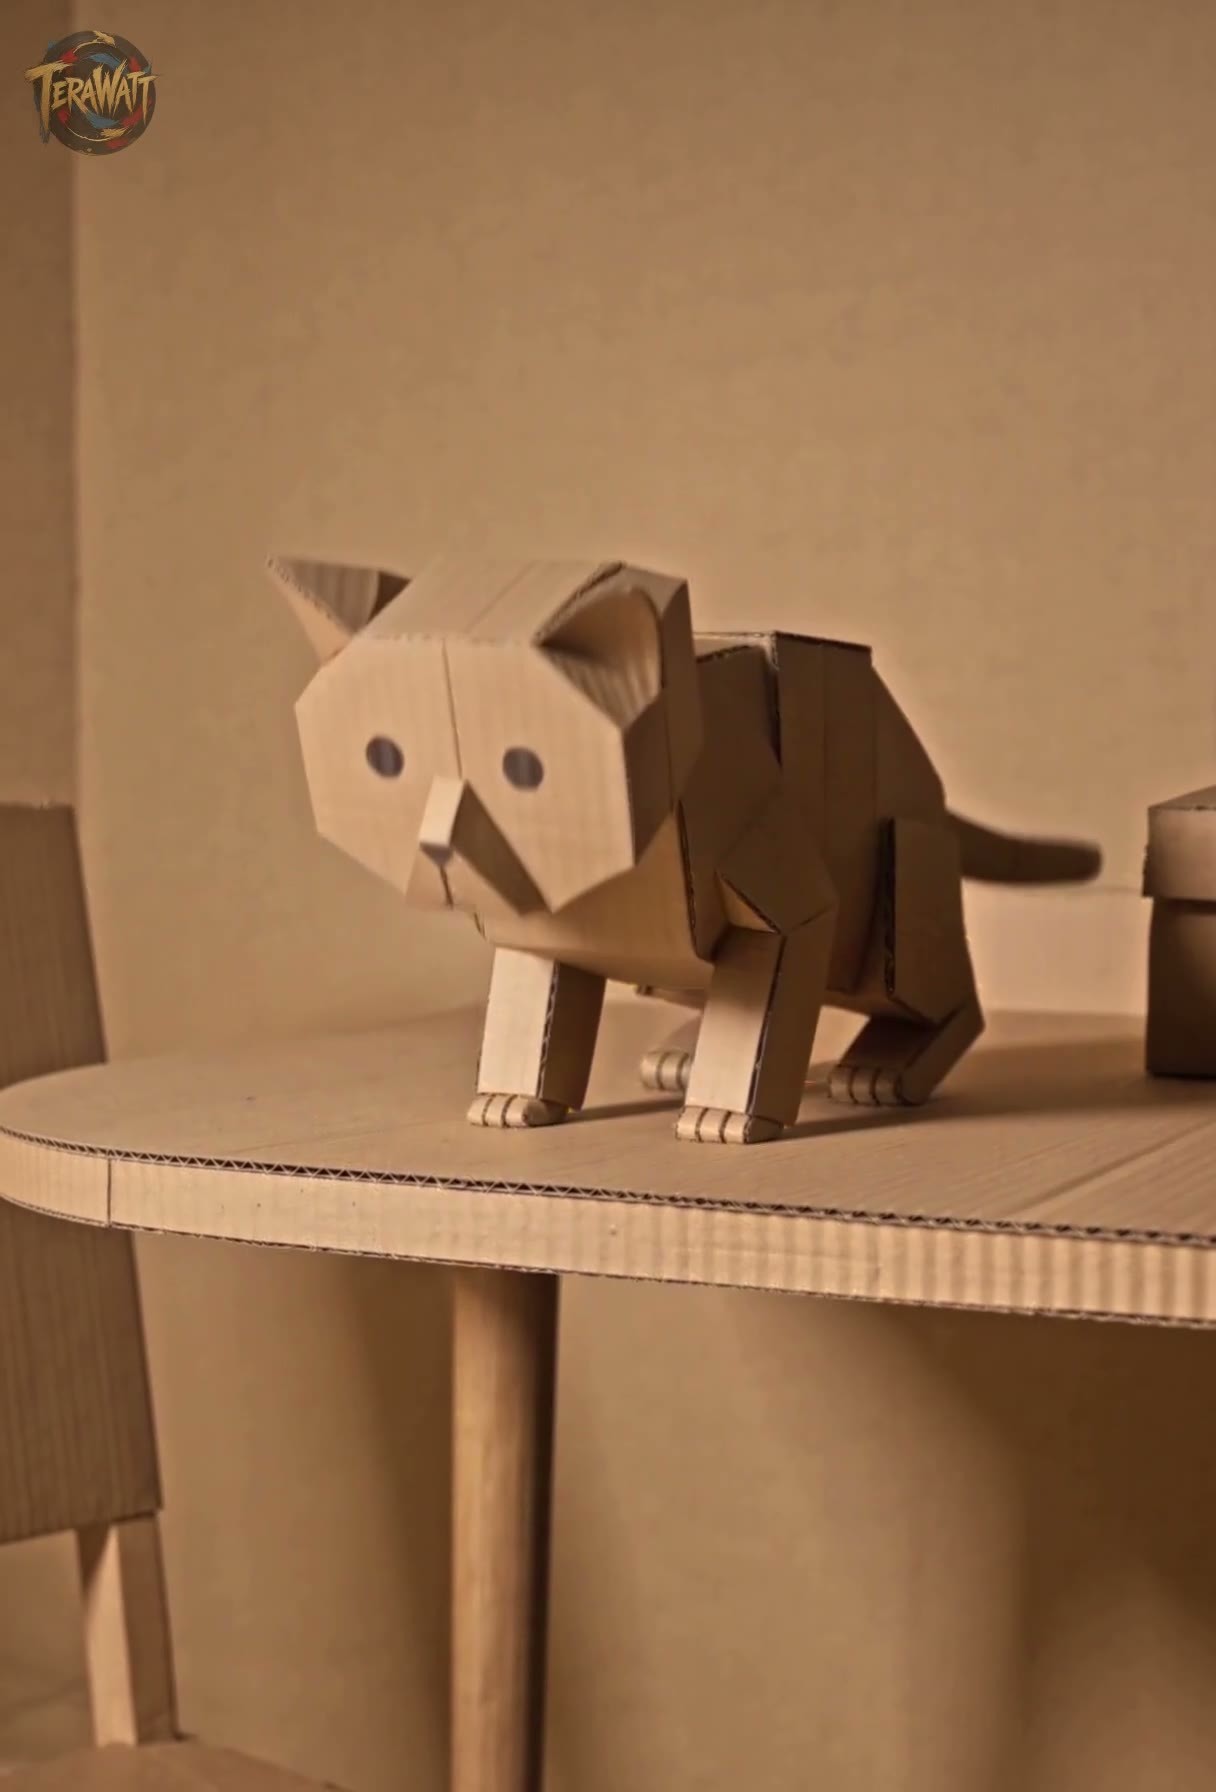
段ボール手工芸風 LoRA:画像を段ボールで作られた手工芸の切り貼り作品に変換し、段ボールの質感、不揃いな縁、粗いテクスチャを付与します。
画像
推奨理由
- ポート:同名モデルはまず Krea 2 で公開され、同日に H3 と MOSS Image 版もリリースされました。3つのバージョンでトリガーワードは共通です。カードには H3 版と画像版の学習時の差異は記載されておらず、H3 のサンプルはすべてテキストから動画生成(文生動画)で作成された旨のみが説明されています。
- シリーズ全体のスタイル統一:作者は、人物、風景、ペットを同一の段ボール手工芸作品として仕上げる例や、異なるキャラクターやシーンで一貫した質感を保つ例を挙げています。
- 11 個のサンプル動画(他に 1 個は非公開)があり、スタイルを確認してから利用可否を判断できます。
使い方
- H3 のテキストから動画生成ワークフローで CorrugatedCardboard_TW_Minimax.safetensors を読み込み、プロンプトにトリガーワード CorrugatedCardboard_TeraWatt を記述します。
- 強度やステップ数については作者から指定がありません。
リスクと制限
- 有料(永久課金)です。本バージョンのダウンロード数は 0 回です。
- 作者はテキストから動画生成への利用方法のみを説明しており、画像から動画生成への適用可否は記載されていません。本項目は動作確認を行っていません。
トリガーワード:CorrugatedCardboard_TeraWatt
【B】Prophetero Final Check GLOBAL — リリース前のレビュー · v1.1
ワークフロー · 新モデル · 作者 Prophetero · 公開 11-03 21:41 · ダウンロード 19
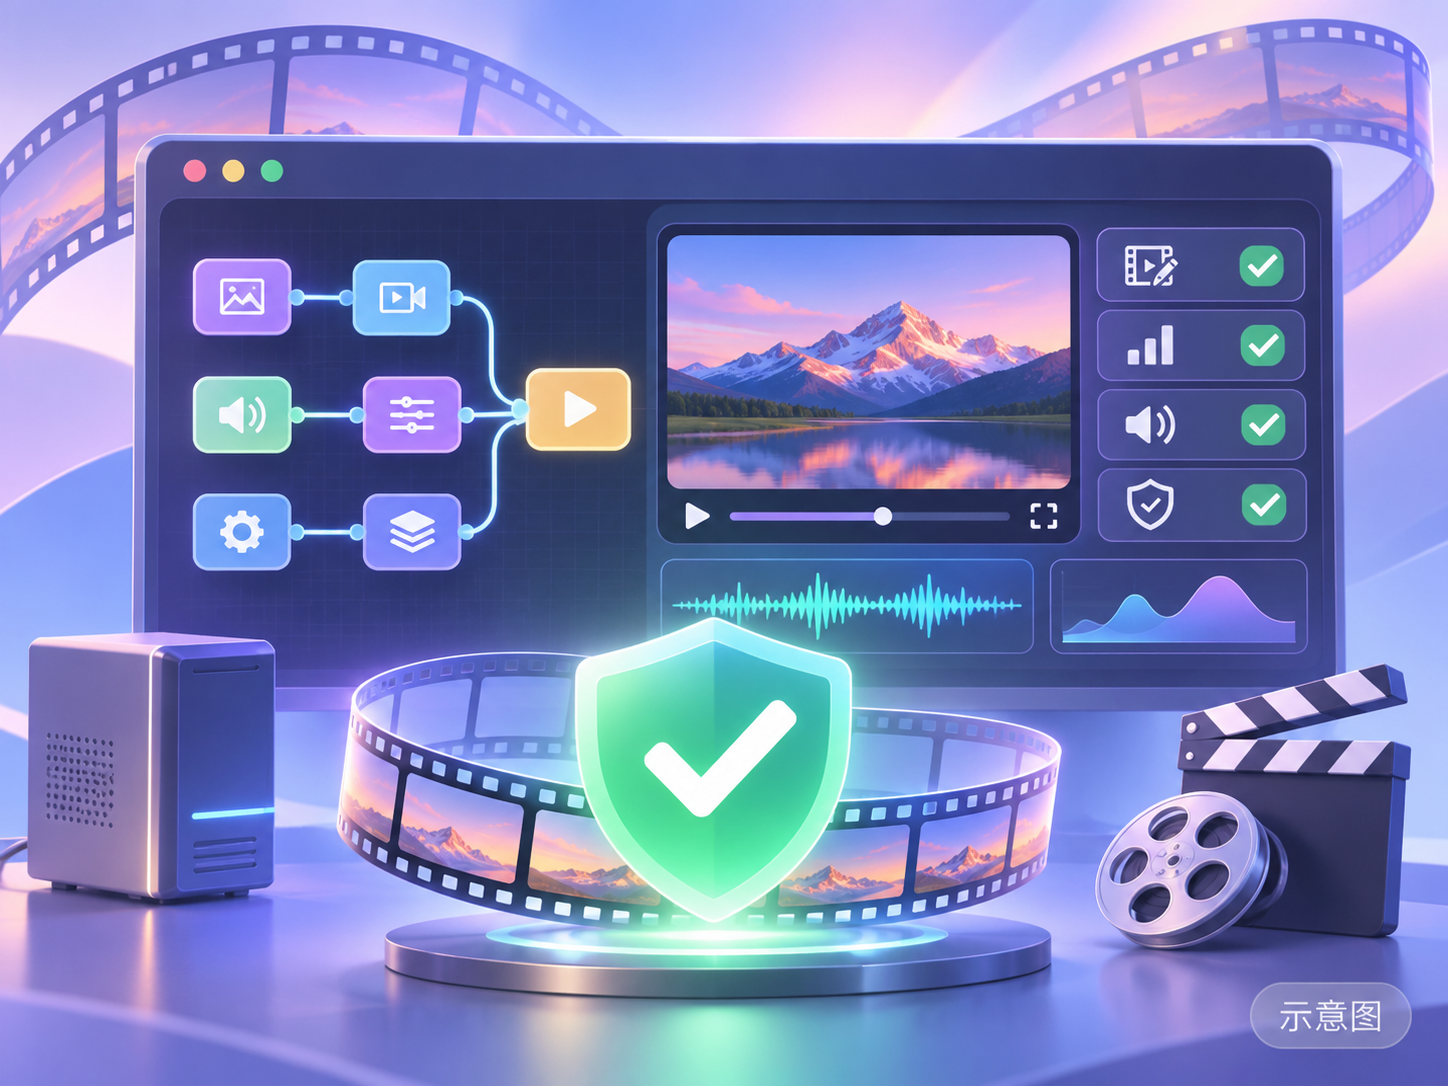
Prophetero Final Check プレビュー版:動画公開前にローカル動画の自動技術チェックを行い、ブラックアウト区間、ほぼ静止している画面、無音または音声トラック欠如、音声ピークが高すぎるタイミングなどを特定し、その後人間が項目ごとに再確認します。
画像
推奨理由
- 新モデル:完成動画のアップロード前における品質検査プロセスを支援します。ほぼ黒い画面、フレーム間の変化が小さい(スタックの可能性もあれば意図的な静止画の可能性もある)区間、無音区間や音声トラックの欠如、ほぼ最大レベルの音声ピーク、および解像度、フレームレート、エンコーディングなどの技術情報を自動でチェックします。さらに、動画内にプロンプトやワークフローが埋め込まれているかどうかも識別します。
- 独立したブラウザタブで動作します:一度に最大 8 本の動画を追加でき、タイムスタンプをクリックして問題箇所へジャンプし、「要再確認 / 修正要 / 意図的」とマークしてメモを記入できます。JSON レポートのダウンロードが可能で、エクスポートされるレポートには完全なソースパスや元のプロンプトは含まれません。
- 生成モデルに依存しません。H3、LTX、カメラ素材などすべてチェック可能です。検出は CPU/FFmpeg 上で逐次実行され、途中で停止できます。選択した区間を作者の Audio Fix、Loop Lab、Take Compare に引き渡すことも可能です。
- 無料です。ダウンロード数は 19 回(注目度の指標にすぎません)。
使い方
- propheteroFinalCheckGLOBAL_v11.zip(49 KB)を解凍し、ComfyUI バックエンドを停止した状態で START_HERE.cmd を実行してインストールします。再起動後、Prophetero_Final_Check_GLOBAL.json を開き、「Open Final Check」をクリックして動画を追加します。
- 既存の ComfyUI Python 環境に aiohttp、PyAV、Pillow、imageio-ffmpeg が必要ですが、作者はこれらを同梱していません。検出時間や音声閾値は調整可能で、個別の検出項目を無効化することもできます。
リスクと制限
- プレビュー版です。縦横比が正方形のピクセルを持つ SDR クリップのみ受け付け、長さは 0.5~120 秒です。完全版のカードにはさらに 1~60 FPS、最大 8 MP、単一ファイル 2 GiB / 累計 6 GiB という制限があります。手の変形、物理的な誤り、美的評価はチェックせず、結果はあくまでヒントにすぎません。
- 本バージョンのリリースノートは誤って Take Compare の更新内容が貼り付けられており、バージョン番号の表記もカード上のものと一致していません。インストーラーは Windows 用の .cmd です。
- 目に見えるサンプルがありません(2 個は非公開)。ライセンスにより派生物の作成は禁止されており、ソフトウェア自体の転売も不可です。本項目は動作確認を行っていません。
- カードの画像は AI 生成された概念図であり、モデルの実際の出力結果ではありません。作者には公開されている通常のサンプルがありません。
収録のみ(5)
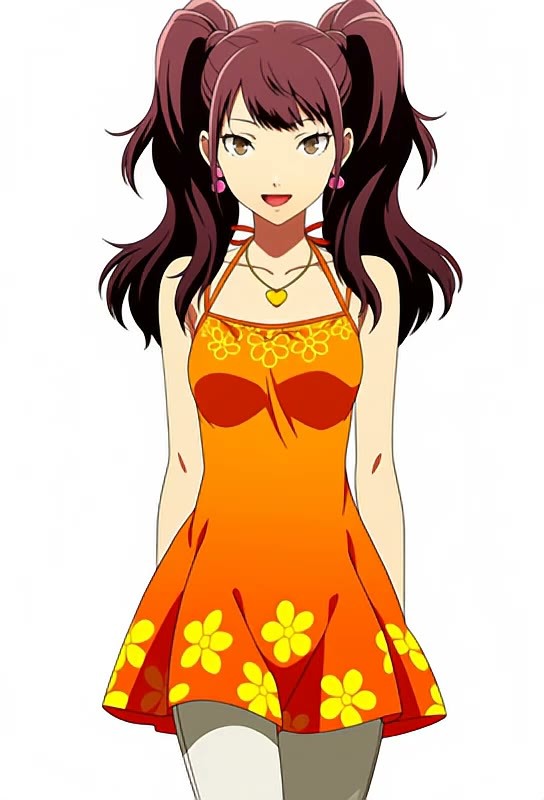
- Rise Kujikawa Voice - Persona 4 - Audio Only [Minimax H3] · Minimax H3 v1.0 — LoRA:『ペルソナ4 ゴールデン』の久慈川りせの日本語音声 LoRA。H3 で生成される話声のみに影響します。
- MiniMax H3 Video to Video Workflow · v2.0 — ワークフロー:H3 の動画から動画への変換ワークフロー v2.0。作者はタイトルのみを記載しており、元動画を具体的にどのように変更するかについては説明がありません。
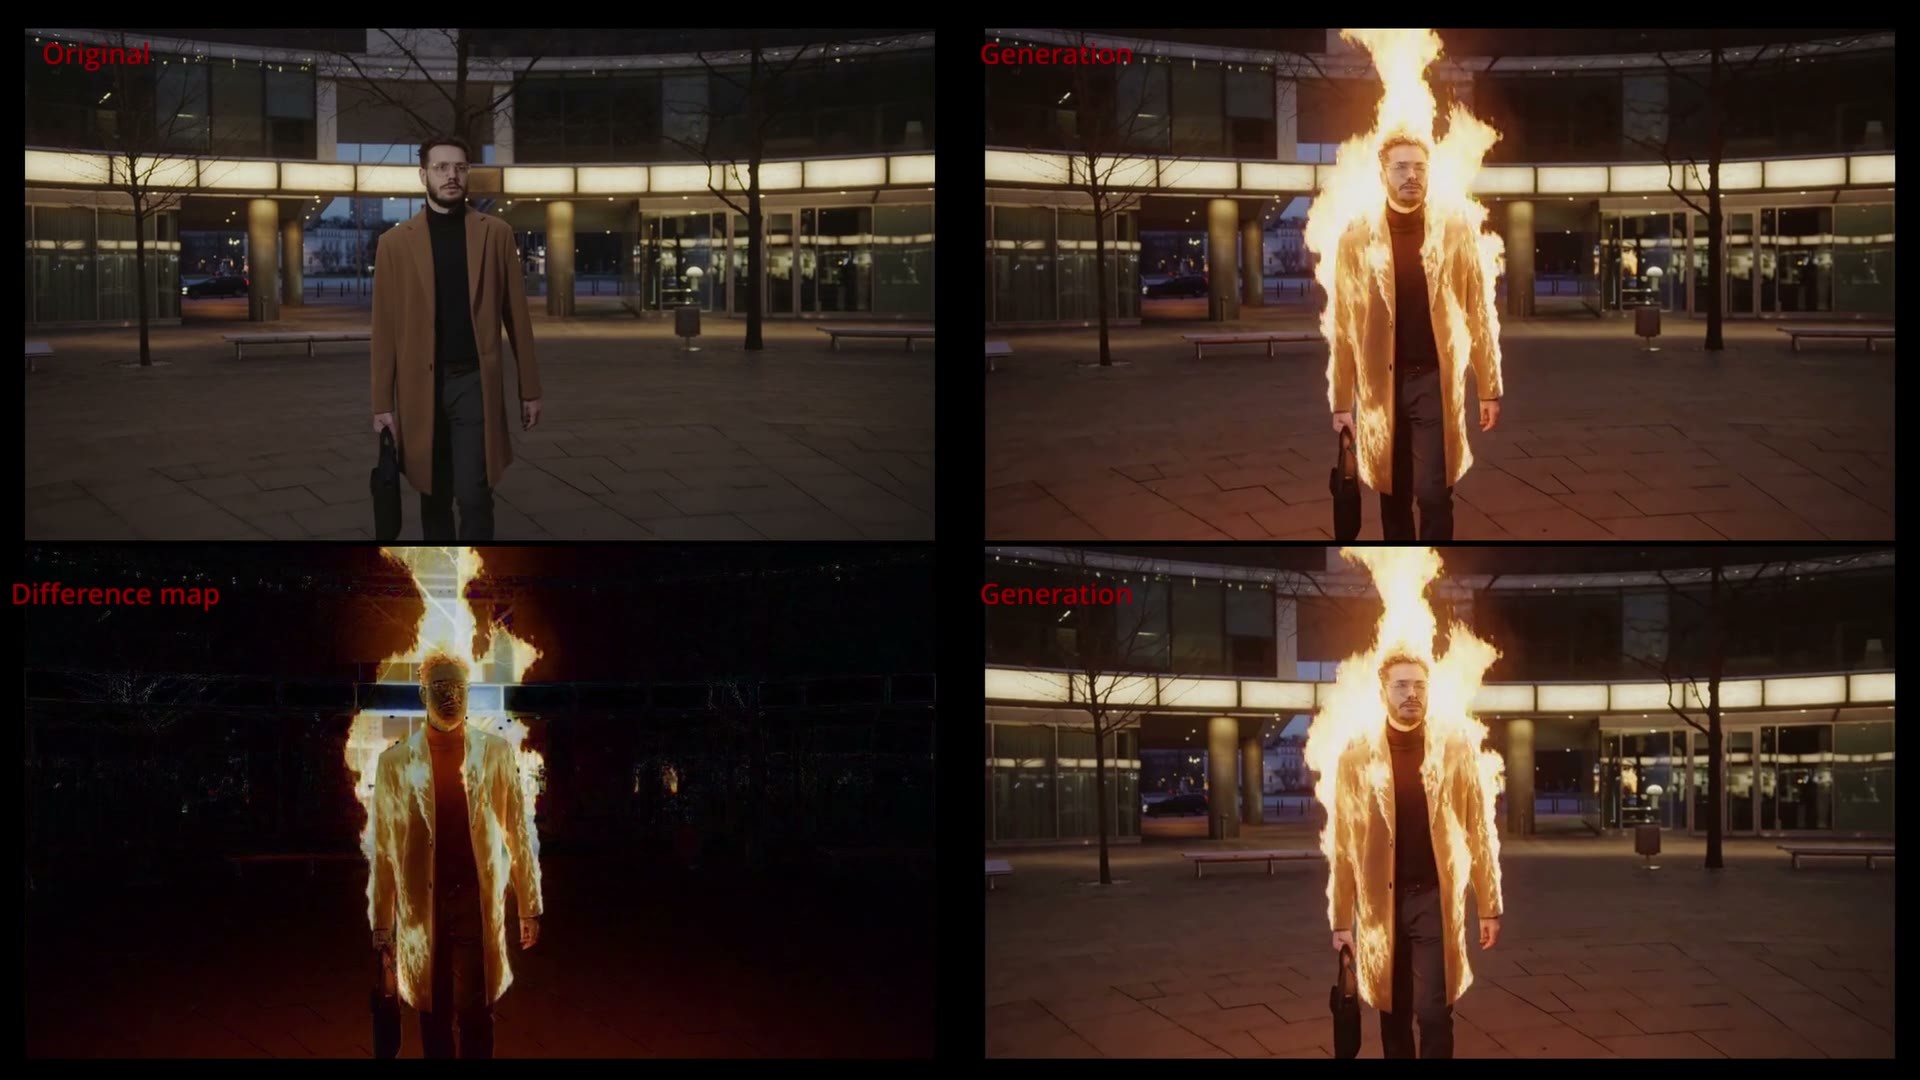
- Diya Von Vergin · MiniMaxH3 — LoRA:作者によるオリジナルの成人架空キャラクター「Diya Von Vergin」(オックスフォードの名門出身のオートクチュールファッションのセレブリティ)のキャラクター LoRA。H3 動画版です。
- Tae Takemi Voice - Persona 5 - Audio Only [Minimax H3] · Minimax H3 v1.0 — LoRA:『ペルソナ5 ロイヤル』の武見妙の日本語音声 LoRA。H3 で生成される話声のみに影響します。
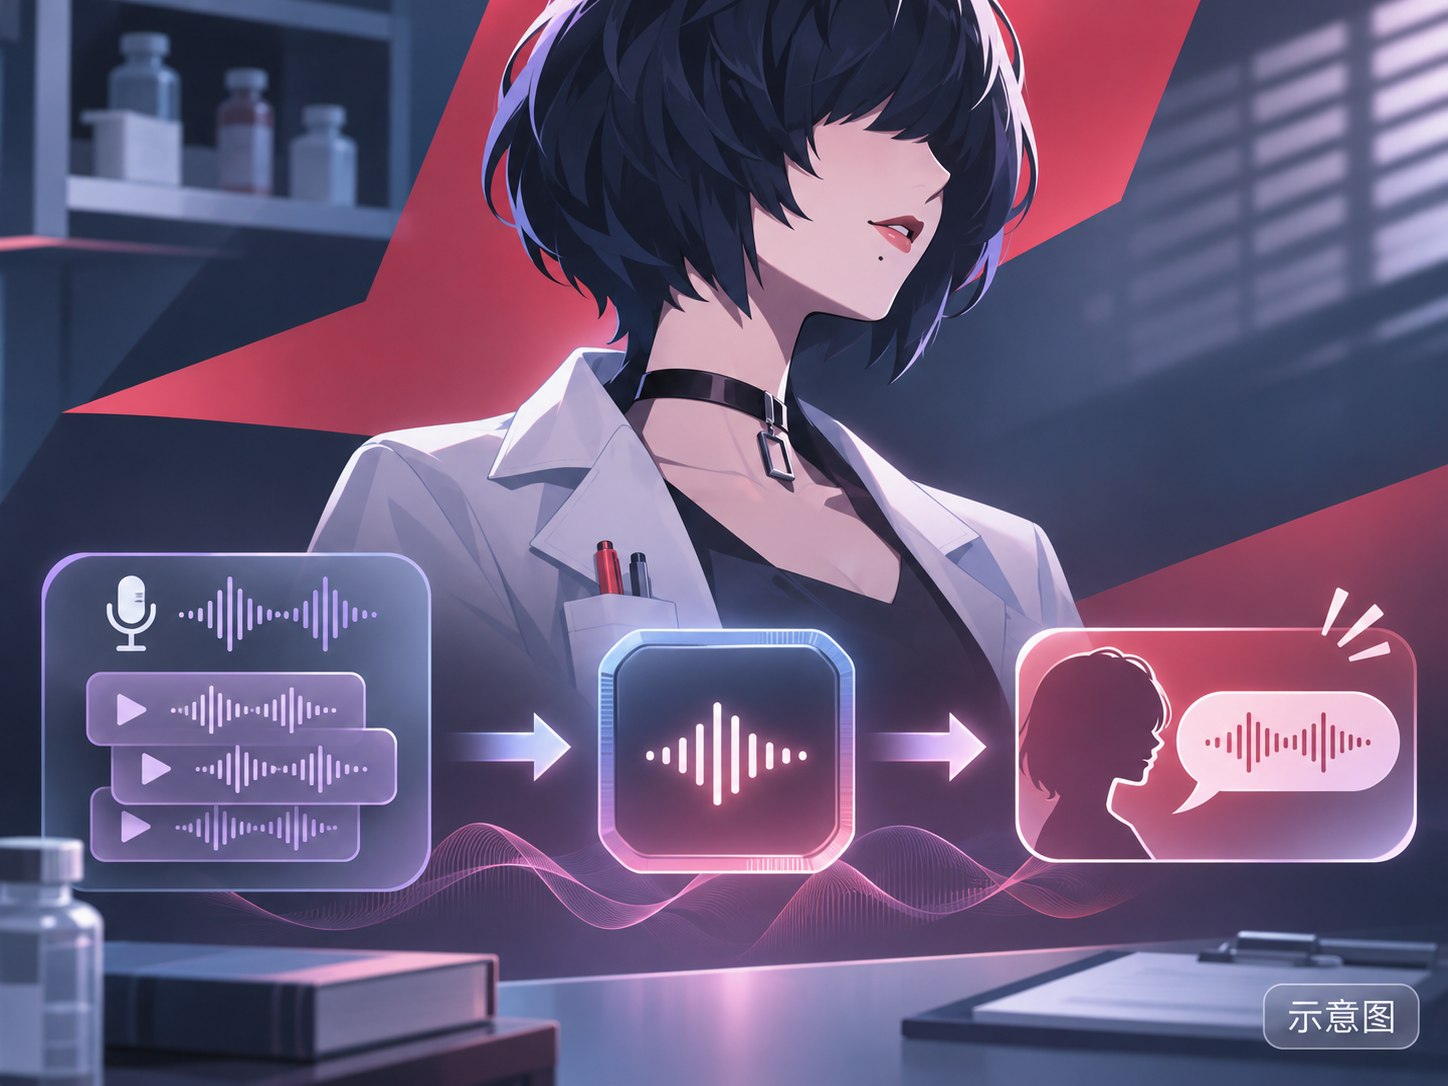
- Minimax-H3_Video_Editing_1STG_2Batchs · v2.0 — ワークフロー:H3 動画編集ワークフロー v2.0:1つのショットを2バッチに分けて処理し、最大トークン数超過を回避します。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-03 20:31 → 11-04 09:01(北京時間)。推奨理由は編集者によるレビュー済み。ダウンロード数は注目度にすぎません。