貞貞のAIレーダー · MiniMax H3 · 2026-11-05 朝刊
今号の 10 個の新バージョン:強く推奨 0 · 推奨 5 · 注目 2 · 収録のみ 3
編集者按語 今号では 10 個の H3 新バージョンをレビューしました。初推は H3MD Director 0.3:オープンソースのノードパックとワークフローにより、H3 を用いて 2~3 分の長尺動画を一度で生成可能。長回しでは各セグメントが前の末尾の latent を引き継いで続きを描き、カット割りによるハードカットも可能ですが、公開されているサンプルは 1 枚のみで、評価は A です。A ランクには他に、Ref2VA を静止画生成器として使う Image Studio、P-H3-Image のテキストから画像生成/参照編集ワークフロー、LongForge 7.6(エクスポート時に全体を RTX 超解像、フレーム補間、HDR 処理)、単一画像からのカメラアングル変更ワークフローが含まれます。P-H3 版のキャラクター設定画ワークフローと音声トラックのみを修正するオーディオパッチツールは B、人物/キャラクター LoRA の説明や公開サンプルが不十分な 3 件は C としました。
推奨(5)
【A】Minimax H3 Image Studio 4k+ · v1.0
ワークフロー · 新モデル · 作者 Hopik65 · 公開 11-04 21:46 · ダウンロード 75
H3 の Ref2VA ビデオモデルを静止画生成器として利用する ComfyUI ワークフロー:テキストから画像生成、または最大 9 枚の参照画像を用いた生成が可能で、SeedVR2 による詳細化と 4096 px への拡大も選択できます。
推奨理由
- 新モデル(ワークフロー):Pika H3 Flex Turbo LoRA を用いて 8 ステップのサンプリングを行い、デコードされたフレームから自動でベストな 1 フレームを選択;参照画像スイッチをオフにすれば純粋なテキストから画像生成
- キャラクター/シーンの一貫性が必要な静止画サービス向け:最大 9 枚の参照画像、それぞれ個別のグループに設定可能で、個別にミュート可能
- 作者は依存関係を完全に記載:拡散モデル、テキストエンコーダー、VAE、Turbo LoRA のファイル名と Hugging Face リンク、およびインストールが必要なカスタムノードパック
- 6 枚の公開サンプル画像;無料、ライセンスは寛容(販売許可あり);75 回のダウンロード(注目度のみを示す)
使い方
- minimaxH3ImageStudio_v10.json をインポート;Text (Prompt) ノードでシーン、被写体、ライティング、スタイルを記述し、カメラワークや音声は記述不要
- 参照画像を使用する場合:必要な Ref Img ノードのミュートを解除し、スイッチを true に設定;参照画像を使用しない場合は Image Reference (On & OFF) を false に設定
- H3ImageResolutionPreset でアスペクト比と解像度を選択:デフォルトは 8 MP、VRAM が不足する場合は 4 MP またはそれ以下に下げ、SeedVR2 で拡大;拡大が不要な場合は SeedVR2 グループをミュート
- モデル:minimax_h3_ref2va_fp8_e4m3fn、qwen3vl_32b_minimax_h3_nvfp4_awq(テキストエンコーダー)、minimax_h3_video_vae_int8_convrot、pika_h3_flex_turbo_8step_hd_ref2va;ノード:ComfyUI-MiniMax-H3-Image-Studio、rgthree-comfy、comfyui-zip-ties、ComfyUI-SeedVR2_VideoUpscaler
リスクと制限
- 依存関係が重い:拡散モデル 33.3 GB、テキストエンコーダー 14.9 GB、Turbo LoRA 3.9 GB;作者は RTX 3060 上で 4K + SeedVR2 を使用し、1 枚あたり約 500~550 秒
- PrunaAI リポジトリの VAE ファイル名が異なるため、リネームするかローダーで手動選択が必要;Power Lora Loader 内の PhotoReal LoRA は自前で用意するか無効にする必要あり
- 1 件のセンシティブレベルのサンプルは非表示;画質は未検証;本項目は未実行
【A】MiniMax P-H3 Image Generation & Reference Editing v1.0 (Anikin Labs) · v1.0
ワークフロー · 新モデル · 作者 Roman_Anikin · 公開 11-05 02:46 · ダウンロード 103
P-H3-Image の ComfyUI ワークフロー:スイッチ一つでテキストから画像生成と参照画像編集(最大 2 枚の参照)を切り替え、PrunaAI の W4A8 量子化モデルとプリセットの 8 ステップ sigma テーブルを使用。
推奨理由
- 名称の P-H3 は P-H3-Image を指す:PrunaAI が MiniMax H3 をファインチューニングしたテキストから画像生成/画像編集モデル(Hugging Face のモデルカードに MiniMax-H3 ベース、H3 コミュニティライセンス継承と明記)であり、本セクションに該当するが、出力は動画ではなく静止画
- 新モデル(ワークフロー):テキストから画像生成と参照編集を同一インターフェースに統合、解像度は調整可能、独自の 8 ステップ sigma スケジュールを内蔵
- 必須の 3 つのモデルファイルとダウンロードリポジトリが記載されており、手順が明確;3 枚の公開サンプル画像
- 無料;103 回のダウンロード、9 いいね(注目度のみを示す)
使い方
- Hugging Face の PrunaAI/P-H3-Image-Comfy から p-h3-image_w4a8.safetensors(拡散モデル)、p-h3-image_text_encoder_w4a8.safetensors(テキストエンコーダー)、p-h3-image_vae_int8_convrot.safetensors(VAE)をダウンロード
- minimaxPH3ImageGeneration_v10.json をインポートし、スイッチでモードを選択;参照編集時は 1~2 枚の参照画像を読み込み
- プリセットの 8 ステップ sigma テーブルは変更しないこと(作者は不慣れな場合は変更しないよう注意喚起);CFG、サンプラー、必要なカスタムノードについては作者から提供されていない
リスクと制限
- P-H3-Image には独自のライセンスと地域制限があり、作者は米国、EU、英国、韓国のユーザーに対し公式ライセンスを確認するよう注意喚起
- Hugging Face ページには VRAM 要件が 21 GB 以上と記載
- 2 件のセンシティブレベルのサンプルは非表示;本項目は未実行
【A】MiniMax H3 LongForge FL2VA & REF2VA (LONG VIDEO) · LongForge v7.6
ワークフロー · バージョン更新 · 作者 AIBOB1199 · 公開 11-05 05:48 · ダウンロード 104
シーンごとに H3 の長尺動画を音声付き完成動画にする ComfyUI ワークフローキット(ノードパックと RefMod Studio 同梱)、7.6 版ではエクスポート時に全体を NVIDIA RTX 超解像、フレーム補間、HDR 処理する機能が追加。
推奨理由
- バージョン更新(第 20 バージョン):エクスポート時に全体を Super Resolution → Frame Generation → HDR の順で処理可能、3 項目は個別または組み合わせで有効化でき、元の take と latent は保持され、フレーム補間は長さと音声を変更しない
- 参照素材(画像/動画/オーディオカード)はドラッグ&ドロップで並べ替え可能、順序はワークフローに保存される;メインワークフローのレイアウトを再構成し、3 つの RTX スイッチを 21 · RTX Export に集約
- FL2VA / REF2VA のマルチシーン長尺動画向け:プロンプト、take 選択、編集から HQ 拡大までをワンフローで実現、ワークフロー内にロシア語/英語の説明を内蔵
- モデル累計 10202 回のダウンロード、本バージョン公開後 4 時間で 104 回(注目度のみを示す)
使い方
- minimaxH3LongforgeFL2VA_longforgeV76.zip を解凍し、同梱の Node Pack をインストール、FL2VA / REF2VA メインワークフローを開く
- RTX 効果を使用する場合:ComfyUI Nvidia VFX Nodes とその依存関係を別途インストールし、21 · RTX Export で必要な効果を有効化(デフォルトはすべてオフ)、画像入力は空のまま、EXPORT FILM を実行
- RTX フレーム補間を使用する場合、Export Settings の Frame interpolation × を 1 に設定し、RIFE/FILM との重複を避ける;Specific timestep モードは ×2 FPS
- 必要な H3 モデルとサンプリングパラメータはワークフロー内の説明に記載されているが、本項目では個別に検証していない
リスクと制限
- 作者は更新説明を記載していない:バージョン説明欄は空欄で、変更点はモデルカードの「7.6 新規追加」セクションにのみ記載
- 公開サンプル画像は 1 枚のみ(生成パラメータなし)、他に 5 件のセンシティブレベルは非表示;完成動画は未視聴、画質は未検証
- RTX 効果には NVIDIA グラフィックカードと追加ノードパックが必要、メモリに応じてバッチ処理、作者はまず短いシーンと 1 種類の効果で試すことを推奨;HDR で H264 を選択すると自動的に HEVC に変更
- 依存関係が多く、更新が速い(1 週間で 7.3~7.6 の 4 バージョンを連続リリース);本項目は未実行
【A】H3MD Director 0.3 – 2–3 min long videos with MiniMax H3 (simple workflow + Control Panel) · v0.3.3
ワークフロー · 新モデル · 作者 1113800942188 · 公開 11-05 05:42 · ダウンロード 51
オープンソースの ComfyUI ノードパック + ワークフローで、MiniMax H3 を用いて 2~3 分の長尺動画を一度で生成:長回しのワンカットも、カット割りごとのセグメント生成も可能。
今号の LongForge 新バージョンも長尺動画ソリューション:H3MD は一度で完走、パネルが簡素な方向性;LongForge はシーンごとの take 選択、編集、エクスポート後の処理が中心。
推奨理由
- 新モデルページ(プロジェクトの継続):前バージョン v0.1.1 は別ページにあり、本ページのノードパック 0.3.3 では Control Panel と簡素化ワークフロー、「which segments」による指定セグメントの再実行、プランと素材のバンドルエクスポート/インポート、保存時のドリフト補正、T8 セマンティックブリッジと SeedVR2 による顔修正が新規追加
- 長回し:各セグメントは前のセグメントの最後の 1.6 秒の latent から続きを生成し、動きとカメラワークが途切れない;ハードカットも可能で、新しいカットは自身の参照画像から再開し、ドリフトが蓄積しない
- Director パネルでカットごとの長さ、プロンプト、参照画像、ロックされたオーディオを計画;作者はリップシンク付き MV、モーション転送(depth + SAM3)、テキストから動画生成をサポートすると主張、長尺動画は 1080P まで対応し、低 VRAM/チャンク分割オプション付き
- 無料・オープンソース(AGPL-3.0)、GitHub にドキュメント、モデル表、プロンプトガイドがあり、YouTube にインストールチュートリアルもある
使い方
- ComfyUI 0.43 以上が必要(H3 をネイティブサポート);ComfyUI Manager で H3MD Director を検索するか、GitHub リポジトリを custom_nodes にクローンしてください
- 圧縮ファイル内の H3MD Director simple.json をキャンバスにドラッグして開始します;Control Panel でサイズ、fps / フレーム補間、顔修正、シード、スタイルボタン(Balanced / High motion / Motion copy)、および高 / 低解像度 LoRA リストを設定します
- which segments に 1 を入力して最初のセグメントのみを試行し、満足したらクリアして全体をレンダリングします(完了済みのセグメントはキャッシュから取得されます)
- 具体的なモデルファイルとステップ数は GitHub のモデル表に記載されており、モデルカードには記載されていません
リスクと制限
- 公開されている例は 1 枚の画像のみ(生成パラメータなし)で、他の 3 件のセンシティブレベルは非表示です;モデルカードに記載されているサンプル MV はこのページでは確認できず、「2〜3 分で一度に完了」というのは作者の主張です
- オプションコンポーネントが多く(SeedVR2 / VOSR2 による顔修正、depth + SAM3 によるモーション転送)、長尺動画の所要時間と VRAM 要件はモデルカードに記載されていません
- AGPL ライセンスにより派生作品のオープンソース化が要求されます;モデルカードには RunningHub のプロモーションリンクが含まれています;本項目は未実行です
【A】MiniMax H3 Multiangle Workflow for ComfyUI · v1.0
ワークフロー · 新モデル · 作者 ukr8b3g201 · 公開 11-05 02:42 · ダウンロード数 52
参考画像のカメラアングルを変更するための ComfyUI ワークフローです:3D カメラパネルで水平角、俯仰角、フレーミングを調整し、H3 に新しい視点の画像を生成させます。
推奨理由
- 新モデル(ワークフロー):H3 用であることを確認済み——拡散モデルは MiniMax H3 FL2VA(プルーニングされた INT8 版)で、P-H3-Image の VAE と LoRA が併用されています;Civitai のベースモデルタグは誤って MOSS Image と表記されています
- Match Background View をオンにすると新しいカメラ位置で元のシーンを再構築し、オフにすると被写体を単色背景に配置します;Additional Prompt で服装、髪型、ライティングの保持を要求できます
- キャラクター / プロダクトのマルチアングル素材作成に最適:単一の画像から斜め横、高低アングル、またはよりタイトなクロップを生成できます
- 作者は限界を明記しています:H3 版の信頼できる角度範囲は Qwen 版より狭く、元の角度に近くなったり逆方向に回転したりすることがあり、背景の一貫性は角度と参考画像によって大きく変動します
使い方
- ComfyUI 0.44.0 以降が必要です;2 つのカスタムノードをインストールします:Qwen Multiangle Camera(3D カメラパネル)と H3 Camera Prompt Adapter(カメラ位置を編集指示に変換)
- 4 つのモデルファイルをダウンロードして対応するフォルダに配置します(H3 FL2VA 拡散モデル、Qwen3-VL テキストエンコーダ、P-H3-Image の VAE と LoRA)。P3_image_MultiangleCamera.json を開き、Load Image で参考画像を選択します
- カメラ位置と背景スイッチを調整して実行すると、結果は Save Animated WEBP によって output に保存されます;角度が正しくない場合は、隣接する水平 / 垂直角度を試すか、シードを変更してください;ステップ数は作者により提供されていません
リスクと制限
- 表示されている 3 枚の画像には生成パラメータがなく、他の 1 件のセンシティブレベルは非表示です;新しい視点の精度は未検証です
- ベースモデルタグは MOSS Image であるため、H3 ベースモデルでフィルタリングすると見逃されます;P-H3-Image は H3 コミュニティライセンス(地域制限あり)を引き継いでいます
- 2 つのノードパッケージと 4 つのモデルファイルに依存します;本項目は未実行です
注目すべき項目(2)
【B】Qwen 2.1 Character Sheet Builder - No LLM · pH3_CharSheet_v2.4_Basic
ワークフロー · ポート · 作者 AirbagGuy · 公開 11-05 02:18 · ダウンロード数 37
参考画像からマルチアングルのキャラクター設定図を生成する ComfyUI ワークフローです;このバージョンでは Qwen 2.1 版の参考ノードを P-H3-Image(Pruna の H3 画像版)に置き換え、背面視点と自動背景除去を追加しました。
推奨理由
- ポート:H3 シリーズ用であることを確認済み——このバージョンの baseModel は MiniMax H3 で、バージョン説明には「Made to be used with pH3」と記載されており、本文では Pruna H3 Image モデルが必要だと述べられています;作者は参考ノードの置き換えを除き、Q21 Version 2.1 Basic とほぼ同一であると述べているため、モデルページは依然として Qwen 2.1 と呼ばれており、otherBases の Qwen 2.1 は同じページの旧バージョンです
- このバージョンの差異:背面視点セクションを追加;作者は pH3 が透明チャンネルを出力しないと考えているため、背景除去ノードを追加し、autotrim サブグラフ内の alpha スイッチを削除しました;最後に RefMod 出力を接続しています
- キャラクター素材の準備に最適:出力されるマルチアングル画像は、参考画像、RefMod 素材、または LoRA データセットの起点として使用できます;LLM は不要で、各角度のプロンプトはプリセットテンプレートです
- モデルページの累計ダウンロード数は 2814 回、コメント数は 12 件で、主に Qwen 版で蓄積されたものです(注目度のみを示します)
使い方
- qwen21CharacterSheet_ph3CharsheetV24Basic.json をインポートします;P-H3-Image モデル、作者の AutoTrim ノード(GitHub AirbagGuy/ComfyUI-AirbagGuyAutoTrim)が必要で、保存には KJ のノードを使用します
- Step 1 でメイン参考画像を Primary Image に配置します(最大 4 枚、それ以上は手動でルーティングサブグラフに接続する必要があります);Step 2 で Prompt Templates に参考画像の数を設定し、スタイル、表情、頭部 / 身体の変更を記入します;Step 3 でモデル読み込み、サイズ、シードを調整します
- ステップ数、サンプリングパラメータは作者により調整が必要とされており、推奨値は提供されていません
リスクと制限
- 作者は急ぎで作成したものと自称しています:末尾の RefMod 部分は未テストで、VAE が誤って接続されている可能性があります;H3 が白背景を出力する際はよく影が付随し、autotrim のトリミングが無効になることがあります
- バージョン番号の不整合:ファイル名は v2.4 ですが、説明には Version 2.3 - pH3 Basic と記載されています
- 表示されている例は 1 枚のみで、他の 4 件のセンシティブレベルは非表示です;本項目は未実行です
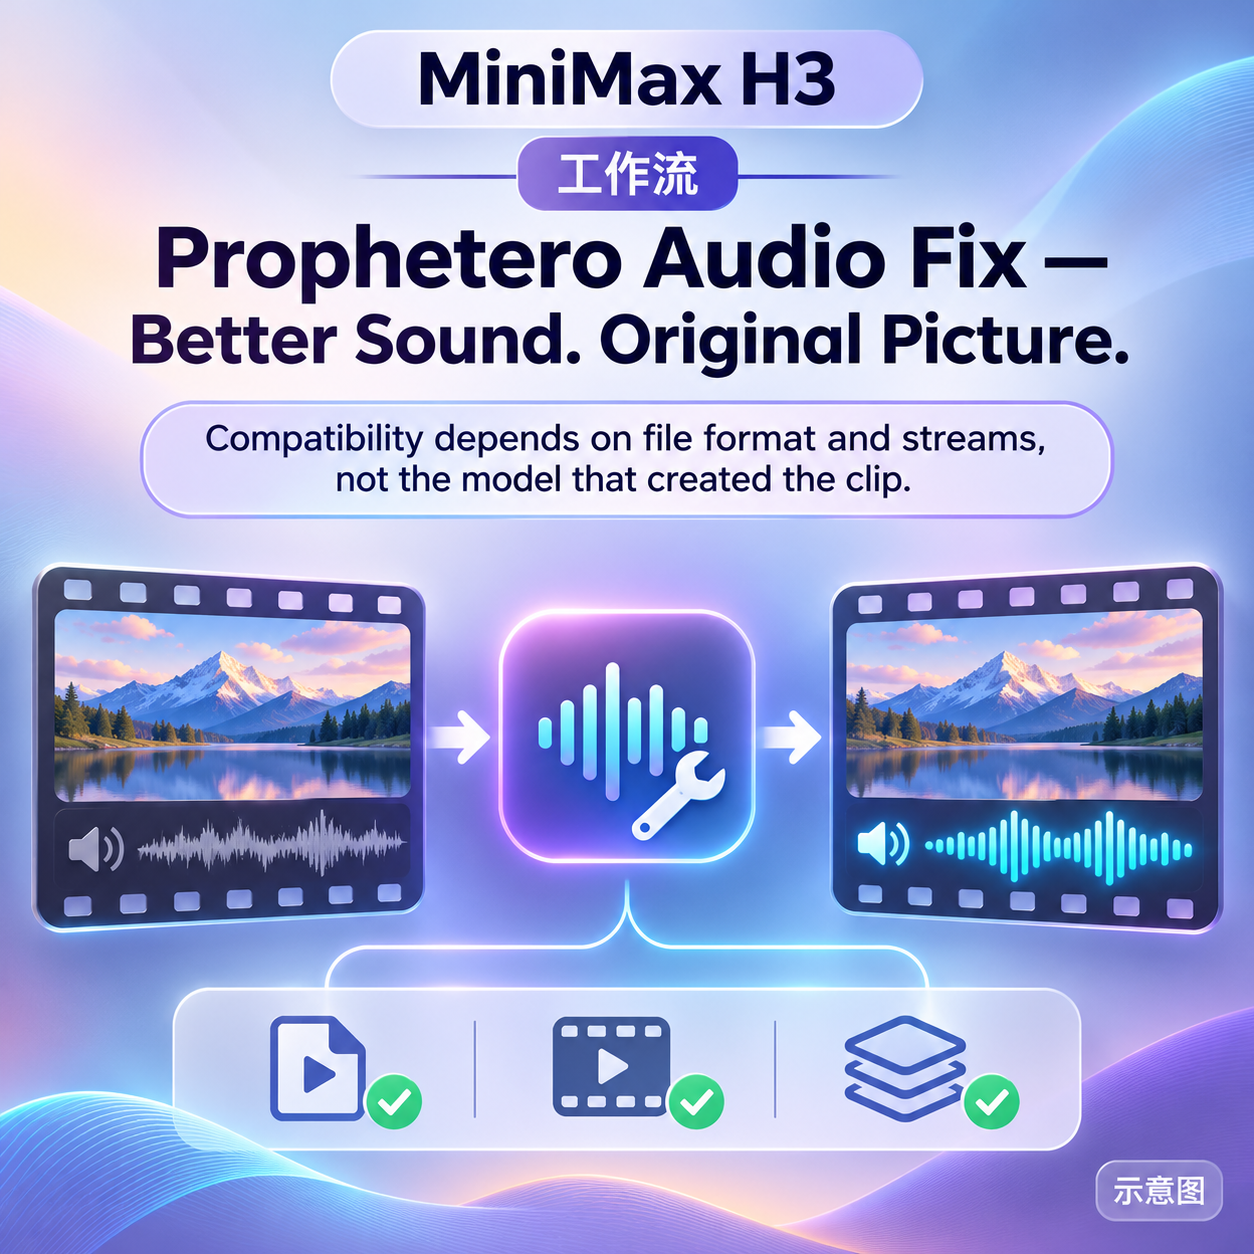
【B】Prophetero Audio Fix — Better Sound. Original Picture. · v0.3.0
ワークフロー · バージョン更新 · 作者 Prophetero · 公開 11-04 23:02 · ダウンロード数 35
映像を再エンコードせず、音声トラックのみを処理する ComfyUI 音声修正ツールです;0.3.0 版では時間範囲指定による部分的な修正が追加されました:同一動画または外部の音声 / 映像クリップによる置換、ミュート、減衰、ゲイン調整が可能です。
図解
推奨理由
- バージョン更新:0.1.0 と比較して、独立した選択範囲修正ワークスペースが追加され、同一動画 / 外部「ドナー」音声による置換、部分的なミュート、減衰、部分的なゲイン調整(-36 から +24 dB)に対応しています
- 最大 50 個の名前付き修正セグメント、各セグメント 0.02〜30 秒、個別にオン / オフ可能で、20 ステップの取り消し機能があります;レベル / 質感に基づいて近似した 3/5/8 個の候補ドナークリップを推薦し、試聴できます
- 映像ストリームは直接コピーされ、ハッシュ検証が行われ、元動画は変更されません;すべての修正は一括処理され、音声は最後に一度だけ AAC エンコードされます;同じ位置での前後比較プレビューと JSON プロジェクトの保存 / 読み込み機能があります
- H3 に限定されません:LTX、他の生成器、カメラで撮影した動画にも使用できます;無料で、生成モデルや GPU は不要です
使い方
- propheteroAudioFixBetter_v030.zip 全体を解凍し、START_HERE.cmd を実行して、実際に使用している ComfyUI バックエンドを選択します(SwarmUI の場合はその ComfyUI バックエンドを選択)。インストール後、バックエンドを完全に再起動します
- Prophetero_Audio_Fix_GLOBAL.json を開き、まず短いクリップで比較プレビューを行い、その後 Run/Queue で全動画をエクスポートします;出力は output/Prophetero/AudioFix/Final にあります
リスクと制限
- 表示されている例はありません(1 件のセンシティブレベルは非表示);作者は実際のブラウザでの受け入れテストと複数の障害時の試聴テストがまだ完了しておらず、自動修正を保証しないことを明記しています
- インストーラーは Windows 向けで、FFmpeg などに依存します;1 つの動画ストリーム + 1 つのモノラル / ステレオ音声トラックのみをサポートします
- H3 専用ツールではなく、単に H3 ベースモデルの下に配置されているだけです;ソフトウェアの転売には別途許可が必要です;本項目は未実行です
- カードの図解は AI 生成の概念図であり、モデルの実際の効果ではありません;作者には公開されている一般レベルの例がありません
収録のみ(3)
- Mira Thistlewhisk · v1.0 H3 — LoRA:オリジナルのネズミ耳キャラクター Mira Thistlewhisk の H3 キャラクター LoRA、トリガーワードは miralora。
- Minnie Belwyn · MiniMaxH3 — LoRA:架空の女性キャラクター Minnie Belwyn の H3 人物 LoRA、作者は実在の人物に対応しないことを宣言しています。
- SERENA Belrose · MiniMaxH3 — LoRA:架空の女性キャラクター Serena Belrose の H3 人物 LoRA、作者は実在の人物に対応しないことを宣言しています。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-04 21:00 → 11-05 09:00(北京時間)、バックフィル期間。推奨理由は編集者によるレビュー済み;ダウンロード数は注目度のみを示します。