진진의 AI 레이더 · MiniMax H3 · 2026-11-05 모닝 브리프
이번 호의 10개 새로운 버전: 강력 추천 0 · 추천 5 · 주목할 만함 2 · 단순 수록 3
편집자 주 이번 호에서는 10개의 H3 새로운 버전을 검토했습니다. 첫 번째 추천은 H3MD Director 0.3입니다: 오픈 소스 노드 팩과 워크플로우를 통해 H3로 한 번에 2–3분 길이의 긴 영상을 생성하며, 롱 테이크의 경우 각 세그먼트가 이전 세그먼트의 마지막 latent에서 이어져 생성되고, 스토리보드에 따라 하드 컷으로 전환할 수도 있지만, 공개된 예시는 1장뿐이므로 A등급으로 평가했습니다. A등급에는 Ref2VA를 정지 프레임 생성기로 사용하는 Image Studio, P-H3-Image 텍스트-이미지 생성/참조 편집 워크플로우, LongForge 7.6(내보내기 시 전체 영상에 대해 RTX 초해상도, 프레임 보간, HDR 적용), 그리고 단일 이미지 카메라 각도 변경 워크플로우가 포함됩니다. P-H3 버전의 캐릭터 시트 워크플로우와 오디오 트랙만 수정하는 오디오 수리 도구는 B등급으로, 세 가지 인물/캐릭터 LoRA의 설명이나 공개된 예시가 부족한 것은 C등급으로 평가했습니다.
추천 (5)
【A】Minimax H3 Image Studio 4k+ · v1.0
워크플로우 · 신규 모델 · 저자 Hopik65 · 게시일 11-04 21:46 · 다운로드 수 75
H3의 Ref2VA 비디오 모델을 정지 프레임 생성기로 사용하는 ComfyUI 워크플로우입니다: 텍스트로 이미지를 생성하거나, 최대 9장의 참조 이미지를 사용하여 이미지를 생성할 수 있으며, 선택적으로 SeedVR2를 사용하여 4096px까지 디테일한 업스케일링을 수행할 수 있습니다.
추천 이유
- 신규 모델(워크플로우): Pika H3 Flex Turbo LoRA를 사용하여 8단계 샘플링을 수행하고, 디코딩된 프레임 중 최상의 프레임을 자동으로 선택합니다. 참조 이미지 스위치를 끄면 순수 텍스트-이미지 생성이 됩니다.
- 캐릭터/장면 일관성이 필요한 정지 프레임에 적합: 최대 9장의 참조 이미지를 사용하며, 각 이미지는 개별 그룹으로 묶여 개별적으로 음소거(mute)할 수 있습니다.
- 저자가 의존성을 명확히 기재했습니다: 확산 모델, 텍스트 인코더, VAE, Turbo LoRA의 파일 이름과 Hugging Face 링크, 그리고 설치해야 할 커스텀 노드 팩을 포함합니다.
- 6장의 공개된 예시 이미지; 무료이며 라이선스가 관대함(판매 허용); 75회 다운로드(관심도만 반영)
사용 방법
- minimaxH3ImageStudio_v10.json을 가져오세요. Text (Prompt) 노드에서 장면, 주체, 조명, 스타일을 작성하되, 카메라 앵글이나 소리는 작성하지 마세요.
- 참조 이미지 사용 시: 필요한 Ref Img 노드의 음소거를 해제하고 스위치를 true로 설정하세요. 참조 이미지를 사용하지 않으려면 Image Reference (On & OFF)를 false로 설정하세요.
- H3ImageResolutionPreset에서 비율과 해상도를 선택하세요: 기본값은 8MP이며, VRAM이 부족하면 4MP 또는 그 이하로 낮춘 후 SeedVR2로 업스케일링하세요. 업스케일링이 필요 없다면 SeedVR2 그룹을 음소거하세요.
- 모델: minimax_h3_ref2va_fp8_e4m3fn, qwen3vl_32b_minimax_h3_nvfp4_awq(텍스트 인코더), minimax_h3_video_vae_int8_convrot, pika_h3_flex_turbo_8step_hd_ref2va; 노드: ComfyUI-MiniMax-H3-Image-Studio, rgthree-comfy, comfyui-zip-ties, ComfyUI-SeedVR2_VideoUpscaler
리스크 및 제한 사항
- 의존성이 무거움: 확산 모델 33.3GB, 텍스트 인코더 14.9GB, Turbo LoRA 3.9GB; 저자는 RTX 3060에서 4K + SeedVR2로 한 장 생성하는 데 약 500–550초가 소요된다고 보고했습니다.
- PrunaAI 저장소의 VAE 파일 이름이 다르므로, 이름을 변경하거나 로더에서 수동으로 선택해야 합니다. Power Lora Loader의 PhotoReal LoRA는 직접 준비하거나 비활성화해야 합니다.
- 1개의 민감도 등급 예시가 숨겨져 있습니다; 화질은 검증되지 않았습니다; 이 항목은 실행되지 않았습니다.
【A】MiniMax P-H3 Image Generation & Reference Editing v1.0 (Anikin Labs) · v1.0
워크플로우 · 신규 모델 · 저자 Roman_Anikin · 게시일 11-05 02:46 · 다운로드 수 103
P-H3-Image의 ComfyUI 워크플로우입니다: 하나의 스위치로 텍스트-이미지 생성과 참조 이미지 편집(최대 두 장의 참조 이미지)을 전환할 수 있으며, PrunaAI의 W4A8 양자화 모델과 사전 설정된 8단계 sigma 테이블을 사용합니다.
추천 이유
- 이름의 P-H3은 P-H3-Image를 의미합니다: PrunaAI가 MiniMax H3을 미세 조정한 텍스트-이미지 생성/이미지 편집 모델(Hugging Face 모델 카드는 MiniMax-H3 기반이며 H3 커뮤니티 라이선스를 따름을 명시)이므로 이 섹션에 속하지만, 출력은 비디오가 아닌 정지 이미지입니다.
- 신규 모델(워크플로우): 텍스트-이미지 생성과 참조 편집이 동일한 인터페이스에 있으며, 해상도를 조정할 수 있고, 자체적인 8단계 커스텀 sigma 스케줄링을 포함합니다.
- 세 가지 필수 모델 파일과 다운로드 저장소가 모두 나열되어 있으며, 단계가 명확합니다; 3장의 공개된 예시 이미지.
- 무료; 103회 다운로드, 9개 좋아요(관심도만 반영)
사용 방법
- Hugging Face의 PrunaAI/P-H3-Image-Comfy에서 p-h3-image_w4a8.safetensors(확산 모델), p-h3-image_text_encoder_w4a8.safetensors(텍스트 인코더), p-h3-image_vae_int8_convrot.safetensors(VAE)를 다운로드하세요.
- minimaxPH3ImageGeneration_v10.json을 가져와 스위치로 모드를 선택하세요. 참조 편집 시 1–2장의 참조 이미지를 로드하세요.
- 사전 설정된 8단계 sigma 테이블은 변경하지 마세요(저자는 익숙하지 않으면 변경하지 말라고 경고합니다); CFG, 샘플러, 필요한 커스텀 노드는 저자가 제공하지 않았습니다.
리스크 및 제한 사항
- P-H3-Image는 자체 라이선스와 지역 제한이 있으며, 저자는 미국, EU, 영국, 한국 사용자가 공식 라이선스를 먼저 확인하도록 경고합니다.
- Hugging Face 페이지에는 VRAM 요구 사항이 21GB부터 시작한다고 명시되어 있습니다.
- 2개의 민감도 등급 예시가 숨겨져 있습니다; 이 항목은 실행되지 않았습니다.
【A】MiniMax H3 LongForge FL2VA & REF2VA (LONG VIDEO) · LongForge v7.6
워크플로우 · 버전 업데이트 · 저자 AIBOB1199 · 게시일 11-05 05:48 · 다운로드 수 104
장면별로 H3 긴 영상을 오디오가 포함된 완성본으로 만드는 ComfyUI 워크플로우 키트(자체 노드 팩과 RefMod Studio 포함)로, 7.6버전에서는 내보내기 시 전체 영상에 대해 NVIDIA RTX 초해상도, 프레임 보간, HDR을 추가했습니다.
추천 이유
- 버전 업데이트(20번째 버전): 내보내기 시 전체 영상에 대해 Super Resolution → Frame Generation → HDR 순서로 처리할 수 있으며, 세 가지를 개별적으로 또는 조합하여 활성화할 수 있습니다. 원본 take와 latent은 보존되며, 프레임 보간은 길이와 오디오를 변경하지 않습니다.
- 참조 자료(이미지/비디오/오디오 카드)를 드래그하여 정렬할 수 있으며, 순서는 워크플로우와 함께 저장됩니다. 메인 워크플로우가 재배치되었으며, 세 개의 RTX 스위치가 21 · RTX Export에 집중되어 있습니다.
- FL2VA / REF2VA 다중 장면 장편 영상에 적합: 프롬프트, take 선택, 편집부터 HQ 업스케일링까지 하나의 프로세스로 처리하며, 워크플로우에 러시아어/영어 이중 언어 설명이 내장되어 있습니다.
- 모델 누적 다운로드 수 10202회, 이 버전 게시 후 4시간 만에 104회(관심도만 반영)
사용 방법
- minimaxH3LongforgeFL2VA_longforgeV76.zip을 압축 해제하고, 자체 Node Pack을 설치한 후 FL2VA / REF2VA 메인 워크플로우를 여세요.
- RTX 효과를 사용하려면: ComfyUI Nvidia VFX Nodes 및 그 의존성을 별도로 설치하고, 21 · RTX Export에서 필요한 효과를 활성화하세요(기본값은 모두 꺼짐). 이미지 입력은 비워두고 EXPORT FILM을 실행하세요.
- RTX 프레임 보간 사용 시 Export Settings의 Frame interpolation ×를 1로 설정하여 RIFE/FILM과 중첩되지 않도록 하세요. Specific timestep 모드는 ×2 FPS입니다.
- 필요한 H3 모델과 샘플링 매개변수는 워크플로우 내장 설명에 기재되어 있으며, 이 항목에서는 개별적으로 확인하지 않았습니다.
리스크 및 제한 사항
- 저자가 업데이트 노트를 작성하지 않았습니다: 버전 설명란이 비어 있으며, 변경 사항은 모델 카드의 '7.6 신규 추가' 섹션에만 기재되어 있습니다.
- 공개된 예시 이미지는 1장뿐입니다(생성 매개변수 없음). 다른 5개의 민감도 등급은 숨겨져 있습니다. 완성본을 보지 않았으므로 화질은 검증되지 않았습니다.
- RTX 효과는 NVIDIA 그래픽 카드와 추가 노드 팩이 필요하며, 메모리에 따라 배치 처리합니다. 저자는 먼저 짧은 장면과 하나의 효과로 테스트할 것을 권장합니다. HDR에서 H264를 선택하면 자동으로 HEVC로 변경됩니다.
- 의존성이 많고 업데이트가 빠릅니다(일주일 내에 7.3–7.6 네 개의 버전을 연속 출시). 이 항목은 실행되지 않았습니다.
【A】H3MD Director 0.3 – 2–3 min long videos with MiniMax H3 (simple workflow + Control Panel) · v0.3.3
워크플로우 · 신규 모델 · 저자 1113800942188 · 게시일 11-05 05:42 · 다운로드 수 51
오픈 소스 ComfyUI 노드 팩 + 워크플로우로, MiniMax H3를 사용하여 한 번에 2–3분 길이의 긴 영상을 생성합니다: 원테이크 롱 테이크로 생성하거나, 스토리보드에 따라 세그먼트별로 생성할 수 있습니다.
이번 호의 LongForge 신버전과 마찬가지로 긴 영상 솔루션입니다: H3MD는 한 번에 실행하고 패널이 간결한 편이며, LongForge는 장면별로 take를 선택하고 편집 및 내보내기 후처리에 중점을 둡니다.
추천 이유
- 신규 모델 페이지(프로젝트 지속): 이전 버전 v0.1.1은 다른 페이지에 있었으며, 이 페이지의 노드 팩 0.3.3에는 Control Panel과 간소화된 워크플로우, 'which segments'로 지정된 세그먼트만 재실행, 솔루션과 자료의 패키지 내보내기/가져오기, 저장 시 드리프트 보정, 그리고 T8 시맨틱 브리지와 SeedVR2 얼굴 수정 지원이 새로 추가되었습니다.
- 롱 테이크: 각 세그먼트는 이전 세그먼트의 마지막 1.6초 latent에서 이어져 생성되므로 움직임과 카메라 워크가 끊기지 않습니다. 하드 컷도 가능하며, 새로운 샷은 자신의 참조 이미지에서 다시 시작하여 드리프트가 누적되지 않습니다.
- Director 패널은 샷별 길이, 프롬프트, 참조 이미지, 오디오 잠금을 계획합니다. 저자는 립싱크가 포함된 MV, 모션 트랜스퍼(depth + SAM3), 텍스트-비디오 생성을 지원하며, 긴 영상은 1080P까지 가능하고 저 VRAM/블록 옵션을 제공한다고 주장합니다.
- 무료 오픈 소스(AGPL-3.0)이며, GitHub에 문서, 모델 표, 프롬프트 가이드가 있고, YouTube에 설치 튜토리얼이 있습니다.
사용 방법
- ComfyUI 0.43 이상 필요(H3 네이티브 지원); ComfyUI Manager에서 H3MD Director 검색 또는 GitHub 저장소를 custom_nodes에 클론
- 압축 파일의 H3MD Director simple.json을 캔버스에 드래그하여 시작; Control Panel에서 크기, fps / 프레임 보간, 얼굴 수정, 시드, 스타일 버튼(Balanced / High motion / Motion copy) 및 고해상도 / 저해상도 LoRA 목록 설정
- which segments에 1 입력하여 첫 번째 구간만 테스트하고, 만족 시 비운 후 전체 렌더링(완료된 구간은 캐시에서 가져옴)
- 구체적인 모델 파일과 스텝 수는 GitHub의 모델 표에 있으며, 모델 카드에는 나열되지 않음
리스크 및 제한 사항
- 공개된 예시는 1장의 이미지뿐(생성 파라미터 없음)이며, 다른 3개의 민감도 등급은 숨겨져 있음; 모델 카드에 언급된 예시 MV는 이 페이지에서 확인할 수 없고, “2–3분 만에 한 번에 실행”은 저자의 주장임
- 선택적 구성 요소가 많음(SeedVR2 / VOSR2 얼굴 수정, depth + SAM3 모션 전이)으로, 긴 영상의 소요 시간과 VRAM 요구 사항은 모델 카드에 명시되지 않음
- AGPL 라이선스로 파생 작품의 오픈 소스화가 요구됨; 모델 카드에 RunningHub 홍보 링크가 포함됨; 본 항목은 실행되지 않음
【A】MiniMax H3 Multiangle Workflow for ComfyUI · v1.0
워크플로우 · 신규 모델 · 저자 ukr8b3g201 · 게시일 11-05 02:42 · 다운로드 수 52
참고 이미지의 카메라 각도를 변경하는 ComfyUI 워크플로우: 3D 카메라 패널에서 수평각, 피치각 및 프레이밍을 조정한 후 H3에 전달하여 새로운 시점의 이미지를 생성합니다.
추천 이유
- 신규 모델(워크플로우): H3용임을 확인함—확산 모델은 MiniMax H3 FL2VA(프루닝된 INT8 버전)이며, 추가로 P-H3-Image의 VAE와 LoRA를 사용; Civitai의 기본 모델 태그는 MOSS Image로 잘못 표기됨
- Match Background View가 켜져 있으면 새로운 카메라 각도에 맞춰 원본 장면을 재구성하고, 꺼져 있으면 피사체를 단색 배경 위에 배치; Additional Prompt를 통해 의상, 헤어스타일, 조명 유지를 요청할 수 있음
- 캐릭터 / 제품용 다중 시점 소스 제작: 단일 이미지에서 3/4 측면, 고/저 각도 또는 더 타이트한 크롭을 생성
- 저자가 한계를 명시함: H3 버전의 신뢰할 수 있는 각도 범위는 Qwen 버전보다 좁으며, 때로는 원본 각도에 가깝거나 반대 방향으로 회전할 수 있고, 배경 일관성은 각도와 참고 이미지에 따라 크게 변동함
사용 방법
- ComfyUI 0.44.0 이상; 두 개의 커스텀 노드 설치: Qwen Multiangle Camera(3D 카메라 패널)와 H3 Camera Prompt Adapter(카메라 각도를 편집 지시로 변환)
- 네 개의 모델 파일을 다운로드하여 해당 폴더에 배치(H3 FL2VA 확산 모델, Qwen3-VL 텍스트 인코더, P-H3-Image의 VAE 및 LoRA)하고, P3_image_MultiangleCamera.json을 열어 Load Image에서 참고 이미지를 선택
- 카메라 각도와 배경 스위치를 조정한 후 실행하면, 결과는 Save Animated WEBP를 통해 output에 저장됨; 각도가 잘못되면 인접한 수평 / 수직 각도를 시도하거나 시드를 변경; 스텝 수는 저자가 제공하지 않음
리스크 및 제한 사항
- 3장의 공개된 이미지 모두 생성 파라미터가 없으며, 다른 1개의 민감도 등급은 숨겨져 있음; 새로운 시점의 정확도는 검증되지 않음
- 기본 모델 태그가 MOSS Image이므로, H3 기본 모델로 필터링하면 누락될 수 있음; P-H3-Image는 H3 커뮤니티 라이선스(지역 제한 있음)를 따름
- 두 개의 노드 패키지 + 네 개의 모델 파일에 의존; 본 항목은 실행되지 않음
주목할 만함 (2)
【B】Qwen 2.1 Character Sheet Builder - No LLM · pH3_CharSheet_v2.4_Basic
워크플로우 · 포팅 · 저자 AirbagGuy · 게시일 11-05 02:18 · 다운로드 수 37
참고 이미지 하나로 다중 각도 캐릭터 시트 이미지를 생성하는 ComfyUI 워크플로우; 이 버전은 Qwen 2.1 버전의 참고 노드를 P-H3-Image(Pruna의 H3 이미지 버전)로 교체하고, 후면 시점과 자동 배경 제거 기능을 추가했습니다.
추천 이유
- 포팅: H3 계열용임을 확인함—이 버전의 baseModel은 MiniMax H3이며, 버전 설명에 “Made to be used with pH3”라고 적혀 있고, 본문에서는 Pruna H3 Image 모델이 필요하다고 언급; 저자는 참고 노드 교체 외에는 Q21 Version 2.1 Basic과 거의 동일하다고 주장하므로, 모델 페이지 이름은 여전히 Qwen 2.1이며, otherBases의 Qwen 2.1은 동일 페이지의 이전 버전임
- 이 버전의 차이점: 후면 시점 구간 추가; 저자는 pH3가 투명 채널을 출력하지 않는다고 판단하여 배경 제거 노드를 추가하고, autotrim 서브그래프의 alpha 스위치를 제거; 끝에 RefMod 출력을 연결
- 캐릭터 소스 준비: 출력된 다중 시점 이미지는 참고 이미지, RefMod 소스 또는 LoRA 데이터셋의 시작점으로 사용 가능; LLM을 사용하지 않으며, 각 각도의 프롬프트는 사전 설정된 템플릿임
- 모델 페이지 누적 다운로드 2814회, 댓글 12개는 주로 Qwen 버전에서 축적된 것(관심도만 반영)
사용 방법
- qwen21CharacterSheet_ph3CharsheetV24Basic.json을 가져오기; P-H3-Image 모델, 저자의 AutoTrim 노드(GitHub AirbagGuy/ComfyUI-AirbagGuyAutoTrim)가 필요하며, 저장은 KJ의 노드를 사용
- Step 1에서 주요 참고 이미지를 Primary Image에 배치(최대 4장, 초과분은 수동으로 라우팅 서브그래프에 연결); Step 2에서 Prompt Templates에 참고 이미지 수량을 설정하고, 스타일, 표정, 머리 / 신체 수정 사항을 입력; Step 3에서 모델 로드, 크기 및 시드 조정
- 스텝 수, 샘플링 파라미터는 저자가 직접 조정하도록 하며 권장값을 제공하지 않음
리스크 및 제한 사항
- 저자가 급조한 작품이라고 스스로 밝힘: 끝부분의 RefMod 부분은 테스트되지 않았고, VAE가 잘못 연결될 수 있음; H3가 흰색 배경을 생성할 때 종종 그림자가 포함되어 autotrim 크롭이 실패할 수 있음
- 버전 번호 불일치: 파일 이름에는 v2.4로 적혀 있으나, 설명에는 Version 2.3 - pH3 Basic으로 적혀 있음
- 공개된 예시는 1장뿐이며, 다른 4개의 민감도 등급은 숨겨져 있음; 본 항목은 실행되지 않음
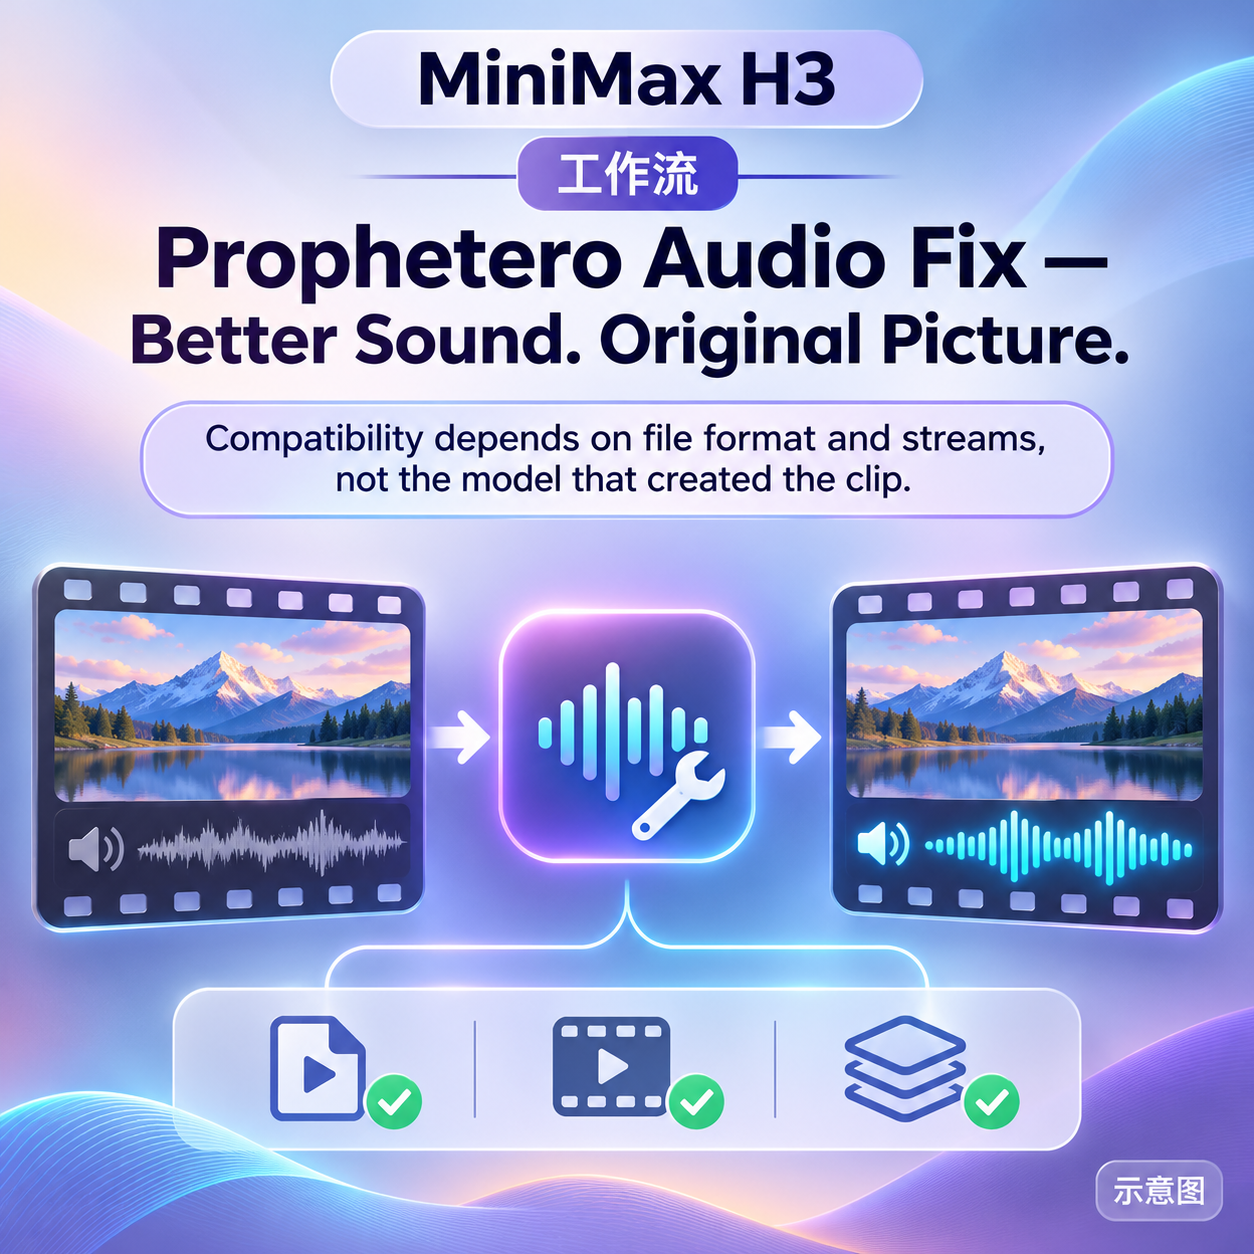
【B】Prophetero Audio Fix — Better Sound. Original Picture. · v0.3.0
워크플로우 · 버전 업데이트 · 저자 Prophetero · 게시일 11-04 23:02 · 다운로드 수 35
화면은 재인코딩하지 않고 오디오 트랙만 처리하는 ComfyUI 오디오 수정 도구; 0.3.0 버전에서는 시간 구간별 부분 수정 기능이 추가됨: 동일 영상 또는 외부 오디오/비디오 클립으로 교체, 음소거, 감쇠, 게인 조정 가능.
배경 이미지
추천 이유
- 버전 업데이트: 0.1.0 대비 독립적인 선택 영역 수정 워크스페이스가 추가되어, 동일 영상 / 외부 “공여” 오디오 교체, 부분 음소거, 감쇠 및 부분 게인(-36 ~ +24 dB)을 지원
- 최대 50개의 명명된 수정 구간을 지원하며, 각 구간은 0.02–30초이고 개별 토글이 가능하며, 20단계의 실행 취소 기능 제공; 레벨 / 질감 유사성에 따라 3/5/8개의 후보 공여 클립을 추천하여 미리 듣기 가능
- 화면 스트림은 직접 복사하고 해시 검증을 수행하여 원본 영상을 변경하지 않음; 모든 수정은 일괄 처리되며, 오디오는 최종적으로 한 번만 AAC 인코딩됨; 동일 위치의 전후 비교 미리보기와 JSON 프로젝트 저장/불러오기 기능 제공
- H3에 국한되지 않음: LTX, 다른 생성기, 카메라로 촬영한 영상 모두 사용 가능; 무료이며 생성 모델이나 GPU가 필요 없음
사용 방법
- propheteroAudioFixBetter_v030.zip 전체를 압축 해제하고, START_HERE.cmd를 실행하여 실제로 사용하는 ComfyUI 백엔드를 선택(SwarmUI의 경우 해당 ComfyUI 백엔드 선택), 설치 후 백엔드를 완전히 재시작
- Prophetero_Audio_Fix_GLOBAL.json을 열고, 먼저 짧은 클립으로 비교 미리보기를 한 후 Run/Queue를 통해 전체 영상을 내보냄; 출력은 output/Prophetero/AudioFix/Final에 저장됨
리스크 및 제한 사항
- 공개된 예시 없음(1개의 민감도 등급은 숨겨져 있음); 저자는 실제 브라우저에서의 검수 및 다중 장애 미리 듣기 테스트가 아직 완료되지 않았으며, 자동 수정을 보장하지 않는다고 명시함
- 설치 프로그램은 Windows용이며, FFmpeg 등에 의존; 하나의 비디오 스트림 + 하나의 모노 / 스테레오 오디오 트랙만 지원
- H3 전용 도구가 아니며, 단순히 H3 기본 모델 하위에 등록되어 있을 뿐; 소프트웨어 재판매 시 별도의 허가가 필요; 본 항목은 실행되지 않음
- 카드의 배경 이미지는 AI 생성 개념도이며, 모델의 실제 효과가 아님; 저자에게 공개된 일반 등급의 예시가 없음
최소한으로 수록 (3)
- Mira Thistlewhisk · v1.0 H3 — LoRA: 오리지널 마우스 걸 캐릭터 Mira Thistlewhisk의 H3 캐릭터 LoRA, 트리거 워드는 miralora.
- Minnie Belwyn · MiniMaxH3 — LoRA: 가상의 여성 캐릭터 Minnie Belwyn의 H3 인물 LoRA, 저자는 실제 인물을 나타내지 않는다고 선언.
- SERENA Belrose · MiniMaxH3 — LoRA: 가상의 여성 캐릭터 Serena Belrose의 H3 인물 LoRA, 저자는 실제 인물을 나타내지 않는다고 선언.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수록 기간 11-04 21:00 → 11-05 09:00(베이징 시간), 백필 기간. 추천 이유는 편집 검수를 거쳤음; 다운로드 수는 관심도만 반영.