貞貞のAIレーダー · Qwen Image 2.1 · 2026-11-15 夕刊
今号の新バージョンは 4 件:強く推奨 0 · 推奨 1 · 注目すべき 3 · 収録のみ 0
編集者按語 今号では Qwen 2.1 の新バージョンを 4 件レビューし、A評価が 1 件、B評価が 3 件でした。初推めは Qwen Image 2.1 Ultimate 12GB ワークフローです:ドロップダウンメニュー1つで 2K テキストから画像生成、1〜3枚の画像編集、背景除去による透明PNG出力、そして3種類の Fun ControlNet を切り替えられ、コアノードのみを使用します。本バージョンは説明文のみを改訂し、グラフ構造は変更されていませんが、自動評価SからAへ降格しました。同じ作者による 40 ステップ / Turbo デュアルパスのテキストから画像生成ワークフローも同様に説明文のみを変更したため、Bへ降格しました。Yennefer キャラクター LoRA の Qwen 2.1 版は再訓練後にトリガーワードと完全なサンプルプロンプトを備えていますが、著作権キャラクターであるためSからBへ降格しました。人物のポーズを線画に変換する編集用LoRAは使い方が明確ですが、目に見えるサンプルがないためB評価としました。
推奨(1)
【A】Qwen Image 2.1 Ultimate 12GB — Turbo 8-step 2K T2I + Edit 1-3 Images + Remove Background + Fun ControlNet Pose/Depth/Canny · v2.1.1
ワークフロー · バージョン更新 · 作者 The_frizzy1 · 公開日 11-15 20:21 · ダウンロード数 8
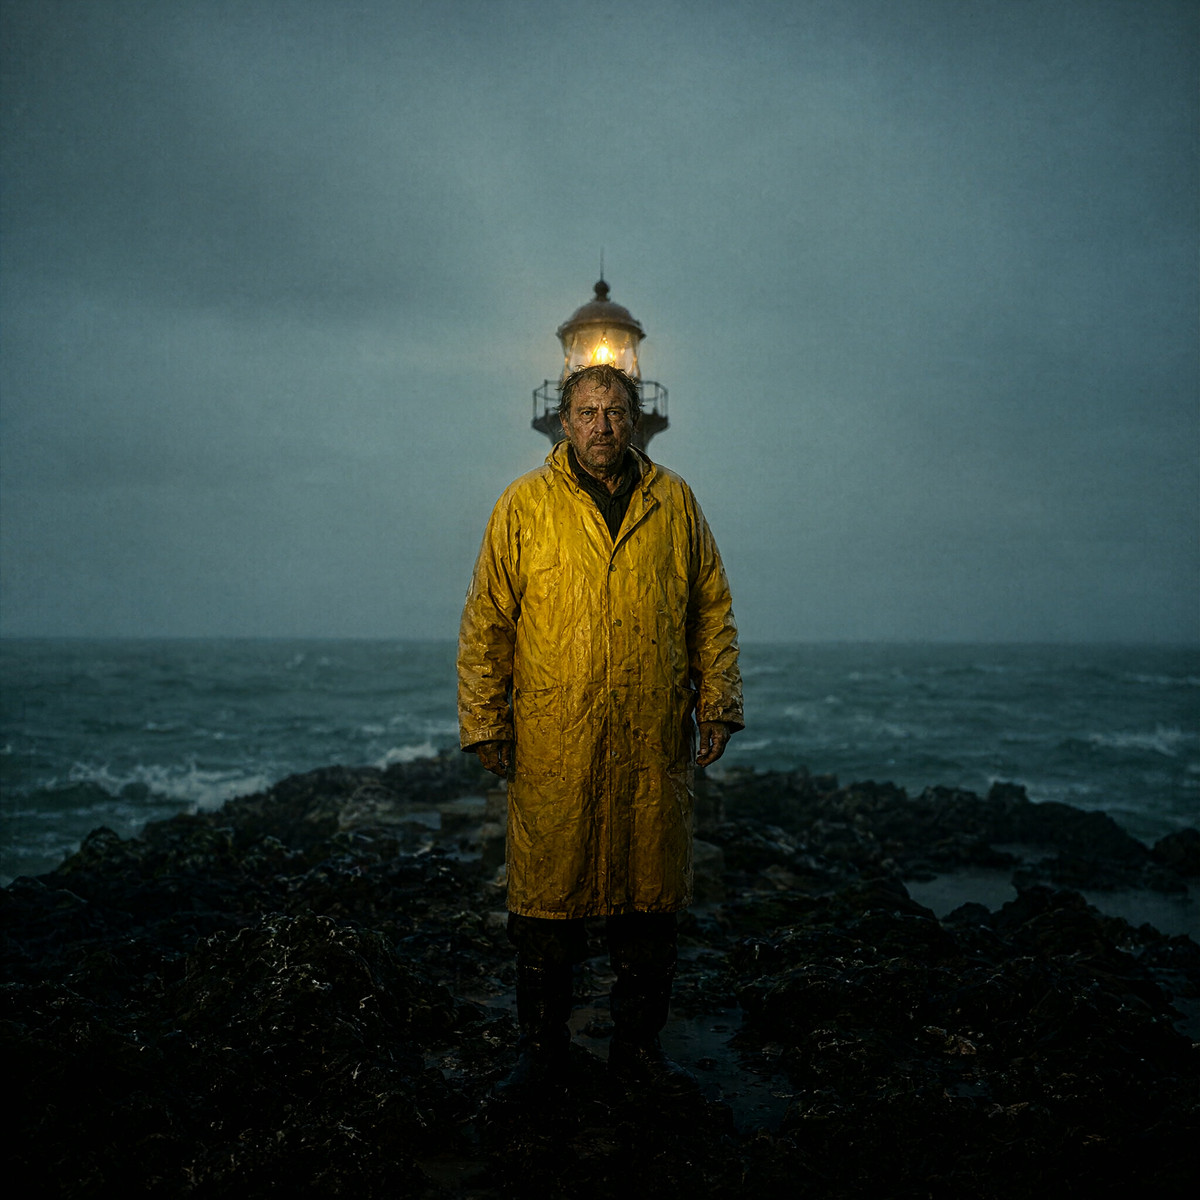
Qwen Image 2.1 のすべてのモードを1つのワークフローに統合しました:ネイティブ 2K テキストから画像生成、自分の画像 1〜3枚を用いた編集、背景除去による透明PNGの直接出力、Fun ControlNet によるポーズ / 深度 / エッジ制御。デフォルトでは 8 ステップの Turbo を使用し、コアノードのみで構成されています。
画像付き説明
推奨理由
- バージョン更新:v2.1.1 では「使い方」の説明(入力、設定、コツ、アテンションパラメータ、テスト環境)のみを改訂し、ダウンロード手順の位置を移動しました。作者によればグラフ構造は変更されていません。
- テキストから画像生成、部分編集、EC向け切り抜き、ポーズ / 深度 / 線画による制御に対応:Mode ドロップダウンメニューで切り替え可能。入力はデフォルトでバイパスされており、開くだけでテキストから画像生成を実行できます。
- 再現性が高い:作者は各ファイル名、サイズ、配置ディレクトリを明記し、12 GB VRAM環境での Turbo 2K 時のピークメモリ使用量が 11.6 GB であることを示しています。目に見えるサンプルが 20 枚あります。
使い方
- ComfyUI バージョン 0.38 以上が必要(Apply Fun ControlNet はすでにコアノードです)。テキストから画像生成と編集には、Turbo モデル、qwen3vl_8b テキストエンコーダー、VAE の3つのファイルをダウンロードする必要があります。
- Turbo はデフォルトでオン、8 ステップです。Turbo をオフにすると 40 ステップのベースモデルを使用します。編集時は Image 1(オプションで 2、3)を接続し、プロンプト内で参照してください。
- ControlNet モードでは、Fun ControlNet、SDPose、Lotus 深度などのファイルを別途ダウンロードする必要があります。
リスクと制限
- 本バージョンは説明文のみを変更しているため、v2.1.0 をインストール済みのユーザーは更新不要です。
- 作者によれば、ControlNet はネイティブ 2K ではエラーが発生するため、ControlNet の解像度を 1 MP に保つ必要があります。
- Qwen Image 2.1 と Turbo は Qwen Research License の下で提供されており、非商用利用です。
注目すべき(3)
【B】Witches: Yennefer cosplay | MOSS / Krea 2 /Qwen 2.1 · v2.0 Qwen 2.1
LoRA · バージョン更新 · 作者 bazya022020810 · 公開日 11-15 18:26 · ダウンロード数 13
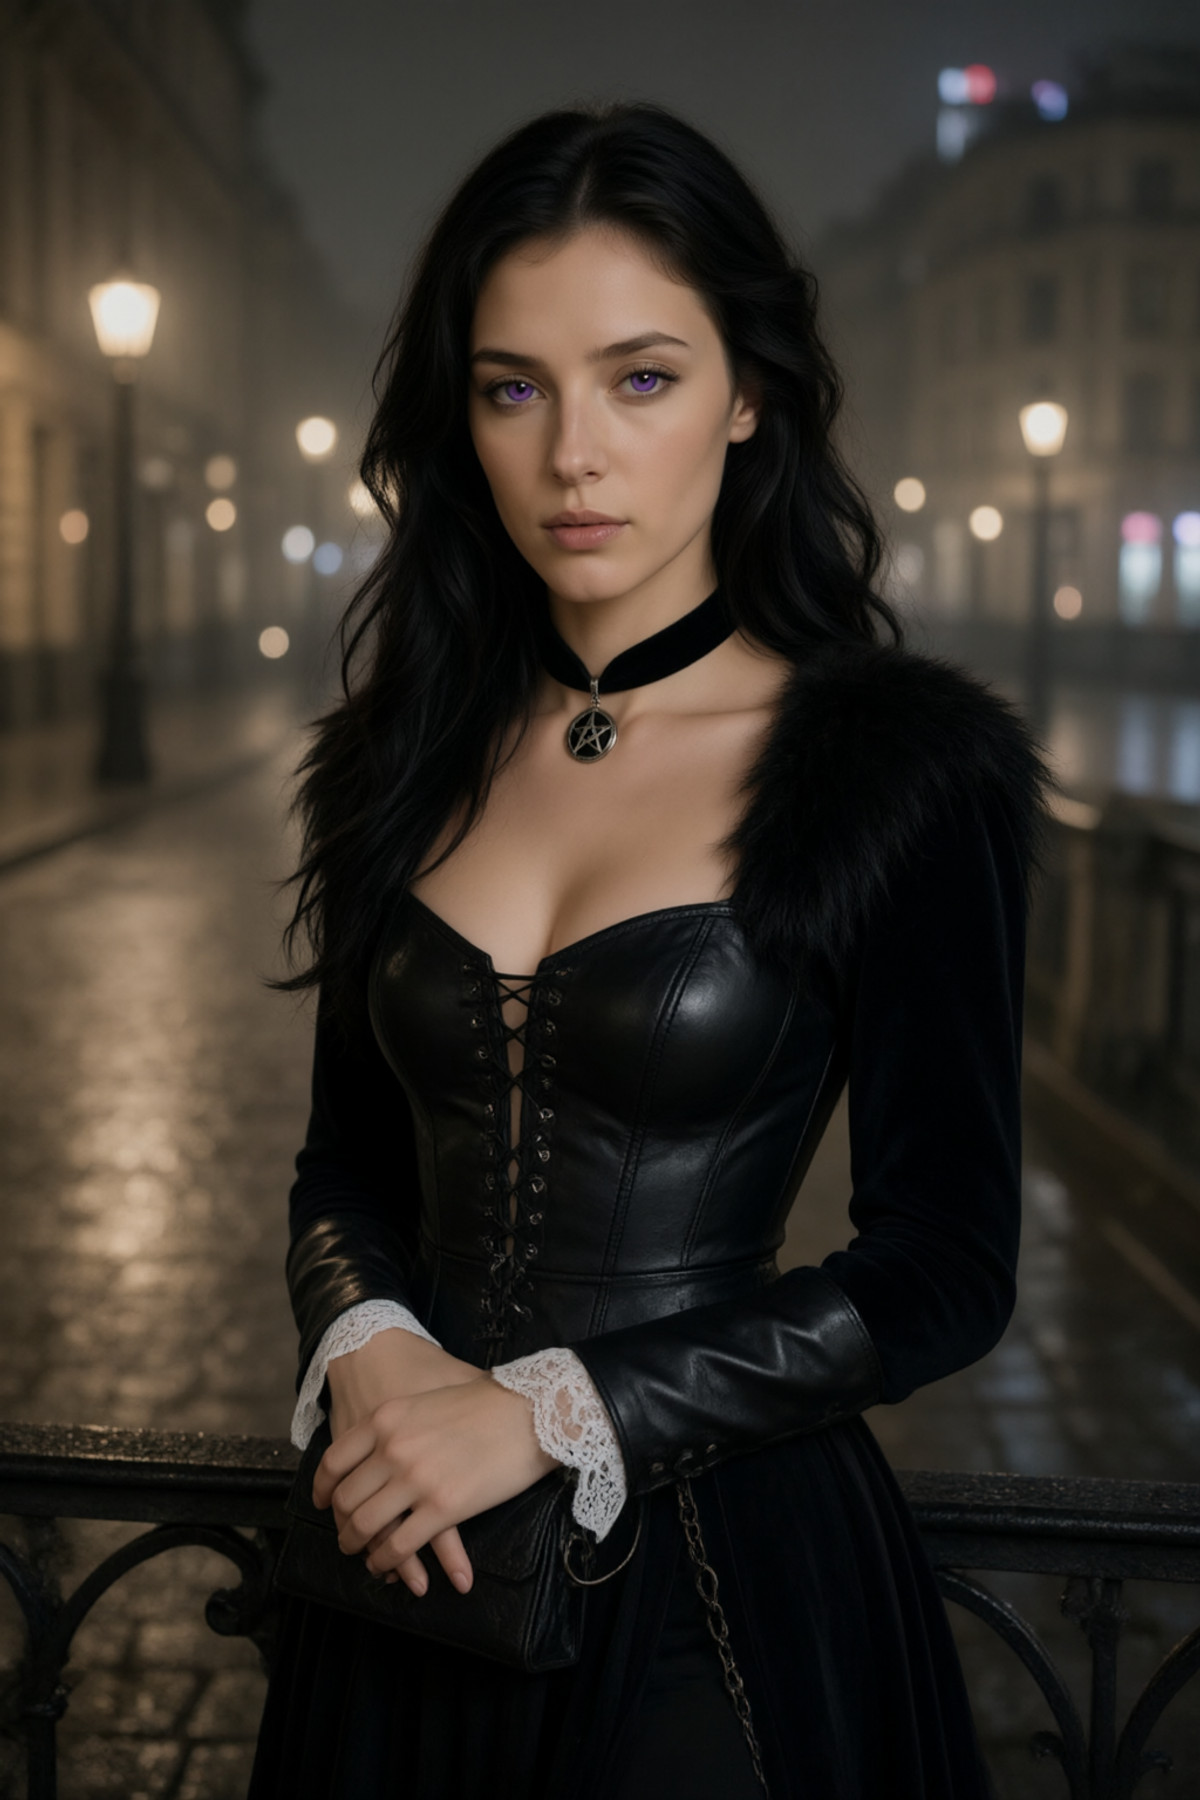
『ウィッチャー』のイェネファーのコスプレキャラクターLoRAの Qwen 2.1 版です:トリガーワードを追加すると、クラシックな黒革のコルセット、ファーカラー、星形のチョーカーのスタイルが生成されます。トリガーワードなしでは任意の服装に変更でき、顔、黒い巻き毛、紫色の目は一貫して保持されます。
画像付き説明
推奨理由
- v2.0 で再訓練:作者によれば v1.0 では顔の一貫性と服装変更が不十分だったため、v2.0 では新しい 55 枚のデータセットでゼロから訓練されました。
- 使い方が詳細に記載されています:トリガーワード
yenoutfitをプロンプトの先頭に置くとクラシックな服装が生成され、省略して望む服装を記述すれば服装変更が可能です。トリガーワードあり / なしの2つの完全なサンプルプロンプトが提供されています。 - 同シリーズには MOSS と Krea 2 版もあり、本項目は Qwen 2.1 ベースモデルです。
使い方
- 強度は 0.85〜1.0。クラシックなスタイルではプロンプトの先頭に
yenoutfitを記述し、服装変更時はトリガーワードを削除して服装を明記します。 - 作者は、キャラクターと矛盾する髪色や瞳色をプロンプトに書かないよう注意を促しています。
リスクと制限
- 作者は更新説明を記載していません(再訓練情報はモデルカードの本文にあります)。
- 『ウィッチャー』の著作権キャラクターであり、ライセンスでは派生作品が許可されていません。目に見えるサンプルは 3 枚、非表示が 4 枚で、ページは混合コンテンツです。
トリガーワード:yenoutfit,
【B】Qwen Image 2.1 12GB — int8 Native 2K Text to Image, 40-step QUALITY + Viggle 6-step TURBO LoRA · v2.0.1
ワークフロー · バージョン更新 · 作者 The_frizzy1 · 公開日 11-15 20:17 · ダウンロード数 6
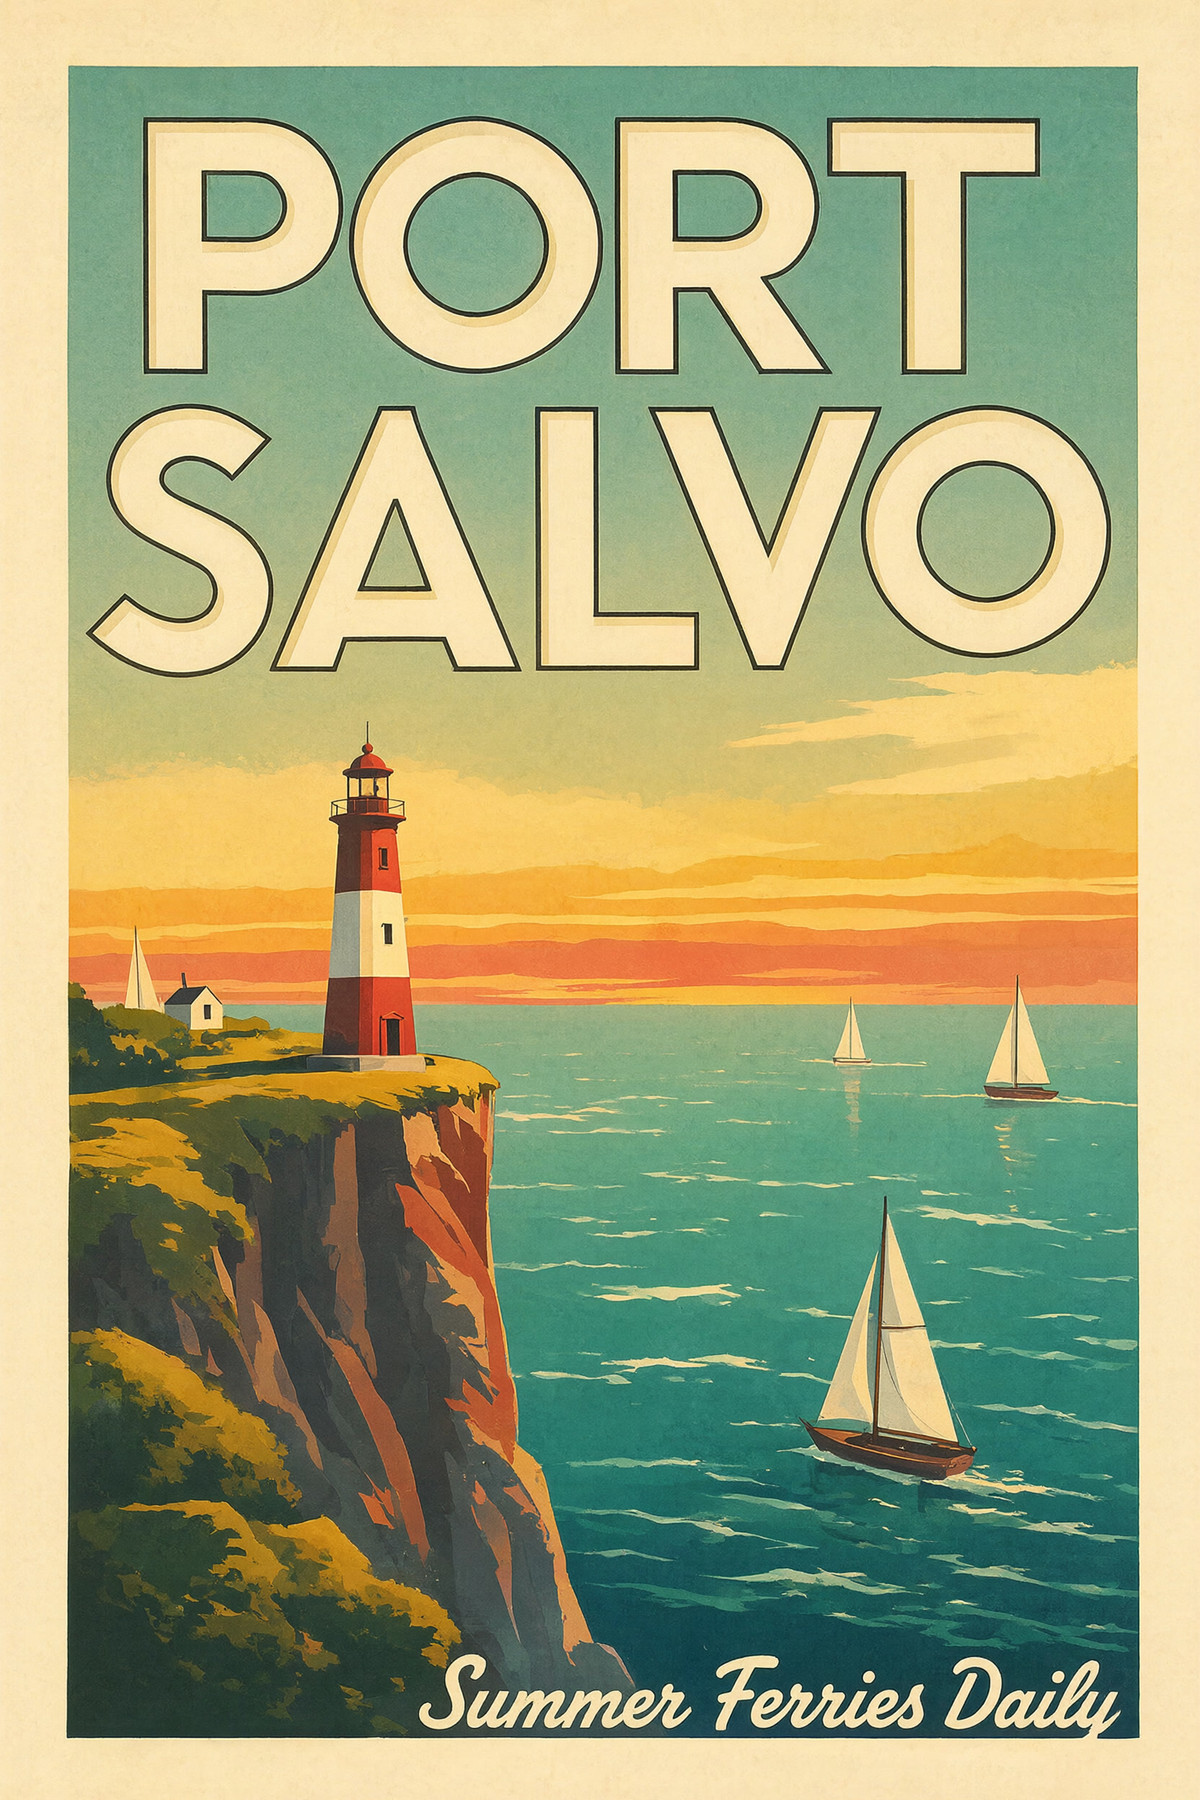
12 GB のGPUで Qwen Image 2.1 のネイティブ 2K テキストから画像生成を実行するワークフローです。1つのグラフ内に2つのパスがあります:40 ステップの QUALITY パスと、Viggle の 6 ステップ Turbo LoRA を使用した TURBO パス。コアノードのみを使用します。
画像付き説明
推奨理由
- バージョン更新:v2.0.1 では「使い方」の説明(各入力、TURBO への切り替え方法、重要な設定、テスト環境)のみを改訂し、ダウンロード手順は句読点のみ変更しました。作者によればグラフ構造は変更されていません。
- 12 GB のカードで 2048×2048 のテキストから画像生成を行い、かつ品質と速度の間で切り替えたいユーザー向けです。公式のテキストから画像生成テンプレートに基づき、int8 モデル + int8 テキストエンコーダーを使用し、ステップ数をテンプレートの 25 から 40 に調整しています。
使い方
- ComfyUI バージョン 0.37 以上が必要。int8 モデル、qwen3vl_8b テキストエンコーダー、VAE をダウンロードします。TURBO パスでは Viggle の 6 ステップ LoRA を追加し、下部の Save Image を有効にします。
リスクと制限
- 本バージョンは説明文のみを変更しているため、前バージョンをインストール済みのユーザーは更新不要です。同じ作者の Ultimate ワークフローにはすでに Turbo テキストから画像生成が含まれています。
- 目に見えるサンプルは 4 枚のみです。Qwen Image 2.1 と Viggle LoRA は非商用ライセンスです。
【B】PoseLineartLoRA · v2.0
LoRA · バージョン更新 · 作者 PLANXS · 公開日 11-15 20:02 · ダウンロード数 19
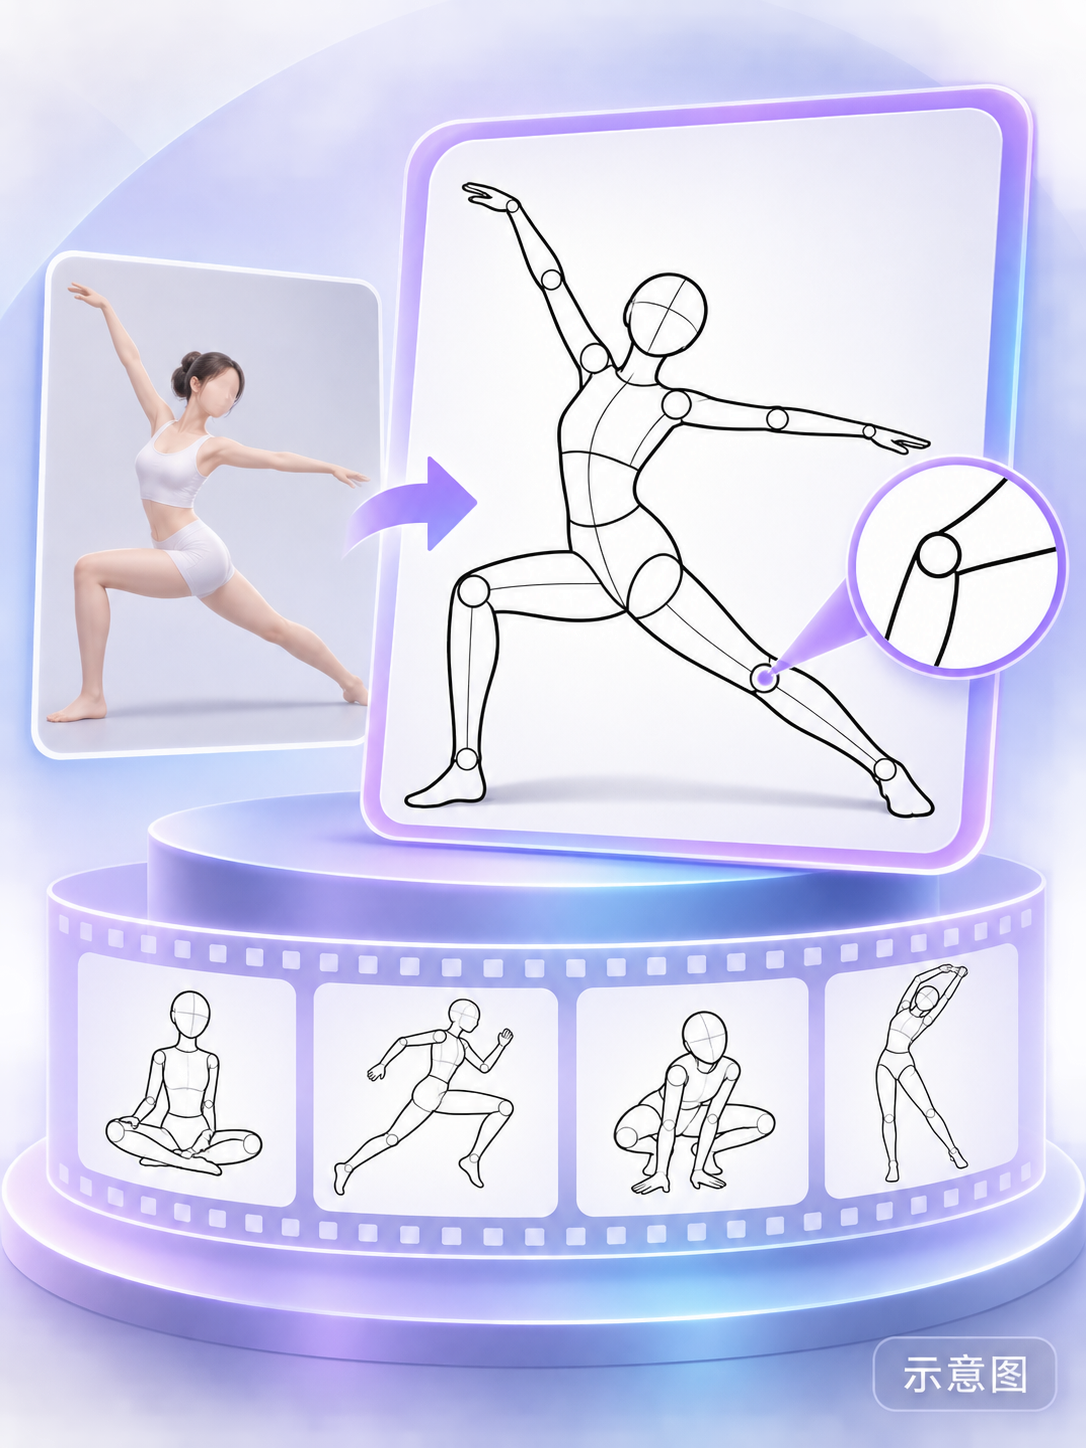
Qwen Image 2.1 編集モデルと併用するLoRAです:人物写真を白背景に黒い線画の人体ポーズ構造図に変換し、背景、服装、顔のディテールを除去します。絵画の参考資料の整理や動作研究に使用できます。
画像付き説明
推奨理由
- Qwen Image 2.1 でポーズ線画を直接生成すると不安定になる問題を解決します。v2.0 のバージョン説明では、複数人物や男女混合の対応が追加されています。
- 再現性が高い:作者は完全な中国語編集指示を提供し、強度は 1.0 から開始します。トリガーワードはありません。
- 絵画の参考資料の整理や動作研究に役立ち、出力をポーズ制御の参考画像として使用することも可能です。
使い方
- Qwen Image 2.1 編集モデルで元画像をアップロードし、LoRA を読み込みます(強度は 1.0 から開始)。プロンプトには「写真内の人物を、白背景に黒い線画の人体ポーズ構造図に変換してください。人物のポーズ、視点、身体比率を保持し、背景、服装、顔のディテールを除去してください」と記述します。
リスクと制限
- 本バージョンには目に見えるサンプルがありません(2 枚は非表示)。複数人物の効果はプレビューできません。
- 作者によれば、指、遮蔽部分、身体比率が変化する可能性があり、精密なトレースではありません。
- カードの画像はAI生成の概念図であり、モデルの実際の出力ではありません。作者は一般公開レベルのサンプルを公開していません。
データ:Civitai 公開API(ベースモデル Qwen 2.1)、収録期間 11-15 08:31 → 11-15 21:01(北京時間)。推奨理由は編集者によるレビュー済みです。ダウンロード数は注目度を表すに過ぎません。