Zhenzhen의 AI 레이더 · Qwen Image 2.1 · 2026-11-15 저녁 뉴스레터
이번 호 4개의 새로운 버전: 강력 추천 0 · 추천 1 · 주목할 만함 3 · 단순 수록 0
편집자 주 이번 호에서는 Qwen 2.1의 새로운 버전 4개를 검토하여 A등급 1개, B등급 3개로 분류했습니다. 최신 추천은 Qwen Image 2.1 Ultimate 12GB 워크플로우입니다: 하나의 드롭다운 메뉴로 2K 텍스트-이미지 생성, 1–3장 이미지 편집, 투명 PNG 배경 제거 및 세 가지 Fun ControlNet을 전환하며, 핵심 노드만 사용합니다. 이번 버전은 설명문만 재작성했고 그래프 구조는 변경되지 않았으므로 자동 S등급에서 A등급으로 하향 조정했습니다. 같은 저자의 40단계 / Turbo 이중 경로 텍스트-이미지 생성 워크플로우 역시 설명문만 수정되어 B등급으로 하향되었습니다. Yennefer 캐릭터 LoRA의 Qwen 2.1 버전은 재훈련 후 트리거 단어와 완전한 예시 프롬프트를 포함하지만, 저작권이 있는 캐릭터이므로 S등급에서 B등급으로 하향되었습니다. 인물 포즈 라인아트로 변환하는 편집용 LoRA는 사용법이 명확하지만 공개된 예시가 없어 B등급으로 분류했습니다.
추천 (1)
【A】Qwen Image 2.1 Ultimate 12GB — Turbo 8단계 2K T2I + 이미지 1-3장 편집 + 배경 제거 + Fun ControlNet 포즈/깊이/캔니 · v2.1.1
워크플로우 · 버전 업데이트 · 저자 The_frizzy1 · 게시일 11-15 20:21 · 다운로드 수 8
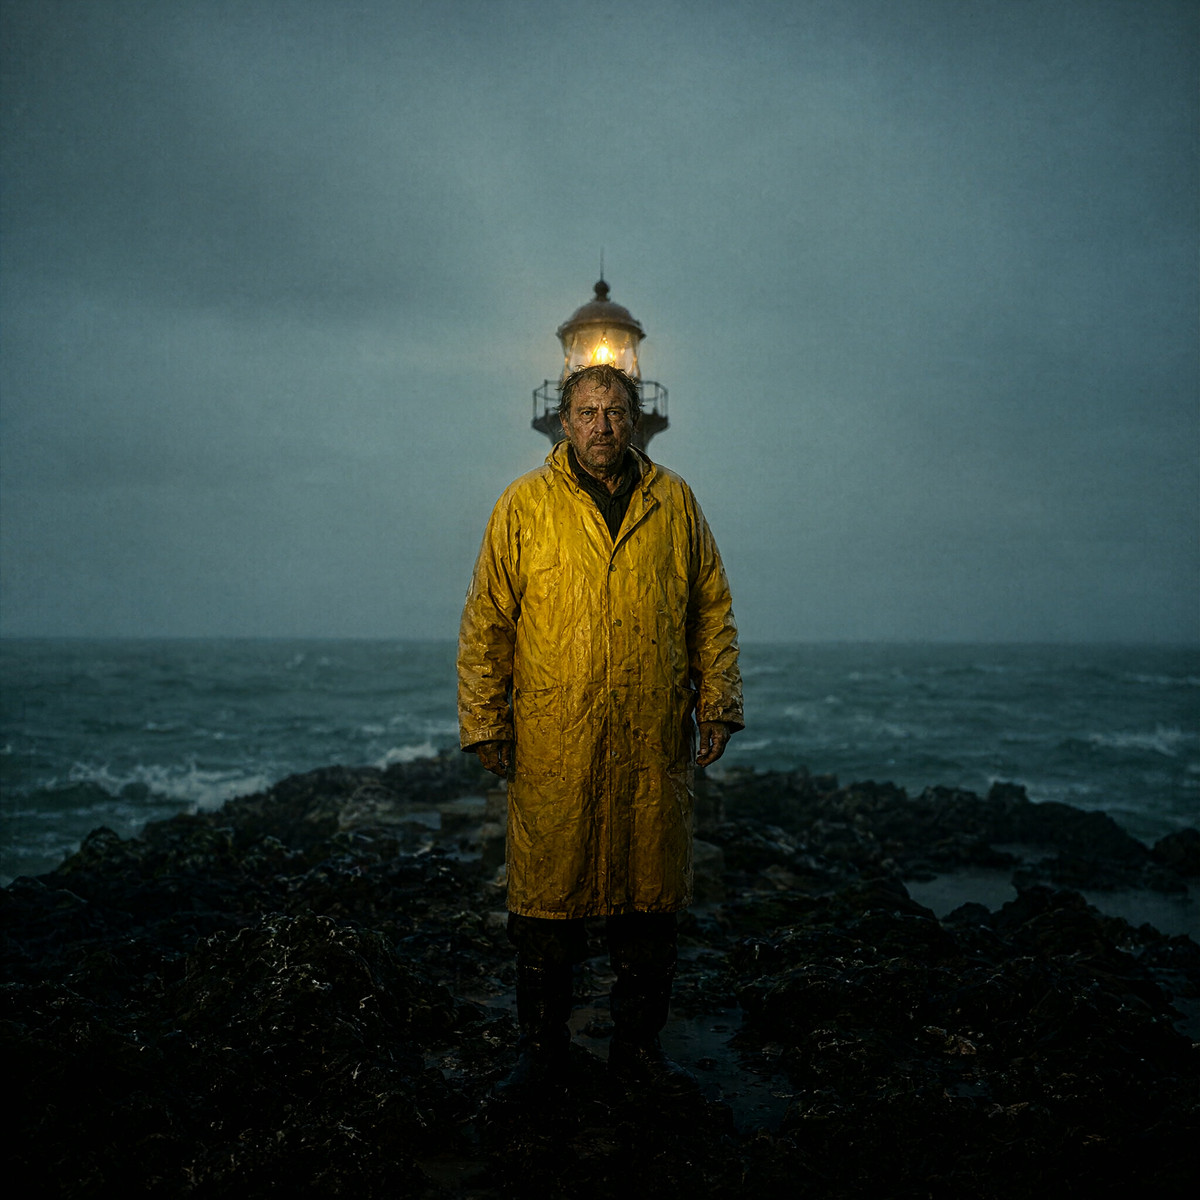
Qwen Image 2.1의 모든 모드를 하나의 워크플로우에 통합했습니다: 네이티브 2K 텍스트-이미지 생성, 자신의 이미지 1–3장을 사용한 편집, 투명 PNG 직접 출력 배경 제거, Fun ControlNet 포즈 / 깊이 / 엣지 제어 기능을 제공하며, 기본값은 8단계 Turbo이고 핵심 노드만 사용합니다.
예시 이미지
추천 이유
- 버전 업데이트: v2.1.1은 사용법(How to use) 설명문(입력, 설정, 팁, 주의 매개변수, 테스트 환경)만 재작성하고 다운로드 안내 위치를 이동했으며, 저자는 그래프 구조가 변경되지 않았다고 밝혔습니다
- 텍스트-이미지 생성, 부분 편집, 이커머스 배경 제거 및 포즈 / 깊이 / 라인아트 제어 기능을 지원합니다: 하나의 Mode 드롭다운 메뉴로 전환하며, 입력값은 기본적으로 우회(bypass)되어 열자마자 바로 텍스트-이미지 생성이 가능합니다
- 따라 하기 쉽습니다: 저자는 각 파일명, 크기 및 저장 경로를 명시하고, 12 GB VRAM 환경에서 Turbo 2K의 피크 메모리 사용량이 11.6 GB임을 표기했으며, 20장의 공개 예시를 제공합니다
사용 방법
- ComfyUI 0.38 이상 버전 필요(Apply Fun ControlNet은 이미 핵심 노드임); 텍스트-이미지 생성 및 편집을 위해 Turbo 모델, qwen3vl_8b 텍스트 인코더 및 VAE 세 개의 파일을 다운로드해야 합니다
- Turbo는 기본적으로 활성화되며 8단계로 설정됩니다; Turbo를 끄면 40단계의 기본 모델을 사용합니다; 편집 시 Image 1(선택 사항: 2, 3)을 연결하고 프롬프트에서 참조합니다
- ControlNet 모드를 사용하려면 Fun ControlNet, SDPose, Lotus 깊이 맵 등의 파일을 추가로 다운로드해야 합니다
리스크 및 제한 사항
- 이번 버전은 설명문만 변경되었으므로 v2.1.0을 이미 설치한 사용자는 업데이트할 필요가 없습니다
- 저자에 따르면 ControlNet은 네이티브 2K 해상도에서 오류가 발생할 수 있으므로, ControlNet의 해상도를 1 MP로 유지해야 합니다
- Qwen Image 2.1 및 Turbo는 Qwen Research License를 따르며 비상업적 용도로만 사용 가능합니다
주목할 만함 (3)
【B】Witches: Yennefer 코스프레 | MOSS / Krea 2 /Qwen 2.1 · v2.0 Qwen 2.1
LoRA · 버전 업데이트 · 저자 bazya022020810 · 게시일 11-15 18:26 · 다운로드 수 13
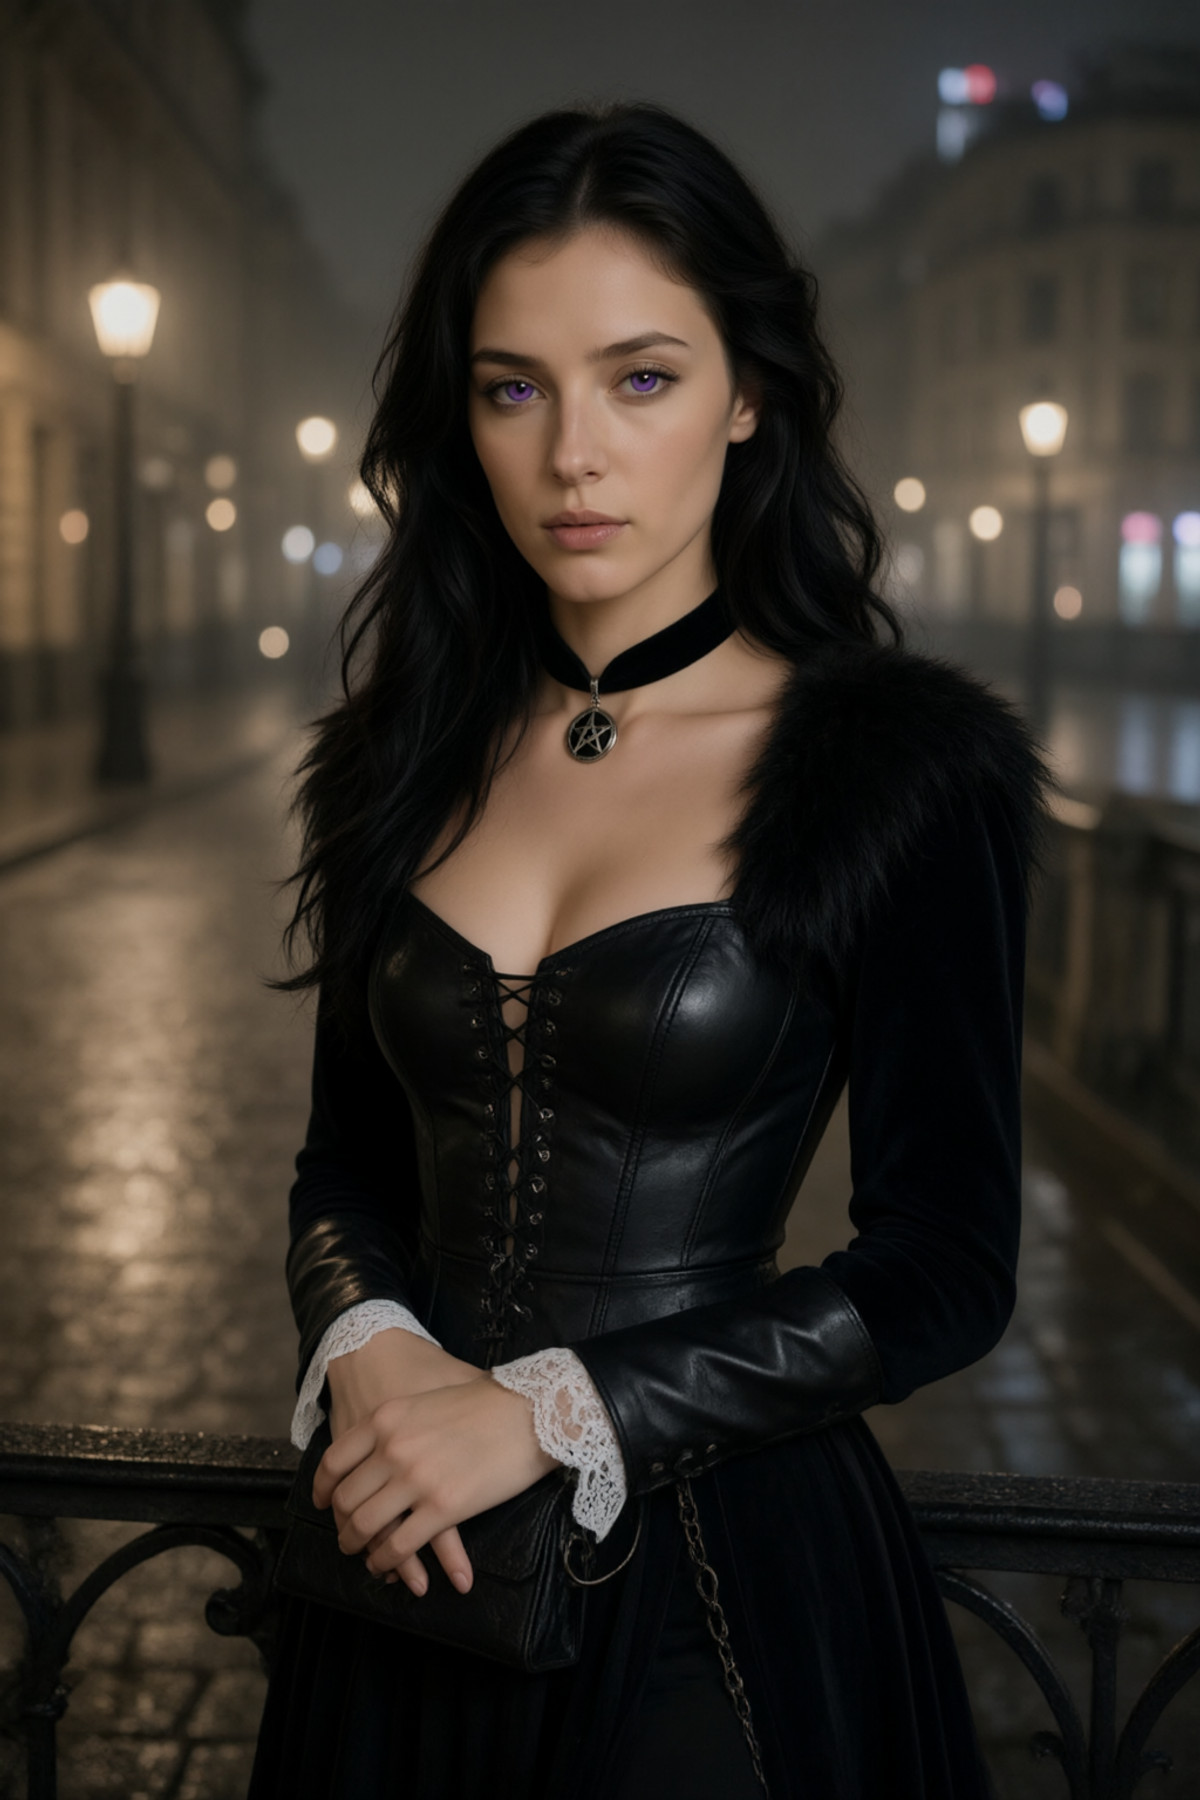
『위쳐』의 예니퍼 코스프레 캐릭터 LoRA의 Qwen 2.1 버전입니다: 트리거 단어를 추가하면 클래식한 검은색 가죽 코르셋, 모피 칼라 및 별 모양 초커 스타일이 생성되며, 트리거 단어를 생략하면 의상을 자유롭게 변경할 수 있습니다. 얼굴, 검은색 곱슬머리 및 보라색 눈동자는 일관되게 유지됩니다.
예시 이미지
추천 이유
- v2.0 재훈련: 저자는 v1.0가 얼굴 일관성과 의상 변경 모두 불만족스러웠다고 밝히며, v2.0은 새로운 55장의 데이터셋으로 처음부터 훈련되었습니다
- 사용법 상세 기술: 트리거 단어 'yenoutfit'을 프롬프트 맨 앞에 배치하면 클래식 의상이 생성되고, 이를 생략하고 원하는 옷을 묘사하면 의상 변경이 가능합니다; 트리거 단어를 포함/제외한 두 가지 완전한 예시 프롬프트를 제공합니다
- 같은 시리즈에는 MOSS 및 Krea 2 버전도 있으며, 본 항목은 Qwen 2.1 기반 모델입니다
사용 방법
- 강도(strength)는 0.85–1.0 사이로 설정합니다; 클래식 스타일은 프롬프트 맨 앞에 'yenoutfit'을 작성하고, 의상 변경 시 트리거 단어를 제거하고 의상을 명시합니다
- 저자는 캐릭터와 충돌하는 머리색이나 눈동자 색을 프롬프트에 포함하지 말라고 조언합니다
리스크 및 제한 사항
- 저자는 업데이트 노트를 작성하지 않았습니다(재훈련 정보는 모델 카드 본문에 있음)
- 『위쳐』는 저작권이 있는 캐릭터이며, 라이선스는 파생 작품 생성을 허용하지 않습니다; 공개된 예시 3장, 숨겨진 예시 4장이 있으며 페이지는 혼합 콘텐츠(mixed content)입니다
트리거 단어: yenoutfit,
【B】Qwen Image 2.1 12GB — int8 네이티브 2K 텍스트-이미지 생성, 40단계 QUALITY + Viggle 6단계 TURBO LoRA · v2.0.1
워크플로우 · 버전 업데이트 · 저자 The_frizzy1 · 게시일 11-15 20:17 · 다운로드 수 6
12 GB VRAM 그래픽 카드로 Qwen Image 2.1 네이티브 2K 텍스트-이미지 생성을 실행하는 워크플로우입니다. 하나의 그래프에 두 가지 경로가 있습니다: 40단계 QUALITY 경로와 Viggle 6단계 Turbo LoRA를 사용하는 TURBO 경로이며, 핵심 노드만 사용합니다.
예시 이미지
추천 이유
- 버전 업데이트: v2.0.1은 사용법(How to use) 설명문(각 입력값, TURBO 전환 방법, 중요한 설정, 테스트 환경)만 재작성했고 다운로드 안내는 구두점만 수정했으며, 저자는 그래프 구조가 변경되지 않았다고 밝혔습니다
- 12 GB 카드에서 2048×2048 텍스트-이미지 생성을 원하면서 품질과 속도 간에 전환하고 싶은 사용자를 대상으로 합니다; 공식 텍스트-이미지 생성 템플릿을 기반으로 하며, int8 모델 + int8 텍스트 인코더를 사용하고 단계 수를 템플릿의 25에서 40로 조정했습니다
사용 방법
- ComfyUI 0.37 이상 버전 필요; int8 모델, qwen3vl_8b 텍스트 인코더 및 VAE를 다운로드합니다; TURBO 경로는 Viggle의 6단계 LoRA를 추가로 적용하고 하단의 Save Image 노드를 활성화해야 합니다
리스크 및 제한 사항
- 이번 버전은 설명문만 변경되었으므로 이전 버전을 설치한 사용자는 업데이트할 필요가 없습니다; 같은 저자의 Ultimate 워크플로우에는 이미 Turbo 텍스트-이미지 생성 기능이 포함되어 있습니다
- 공개된 예시는 4장뿐입니다; Qwen Image 2.1 및 Viggle LoRA는 비상업적 라이선스를 따릅니다
【B】PoseLineartLoRA · v2.0
LoRA · 버전 업데이트 · 저자 PLANXS · 게시일 11-15 20:02 · 다운로드 수 19
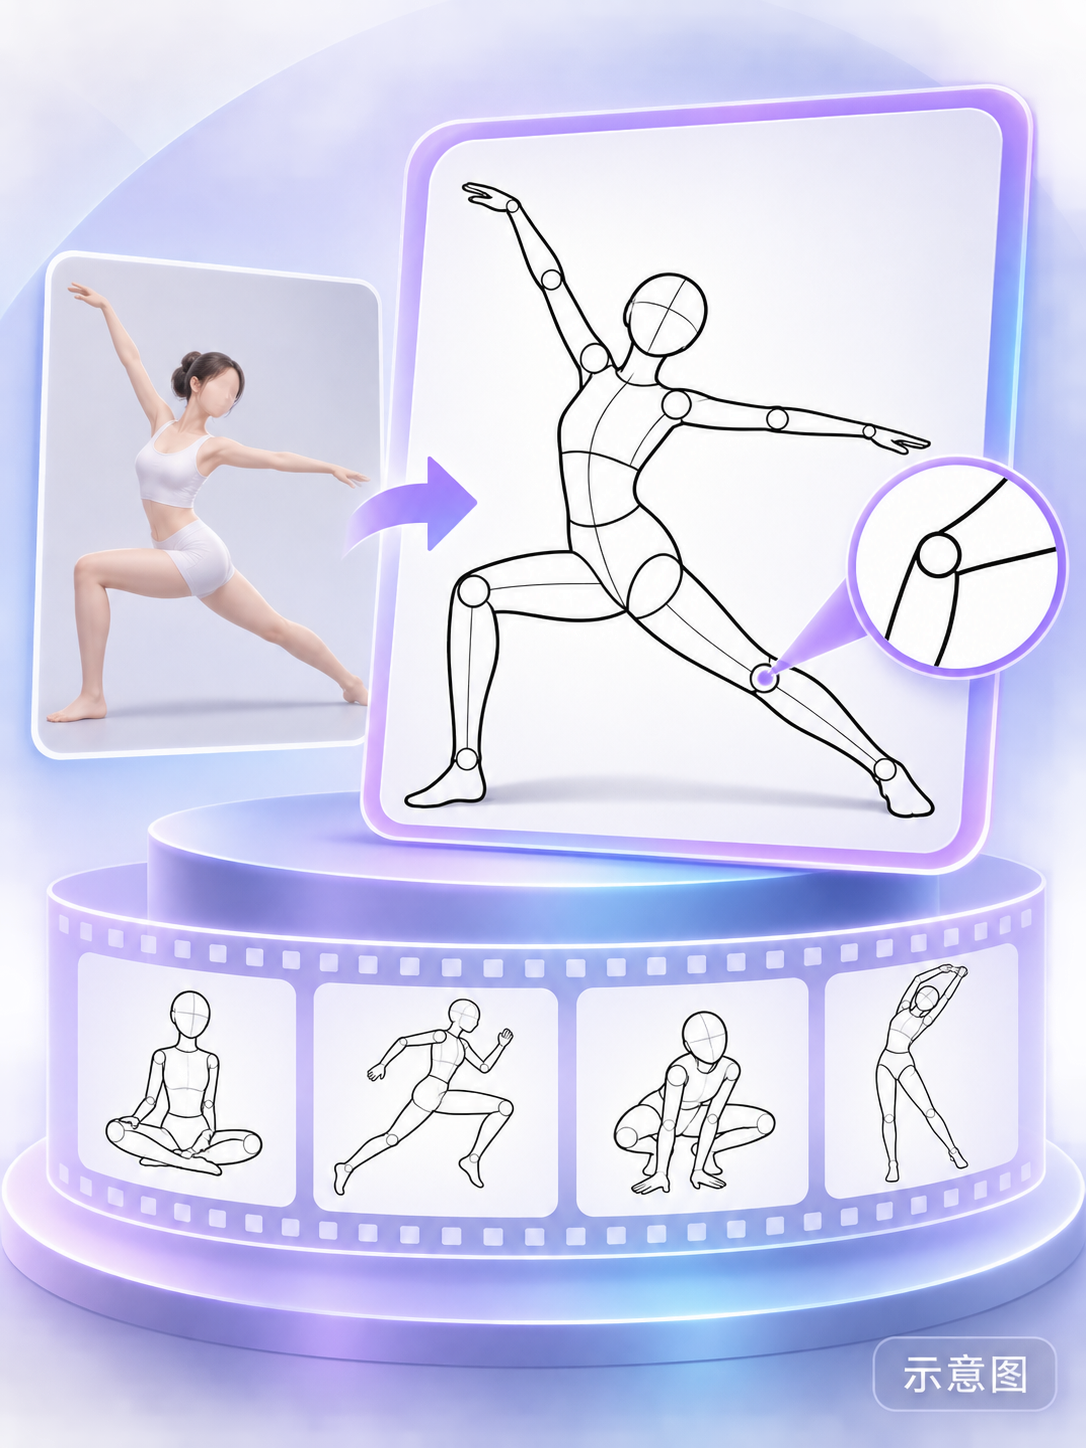
Qwen Image 2.1 편집 모델과 함께 사용하는 LoRA입니다: 인물 사진을 흰색 배경의 검은색 선으로 된 인체 포즈 구조 라인아트로 변환하여 배경, 의상 및 얼굴 세부 사항을 제거합니다. 그림 참고 자료 정리 및 동작 연구에 유용합니다.
예시 이미지
추천 이유
- Qwen Image 2.1로 포즈 라인아트를 직접 생성할 때 불안정한 문제를 해결합니다; v2.0의 버전 설명은 다중 인물 및 남녀 혼합 지원임을 명시합니다
- 따라 하기 쉽습니다: 저자는 완전한 중국어 편집 지시문을 제공하며, 강도는 1.0부터 시작하고 트리거 단어는 없습니다
- 그림 참고 자료 정리 및 동작 연구에 유용하며, 출력물을 포즈 제어의 참고 이미지로 사용할 수도 있습니다
사용 방법
- Qwen Image 2.1 편집 모델을 사용하여 원본 이미지를 업로드하고 LoRA를 로드합니다(강도 1.0부터 시작). 프롬프트에는 다음과 같이 작성합니다: '사진 속 인물을 흰색 배경의 검은색 선으로 된 인체 포즈 구조 라인아트로 변환하세요. 인물의 포즈, 시점 및 신체 비율을 유지하고 배경, 의상 및 얼굴 세부 사항은 제거하세요.'
리스크 및 제한 사항
- 이번 버전에는 공개된 예시가 없습니다(2장 숨겨짐). 다중 인물 효과는 미리 볼 수 없습니다
- 저자는 손가락, 가려진 부위 및 신체 비율이 변할 수 있으며 정확한 트레이싱(tracing)은 아니라고 밝혔습니다
- 카드의 예시 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아닙니다; 저자는 공개된 일반 등급의 예시를 제공하지 않았습니다
데이터: Civitai 공개 API(기반 모델 Qwen 2.1), 수집 기간 11-15 08:31 → 11-15 21:01(베이징 시간). 추천 이유는 편집자 검수를 거쳤습니다; 다운로드 수는 단지 관심도를 나타냅니다.