정정(貞貞)의 AI 레이더 · MiniMax H3 · 2026-10-31 모닝 브리프
이번 호 8개의 새로운 버전: 강력 추천 1 · 추천 1 · 주목할 만함 2 · 등재만 함 4
편집자 주 이번 호에서는 H3의 새로운 버전 9개를 검토했습니다. 최우선 추천은 Perfect Looper입니다. H3가 생성한 영상과 소리가 함께 처음과 끝이 매끄럽게 이어지는 루프 영상을 만드는 ComfyUI 워크플로우로, 텍스트 생성, 이미지 생성, 참조 생성 및 기존 영상 네 가지 입력 방식을 모두 지원합니다. 노드, 모델, 6 스텝 터보 및 프롬프트 템플릿이 명확하게 기술되어 있습니다. 다른 A등급 항목은 H3의 멀티 샷 영상을 만화 페이지로 배치하고 대사 상자를 추가할 수 있는 Komikku 노드 팩으로, B등급에서 A등급으로 상향되었으나 의존성이 많고 예시가 1장에 불과합니다. PIKA72 병합 베이스 모델(내장 LoRA의 역할 미설명, 스텝 및 샘플링 파라미터 누락)은 S등급에서 B등급으로 하향되었으며, InstaPic H3 버전과 단일 프레임 편집 워크플로우는 설명이 부족하여 A등급에서 B등급으로 하향되었습니다. 외부 링크 영상으로만 설명된 업스케일링 워크플로우와 세 개의 일반적인 캐릭터 LoRA는 C등급으로 분류되었습니다.
강력 추천 (1)
【S】Perfect Looper (MiniMax-H3) | T2AV, I2AV, Ref2AV, V2AV | 6 steps turbo · v1.1
워크플로우 · 신규 모델 · 저자 CoolBreeze_ · 게시일 10-31 05:11 · 다운로드 수 56
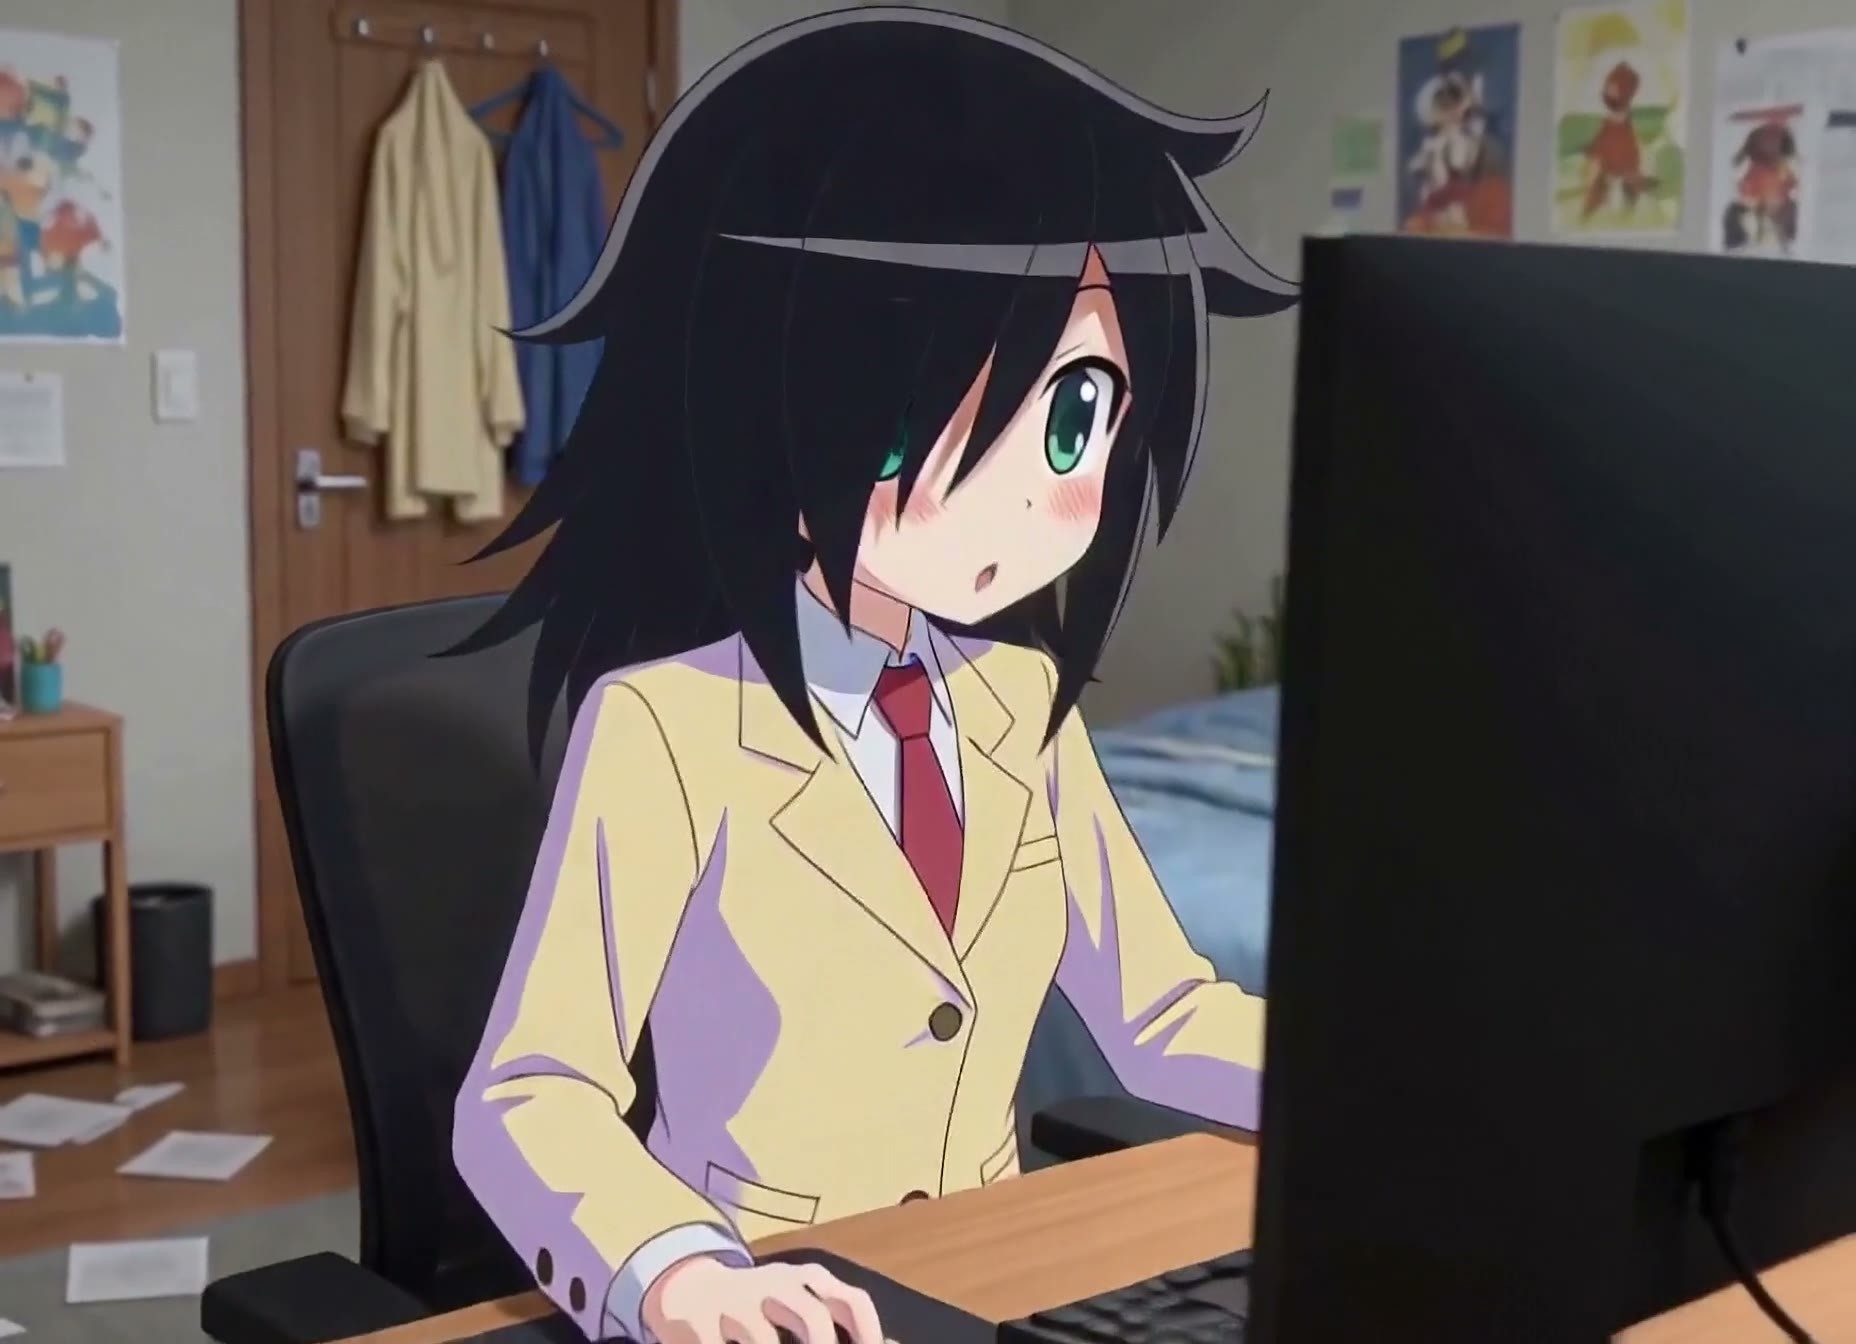
MiniMax H3로 처음과 끝이 매끄럽게 이어지는 루프 영상(영상과 소리가 함께 루프됨)을 생성하는 ComfyUI 워크플로우입니다. 텍스트, 이미지 또는 참조 이미지에서 처음부터 생성할 수도 있고, 기존 영상을 루프로 연결할 수도 있습니다. 자체적으로 새로운 가중치(weights)는 아닙니다.
S등급 유지: 기능이 신규하고 명확하며(영상과 오디오가 함께 폐루프를 형성), 5개의 가시적인 예시가 있고, 노드, 모델, 스텝 수 및 프롬프트 템플릿이 명확하게 기술되어 있으며, 무료이고 라이선스가 관대합니다. 진입 장벽은 수동으로 설치해야 하는 노드 팩과 복잡한 동작의 경우 루프가 보장되지 않는다는 점입니다.
이미지
추천 이유
- 신규 모델(사이트 내 첫 버전, 버전명 v1.1): 먼저 작은 '앵커(anchor)' 클립을 생성하고, 이 클립의 첫 프레임과 마지막 프레임을 다음 샘플러에 인코딩하여 마스크로 보호한 후, 동일한 프롬프트를 사용하여 앵커의 끝에서 시작점으로 돌아가는 '브리지(bridge)' 클립을 생성합니다. 마지막으로 두 클립의 영상과 오디오를 크로스 페이드(cross-fade)하여 루프로 결합합니다.
- 루프형 숏폼 영상, 제자리 동작/댄스 루프, 배경 GIF 등의 요구 사항에 적합합니다. 텍스트 생성(T2AV), 이미지 생성(I2AV), 참조 생성(Ref2AV) 및 기존 영상(반드시 24 fps) 네 가지 입력 방식을 모두 지원합니다. 저자는 임의의 H3 미세 조정 베이스 모델과 LoRA 조합과 함께 사용할 수 있다고 언급했습니다.
- 해상도, 앵커 및 브리지 길이, 겹치는 길이, 루프 횟수를 조정할 수 있으며, 최종 영상에 RTX 업스케일링 및 프레임 보간을 선택적으로 적용할 수 있습니다. 기본 설정은 Larryvrh의 터보 LoRA를 사용하여 6 스텝을 실행하며, 앵커와 브리지 모두 CK+SLA 하이브리드 어텐션을 사용합니다.
- 카드에 명시된 V1.1 변경 사항: 터보 LoRA를 ComfyUI 최적화 버전으로 교체하여 텐서 크기 불일치 오류를 수정했습니다(이제 이전 LoRA용 노드 팩이 필요 없음). 샘플링 파라미터를 조정하고, 비디오 VAE를 int8로 변경했으며, STAGE 2에 음소거 스위치를 추가했습니다. 먼저 STAGE 1의 시드만 다시 추출하여 적절한 루프 베이스 영상을 찾을 수 있습니다.
- 5개의 가시적인 예시 영상이 있으며, 일부는 프롬프트가 포함되어 있습니다. 무료이며, 라이선스는 이미지 출력, 대여, 판매 및 융합 판매를 허용합니다. 게시 후 약 4시간 동안 56회 다운로드되었습니다(관심도만 반영).
사용 방법
- perfectLooperMinimaxH3T2AV_v11 압축 파일을 해제하여 ComfyUI에 가져온 후, 대부분의 노드는 Manager의 'Install missing custom nodes' 기능을 통해 설치합니다. 저자의 ComfyUI-CoolB-Nodes는 최신 버전으로 업데이트해야 하며, ComfyUI-H3-Motion-Context-MultiRef는 Manager에 없으므로 수동으로 다운로드해야 합니다. 또한 rgthree, KJNodes, VideoHelperSuite 및 Nvidia VFX 노드(업스케일링/프레임 보간용)가 필요합니다.
- 모델: 임의의 H3 메인 모델(저자는 Singularity ref2va 프루닝 int8 버전을 사용함), 텍스트 인코더와 VAE는 공식 Comfy-Org/MiniMax-H3 저장소를 사용하며, 터보 LoRA는 drbaph 저장소의 ComfyUI 최적화 버전인 Larryvrh LoRA를 사용하고 6 스텝을 실행합니다.
- 프롬프트는 워크플로우의 템플릿에 따라 루프가 가능한 동작을 작성합니다. 예를 들어 '캐릭터가 제자리에서 특정 동작을 수행하며, 고정 카메라' 또는 '카메라가 장면을 한 바퀴 돌음'과 같이 작성합니다. 연결이 매끄럽지 않으면 영상 길이를 변경하거나 앵커/브리지의 시드를 변경합니다. 기존 영상을 루프할 경우, 프롬프트에 브리지 구간이 끝에서 시작점으로 어떻게 전환되는지 명확히 작성합니다. 가능한 한 음악 생성은 피하는 것이 좋습니다.
리스크 및 제한 사항
- 복잡한 동작은 루프가 보장되지 않습니다: 동작은 공간적 및 시간적 진폭 모두에서 다시 연결될 수 있어야 하며, 그렇지 않으면 브리지 구간이 마지막 프레임 전에 하드 컷(hard cut)이 발생할 수 있습니다. 비트가 거의 일치하지 않으므로, 저자는 음악 생성을 피하고 후반 작업에서 별도로 추가할 것을 권장합니다.
- 의존성이 많습니다: 하나의 노드 팩은 수동으로 설치해야 합니다. Nvidia VFX 노드의 프레임 보간 기능은 RTX 40 시리즈 이상의 그래픽 카드가 필요하며, 나머지 기능은 cu130+ PyTorch가 필요합니다. 조건을 충족하지 못하면 다른 업스케일링/프레임 보간 노드로 대체하십시오.
- VHS 노드로 저장된 루프 영상의 끝부분에 약간의 빈 오디오가 추가될 수 있습니다. 다시 처음과 끝을 연결하기 전에 2–3 ms를 잘라내야 하며, 그렇지 않으면 루프 지점에서 소리 점프가 발생합니다.
- 저자의 테스트 환경은 ComfyUI 0.42.0/0.43.0, PyTorch 2.14.0+cu130, RTX 4080 SUPER, 64 GB RAM입니다. 업로드된 버전은 0.7 MP, 7초 예시 설정이며, 저자는 총 소요 시간이 156초(로딩 시간 제외)라고 언급했습니다. 두 단계 샘플링은 각각 17초와 84초가 소요됩니다. 이 항목은 실행되지 않았습니다.
- 4개의 민감도 등급 예시는 숨겨져 있으며, 저자는 프롬프트 팁에서 은근한 암시를 하고 있습니다.
추천 (1)
【A】Minimax-H3-Komikku | Video → Manga/Comic Page (ComfyUI) · v1.0
워크플로우 · 신규 모델 · 저자 paralaif_xox · 게시일 10-31 01:44 · 다운로드 수 32
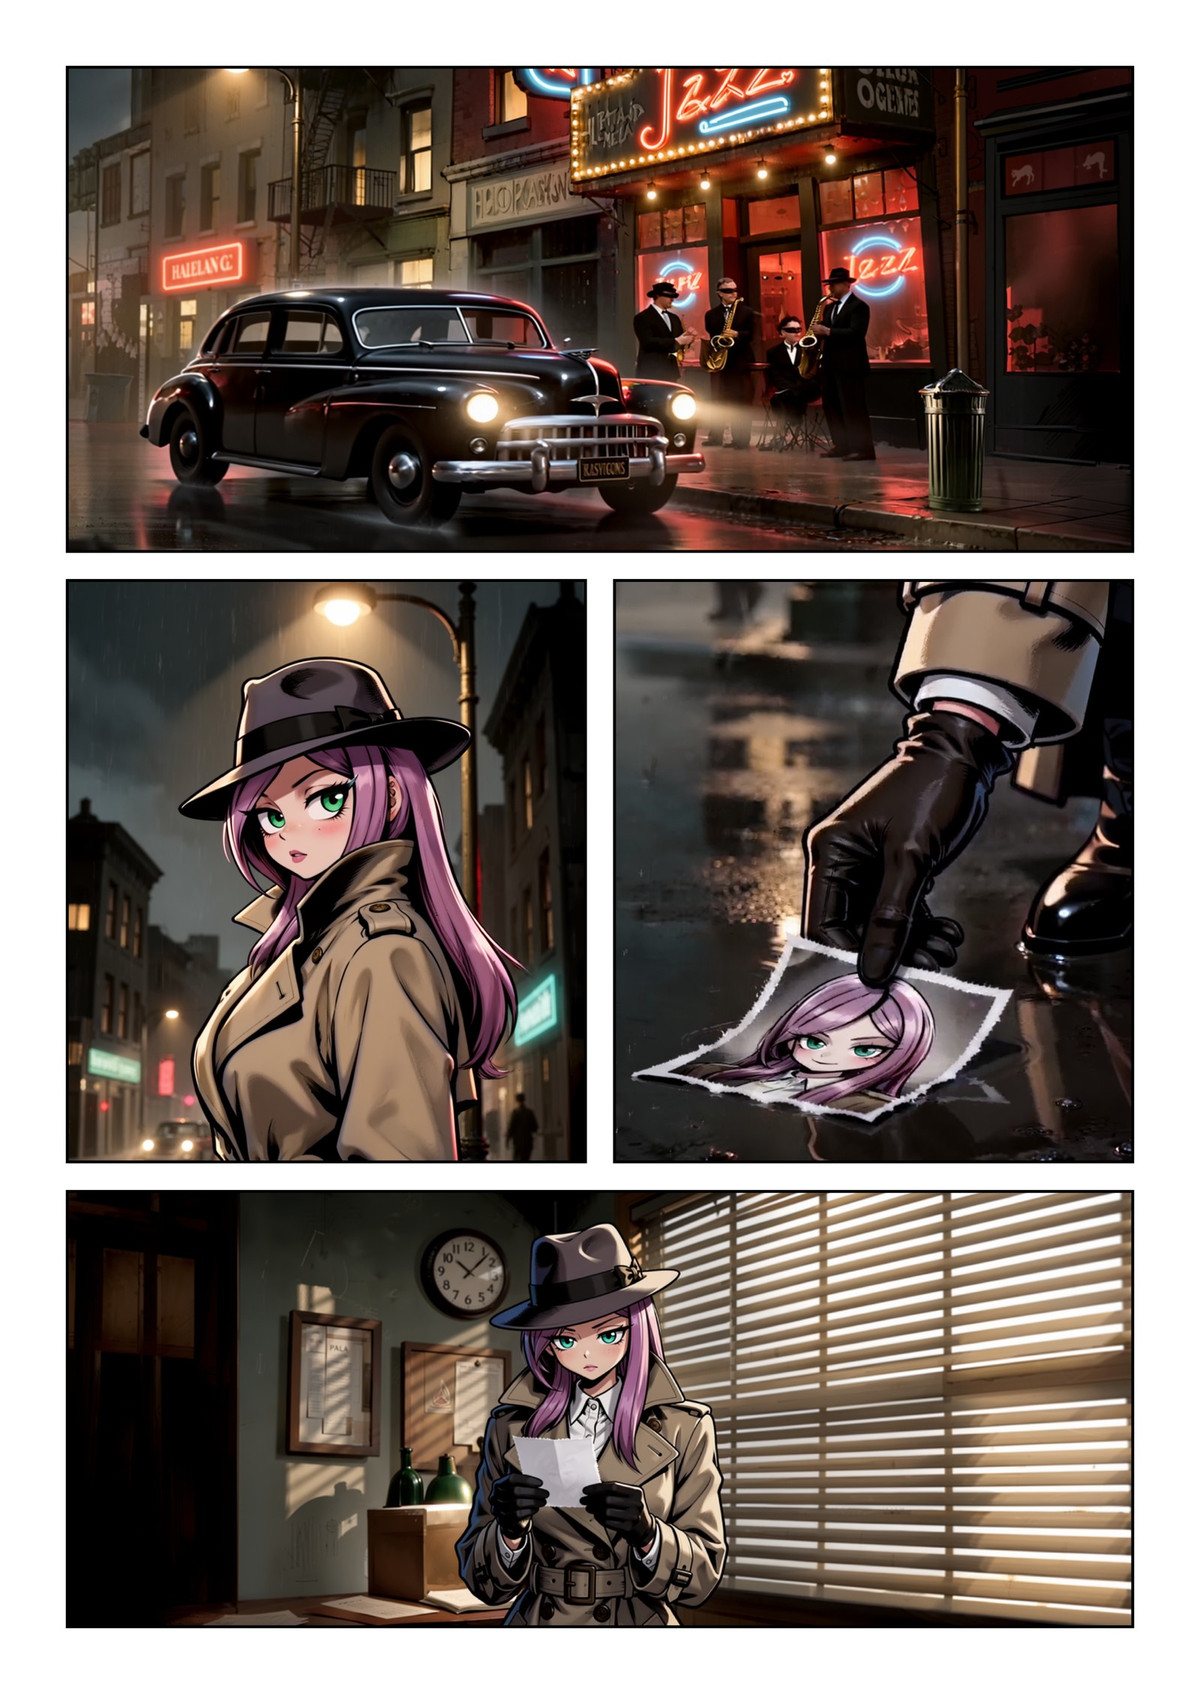
MiniMax H3의 참조 생성 영상 멀티 샷 출력을 완전한 만화 페이지로 변환하는 ComfyUI 노드 팩 및 워크플로우입니다. 먼저 레이아웃을 배치하고, 각 칸은 영상 내의 하드 컷 샷에 대응됩니다. 그런 다음 각 샷의 영상을 칸에 다시 배치하고 대사를 추가합니다.
B등급에서 A등급으로 상향: 멀티 샷 영상을 만화 페이지로 변환하는 것은 이번 호에서 가장 참신한 워크플로우입니다. 프로세스 및 설치 설명이 명확하고 MIT 오픈 소스이지만, 여러 모델에 의존하며 사이트 내 예시는 1장에 불과합니다.
이미지
추천 이유
- 신규 모델: Komikku Page & Shots는 전체 화면 레이아웃 편집기(프리셋, 자유형, 사선 및 다각형 칸 나누기, 칼선)입니다. 칸을 클릭하여 해당 칸의 샷 내용을 작성하면, 노드가 자동으로 타임스탬프가 포함된 H3 멀티 샷 프롬프트를 생성합니다.
- 전체 프로세스: H3 ref2vid가 최대 4장의 캐릭터 참조 이미지를 사용하여 멀티 샷 영상을 생성합니다 → 장면 감지를 통해 각 샷에서 한 프레임을 추출합니다 → FLUX 3 Klein이 칸 비율에 따라 영상을 재구성합니다 → 선택적으로 MOSS-Image를 사용하여 5 MP로 고해상도 처리합니다 → Komikku Page Compose에서 이미지를 이동, 확대/축소하고 말하기, 생각, 외침, 속삭임, 내레이션, 의성어 등의 텍스트 상자를 추가하며, 레이어를 겹치고 컬렉션 라이브러리 및 사용자 정의 글꼴을 사용합니다.
- 선택적으로 로컬 텍스트 인코더 MOSS Qwen3.5-9B를 사용하여 샷 설명을 재작성하고 대사를 제안할 수 있습니다. 메인 워크플로우(1:1 영상)와 슈퍼히어로, 탐정, 일본 만화, 다크 네 가지 장르의 예시가 포함되어 있습니다.
- MIT 오픈 소스, 무료이며, 라이선스는 이미지 출력, 대여, 판매 및 융합 판매를 허용합니다.
사용 방법
- 저자의 노드 github.com/quinteroac/ComfyUI-Minimax-H3-Komikku를 설치하고, 워크플로우 설명에 나열된 ZNGB-SceneDetect, VideoHelperSuite, Pixaroma, rgthree, comfyui-obvpm을 추가로 설치합니다.
- minimaxH3KomikkuVideo_v10.zip을 해제하여 메인 워크플로우를 가져온 후, 먼저 자신의 캐릭터 이미지를 Picture 1에 넣은 다음 실행합니다. Manga 예시는 망점 LoRA manga_tone_v2를 사용하며, 트리거 단어는 'manga-tone rendering'입니다.
- H3, FLUX 3 Klein, MOSS-Image의 구체적인 모델 파일과 스텝 수, CFG 값은 저자가 제공하지 않았습니다.
리스크 및 제한 사항
- 의존성이 많습니다: H3와 FLUX 3 Klein이 동시에 필요하며, 선택적으로 MOSS-Image와 MOSS Qwen3.5-9B가 필요하고, 추가로 다섯 개의 서드파티 노드 팩이 필요합니다.
- 가시적인 예시 이미지는 1장뿐이며(프롬프트 없음), 추가로 3개의 민감도 등급 예시는 숨겨져 있습니다. 첫 번째 버전입니다. 이 항목은 실행되지 않았습니다.
주목할 만함 (2)
【B】Singularity-V2-x-10Eros-Max · PIKA72
베이스 모델 / 체크포인트 · 버전 업데이트 · 저자 0l1v1aR0551 · 게시일 10-30 21:07 · 다운로드 수 508
H3 참조 생성 영상(Ref2VA) 병합 베이스 모델입니다. 저자가 자체 제작한 PRISM 알고리즘을 사용하여 Singularity V2와 10Eros-Max(8 스텝 터보) 두 미세 조정 모델을 결합했습니다. 이 PIKA72 버전은 Pika-Labs의 Pika-H3-Flex LoRA를 1.00 또는 0.85 강도로 가중치에 직접 융합합니다.
S등급에서 B등급으로 하향: 병합 방법과 내장 LoRA의 강도만 언급했을 뿐, 이 LoRA가 무엇을 변경하는지 설명하지 않았고, 스텝 수 및 샘플링 파라미터를 제공하지 않았으며, 두 파일을 구분할 수 없습니다. 다운로드 속도가 빠른 것은 관심도가 높다는 것만 의미합니다.
이미지
추천 이유
- 버전 업데이트(4번째 버전): 저자는 사용자들의 요청에 따라 BETA7 x Singularity-V2를 기반으로 Pika-H3-Flex LoRA를 내장했다고 언급했습니다. 1.00과 0.85 두 가지 강도가 있으며, 이 LoRA를 별도로 로드할 필요가 없습니다.
- 저자는 PRISM이 터보 모델을 베이스 모델에 병합할 때 발생하는 가중치 아티팩트를 줄일 수 있다고 주장합니다: 랜덤 SVD(rank 64)를 사용하여 확산 노이즈 증분을 필터링하고, 방향은 SLERP, 진폭은 로그 공간 보간을 적용하며, 부호 충돌을 해결하고 레이어 정규화를 재보정합니다.
- 동일한 모델 페이지에는 CLASSICS(Singularity V1.3 x 10Eros-Beta5)와 BETA72(Singularity V2 x 10Eros-Beta7) 두 가지 버전이 비교용으로 있습니다. 저자의 Hugging Face 저장소에는 fp16, int8, w6a8 세 가지 정밀도가 있습니다.
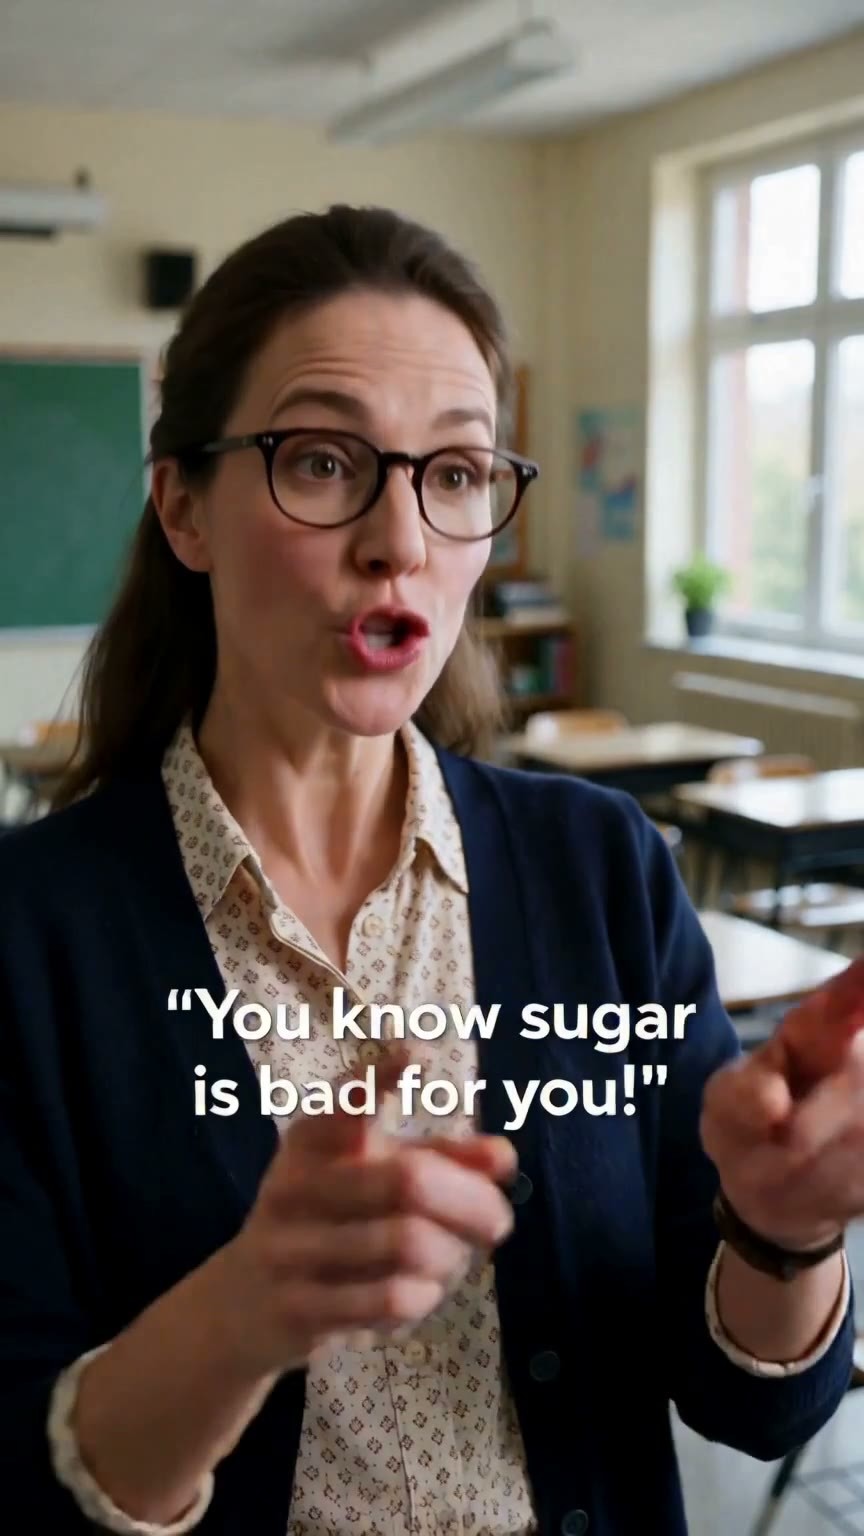
- 게시 후 약 12시간 동안 508회 다운로드되었으며, 모델 누적 다운로드 수는 3670회입니다(관심도만 반영). 무료이며, 라이선스는 이미지 출력 및 사이트 내 대여를 허용합니다.
사용 방법
- int8 safetensors 파일(약 21.3 GB)을 다운로드하여 H3 ref2va 기본 모델 로드를 대체하세요. 모델 페이지의 두 파일 모두 int8 형식이며 크기가 같지만, 파일명만으로는 어느 것이 1.00이고 어느 것이 0.85인지 구분할 수 없습니다.
- 다른 정밀도는 Hugging Face의 OliviaRossi/Minimax-h3_Singularity-x-10Eros-Max_PRISM에서 확인하세요. 스텝 수, CFG, 샘플러는 작성자가 명시하지 않았습니다(병합 출처인 10Eros-Max는 8 스텝 turbo입니다).
리스크 및 제한 사항
- 작성자가 업데이트 내역(changelog)을 작성하지 않았으며, 버전 설명에 한 줄만 기재되어 있고 Pika-H3-Flex LoRA 자체가 어떤 효과를 가져오는지 언급하지 않았습니다.
- 3자 병합 모델로 권장 스텝 수 및 샘플링 설정이 없습니다. 공개된 예시는 1개의 영상과 1장의 이미지뿐이며, 3개의 민감도 등급 예시는 숨겨져 있습니다. 본 항목은 실행되지 않았습니다.
- 내장 LoRA와 두 출처의 미세 조정 모델에 대한 라이선스는 직접 확인해야 합니다.
【B】MiniMaxH3. Single frame edit · v0.1
워크플로우 · 신규 모델 · 작성자 brainburns894 · 게시일 10-30 23:40 · 다운로드 수 88
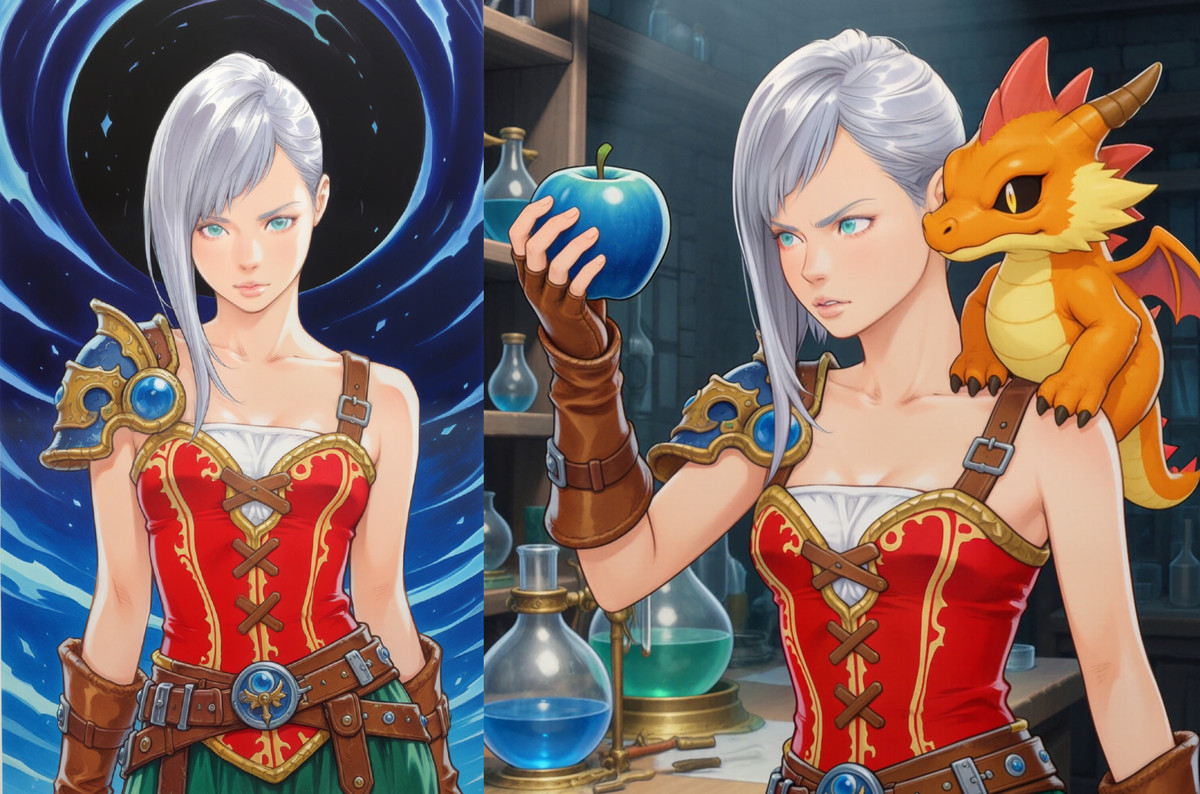
MiniMax H3를 이미지 편집 모델로 사용하는 ComfyUI 워크플로우입니다. 단일 프레임만 생성하며, 여러 장의 참조 이미지와 포즈 복사를 지원합니다. 이 v0.1 버전은 주로 캐릭터의 포즈를 변경하는 데 사용됩니다.
A에서 B로 강등: 아이디어는 신선하고 3장의 예시가 있지만, 설명이 몇 줄에 불과하며 의존성 및 파라미터가 제공되지 않았습니다. 두 파일의 차이점도 명확하지 않습니다.
첨부 이미지
추천 이유
- 신규 모델: 작성자는 H3를 사용하여 단일 프레임 이미지 편집이 가능하며, '동일한 캐릭터의 포즈 변경'이나 '참조 이미지에 따른 이미지 수정'과 같은 요구 사항을 충족한다고 주장합니다. 이는 비디오 모델에서는 드문 용도입니다.
- 작성자는 두 가지 팁을 제공했습니다: 프롬프트의 detailed_description 부분에 입력 이미지의 화풍(예: monochrome sketch, expressive digital illustration, anime screencap)을 명확히 기재하면 원본 스타일을 유지할 수 있다고 합니다. 목표 해상도는 2.0 MP 미만으로 설정하지 마세요.
- 3장의 공개 예시 이미지가 있습니다. 무료이며, 라이선스는 이미지 출력, 대여, 판매 및 융합 이미지 판매를 허용합니다.
사용 방법
- minimaxh3SingleFrame_v01_3337169.json 또는 minimaxh3SingleFrame_v01_3337171.json(147 KB / 161 KB, 두 파일의 차이는 작성자가 설명하지 않음)을 가져온 후, Manager를 사용하여 누락된 노드를 보완하세요. 필요한 노드, H3 모델 파일, 스텝 수 및 CFG는 작성자가 제공하지 않았습니다.
리스크 및 제한 사항
- 모델 카드가 몇 줄에 불과하며, 의존 노드 및 모델 목록이 없습니다. v0.1는 초기 버전으로, 버전 설명이 한 줄뿐입니다.
- 5개의 민감도 등급 예시가 숨겨져 있습니다. 워크플로우 JSON은 새로운 가중치가 아닙니다. 본 항목은 실행되지 않았습니다.
별도 수록(4)
- MiniMax H3 2K Upscale Workflow · v1.0 — 워크플로우: MiniMax H3 2K 업스케일링용 ComfyUI 워크플로우입니다. 모델 카드는 한 줄 소개만 있으며, 설치 방법과 원리는 외부 링크된 YouTube 영상에 있습니다.
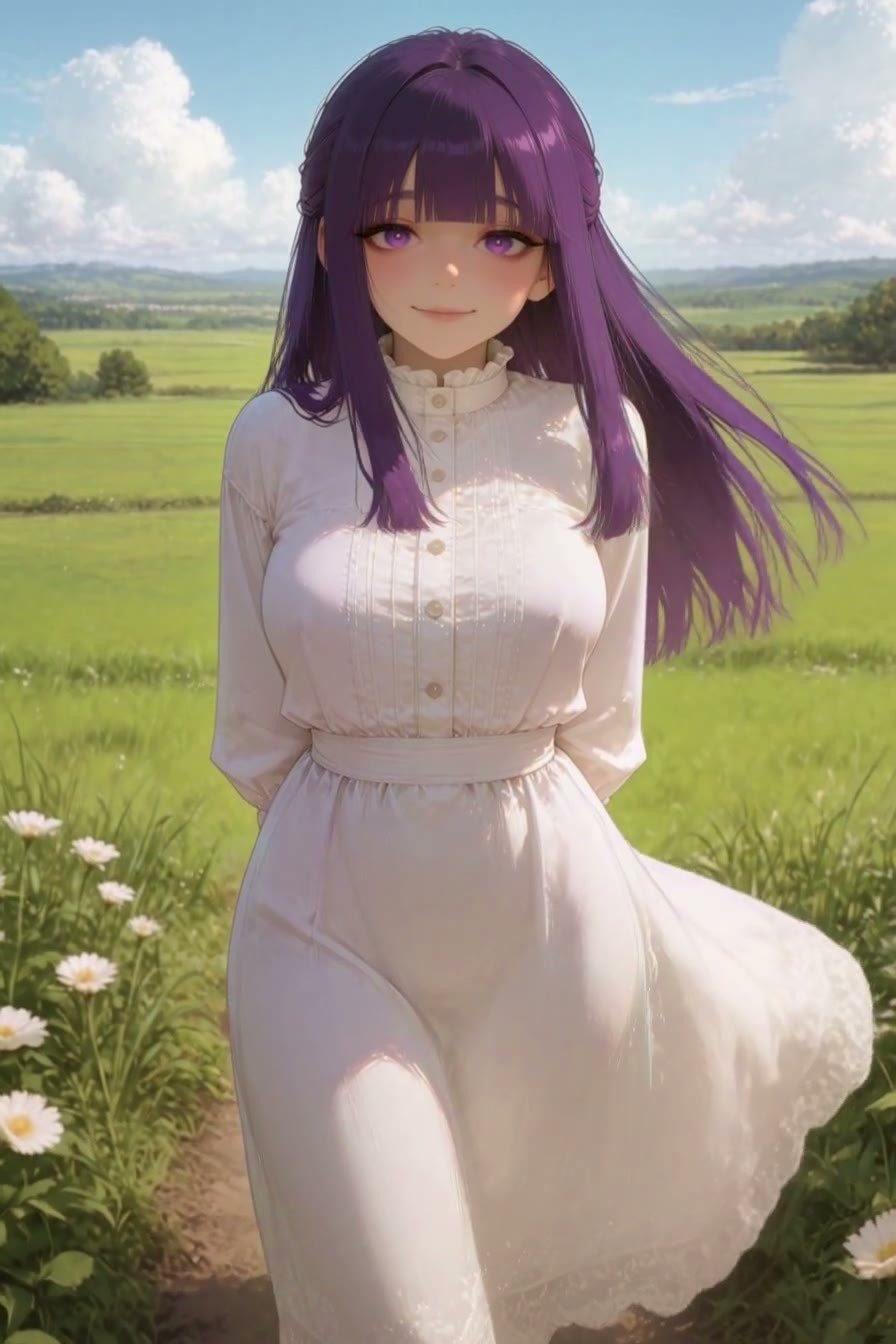
- Fern :: bvga Character Style · v1.0 — LoRA: 캐릭터 Fern의 H3 LoRA입니다. 작성자가 자신의 화풍으로 그린 이미지(보라색 머리, 셔츠, 반실사 애니메이션 일러스트 스타일)로 학습했습니다.
- Darcy Belwyn · MiniMaxH3 — LoRA: 오리지널 가상 여성 캐릭터 Darcy Belwyn의 H3 LoRA입니다. 모델 카드는 인물 소개(브뤼헤 명문 가문 출신, 고서 복원)로 구성되어 있으며 사용법 설명은 없습니다.
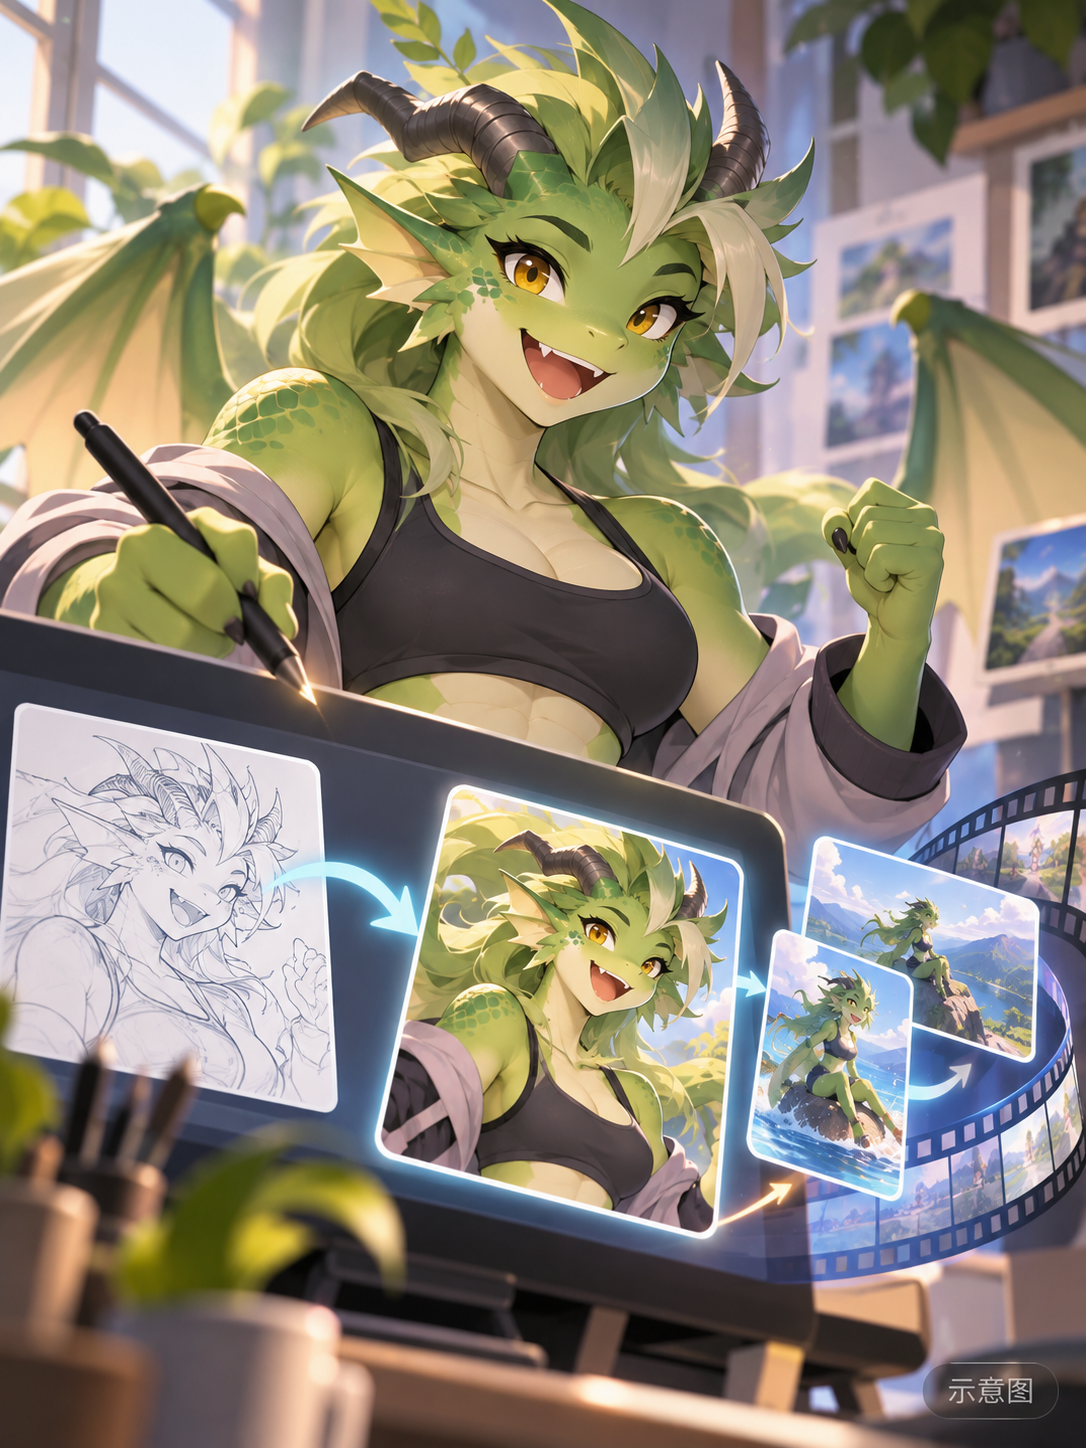
- Kaida Pax · v1.0 H3 — LoRA: 오리지널 녹색 용족 여성 수인 캐릭터 Kaida Pax의 H3 LoRA이며, 트리거 워드는 kaidapax입니다. 모델 카드는 캐릭터 성격 소개로 구성되어 있습니다.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수록 기간 10-30 20:31 → 10-31 09:01(베이징 시간). 추천 이유는 편집자 검수를 거쳤으며, 다운로드 수는 관심도를 나타냅니다.