贞贞的AI雷达 · MiniMax H3 · 2026-10-31 晨报
本期 8 个新版本:强烈推荐 1 · 推荐 1 · 可关注 2 · 仅收录 4
编辑按语 本期审阅 9 个 H3 新版本。首推 Perfect Looper:一个让 H3 生成画面和声音一起首尾闭合的循环视频的 ComfyUI 工作流,文生、图生、参考生和现有视频四种入口都能用,节点、模型、6 步 turbo 和提示词模板都写清了。另一个 A 是把 H3 多镜头视频排成漫画页、可加对白框的 Komikku 节点包,由 B 升为 A,但依赖多、示例只有 1 张。PIKA72 合并底模(没说内置 LoRA 的作用、缺步数采样参数)由 S 降为 B,InstaPic H3 版和单帧编辑工作流因说明薄由 A 降为 B;只靠外链视频讲解的放大工作流和三个常规角色 LoRA 定为 C。
强烈推荐(1)
【S】Perfect Looper (MiniMax-H3) | T2AV, I2AV, Ref2AV, V2AV | 6 steps turbo · v1.1
工作流 · 新模型 · 作者 CoolBreeze_ · 发布 10-31 05:11 · 下载 56
一个让 MiniMax H3 生成首尾无缝衔接的循环视频(画面和声音一起循环)的 ComfyUI 工作流:可以从文本、图片或参考图从零生成,也能把一段现有视频接成循环;本身不是新权重。
维持 S:能力新且明确(画面和音频一起闭环),有 5 段可见示例,节点、模型、步数和提示词模板都写清了,免费且许可宽;门槛是一个手动安装的节点包,以及复杂动作不保证闭合。
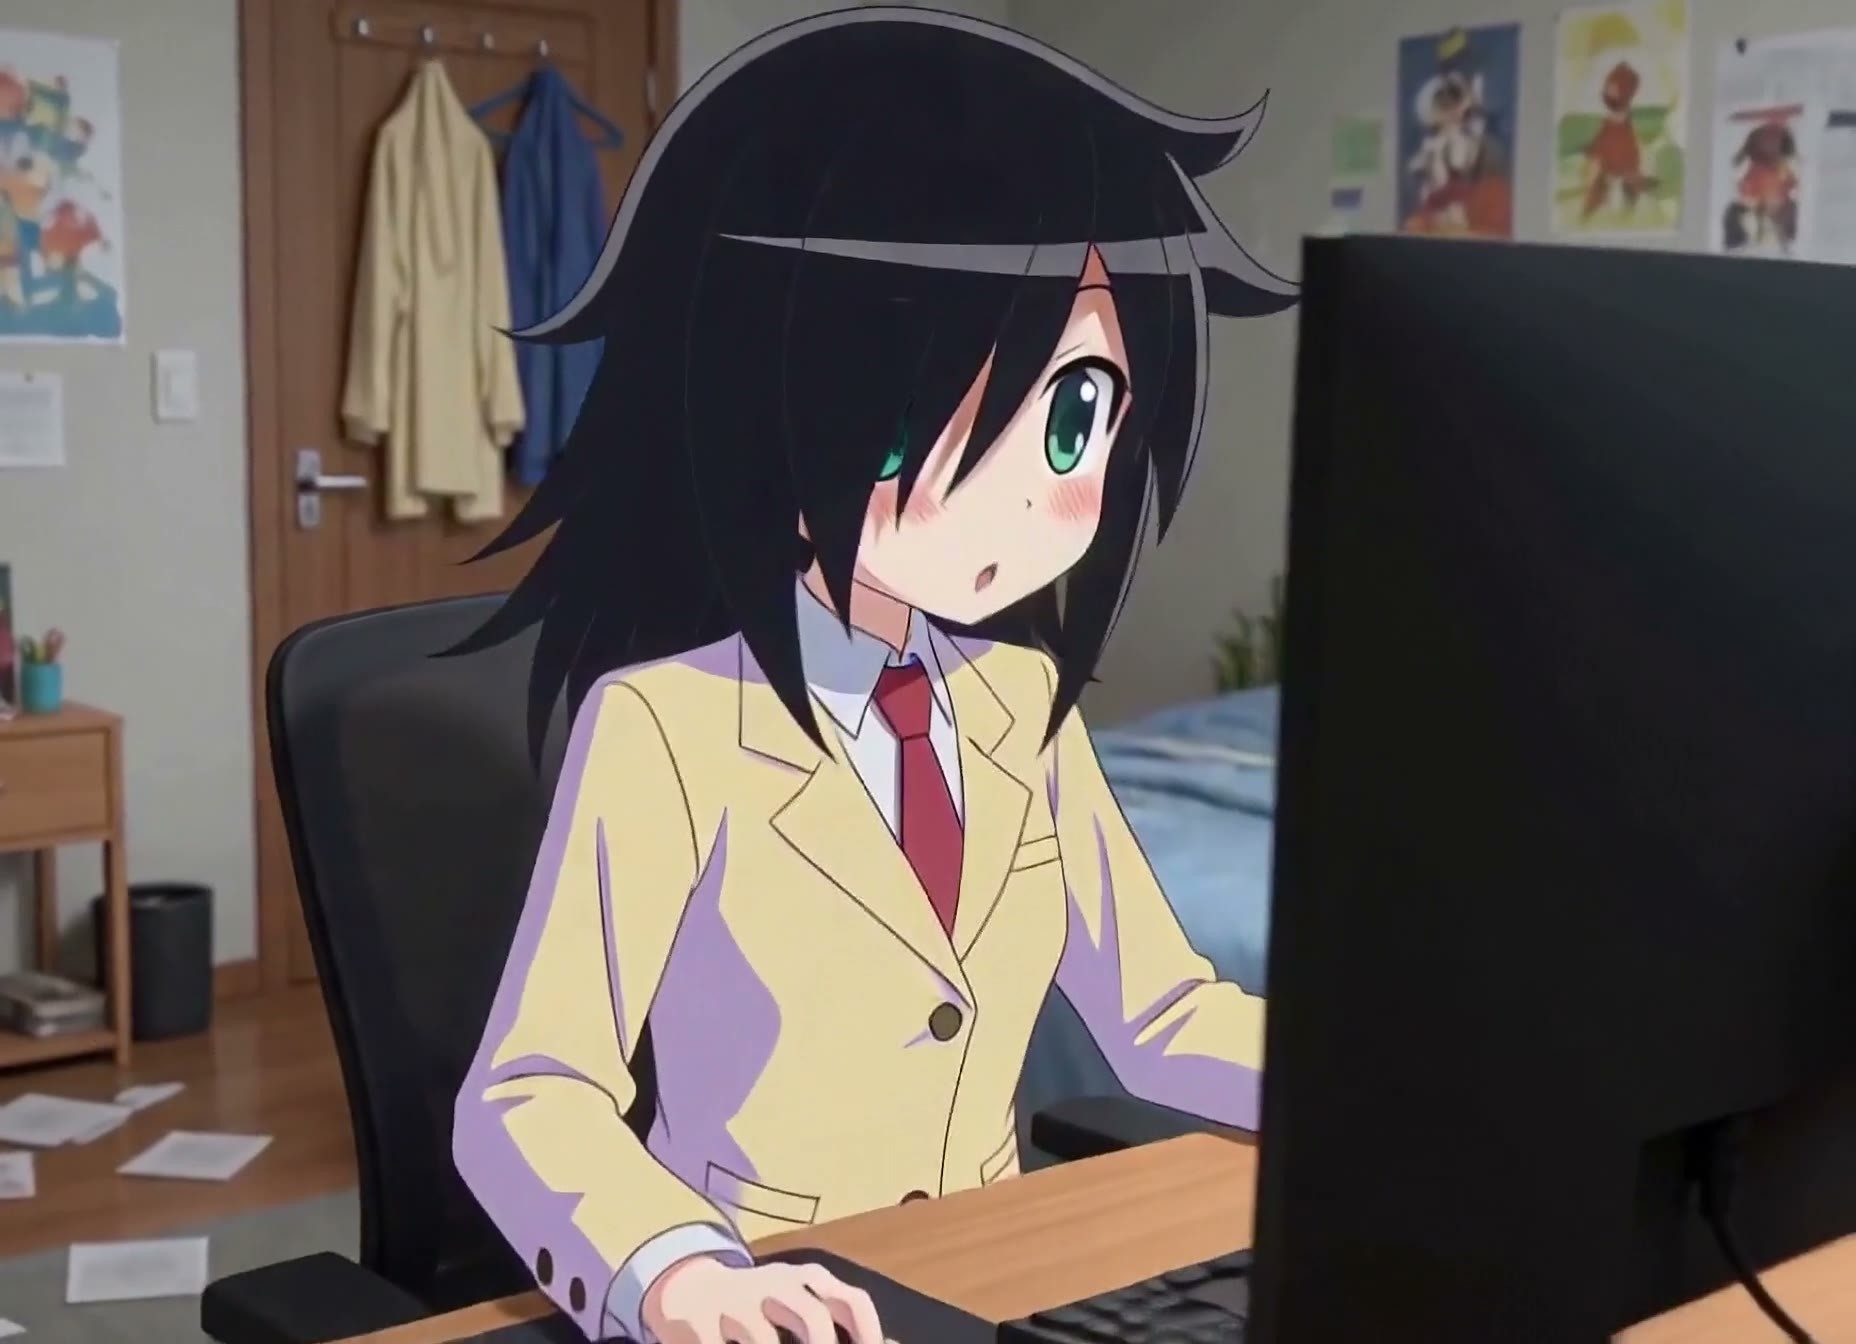
配图
推荐理由
- 新模型(站内首个版本,版本名 v1.1):先生成一小段“锚点”片段,把它的首尾帧编码进下一个采样器并遮罩保护,再用同一提示词生成从锚点结尾走回开头的“桥接”片段,最后把两段的画面和音频交叉淡化拼成循环
- 服务循环短视频、原地动作 / 舞蹈循环、背景动图这类需求;文生(T2AV)、图生(I2AV)、参考生(Ref2AV)和现有视频(须 24 fps)四种入口都能用,作者称可配任意 H3 微调底模和 LoRA 组合
- 可调分辨率、锚点和桥接时长、重叠长度、循环次数,成片可选 RTX 放大和插帧;默认配置用 Larryvrh 的 turbo LoRA 跑 6 步,锚点和桥接都用 CK+SLA 混合注意力
- 卡上列的 V1.1 改动:turbo LoRA 换成 ComfyUI 优化版以修复张量尺寸不匹配报错(不再需要旧 LoRA 的节点包)、调整采样参数、视频 VAE 换成 int8、给 STAGE 2 加静音开关,可以先只重抽 STAGE 1 的种子找合适的循环底片
- 有 5 段可见示例视频,部分带提示词;免费,许可允许出图、出租、售卖和售卖融合;发布约 4 小时 56 次下载(只代表关注度)
怎么用
- 解压 perfectLooperMinimaxH3T2AV_v11 压缩包导入 ComfyUI,大部分节点用 Manager 的 Install missing custom nodes 补齐;作者的 ComfyUI-CoolB-Nodes 要更新到最新版,ComfyUI-H3-Motion-Context-MultiRef 不在 Manager 里、要手动下载;另需 rgthree、KJNodes、VideoHelperSuite 和 Nvidia VFX 节点(放大 / 插帧)
- 模型:任意 H3 主模型(作者自用 Singularity ref2va 剪枝 int8 版),文本编码器和 VAE 用官方 Comfy-Org/MiniMax-H3 仓库,turbo LoRA 用 drbaph 仓库里 ComfyUI 优化版的 Larryvrh LoRA,6 步
- 提示词照工作流里的模板写能闭合的动作,如“角色原地做某个动作,固定镜头”或“镜头绕场景转一整圈”;接不上就改视频时长或换锚点 / 桥接的种子;循环现有视频时在提示词里写清桥接段如何从结尾过渡回开头;尽量不要生成音乐
风险与限制
- 复杂动作不保证闭合:动作在空间和时间幅度上都要能接回去,否则桥接段会在结尾帧前出现硬切;节拍几乎对不上,作者建议不生成音乐、后期另配
- 依赖多:一个节点包要手动装;Nvidia VFX 节点的插帧需要 RTX 40 系以上显卡,其余功能需要 cu130+ PyTorch,不满足就换别的放大 / 插帧节点
- 用 VHS 节点保存的循环视频结尾会多一点空音频,再次首尾拼接前要剪掉 2–3 ms,否则循环处会有声音跳变
- 作者测试环境为 ComfyUI 0.42.0/0.43.0、PyTorch 2.14.0+cu130、RTX 4080 SUPER、64 GB 内存;上传版是 0.7 MP、7 秒示例的设置,作者称总耗时 156 秒(不含加载),两阶段采样分别 17 秒和 84 秒;本条未运行
- 4 个敏感级示例已隐藏,作者在提示技巧里有擦边暗示
推荐(1)
【A】Minimax-H3-Komikku | Video → Manga/Comic Page (ComfyUI) · v1.0
工作流 · 新模型 · 作者 paralaif_xox · 发布 10-31 01:44 · 下载 32
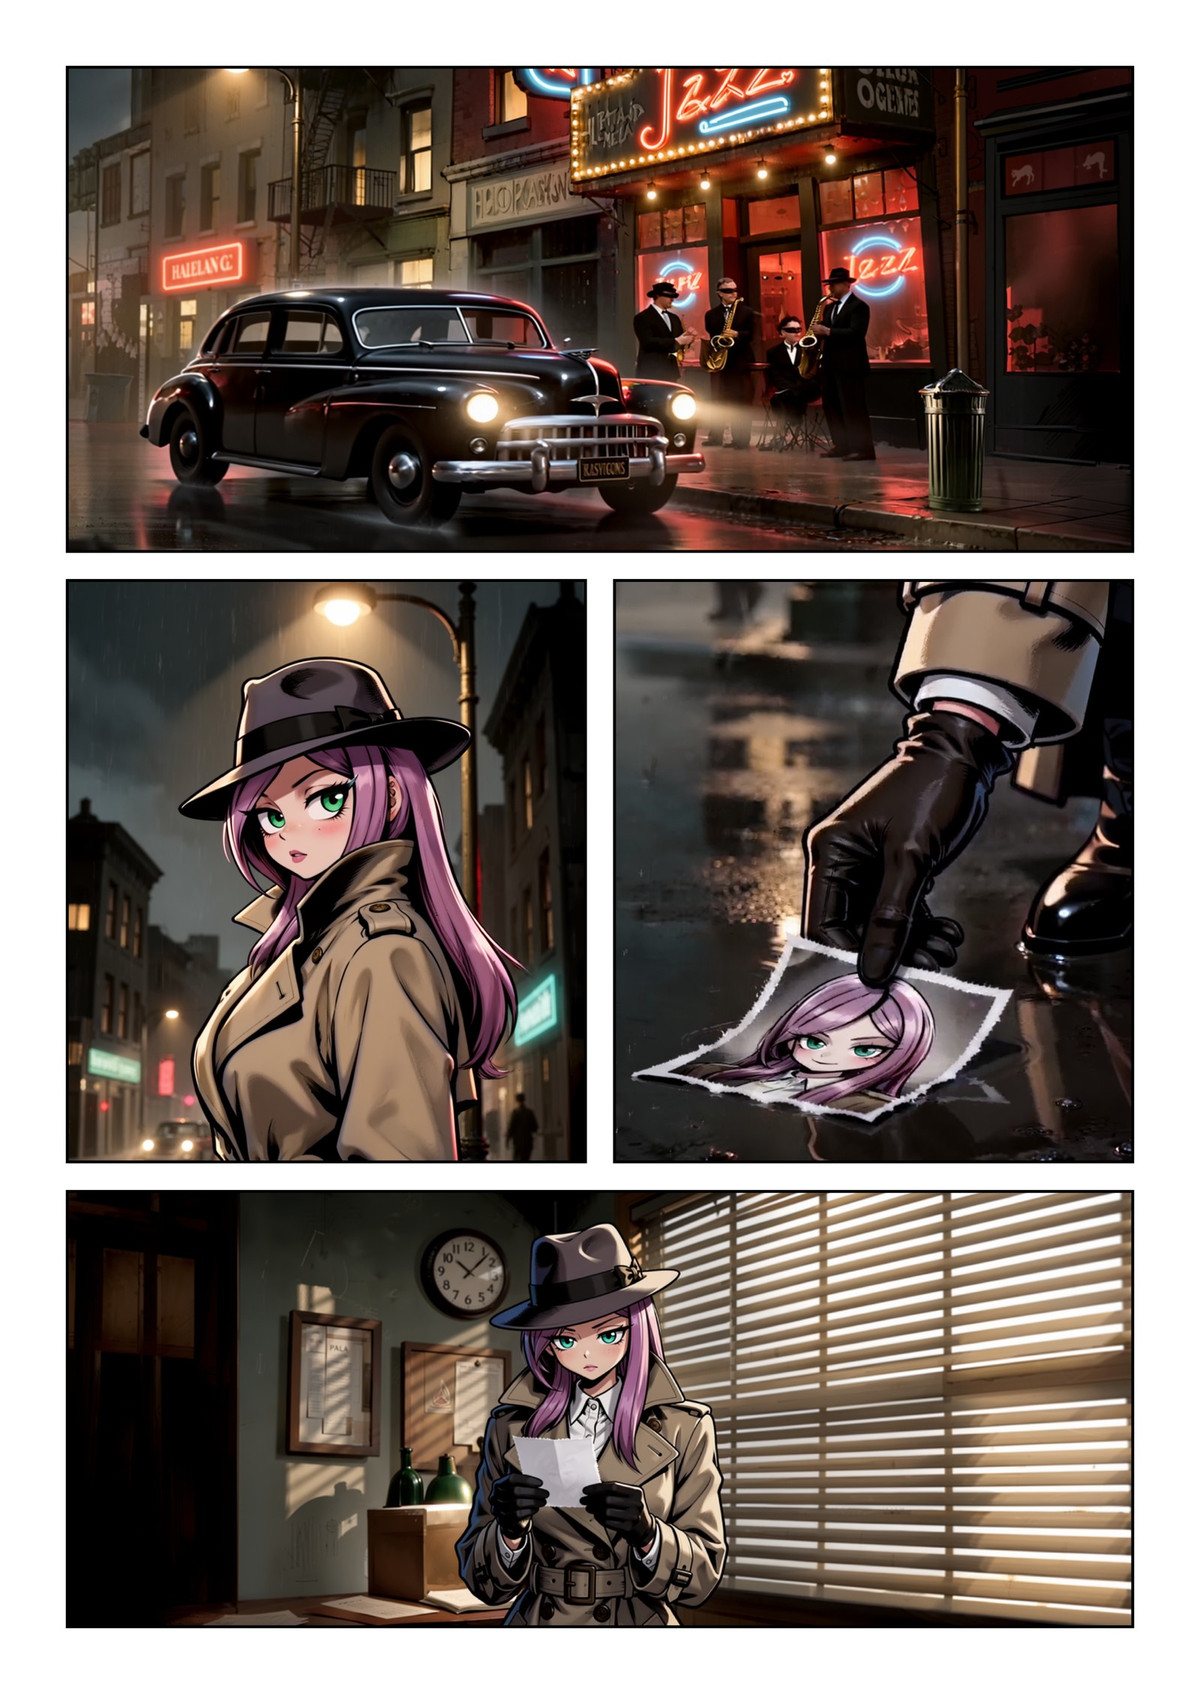
一套把 MiniMax H3 参考生视频的多镜头输出做成完整漫画页的 ComfyUI 节点包和工作流:先排版面,每个分格对应视频里的一个硬切镜头,再把每个镜头的画面放回分格并加对白。
由 B 升为 A:把多镜头视频转成漫画页是本期最有新意的工作流,流程和安装说明清楚、MIT 开源;但依赖多个模型,站内只有 1 张示例。
配图
推荐理由
- 新模型:Komikku Page & Shots 是全屏版面编辑器(预设、自由、斜切和多边形分格、刀切),点分格写这一格的镜头内容,节点自动拼出带时间戳的 H3 多镜头提示词
- 完整流程:H3 ref2vid 用最多 4 张角色参考图生成多镜头视频 → 场景检测每个镜头取一帧 → FLUX 3 Klein 按分格比例重构画面 → 可选 MOSS-Image 高清化到 5 MP → 在 Komikku Page Compose 里移动、缩放图片,加说话、思考、喊叫、耳语、旁白、拟声词等文字框,叠加图层,用收藏库和自定义字体
- 可选用本地文本编码器 MOSS Qwen3.5-9B 改写镜头描述并建议对白;附主工作流(1:1 视频)和超级英雄、侦探、日漫、暗黑四种题材示例
- MIT 开源、免费,许可允许出图、出租、售卖和售卖融合
怎么用
- 装作者节点 github.com/quinteroac/ComfyUI-Minimax-H3-Komikku,另装工作流说明里列的 ZNGB-SceneDetect、VideoHelperSuite、Pixaroma、rgthree、comfyui-obvpm
- 解压 minimaxH3KomikkuVideo_v10.zip 导入主工作流,先把自己的角色图放进 Picture 1 再运行;Manga 示例用到网点 LoRA manga_tone_v2,触发词「manga-tone rendering」
- H3、FLUX 3 Klein、MOSS-Image 的具体模型文件和步数、CFG 作者未给
风险与限制
- 依赖多:同时要 H3 和 FLUX 3 Klein,可选 MOSS-Image 和 MOSS Qwen3.5-9B,外加五个第三方节点包
- 只有 1 张可见示例图(无提示词),另 3 个敏感级示例已隐藏;首个版本;本条未运行
可关注(2)
【B】Singularity-V2-x-10Eros-Max · PIKA72
底模 / Checkpoint · 版本更新 · 作者 0l1v1aR0551 · 发布 10-30 21:07 · 下载 508
一个 H3 参考生视频(Ref2VA)合并底模:用作者自制的 PRISM 算法把 Singularity V2 和 10Eros-Max(8 步 turbo)两个微调合在一起,这一版 PIKA72 再把 Pika-Labs 的 Pika-H3-Flex LoRA 按 1.00 或 0.85 的强度直接融进权重。
由 S 降为 B:只讲了合并方法和内置 LoRA 的强度,没说这个 LoRA 改变什么、没给步数和采样参数,两个文件也分不清;下载快只说明关注度高。
配图
推荐理由
- 版本更新(第 4 个版本):作者称按用户要求,在 BETA7 x Singularity-V2 的基础上内置了 Pika-H3-Flex LoRA,有 1.00 和 0.85 两种强度,省去另外加载这个 LoRA
- 作者称 PRISM 能减少把 turbo 模型并进底模时的权重伪影:用随机 SVD(rank 64)过滤扩散噪声增量,方向 SLERP 加对数空间幅度插值,并解决符号冲突、重新校准层归一化
- 同一模型页还有 CLASSICS(Singularity V1.3 x 10Eros-Beta5)和 BETA72(Singularity V2 x 10Eros-Beta7)两个版本可对照;作者的 Hugging Face 仓库有 fp16、int8、w6a8 三种精度
- 发布约 12 小时 508 次下载,模型累计 3670 次(只代表关注度);免费,许可允许出图和站内出租
怎么用
- 下载 int8 safetensors(约 21.3 GB)替换 H3 ref2va 底模加载;模型页的两个文件同为 int8、大小相同,文件名看不出哪个是 1.00、哪个是 0.85
- 其他精度在 Hugging Face 的 OliviaRossi/Minimax-h3_Singularity-x-10Eros-Max_PRISM;步数、CFG、采样器作者未给(合并来源 10Eros-Max 是 8 步 turbo)
风险与限制
- 作者未写更新说明(changelog 为空),只有版本描述里一句话,也没说 Pika-H3-Flex LoRA 本身带来什么效果
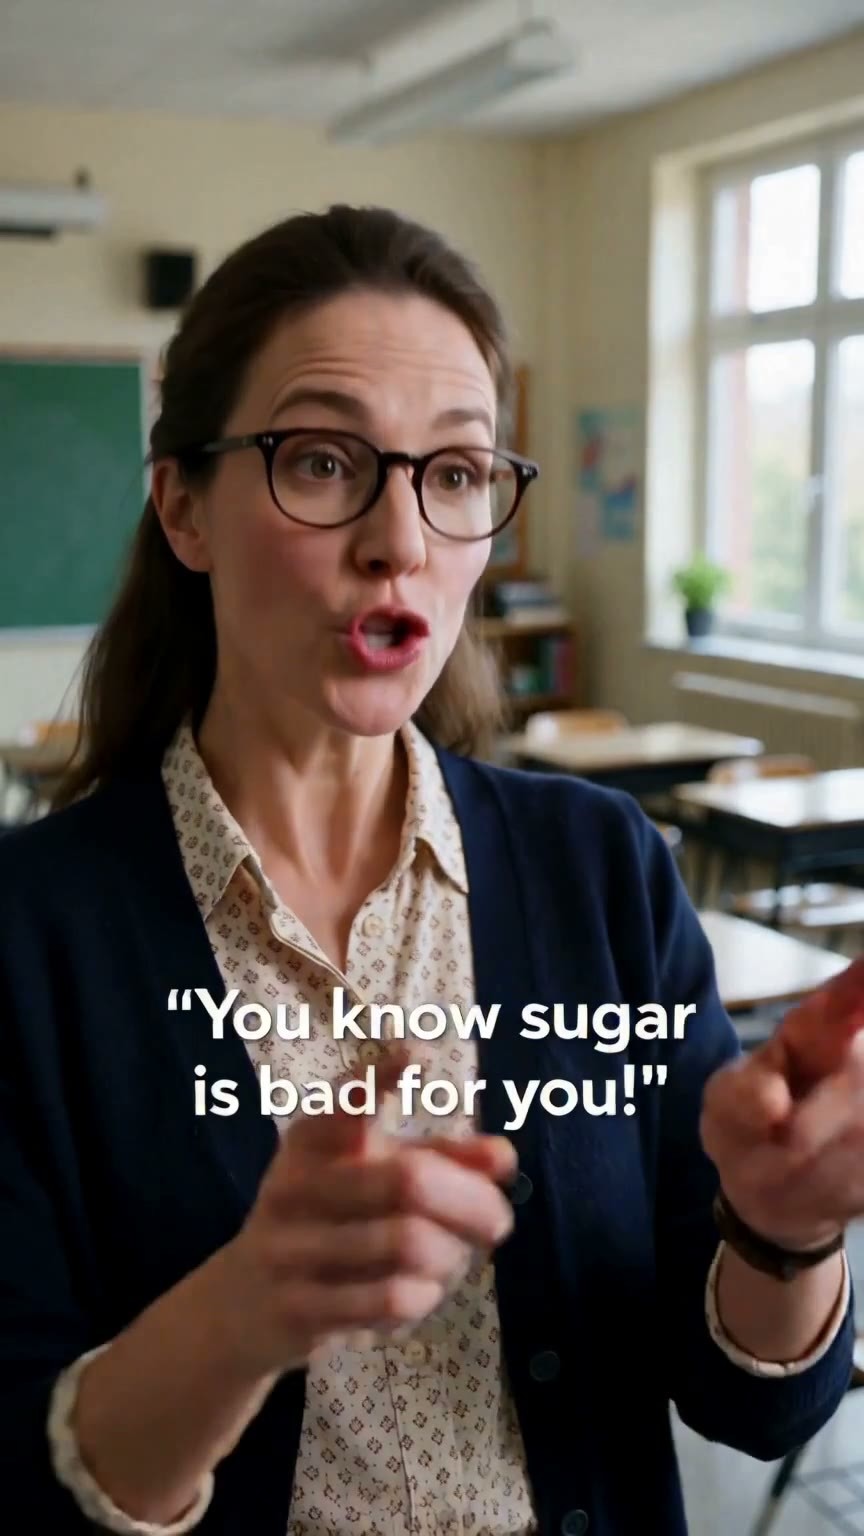
- 三方合并模型,没有推荐步数和采样设置;可见示例只有 1 段视频 + 1 张图,另有 3 个敏感级示例已隐藏;本条未运行
- 内置 LoRA 和两个来源微调的许可需自行核对
【B】MiniMaxH3. Single frame edit · v0.1
工作流 · 新模型 · 作者 brainburns894 · 发布 10-30 23:40 · 下载 88
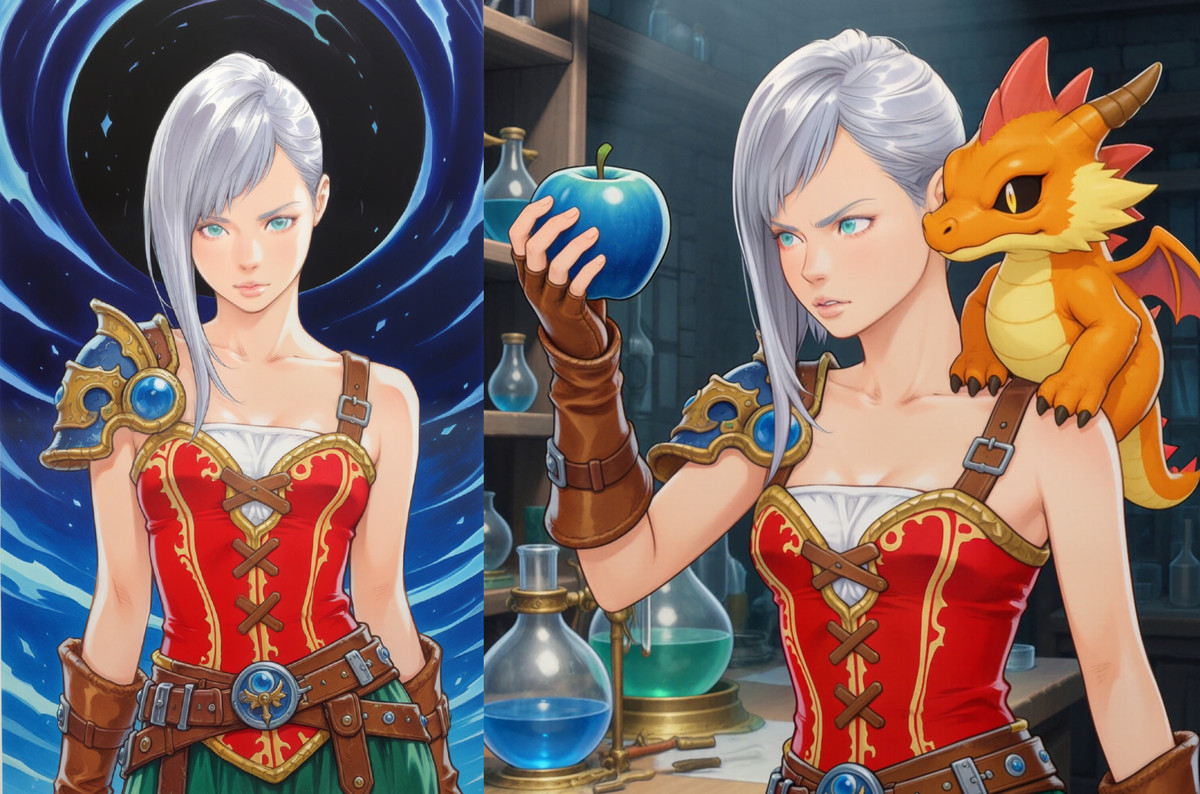
把 MiniMax H3 当图像编辑模型用的 ComfyUI 工作流:只生成单帧,支持多张参考图和姿势复制;这个 v0.1 主要用来给角色改姿势。
由 A 降为 B:思路新、有 3 张示例,但说明只有几行,依赖和参数都没给,两个文件的区别也不清楚。
配图
推荐理由
- 新模型:作者称能用 H3 做单帧图像编辑,服务“同一角色换姿势、按参考图改图”的需求,这是视频模型少见的用法
- 作者给了两条技巧:在提示词的 detailed_description 部分写清输入图的画风(如 monochrome sketch、expressive digital illustration、anime screencap),作者称这样能保住原图风格;目标尺寸不要低于 2.0 MP
- 有 3 张可见示例图;免费,许可允许出图、出租、售卖和售卖融合
怎么用
- 导入 minimaxh3SingleFrame_v01_3337169.json 或 minimaxh3SingleFrame_v01_3337171.json(147 KB / 161 KB,两者区别作者未说明),用 Manager 补齐缺失节点;需要的节点、H3 模型文件、步数和 CFG 作者未给
风险与限制
- 模型卡只有几行,没列依赖节点和模型;v0.1 早期版本,版本说明只有一句
- 5 个敏感级示例已隐藏;工作流 JSON 不是新权重;本条未运行
仅收录(4)
- MiniMax H3 2K Upscale Workflow · v1.0 — 工作流:一个 MiniMax H3 2K 放大 ComfyUI 工作流;模型卡只有一句介绍,安装方法和原理都放在外链 YouTube 视频里。
- Fern :: bvga Character Style · v1.0 — LoRA:角色 Fern 的 H3 LoRA,作者用自己画风的图训练:紫发、衬衫、半写实动漫插画风。
- Darcy Belwyn · MiniMaxH3 — LoRA:原创虚构女性角色 Darcy Belwyn 的 H3 LoRA;模型卡是一段人物小传(布鲁日世家出身、修复古籍),没有用法说明。
- Kaida Pax · v1.0 H3 — LoRA:原创绿龙族女性兽人角色 Kaida Pax 的 H3 LoRA,触发词 kaidapax;模型卡是一段角色性格介绍。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 10-30 20:31 → 10-31 09:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。