정정의 AI 레이더 · MiniMax H3 · 2026-11-11 저녁 브리핑
이번 호 11개 신규 버전: 강력 추천 1 · 추천 5 · 관심 권장 3 · 단순 수록 2
편집자 주 이번 호에서는 11개의 H3 신규 버전을 검토했으며, S급 1개, A급 5개, B급 3개, C급 2개로 분류했습니다. 최신 추천은 MMH3 피부 리얼리즘 LoRA V2의 ref2va 버전입니다: 참고 이미지 속 얼굴의 플라스틱 반사를 제거하고 자연스러운 피부 질감을 복원하며, 같은 페이지의 Base H3 및 fl2va 두 파일은 베이스 모델에 따라 번호를 재부여하여 A급으로 분류했습니다. 또한 Hand Tie Clips 3.5.1의 ic 업스케일링, KinetiX 비 효과 슬라이더, 캐릭터 설정표 워크플로우의 H3 Image 버전이 A급으로 분류되었습니다. Score to Screen v8.2은 가시적인 예시가 없고, 투명화 효과 LoRA는 예시가 모두 숨겨져 있으며, 키리조 미츠루 목소리 LoRA는 음성 저작권 문제가 있어 모두 B급으로 분류되었습니다.
강력 추천 (1)
【S】MMH3 리얼리즘 슬라이더 V2 — HyperFlow H3 Flash & MiniMax H3 · V2 - ref2va
LoRA · 버전 업데이트 · 작성자 voidhunter77 · 게시일 11-11 18:05 · 다운로드 수 185
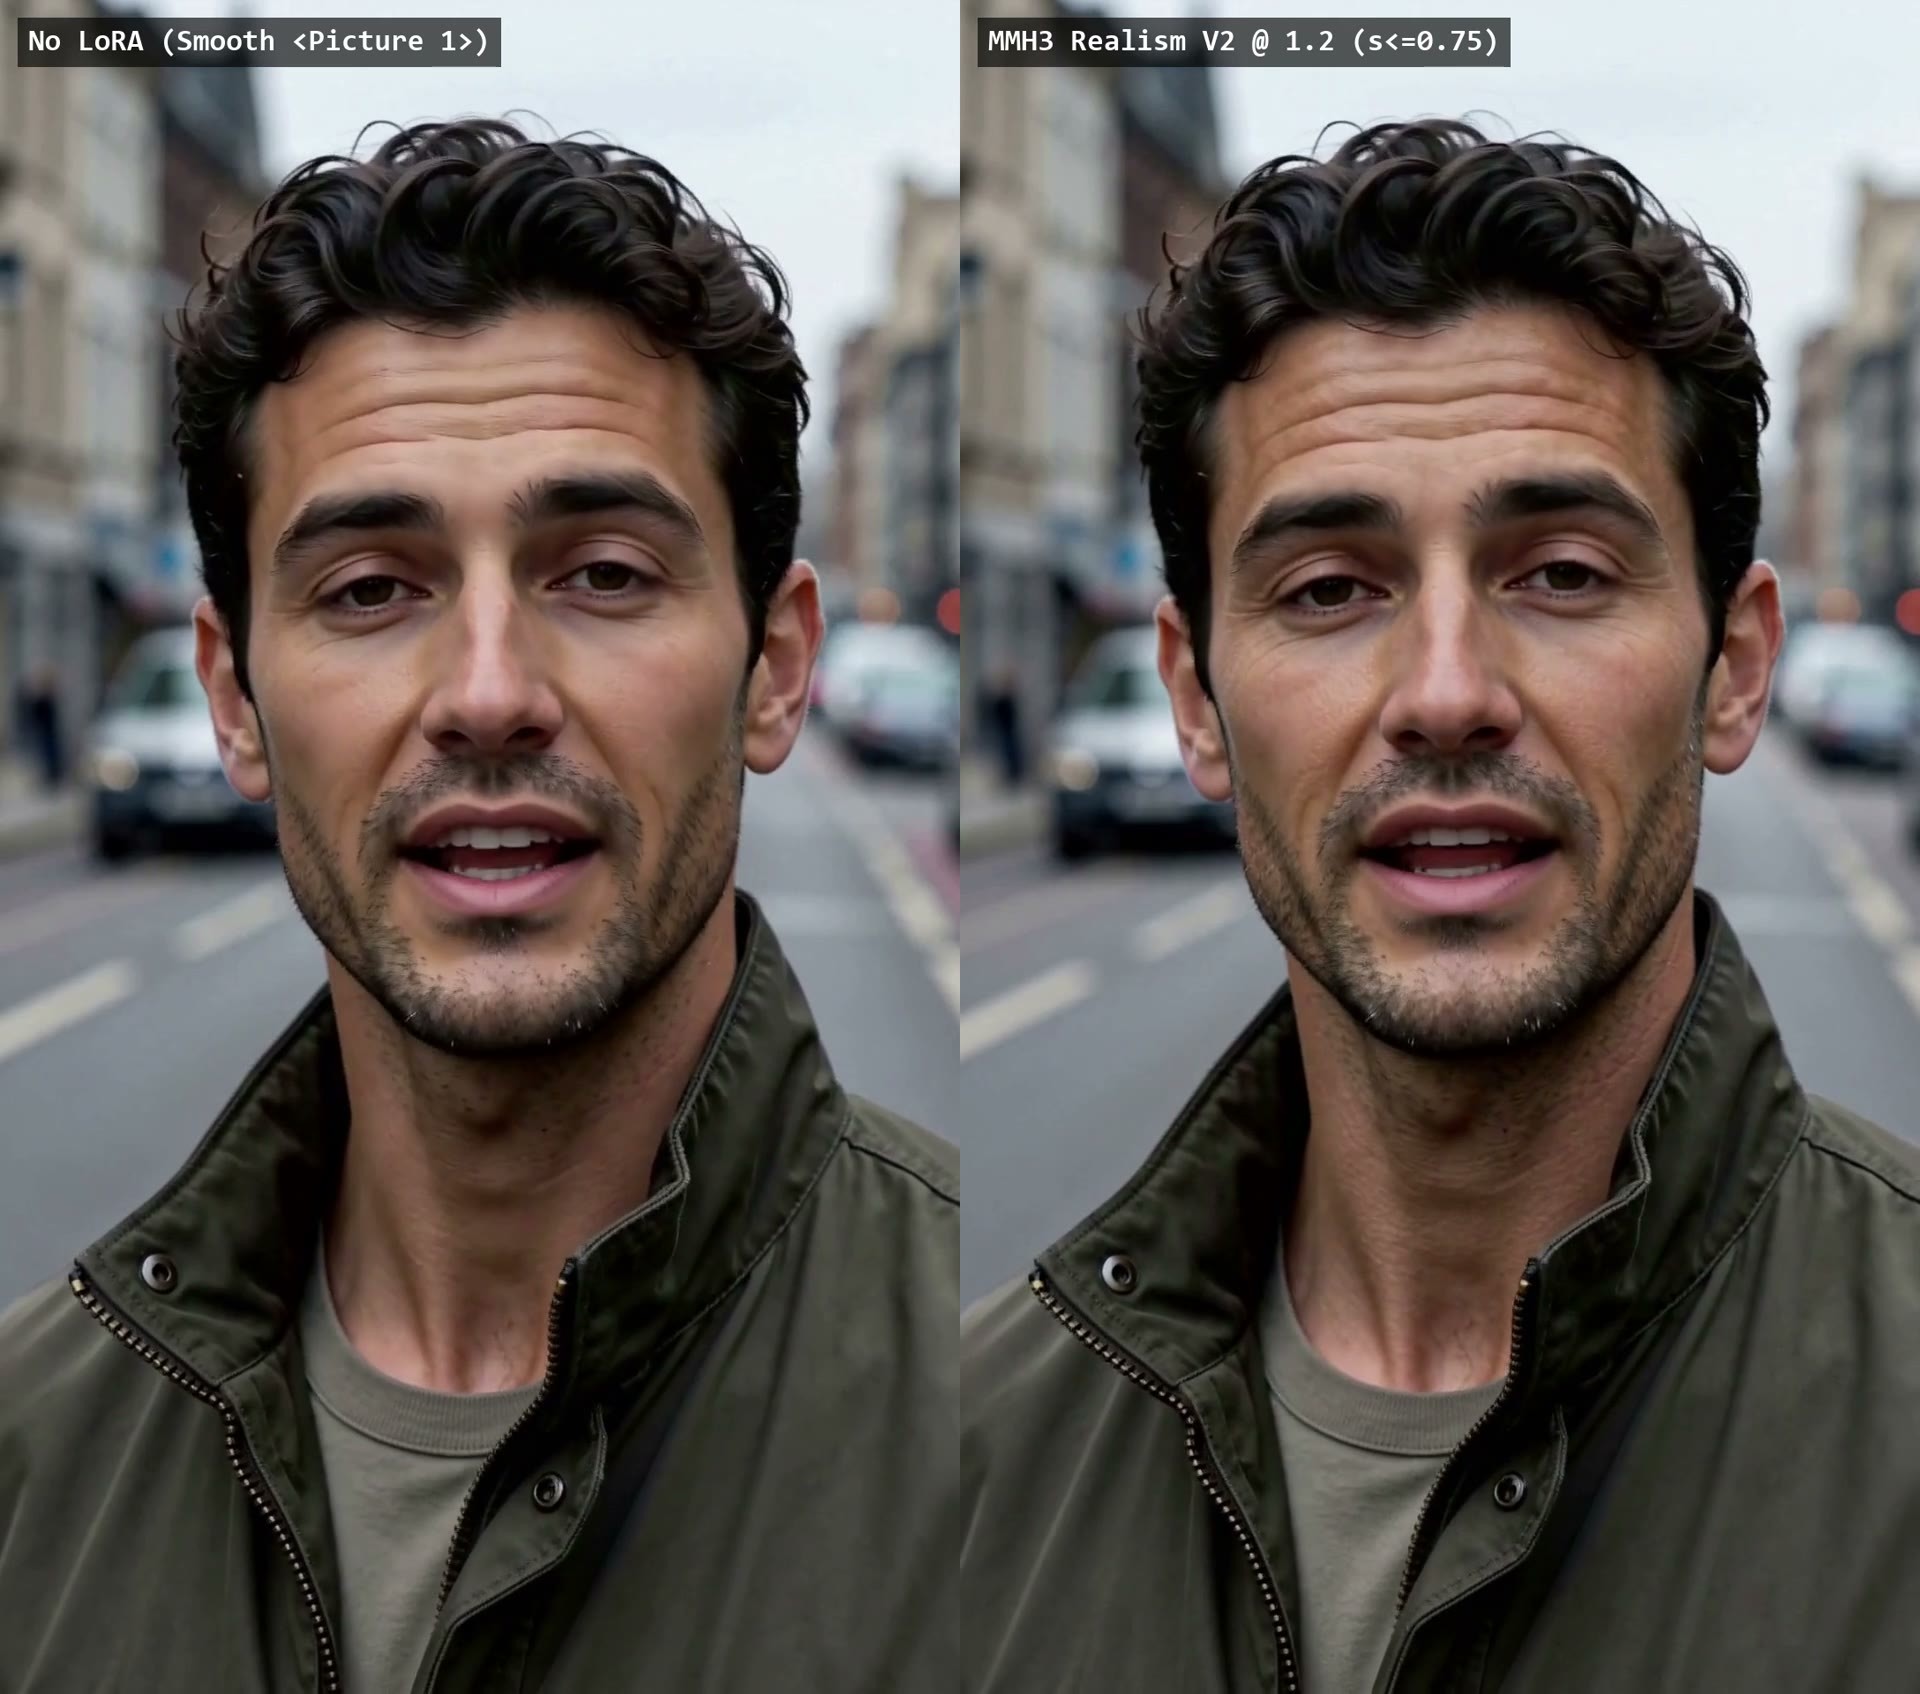
피부 리얼리즘 LoRA V2의 HyperFlow H3 Flash ref2va 전용 버전: 참고 이미지 속 인물 피부의 플라스틱 반사를 제거하고 자연스러운 피부 질감을 복원하되, 속눈썹, 홍채, 수염은 건드리지 않습니다.
같은 페이지의 세 파일은 동일한 학습 결과물을 서로 다른 베이스 모델에 맞춰 번호를 재부여한 것이므로, 사용 중인 모델에 해당하는 파일을 다운로드하면 됩니다.
예시 이미지
추천 이유
- 버전 업데이트: V1는 alcaitiff 원본의 rank 1 슬라이더 이식으로 MLP만 학습시켰기 때문에, 참고 이미지에서 매끄러운 인물은 셀프 어텐션을 통해 이를 '우회'하여 거의 변화가 없습니다. V2는 처음부터 rank 16으로 학습되었으며, 셀프 어텐션(qkv_proj, out_proj)과 MLP(fc1, fc2)를 모두 학습하여 blocks 23–47의 총 100개 레이어를 커버합니다
- 참고 이미지 기반 영상 생성(ref2va) 및 시작/종료 프레임 영상에서 얼굴의 플라스틱 느낌이 과도한 문제를 해결합니다. 작성자는 밝은 피부, 올리브 톤, 동아시아, 남아시아 및 어두운 피부 톤에서 테스트했으며, 입자 추가나 노화 현상은 보이지 않았고, 눈, 눈썹, 수염, 머리카락은 움직임과 1080p 최종 영상에서 선명하게 유지된다고 밝혔습니다
- HyperFlow ref2va의 49개 block에 맞춰 번호를 재부여했습니다(해당 모델은 H3의 block 9를 제거함). ComfyUI 기본 로더로 모든 100개 레이어를 로드할 수 있으며, 6개 영상 + 1개의 가시적인 예시 이미지를 제공합니다
사용 방법
- ComfyUI 기본 LoraLoaderModelOnly로 로드하며, minimax_h3_ref2va_hyperflow_flash_14b와 함께 사용하세요. 강도 0.65–0.85, 기본값 0.75입니다. 트리거 워드는 없습니다
- H3 Editor(comfyui-h3-editor)를 사용하는 경우, 같은 페이지의 V2 - Base H3 파일을 사용하세요. 이 도구의 H3 LoRA 노드는 자동으로 번호를 재부여합니다
리스크 및 제한 사항
- HyperFlow ref2va 모델 전용입니다. 원본 50 block의 H3는 Base H3 파일을 사용해야 하며, 순수 프롬프트 기반의 fl2va는 fl2va 파일을 사용해야 합니다
- 1개의 예시가 숨겨져 있습니다. 피부 톤 및 디테일 유지 효과는 작성자의 주장에 따릅니다
추천 (5)
【A】Hand Tie Clips — 멀티홉 MiniMax H3 영상 + 오디오, 단일 큐 · v3.51
워크플로우 · 버전 업데이트 · 작성자 sandpies · 게시일 11-11 18:42 · 다운로드 수 19
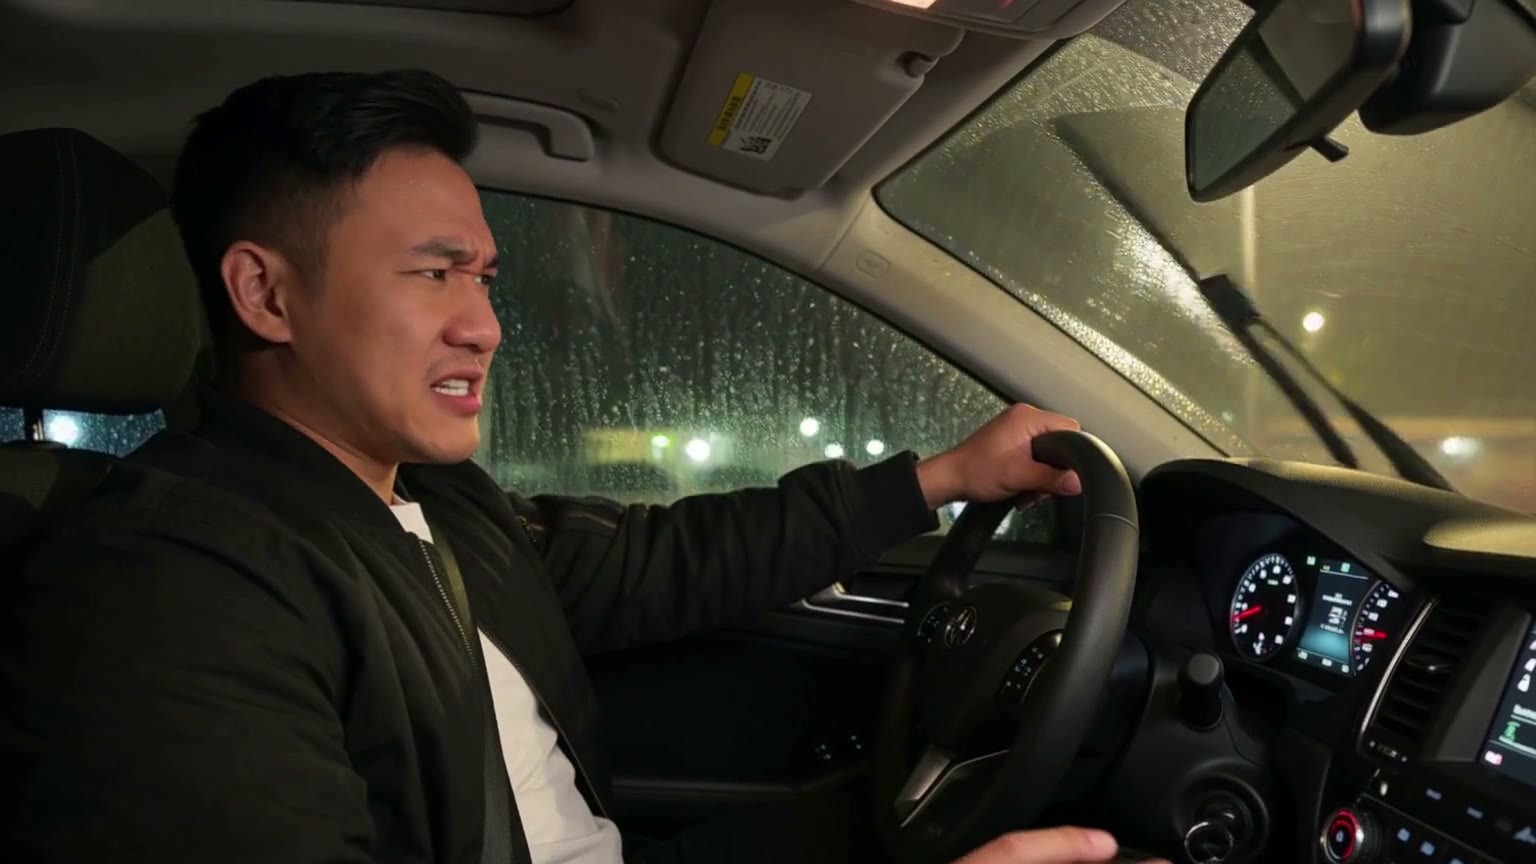
멀티홉(multi-hop) H3 오디오/비디오 장편 워크플로우 3.5.1에 ic 업스케일링이 추가되었습니다. 각 구간을 리렌더링할 때 전체 영상을 보고 배경음악을 들을 수 있으며, 얼굴, 텍스트, 립싱크는 원본 상태를 유지합니다.
예시 이미지
추천 이유
- 버전 업데이트(3.5.0 + 수정): ic 업스케일링은 NVlabs의 Open-H3-Regenerate-2K-IC를 기반으로 하며, Kijai의 minimax_h3_open_regenerate_2k_ic_lora(200 MB)와 minimax_h3_hyperflow_8step LoRA가 필요합니다. 태스크 프롬프트는 사전 인코딩되므로 26 GB의 텍스트 인코더를 로드할 필요가 없습니다
- upsample_steps 추가: 3단계는 레시피 기준, 2단계는 더 빠릅니다. 작성자는 2단계가 약 1/3 더 빠르고 테스트 결과 시각적 품질은 동일하다고 밝혔습니다. H3 Token LoRA 로더가 추가되어 영상, 배경음악, 참고 이미지, 프롬프트의 강도를 각각 설정할 수 있습니다. 예를 들어 audio를 0으로 설정하면 스타일 LoRA가 보컬에 영향을 미치지 않습니다
- Realism Boost가 Upscale 2nd Pass(마지막 구간 이후 확대하고 사용자 LoRA로 텍스처를 리렌더링)로 변경되었습니다. 얼굴 교체/편집은 Viggle remake LoRA를 사용하도록 변경되었습니다. 하드 컷 시 이전 컷이 깜빡이는 현상, motion_context 이음새가 밝아지는 문제 등이 수정되었습니다. 1개의 가시적인 예시 영상을 제공합니다
사용 방법
- RUN 페이지에서 UPSAMPLE 그룹을 열고 upsample method를 ic로 설정하세요. 두 LoRA는 models/loras 폴더에 배치합니다
- ic는 공식 비프닝(minimax_h3_ref2va_*) 모델만 지원하며, 프닝 버전, fl2va, 융합 모델은 지원되지 않습니다(잘못된 경우 실행 전 오류 메시지가 표시됩니다)
- 첫 번째 패스는 6–8단계로 오디오 품질을 보장합니다(4단계 turbo는 4단계 사용). Upscale 2nd Pass는 2–3단계를 사용합니다
리스크 및 제한 사항
- ic는 Regen2K보다 느립니다. 의존성이 많으며(KJNodes, Viggle remake LoRA 등), 구버전 KJNodes는 밀집 어텐션으로 폴백됩니다
- 3개의 예시가 숨겨져 있습니다. 업데이트 설명은 이미 이 워크플로우를 사용 중인 사용자를 대상으로 하므로 초보자가 익히기에는 진입 장벽이 높습니다
【A】KinetiX Weather System Series · Rain & Downpour v1.0
LoRA · 버전 업데이트 · 작성자 make676767 · 게시일 11-11 18:17 · 다운로드 수 46
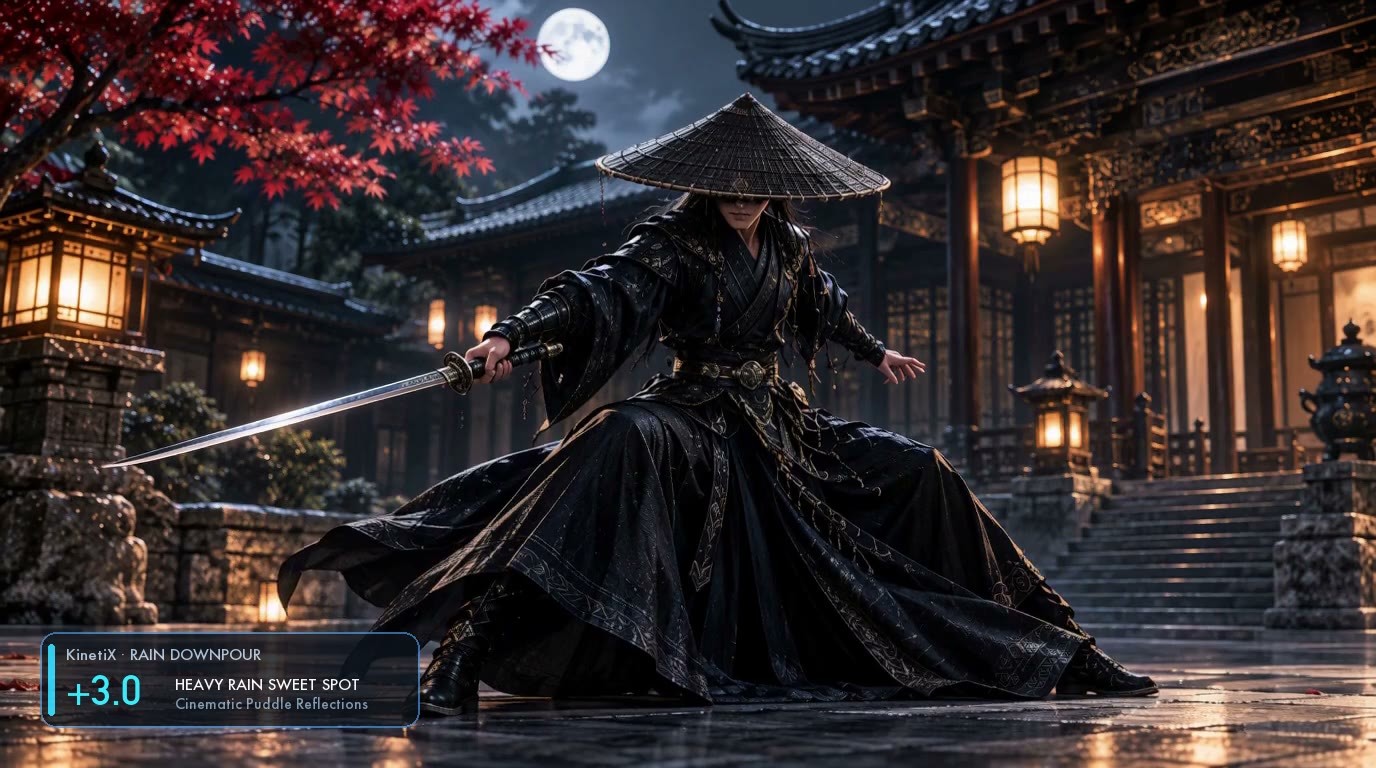
KinetiX 날씨 슬라이더 시리즈의 비 효과 LoRA: 가중치를 통해 비의 양을 선형적으로 제어하여 가랑비, 폭우, 소나기까지 표현할 수 있으며, 음수 값을 사용하면 화면이 맑아지고 지면이 마릅니다.
예시 이미지
추천 이유
- 버전 업데이트(동일 시리즈의 3번째 버전으로, 이전에는 Snow & Blizzard와 Day to Night가 각각 다른 날씨를 담당했으며, 동일 LoRA의 개선 버전이 아님): 공중의 빗줄기 밀도, 빗방울이 튀어 오르는 물안개, 지면 고인 물의 반사를 제어합니다
- 작성자가 전체 가중치 단계를 제공했습니다: +1.0 ~ +1.5은 가랑비로 젖은 지면, +2.0 ~ +3.0는 영화급 폭우(작성자 추천), +4.0 ~ +5.0는 소나기, -2.0 ~ -3.0는 맑고 마른 지면입니다. 동일 시리즈의 camera_shake, movement_amplitude, hit_stop 슬라이더와 함께 사용할 수 있습니다
- 바로 복사해 쓸 수 있는 장면 프롬프트(비 오는 밤 고전 정원의 검술, 사이버펑크 비 오는 밤 골목 등)가 포함되어 있으며, 5개의 가시적인 예시 영상을 제공합니다
사용 방법
- 트리거 워드는 없습니다. 프롬프트에 'It is raining.'을 추가하면 비가 내리는 것을 보장할 수 있으며, 비의 양은 가중치로 제어합니다
- ComfyUI strength_model은 +2.0 ~ +3.0부터 시작하세요. 작성자의 사이버펑크 비 오는 밤 조합은 rain_downpour +2.5와 camera_shake +0.8을 함께 사용하는 것입니다
리스크 및 제한 사항
- 추천 가중치가 일관되지 않습니다: 페이지 요약에는 +2.5 ~ +3.5로, 단계 표에는 +2.0 ~ +3.0로 기재되어 있습니다
- 작성자는 건물, 인물, 구도가 100% 변하지 않는다고 주장하지만, 적용 전후 비교 예시가 없습니다. 강도가 일반 LoRA보다 훨씬 높으므로 다른 LoRA와 겹쳐 사용할 때 주의해야 합니다
【A】MMH3 리얼리즘 슬라이더 V2 — HyperFlow H3 Flash & MiniMax H3 · V2 - Base H3
LoRA · 버전 업데이트 · 작성자 voidhunter77 · 게시일 11-11 18:08 · 다운로드 수 53
동일한 피부 리얼리즘 LoRA V2의 원본 H3 파일: 50 block을 가진 MiniMax H3용이며, H3 Editor가 모든 베이스 모델(두 HyperFlow 버전 포함)에서 사용해야 하는 파일이기도 합니다.
예시 이미지
추천 이유
- 버전 업데이트: ref2va 버전과 동일한 rank 16 학습 결과이며, 원본 번호 체계에 따라 blocks 24–48의 총 100개 레이어를 커버합니다. V1는 MLP만 학습하여 참고 이미지의 매끄러운 피부에는 거의 효과가 없으나, V2는 플라스틱 하이라이트를 제거하고 무광 자연 피부 질감을 복원합니다
- H3 Editor 사용법이 상세히 기술되어 있습니다: 강도 1.0–1.4, 기본값 1.2, start_sigma 0.75을 설정하여 초기 단계가 영향을 받지 않도록 하면 포즈와 구도가 LoRA를 적용하지 않은 결과와 유사해집니다. 볼이나 이마에 넓은 습한 하이라이트가 있을 경우 start_sigma 1.0, 강도 0.75을 시도해 보세요
- 3개 영상 + 1개의 가시적인 예시 이미지
사용 방법
- H3 Editor 0.3.0 이상: 해당 H3 LoRA 노드로 로드하며, 강도 1.2, start_sigma 0.75을 설정하세요
- ComfyUI 기본 LoraLoaderModelOnly: 원본 50 block H3에는 0.65–0.85을 사용하세요. 작성자는 MiniMax H3 Image에 적용할 경우 효과가 약하므로 1.2–1.6까지 높여야 한다고 밝혔습니다
- 트리거 워드는 없습니다
리스크 및 제한 사항
- HyperFlow 모델은 자체 로더를 사용할 때 해당 ref2va / fl2va 파일을 다운로드해야 하며, 이 파일을 사용하지 마세요
- 1개의 예시가 숨겨져 있습니다
【A】MMH3 Realism Slider V2 — HyperFlow H3 Flash & MiniMax H3 · V2 - fl2va
LoRA · 버전 업데이트 · 작성자 voidhunter77 · 게시일 11-11 18:05 · 다운로드 수 77
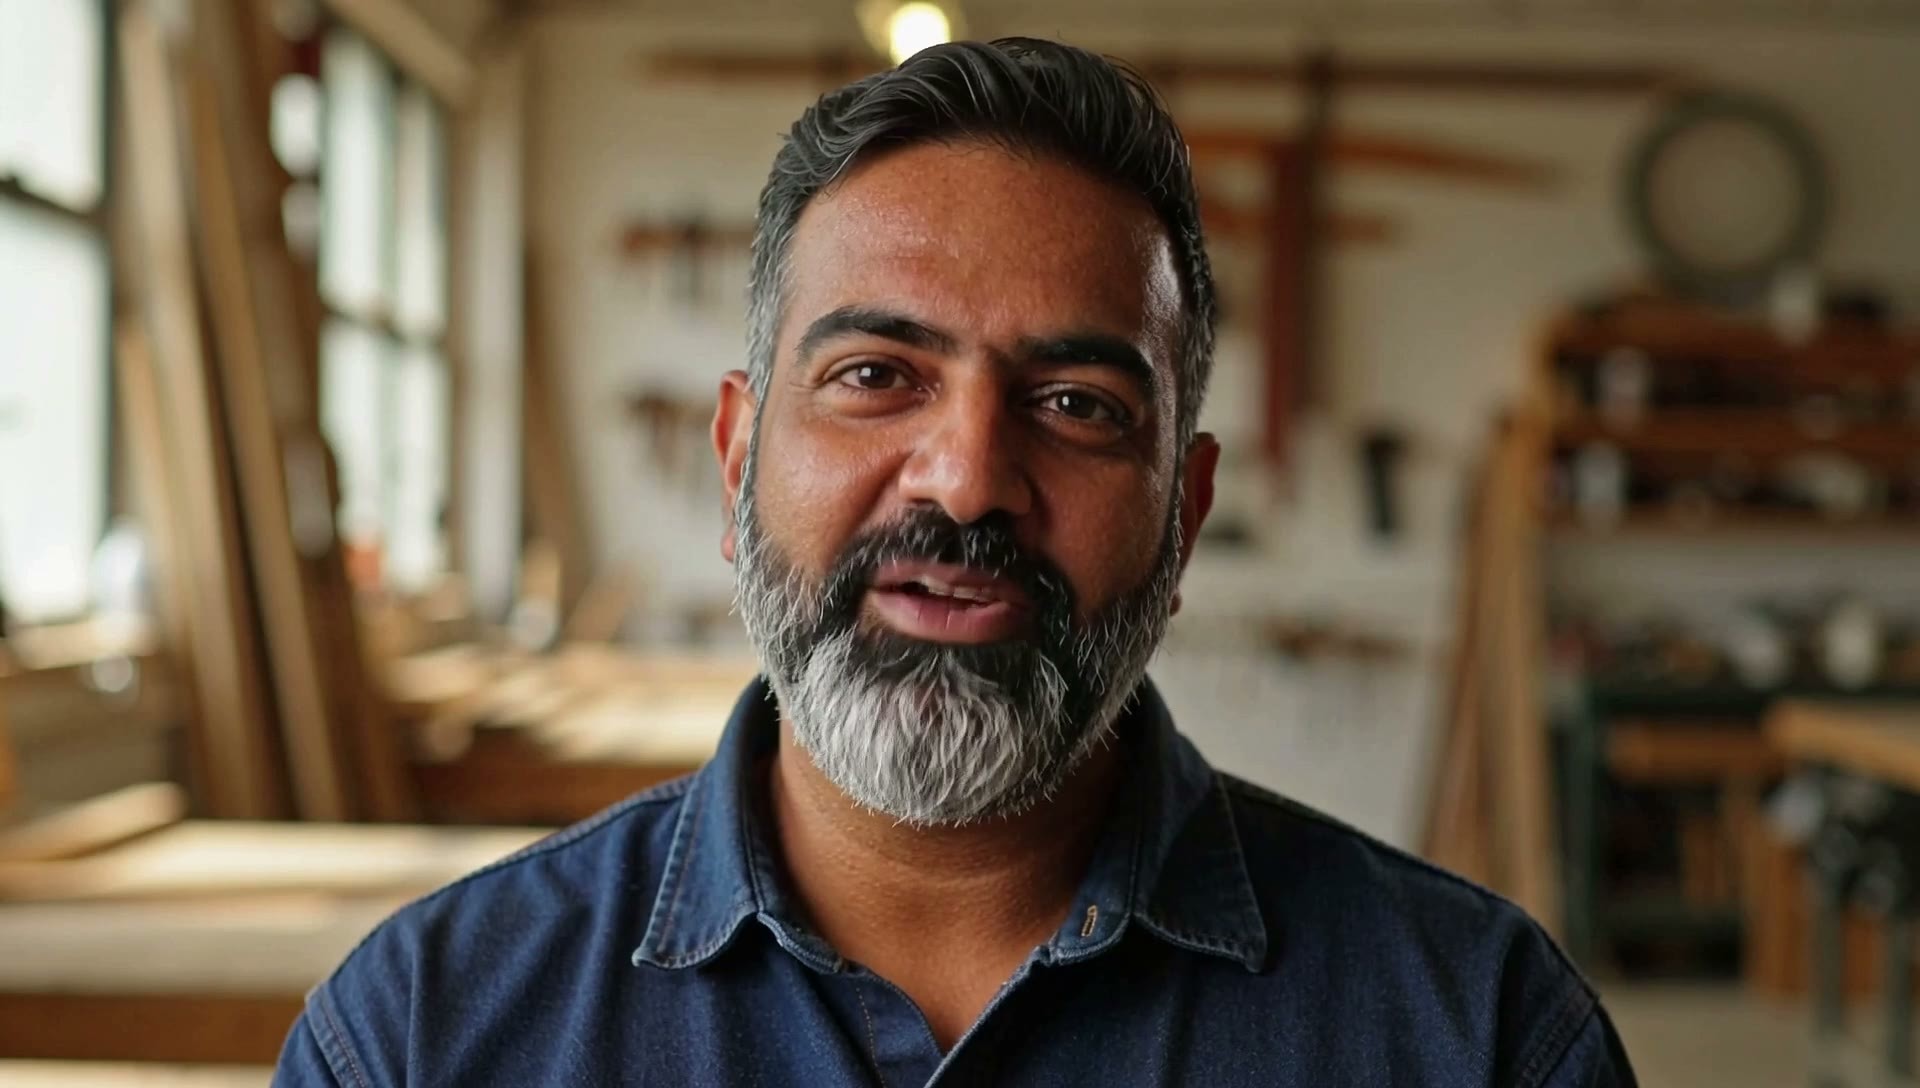
동일한 피부 리얼리즘 LoRA V2의 HyperFlow H3 Flash fl2va(순수 프롬프트로 영상 생성) 버전입니다.
이미지
추천 이유
- 버전 업데이트: fl2va의 47개 블록에 따라 번호를 재부여했습니다(이 모델은 H3의 블록 6, 21, 22를 제거했습니다). 블록 21–45의 셀프 어텐션과 MLP를 학습했습니다. 작성자는 V1로 인해 이마가 매끄러워지거나 속눈썹과 수염이 흐려지는 문제가 더 이상 없다고 설명합니다
- 1개의 공개된 예시 영상
사용 방법
- ComfyUI의 기본 LoraLoaderModelOnly를 사용하며, minimax_h3_fl2va_hyperflow_flash_14b와 함께 사용합니다. 강도 0.65–0.90, 기본값 0.80. 트리거 워드 없음
- H3 Editor를 사용할 경우, 같은 페이지의 V2 - Base H3로 변경하세요
리스크 및 제한 사항
- 기본 로더는 100 레이어 중 97 레이어만 로드할 수 있으며, 나머지 3 레이어는 HyperFlow가 분해된 형태로 저장되어 있어 경고가 발생합니다. 작성자는 이것이 정상이라고 설명합니다. 이 레이어들도 적용하려면 H3 Editor를 사용해야 합니다
- 예시는 1개의 영상만 있으며, 추가로 1개가 숨겨져 있습니다
【A】H3 Character Sheet Designer for ComfyUI -Image Generation · v1.4
워크플로우 · 버전 업데이트 · 작성자 ukr8b3g201 · 게시일 11-11 20:42 · 다운로드 수 24
한 장의 캐릭터 이미지에서 캐릭터 설정 시트를 생성하는 워크플로우 v1.4.0입니다. MiniMax H3 Image 전용 버전이 추가되었습니다: 최대 13개의 뷰, 출력 해상도 최대 16 MP.
이미지
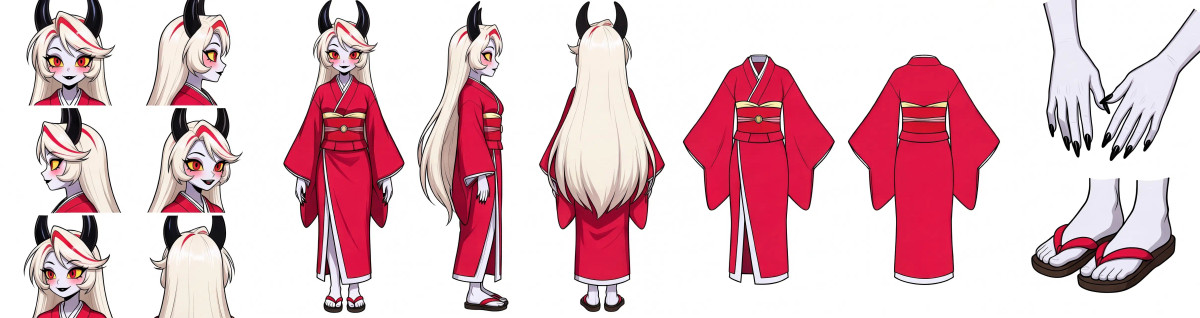
추천 이유
- 버전 업데이트: v1.4.0에 H3 Image 워크플로우(네이티브 MiniMax H3 Image Conditioning 노드)가 추가되었습니다. ZIP 파일에는 이전 버전인 P-H3 v1.3.0 워크플로우도 함께 포함되어 있습니다. 아바타, 전신 회전, 의상 앞뒤, 손 및 신발 등 최대 13개의 뷰를 선택할 수 있으며, 1장의 메인 이미지와 최대 3장의 참고 이미지를 사용하여 디테일을 제어합니다
- 해상도 Auto 옵션에는 Current, High detail, 8 MP, 16 MP의 4단계가 있으며, 캔버스 크기를 수동으로 입력할 수도 있습니다. 기본값은 Standard 5 뷰 + High detail입니다. 각 뷰의 프롬프트와 의상, 신발의 부분 설명을 수정할 수 있습니다
- H3 Image용 3개 모델의 파일명과 배치 디렉터리를 제공합니다
사용 방법
- H3 Character Sheet Designer 노드 v1.4.0 이상 및 ComfyUI 0.45.0 이상이 필요합니다
- 기본 모델 minimax_h3_image_pruned_int8_convrot은 models/diffusion_models/minimax/에 배치합니다. 텍스트 인코더는 qwen3vl_32b_minimax_h3_nvfp4_awq, VAE는 minimax_h3_image_vae_fp16입니다. 샘플링 매개변수는 작성자가 제공하지 않았습니다
리스크 및 제한 사항
- 작성자는 v1.3 설명에서 화질 개선이 확인되지 않았으며, 여전히 불필요한 인체 잔상이나 뷰 누락이 발생할 수 있다고 명시했습니다
- 공개된 예시는 1장뿐이며, 1개가 숨겨져 있습니다
주목할 만한 항목 (3)
【B】One prompt → one song → a two-scene music video (YuE2 × MiniMax H3) · v8.2
워크플로우 · 버전 업데이트 · 작성자 koyan0418439 · 게시일 11-11 19:17 · 다운로드 수 15
하나의 프롬프트로 노래를 생성한 후 여러 장면의 MV를 만드는 워크플로우(YuE2로 노래 생성 × H3로 영상 생성) v8.2입니다: 최대 64개의 장면, 노래의 섹션에 따라 자동 분할되며, 각 장면의 카메라 워크는 LLM이 작성합니다.
이미지
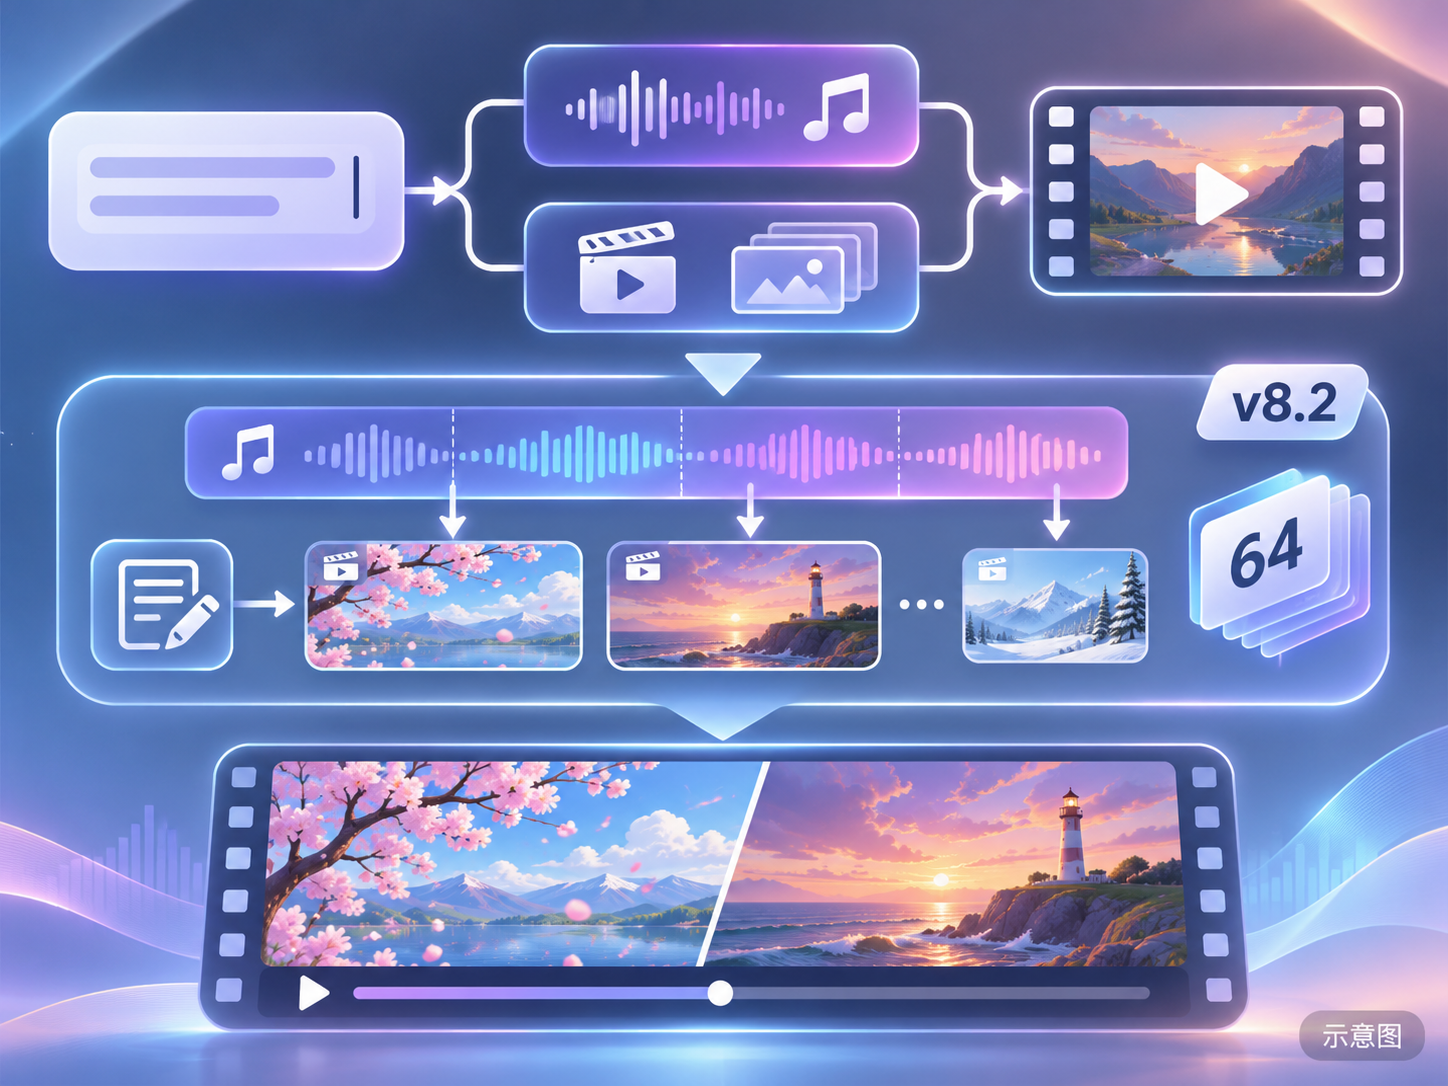
추천 이유
- 버전 업데이트: 별도로 공개되지 않았던 v7.1, v8.0, v8.1를 통합했습니다. 장면 상한이 24에서 64으로 증가했으며, 분할 지점은 노래 섹션이 변경되는 마디 라인에 위치하고, 단일 장면의 최대 길이는 15초입니다
- Scene Director가 추가되었습니다: 노래 분석에 따라 각 장면에서 누가 연주하고 언제 노래하는지 알려줍니다. H3 프롬프트는 MiniMax 공식 Ref2VA의 분할 형식으로 전환할 수 있습니다. 3가지 H3 엔진이 있으며, 작성자는 FastH3 Omni가 8 스텝에서 약 4배 더 빠르다고 설명합니다
- 작성자는 19개의 장면과 4인 밴드가 포함된 실제 실행에서 발생한 문제를 수정했다고 설명합니다: 카메라에 맞는 인물, 리드 보컬만 노래함, 드럼 비트가 노래를 따름
사용 방법
- Standard 모드: H3 ref2va, 20 스텝, res_multistep. Turbo 모드: 4 스텝 Turbo LoRA를 사용하여 4 스텝으로 초안을 생성
- 먼저 Timeline에서 'Analyse this song'을 실행하여 노래를 분석한 후, 모든 장면을 생성하세요
리스크 및 제한 사항
- 공개된 예시가 없습니다(1개가 숨겨져 있음). 작성자는 공식 프롬프트 형식이 얼굴, 의상 및 연주를 더 안정적으로 만들 수 있다고 설명하지만, GPU에서 검증되지 않았다고 명시했습니다
- 프로세스가 매우 무겁습니다: 각 장면마다 H3을 한 번 실행해야 하며, 3분 길이의 노래는 약 12–15개의 장면을 생성합니다
- 카드 이미지는 AI로 생성된 개요도이며 모델의 실제 결과가 아닙니다. 작성자는 공개된 일반 수준의 예시가 없습니다
【B】Mitsuru Kirijo Voice - Persona 3 - Audio Only [Minimax H3] · Minimax H3 v1.0
LoRA · 신규 모델 · 작성자 OneMoreLurker · 게시일 11-11 13:25 · 다운로드 수 58
『페르소나 3 Reload』의 키리조 미츠루 일본어 목소리를 위한 H3 오디오 LoRA입니다. 말하는 소리만 변경하며 화면은 변경하지 않습니다.
이미지
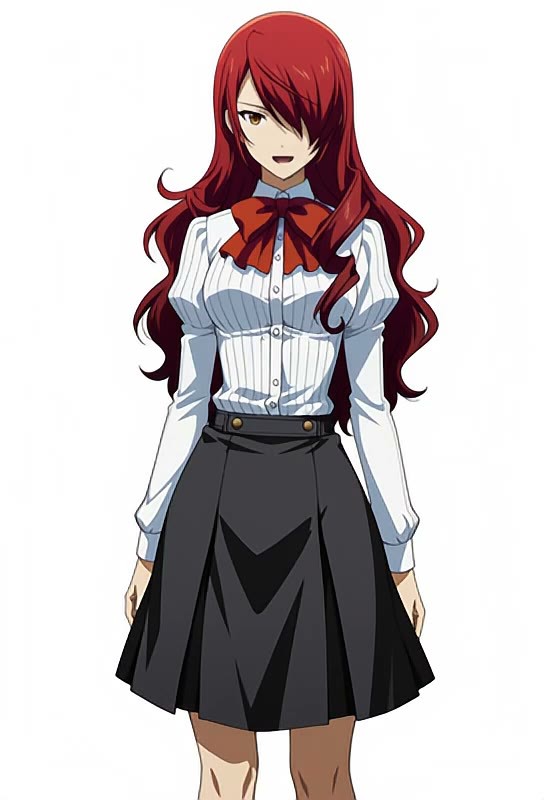
추천 이유
- 신규 모델. H3 영상의 캐릭터 더빙을 지원합니다: 『Persona 3 Reload』의 키리조 미츠루 일본어 음성으로 학습되었으며, 작성자는 부끄러움, 긴장, 자신감, 이완, 기쁨, 흥분, 애정 등 다양한 감정을 커버한다고 설명합니다
- 데이터셋은 영어 설명과 일본어 전사(transcription)를 사용합니다. 작성자는 영어 대사를 입력해도 말할 수 있지만, 공식 영어 더빙과 다르게 들릴 수 있다고 설명합니다. 1개의 공개된 예시 영상
사용 방법
- 프롬프트는 학습 형식에 따라 Mitsuru says "<대사>"로 작성하세요. 강도와 트리거 워드는 작성자가 제공하지 않았습니다
리스크 및 제한 사항
- 상업용 게임 캐릭터의 더빙으로 학습되어 성우의 음성 권리와 관련이 있습니다. 라이선스에 이미지 생성의 상업적 사용이 명시되어 있지 않습니다
- 3개의 예시가 숨겨져 있습니다
【B】H3-R2V Invisible people · v1.0
LoRA · 신규 모델 · 작성자 gangstuhh · 게시일 11-11 14:03 · 다운로드 수 90
H3 R2V용 '투명화' 특수 효과 편집 LoRA입니다: 영상 속 모든 사람을 투명하게 만들며, 나머지 화면과 타임라인은 그대로 유지합니다.
이미지
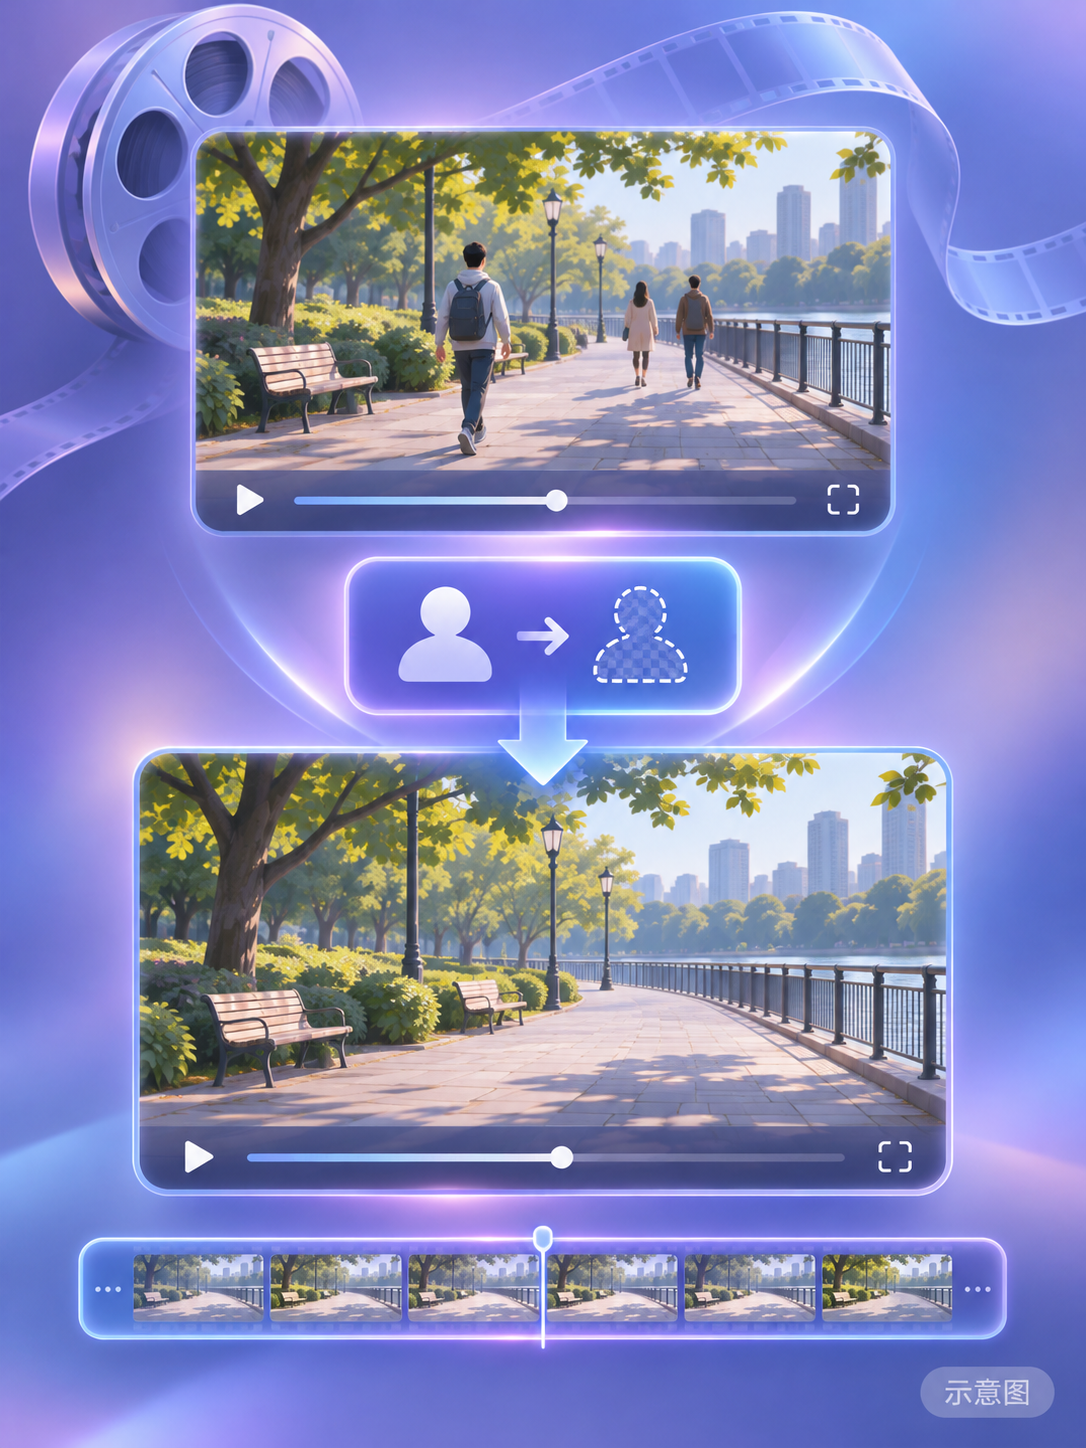
추천 이유
- 신규 모델. 영상 특수 효과 편집을 지원합니다: 원본 영상을 가이드 입력으로 연결합니다(작성자는 참고 이미지가 아님을 강조). 하나의 고정된 지시를 사용하여 화면 속 모든 사람을 투명하게 만듭니다
- 사용법은 하나의 프롬프트뿐이며 그대로 복사하여 사용할 수 있습니다. 게시 당일 90회 다운로드되어 관심도를 나타냅니다
사용 방법
- 편집할 영상을 guide 입력으로 사용하세요. 프롬프트: vfx_edit: Make everyone invisible, maintain the rest of the video including the timeline.
- 강도, 스텝 수 및 구체적으로 어떤 R2V 모델을 사용하는지는 작성자가 제공하지 않았습니다
리스크 및 제한 사항
- 공개된 예시가 없습니다(3개가 숨겨져 있음). 효과를 판단할 수 없습니다
- 설명이 두 문장뿐입니다
- 카드 이미지는 AI로 생성된 개요도이며 모델의 실제 결과가 아닙니다. 작성자는 공개된 일반 수준의 예시가 없습니다
참고용 (2)
- CivChan (Unoffical) · v1.0 MiniMax H3 — LoRA: Civitai 마스코트 CivChan의 비공식 캐릭터 LoRA로, 같은 페이지의 Anima 버전을 H3 영상용으로 이식한 것입니다.
- P1_video_minimax_h3_r2v · v1.0 — 워크플로우: P1_video_minimax_h3_r2v라는 이름의 H3 참고 영상 생성 워크플로우로, 설명은 제목만 있습니다.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수집 기간 11-11 12:33 → 11-11 21:33(베이징 시간). 추천 이유는 편집자 검수를 거쳤습니다. 다운로드 수는 관심도만을 나타냅니다.