贞贞的AI雷达 · MiniMax H3 · 2026-11-11 晚报
本期 11 个新版本:强烈推荐 1 · 推荐 5 · 可关注 3 · 仅收录 2
编辑按语 本期审阅 11 个 H3 新版本,1 个 S、5 个 A、3 个 B、2 个 C。首推 MMH3 皮肤写实 LoRA V2 的 ref2va 版:去掉参考图人脸的塑料反光、恢复自然肤质,同页 Base H3、fl2va 两个文件按底模重新编号,列 A。另有 Hand Tie Clips 3.5.1 的 ic 上采样、KinetiX 下雨滑杆、角色设定表工作流的 H3 Image 版列 A;Score to Screen v8.2 无可见示例、隐身特效 LoRA 示例全隐藏、桐条美鹤声线 LoRA 有声音版权问题,均为 B。
强烈推荐(1)
【S】MMH3 Realism Slider V2 — HyperFlow H3 Flash & MiniMax H3 · V2 - ref2va
LoRA · 版本更新 · 作者 voidhunter77 · 发布 11-11 18:05 · 下载 185
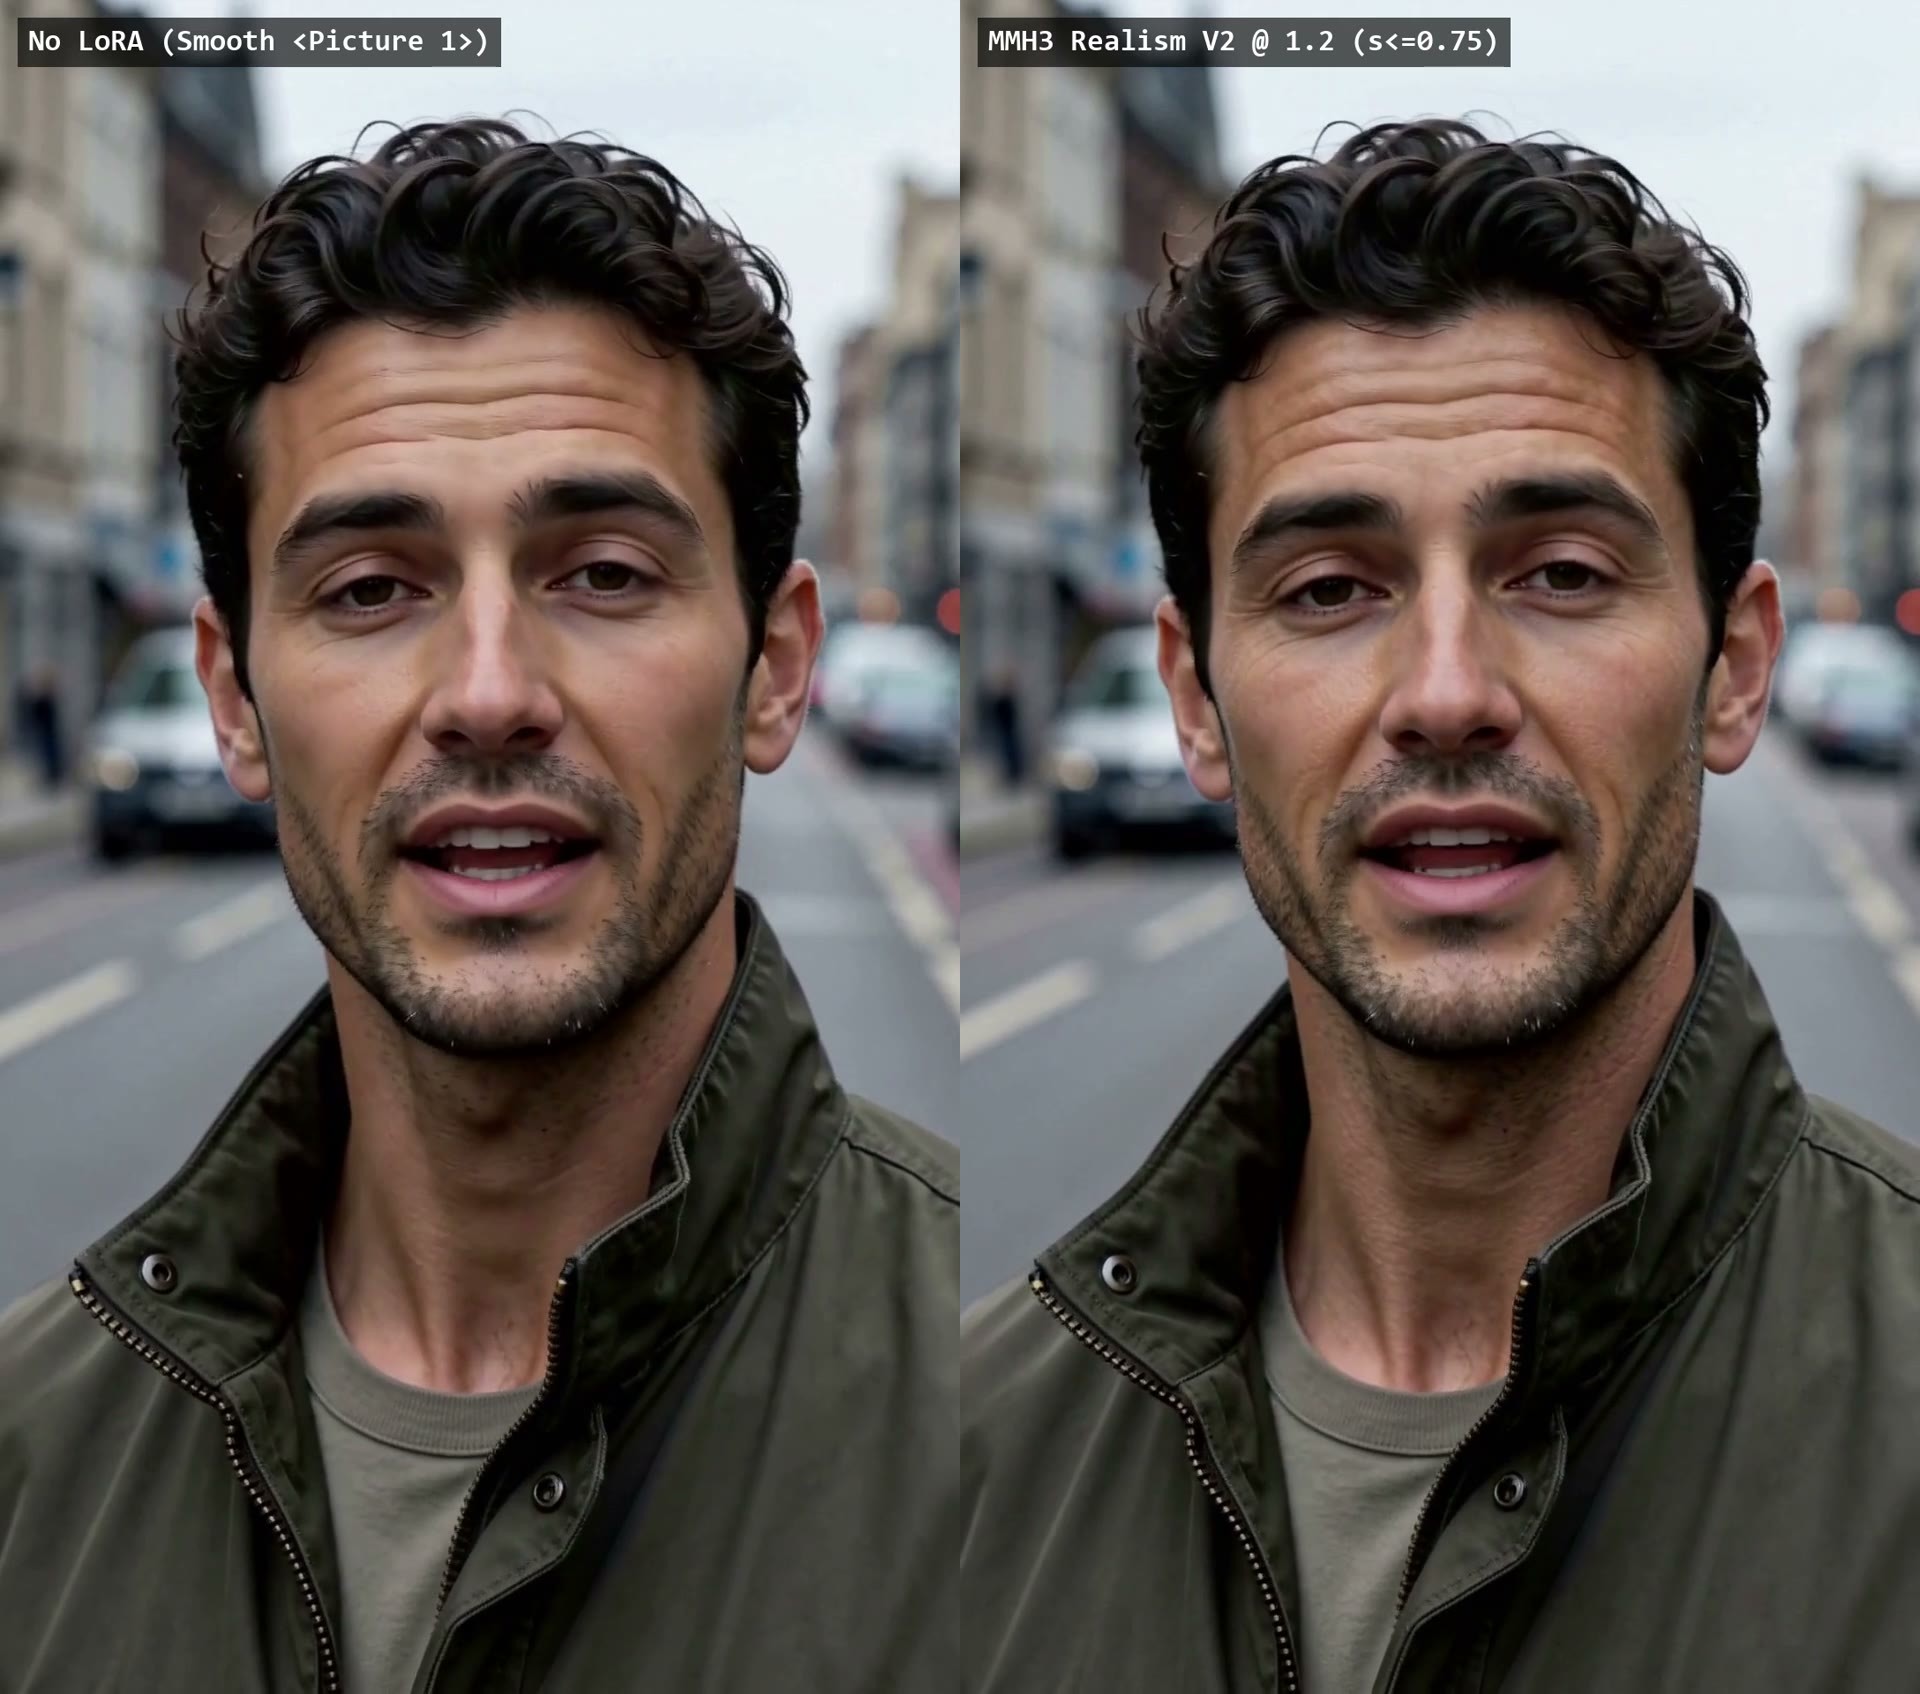
皮肤写实 LoRA V2 的 HyperFlow H3 Flash ref2va 专用版:去掉参考图人像皮肤的塑料反光、恢复自然肤质,同时不动睫毛、虹膜和胡茬。
同页三个文件是同一次训练按不同底模重新编号,按自己用的模型下对应那个即可。
配图
推荐理由
- 版本更新:V1 是 alcaitiff 原版 rank 1、只训 MLP 的滑杆移植,参考图里光滑的人像会经自注意力“绕过”它、几乎不变;V2 从头训练 rank 16,同时训自注意力(qkv_proj、out_proj)和 MLP(fc1、fc2),覆盖 blocks 23–47 共 100 层
- 服务参考图生视频(ref2va)和首尾帧视频里人脸塑料感过重的问题;作者称在白皙、橄榄、东亚、南亚和深色肤色上测过,没看到加颗粒或显老,眼睛、眉毛、胡子和头发在运动和 1080p 成片里保持清晰
- 按 HyperFlow ref2va 的 49 个 block 重新编号(该模型去掉了 H3 的 block 9),ComfyUI 自带加载器即可加载全部 100 层;6 段视频 + 1 张可见示例
怎么用
- ComfyUI 自带 LoraLoaderModelOnly 加载,配 minimax_h3_ref2va_hyperflow_flash_14b;强度 0.65–0.85,默认 0.75;无触发词
- 用 H3 Editor(comfyui-h3-editor)的话改下同页的 V2 - Base H3 文件,它的 H3 LoRA 节点会自己重新编号
风险与限制
- 只对应 HyperFlow ref2va 这一个模型,原版 50 block 的 H3 要用 Base H3 文件,纯提示词的 fl2va 用 fl2va 文件
- 1 个示例被隐藏;肤色和细节保持的效果为作者称
推荐(5)
【A】Hand Tie Clips — multi-hop MiniMax H3 video + audio, one queue · v3.51
工作流 · 版本更新 · 作者 sandpies · 发布 11-11 18:42 · 下载 19
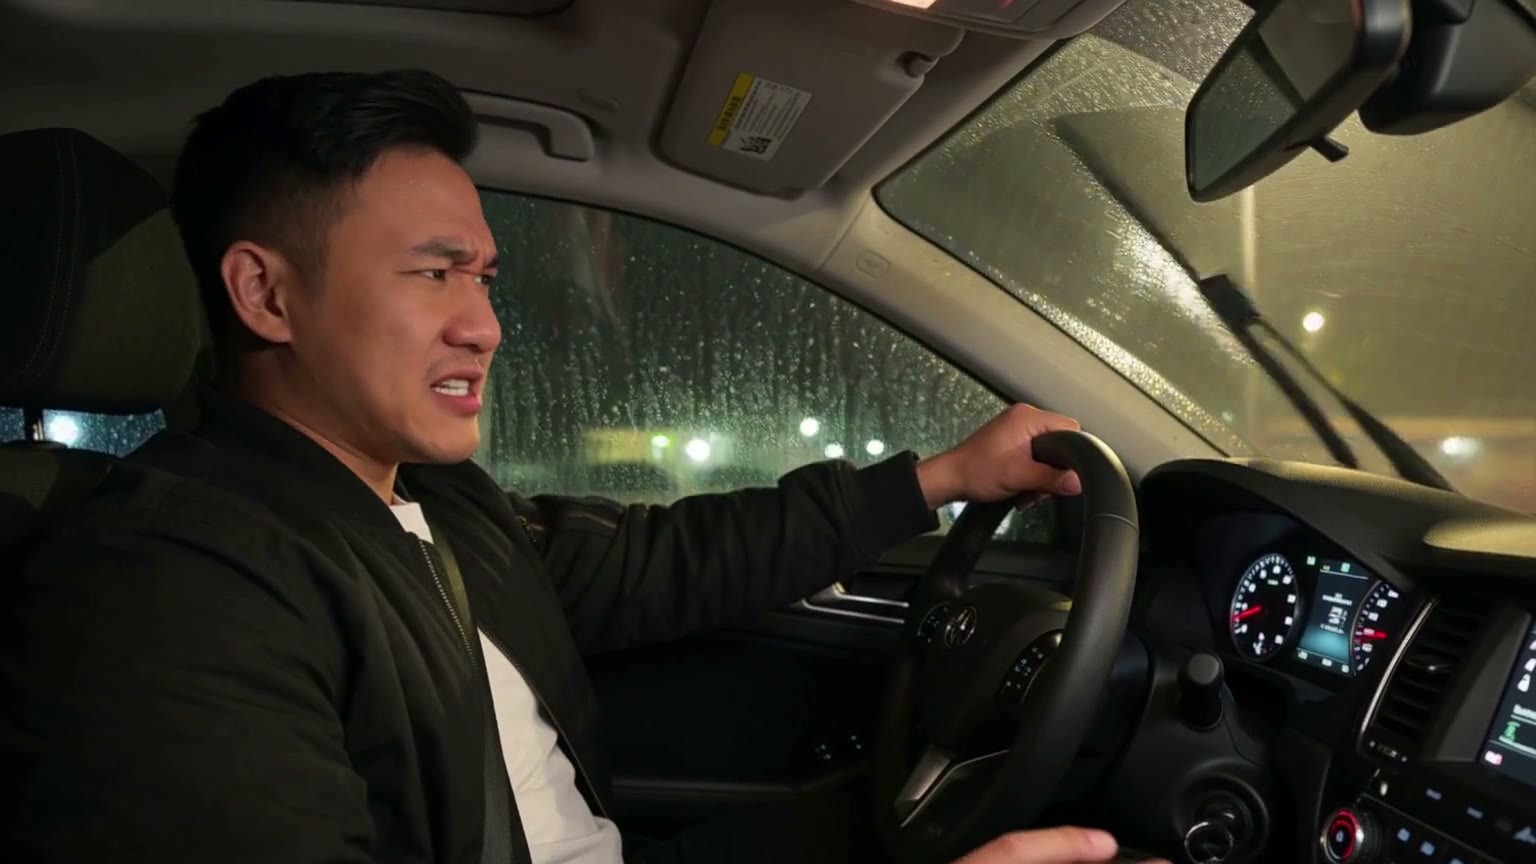
多段(multi-hop)H3 音视频长片工作流 3.5.1,新增 ic 上采样:重绘每一段时能看到整部片、听到配乐,脸、文字和口型保持原样。
配图
推荐理由
- 版本更新(3.5.0 + 修复):ic 上采样基于 NVlabs 的 Open-H3-Regenerate-2K-IC,需要 Kijai 的 minimax_h3_open_regenerate_2k_ic_lora(200 MB)和 minimax_h3_hyperflow_8step LoRA;任务提示词预先编码,26 GB 的文本编码器不用加载
- 新增 upsample_steps:3 步按配方、2 步更快,作者称 2 步约快三分之一、测试中观感相同;新增 H3 Token LoRA 加载器,可分别设视频、配乐、参考图和提示词的强度,比如把 audio 设 0 让风格 LoRA 不碰人声
- Realism Boost 改为 Upscale 2nd Pass(最后一段之后放大并用你自己的 LoRA 重绘纹理);换脸 / 编辑改用 Viggle remake LoRA;修了硬切闪前一镜、motion_context 接缝变亮等问题;1 段可见示例视频
怎么用
- RUN 页打开 UPSAMPLE 组,把 upsample method 设为 ic;两个 LoRA 放 models/loras
- ic 只支持官方未剪枝的 minimax_h3_ref2va_* 模型,剪枝版、fl2va 和融合模型不行(不对时运行前就会报错提示)
- 第一遍 6–8 步保证音频干净(4 步 turbo 用 4 步),Upscale 2nd Pass 用 2–3 步
风险与限制
- ic 比 Regen2K 慢;依赖多(KJNodes、Viggle remake LoRA 等),旧版 KJNodes 会退回稠密注意力
- 3 个示例被隐藏;更新说明面向已在用这套工作流的用户,新手上手成本高
【A】KinetiX Weather System Series · Rain & Downpour v1.0
LoRA · 版本更新 · 作者 make676767 · 发布 11-11 18:17 · 下载 46
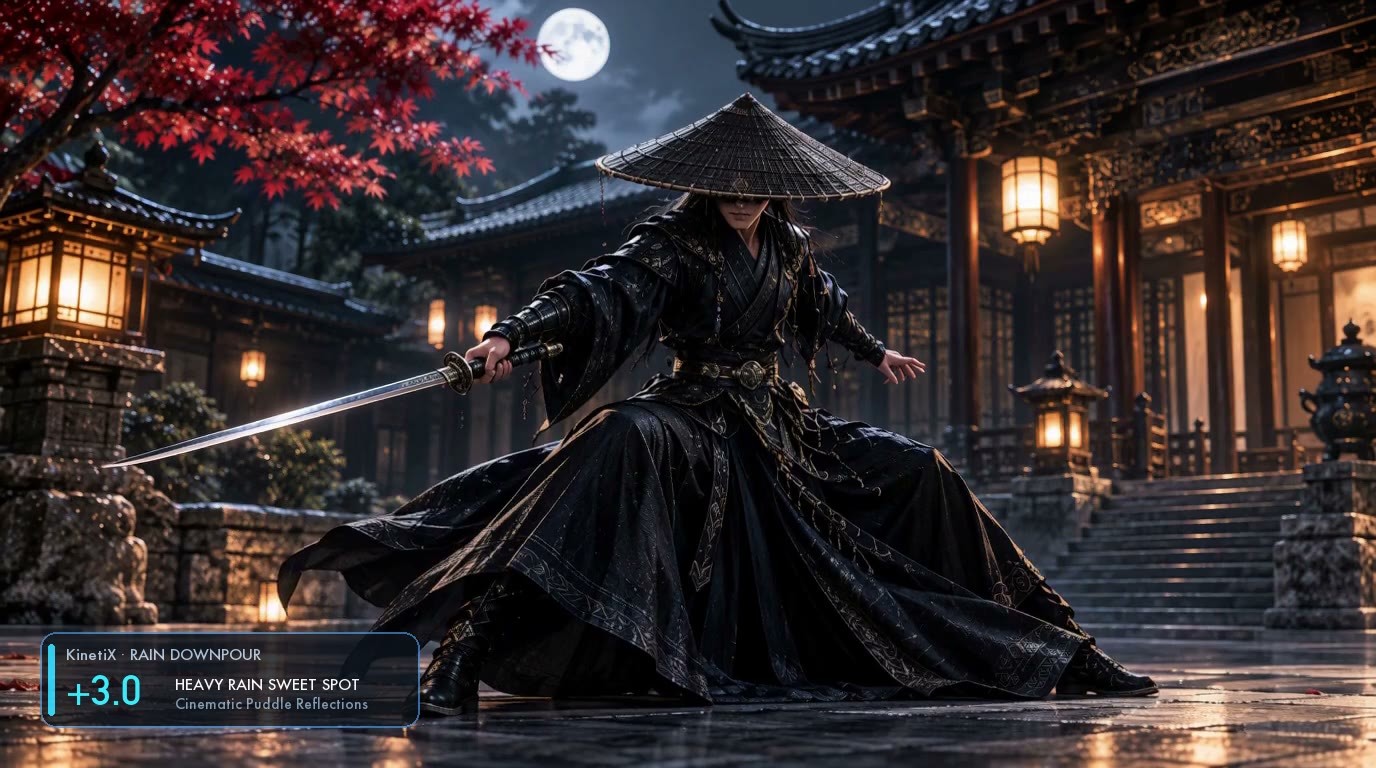
KinetiX 天气滑杆系列的下雨 LoRA:用权重线性控制雨量,从小雨、大雨到倾盆暴雨,负值则把画面变成晴天、地面晒干。
配图
推荐理由
- 版本更新(同系列第 3 个版本,此前是 Snow & Blizzard 和 Day to Night,各管一种天气,不是同一 LoRA 的改进):控制空中雨丝密度、雨滴溅起的水雾和地面积水倒影
- 作者给了完整权重档位:+1.0 ~ +1.5 小雨湿地,+2.0 ~ +3.0 电影级大雨(作者推荐),+4.0 ~ +5.0 暴雨,-2.0 ~ -3.0 晴天干地;可与同系列的 camera_shake、movement_amplitude、hit_stop 滑杆叠用
- 附可直接复制的场景提示词(雨夜古风庭院拔刀、赛博朋克雨夜小巷等);5 段可见示例视频
怎么用
- 无触发词;提示词里加一句 It is raining. 可确保出雨,雨量交给权重控制
- ComfyUI strength_model 从 +2.0 ~ +3.0 起步;作者的赛博雨夜组合是 rain_downpour +2.5 配 camera_shake +0.8
风险与限制
- 推荐权重前后不一:页面摘要写 +2.5 ~ +3.5,档位表写 +2.0 ~ +3.0
- 作者称建筑、人物和构图 100% 不变,没有加 / 不加的对照示例;强度远高于常规 LoRA,与其他 LoRA 叠加时要留意
【A】MMH3 Realism Slider V2 — HyperFlow H3 Flash & MiniMax H3 · V2 - Base H3
LoRA · 版本更新 · 作者 voidhunter77 · 发布 11-11 18:08 · 下载 53
同一皮肤写实 LoRA V2 的原版 H3 文件:给 50 block 的 MiniMax H3 用,也是 H3 Editor 在任何底模(含两个 HyperFlow 版)上应该用的文件。
配图
推荐理由
- 版本更新:与 ref2va 版是同一次 rank 16 训练,按原版编号覆盖 blocks 24–48 共 100 层;V1 只训 MLP,对参考图里光滑的皮肤基本不起作用,V2 能去掉塑料高光、恢复哑光自然肤质
- H3 Editor 用法写得细:强度 1.0–1.4,默认 1.2,配 start_sigma 0.75 让前几步不受影响,姿势和构图接近不加 LoRA 的结果;脸颊、额头有大片湿亮高光时可试 start_sigma 1.0、强度 0.75
- 3 段视频 + 1 张可见示例
怎么用
- H3 Editor 0.3.0 及以上:用其 H3 LoRA 节点加载,强度 1.2、start_sigma 0.75
- ComfyUI 自带 LoraLoaderModelOnly:原版 50 block H3 用 0.65–0.85;作者称用在 MiniMax H3 Image 上效果较弱,要推到 1.2–1.6
- 无触发词
风险与限制
- HyperFlow 模型用自带加载器时要下对应的 ref2va / fl2va 文件,不要用这个
- 1 个示例被隐藏
【A】MMH3 Realism Slider V2 — HyperFlow H3 Flash & MiniMax H3 · V2 - fl2va
LoRA · 版本更新 · 作者 voidhunter77 · 发布 11-11 18:05 · 下载 77
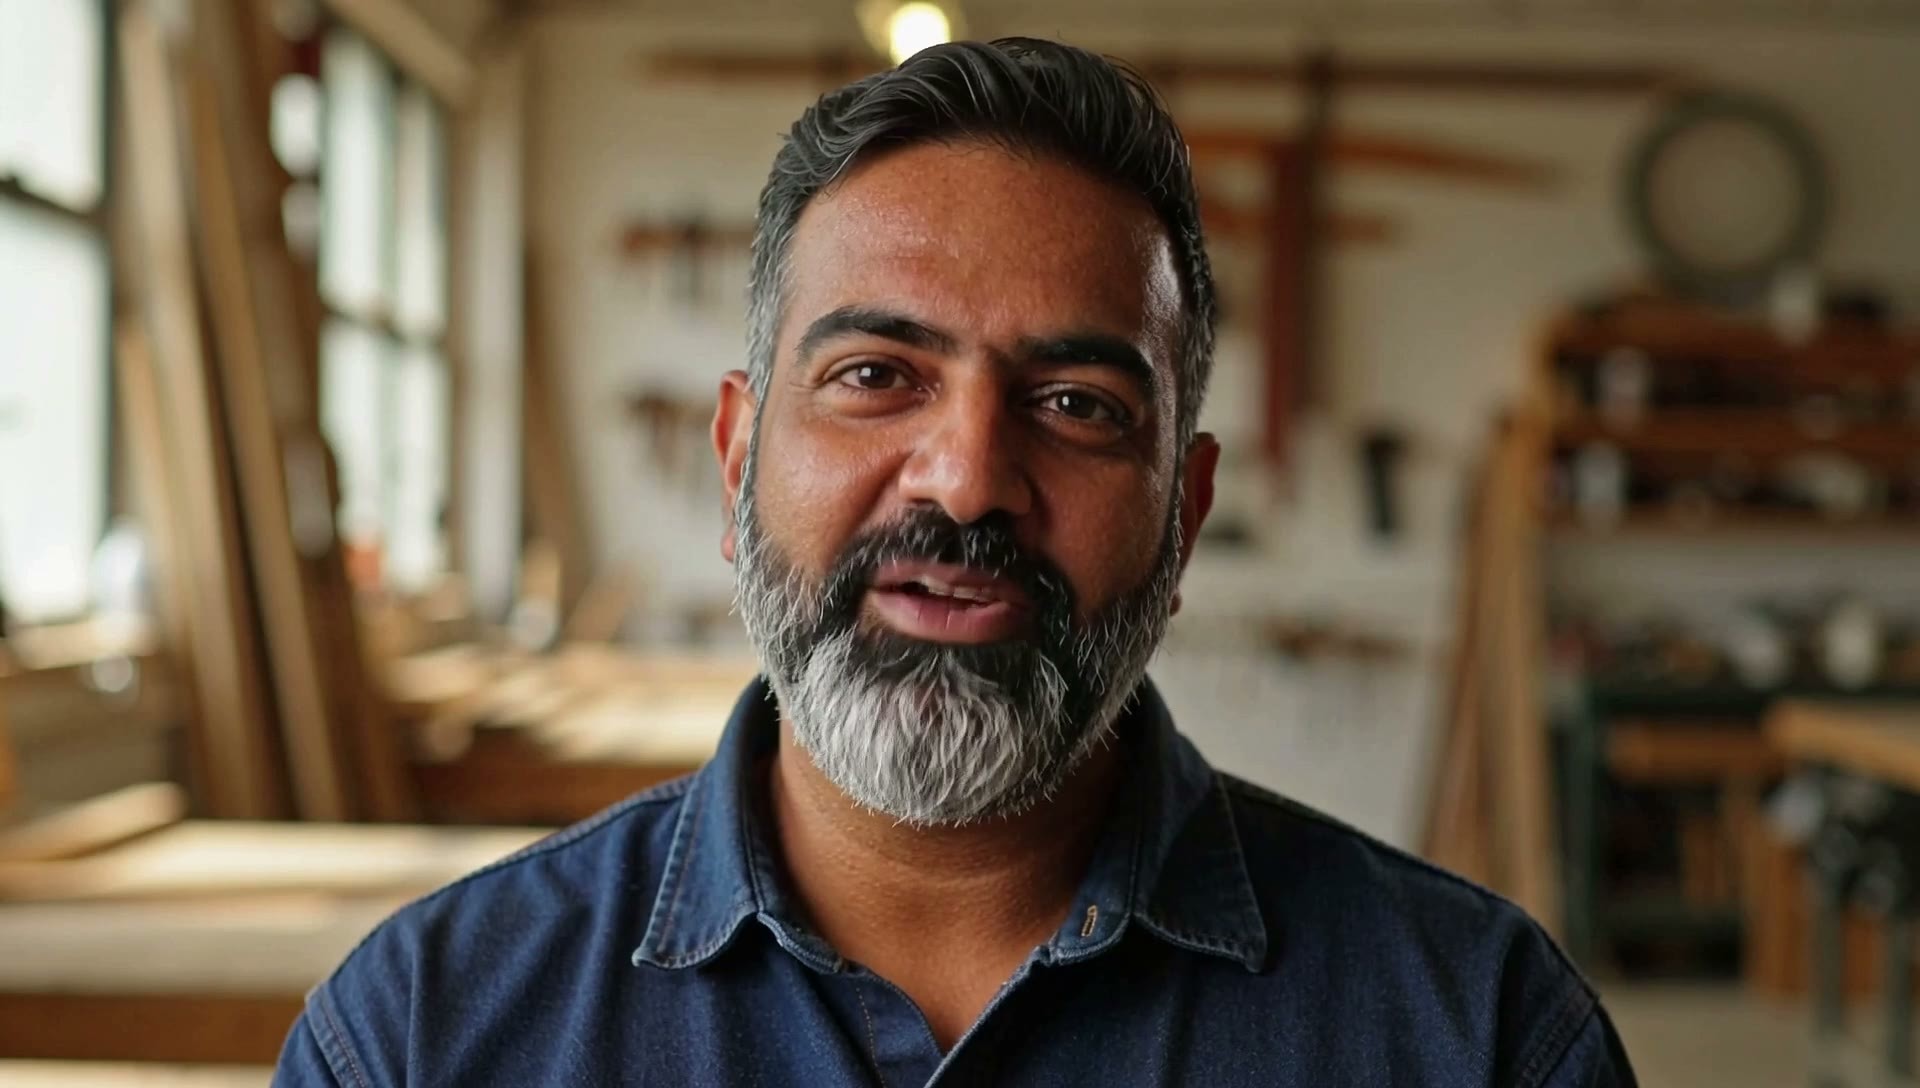
同一皮肤写实 LoRA V2 的 HyperFlow H3 Flash fl2va(纯提示词出视频)版。
配图
推荐理由
- 版本更新:按 fl2va 的 47 个 block 重新编号(该模型去掉了 H3 的 block 6、21、22),训练 blocks 21–45 的自注意力和 MLP;作者称不再有 V1 把额头抹平、睫毛和胡子变软的问题
- 1 段可见示例视频
怎么用
- ComfyUI 自带 LoraLoaderModelOnly,配 minimax_h3_fl2va_hyperflow_flash_14b;强度 0.65–0.90,默认 0.80;无触发词
- 用 H3 Editor 时改下同页的 V2 - Base H3
风险与限制
- 自带加载器只能加载 100 层里的 97 层,另外 3 层因 HyperFlow 以分解形式存储会报警告,作者称属正常;要让这几层也生效需用 H3 Editor
- 示例只有 1 段视频,另有 1 个被隐藏
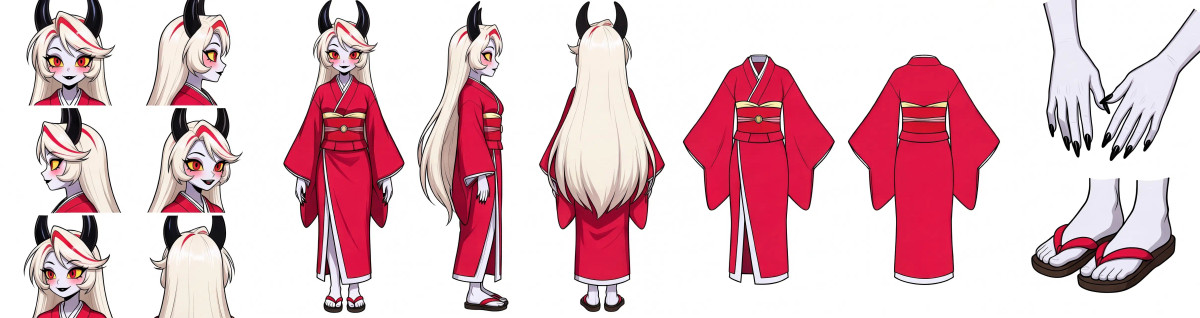
【A】H3 Character Sheet Designer for ComfyUI -Image Generation · v1.4
工作流 · 版本更新 · 作者 ukr8b3g201 · 发布 11-11 20:42 · 下载 24
从一张角色图生成角色设定表的工作流 v1.4.0,新增 MiniMax H3 Image 专用版:最多 13 个视角,输出最高 16 MP。
配图
推荐理由
- 版本更新:v1.4.0 新加 H3 Image 工作流(原生 MiniMax H3 Image Conditioning 节点),ZIP 里同时保留上一版 P-H3 v1.3.0 工作流;可选头像、全身转身、服装前后、手和鞋等最多 13 个视角,用 1 张主图加最多 3 张参考图控制细节
- 分辨率 Auto 有 Current、High detail、8 MP、16 MP 四档,也可手动填画布尺寸;默认 Standard 5 视角 + High detail;每个视角的提示词和服装、鞋子的局部说明都能改
- 给了 H3 Image 三个模型的文件名和放置目录
怎么用
- 需要 H3 Character Sheet Designer 节点 v1.4.0 及以上、ComfyUI 0.45.0 及以上
- 底模 minimax_h3_image_pruned_int8_convrot 放 models/diffusion_models/minimax/,文本编码器 qwen3vl_32b_minimax_h3_nvfp4_awq,VAE minimax_h3_image_vae_fp16;采样参数作者未给
风险与限制
- 作者在 v1.3 说明里写明画质提升未确认,仍可能出现多余人体残影和缺视角
- 只有 1 张可见示例,1 个被隐藏
可关注(3)
【B】One prompt → one song → a two-scene music video (YuE2 × MiniMax H3) · v8.2
工作流 · 版本更新 · 作者 koyan0418439 · 发布 11-11 19:17 · 下载 15
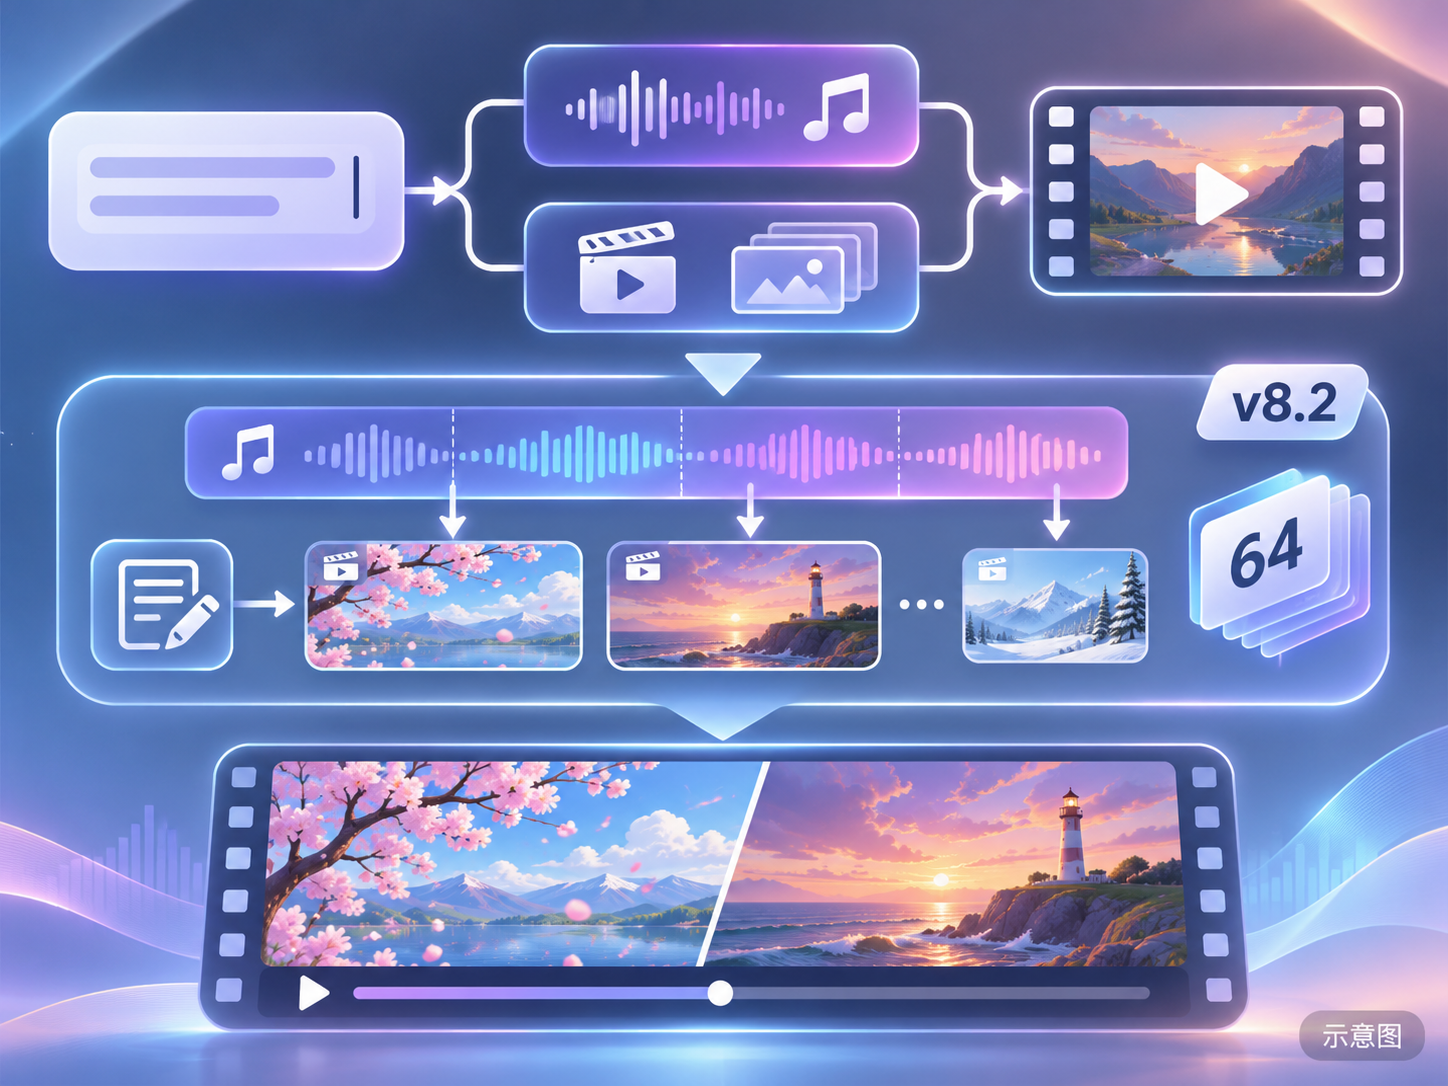
一句提示词出一首歌再出多场景 MV 的工作流(YuE2 出歌 × H3 出画)v8.2:最多 64 个场景,按歌曲段落自动切分,每个场景由 LLM 写镜头。
配图
推荐理由
- 版本更新:合并了没单独发布的 v7.1、v8.0、v8.1;场景上限从 24 提到 64,切点落在歌曲段落变化的小节线上,单个场景最长 15 秒
- 新增 Scene Director:按歌曲分析告诉每个场景谁在演奏、何时唱;H3 提示词可切换为 MiniMax 官方 Ref2VA 的分段格式;有三种 H3 引擎,作者称 FastH3 Omni 8 步约快 4 倍
- 作者称修复来自 19 个场景、4 人乐队的实际运行:镜头上是对的人、只有主唱在唱、鼓点跟着歌
怎么用
- Standard 档:H3 ref2va,20 步,res_multistep;Turbo 档:配 4 步 Turbo LoRA 跑 4 步出草稿
- 先在 Timeline 上运行 Analyse this song 分析歌曲,再生成全部场景
风险与限制
- 没有可见示例(1 个被隐藏);作者称官方提示词格式可能让脸、服装和演奏更稳,但写明尚未在 GPU 上验证
- 流程很重:每个场景跑一次 H3,一首 3 分钟的歌约 12–15 个场景
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
【B】Mitsuru Kirijo Voice - Persona 3 - Audio Only [Minimax H3] · Minimax H3 v1.0
LoRA · 新模型 · 作者 OneMoreLurker · 发布 11-11 13:25 · 下载 58
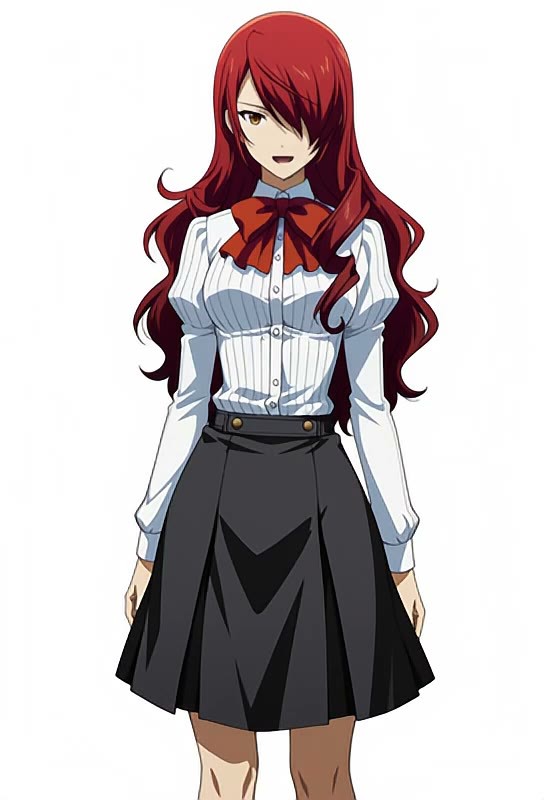
《女神异闻录3 Reload》桐条美鹤日语声线的 H3 音频 LoRA,只改说话声音,不改画面。
配图
推荐理由
- 新模型;服务 H3 视频里的角色配音:用《Persona 3 Reload》中桐条美鹤的日语语音训练,作者称覆盖害羞、紧张、自信、放松、开心、兴奋、深情等情绪
- 数据集用英文描述、日文转写;作者称给英文台词也能说,但听起来会和官方英文配音不同;1 段可见示例视频
怎么用
- 提示词按训练格式写 Mitsuru says "<台词>";强度和触发词作者未给
风险与限制
- 用商业游戏角色配音训练,涉及声优的声音权利;许可未列出出图商用
- 3 个示例被隐藏
【B】H3-R2V Invisible people · v1.0
LoRA · 新模型 · 作者 gangstuhh · 发布 11-11 14:03 · 下载 90
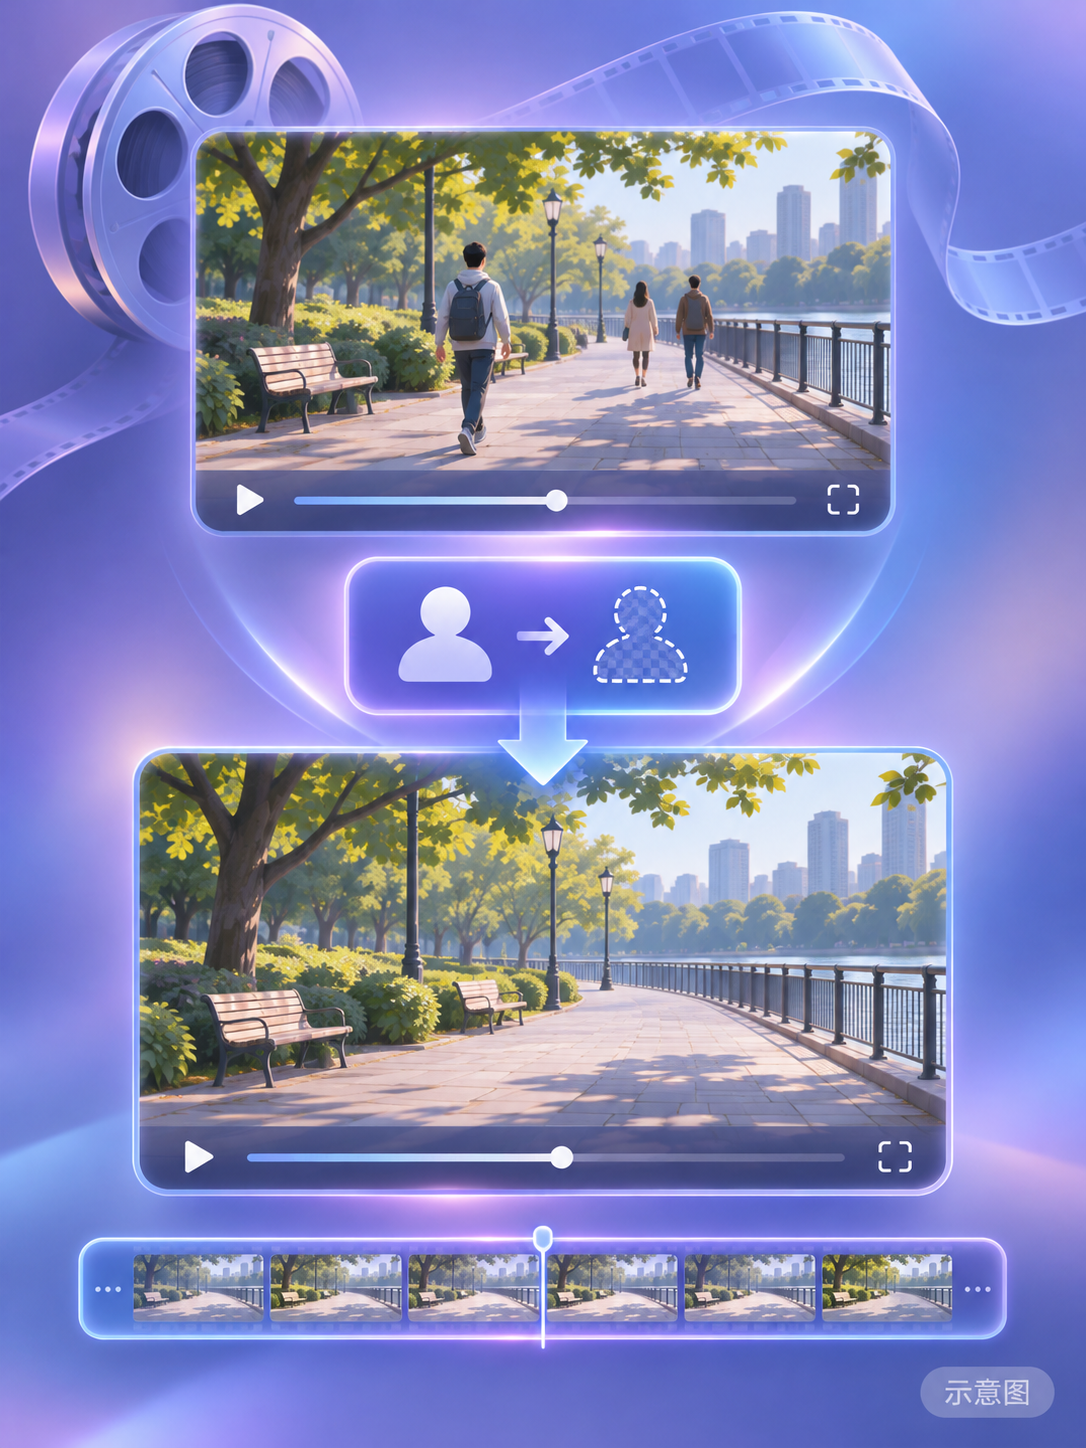
H3 R2V 的“隐身”特效编辑 LoRA:把视频里的人全部变透明,其余画面和时间线保持不变。
配图
推荐理由
- 新模型;服务视频特效编辑:把原视频接到引导输入(作者强调不是参考图),用一条固定指令让画面里的人全部隐身
- 用法就是一条提示词,可照抄;发布当天 90 次下载,只说明关注度
怎么用
- 要编辑的视频作为 guide 输入;提示词:vfx_edit: Make everyone invisible, maintain the rest of the video including the timeline.
- 强度、步数和具体用哪个 R2V 模型作者未给
风险与限制
- 没有可见示例(3 个被隐藏),效果无法判断
- 说明只有两句
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
仅收录(2)
- CivChan (Unoffical) · v1.0 MiniMax H3 — LoRA:Civitai 吉祥物 CivChan 的非官方角色 LoRA,从同页的 Anima 版移植到 H3 视频。
- P1_video_minimax_h3_r2v · v1.0 — 工作流:名为 P1_video_minimax_h3_r2v 的 H3 参考生视频工作流,说明只有标题。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-11 12:33 → 11-11 21:33(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。