정정(貞貞)의 AI 레이더 · MiniMax H3 · 2026-11-22 모닝 브리프
이번 호 10개 신규 버전: 강력 추천 1 · 추천 3 · 주목할 만함 3 · 단순 수록 3
편집자 주 이번 호에서는 H3의 신규 버전 11개를 검토하여, S등급 1개, A등급 3개, B등급 3개, C등급 3개를 선정하고 1개를 제외했습니다. 최우선 추천은 Eto Ranger 아트 스타일 LoRA입니다: 1995년 애니메이션 클립으로 학습한 90년대 일본식 셀 애니메이션 스타일로, 트리거 워드, 강도, 가속 LoRA, 샘플러 및 스텝 수까지 모두 상세히 안내합니다. Dispatch 3D 셀 스타일 v2, H3 Look Sheets 멀티 앵글 시트 v1.3, 여성 억양 오디오 LoRA v1.2는 A등급으로 분류했습니다. 음성 클로닝 워크플로우는 예시와 파라미터가 부족하여 A등급에서 B등급으로 하향 조정했습니다. Mid journey anime은 H3 Image용 이미지 LoRA로, 비디오 섹션에 해당하지 않으므로 제외했습니다.
강력 추천 (1)
【S】Eto Ranger Art Style · protype
LoRA · 신규 모델 · 저자 OrioTysumi · 공개일 11-21 22:24 · 다운로드 수 62
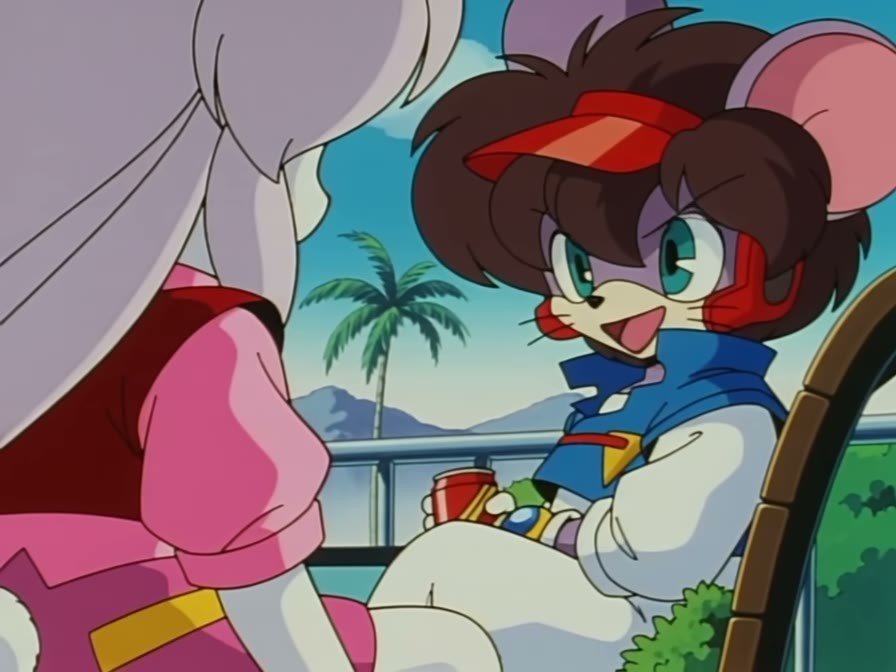
화면을 1995년 일본 TV 애니메이션 《십이전지 폭발 에토 레인저》의 90년대 셀 애니메이션 스타일로 구현하는 비디오 LoRA로, 레트로한 일본 TV 애니메이션 질감의 동물 의인화 장면을 생성하는 데 사용됩니다.
이미지
추천 이유
- 신규 모델: 저자는 해당 작품의 초기 에피소드에서 발췌한 287개 클립으로 학습했으며, 목표는 90년대 일본 셀 애니메이션의 화풍과 분위기 재현으로, 텍스트-투-비디오(Text-to-Video)에 바로 사용 가능합니다
- 파라미터 완비: 강도 1.0, DMAD 4-step 가속 LoRA 조합, 샘플러 er_sde, 스케줄러 beta, 스텝 수 6~8
- 저자가 제시한 추가 사용 팁: 원작 캐릭터 재현을 원할 경우 R2VA(참조 기반 비디오 생성)를 병행 사용하세요. 화면비는 4:3로 설정하면 당시 TV 방송과 유사하고, 16:9로 설정하면 극장판과 유사합니다. 프롬프트에 레트로 애니메이션 키워드를 추가하세요
- 5개 예시 비디오 확인 가능; 무료이며, 공개 후 11시간 만에 다운로드 62회, 좋아요 10개 기록
사용법
- 프롬프트에 트리거 워드 etoranger를 입력하고, 90년대 일본 애니메이션 관련 레트로 키워드를 추가하세요
- LoRA 강도 1.0; DMAD 4-step LoRA를 겹쳐 사용하며, 샘플러 er_sde, 스케줄러 beta, 스텝 수 6~8로 설정하세요
- TV판 느낌을 원하면 4:3 화면비, 극장판 느낌을 원하면 16:9 화면비를 사용하세요. 원작 캐릭터 재현을 원한다면 R2VA 참조 이미지를 병행 사용하세요
리스크 및 제한 사항
- 학습 소재가 저작권이 있는 애니메이션 작품에서 가져온 것으로, 상업적 라이선스는 대여만 허용되며 이미지 판매는 불허합니다
- 민감도 등급이 있는 예시 3개는 숨겨져 있습니다. 버전명이 protype(프로토타입)이며, 저자는 향후 추가 학습 여부를 명시하지 않았습니다
트리거 워드: etoranger
추천 (3)
【A】Dispatch Style Lora H3 · v2.0 Ref Model
LoRA · 버전 업데이트 · 저자 tazmannner379 · 공개일 11-21 22:50 · 다운로드 수 90
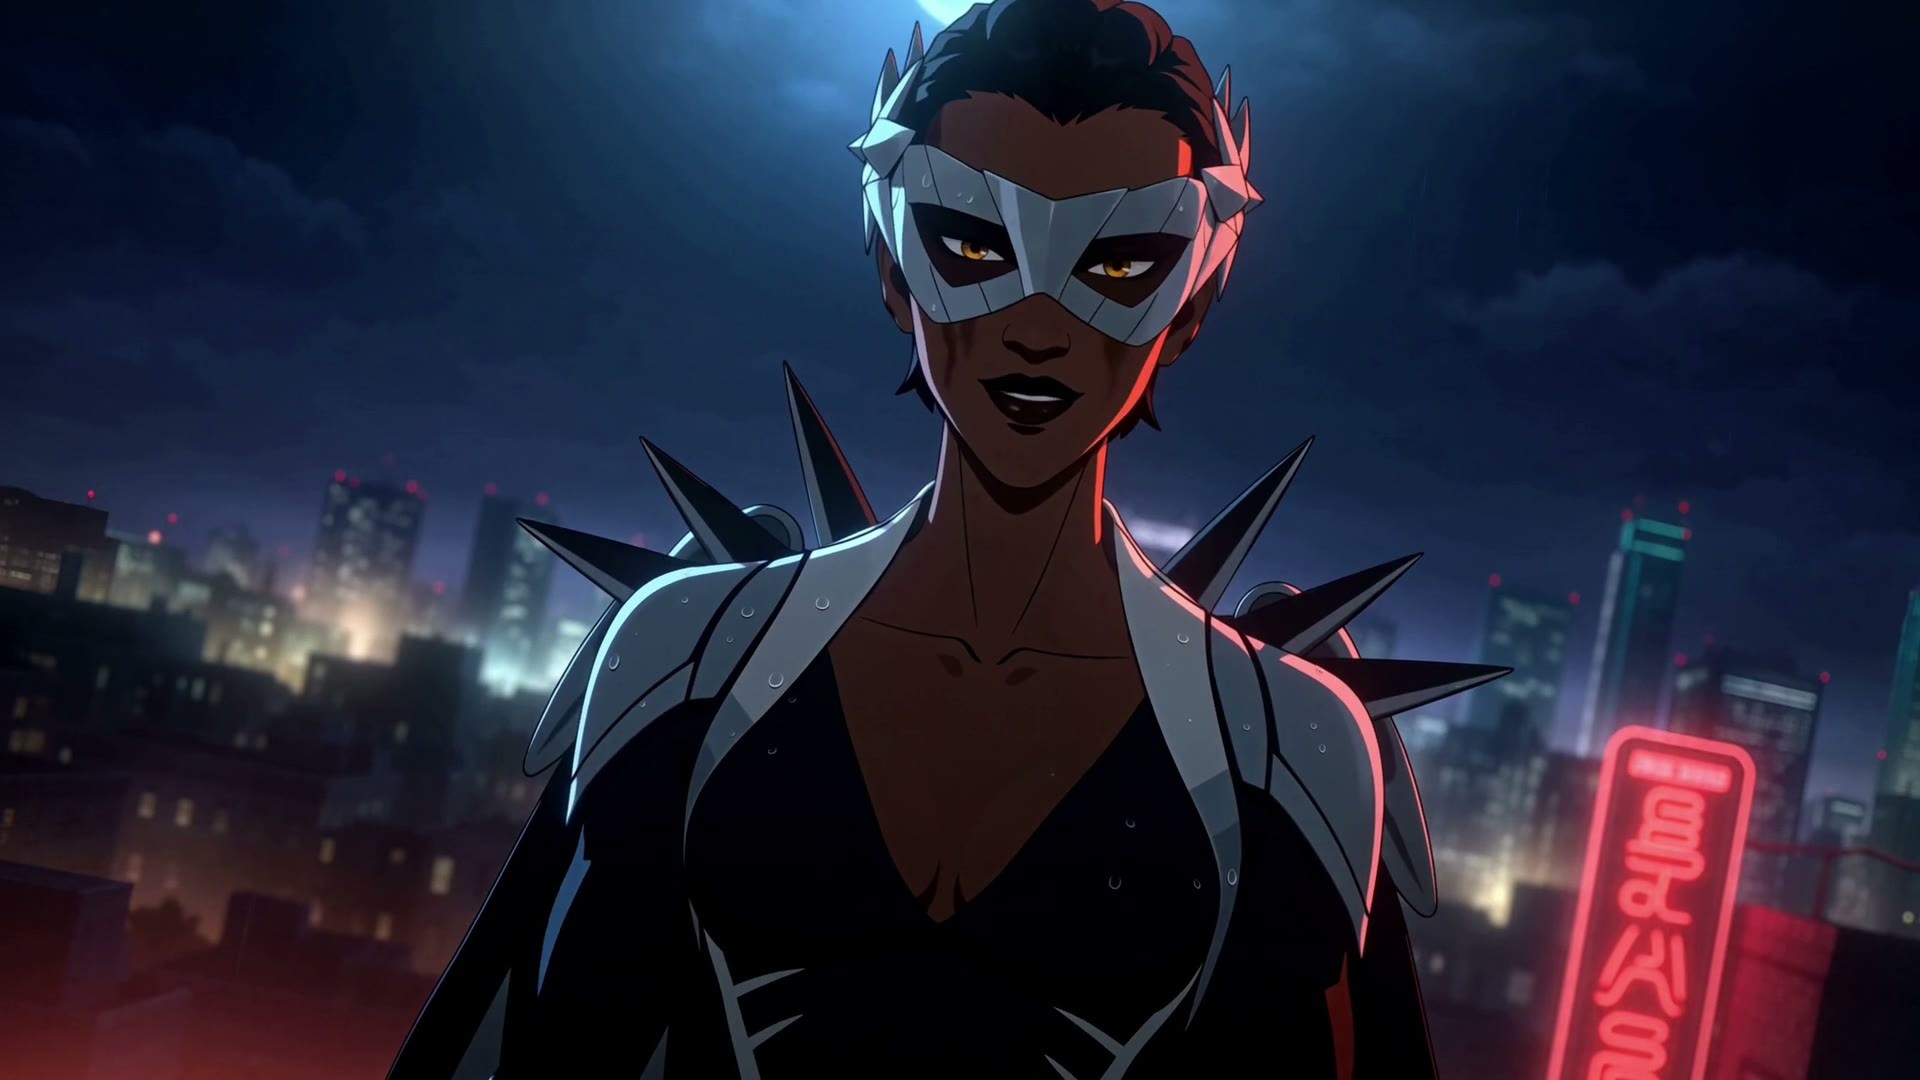
게임 Dispatch의 3D 셀 애니메이션 만화 스타일 LoRA의 두 번째 버전으로, 새로운 데이터셋으로 처음부터 재학습되었습니다. 참조 기반 비디오 생성 모델을 대상으로 하며, 저자가 정리한 캐릭터 설정 이미지와 더빙 클립을 활용하면 게임 내 캐릭터를 지정하여 생성할 수 있습니다.
이미지
추천 이유
- 버전 업데이트: 저자는 본 버전을 처음부터 학습하고 새로운 데이터셋으로 교체했다고 밝혔습니다. 버전명은 Ref Model이며 파일명에 REF가 포함됩니다. Hugging Face 설명 페이지에는 H3 참조 기반 비디오(Ref2VA) 모델에서 학습되었으며 해당 모델에서만 사용해야 한다고 명시되어 있습니다
- 저자는 Hugging Face에 캐릭터 설정 이미지, 더빙 참조 클립, 캐릭터 프롬프트 가이드 등 전체 세트를 게시했습니다. 모델 카드에는 모든 캐릭터가 프롬프트 또는 참조 이미지로 지정 가능하다고 명시되어 있습니다
- 트리거 워드 명확: Stylized 3D cel-shaded comic style, Dispatch style; Civitai의 이 파일은 step00004200 체크포인트입니다
- 10개 예시 비디오 확인 가능; 무료이며, 공개 후 10시간 만에 다운로드 90회, 좋아요 19개 기록, 모델 페이지 누적 다운로드 888회
사용법
- 프롬프트 시작 부분에 Stylized 3D cel-shaded comic style, Dispatch style를 입력하세요
- H3 참조 기반 비디오(Ref2VA) 모델에 로드하고 강도를 1으로 설정하세요. 캐릭터 외형은 저자의 설정 이미지를 참조 이미지로, 목소리는 더빙 클립을 오디오 참조로 사용하며, 캐릭터 작성 방법은 CHARACTERS.md를 참고하세요
- Civitai 모델 카드에는 스텝 수와 CFG가 명시되어 있지 않으므로 Hugging Face 설명 페이지를 확인해야 합니다
리스크 및 제한 사항
- 강도, 기본 모델, 학습 세부 사항(589개 클립 + 777장 스크린샷으로 학습, 오디오는 학습하지 않음)은 Hugging Face 페이지에만 기재되어 있으며, Civitai 버전 설명에는 'trained from scratch, new dataset'이라는 한 줄만 있습니다
- 소재는 게임 Dispatch의 컷신에서 가져온 것으로, 저자는 HF 페이지에서 저작권을 보유하지 않았다고 선언했지만 Civitai 라이선스에는 판매 가능이 체크되어 있어 상업적 사용 시 자체 판단이 필요합니다
- 민감도 등급이 있는 예시 4개는 숨겨져 있습니다. Hugging Face 페이지에는 다른 두 개의 체크포인트(3900 / 4500)가 있으며, 4200 결과가 어긋날 경우 저자는 이를 대체 사용하도록 권장합니다
트리거 워드: Stylized 3D cel-shaded comic style, Dispatch style
【A】H3 Look Sheets · v1.3 - Relay VSR/SeedVR2
워크플로우 · 버전 업데이트 · 저자 FromWood · 공개일 11-21 23:45 · 다운로드 수 56
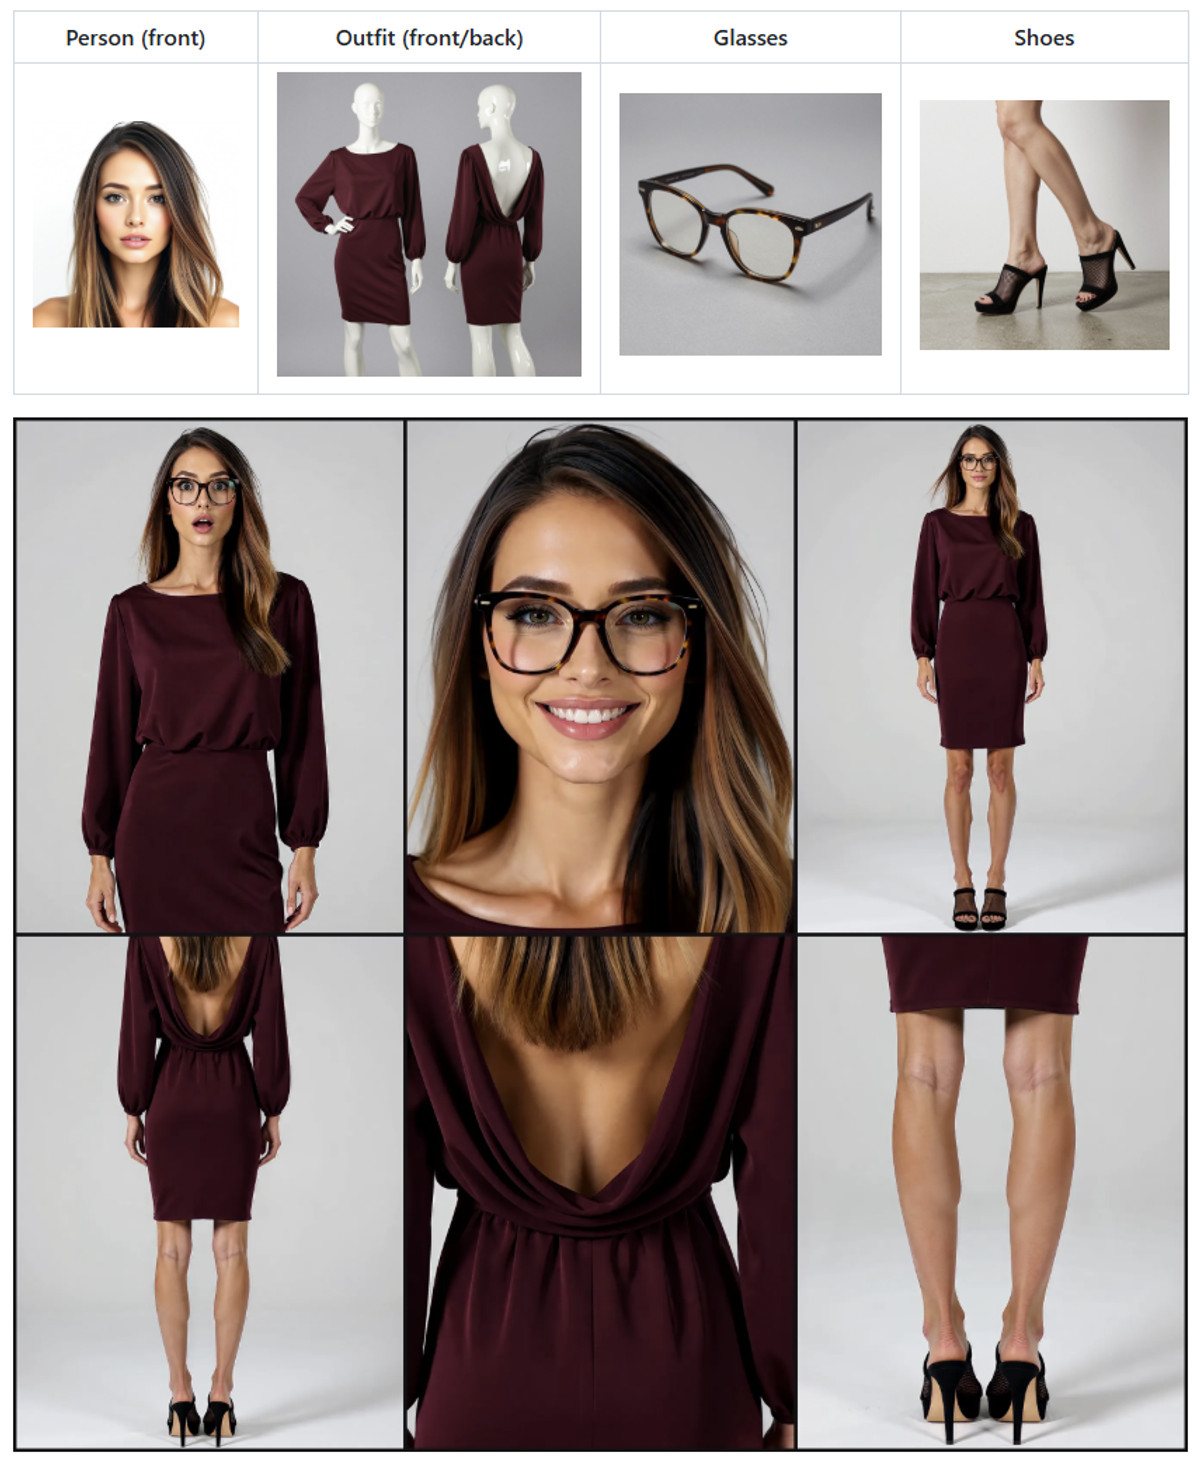
인물 사진 한 장과 의상 사진 몇 장을 입력하면 H3 멀티 참조 비디오 생성으로 해당 인물이 그 의상을 입은 다양한 각도의 장면을 한 번에 촬영하고, 자동으로 프레임을 선택하여 캐릭터/의상 설정 시트로 배치하는 ComfyUI 노드 패키지입니다. v1.3에서는 RelayVSR을 사용한 업스케일링 워크플로우가 추가되었습니다.
이미지
추천 이유
- 버전 업데이트: ComfyUI-H3LookSheets-2StageSamplingUpscaleRelayVSR.json이 추가되었습니다. ComfyUI 기본 내장 RelayVSR x2 업스케일링으로 SeedVR2을 대체하며, H3 Face Refine 이후 Select Frames 이전에 전체 비디오를 업스케일링합니다. 기존 SeedVR2 워크플로우는 이름만 변경되었습니다
- 도구 자체: Qwen3-VL이 각 참조 이미지에 설명을 작성한 후, 사용자가 선택한 신체 부위 × 카메라 위치를 기반으로 스토리보드 프롬프트를 자동으로 작성합니다. H3로 모든 각도를 한 편의 비디오로 촬영하고, Select Frames가 가장 좋고 차이가 큰 프레임을 선택하여 배치합니다
- 캐릭터 일관성 유지, 의상 룩북, LoRA 학습 데이터셋 준비, 의상 참조 등의 작업에 적합합니다
- 무료이며, 공개 후 9시간 만에 다운로드 56회, 모델 페이지 누적 다운로드 728회
사용법
- custom_nodes에 ComfyUI-H3LookSheets를 git clone하고 해당 워크플로우를 캔버스로 드래그하세요. RelayVSR 버전은 ComfyUI v0.45.0 이상이 필요하며, SeedVR2 버전은 기존 요구 사항을 따릅니다
- 저자의 예시에서는 int8 ref2va 모델 + 4-step turbo LoRA를 사용하고, 비전 모델은 Qwen3-VL(qwen3vl_4b_fp8_scaled)을 사용합니다
- 참조 이미지에서 동일 인물의 헤어스타일을 일정하게 유지하세요. 의상 사진이 다른 사람이 입은 것이라면 머리를 먼저 크롭하세요. 각 의상 이미지는 해당 슬롯에 할당해야 합니다
리스크 및 제한 사항
- 본 버전은 업스케일링 옵션이 하나 추가되었을 뿐이며, 이미 v1.2을 사용 중이고 SeedVR2이 잘 작동하는 경우 업데이트할 필요가 없습니다
- 후처리 의존성이 많습니다(latent upscaler, H3 Face Refine, KJNodes, Impact Pack 등). 본 도구는 실행되지 않았습니다
- Civitai에는 예시 이미지 1장만 있으며(민감도 등급이 있는 1개는 숨겨져 있음), 데모 비디오는 저자의 YouTube 재생 목록에 있습니다
【A】Minimax Female Accents · v1.2
LoRA · 버전 업데이트 · 저자 imb101 · 공개일 11-22 05:25 · 다운로드 수 97
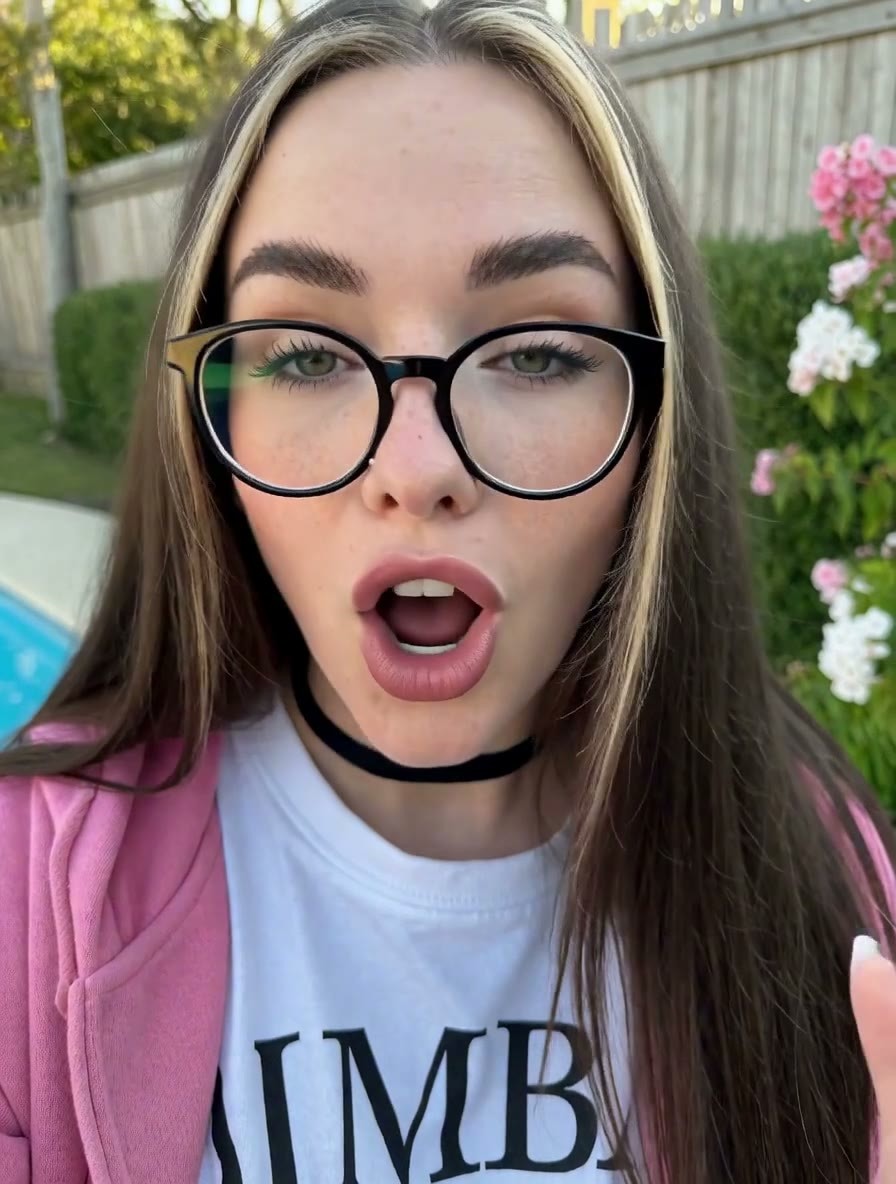
H3의 오디오 부분만 수정하는 여성 억양 LoRA 모음으로, 각 억양마다 파일이 하나씩 있어 인물이 지정된 영어 억양으로 말하도록 합니다. v1.2에서는 맨체스터, 멕시코, 북아일랜드, 루마니아, 러시아, 퀘벡 프랑스어 등 6가지 억양이 추가되었습니다.
(편집자 A등급 상향: 사용법, 가중치, 트리거 작성법이 명확하고 추가된 억양이 많지만, 예시는 1개뿐입니다.)
이미지
추천 이유
- 버전 업데이트: 새 억양 6개 추가; 가장 초기의 5개 억양(Utah, Atlanta, New Jersey, Liverpool, Minnesota)의 DIM을 32에서 8로 압축하여 파일 크기를 줄였고, 저자는 파형이 거의 동일하다고 주장합니다. 전체를 하나의 zip으로 묶었으며 각 파일도 개별 업로드했습니다
- H3 기본 억양이 평평한 문제를 해결: 저자는 오디오 레이어만 수정하고 화면에는 영향을 주지 않는다고 주장하며, 이미지-투-비디오/텍스트-투-비디오에서 여성 캐릭터에 특정 억양의 대사를 입히는 데 적합합니다
- 프롬프트 작성법 통일: 대사 앞이나 뒤에 in a <억양 이름> accent를 추가하고, 퀘벡은 Quebecois로 직접 작성하세요
- 무료이며, 공개 후 4시간 만에 다운로드 97회, 좋아요 14개 기록, 모델 페이지 누적 다운로드 1256회
사용법
- 각 억양에 해당하는 개별 LoRA를 로드하고 가중치를 0.6-0.8로 설정하세요. 오디오 샘플링은 3으로 설정하세요(이상한 기포 소리가 나면 높여 조정하세요)
- 대사는 The woman says [English]…… in a manchester accent 형식으로 작성하며, 억양 이름은 대사 앞이나 뒤에 모두 배치할 수 있습니다
리스크 및 제한 사항
- 억양당 LoRA가 하나씩이므로, 한 번의 생성에서 두 사람이 서로 다른 억양으로 말하는 것은 불가능합니다. 여성 목소리만 대상입니다
- 확인 가능한 예시 비디오는 1개뿐입니다(나머지 1개는 숨겨져 있음). 저자 스스로 일부 억양은 강하고 일부는 약하다고 언급했습니다
- zip 압축 파일의 보안 스캔이 완료되지 않았습니다. 파일에는 Quebecois와 Quebecois-French 두 가지 퀘벡 버전이 동시에 존재하지만 저자는 차이를 설명하지 않았습니다. 라이선스는 파생 작업을 허용하지 않습니다
주목할 만함 (3)
【B】MiniMax H3 Voice Cloning (Audio Only) · v1.0
워크플로우 · 신규 모델 · 저자 NekoCap · 공개일 11-22 07:20 · 다운로드 수 51
H3의 오디오 생성을 사용하여 음성 클로닝을 수행하는 ComfyUI 워크플로우입니다: 깨끗한 1인 음성 샘플을 입력하면 해당 음색을 모방한 오디오만 출력합니다.
(편집자 B등급 하향: 예시가 없고, 파라미터와 의존성이 명시되지 않았습니다.)
이미지
추천 이유
- 신규 모델: 더빙, 캐릭터 대사 등 오디오만 필요한 작업에 대해 저자는 "성능이 꽤 괜찮다"고 평가했으나, 스스로도 "silly experiment(어리석은 실험)"라고 언급함
- 샘플 요구사항이 명확함: 1인 목소리만 필요하며, 약간의 배경 소음이나 가사가 없는 배경 음악은 큰 영향을 미치지 않음. 여러 사람이 섞인 샘플은 H3를 혼란스럽게 만듦
- 무료이며, 공개 후 2시간 동안 51회 다운로드됨
사용 방법
- MiniMax-H3_Voice-Clone.json을 다운로드하여 ComfyUI에 가져온 후, 1인 목소리 샘플을 넣음
- 필요한 노드, 모델, 파라미터는 저자가 제공하지 않음
리스크 및 제한 사항
- 오디오 또는 비디오 예시가 전혀 없으며, 유일한 미리보기 이미지는 한 문장임: 저자는 Civitai가 실제 미리보기를 환영하지 않을 수 있다고 말함
- 타인의 목소리 클로닝은 법적 및 윤리적 리스크가 있으며, 저자는 명확히 면책 조항을 명시함. 사용 전 샘플 목소리의 라이선스 여부를 확인해야 함
- 설명이 매우 짧으며, 의존하는 노드와 모델은 직접 확인해야 함. 본 도구는 실행되지 않음
【B】OmegaWPN YouTube,Facebook,Pinterest and Instagram Loader + Viewer · v0.4
기타 · 버전 업데이트 · 저자 OmegaWPN · 공개 11-22 00:49 · 다운로드 28
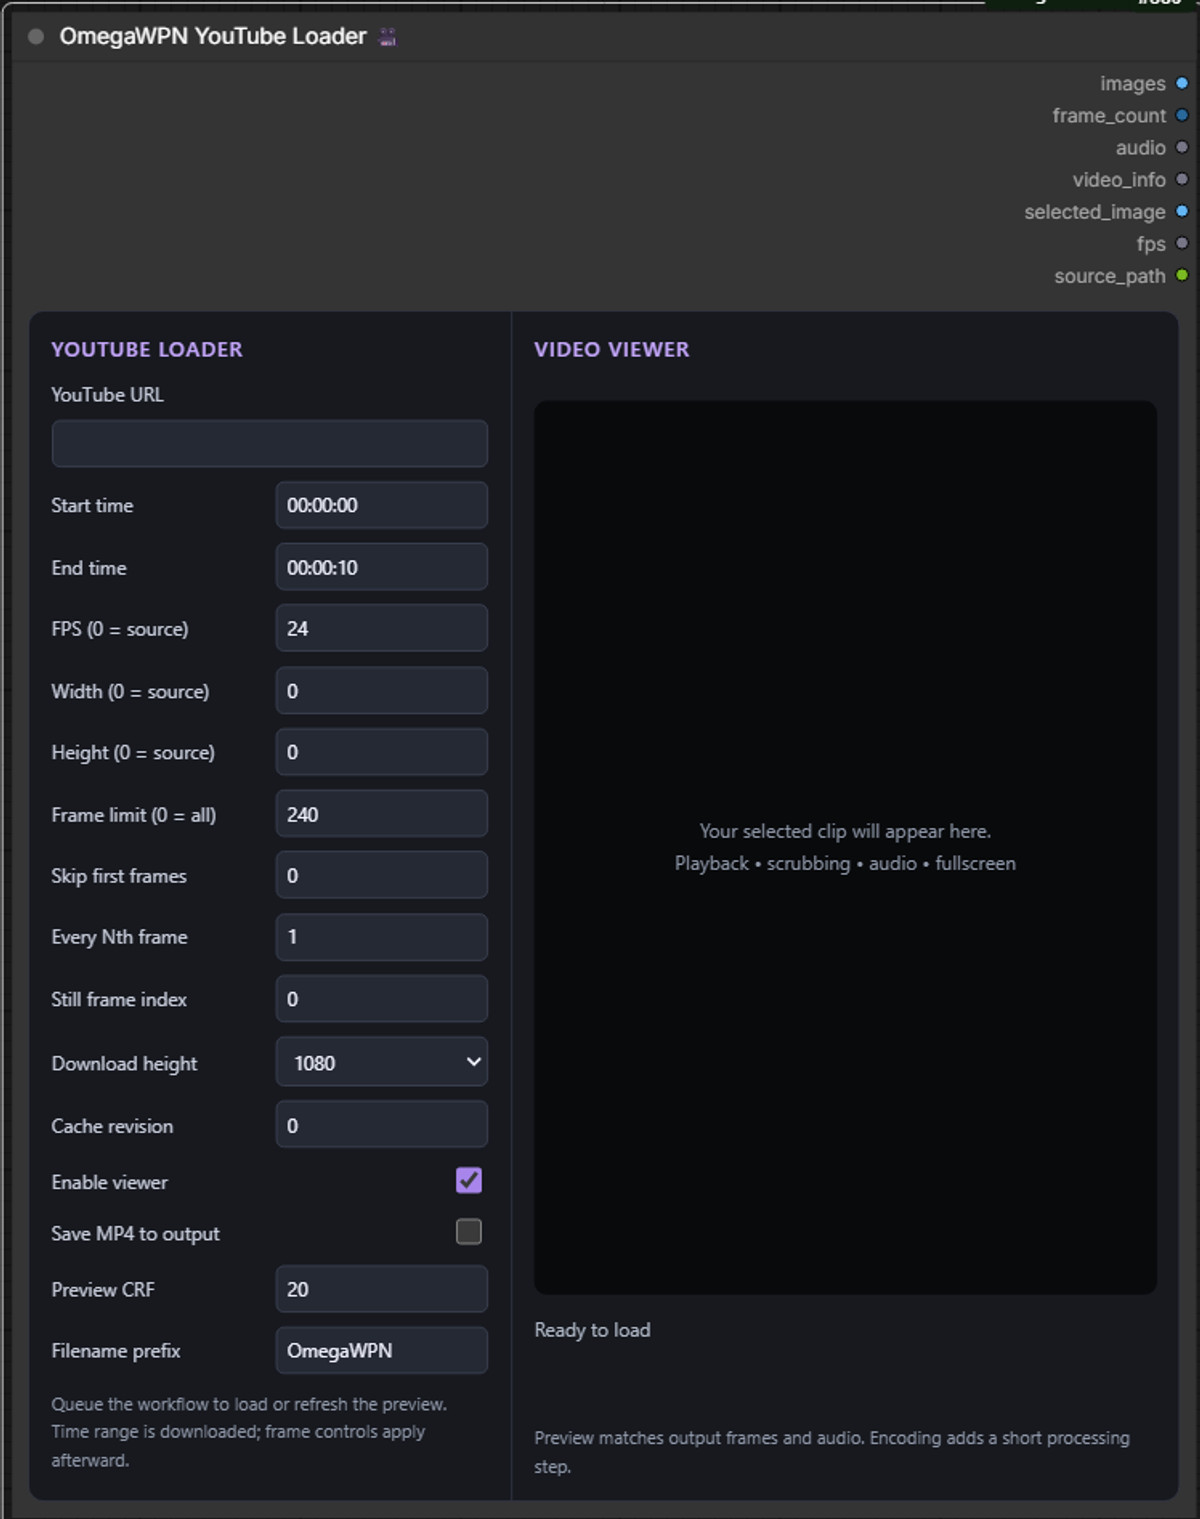
ComfyUI 비디오 로딩 노드: YouTube, Instagram, Facebook, Pinterest 또는 직링크 비디오 주소를 붙여넣고 시작 및 종료 시간을 지정하여 일부만 다운로드하며, 프레임, 오디오 및 선택된 단일 프레임을 출력함. 노드 옆에 플레이어 미리보기가 포함됨.
도구류로 수록됨: H3와 직접적인 연관은 없으며, 웹에서 참고 클립을 발췌해야 하는 사용자에게 적합함.
이미지
추천 이유
- 버전 업데이트: v0.4은 YouTube 로더에서 범용 비디오 로더로 확장되어 yt-dlp가 지원할 수 있는 모든 사이트와 직링크를 지원함. FPS, 해상도, 프레임 건너뛰기 및 최대 프레임 수를 조정할 수 있음
- H3와의 관계: H3 가중치나 H3 전용 노드를 포함하지 않는 범용 입력 도구이며, 저자는 기본 모델을 H3로 표기함. H3의 참고 기반 비디오 생성이나 오디오 참고용 소재 준비에 사용할 수 있으나, 저자는 H3 예시를 작성하지 않음
- 무료이며, 공개 후 8시간 동안 28회 다운로드되었고, 모델 페이지 누적 다운로드는 107회임
사용 방법
- ComfyUI\custom_nodes에 압축을 풀고 VideoHelperSuite, yt-dlp, FFmpeg를 설치함. YouTube의 경우 Deno와 같은 JavaScript 런타임이 추가로 필요함
- Windows 포터블 버전의 경우 install_portable.bat와 'activate youtube (only once).bat'를 한 번 실행한 후 재시작하여 OmegaWPN YouTube Loader를 추가함
- 저자 예시: 24 FPS로 15초를 가져오며 최대 프레임 수를 360로 설정하고, 0로 설정하면 읽기 구간 내의 모든 프레임을 가져옴
리스크 및 제한 사항
- H3 모델이 아닌 범용 ComfyUI 도구임. 설치 스크립트는 Windows 포터블 버전 전용이며, 기본 경로가 C:\ComfyUI_windows_portable로 고정되어 있음
- 웹 비디오 다운로드 시 플랫폼 약관 및 소재 저작권 문제가 발생할 수 있음. 일부 사이트는 로그인이 필요하거나 지원되지 않음
- 라이선스상 파생 작업이 허용되지 않으며, 저자는 v0.3 대비 항목별 업데이트 설명을 작성하지 않음
【B】img2Vid MiniMax H3 Workflow (12GB VRAM) · v3.0
워크플로우 · 버전 업데이트 · 저자 theevildarkmage126 · 공개 11-21 23:07 · 다운로드 53
12GB VRAM을 위한 H3 이미지 기반 비디오 생성 ComfyUI 워크플로우의 3번째 버전: Turbo 모델로 교체하고 두 개의 디테일 LoRA를 겹쳐 적용한 후, 2배 업스케일링을 수행함.
이미지
추천 이유
- 버전 업데이트: v3은 Turbo 체크포인트로 변경하고 LoRA Manager를 사용하여 두 개의 디테일 LoRA를 적용하며, 최종적으로 2배 업스케일링을 수행함. 저자는 RTX 4070에서 5초 분량의 비디오 생성에 약 6분이 소요되며 화질은 여전히 수용 가능하다고 주장함
- VRAM이 제한적인 이미지 기반 비디오 생성 사용자를 위한 것임. 이전 버전의 Quick(4 스텝) / Standard(20 스텝) 두 단계 방식은 먼저 프롬프트를 빠르게 조정한 후 정밀하게 다듬는 개념이었음
- 무료이며, 공개 후 10시간 동안 53회 다운로드되었고, 모델 페이지 누적 다운로드는 878회임
사용 방법
- MiniMax_H3_V5xs_Turbo6_MultiLoRA_RTX2x.json을 가져오고, ComfyUI LoRA Manager, ComfyUI NVIDIA VFX Nodes, ComfyUI KJNodes를 추가로 설치함
- 두 개의 디테일 LoRA의 이름과 스텝 수는 저자가 v3 설명에 기재하지 않음
리스크 및 제한 사항
- 저자는 업데이트 설명을 작성하지 않음(버전 설명이 비어 있으며, v3 내용은 모델 카드의 첫 몇 줄에만 존재함)
- 유일한 예시는 민감 등급으로 분류되어 숨겨져 있어 효과를 미리 볼 수 없으며, 라이선스상 상업적 사용과 파생 작업이 모두 허용되지 않음
- 의존하는 노드와 모델은 직접 확인해야 하며, 본 도구는 실행되지 않음
- 카드의 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아님. 저자는 공개된 일반 등급의 예시를 제공하지 않음
수록만 함 (3)
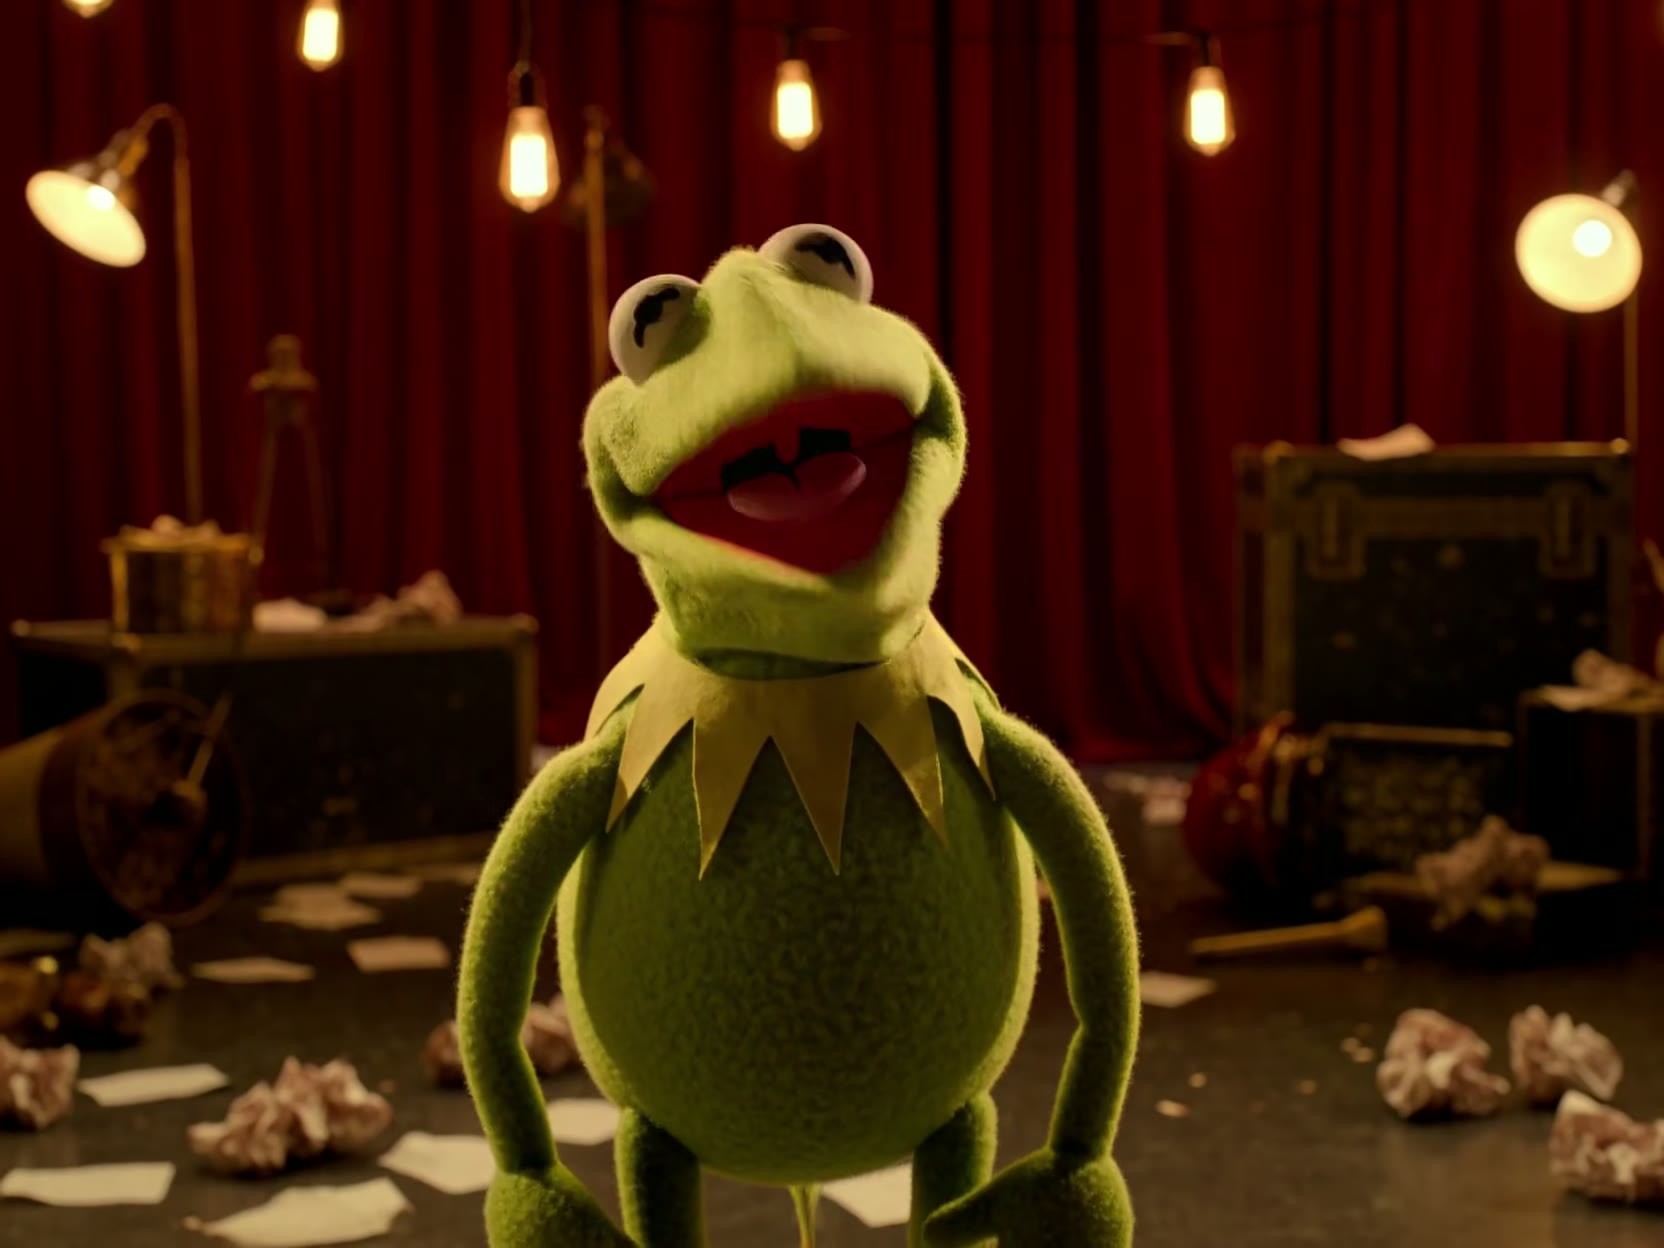
- Kermit the Frog Muppet Minimax H3 Refmod · v1.0 — LoRA: 인형 캐릭터 Kermit의 캐릭터 참고 파일로, 저자는 외형과 목소리 두 가지 참고를 하나의 파일로 통합했다고 설명함. H3의 참고 기반 비디오 생성에서 이 인형 캐릭터가 등장해 말하도록 하는 데 사용됨.
- onef0x · v1.0 medium — LoRA: 저자가 연습용으로 만든 캐릭터 LoRA로, 트리거 워드 onef0x는 특정 인간형 캐릭터에 바인딩되어 있음. 저자는 이것이 스타일 LoRA처럼 전체 화면에 영향을 미친다고 스스로 언급함.
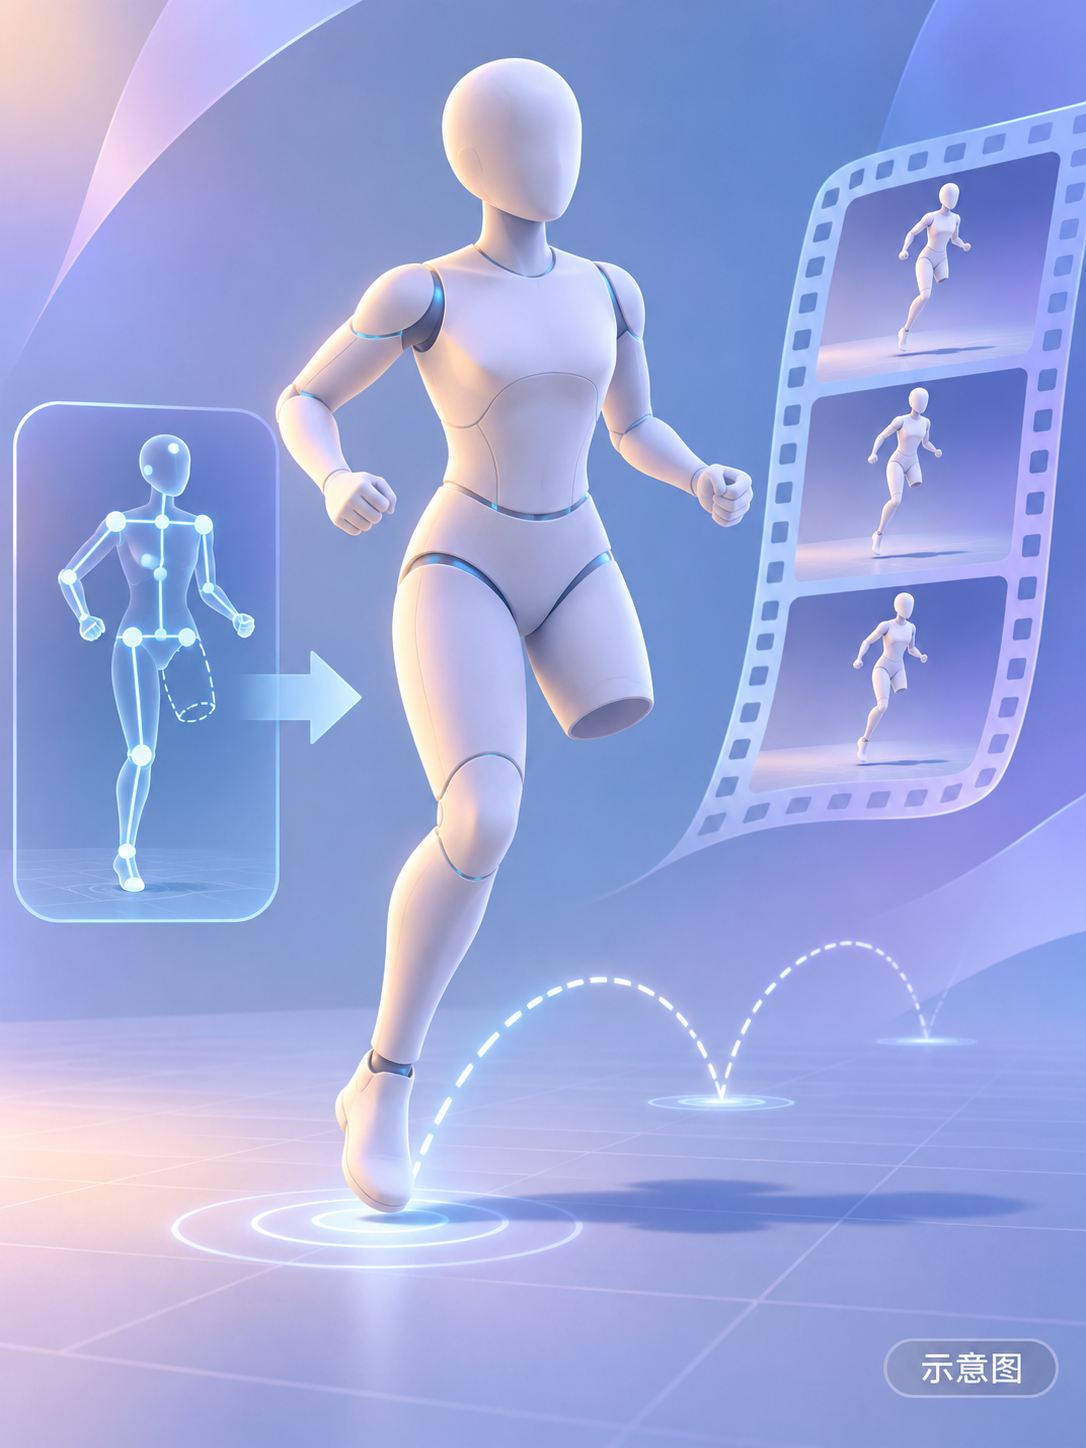
- Single above knee hopping · Minimax — LoRA: 동작 LoRA로, 한쪽 다리가 무릎 위 절단된 캐릭터가 나머지 한쪽 다리로 한 발 뛰기를 하도록 함.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수록 기간 11-21 20:31 → 11-22 09:01(베이징 시간). 추천 이유는 편집 검수를 거쳤으며, 다운로드 수는 관심도를 나타낼 뿐임.