Radar AI của Trinh Trinh · MiniMax H3 · Bản tin buổi sáng 2026-11-22
Bản tin này có 10 phiên bản mới: Đề xuất mạnh mẽ 1 · Đề xuất 3 · Đáng chú ý 3 · Chỉ ghi nhận 3
Lời bình của biên tập viên Bản tin này đã xem xét 11 phiên bản mới của H3, gồm 1 xếp hạng S, 3 xếp hạng A, 3 xếp hạng B, 3 xếp hạng C, và loại trừ 1 mục. Đề xuất hàng đầu là LoRA phong cách Eto Ranger: phong cách hoạt hình cel-shading kiểu Nhật thập niên 90 được huấn luyện bằng các đoạn clip hoạt hình năm 1995, cung cấp đầy đủ từ khóa kích hoạt, cường độ, LoRA tăng tốc, bộ lấy mẫu và số bước. Dispatch 3D phong cách cel-shading v2, H3 Look Sheets bảng thiết kế đa góc v1.3, LoRA âm thanh giọng nữ v1.2 được xếp hạng A; quy trình làm việc nhân bản giọng nói bị hạ từ A xuống B do thiếu ví dụ và tham số. Mid journey anime là LoRA hình ảnh cho H3 Image, không thuộc mảng video nên bị loại trừ.
Đề xuất mạnh mẽ (1)
【S】Phong cách nghệ thuật Eto Ranger · prototype
LoRA · Mô hình mới · Tác giả OrioTysumi · Phát hành 11-21 22:24 · Tải xuống 62
LoRA video này biến hình ảnh thành phong cách hoạt hình cel-shading thập niên 90 giống bộ phim truyền hình Nhật Bản năm 1995 "Juuni Senshi Bakuretsu Eto Ranger", dùng để tạo ra các cảnh quay động vật nhân hóa với chất lượng hoạt hình TV Nhật Bản cổ điển.
Hình minh họa
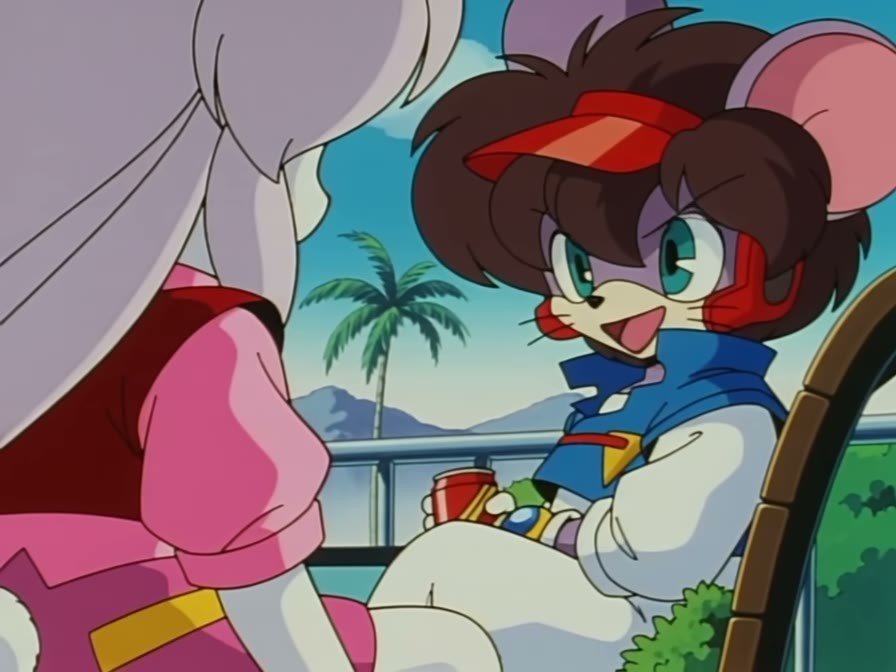
Lý do đề xuất
- Mô hình mới: Tác giả huấn luyện bằng 287 đoạn clip cắt từ các tập đầu của bộ phim, nhằm tái tạo phong cách và không khí hoạt hình cel-shading Nhật Bản thập niên 90, có thể sử dụng trực tiếp cho việc tạo video từ văn bản
- Tham số đầy đủ: Cường độ 1.0, kết hợp với LoRA tăng tốc DMAD 4 bước, bộ lấy mẫu er_sde, bộ lập lịch beta, số bước từ 6 đến 8
- Tác giả cũng đưa ra lời khuyên sử dụng: Để tái tạo nhân vật gốc, hãy kết hợp với R2VA (tạo video từ tham chiếu); đặt tỷ lệ khung hình 4:3 để giống phát sóng TV ngày xưa, 16:9 để giống phiên bản điện ảnh; thêm các từ khóa hoạt hình cổ điển vào prompt
- Có thể xem 5 đoạn video mẫu; miễn phí, đạt 62 lượt tải và 10 lượt thích sau 11 giờ phát hành
Cách sử dụng
- Viết từ khóa kích hoạt etoranger vào prompt, đồng thời thêm các từ khóa cổ điển liên quan đến hoạt hình Nhật Bản thập niên 90
- Đặt cường độ LoRA là 1.0; chồng thêm LoRA DMAD 4 bước, bộ lấy mẫu er_sde, bộ lập lịch beta, số bước từ 6 đến 8
- Dùng tỷ lệ khung hình 4:3 nếu muốn giống bản TV, 16:9 nếu muốn giống bản điện ảnh; kết hợp thêm hình ảnh tham chiếu R2VA nếu muốn tái tạo nhân vật gốc
Rủi ro và hạn chế
- Dữ liệu huấn luyện lấy từ tác phẩm hoạt hình có bản quyền, giấy phép thương mại chỉ cho phép cho thuê, không cho phép bán ảnh
- Có 3 ví dụ cấp độ nhạy cảm đã bị ẩn; tên phiên bản là prototype (nguyên mẫu), tác giả không nói rõ liệu có tiếp tục huấn luyện trong tương lai hay không
Từ khóa kích hoạt: etoranger
Đề xuất (3)
【A】LoRA Phong cách Dispatch H3 · v2.0 Mô hình tham chiếu
LoRA · Cập nhật phiên bản · Tác giả tazmannner379 · Phát hành 11-21 22:50 · Tải xuống 90
Phiên bản thứ hai của LoRA phong cách truyện tranh cel-shading 3D cho trò chơi Dispatch, được huấn luyện lại từ đầu với bộ dữ liệu mới, hướng tới mô hình tạo video từ tham chiếu, kết hợp với hình ảnh thiết kế nhân vật và đoạn lồng tiếng do tác giả tổng hợp để tạo ra các nhân vật trong trò chơi theo yêu cầu.
Hình minh họa
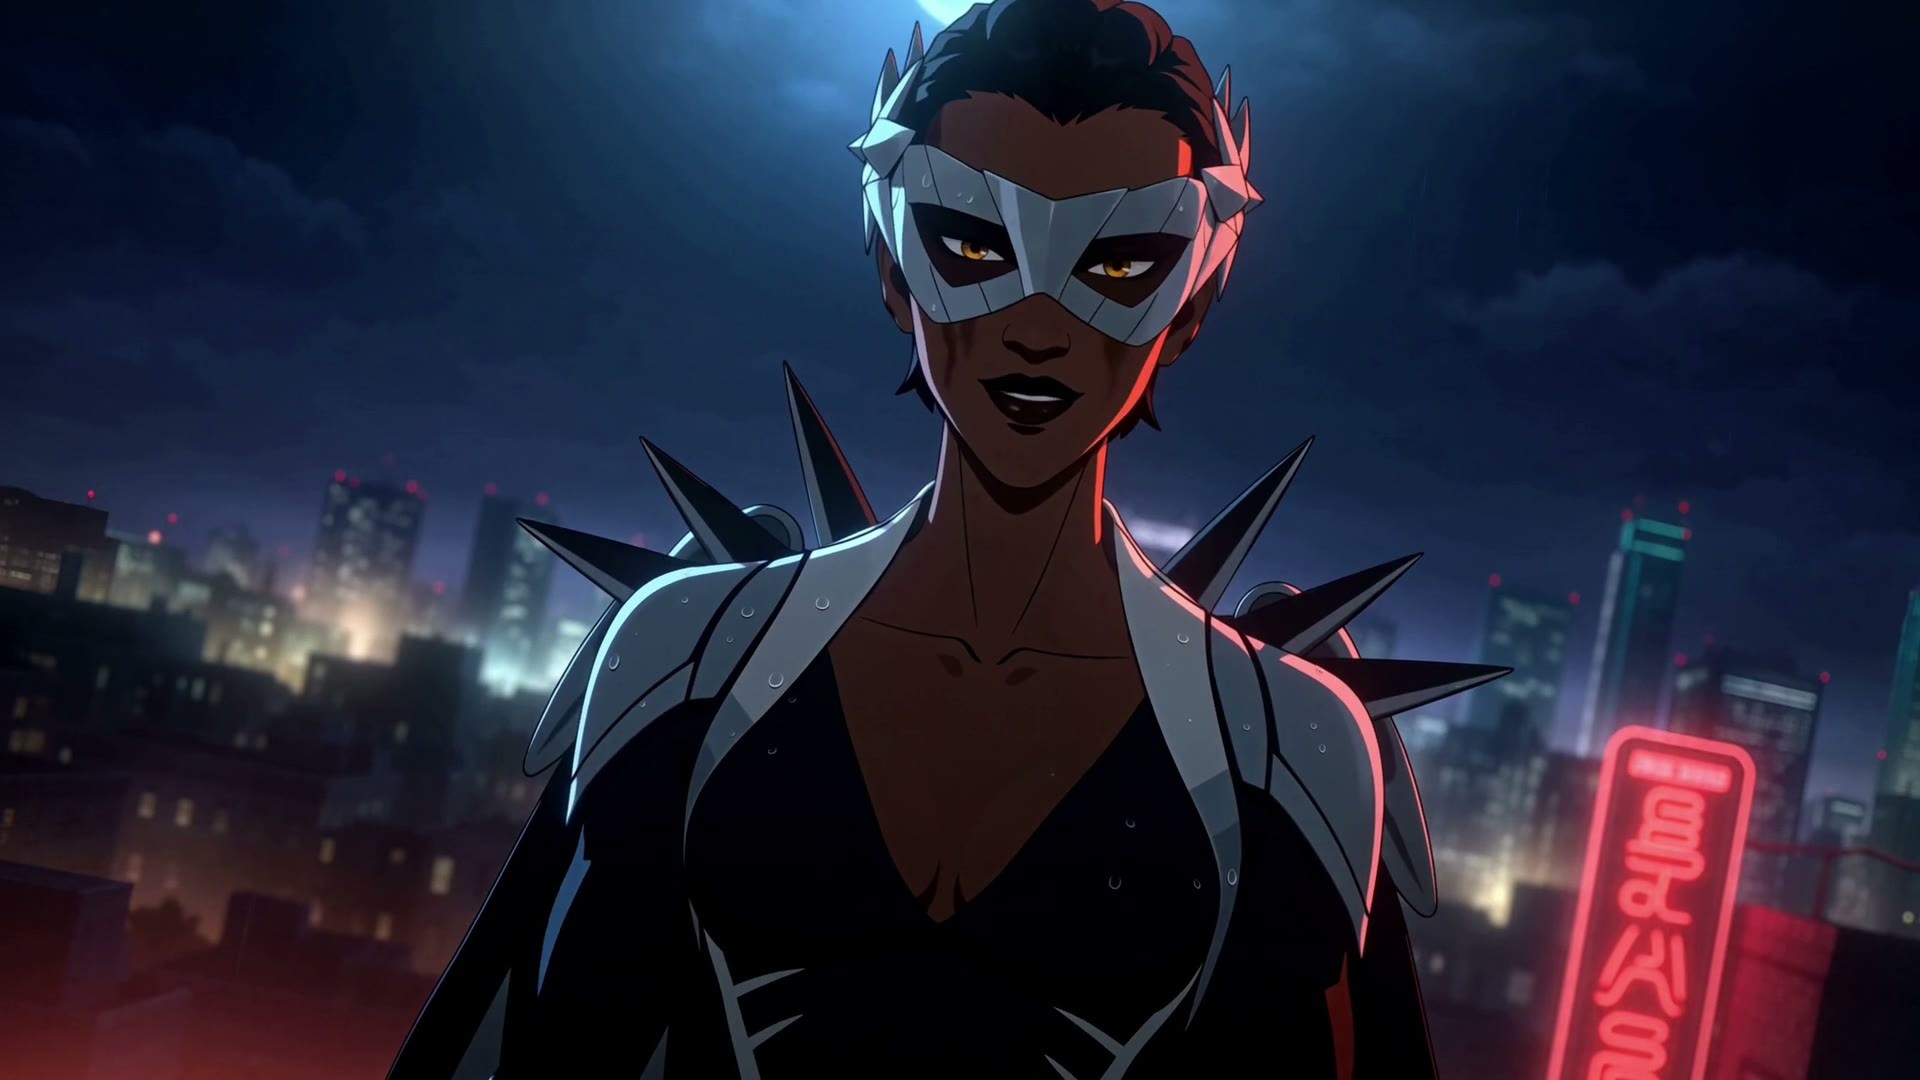
Lý do đề xuất
- Cập nhật phiên bản: Tác giả tuyên bố phiên bản này được huấn luyện từ đầu và thay đổi bộ dữ liệu mới; tên phiên bản là Ref Model, tên tệp có chứa REF, trang mô tả trên Hugging Face ghi rõ nó được huấn luyện trên mô hình tạo video từ tham chiếu H3 (Ref2VA) và cũng phải được sử dụng trên mô hình đó
- Tác giả đã đăng tải toàn bộ tài liệu đi kèm trên Hugging Face: hình ảnh thiết kế nhân vật, đoạn tham chiếu lồng tiếng và hướng dẫn prompt nhân vật, thẻ mô hình ghi rõ mỗi nhân vật đều có thể được gọi tên bằng prompt hoặc hình ảnh tham chiếu
- Từ khóa kích hoạt rõ ràng: Stylized 3D cel-shaded comic style, Dispatch style; tệp này trên Civitai là điểm kiểm tra step00004200
- Có thể xem 10 đoạn video mẫu; miễn phí, đạt 90 lượt tải và 19 lượt thích sau 10 giờ phát hành, trang mô hình đạt tổng cộng 888 lượt tải
Cách sử dụng
- Bắt đầu prompt bằng Stylized 3D cel-shaded comic style, Dispatch style
- Tải vào mô hình tạo video từ tham chiếu H3 (Ref2VA), cường độ 1; ngoại hình nhân vật dựa trên hình ảnh thiết kế của tác giả làm tham chiếu, giọng nói dựa trên đoạn lồng tiếng làm tham chiếu âm thanh, cách viết nhân vật xem trong CHARACTERS.md
- Thẻ mô hình trên Civitai không ghi số bước, CFG, cần xem trang mô tả trên Hugging Face
Rủi ro và hạn chế
- Cường độ, mô hình cơ sở, chi tiết huấn luyện (huấn luyện bằng 589 đoạn clip + 777 ảnh chụp màn hình, chỉ huấn luyện video không huấn luyện âm thanh) chỉ được ghi trên trang Hugging Face, mô tả phiên bản trên Civitai chỉ có một câu "trained from scratch, new dataset"
- Tài nguyên lấy từ các đoạn cắt cảnh của trò chơi Dispatch, tác giả tuyên bố trên trang HF rằng không sở hữu bản quyền, nhưng giấy phép Civitai đã chọn cho phép bán, cần tự đánh giá khi sử dụng thương mại
- 4 ví dụ cấp độ nhạy cảm đã bị ẩn; trang Hugging Face còn có hai điểm kiểm tra khác (3900 / 4500), tác giả đề nghị chuyển sang dùng khi 4200 bị lệch
Từ khóa kích hoạt: Stylized 3D cel-shaded comic style, Dispatch style
【A】H3 Look Sheets · v1.3 - Relay VSR/SeedVR2
Quy trình làm việc · Cập nhật phiên bản · Tác giả FromWood · Phát hành 11-21 23:45 · Tải xuống 56
Đặt một bức ảnh chân dung và vài bức ảnh trang phục, sử dụng H3 tạo video đa tham chiếu để quay các góc độ khác nhau của nhân vật mặc bộ trang phục đó trong một lần, sau đó tự động chọn khung hình và sắp xếp thành bảng thiết kế nhân vật/trang phục dưới dạng gói nút ComfyUI; v1.3 bổ sung thêm một quy trình làm việc phóng to bằng RelayVSR.
Hình minh họa
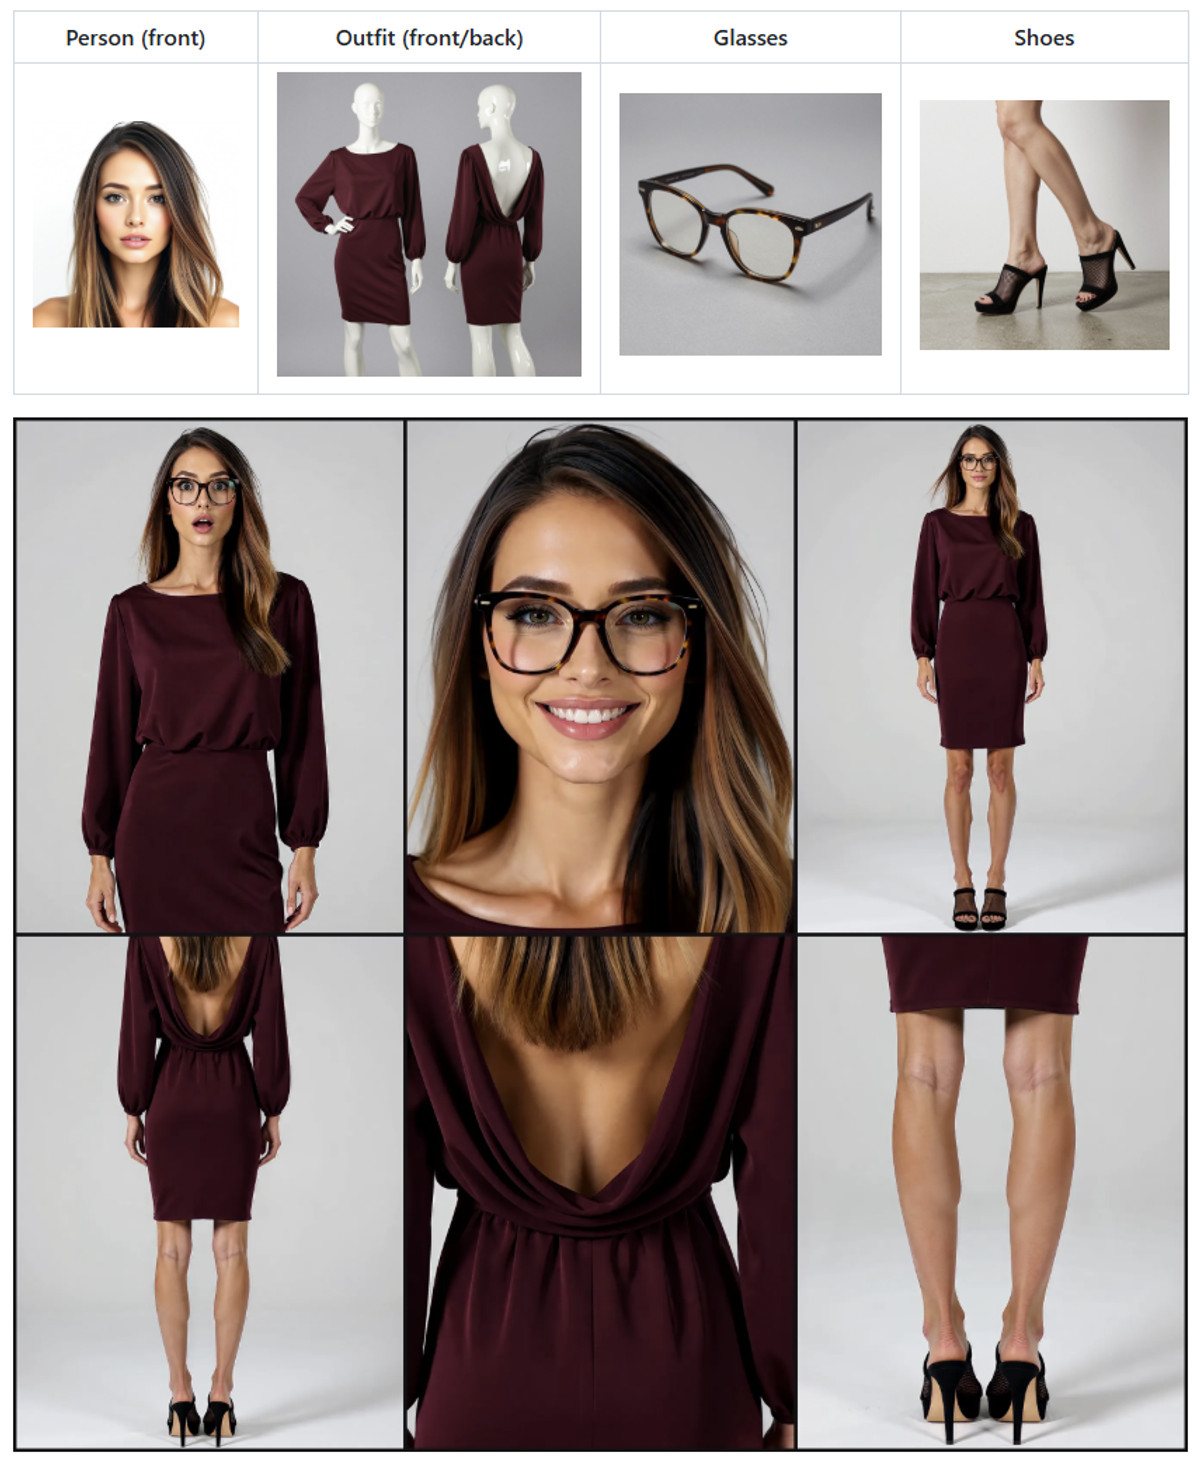
Lý do đề xuất
- Cập nhật phiên bản: Bổ sung tệp ComfyUI-H3LookSheets-2StageSamplingUpscaleRelayVSR.json, sử dụng RelayVSR x2 tích hợp sẵn của ComfyUI để thay thế SeedVR2, phóng to toàn bộ video sau bước H3 Face Refine và trước bước Select Frames; quy trình làm việc SeedVR2 cũ chỉ được đổi tên
- Bản chất công cụ: Qwen3-VL trước tiên viết mô tả cho mỗi hình ảnh tham chiếu, sau đó tự động viết prompt phân cảnh dựa trên bộ phận cơ thể × góc máy bạn chọn, H3 quay tất cả các góc độ trong một video, Select Frames chọn ra những khung hình tốt nhất và khác biệt nhất để sắp xếp
- Phục vụ các nhiệm vụ như nhất quán nhân vật, lookbook trang phục, chuẩn bị tập dữ liệu huấn luyện LoRA, tham chiếu trang phục
- Miễn phí, đạt 56 lượt tải sau 9 giờ phát hành, trang mô hình đạt tổng cộng 728 lượt tải
Cách sử dụng
- git clone ComfyUI-H3LookSheets vào thư mục custom_nodes, kéo quy trình làm việc tương ứng vào canvas; phiên bản RelayVSR yêu cầu ComfyUI v0.45.0 trở lên, phiên bản SeedVR2 giữ nguyên yêu cầu cũ
- Ví dụ của tác giả sử dụng mô hình int8 ref2va + LoRA turbo 4 bước, mô hình thị giác sử dụng Qwen3-VL (qwen3vl_4b_fp8_scaled)
- Giữ nguyên kiểu tóc của cùng một người trong các hình ảnh tham chiếu; nếu ảnh trang phục là do người khác mặc, hãy cắt bỏ phần đầu trước; mỗi hình ảnh trang phục phải được gán vào đúng khe
Rủi ro và hạn chế
- Phiên bản này chỉ thêm một phương án phóng to, những người đang dùng v1.2 và chạy được SeedVR2 không cần cập nhật
- Phụ thuộc nhiều vào xử lý hậu kỳ (latent upscaler, H3 Face Refine, KJNodes, Impact Pack, v.v.), công cụ này chưa được chạy thử
- Civitai chỉ có 1 hình ảnh mẫu (1 hình cấp độ nhạy cảm khác đã bị ẩn), video demo nằm trong danh sách phát YouTube của tác giả
【A】Giọng nữ Minimax · v1.2
LoRA · Cập nhật phiên bản · Tác giả imb101 · Phát hành 11-22 05:25 · Tải xuống 97
Bộ sưu tập LoRA giọng nữ chỉ thay đổi phần âm thanh của H3, mỗi giọng một tệp, giúp nhân vật nói chuyện với giọng Anh được chỉ định; v1.2 bổ sung 6 giọng mới gồm Manchester, Mexico, Bắc Ireland, Romania, Nga, và tiếng Pháp Quebec.
(Biên tập viên nâng lên hạng A: Cách dùng, trọng số, cách viết từ khóa kích hoạt đều rõ ràng, bổ sung nhiều giọng mới, nhưng chỉ có 1 ví dụ.)
Hình minh họa
Lý do đề xuất
- Cập nhật phiên bản: Thêm 6 giọng mới; nén DIM của 5 giọng đầu tiên (Utah, Atlanta, New Jersey, Liverpool, Minnesota) từ 32 xuống 8, tệp nhỏ hơn, tác giả tuyên bố dạng sóng gần như giống hệt; đóng gói tất cả vào một tệp zip, đồng thời tải lên riêng lẻ từng tệp
- Giải quyết vấn đề giọng mặc định của H3 khá phẳng: Tác giả tuyên bố chỉ thay đổi lớp âm thanh, không ảnh hưởng đến hình ảnh, phù hợp để gán lời thoại với giọng đặc biệt cho nhân vật nữ trong quy trình tạo video từ hình ảnh / tạo video từ văn bản
- Cách viết prompt thống nhất: Thêm in a <tên giọng> accent trước hoặc sau lời thoại, riêng Quebec viết trực tiếp là Quebecois
- Miễn phí, đạt 97 lượt tải và 14 lượt thích sau 4 giờ phát hành, trang mô hình đạt tổng cộng 1256 lượt tải
Cách sử dụng
- Tải LoRA đơn lẻ tương ứng với mỗi giọng, trọng số 0.6-0.8, đặt audio sampling là 3 (tăng lên nếu xuất hiện âm thanh bong bóng kỳ lạ)
- Viết lời thoại dưới dạng The woman says [English]…… in a manchester accent, tên giọng có thể đặt trước hoặc sau lời thoại
Rủi ro và hạn chế
- Mỗi giọng một LoRA, không thể để hai người nói hai giọng khác nhau trong cùng một lần tạo; chỉ dành cho giọng nữ
- Chỉ có 1 đoạn video mẫu hiển thị được (1 đoạn khác đã bị ẩn), tác giả tự nhận một số giọng mạnh, một số giọng yếu
- Quét bảo mật tệp zip chưa hoàn tất; trong tệp có cả hai phiên bản Quebecois và Quebecois-French, tác giả không nói rõ sự khác biệt; giấy phép không cho phép tạo tác phẩm phái sinh
Đáng chú ý (3)
【B】Nhân bản giọng nói MiniMax H3 (Chỉ âm thanh) · v1.0
Quy trình làm việc · Mô hình mới · Tác giả NekoCap · Phát hành 11-22 07:20 · Tải xuống 51
Quy trình làm việc ComfyUI để nhân bản giọng nói bằng cách sử dụng tính năng tạo âm thanh của H3: Cung cấp một mẫu giọng nói đơn lẻ sạch sẽ, chỉ xuất ra âm thanh mô phỏng theo âm sắc đó.
(Biên tập viên hạ xuống hạng B: Không có ví dụ, không ghi tham số và phụ thuộc.)
Hình minh họa
Lý do đề xuất
- Mô hình mới: Phục vụ các tác vụ chỉ cần âm thanh như lồng tiếng, lời thoại nhân vật; tác giả gọi là "hiệu quả khá tốt", nhưng cũng tự nhận đây là một "thí nghiệm ngớ ngẩn"
- Yêu cầu mẫu rõ ràng: Chỉ cần giọng người đơn, nhiễu nền nhẹ hoặc nhạc nền không lời không ảnh hưởng nhiều; mẫu âm thanh trộn nhiều người sẽ làm H3 bị rối
- Miễn phí, tải xuống 51 lần trong 2 giờ sau khi phát hành
Cách sử dụng
- Tải MiniMax-H3_Voice-Clone.json và nhập vào ComfyUI, đặt vào một mẫu giọng người đơn
- Tác giả không cung cấp các node, mô hình và tham số cần thiết
Rủi ro và hạn chế
- Không có ví dụ âm thanh hoặc video nào, hình ảnh xem trước duy nhất chỉ là một câu nói: tác giả cho biết Civitai có thể không chấp nhận các bản xem trước thực tế
- Việc nhân bản giọng nói của người khác có rủi ro pháp lý và đạo đức, tác giả đã miễn trừ trách nhiệm rõ ràng; hãy xác nhận quyền sử dụng mẫu giọng nói trước khi dùng
- Mô tả rất ngắn gọn, các node và mô hình phụ thuộc cần tự kiểm tra, công cụ này chưa được chạy thử
【B】Trình tải & Xem OmegaWPN cho YouTube, Facebook, Pinterest và Instagram · v0.4
Công cụ khác · Cập nhật phiên bản · Tác giả OmegaWPN · Phát hành 11-22 00:49 · Tải xuống 28
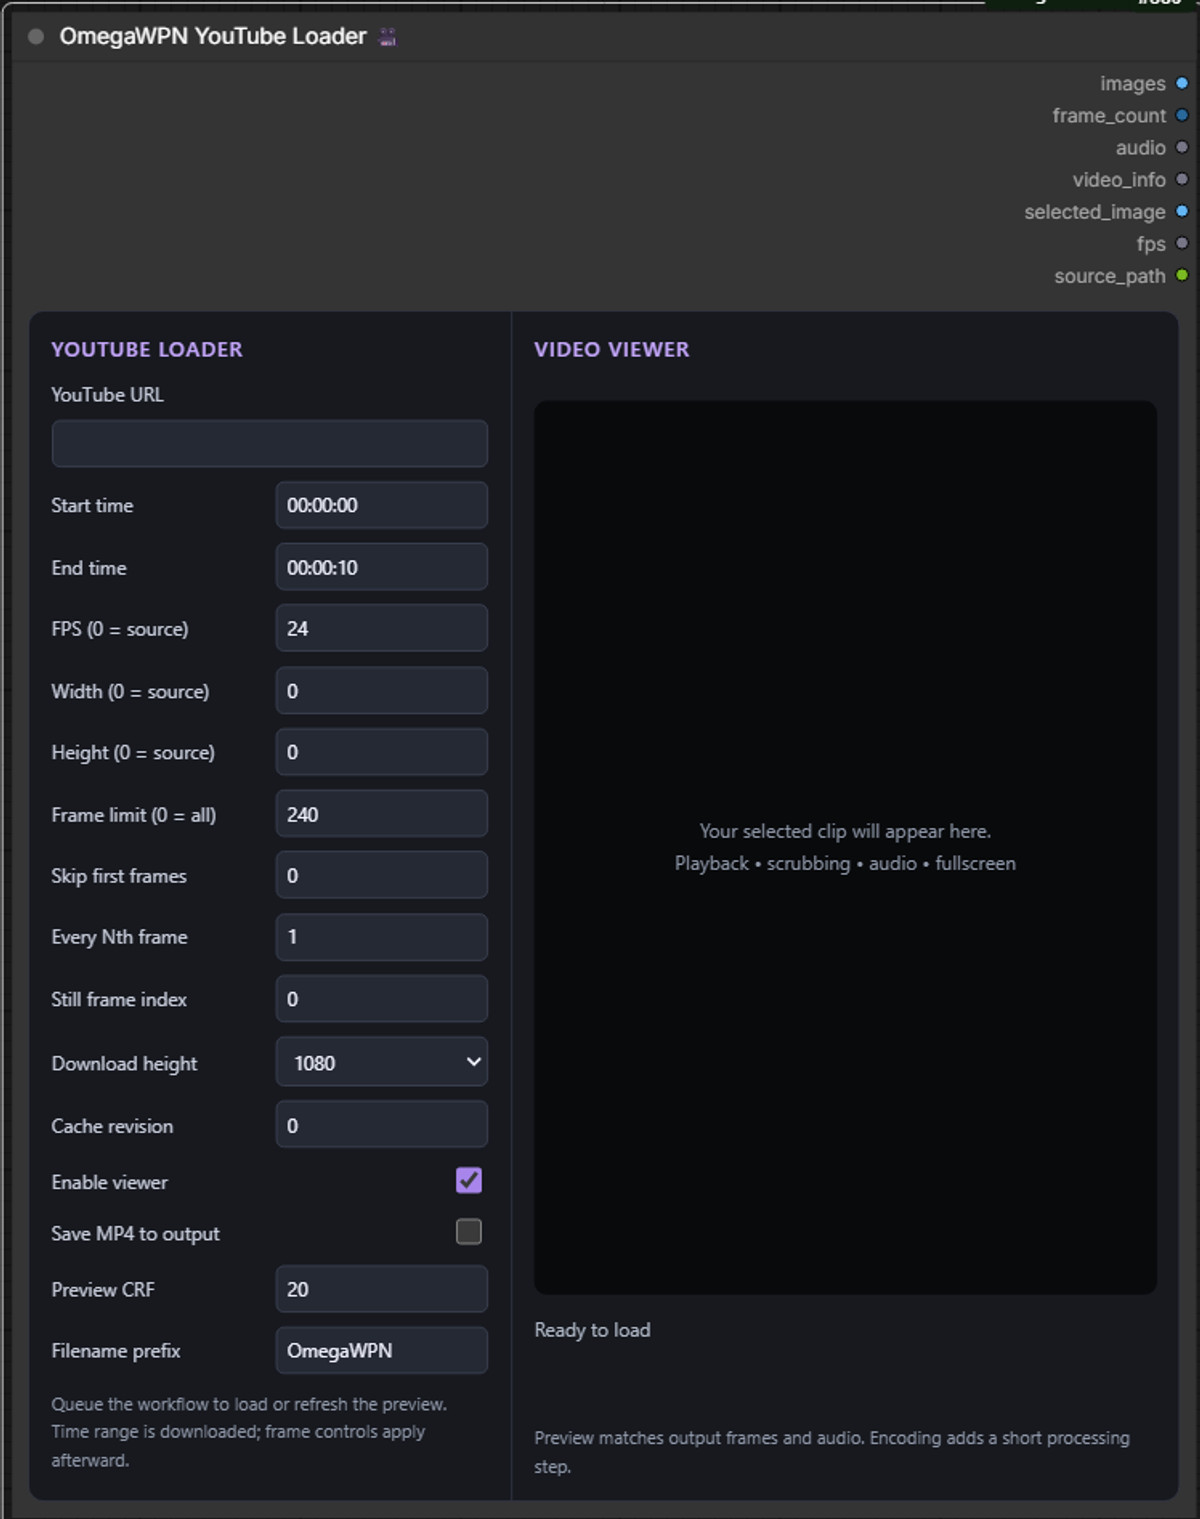
Node tải video cho ComfyUI: Dán địa chỉ video từ YouTube, Instagram, Facebook, Pinterest hoặc liên kết trực tiếp, chỉ tải một đoạn dựa trên thời gian bắt đầu và kết thúc, xuất ra các khung hình, âm thanh và một khung hình đơn được chọn, kèm theo trình phát xem trước bên cạnh node.
Được liệt kê là công cụ: Không liên kết trực tiếp với H3, phù hợp cho những ai cần cắt các đoạn tham khảo từ internet.
Hình ảnh minh họa
Lý do đề xuất
- Cập nhật phiên bản: v0.4 mở rộng từ trình tải YouTube thành trình tải video chung, hỗ trợ các trang web và liên kết trực tiếp mà yt-dlp có thể truy cập; có thể điều chỉnh FPS, độ phân giải, bỏ qua khung hình và giới hạn số lượng khung hình
- Mối quan hệ với H3: Nó không chứa bất kỳ trọng số H3 hoặc node chuyên dụng cho H3 nào, đây là một công cụ đầu vào chung, tác giả đánh dấu mô hình cơ sở là H3; có thể dùng để chuẩn bị tài liệu cho việc tạo video từ tham khảo hoặc tham khảo âm thanh của H3, nhưng tác giả không viết ví dụ cho H3
- Miễn phí, tải xuống 28 lần trong 8 giờ sau khi phát hành, trang mô hình tích lũy 107 lượt tải
Cách sử dụng
- Giải nén vào ComfyUI\custom_nodes, cài đặt VideoHelperSuite, yt-dlp, FFmpeg; YouTube còn cần một môi trường chạy JavaScript như Deno
- Đối với phiên bản di động Windows, trước tiên chạy install_portable.bat và một lần chạy activate youtube (only once).bat, khởi động lại rồi thêm OmegaWPN YouTube Loader
- Ví dụ của tác giả: 24 FPS, lấy 15 giây, đặt giới hạn khung hình là 360, đặt 0 để đọc tất cả các khung hình trong phạm vi
Rủi ro và hạn chế
- Không phải là mô hình H3, thuộc loại công cụ ComfyUI chung; script cài đặt chỉ dành cho phiên bản di động Windows, đường dẫn mặc định được cố định là C:\ComfyUI_windows_portable
- Việc tải video từ mạng liên quan đến điều khoản nền tảng và bản quyền tài liệu; một số trang web yêu cầu đăng nhập hoặc không được hỗ trợ
- Giấy phép không cho phép tạo tác phẩm phái sinh; tác giả không viết hướng dẫn cập nhật chi tiết so với v0.3
【B】Quy trình làm việc img2Vid MiniMax H3 (VRAM 12GB) · v3.0
Quy trình làm việc · Cập nhật phiên bản · Tác giả theevildarkmage126 · Phát hành 11-21 23:07 · Tải xuống 53
Phiên bản thứ 3 của quy trình làm việc ComfyUI tạo video từ hình ảnh H3 dành cho VRAM 12GB: Chuyển sang mô hình Turbo, chồng hai LoRA chi tiết, sau đó phóng to 2 lần.
Hình ảnh minh họa
Lý do đề xuất
- Cập nhật phiên bản: v3 chuyển sang điểm kiểm tra Turbo, sử dụng LoRA Manager để gắn hai LoRA chi tiết, cuối cùng phóng to 2 lần; tác giả cho biết trên RTX 4070, video 5 giây mất khoảng 6 phút, chất lượng hình ảnh vẫn chấp nhận được
- Phục vụ người dùng tạo video từ hình ảnh với bộ nhớ hiển thị hạn chế; ý tưởng hai mức Quick (4 bước) / Standard (20 bước) của phiên bản trước là tinh chỉnh nhanh prompt trước, rồi tinh chỉnh kỹ sau
- Miễn phí, tải xuống 53 lần trong 10 giờ sau khi phát hành, trang mô hình tích lũy 878 lượt tải
Cách sử dụng
- Nhập MiniMax_H3_V5xs_Turbo6_MultiLoRA_RTX2x.json, cài thêm ComfyUI LoRA Manager, ComfyUI NVIDIA VFX Nodes, ComfyUI KJNodes
- Tên của hai LoRA chi tiết và số bước không được tác giả ghi trong mô tả của v3
Rủi ro và hạn chế
- Tác giả không viết hướng dẫn cập nhật (phần mô tả phiên bản trống, nội dung v3 chỉ nằm ở vài câu đầu của thẻ mô hình)
- Ví dụ duy nhất thuộc mức nhạy cảm và đã bị ẩn, không thể xem trước hiệu ứng; giấy phép không cho phép sử dụng thương mại cũng không cho phép tạo tác phẩm phái sinh
- Các node và mô hình phụ thuộc cần tự kiểm tra, công cụ này chưa được chạy thử
- Hình ảnh trên thẻ là hình minh họa do AI tạo, không phải hiệu ứng thực tế của mô hình; tác giả không có ví dụ công khai ở mức bình thường
Chỉ liệt kê (3)
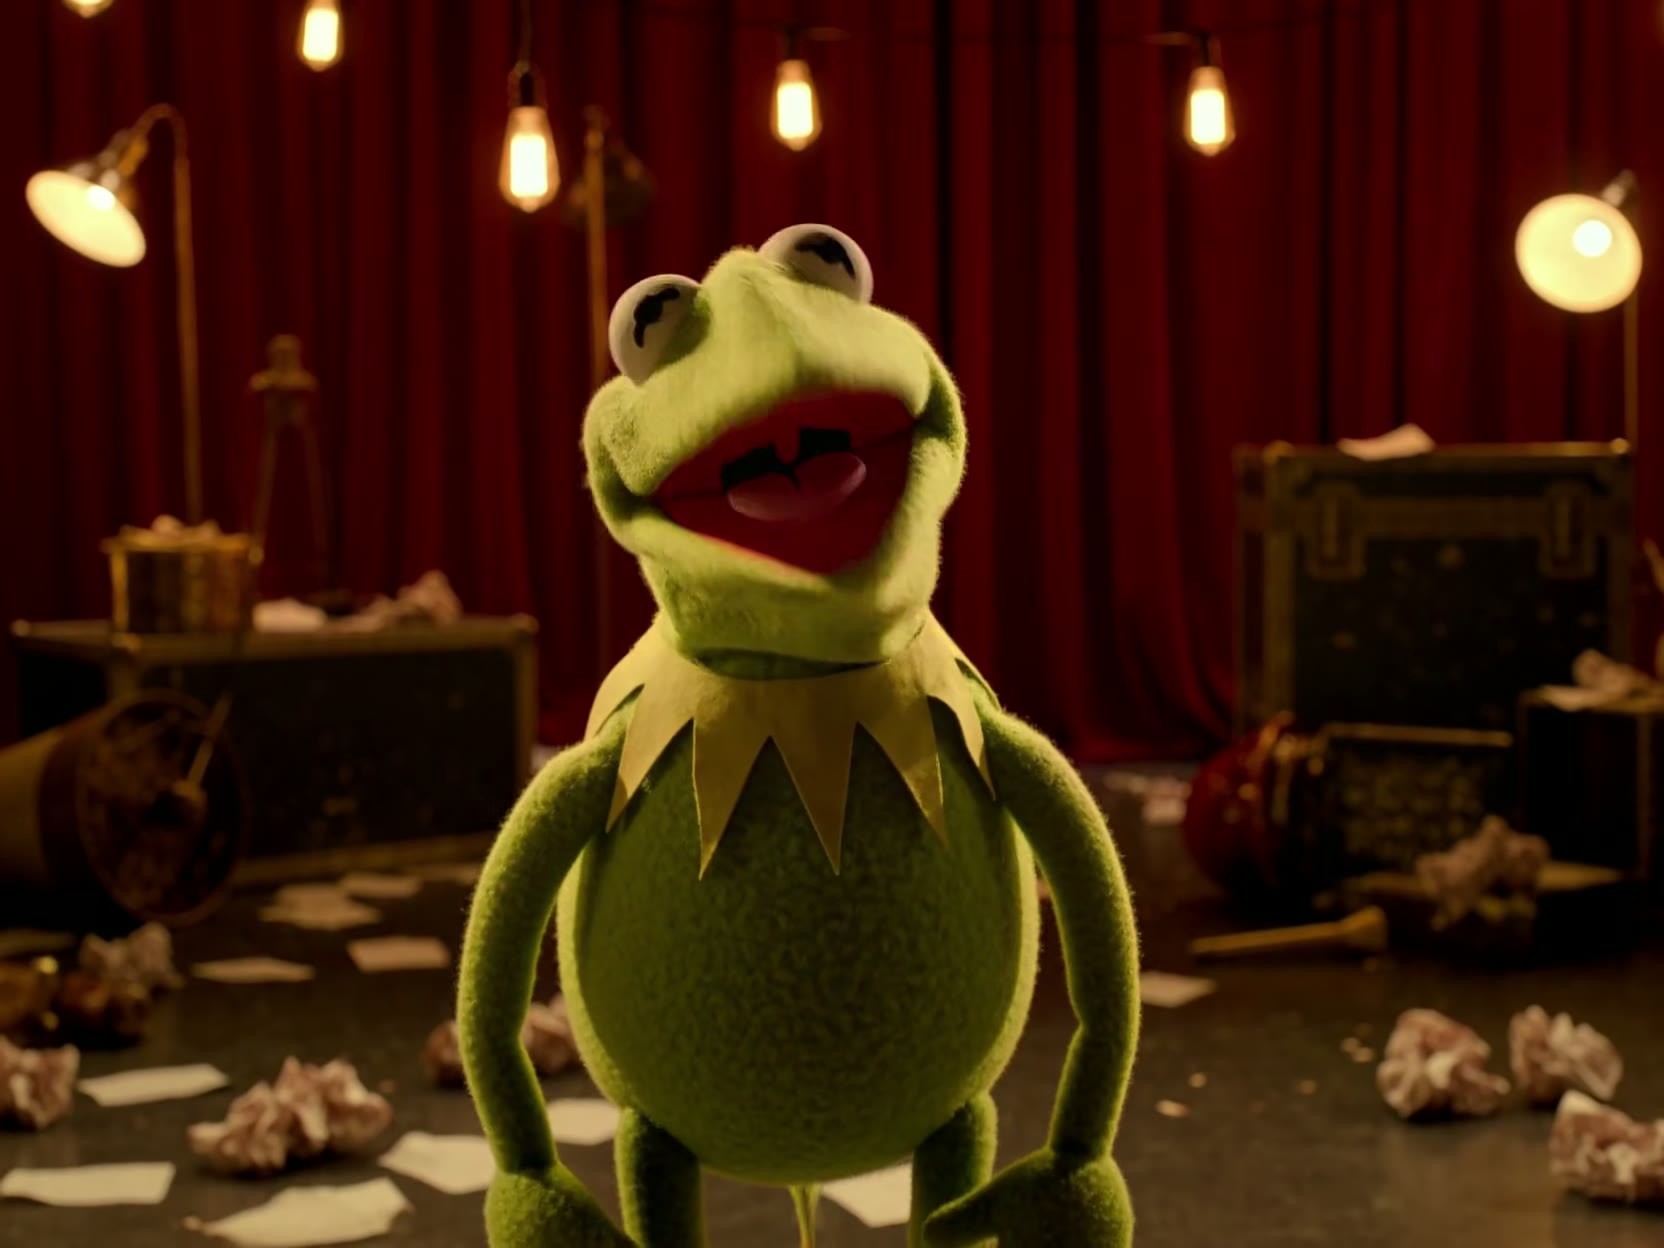
- Kermit the Frog Muppet Minimax H3 Refmod · v1.0 — LoRA: Tệp tham khảo nhân vật cho chú ếch rối Kermit, tác giả cho biết đã kết hợp cả tham khảo ngoại hình và giọng nói vào một tệp, dùng để đưa nhân vật rối này xuất hiện và nói trong quy trình tạo video từ tham khảo của H3.
- onef0x · v1.0 medium — LoRA: LoRA nhân vật để luyện tập của tác giả, từ khóa kích hoạt onef0x liên kết với một nhân vật hình người cụ thể, tác giả tự nói rằng nó sẽ ảnh hưởng đến toàn bộ khung hình giống như một LoRA phong cách.
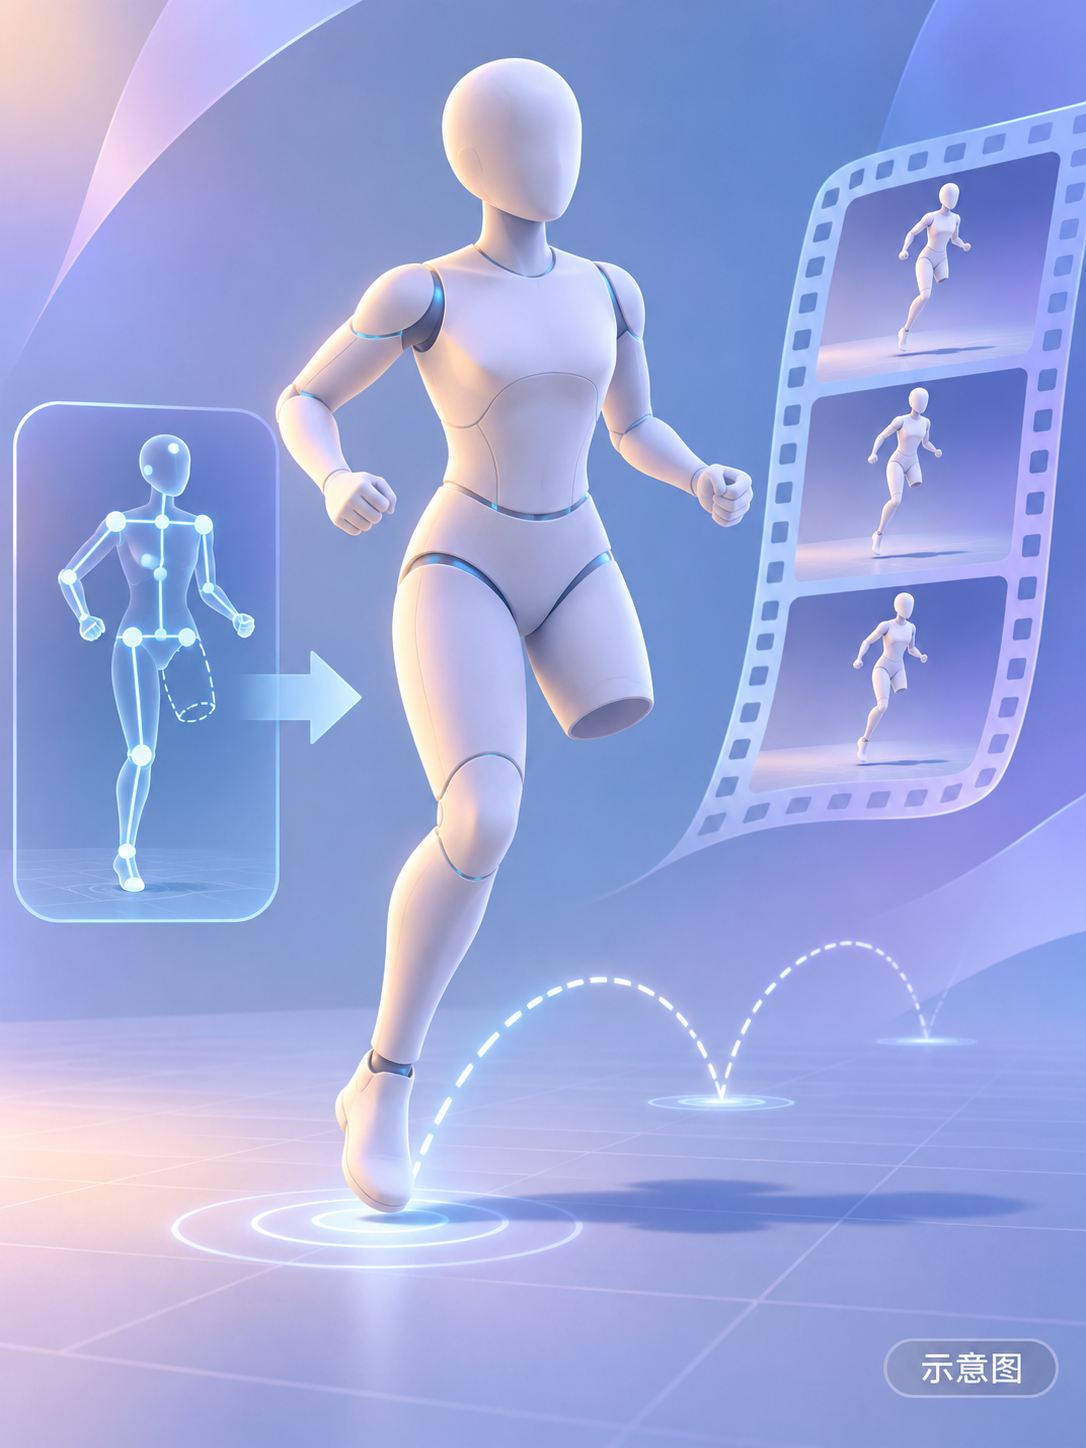
- Single above knee hopping · Minimax — LoRA: LoRA hành động: Cho phép nhân vật bị cắt cụt trên đầu gối một chân nhảy bằng một chân còn lại.
Dữ liệu: API công khai của Civitai (mô hình cơ sở MiniMax H3), cửa sổ liệt kê từ 11-21 20:31 đến 11-22 09:01 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ phản ánh mức độ quan tâm.