Radar AI của Trinh Trinh · Qwen Image 2.1 · Bản tin buổi sáng 2026-11-03
Kỳ này có 4 phiên bản mới: Rất khuyến nghị 0 · Khuyến nghị 2 · Có thể theo dõi 1 · Chỉ ghi nhận 1
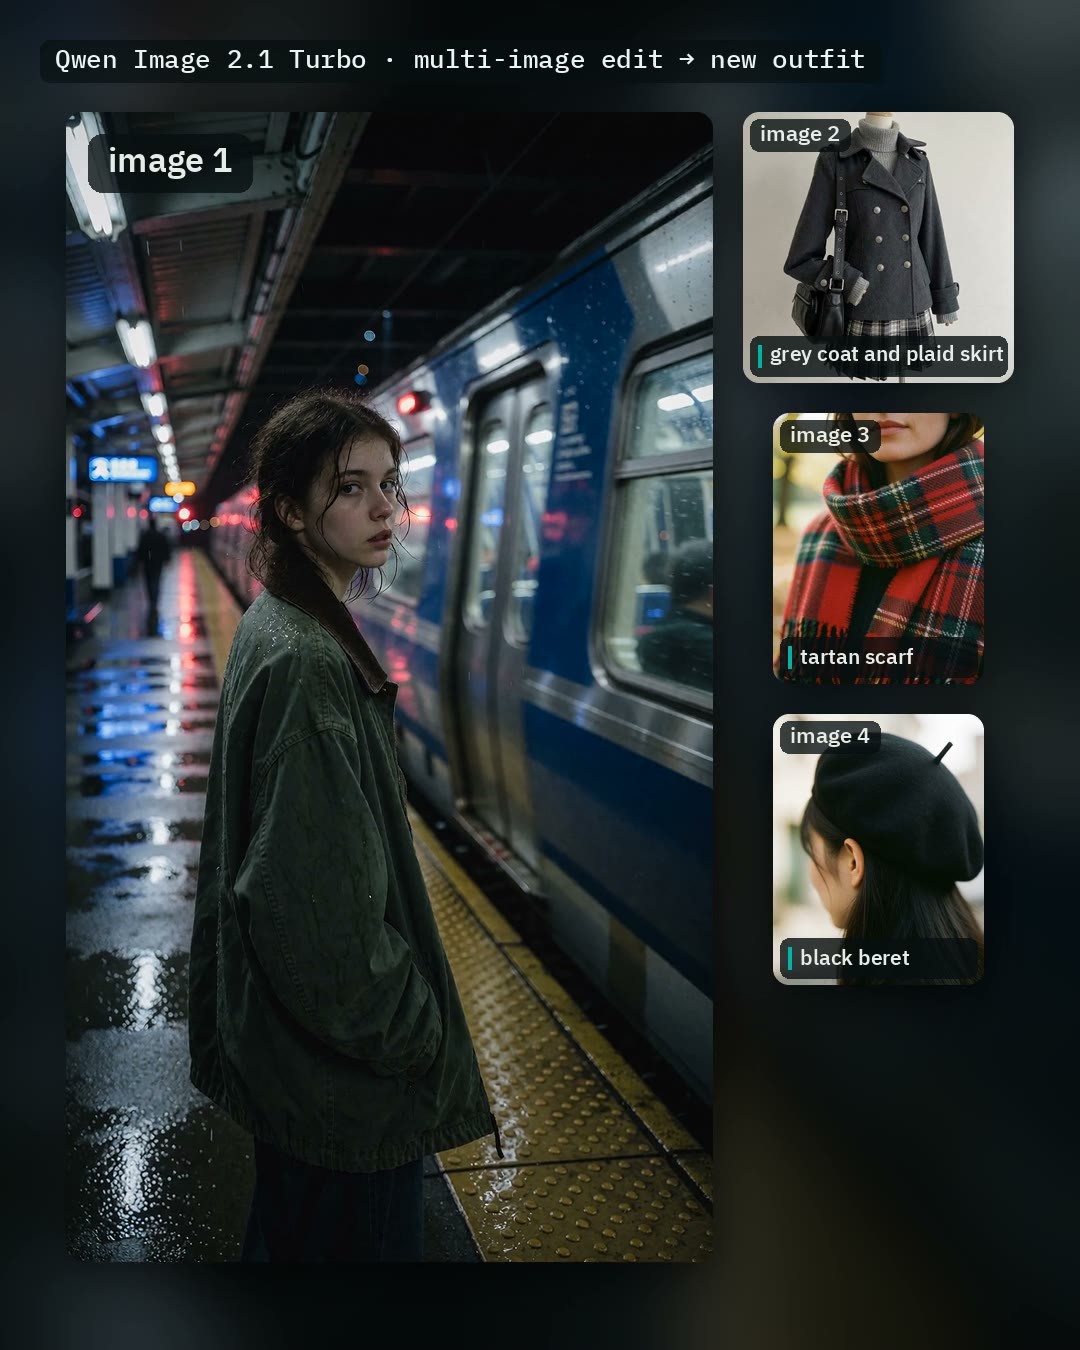
Lời bình của biên tập viên Kỳ này đã xem xét 4 phiên bản mới của Qwen 2.1. Ưu tiên hàng đầu là phiên bản Regular của quy trình làm việc chỉnh sửa đa hình ảnh AusBoss: thay đổi trang phục, kiểu tóc hoặc bối cảnh từ các hình ảnh khác vào hình ảnh 1, với các hộp phía trên mỗi hình tham chiếu ghi rõ bộ phận cần lấy, bổ sung cho những người dùng không có mô hình cơ sở Turbo. LoRA sửa lỗi viền trong suốt có mục đích cụ thể, cường độ và câu lệnh đầy đủ, xếp hạng A; FrameLoom tích hợp hội thoại LLM, phân công hình tham chiếu và xuất ảnh vào một quy trình làm việc, nhiều tính năng nhưng phụ thuộc vào OpenRouter hoặc LLM cục bộ, xếp hạng B; phiên bản Qwen của Claude-chan không có ghi chú cập nhật từ tác giả, xếp hạng C.
Khuyến nghị (2)
【A】Qwen Image 2.1 Chỉnh sửa đa hình ảnh | Regular + Turbo · v1.2 Regular
Quy trình làm việc · Cập nhật phiên bản · Tác giả AusBoss · Phát hành 11-03 08:19 · Tải xuống 15
Phiên bản mô hình thường của quy trình làm việc chỉnh sửa tham chiếu đa hình: thay đổi trang phục của người trong hình 1 bằng trang phục từ tối đa năm hình khác, cũng có thể lấy kiểu tóc, địa điểm, ánh sáng; phiên bản này chạy trên mô hình cơ sở Qwen Image 2.1 thường, dành cho người dùng không có mô hình cơ sở Turbo.
Xếp hạng A ưu tiên hàng đầu: mục đích, tham số, phiên bản phụ thuộc và các bước thao tác đều được ghi rõ; điểm trừ nằm ở việc phụ thuộc vào các nút riêng của tác giả và ít ví dụ cho phiên bản Regular.
Hình minh họa
Lý do khuyến nghị
- Cập nhật phiên bản: cùng một quy trình làm việc trước đây chỉ chạy trên mô hình cơ sở Turbo chính thức (8 bước), phiên bản này chuyển sang mô hình cơ sở thường với 25 bước, và thêm công tắc Fast (Viggle Turbo LoRA + 8 bước); tác giả cho biết việc chỉnh sửa 2 megapixel của hai hình ảnh trên RTX 5090 mất khoảng 25 giây, bật Fast mất khoảng 8 giây
- Phục vụ các chỉnh sửa đa hình tham chiếu như thay trang phục, lấy kiểu tóc của người khác, đổi nền; Auto prompt có ba mức clothes / normal / off, Qwen tự động viết câu lệnh đầy đủ sau khi xem ảnh, không cần tải thêm mô hình
- Hướng dẫn viết chi tiết có thể làm theo: ghi rõ bộ phận cần lấy trong hộp phía trên mỗi hình (ví dụ “jacket”, “red shorts”), tác giả đã cung cấp cách xử lý các lỗi thường gặp; trang mô hình có tổng cộng 2639 lượt tải xuống, 104 lượt thích (chỉ đại diện cho mức độ quan tâm)
Cách sử dụng
- Yêu cầu ComfyUI 0.38 trở lên, AusBoss nodes 2.15.0 trở lên (cập nhật trong ComfyUI-Manager trước rồi khởi động lại); công tắc Fast yêu cầu Viggle Turbo LoRA (liên kết nằm trong chú thích của quy trình làm việc)
- Đặt hình cần chỉnh sửa vào hình 1, đặt các hình tham chiếu từ hình 2 trở đi và bật từng công tắc, ghi rõ thứ cần lấy vào hộp phía trên mỗi hình rồi chạy; đối với các chỉnh sửa khác ngoài thay trang phục, chuyển Auto prompt sang normal
- Người dùng có mô hình cơ sở Turbo hãy chọn v1.2 (phiên bản Turbo) trên cùng trang, hai phiên bản quy trình làm việc giống nhau
Rủi ro và hạn chế
- Danh sách mô hình được liệt kê trên trang mô hình là của phiên bản Turbo, phiên bản Regular cần xem liên kết trong chú thích của quy trình làm việc
- Phiên bản này chỉ có 1 đoạn video ví dụ, có thêm 1 đoạn bị ẩn; phụ thuộc vào gói nút và LoRA riêng của tác giả; mục này chưa được chạy thử
【A】Q2.1 Fix Contour LoRA (Trong suốt) · v1.0
LoRA · Mô hình mới · Tác giả CogDiffusion · Phát hành 11-03 05:27 · Tải xuống 43
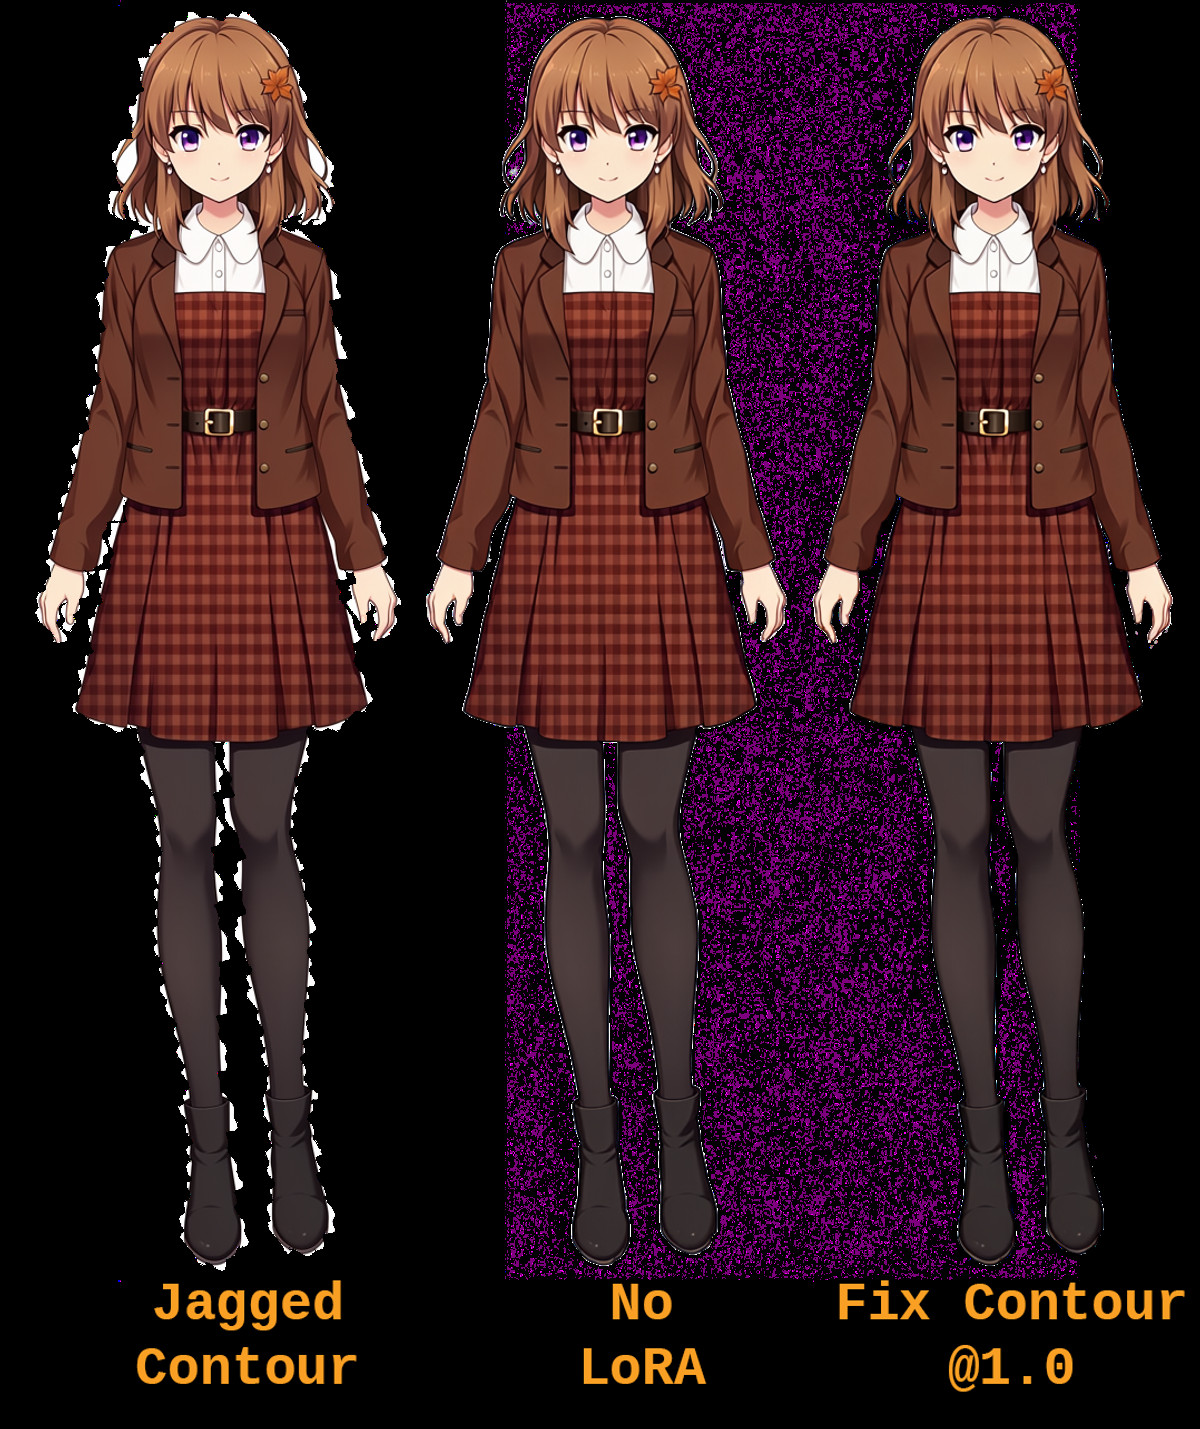
LoRA chỉnh sửa để sửa lỗi viền của chủ thể trên nền trong suốt: Khi Qwen 2.1 chỉnh sửa ảnh có viền trong suốt, dễ xuất hiện răng cưa và biến dạng, LoRA này sử dụng một câu lệnh để làm phẳng viền, đồng thời cũng có thể hỗ trợ cắt ảnh.
Phù hợp để đặt ở bước cuối cùng của quy trình chỉnh sửa ảnh trong suốt để chỉnh sửa viền, có thể so sánh với kết quả không dùng LoRA bằng cùng một seed.
Hình minh họa
Lý do khuyến nghị
- Tính năng mới: tác giả sử dụng hỗ trợ đào tạo RGBA trong suốt của FizGig để huấn luyện, nhắm vào vấn đề răng cưa và biến dạng viền khi Qwen 2.1 chỉnh sửa ảnh trong suốt
- Phục vụ các chỉnh sửa cần viền trong suốt sạch sẽ như sticker, cắt ảnh thương mại điện tử, tài nguyên game; tác giả cho biết khi so sánh cùng seed, việc loại bỏ nền gần với ảnh gốc hơn so với khi không dùng LoRA
- Tác giả đã viết về thành phần tập dữ liệu huấn luyện (ảnh chụp, tranh vẽ, kết xuất 3D, một nhóm nền màu đơn sắc và một nhóm viền xấu) và tham số huấn luyện, miễn phí
Cách sử dụng
- Cường độ 1.0; dưới 1.0 hiệu ứng yếu đi, trên 1.0 sẽ gây ra các khiếm khuyết bổ sung
- Câu lệnh: “Fix the subject’s contour in areas that need fixing. Preserve well defined areas.” (mô tả huấn luyện là “Fix the subject’s contour.”); để loại bỏ nền dùng “Remove the background.”
- Số bước, CFG tác giả không cung cấp
Rủi ro và hạn chế
- Tác giả tự nhận là không hoàn hảo: Qwen 2.1 có xu hướng làm sáng viền, LoRA này không giải quyết được; tác giả cũng thừa nhận rằng bản thân Qwen 2.1 xử lý ảnh trong suốt cũng không tệ
- Chỉ có 1 ví dụ hiển thị (5 ví dụ bị ẩn), chỉ có một điểm kiểm tra epoch 10; mục này chưa được chạy thử
Có thể theo dõi (1)
【B】FrameLoom - Qwen-Image-2.1 // Cloud & Local LLMs Inside ComfyUI · v1.0
Quy trình làm việc · Mô hình mới · Tác giả BeastModeOn · Phát hành 11-03 07:50 · Tải xuống 11
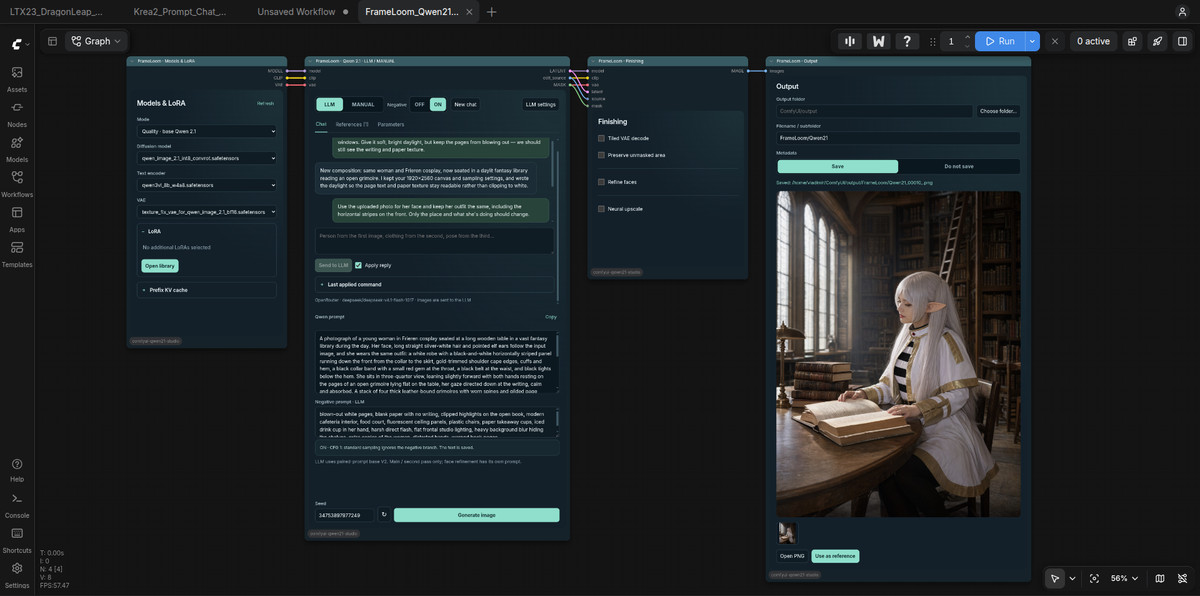
Tích hợp hội thoại LLM, phân công hình tham chiếu và xuất ảnh Qwen Image 2.1 vào một không gian làm việc ComfyUI: trước tiên thảo luận bố cục với trợ lý, chỉ định vai trò cho mỗi hình tham chiếu, xác nhận câu lệnh rồi mới tạo ảnh.
Xếp hạng B: tính năng hoàn chỉnh, mô tả chi tiết, nhưng phụ thuộc vào dịch vụ LLM và nhiều thành phần tùy chọn, không có ví dụ quy trình hoàn chỉnh để so sánh.
Hình minh họa
Lý do khuyến nghị
- Công cụ mới: tích hợp 14 loại tác vụ hình ảnh (ảnh mới, chỉnh sửa ảnh, bố cục văn bản, ảnh trong suốt và loại bỏ nền, vẽ lại cục bộ và mở rộng ảnh, tham chiếu danh tính/trang phục/tư thế/phong cách, v.v.), trợ lý áp dụng các chỉ thị hệ thống khác nhau theo tác vụ đã chọn
- Phục vụ bố cục đa hình tham chiếu, chỉnh sửa lặp lại và thiết lập nhân vật cần nhiều vòng thảo luận; trò chuyện và tạo ảnh tách biệt, tạo thêm một ảnh sẽ không gọi lại LLM
- Có thể kết nối OpenRouter trên đám mây, cũng có thể kết nối LM Studio, Ollama trên cùng máy; còn có các nhánh chuyển đổi LLM / MANUAL, liên kết câu lệnh tích cực/tiêu cực, thư viện LoRA, Union ControlNet tùy chọn, lấy mẫu thứ cấp, sửa mặt và phóng to, v.v.
Cách sử dụng
- Tải xuống zip và nhập vào ComfyUI; tác giả khuyên dùng các mô hình lớn hơn trên OpenRouter (đăng ký tài khoản để tạo API Key, có thể chọn mô hình miễn phí hoặc điền openrouter/free vào cột model), cũng có thể kết nối LLM cục bộ
- Trong Parameters, chọn tác vụ trước rồi gửi tin nhắn; phân tích hình ảnh cần LLM hỗ trợ thị giác và bật Send images; khi CFG 1, câu lệnh tiêu cực không hoạt động, chế độ tiêu cực của Turbo LoRA với CFG 1.1 được tác giả cho là thử nghiệm
- Các nhánh tùy chọn (ControlNet, GGUF, tăng cường câu lệnh cục bộ, v.v.) mỗi cái cần trọng số và nút tương ứng, ví dụ công khai mặc định tắt
Rủi ro và hạn chế
- Phụ thuộc vào dịch vụ LLM bên ngoài hoặc LLM cục bộ, trải nghiệm phụ thuộc vào mô hình đã chọn và VRAM; API Key được lưu trong bộ nhớ trình duyệt
- Ví dụ hiển thị chỉ có 3 hình (1 hình bị ẩn), không liệt kê danh sách các nút tùy chỉnh cần thiết; trình chọn thư mục gốc hiện chỉ hỗ trợ Linux (Zenity)
- Ra mắt khoảng 1 giờ trước, phiên bản này có 11 lượt tải xuống; mục này chưa được chạy thử
Chỉ ghi nhận (1)
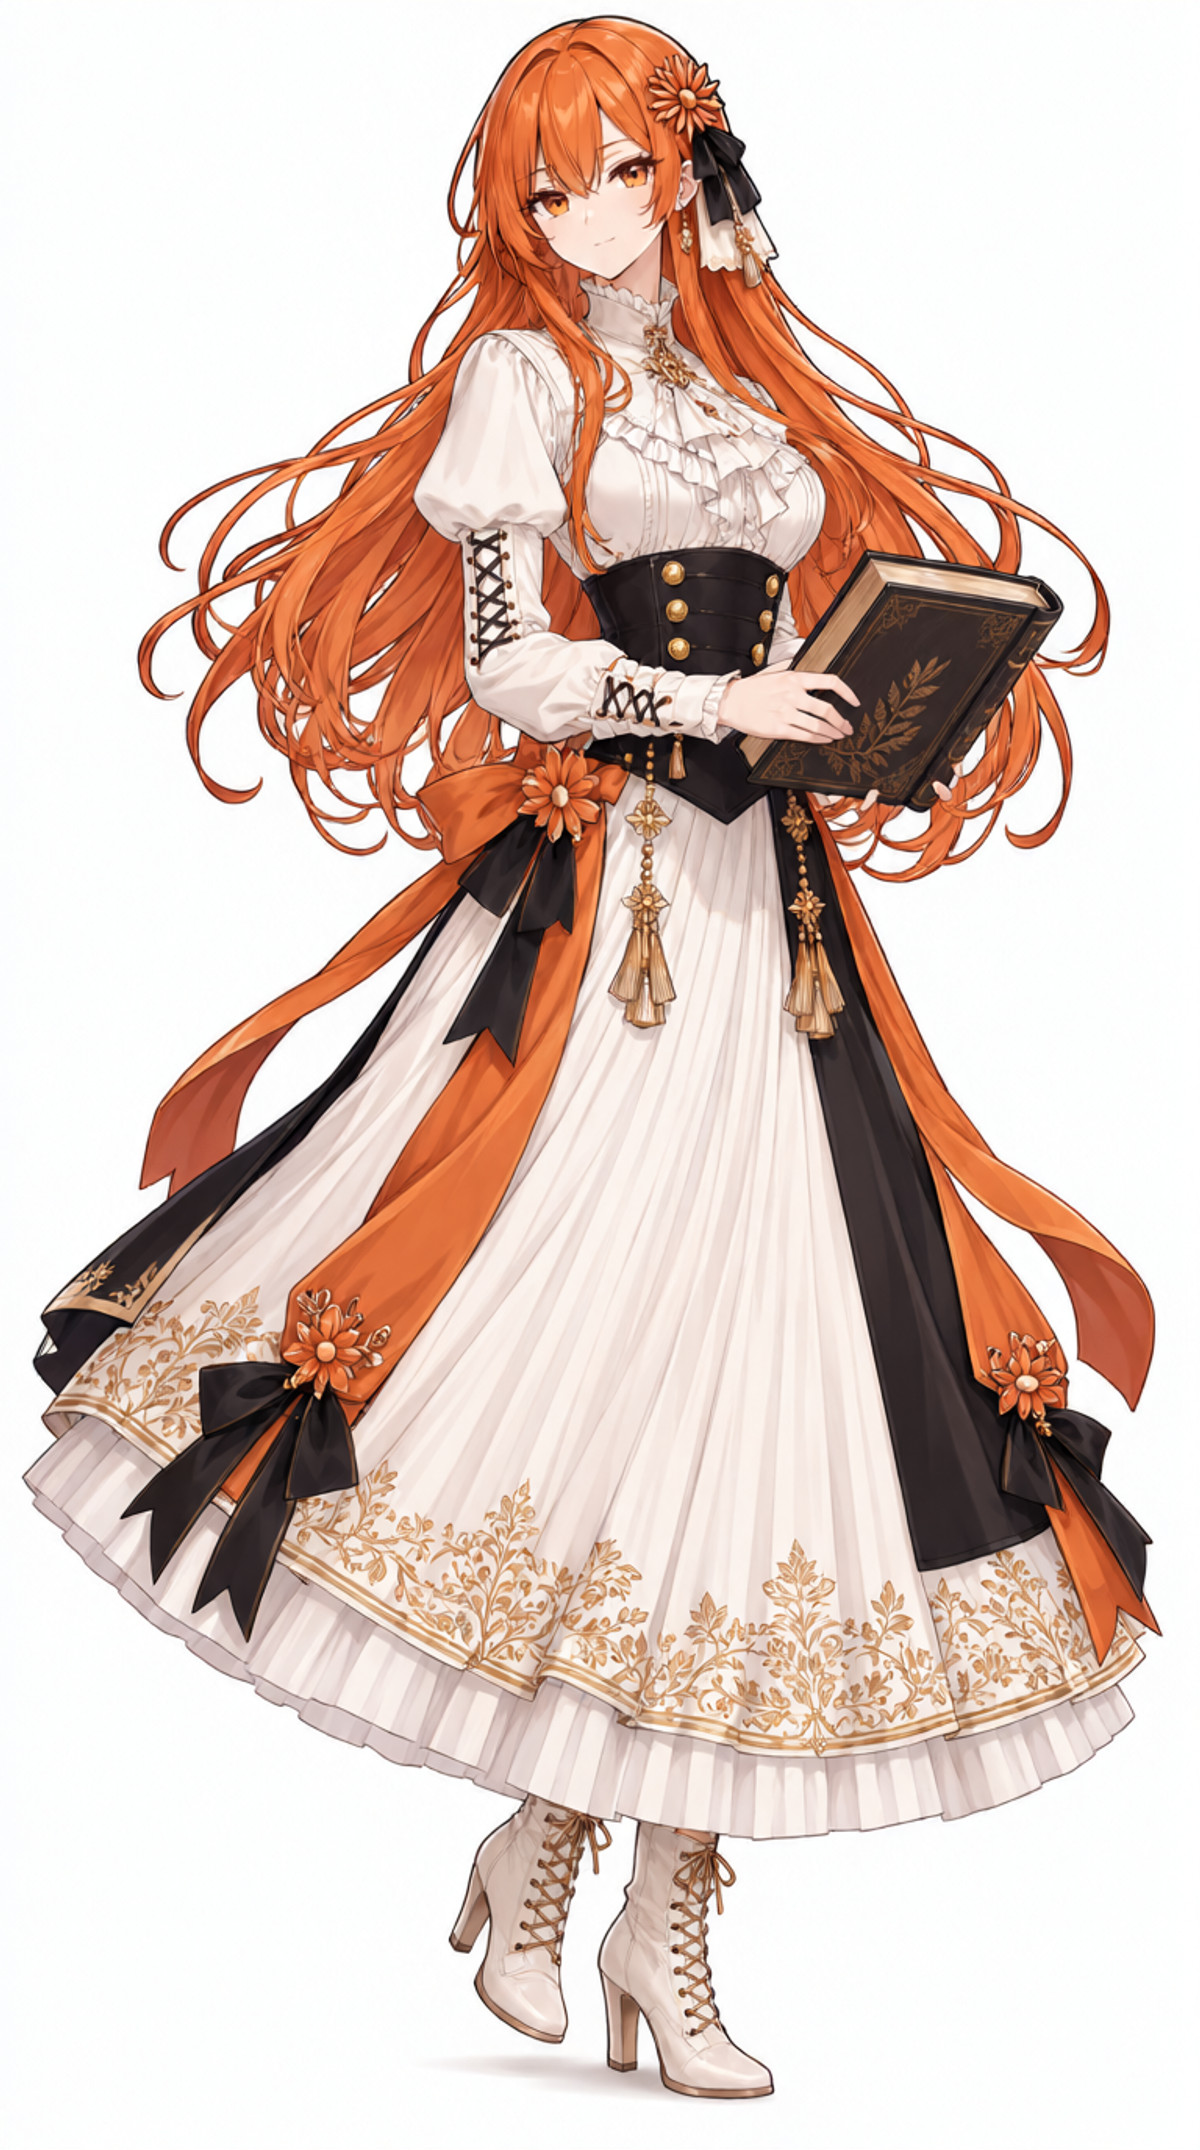
- Claude-chan-Claude chan · Qwen2.1-Claude-chan trẻ — LoRA: LoRA phiên bản Qwen 2.1 của nhân vật nhân hóa Claude “Claude-chan trẻ”, được huấn luyện bằng ảnh tạo ra từ GPT Image, chia sẻ một trang mô hình với phiên bản Q.
Dữ liệu: API công khai của Civitai (mô hình cơ sở Qwen 2.1), cửa sổ ghi nhận 11-02 20:31 → 11-03 09:01 (giờ Bắc Kinh). Lý do khuyến nghị đã được biên tập viên xem xét; số lượt tải xuống chỉ đại diện cho mức độ quan tâm.