Radar IA de Zhenzhen · MiniMax H3 · 2026-10-31 Édition du soir
Cette édition : 13 nouvelles versions : fortement recommandé 0 · recommandé 1 · à suivre 5 · inclus uniquement 7
Note de l'éditeur Cette édition examine 13 nouvelles versions de H3, sans entrée de niveau S. Première recommandation : le portage H3 d'Obsidian Nightmare : un LoRA de style d'ambiance horrifique avec une source de lumière unique et une oppression des ombres, avec les paramètres d'intensité, d'échantillonneur, de nombre de pas et de fréquence d'images fournis ; rétrogradé de S à A, car le style ne constitue pas une nouvelle capacité, la description de la section H3 ne compte que quelques lignes et les exemples visibles ne sont que 2 segments. RefMod d'AIKSK est un ensemble de 6 workflows issus d'un tutoriel (l'auteur a incorrectement étiqueté le modèle de base comme Other, il s'agit en réalité d'une génération vidéo par référence H3), seul le point d'entrée principal Multi-Reference Apply est conservé en B, les quatre modules de création de références et la voie TextEncode sont classés en C ; les workflows d'agrandissement généraux n'utilisant pas H3 et les LoRA de personnages classiques sont classés en C, les paramètres du slider de la roue fantôme payante sont complets, rétrogradé de C à B.
Recommandé (1)
【A】Obsidian Nightmare · Lucid Trauma MiniMax H3
LoRA · Portage · Auteur Granddyser · Publié le 10-31 19:34 · Téléchargements 46
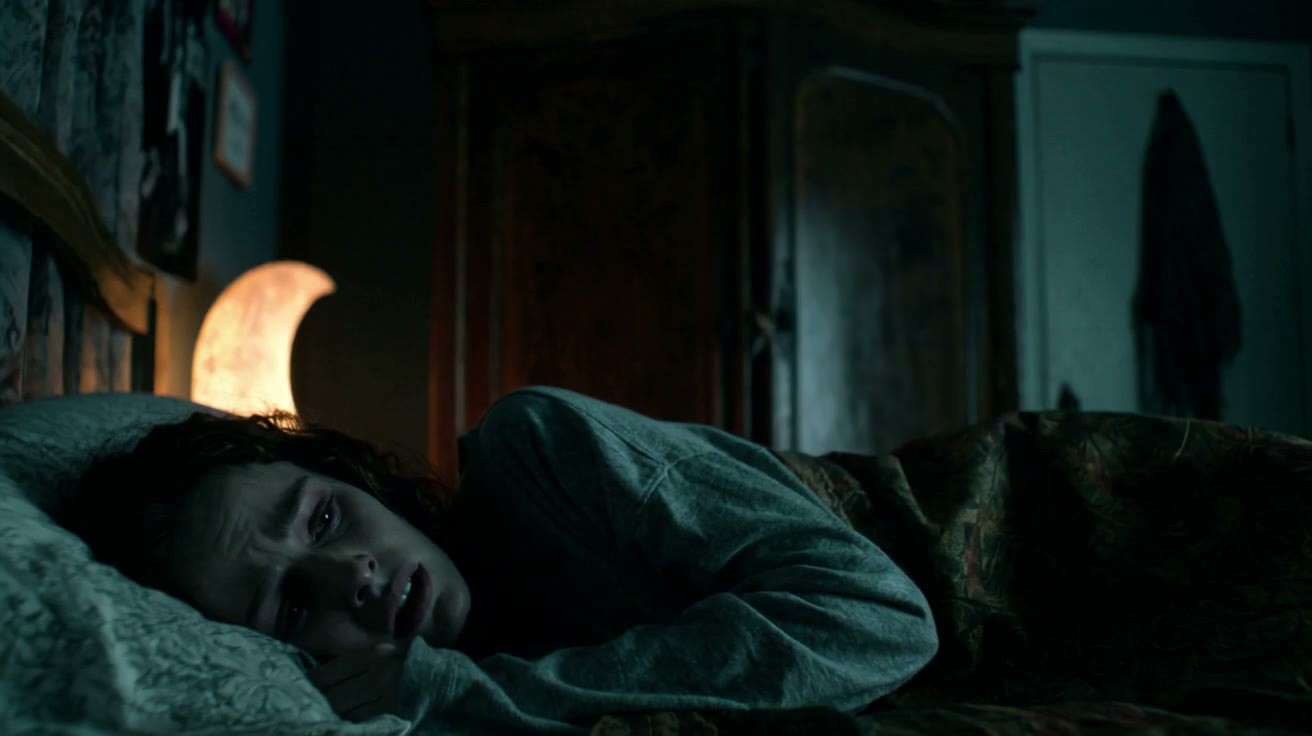
Première version H3 (Lucid Trauma) du LoRA de style d'ambiance horrifique Obsidian Nightmare : l'auteur a entraîné le modèle sur des photos de scène d'horreur originales sélectionnées, mettant l'accent sur une source de lumière unique, de grandes zones d'ombre et la sensation d'oppression de « quelque chose dans l'image vous a déjà remarqué », plutôt que sur le gore.
Rétrogradé de S à A : les paramètres sont complets, gratuit, avec des exemples vidéo, mais le style d'ambiance horrifique ne constitue pas une nouvelle capacité, la description de la version H3 est très courte, les mots-clés de déclenchement ne sont pas clairs, et les exemples visibles ne sont que 2 segments.
Illustration
Raisons de la recommandation
- Portage : la même page de modèle proposait auparavant des versions Krea 2 (Nightmare, Fearbound) et MOSS Image, la version MOSS ayant été publiée la veille, la version H3 conserve le même nom Lucid Trauma ; la version H3 fournit également des paramètres vidéo et suggère d'inclure les sons de la pièce (grincements de planches, gouttes d'eau, respiration) dans le prompt, exploitant la capacité de H3 à générer simultanément du son
- Répond aux besoins de génération vidéo texte-à-vidéo pour les courts-métrages d'horreur et les plans d'ambiance suspense ; astuce de prompt de l'auteur : ne mentionner qu'une seule source de lumière (veilleuse, ampoule nue, lanterne) et laisser le reste dans l'obscurité, définir un angle de caméra clair pour le plan, et s'assurer que chaque personnage dans l'image a un objet de regard
- Paramètres complets : intensité 1.0 (0.9–1.0), échantillonneur er_sde, scheduler beta, 20 pas, environ 0.9 MP (16:9), 24 fps
- Il y a 2 segments de vidéos d'exemple visibles ; gratuit, la licence autorise la génération d'images, la location et la location interne ; environ 1 heures après la publication, 46 téléchargements, total cumulé du modèle 1648 (représentant uniquement l'attention)
Comment l'utiliser
- Dans le workflow H3, charger ObsidianNightmare-LucidTrauma-H3.safetensors (569 MB · FP16), intensité 1.0, er_sde + beta, 20 pas, environ 0.9 MP 16:9, 24 fps
- La version H3 n'a pas enregistré de mot-clé de déclenchement ; m1V8 sur la carte est le mot-clé de déclenchement de la version Krea 2, l'auteur n'a pas précisé s'il faut l'ajouter sous H3
Risques et limitations
- La carte du modèle contient principalement des descriptions et des prompts d'exemple des versions Krea 2 / MOSS Image, les instructions spécifiques à H3 ne comptent que quelques lignes sur l'utilisation et les astuces de prompt
- L'auteur affirme avoir présenté quatre courts-métrages de 5 secondes intégrés dans le workflow, mais seuls 2 segments sont visibles sur le site sans prompts, et 1 exemples de niveau sensible sont masqués ; cette entrée n'a pas été testée
- La licence n'autorise pas les œuvres dérivées ; le thème horrifique inclut des scènes de surprise impliquant des personnages
À suivre (5)
【B】Singularity-V2-x-10Eros-Max · PRISM-PIKA
Modèle de base / Checkpoint · Mise à jour de version · Auteur 0l1v1aR0551 · Publié le 10-31 20:08 · Téléchargements 68
Nouvelle version du modèle de base fusionné PRISM (fusion H3 Ref2VA de Singularity V2 × 10Eros-Max turbo beta 6) : intègre la LoRA Pika-H3-Flex (PIKA) sur la base de la première version PRISM.
Maintenu en B : même approche que PIKA72 d'hier avec un autre modèle de base, pas d'exemples visibles, pas de paramètres d'échantillonnage, et aucune explication sur l'effet de la LoRA intégrée.
Illustration
Raisons de la recommandation
- Mise à jour de version (5ème version) : l'auteur affirme qu'il s'agit du « PRISM original avec PIKA intégré », basé sur Singularity V2 × 10Eros-Max (8 pas Turbo beta 6), tandis que PIKA72 d'hier était basé sur 10Eros-Beta7 avec PIKA fusionné ; cette version ne contient qu'un seul fichier, l'intensité de fusion de PIKA n'est pas indiquée par l'auteur
- La méthode de fusion suit l'algorithme PRISM de l'auteur (filtrage des incréments de bruit par rang SVD aléatoire 64, interpolation SLERP directionnelle avec interpolation d'amplitude en espace logarithmique, gestion des conflits de signe), l'auteur affirme que cela réduit les artefacts lors de la fusion de modèles turbo dans le modèle de base
- Environ 1 heures après la publication, 68 téléchargements, total cumulé du modèle 4173 (représentant uniquement l'attention) ; gratuit, la licence autorise la génération d'images et la location interne
Comment l'utiliser
- Télécharger int8 safetensors (18.8 GB) pour remplacer le chargement du modèle de base H3 ref2va ; les autres précisions fp16, w6a8 sont disponibles dans le dépôt Hugging Face de l'auteur OliviaRossi/Minimax-h3_Singularity-x-10Eros-Max_PRISM
- Le nombre de pas, CFG et l'échantillonneur ne sont pas fournis par l'auteur (la source 10Eros-Max est un turbo de 8 pas)
Risques et limitations
- La note de mise à jour ne contient qu'une phrase promotionnelle (« probably the best merge for everyone »), sans expliquer les changements apportés par la LoRA PIKA ni les cas d'usage respectifs par rapport à PIKA72 / BETA72
- Tous les exemples sont de niveau sensible (4 masqués), aucun aperçu du résultat n'est disponible ; cette entrée n'a pas été testée
- Fusion tripartite avec LoRA intégrée, les licences des différentes sources doivent être vérifiées individuellement
- L'illustration de la carte est un schéma généré par IA, pas le résultat réel du modèle ; l'auteur ne propose pas d'exemples de niveau normal publics
【B】LLM Easy prompt enhancer + modification (both with input image) (krea2/Minimax H3) · MiniMax H3 v2.0
Workflow · Mise à jour de version · Auteur Crimson009 · Publié le 10-31 09:37 · Téléchargements 62
Workflow d'outil H3 v2.0 pour appeler directement un LLM dans ComfyUI afin d'écrire / modifier des prompts : le générateur et le modificateur de prompts peuvent lire des images, et incluent un « Audio Generator » utilisant H3 lui-même pour générer des fichiers audio.
Maintenu en B : les mises à jour sont clairement décrites, l'idée de l'Audio Generator est pratique, mais les dépendances et le LLM ne sont pas précisés, il n'y a que des captures d'écran sans exemples finis.
Illustration
Raisons de la recommandation
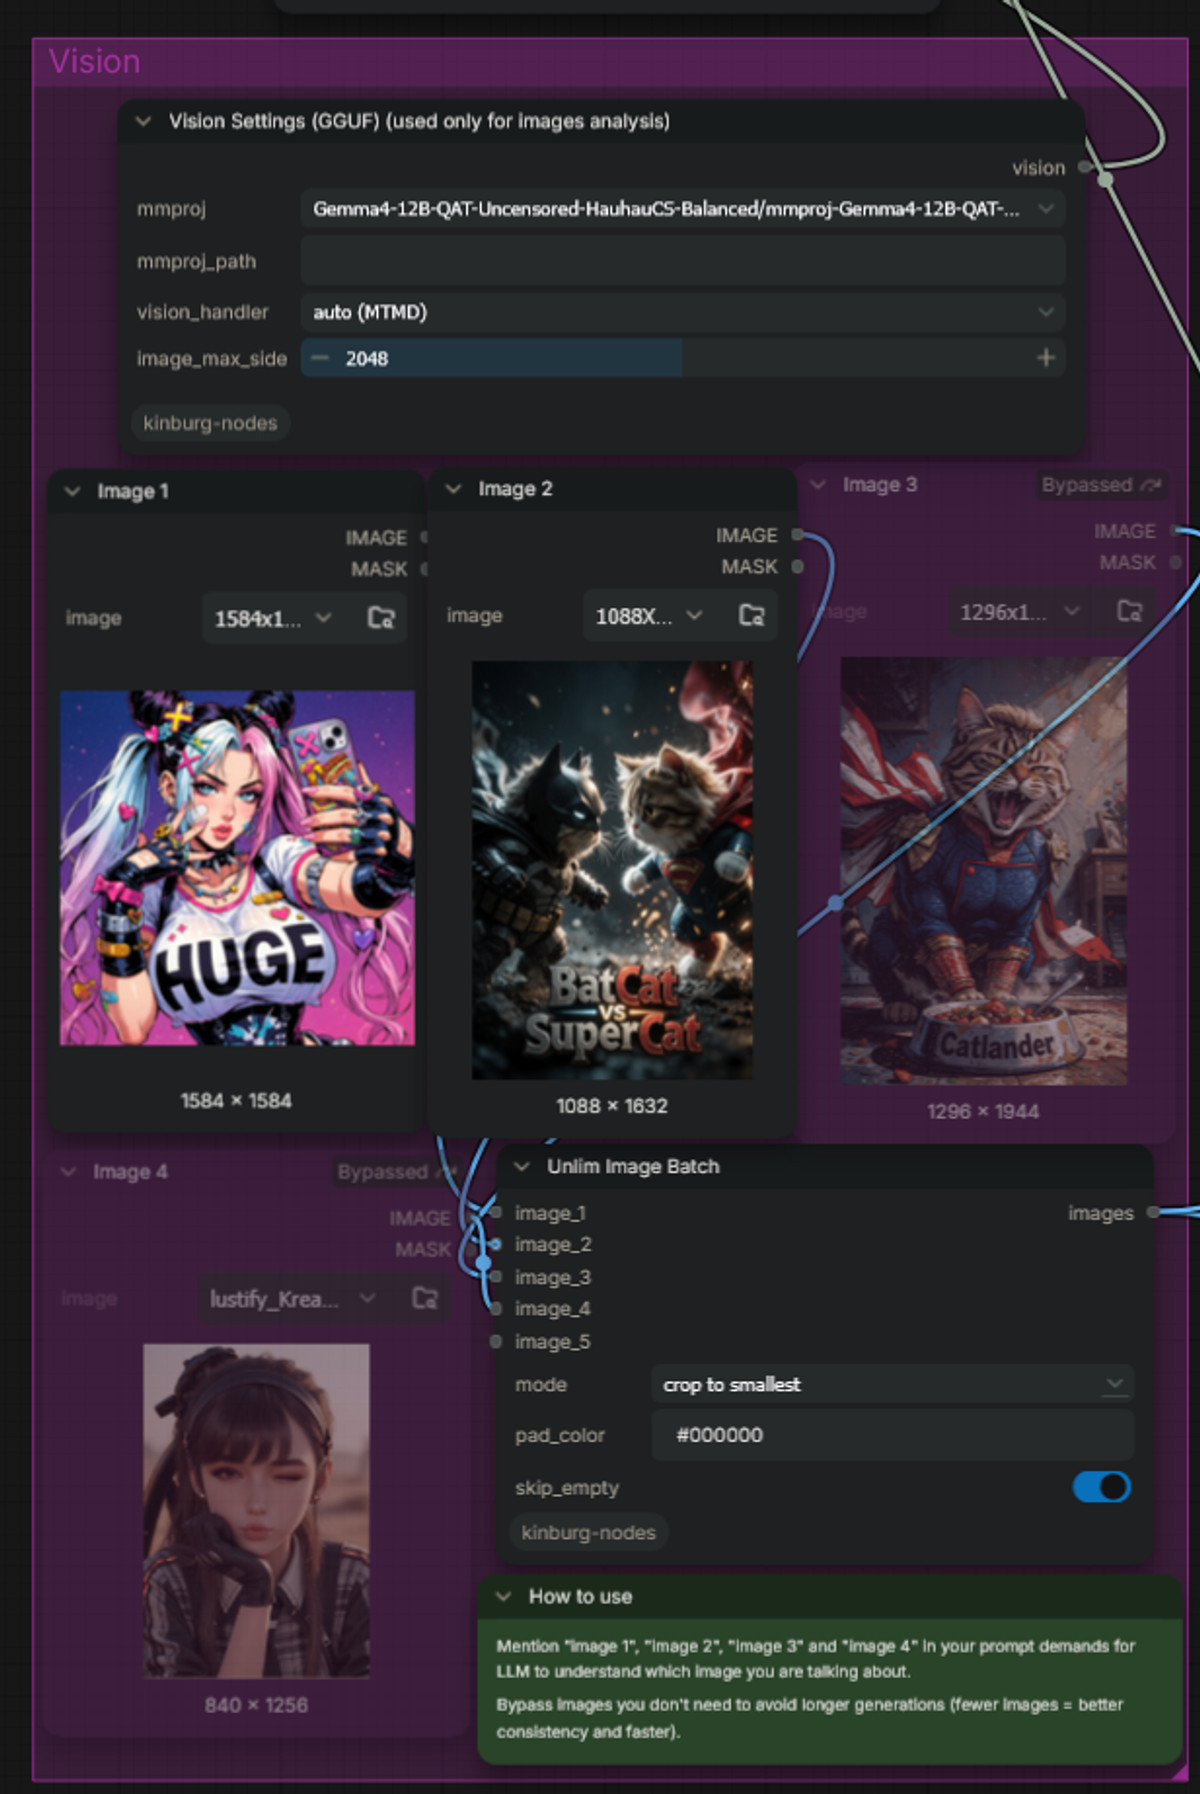
- Mise à jour de version : par rapport à H3 v1.0, le générateur et le modificateur de prompts peuvent téléverser jusqu'à 4 images pour le LLM ; l'ancien « Text Voice Dialogue Generator » est remplacé par « Audio Generator », capable de générer un fichier audio à partir d'une entrée utilisateur ou d'un prompt, l'auteur affirmant que cela facilite le contrôle du son et de la voix dans la génération vidéo par référence (ref2video)
- Approche de l'Audio Generator : faire écrire un prompt audio par le LLM, puis utiliser votre propre modèle de diffusion H3 à la résolution minimale pour générer et extraire la piste audio en fichier, sans nécessiter de téléchargement de modèle supplémentaire (CLIP et VAE audio réutilisent ceux existants) ; l'auteur affirme qu'en moyenne 15-20 secondes sont nécessaires pour générer 15 secondes d'audio sur une RTX 5080
- Conserve la génération de prompts par lecture d'image, la modification de prompts et le chatbot de v1.0 ; les instructions d'utilisation de chaque groupe sont écrites sur des cartes d'explication vertes dans le workflow
- Il y a 2 captures d'écran du workflow ; gratuit, la licence autorise la génération d'images, la location, la location interne et la vente de fusions
Comment l'utiliser
- Importer llmEasyPromptEnhancer_minimaxH3V20.json (141 KB), compléter les nœuds via Manager ; dans l'Audio Generator, indiquer votre modèle de diffusion H3 habituel, l'encodeur de texte et le VAE audio
- Lors de la lecture d'images, préciser dans l'entrée utilisateur si l'image est la première frame ou une référence ; le LLM / modèle visuel spécifique utilisé et les paquets de nœuds requis ne sont pas listés par l'auteur sur la carte
Risques et limitations
- Le backend LLM et les nœuds de dépendance ne sont pas indiqués sur la carte, il faut les découvrir après importation ; les captures d'écran ne sont pas des résultats générés, il n'y a pas d'exemples audio ou vidéo
- La génération à basse résolution via H3 puis l'extraction de la piste audio, la qualité sonore et le contrôle des dialogues ne sont pas illustrés par l'auteur ; cette entrée n'a pas été testée
【B】MiniMax H3 Multi-Reference Apply · v1.0
Workflow · Nouveau modèle · Auteur AIKSK · Publié le 10-31 15:51 · Téléchargements 20
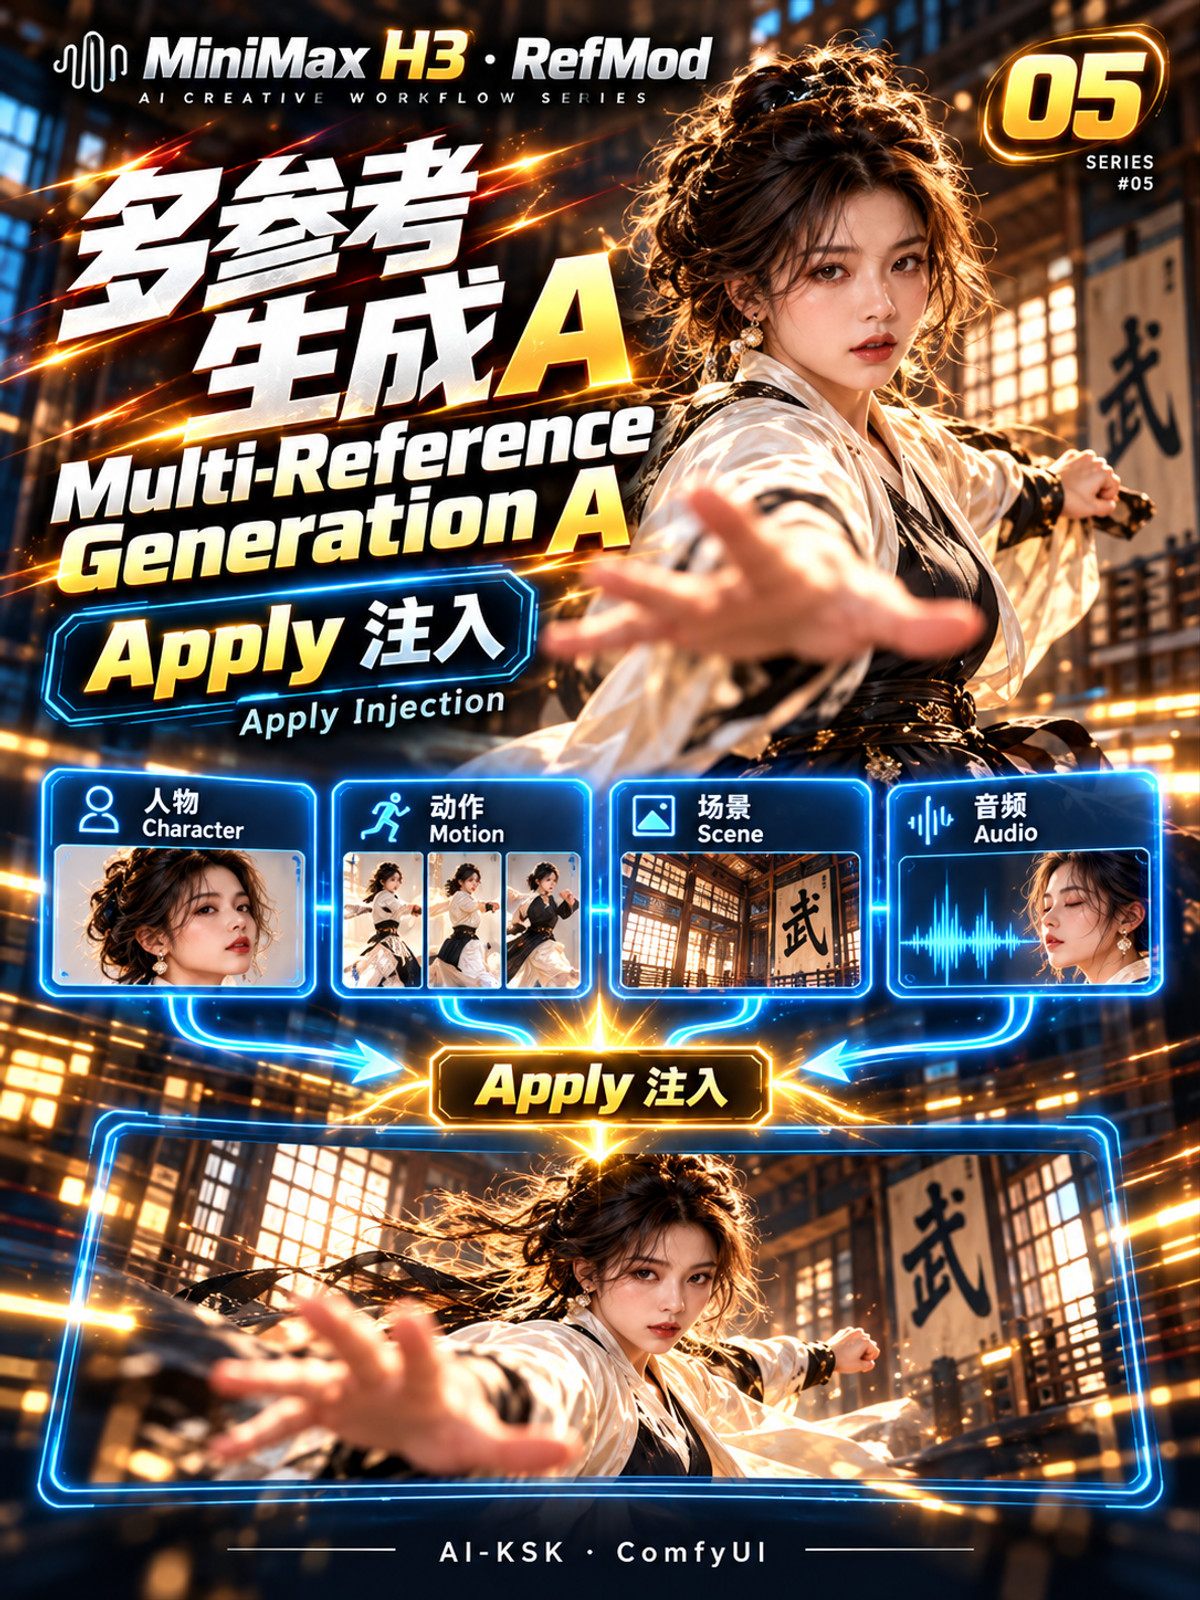
Le 5ème élément du kit de six RefMod H3 d'AI-KSK, et le premier workflow produisant réellement une vidéo (Génération multi-références A : Apply) : injecte simultanément dans les conditions de génération vidéo par référence H3 quatre actifs de référence pré-enregistrés : personnage, action, scène et son.
Maintenu en B : le seul élément du kit de six permettant de voir directement l'usage de la « composition multi-références », les paramètres et dépendances sont clairement écrits, mais il n'y a aucun exemple fini, et il faut d'abord exécuter les quatre workflows préparatoires.
Illustration
Raisons de la recommandation
- Nouveau modèle : encodez d'abord les prompts avec MiniMaxH3ReferenceToVideo natif et créez les variables latentes initiales, puis injectez les actifs RefMod sauvegardés dans les conditions via MiniMaxH3RefModApply ; l'auteur précise que l'encodeur de texte ne voit pas les images de référence elles-mêmes lors de la phase d'encodage
- Service pour des courts-métrages multi-références « même personnage, même scène, actions et voix spécifiées » ; la configuration d'exemple montre le personnage Rin pratiquant seul des coups de poing et des coups de pied retournés dans un dojo, puis prononçant une réplique en chinois, sans musique ni autres personnages
- Paramètres complets : intensité de 1 pour chacun des quatre emplacements, copies 1, retention=1 et override=false pour le nœud Apply, 832×480, 243 images, graine 9527, Euler + beta, 4 étapes, sortie H.264 à 24 fps
- Confirmer qu'il s'agit de contenu H3 : utilise le checkpoint int8 H3 ref2va, les VAE vidéo/audio H3 et le pack de nœuds RefMod ; l'auteur a étiqueté le modèle de base comme « Other » ; gratuit
Comment l'utiliser
- Exécutez d'abord les quatre workflows de la même série 01–04 pour créer les RefMod character / motion / scene / voice, ou remplacez-les par vos propres actifs dans le chargeur, puis importez minimaxH3Multi_v10.json pour la génération
- Nécessite le pack de nœuds RefMod, Video Helper Suite, le checkpoint int8 élagué H3 ref2va, l'encodeur de texte Qwen3-VL-32B NVFP4-AWQ, les VAE vidéo/audio H3 et un LoRA Turbo de 4 étapes (intensité 1) ; ces poids ne sont pas fournis avec le workflow
Risques et limitations
- La seule image est une illustration de couverture, pas un résultat généré ; la fiche précise que les répliques et les actions sont uniquement des exigences de prompt, non vérifiées, et qu'il n'y a pas de données de temps d'exécution ; cette entrée n'a pas été exécutée
- Il faut d'abord créer les quatre actifs de référence ; impossible de contrôler séparément le squelette de deux personnages ; la fiche contient un lien de promotion pour le déploiement sur cloud (avec code d'invitation de l'auteur)
- La licence n'autorise pas l'usage commercial
【B】MinimaxH3 Fully Auto Long Video & Digital Human · v1.0
Workflow · Nouveau modèle · Auteur NicknickAI · Publié le 10-31 13:07 · Téléchargements 62
Un workflow ComfyUI utilisant H3 pour générer des vidéos longues pilotées par l'audio et des humains numériques : fournissez une image de référence du personnage, une piste audio et des prompts pour chaque segment, la génération est segmentée automatiquement en reliant la dernière image d'un segment à la première du suivant, puis l'ensemble audio-vidéo est réassemblé.
Maintenir B : direction claire, utile pour les vidéos longues, mais sans exemples visibles ni dépendances ou paramètres fournis.
Illustration
Raisons de la recommandation
- Nouveau modèle : découpe la piste audio par intervalles spécifiés et génère chaque segment individuellement, en utilisant la dernière image du segment précédent pour guider le suivant afin de maintenir la continuité visuelle, puis assemble automatiquement la vidéo et l'audio.
- Adapté aux besoins dépassant un seul segment, tels que les avatars parlants, les personnages chantant, les clips musicaux (MV) et les narrations continues ; permet d'ajuster le format, la résolution et la durée de chaque segment, avec option d'interpolation d'images via RIFE.
- Gratuit, la licence autorise uniquement la location sur site ; environ 8 heures après la publication, il a enregistré 62 téléchargements (indiquant seulement le niveau d'intérêt).
Comment l'utiliser
- Importez minimaxh3FullyAutoLong_v10.json (162 KB) et complétez les nœuds manquants via Manager ; les fichiers de modèle H3 requis, le nombre d'étapes et les durées recommandées par segment ne sont pas fournis par l'auteur.
Risques et limitations
- Aucun exemple visible (1 exemples de niveau sensible masqués), impossible de prévisualiser la transition et la synchronisation labiale des vidéos longues
- La fiche du modèle ne contient qu'une brève introduction, sans lister les nœuds dépendants ni les modèles ; la dérive visuelle fréquente dans les vidéos longues avec reprise de la dernière image n'est pas mentionnée par l'auteur ; cette entrée n'a pas été testée
- L'image de la fiche est un schéma généré par IA, et non un rendu réel du modèle ; l'auteur ne propose pas d'exemples publics de niveau standard
【B】KinetiX Ghost Rider Hellfire Wheels & Molten Ground Concept Slider · v1.0
LoRA · Nouveau modèle · Auteur make676767 · Publié le 10-31 11:47 · Téléchargements 0 · Payant
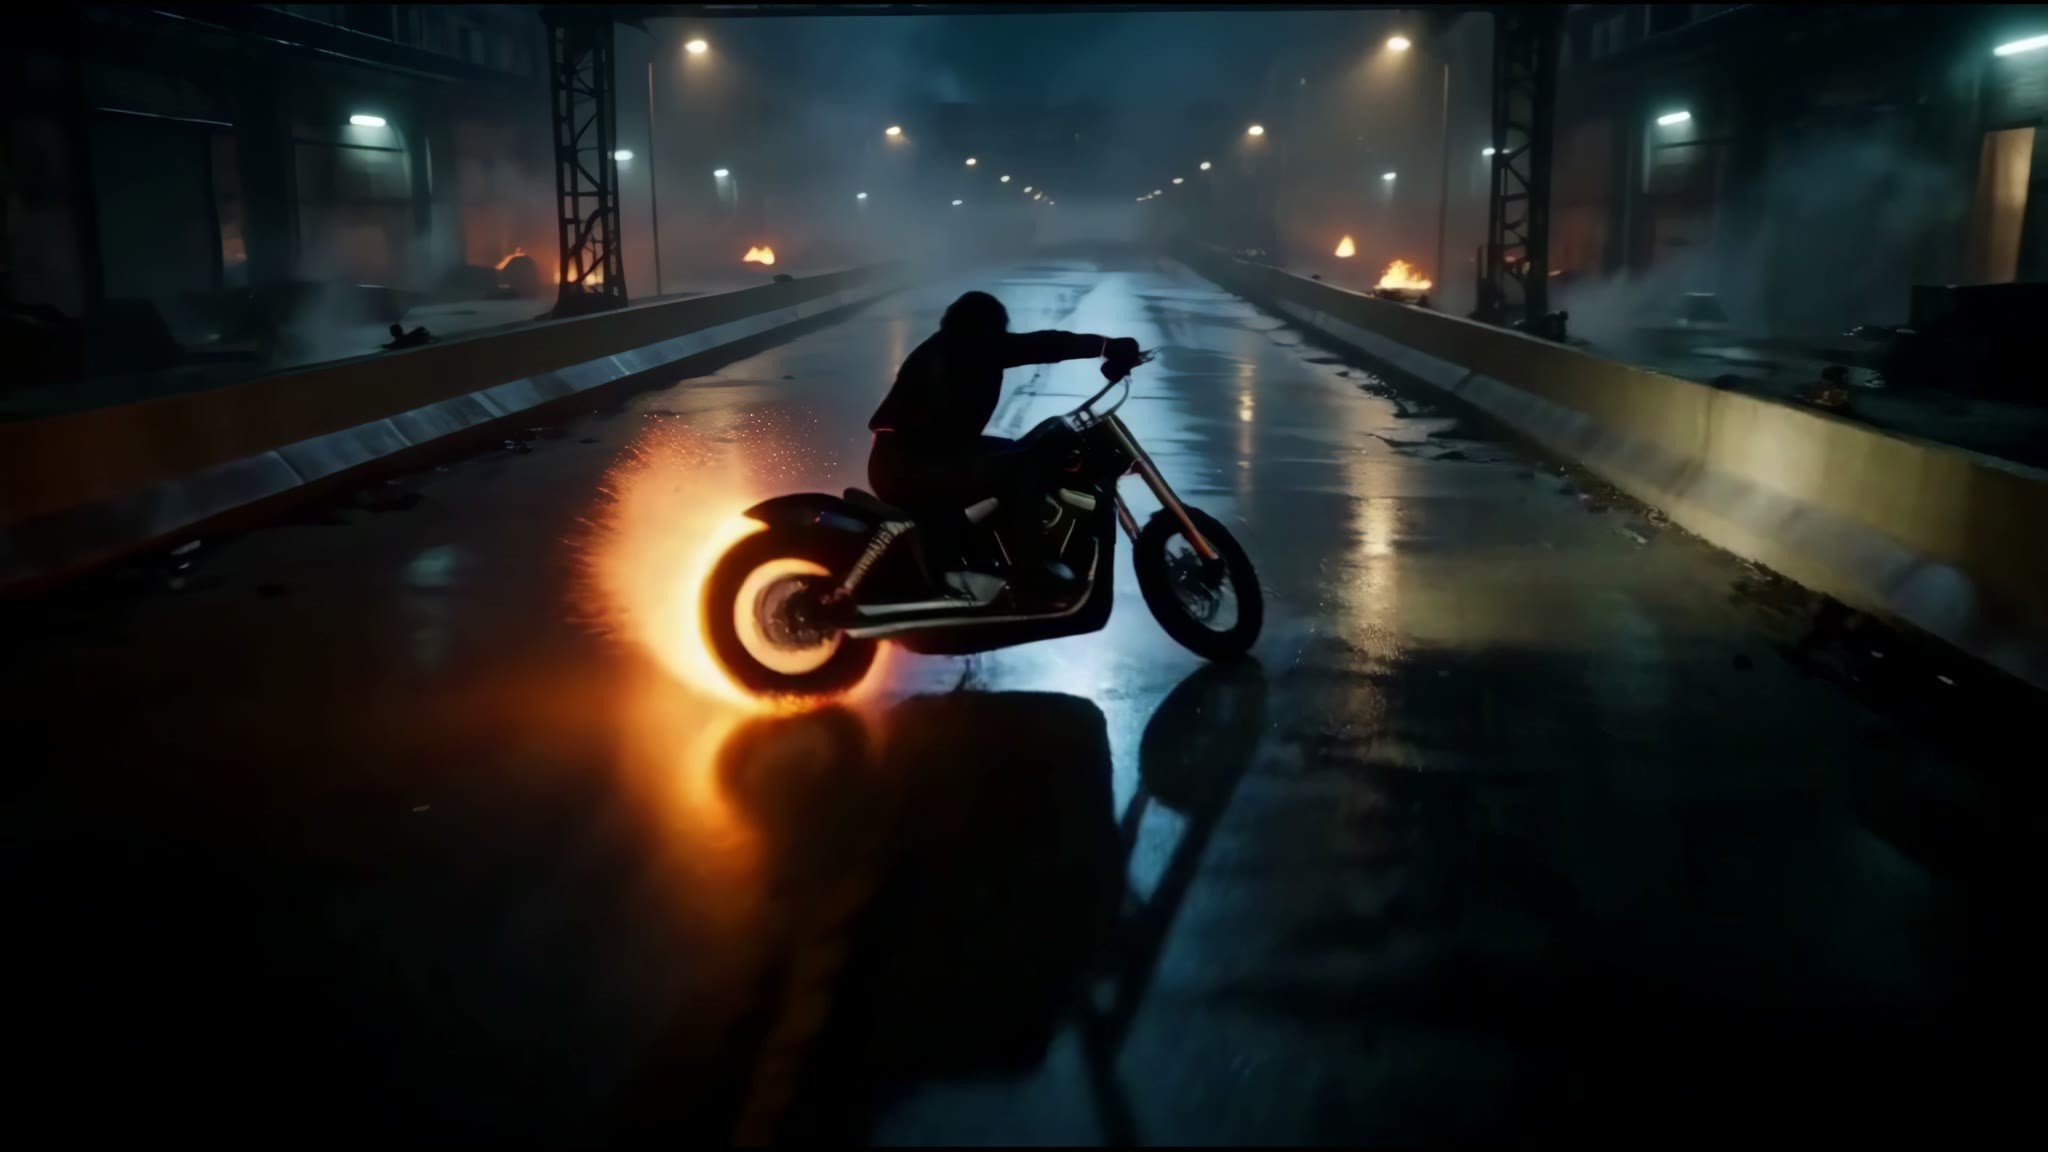
Un curseur d'effets spéciaux à valeur positive ou négative : les valeurs positives enveloppent les roues des motos / voitures de flammes infernales projetées vers l'arrière et font brûler des sillons de sol fondu lumineux sur la route ; les valeurs négatives éteignent les flammes et restaurent la carrosserie en acier froid ; le thème est Ghost Rider.
Passé de C à B : les effets, les paliers d'intensité et les prompts sont clairement décrits, et l'utilisation de valeurs négatives pour éteindre le feu est possible, mais le modèle est payant et seuls 1 exemples sont visibles.
Illustration
Raisons de la recommandation
- Nouveau modèle : l'auteur affirme que les flammes ne s'attachent qu'aux roues et à la route, le châssis restant solide et ne fondant pas ; aucun mot-clé de déclenchement requis
- Les paliers d'intensité sont clairement définis : +1.8 ~ +2.0 pour le réglage recommandé, +2.5 ~ +3.5 pour des flammes et une fumée plus intenses, 0 pour l'état original, -1.5 ~ -2.0 pour éteindre le feu
- Trois prompts bilingues (chinois/anglais) prêts à copier sont fournis (poursuite de moto sur route de nuit, Dodge Charger 1969 avec flammes sur les quatre roues, dérapage sur place créant un anneau de feu) ainsi que des mots-clés d'amélioration optionnels ; un workflow et une archive de ressources sont inclus
- 1 exemples vidéo visibles sont disponibles (4K)
Utilisation
- Chargez KinetiX_vfx_hellfire_cycle_h3_v1.0.safetensors (15 Mo · BF16), commencez avec strength_model entre +1.8 et +2.0 ; vous pouvez ajouter blazing roaring hellfire wheels, violent centrifugal fire plumes, crackling molten scorched ground tracks
- Le nombre de pas, le CFG et l'échantillonneur ne sont pas indiqués par l'auteur sur la fiche (ils se trouvent peut-être dans le workflow fourni)
Risques et limitations
- Téléchargement payant, actuellement 0 téléchargements
- Seuls 1 exemples sont visibles, 5 exemples de niveau sensible sont masqués ; Ghost Rider est un personnage Marvel, l'utilisation commerciale présente un risque de droits d'auteur ; cette entrée n'a pas été testée
Inclus uniquement (7)
- VOSR Image and video over-resolution , recommend · v1.0 — Workflow : un workflow ComfyUI de super-résolution d'images et de vidéos basé sur VOSR2 : la branche image inclut une comparaison avant/après, la branche vidéo décompose les images, les agrandit, puis les recompose à la fréquence d'images et avec l'audio originaux, avec une voie supplémentaire utilisant RTX Video Super Resolution pour un agrandissement supplémentaire ; il n'appelle pas lui-même H3.
- MiniMax H3 RefMod Audio Reference · v1.0 — Workflow : la 3e étape du kit de six outils H3 RefMod : encode un enregistrement vocal en un asset de référence audio H3 réutilisable (RefMod), destiné à être sélectionné par le workflow de génération Apply ultérieur.
- MiniMax H3 Multi-Reference TextEncode · v1.0 — Workflow : le 6e workflow du kit de six outils H3 RefMod (Génération multi-références B : TextEncode) : une autre voie de génération vidéo, où un nœud d'encodage de texte sensible aux références encode directement les assets de référence dans la condition, et peut produire une cartographie de références <Video n> / <Picture n>, permettant de désigner chaque sujet dans le prompt.
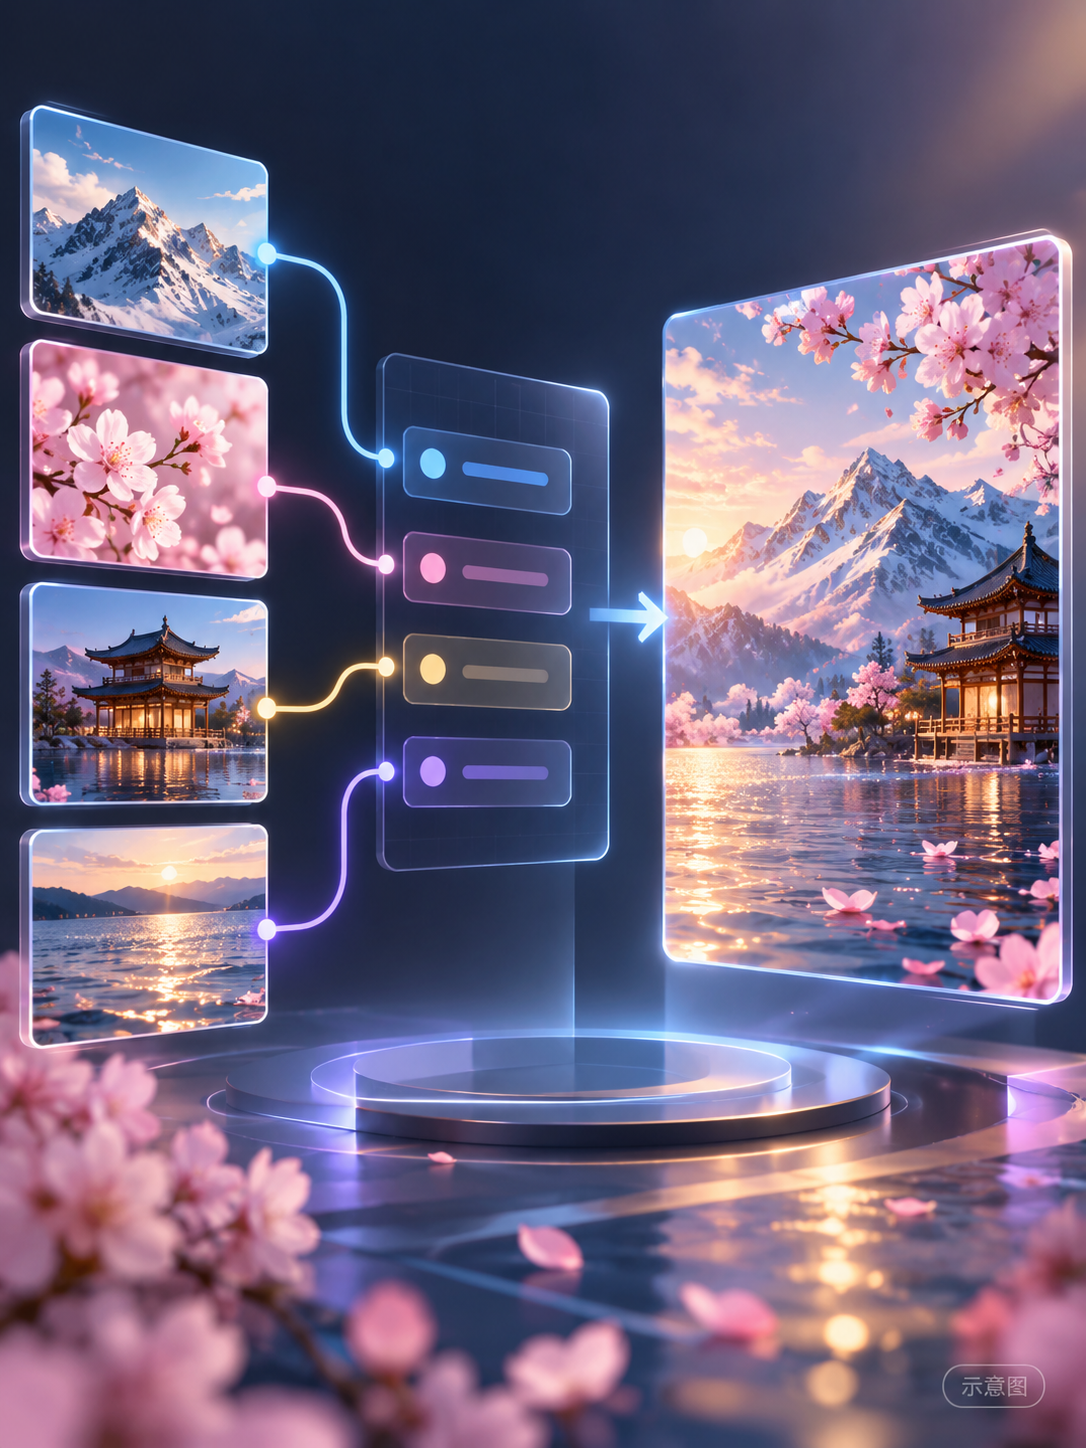
- MiniMax H3 RefMod Character Reference · v1.0 — Workflow : la 1e étape du kit de six outils H3 RefMod : pré-encode les photos de personnages d'un dossier en un asset de référence de personnage H3 réutilisable, les plans ultérieurs pointant vers le même asset nommé pour maintenir la cohérence de l'apparence du personnage.
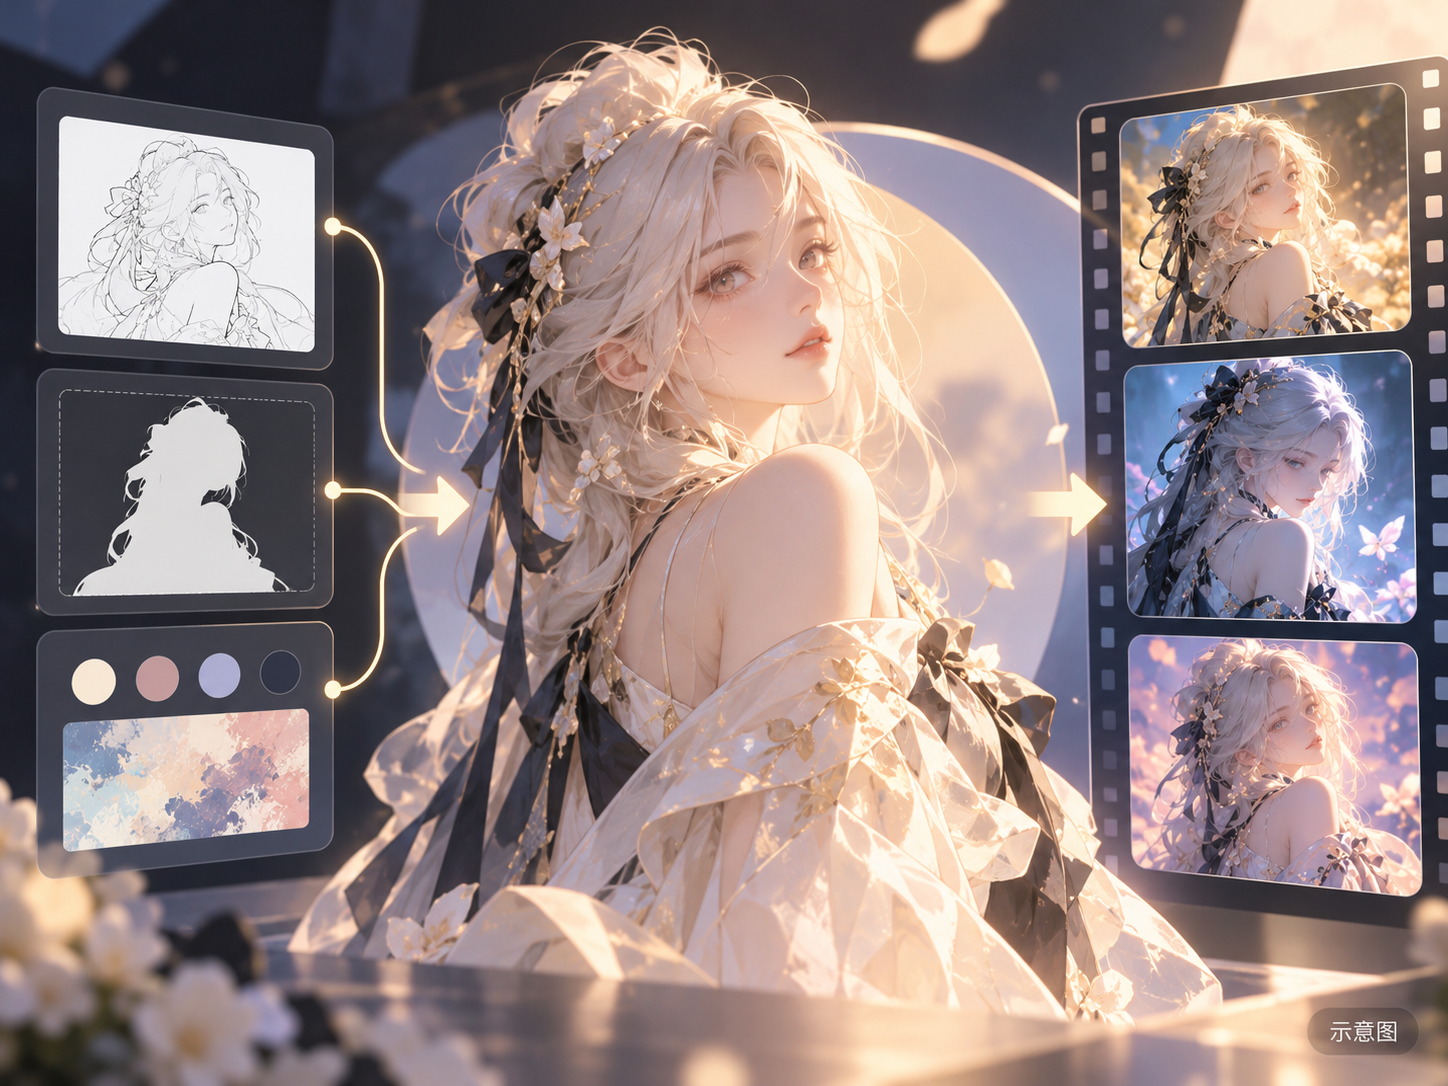
- Maya Belwyn · MiniMaxH3 — LoRA : LoRA H3 pour le personnage féminin fictif original Maya Belwyn ; la fiche du modèle est une courte biographie du personnage (famille de Bruges, propriétaire d'une boutique de restauration de livres anciens), sans instructions d'utilisation.
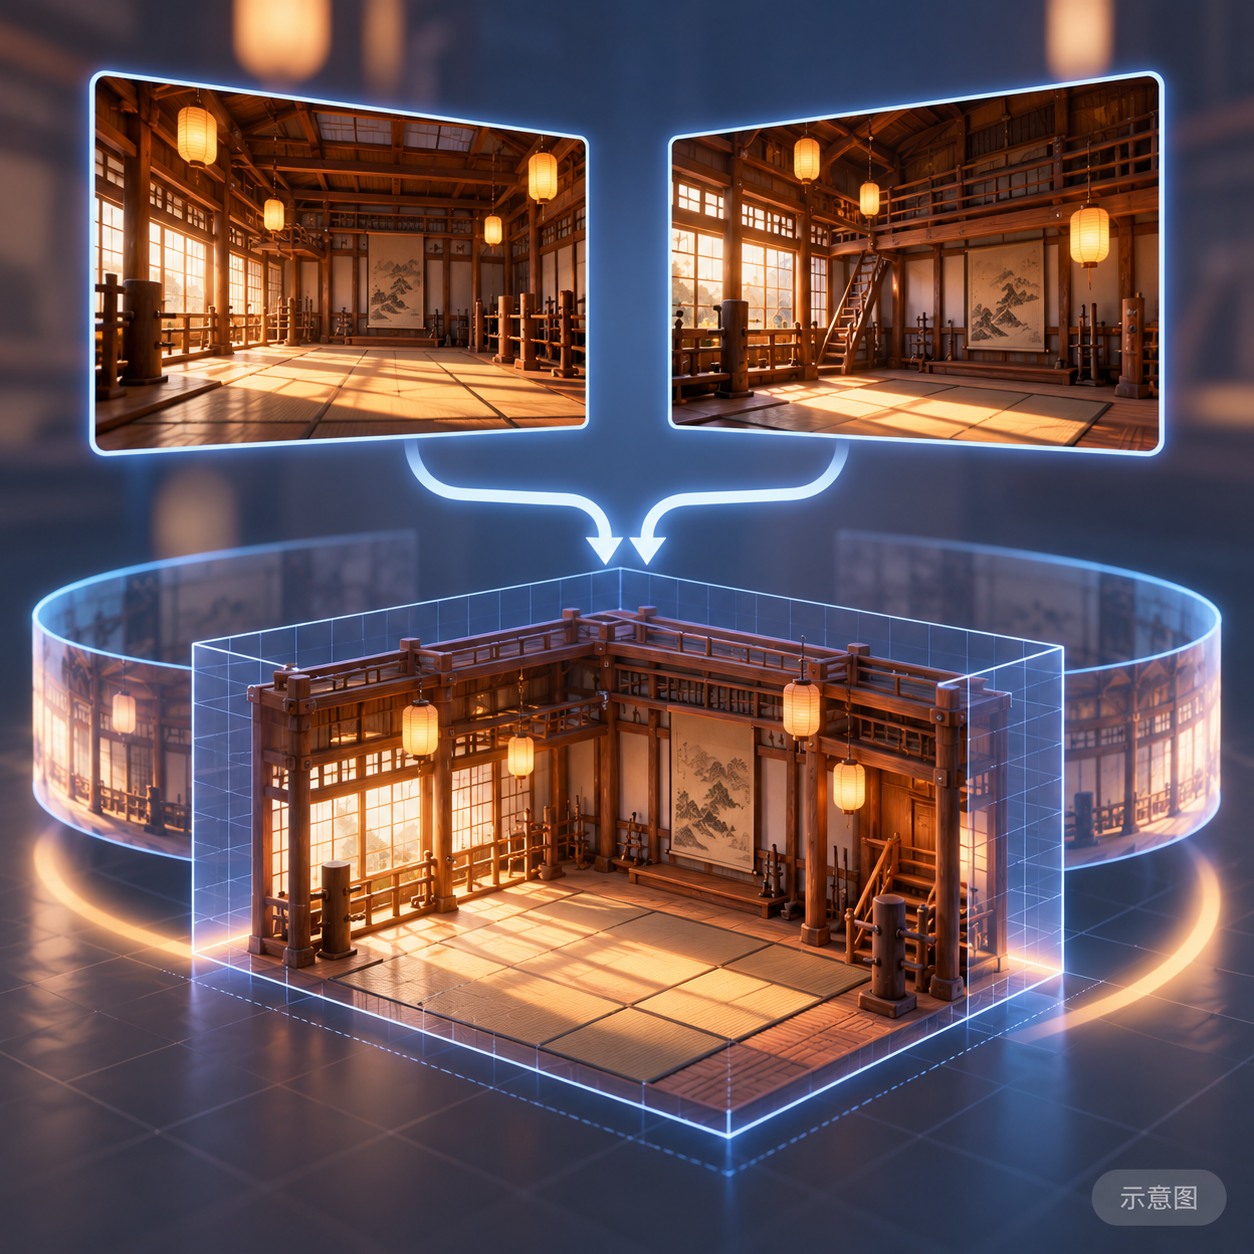
- MiniMax H3 RefMod Two-View Scene · v1.0 — Workflow : la 4e étape du kit de six outils H3 RefMod : utilise deux images de points de vue différents du même lieu pour créer un asset de référence de scène H3 réutilisable, permettant à plusieurs plans de conserver le même décor.
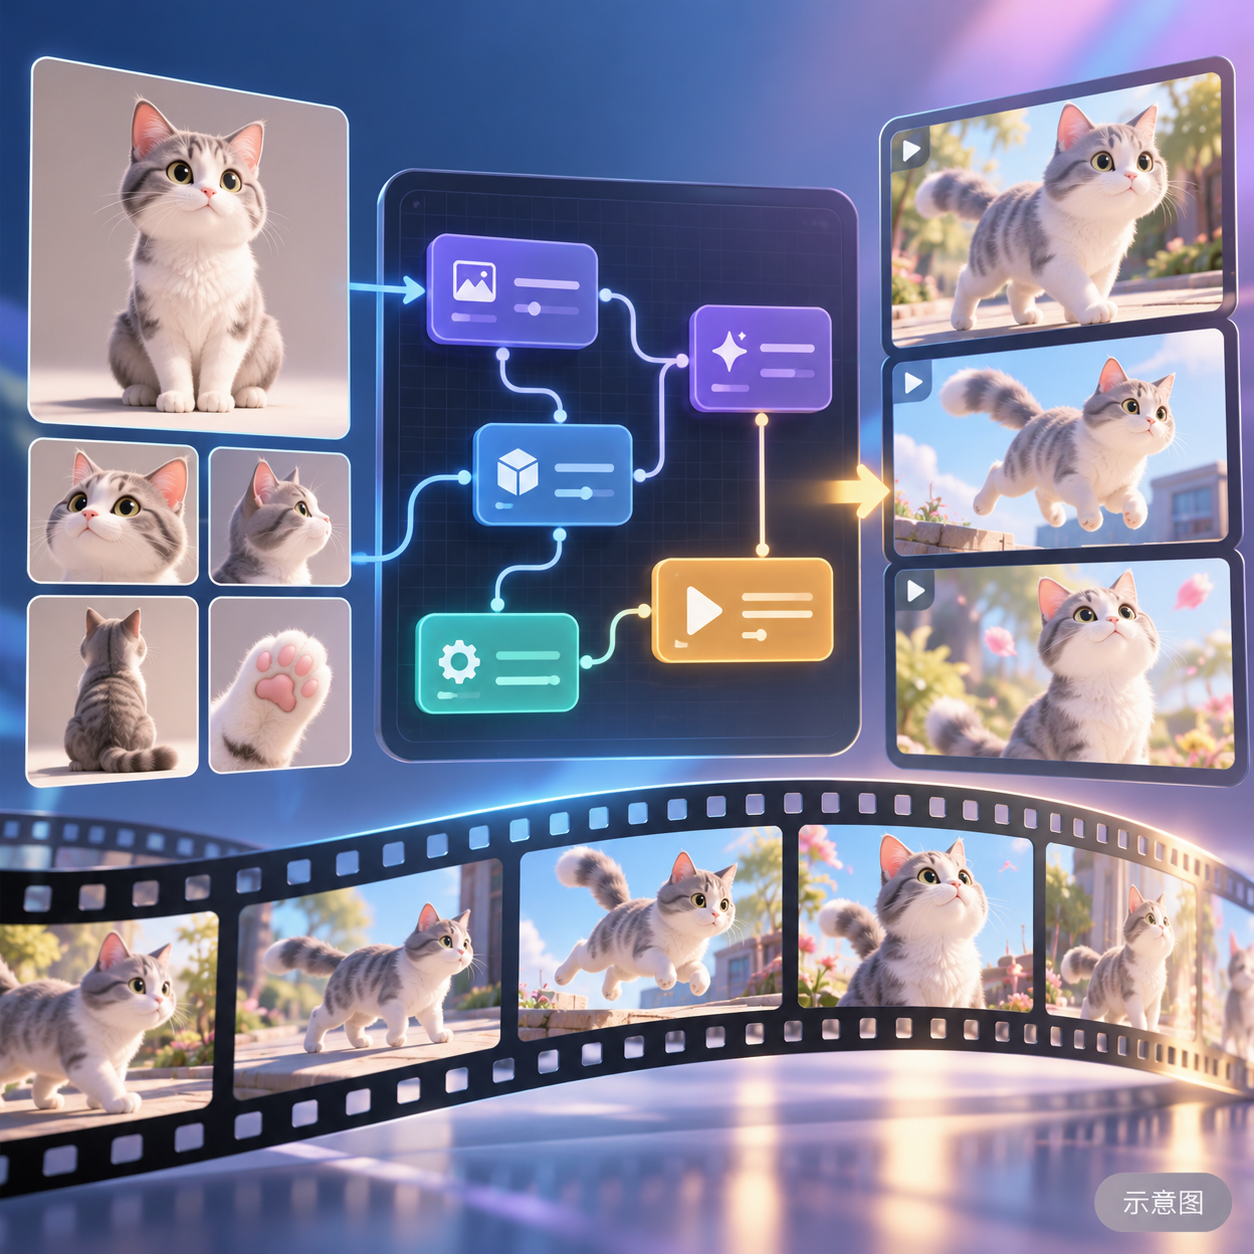
- MiniMax H3 RefMod Motion Reference · v1.0 — Workflow : la 2e étape du kit de six outils H3 RefMod : encode une vidéo de mouvement en un asset de référence de mouvement H3, permettant de transférer les indices de mouvement vers d'autres personnages lors de la génération ultérieure.
Données : API publique Civitai (modèle de base MiniMax H3), période d'inclusion du 10-31 08:31 au 10-31 21:01 (heure de Pékin). Les raisons de recommandation ont été vérifiées par la rédaction ; le nombre de téléchargements reflète uniquement l'intérêt porté au modèle.