贞贞的AI雷达 · MiniMax H3 · 2026-10-31 晚报
本期 13 个新版本:强烈推荐 0 · 推荐 1 · 可关注 5 · 仅收录 7
编辑按语 本期审阅 13 个 H3 新版本,没有 S 级条目。首推 Obsidian Nightmare 的 H3 移植版:单一光源、暗部压迫的恐怖氛围风格 LoRA,强度、采样器、步数和帧率都给了;由 S 降为 A,因为风格不是新能力、H3 段说明只有几行、可见示例只有 2 段。AIKSK 的 RefMod 是一套教程拆成的 6 个工作流(作者误标基模为 Other,实为 H3 参考生视频用),只保留主入口 Multi-Reference Apply 为 B,四个参考素材制作模块和 TextEncode 路线定为 C;不调用 H3 的通用放大工作流和常规角色 LoRA 定为 C,付费的鬼火车轮滑杆参数齐全,由 C 升为 B。
推荐(1)
【A】Obsidian Nightmare · Lucid Trauma MiniMax H3
LoRA · 移植 · 作者 Granddyser · 发布 10-31 19:34 · 下载 46
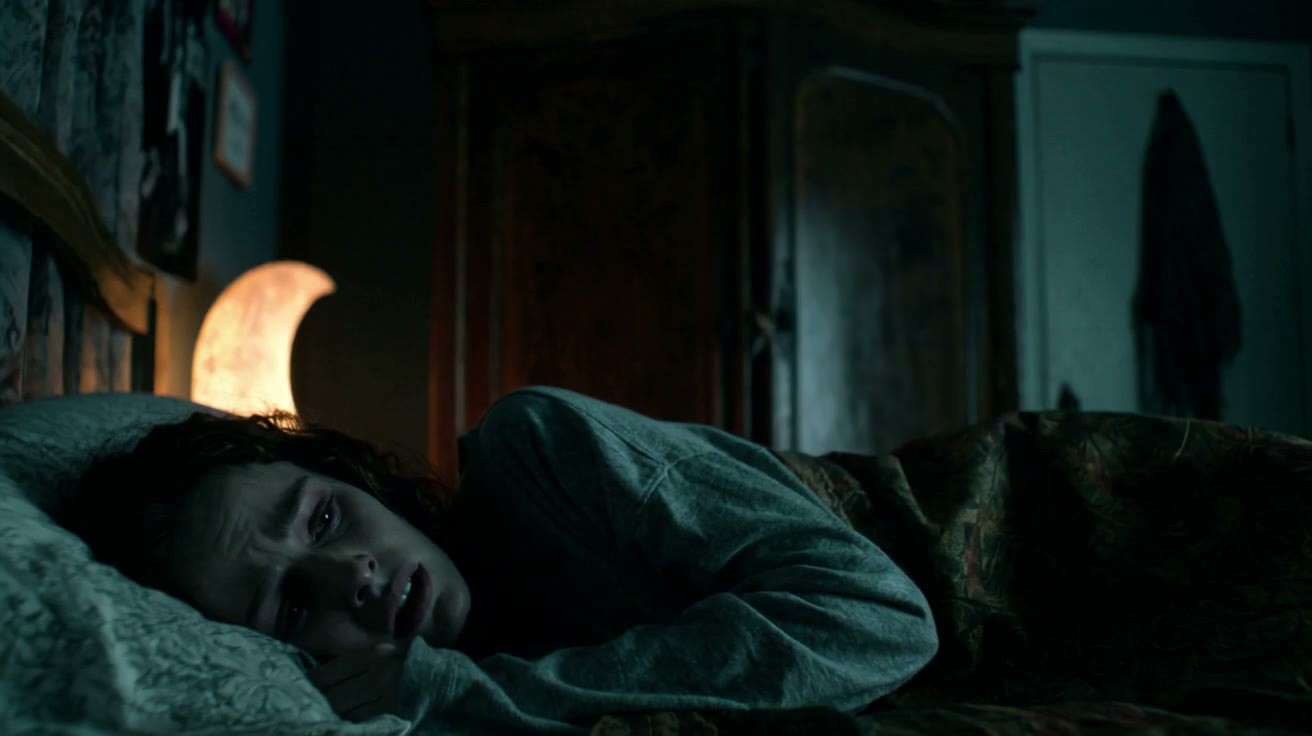
恐怖氛围风格 LoRA Obsidian Nightmare 的首个 H3 版本(Lucid Trauma):作者用自选的原创恐怖剧照训练,强调单一光源、大片暗部和“画面里有东西已经注意到你”的压迫感,而不是血腥。
由 S 降为 A:参数给得齐、免费、有视频示例,但恐怖氛围风格不算新能力,H3 版说明很短、触发词不明,可见示例只有 2 段。
配图
推荐理由
- 移植:同一模型页此前有 Krea 2(Nightmare、Fearbound)和 MOSS Image 版本,MOSS 版前一天发布,H3 版沿用同名 Lucid Trauma;H3 版另给了视频参数,还建议在提示词里写房间的声音(木板吱呀、滴水、呼吸),利用 H3 同时出声音的特点
- 服务恐怖短片、悬疑氛围镜头这类文生视频需求;作者的提示技巧:只点一个光源(小夜灯、裸灯泡、提灯)其余沉入黑暗,给镜头明确机位,让画面里每个角色都有注视对象
- 参数齐:强度 1.0(0.9–1.0),采样器 er_sde、调度器 beta、20 步,约 0.9 MP(16:9)、24 fps
- 有 2 段可见示例视频;免费,许可允许出图、出租和站内出租;发布约 1 小时 46 次下载,整个模型累计 1648 次(只代表关注度)
怎么用
- 在 H3 工作流里加载 ObsidianNightmare-LucidTrauma-H3.safetensors(569 MB · FP16),强度 1.0,er_sde + beta,20 步,约 0.9 MP 16:9,24 fps
- H3 版未登记触发词;卡上的 m1V8 是 Krea 2 版的触发词,H3 下要不要加作者未说明
风险与限制
- 模型卡大部分是 Krea 2 / MOSS Image 版的介绍和示例提示词,H3 专属说明只有用法和提示技巧几行
- 作者称展示了四段 5 秒短片并嵌入工作流,但站内可见的只有 2 段且不带提示词,另有 1 个敏感级示例已隐藏;本条未运行
- 许可不允许衍生;恐怖题材含人物惊吓场景
可关注(5)
【B】Singularity-V2-x-10Eros-Max · PRISM-PIKA
底模 / Checkpoint · 版本更新 · 作者 0l1v1aR0551 · 发布 10-31 20:08 · 下载 68
PRISM 合并底模(Singularity V2 × 10Eros-Max turbo beta 6 的 H3 Ref2VA 合并)的新版本:在最初那版 PRISM 的基础上内置了 Pika-H3-Flex(PIKA)LoRA。
维持 B:和昨天的 PIKA72 是同一思路换个底,没有可见示例、没有采样参数,也没说内置 LoRA 的作用。
配图
推荐理由
- 版本更新(第 5 个版本):作者称这是“内置 PIKA 的原版 PRISM”,即以 Singularity V2 × 10Eros-Max(8 步 Turbo beta 6)为底,而昨天的 PIKA72 是以 10Eros-Beta7 为底再融 PIKA;本版只有一个文件,PIKA 融入强度作者未写
- 合并方法沿用作者的 PRISM 算法(随机 SVD rank 64 过滤噪声增量、方向 SLERP 加对数空间幅度插值、处理符号冲突),作者称能减少把 turbo 模型并进底模时的伪影
- 发布约 1 小时 68 次下载,模型累计 4173 次(只代表关注度);免费,许可允许出图和站内出租
怎么用
- 下载 int8 safetensors(18.8 GB)替换 H3 ref2va 底模加载;fp16、w6a8 等其他精度在作者的 Hugging Face 仓库 OliviaRossi/Minimax-h3_Singularity-x-10Eros-Max_PRISM
- 步数、CFG、采样器作者未给(来源 10Eros-Max 是 8 步 turbo)
风险与限制
- 更新说明只有一句宣传语(“probably the best merge for everyone”),没说 PIKA LoRA 带来什么变化、和 PIKA72 / BETA72 各适合什么
- 示例全部是敏感级(4 个已隐藏),没有任何可预览的效果;本条未运行
- 三方合并加内置 LoRA,各来源的许可需自行核对
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
【B】LLM Easy prompt enhancer + modification (both with input image) (krea2/Minimax H3) · MiniMax H3 v2.0
工作流 · 版本更新 · 作者 Crimson009 · 发布 10-31 09:37 · 下载 62
在 ComfyUI 里直接调 LLM 写 / 改提示词的工具工作流 H3 v2.0:提示词生成器和修改器可以读图,还带一个用 H3 本身生成音频文件的“Audio Generator”。
维持 B:更新内容写得清楚,Audio Generator 的思路也实用,但依赖和 LLM 没交代,只有截图没有成片示例。
配图
推荐理由
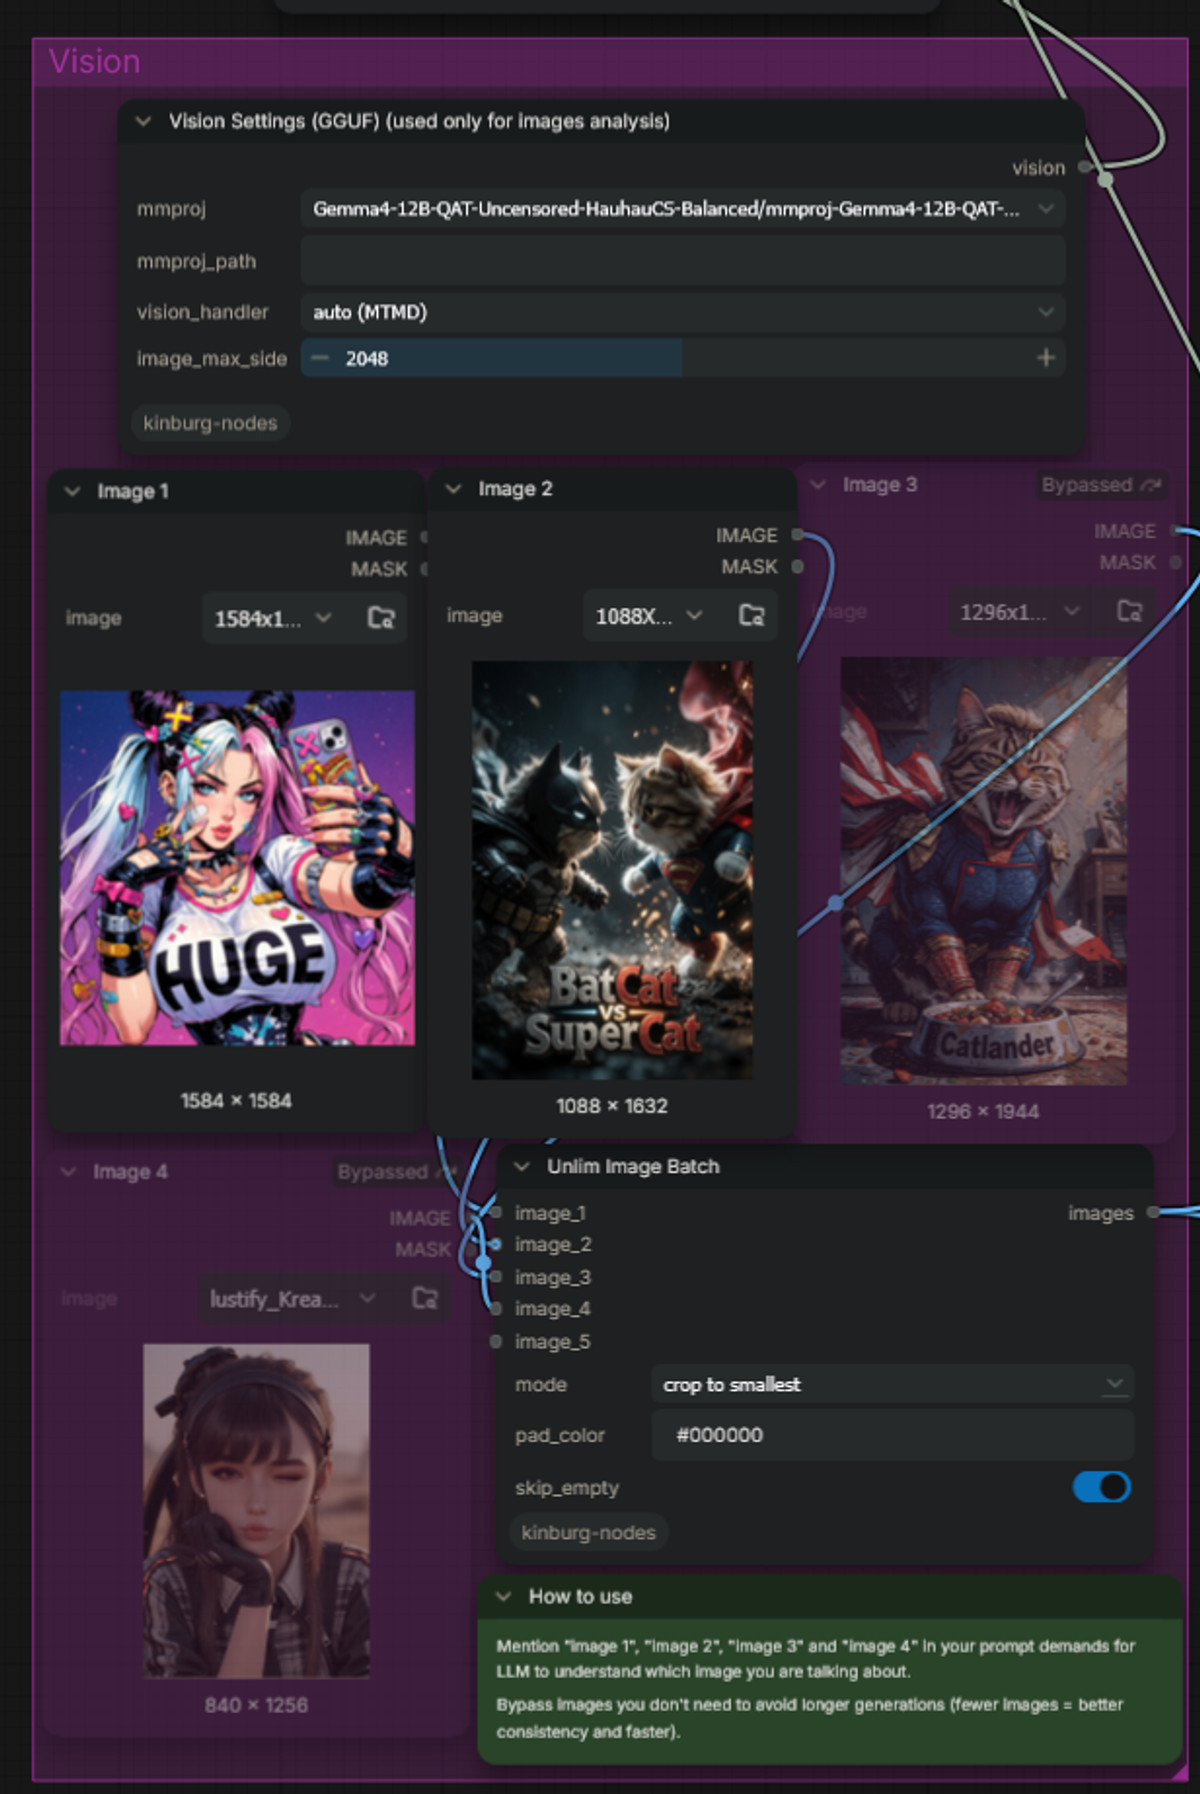
- 版本更新:相比 H3 v1.0,提示词生成器和修改器最多可上传 4 张图给 LLM;原来的“Text Voice Dialogue Generator”换成“Audio Generator”,可从用户输入或提示词生成一个音频文件,作者称便于在参考生视频(ref2video)里控制声音和人声
- Audio Generator 的做法:先让 LLM 写音频提示词,再用你自己的 H3 扩散模型以最低分辨率跑一遍、把音轨抽出来存成文件,不用另下模型(CLIP 和音频 VAE 也沿用现有的);作者称 RTX 5080 上生成 15 秒音频平均 15-20 秒
- 保留 v1.0 的读图提示词生成、提示词修改和聊天机器人;各组的用法写在工作流里的绿色说明卡上
- 有 2 张工作流截图;免费,许可允许出图、出租、站内出租和售卖融合
怎么用
- 导入 llmEasyPromptEnhancer_minimaxH3V20.json(141 KB),用 Manager 补齐节点;Audio Generator 里填你平时用的 H3 扩散模型、文本编码器和音频 VAE
- 读图时要在用户输入里说明图片是首帧还是参考图;具体用哪个 LLM / 视觉模型、要哪些节点包作者未在卡上列出
风险与限制
- LLM 后端和依赖节点未在卡上说明,只能导入后看;截图不是生成结果,没有音频或视频示例
- 用 H3 低分辨率生成再抽音轨,音质和对白可控性作者没有给样例;本条未运行
【B】MiniMax H3 Multi-Reference Apply · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 10-31 15:51 · 下载 20
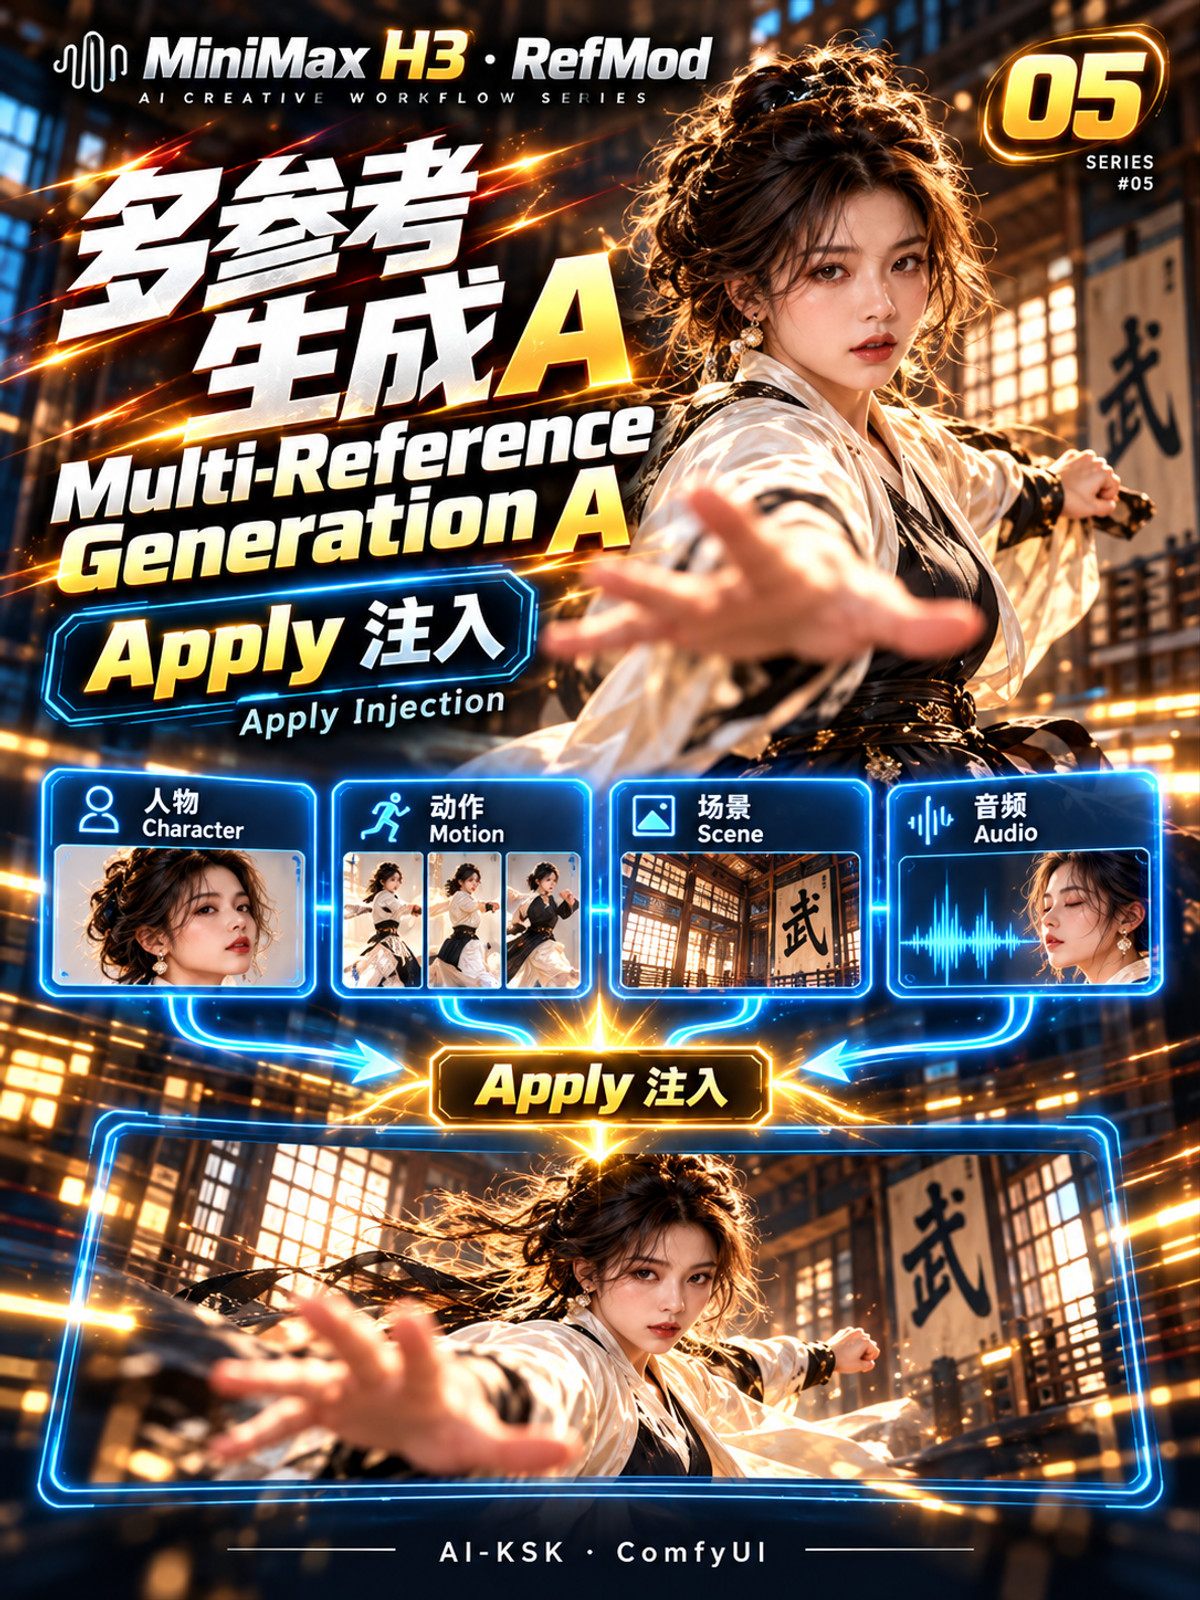
AI-KSK 的 H3 RefMod 六件套里的第 5 个、也是第一个真正出视频的工作流(多参考生成 A:Apply):把事先存好的人物、动作、场景和声音四个参考资产一次注入 H3 参考生视频的条件里。
维持 B:六件套里唯一能直接看出“多参考合成”用法的一条,参数和依赖都写清了,但没有任何成片示例,且要先跑完四个准备工作流。
配图
推荐理由
- 新模型:先用原生 MiniMaxH3ReferenceToVideo 编码提示词并建初始潜变量,再由 MiniMaxH3RefModApply 把已保存的 RefMod 资产注入条件;作者说明文本编码器在编码阶段看不到这些参考图本身
- 服务“同一角色、同一场景、指定动作和声音”的多参考短片;示例配置是角色 Rin 在道场独自练拳和回旋踢,再说一句中文台词,要求无音乐、无其他角色
- 参数写全:四个槽位各强度 1、copies 1,Apply 节点 retention=1、override=false,832×480、243 帧、种子 9527、Euler + beta、4 步,24 fps H.264 输出
- 确认是 H3 内容:用的是 H3 ref2va int8 检查点、H3 视频 / 音频 VAE 和 RefMod 节点包,作者把基模标成了 Other;免费
怎么用
- 先跑同系列 01–04 四个工作流做好 character / motion / scene / voice 四个 RefMod,或在加载器里换成自己的资产,再导入 minimaxH3Multi_v10.json 生成
- 需要 RefMod 节点包、Video Helper Suite、H3 ref2va 剪枝 int8 检查点、Qwen3-VL-32B NVFP4-AWQ 文本编码器、H3 视频 / 音频 VAE 和一个 4 步 Turbo LoRA(强度 1);这些权重都不随工作流提供
风险与限制
- 唯一的图是封面插画,不是生成结果;卡上明说台词和动作只是提示词要求、未验证,也没有耗时数据;本条未运行
- 必须先做好四个参考资产;不能给两名角色分别控制骨骼;卡里附云平台部署推广链接(含作者邀请码)
- 许可不允许商用
【B】MinimaxH3 Fully Auto Long Video & Digital Human · v1.0
工作流 · 新模型 · 作者 NicknickAI · 发布 10-31 13:07 · 下载 62
一个用 H3 做音频驱动长视频和数字人的 ComfyUI 工作流:给一张角色参考图、一段音轨和每段的提示词,自动分段生成并用上一段的末帧接下一段,最后拼回整条音视频。
维持 B:方向明确、对长视频有用,但没有可见示例,也没给依赖和参数。
配图
推荐理由
- 新模型:把音轨按指定区间切开逐段生成,每段以上一段最后一帧引导下一段保持画面连续,最后自动合成视频和音频
- 服务说话头像、角色唱歌、MV 和连续叙事这类比单段更长的需求;可调画幅、分辨率、每段时长,可选 RIFE 插帧
- 免费,许可只允许站内出租;发布约 8 小时 62 次下载(只代表关注度)
怎么用
- 导入 minimaxh3FullyAutoLong_v10.json(162 KB),用 Manager 补齐节点;需要的 H3 模型文件、步数、每段时长建议值作者未给
风险与限制
- 没有可见示例(1 个敏感级已隐藏),长视频的衔接和口型效果无法预览
- 模型卡只有一段介绍,没列依赖节点和模型;末帧接续的长视频常见画面漂移,作者未提;本条未运行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
【B】KinetiX Ghost Rider Hellfire Wheels & Molten Ground Concept Slider · v1.0
LoRA · 新模型 · 作者 make676767 · 发布 10-31 11:47 · 下载 0 · 付费
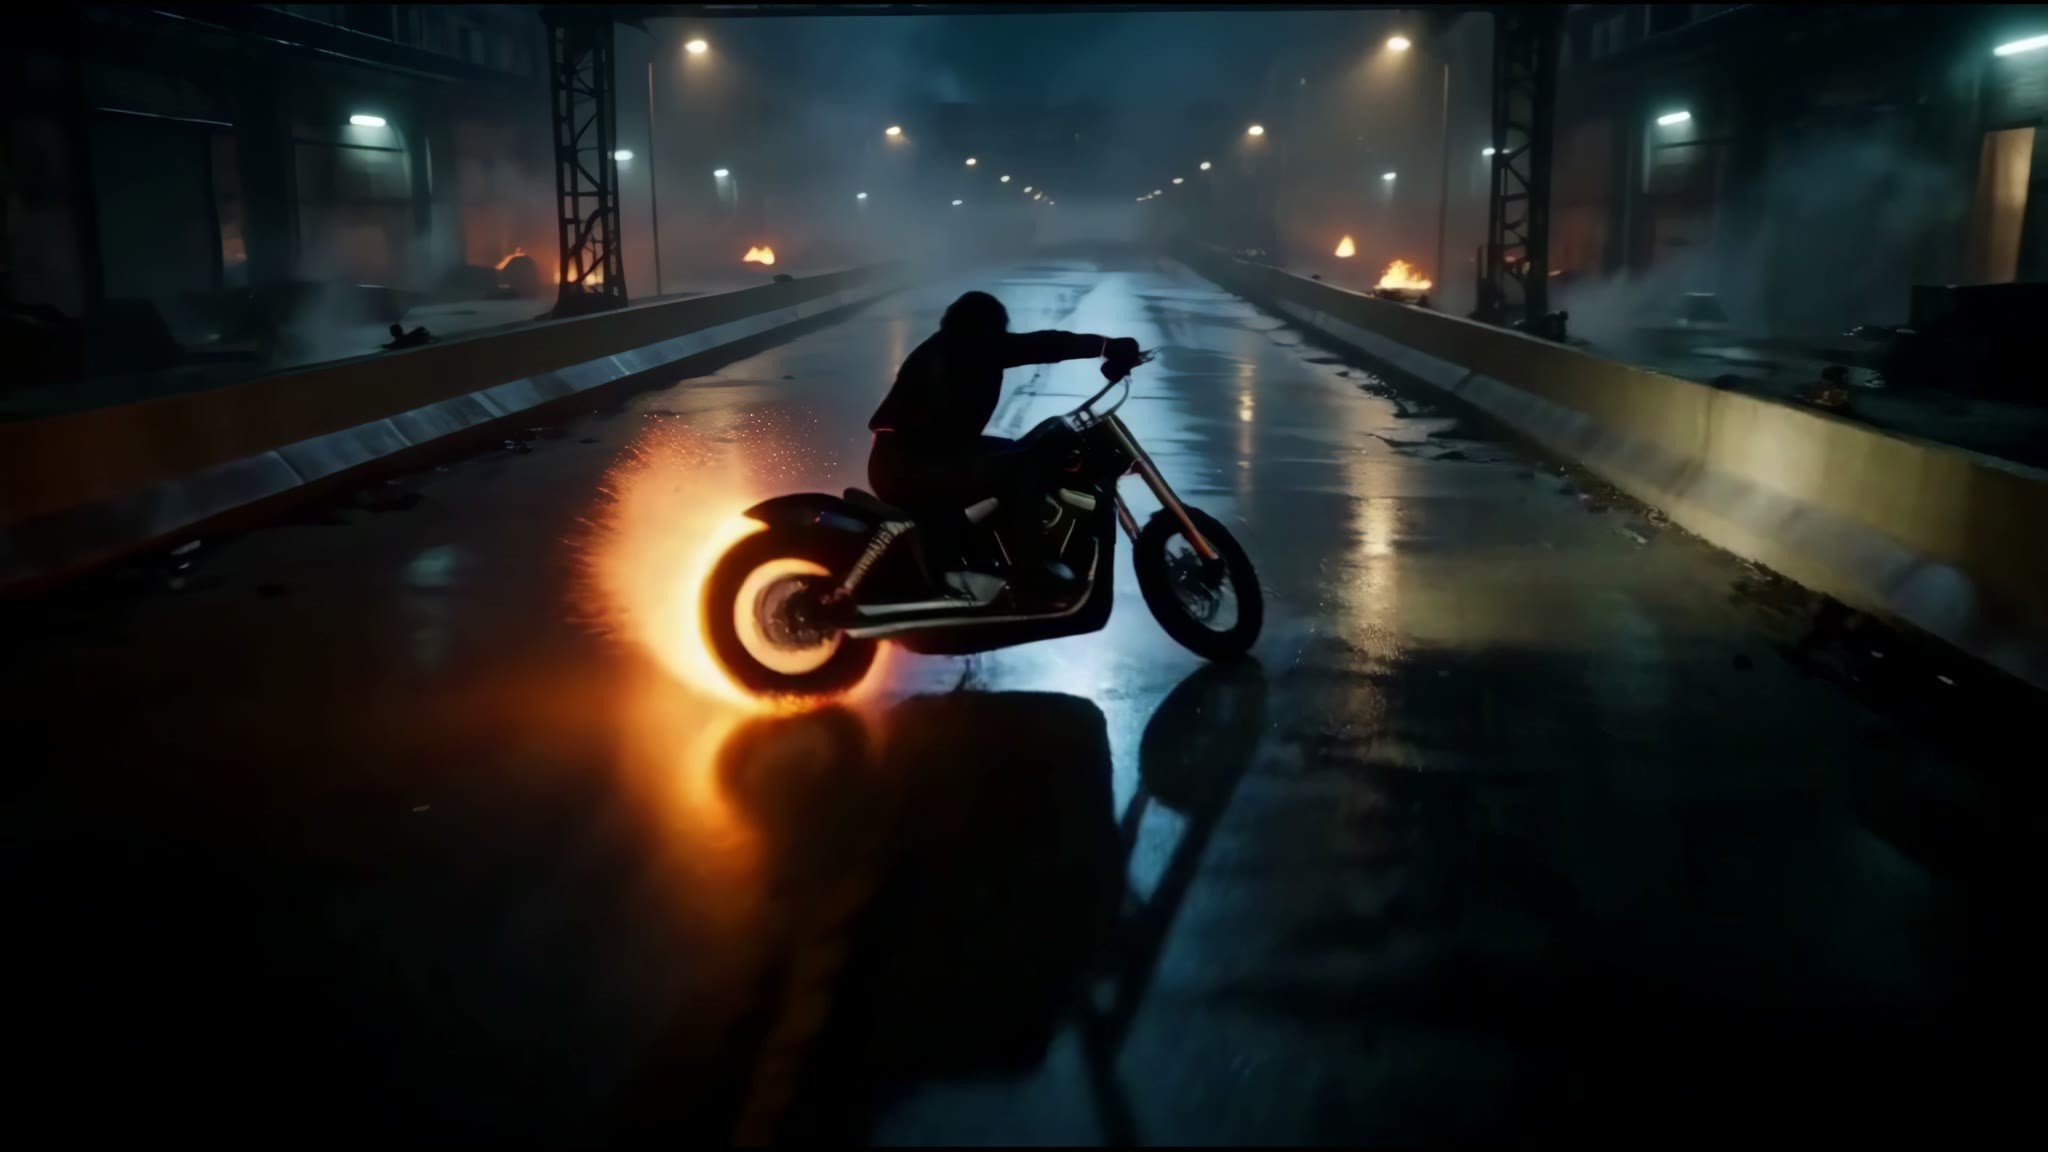
一个可正可负的特效滑杆 LoRA:正值让摩托 / 汽车车轮裹上向后甩的地狱火焰、在路面烧出发光的熔融车辙,负值把火焰扑灭、还原冷钢车身;题材是恶灵骑士。
由 C 升为 B:效果、强度分档和提示词都写清了,还能用负值灭火,但需要付费,可见示例只有 1 段。
配图
推荐理由
- 新模型:作者称火焰只附着在车轮和路面,车架保持实体不融化;无需触发词
- 强度分档写得清楚:+1.8 ~ +2.0 为推荐档,+2.5 ~ +3.5 火焰和浓烟更猛,0 为原样,-1.5 ~ -2.0 灭火
- 给了三条可直接复制的中英文提示词(夜间公路摩托追逐、1969 道奇 Charger 四轮火焰、原地甩尾烧出火环)和可选增强词;附工作流和资源压缩包
- 有 1 段可见示例视频(4K)
怎么用
- 加载 KinetiX_vfx_hellfire_cycle_h3_v1.0.safetensors(15 MB · BF16),strength_model 先试 +1.8 ~ +2.0;可加 blazing roaring hellfire wheels、violent centrifugal fire plumes、crackling molten scorched ground tracks
- 步数、CFG、采样器作者未在卡上写(可能在附带的工作流里)
风险与限制
- 付费下载,目前 0 次下载
- 可见示例只有 1 段,5 个敏感级示例已隐藏;恶灵骑士是 Marvel 角色,商用有版权风险;本条未运行
仅收录(7)
- VOSR Image and video over-resolution ,recommend · v1.0 — 工作流:一个基于 VOSR2 的图片和视频超分 ComfyUI 工作流:图片分支带前后对比,视频分支拆帧放大后按原帧率和原音频重新合成,另有一路 RTX Video Super Resolution 再放大;本身不调用 H3。
- MiniMax H3 RefMod Audio Reference · v1.0 — 工作流:H3 RefMod 六件套的第 3 步:把一段人声录音编码成可复用的 H3 声音参考资产(RefMod),供后面的 Apply 生成工作流选用。
- MiniMax H3 Multi-Reference TextEncode · v1.0 — 工作流:H3 RefMod 六件套的第 6 个工作流(多参考生成 B:TextEncode):另一条出视频路线,由带参考感知的文本编码节点把参考资产直接编进条件,并可输出 <Video n> / <Picture n> 的参考映射,用来在提示词里点名各个主体。
- MiniMax H3 RefMod Character Reference · v1.0 — 工作流:H3 RefMod 六件套的第 1 步:把一个文件夹里的角色照片预编码成可复用的 H3 人物参考资产,后续镜头都指向同一个命名资产来保持角色外观。
- Maya Belwyn · MiniMaxH3 — LoRA:原创虚构女性角色 Maya Belwyn 的 H3 LoRA;模型卡是一段人物小传(布鲁日世家、古籍修复店主),没有用法说明。
- MiniMax H3 RefMod Two-View Scene · v1.0 — 工作流:H3 RefMod 六件套的第 4 步:用同一地点的两张不同视角图,做一个可复用的 H3 场景参考资产,让多个镜头保持同一布景。
- MiniMax H3 RefMod Motion Reference · v1.0 — 工作流:H3 RefMod 六件套的第 2 步:把一段动作视频编码成 H3 动作参考资产,供后续生成时把动作提示迁移到别的角色上。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 10-31 08:31 → 10-31 21:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。