貞貞のAIレーダー · MiniMax H3 · 2026-10-31 夕刊
今号の 13 個の新バージョン:強く推奨 0 · 推奨 1 · 注目 5 · 収録のみ 7
編集後記 今号では 13 個の H3 新バージョンをレビューしましたが、S ランクの項目はありません。初推しは Obsidian Nightmare の H3 移植版です。単一光源と暗部の圧迫感によるホラー雰囲気スタイルの LoRA で、強度、サンプラー、ステップ数、フレームレートがすべて指定されています。S から A に格下げしたのは、スタイルが新機能ではなく、H3 向けの説明が数行しかなく、確認可能なサンプルが 2 本しかないためです。AIKSK の RefMod は、チュートリアルを 6 個のワークフローに分割したものです(作者はベースモデルを Other と誤記していますが、実際には H3 の参照動画生成用です)。メインエントリの Multi-Reference Apply のみを B とし、4 つの参照素材作成モジュールと TextEncode ルートは C と判定しました。H3 を呼び出さない汎用アップスケールワークフローと通常のキャラクター LoRA は C と判定し、有料の「鬼火車輪スライダー」パラメータが揃っているため、C から B に格上げしました。
推奨(1)
【A】Obsidian Nightmare · Lucid Trauma MiniMax H3
LoRA · 移植 · 作者 Granddyser · 公開 10-31 19:34 · ダウンロード 46
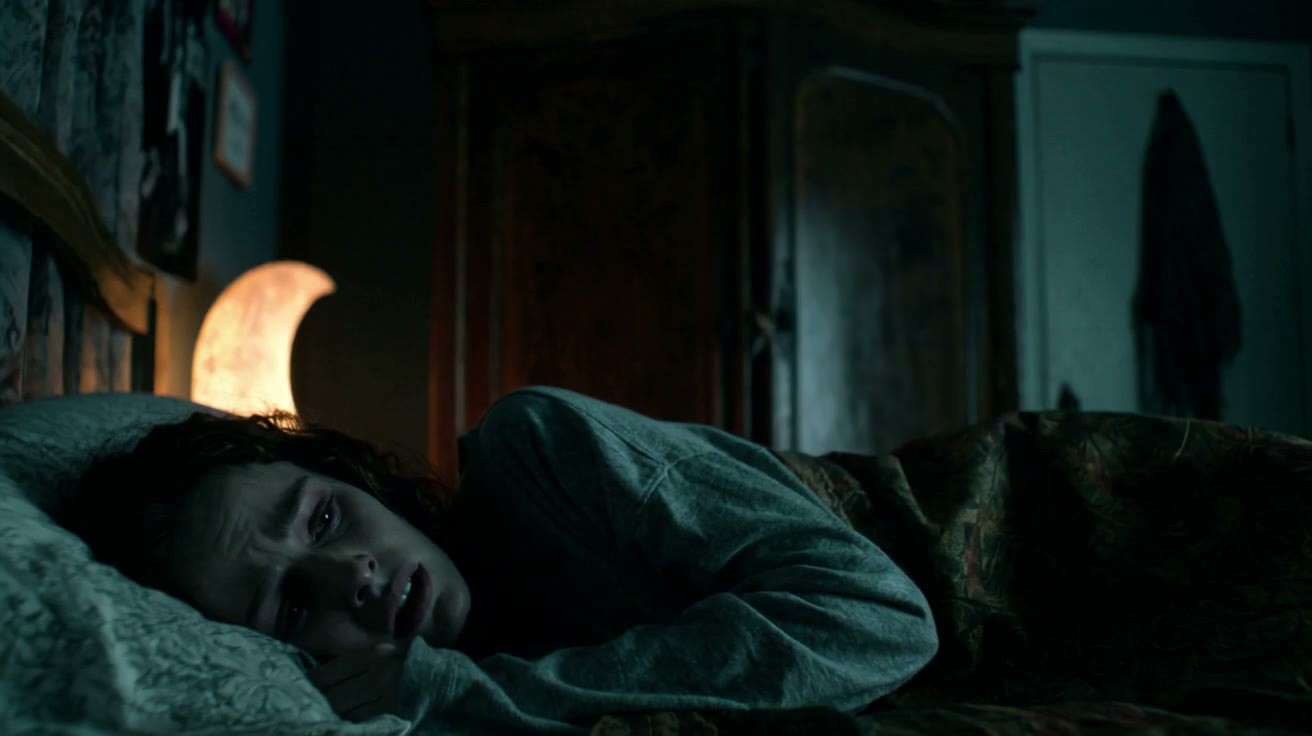
ホラー雰囲気スタイル LoRA「Obsidian Nightmare」の初の H3 版(Lucid Trauma)です。作者は自作のオリジナルホラースチル写真で学習し、血腥さよりも、単一光源、広大な暗部、「画面内の何かがあなたに気づいている」という圧迫感を強調しています。
S から A へ格下げ:パラメータは揃っており、無料で動画サンプルもありますが、ホラー雰囲気スタイルは新機能とは言えず、H3 版の説明は非常に短く、トリガーワードも不明確で、確認可能なサンプルは 2 本のみです。
画像
推奨理由
- 移植:同じモデルページには以前、Krea 2(Nightmare、Fearbound)と MOSS Image 版があり、MOSS 版は前日に公開されました。H3 版も同名の Lucid Trauma を採用しています。H3 版では動画パラメータも提供されており、プロンプトに部屋の音(板の軋み、水滴、呼吸)を記述することを推奨しています。これは H3 が音声も同時に出力する特性を利用するためです
- ホラー短編やサスペンス的な雰囲気のカットといったテキストから動画へのニーズに対応します。作者のプロンプトテクニック:光源を一つだけ指定し(ナイトライト、裸電球、ランタン)、他は暗闇に沈め、カメラアングルを明確にし、画面内の各キャラクターに注視対象を持たせます
- パラメータ完備:強度 1.0(0.9–1.0)、サンプラー er_sde、スケジューラ beta、20 ステップ、約 0.9 MP(16:9)、24 fps
- 確認可能なサンプル動画が 2 本あります。無料で、ライセンスでは画像出力、レンタル、サイト内レンタルが許可されています。公開後約 1 時間で 46 回ダウンロードされ、モデル累計では 1648 回です(これは注目度を示すに過ぎません)
使い方
- H3 ワークフローで ObsidianNightmare-LucidTrauma-H3.safetensors(569 MB · FP16)を読み込み、強度 1.0、er_sde + beta、20 ステップ、約 0.9 MP 16:9、24 fps に設定します
- H3 版ではトリガーワードが登録されていません。カード上の m1V8 は Krea 2 版のトリガーワードであり、H3 で追加すべきかどうかは作者から説明がありません
リスクと制限
- モデルカードの大部分は Krea 2 / MOSS Image 版の紹介とサンプルプロンプトであり、H3 専用の説明は使い方とプロンプトテクニックの数行のみです
- 作者は 5 秒の短編を4本展示しワークフローに埋め込んだと述べていますが、サイト内で確認できるのは 2 本のみでプロンプトも付いておらず、さらに 1 個のセンシティブレベルのサンプルは非表示です。本項目は実行していません
- ライセンスでは派生物の作成が許可されていません。ホラーテーマには人物の驚愕シーンが含まれます
注目(5)
【B】Singularity-V2-x-10Eros-Max · PRISM-PIKA
ベースモデル / Checkpoint · バージョン更新 · 作者 0l1v1aR0551 · 公開 10-31 20:08 · ダウンロード 68
PRISM マージベースモデル(Singularity V2 × 10Eros-Max turbo beta 6 の H3 Ref2VA マージ)の新バージョンです。当初の PRISM 版をベースに、Pika-H3-Flex(PIKA)LoRA を内蔵しています。
B 維持:昨日の PIKA72 と同じアプローチでベースを変えただけであり、確認可能なサンプルもサンプリングパラメータもなく、内蔵 LoRA の効果についても説明がありません。
画像
推奨理由
- バージョン更新(第 5 版):作者はこれを「PIKA を内蔵した原版 PRISM」と呼んでいます。つまり、Singularity V2 × 10Eros-Max(8 ステップ Turbo beta 6)をベースとしており、昨日の PIKA72 は 10Eros-Beta7 をベースに PIKA を融合したものでした。本バージョンはファイルが1つだけで、PIKA の融合強度については作者から記載がありません
- マージ手法は作者の PRISM アルゴリズム(ランダム SVD rank 64 によるノイズ増分のフィルタリング、方向 SLERP と対数空間での振幅補間、符号衝突の処理)を踏襲しており、turbo モデルをベースモデルにマージする際のアーティファクトを軽減できると作者は述べています
- 公開後約 1 時間で 68 回ダウンロードされ、モデル累計では 4173 回です(これは注目度を示すに過ぎません)。無料で、ライセンスでは画像出力とサイト内レンタルが許可されています
使い方
- int8 safetensors(18.8 GB)をダウンロードし、H3 ref2va ベースモデルの読み込み時に置き換えます。fp16、w6a8 などの他の精度は、作者の Hugging Face リポジトリ OliviaRossi/Minimax-h3_Singularity-x-10Eros-Max_PRISM にあります
- ステップ数、CFG、サンプラーについては作者から記載がありません(ソースである 10Eros-Max は 8 ステップの turbo です)
リスクと制限
- 更新説明は宣伝文句1つ(“probably the best merge for everyone”)のみで、PIKA LoRA がどのような変化をもたらすのか、PIKA72 / BETA72 と比較して何が適しているのかについては述べられていません
- サンプルはすべてセンシティブレベル(4 個が非表示)であり、プレビュー可能な効果は一切ありません。本項目は実行していません
- 三者マージに内蔵 LoRA が加わっているため、各ソースのライセンスは各自で確認する必要があります
- カードの画像は AI で生成された概念図であり、モデルの実際の効果ではありません。作者には公開されているノーマルレベルのサンプルがありません
【B】LLM Easy prompt enhancer + modification (both with input image) (krea2/Minimax H3) · MiniMax H3 v2.0
ワークフロー · バージョン更新 · 作者 Crimson009 · 公開 10-31 09:37 · ダウンロード 62
ComfyUI 内で LLM を直接呼び出してプロンプトを作成/修正するツールワークフロー H3 v2.0 です。プロンプトジェネレーターとモディファイアーは画像を読み取ることができ、さらに H3 自体を使用して音声ファイルを生成する「Audio Generator」も備えています。
B 維持:更新内容は明確に記述されており、Audio Generator のアプローチも実用的ですが、依存関係や LLM については説明がなく、スクリーンショットのみで完成動画のサンプルはありません。
画像
推奨理由
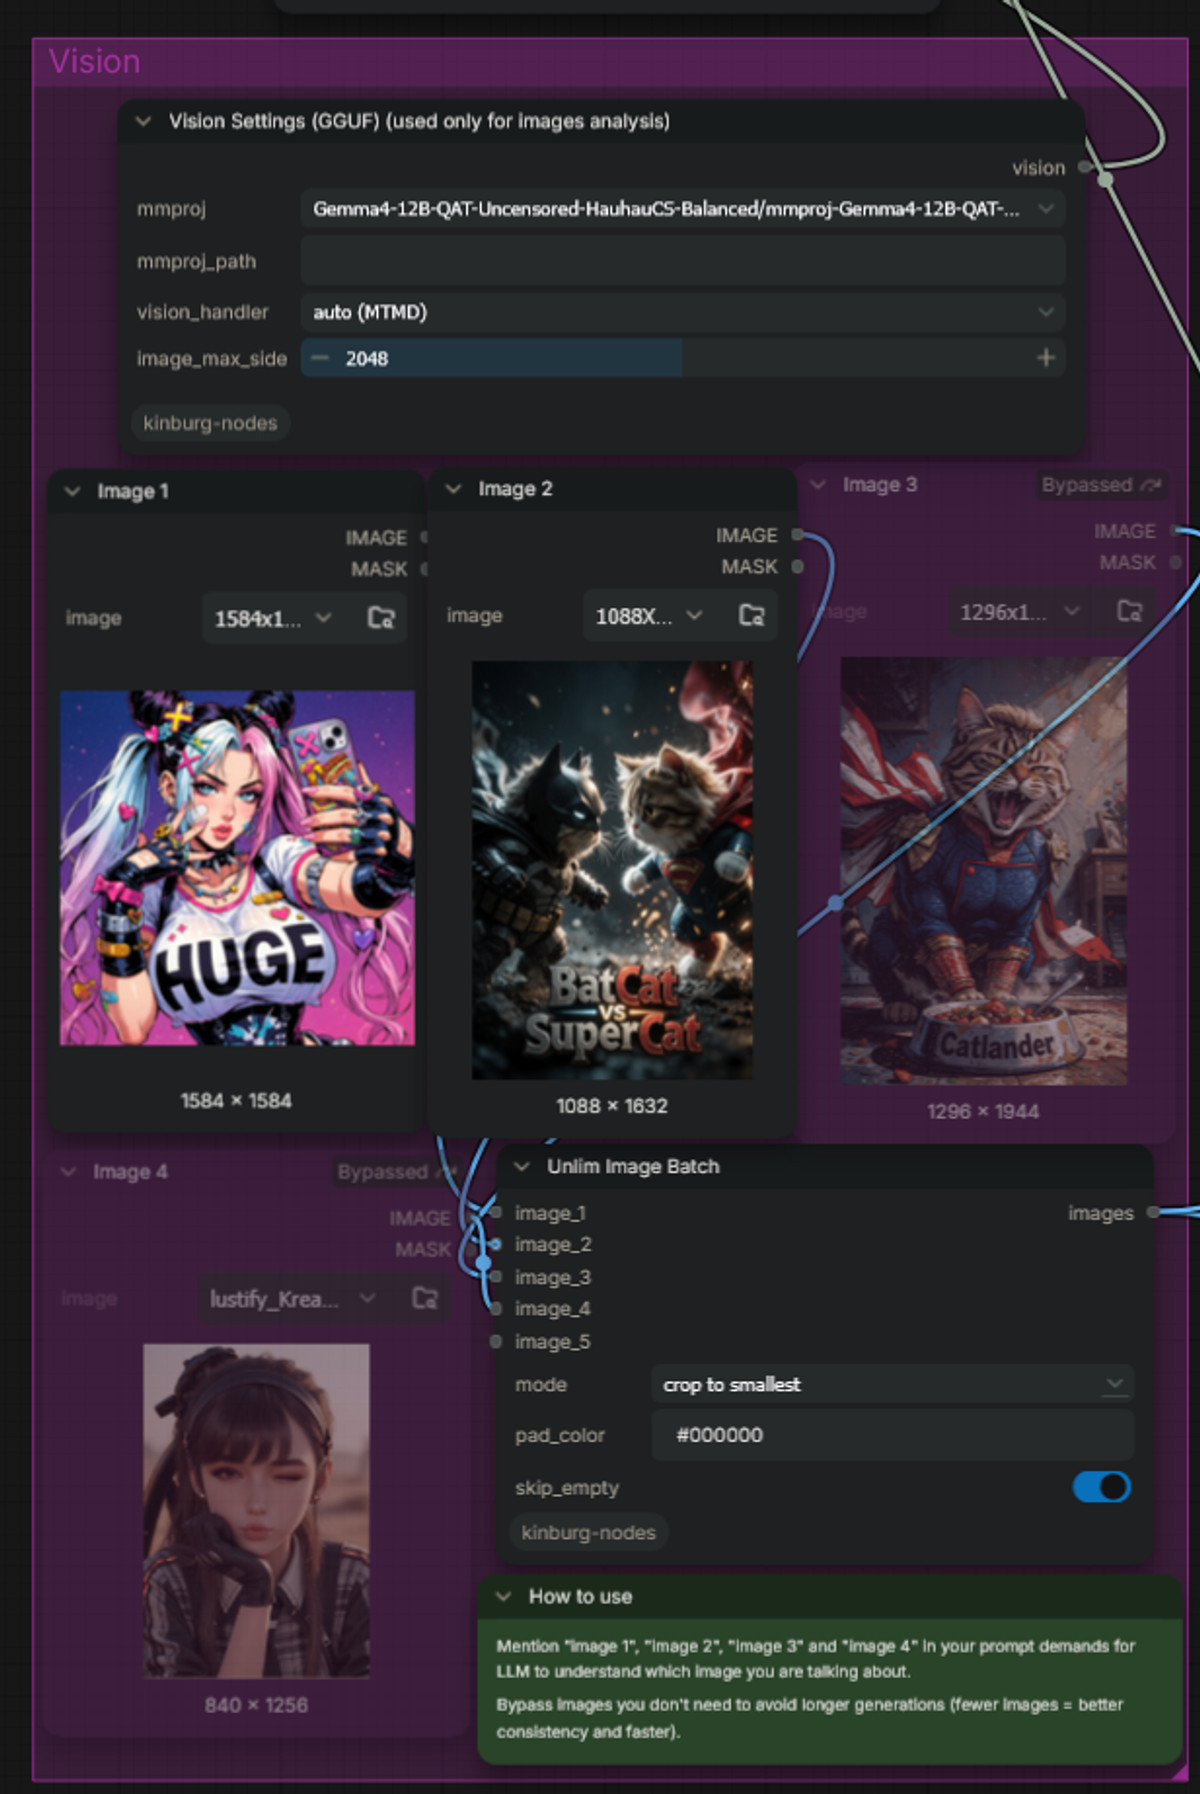
- バージョン更新:H3 v1.0 と比較し、プロンプトジェネレーターとモディファイアーでは最大 4 枚の画像を LLM にアップロードできます。従来の「Text Voice Dialogue Generator」は「Audio Generator」に置き換えられ、ユーザー入力またはプロンプトから音声ファイルを生成できます。作者は、参照動画生成(ref2video)で音声や声を制御するのに便利だと述べています
- Audio Generator の手法:まず LLM に音声プロンプトを書かせ、次にユーザー自身の H3 拡散モデルで最低解像度を実行し、オーディオトラックを抽出してファイルとして保存します。追加のモデルダウンロードは不要です(CLIP と音声 VAE も既存のものを使用)。作者は RTX 5080 で 15 秒の音声を生成するのに平均 15-20 秒かかると述べています
- v1.0 の画像読み取りプロンプト生成、プロンプト修正、チャットボット機能は維持されています。各グループの使い方はワークフロー内の緑色の説明カードに記載されています
- ワークフローのスクリーンショットが 2 枚あります。無料で、ライセンスでは画像出力、レンタル、サイト内レンタル、マージ品の販売が許可されています
使い方
- llmEasyPromptEnhancer_minimaxH3V20.json(141 KB)をインポートし、Manager でノードを補完します。Audio Generator には、普段使用している H3 拡散モデル、テキストエンコーダー、音声 VAE を入力します
- 画像を読み取らせる際は、ユーザー入力でその画像が最初のフレームなのか参照画像なのかを指定する必要があります。使用する LLM / ビジュアルモデルや必要なノードパッケージについては、カード上に記載がありません
リスクと制限
- LLM バックエンドと依存ノードはカード上に記載されておらず、インポート後に確認するしかありません。スクリーンショットは生成結果ではなく、音声や動画のサンプルはありません
- H3 の低解像度で生成してからオーディオトラックを抽出するため、音声品質や対話の制御可能性について作者からサンプル提供はありません。本項目は実行していません
【B】MiniMax H3 Multi-Reference Apply · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 10-31 15:51 · ダウンロード 20
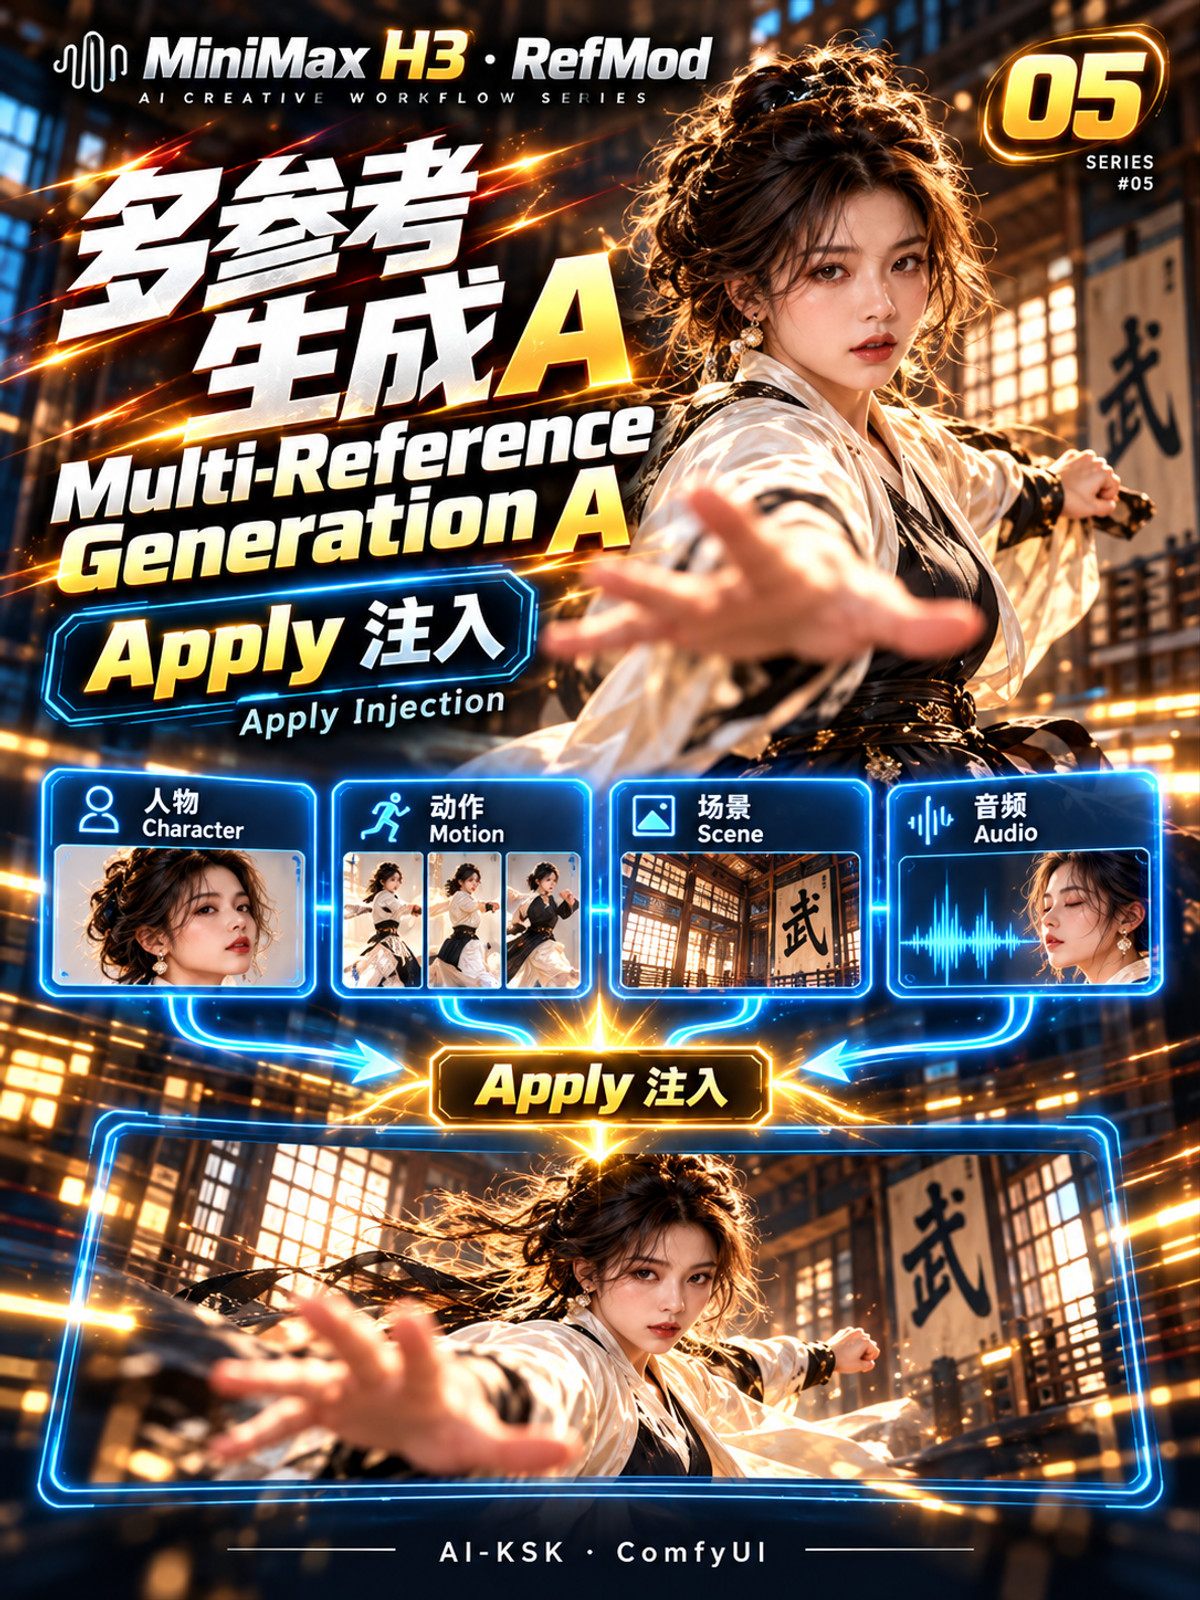
AI-KSK の H3 RefMod 6点セットのうち第 5 番目であり、初めて実際に動画を出力するワークフロー(マルチリファレンス生成 A:Apply)です。事前に保存しておいた人物、動作、シーン、音声の4つの参照アセットを、H3 参照動画生成の条件に一度に注入します。
B 維持:6点セットの中で唯一「マルチリファレンス合成」の使い方が直接見て取れる項目であり、パラメータと依存関係は明確に記述されていますが、完成動画のサンプルは一切なく、事前に4つの準備ワークフローを実行する必要があります。
画像
推奨理由
- 新モデル:まずネイティブの MiniMaxH3ReferenceToVideo でプロンプトをエンコードし、初期潜在変数を構築。その後、MiniMaxH3RefModApply で保存済みの RefMod アセットを条件に注入。著者によると、テキストエンコーダーはエンコード段階でこれらの参考画像そのものを見ることができない
- 「同一キャラクター、同一シーン、指定された動作と音声」に対応したマルチリファレンス短編動画サービス。設定例は、キャラクターの Rin が道場で一人で拳法と回し蹴りを練習し、中国語のセリフを一言発するもので、音楽なし、他キャラクターなしが要求されている
- パラメータを詳細に指定:4つのスロットそれぞれの強度 1、copies 1、Apply ノードの retention=1、override=false、832×480、243 フレーム、シード 9527、Euler + beta、4 ステップ、24 fps の H.264 出力
- H3 関連コンテンツであることを確認:使用しているのは H3 ref2va int8 チェックポイント、H3 動画/音声 VAE、および RefMod ノードパッケージ。著者はベースモデルを Other と表記。無料
使い方
- まず同シリーズの 01–04 の4つのワークフローを実行して、character / motion / scene / voice の4つの RefMod を作成するか、ローダー内で独自のアセットに置き換えてから、minimaxH3Multi_v10.json を読み込んで生成する
- RefMod ノードパッケージ、Video Helper Suite、H3 ref2va プルーニング済み int8 チェックポイント、Qwen3-VL-32B NVFP4-AWQ テキストエンコーダー、H3 動画/音声 VAE、および 1 つの 4 ステップ Turbo LoRA(強度 1)が必要。これらの重みはワークフローには含まれていない
リスクと制限
- 唯一の画像はカバーイラストであり、生成結果ではない。カードには、セリフと動作はプロンプト上の要求に過ぎず検証済みではなく、所要時間データもないと明記されている。本項目は未実行
- 4つの参考アセットを事前に作成する必要がある。2人のキャラクターに対して個別に骨格を制御することはできない。カードにはクラウドプラットフォームのデプロイ用プロモーションリンク(著者の招待コードを含む)が添付されている
- ライセンスにより商用利用は禁止されている
【B】MinimaxH3 完全自動長尺動画 & デジタルヒューマン · v1.0
ワークフロー · 新モデル · 作者 NicknickAI · 公開 10-31 13:07 · ダウンロード 62
H3 を使用して音声駆動の長尺動画とデジタルヒューマンを生成する ComfyUI ワークフロー。キャラクターの参考画像、音声トラック、各セグメントのプロンプトを入力すると、自動でセグメントごとに生成し、前セグメントの最終フレームで次セグメントを接続し、最後に動画と音声を結合して一本の動画にする。
評価 B:方向性は明確で長尺動画に有用だが、目に見えるサンプルがなく、依存関係やパラメータも提供されていない。
画像
推奨理由
- 新モデル:音声トラックを指定区間で切り分け、セグメントごとに生成。各セグメントは前セグメントの最終フレームをガイドとして画面の連続性を保ち、最後に動画と音声を自動合成する
- 話しているアバター、キャラクターの歌唱、MV、連続ナラティブなど、単一セグメントより長いニーズに対応。アスペクト比、解像度、各セグメントの長さを調整可能で、RIFE によるフレーム補間を選択可能
- 無料。ライセンスはサイト内でのレンタルのみ許可。公開後約 8 時間で 62 回のダウンロード(注目度を示すのみ)
使い方
- minimaxh3FullyAutoLong_v10.json(162 KB)を読み込み、Manager でノードを補完。必要な H3 モデルファイル、ステップ数、各セグメントの推奨長さは著者から提供されていない
リスクと制限
- 可視サンプルなし(1件のセンシティブレベルは非表示)、長尺動画のつなぎ目やリップシンク効果はプレビュー不可
- モデルカードは紹介文のみで、依存ノードやモデルが記載されていない。最終フレームからの長尺動画継続時の画面ドリフトは一般的だが、作者は言及していない。本項目は未実行
- カードの画像はAI生成の概念図であり、モデルの実際の出力結果ではない。作者は一般レベルの公開サンプルを持っていない
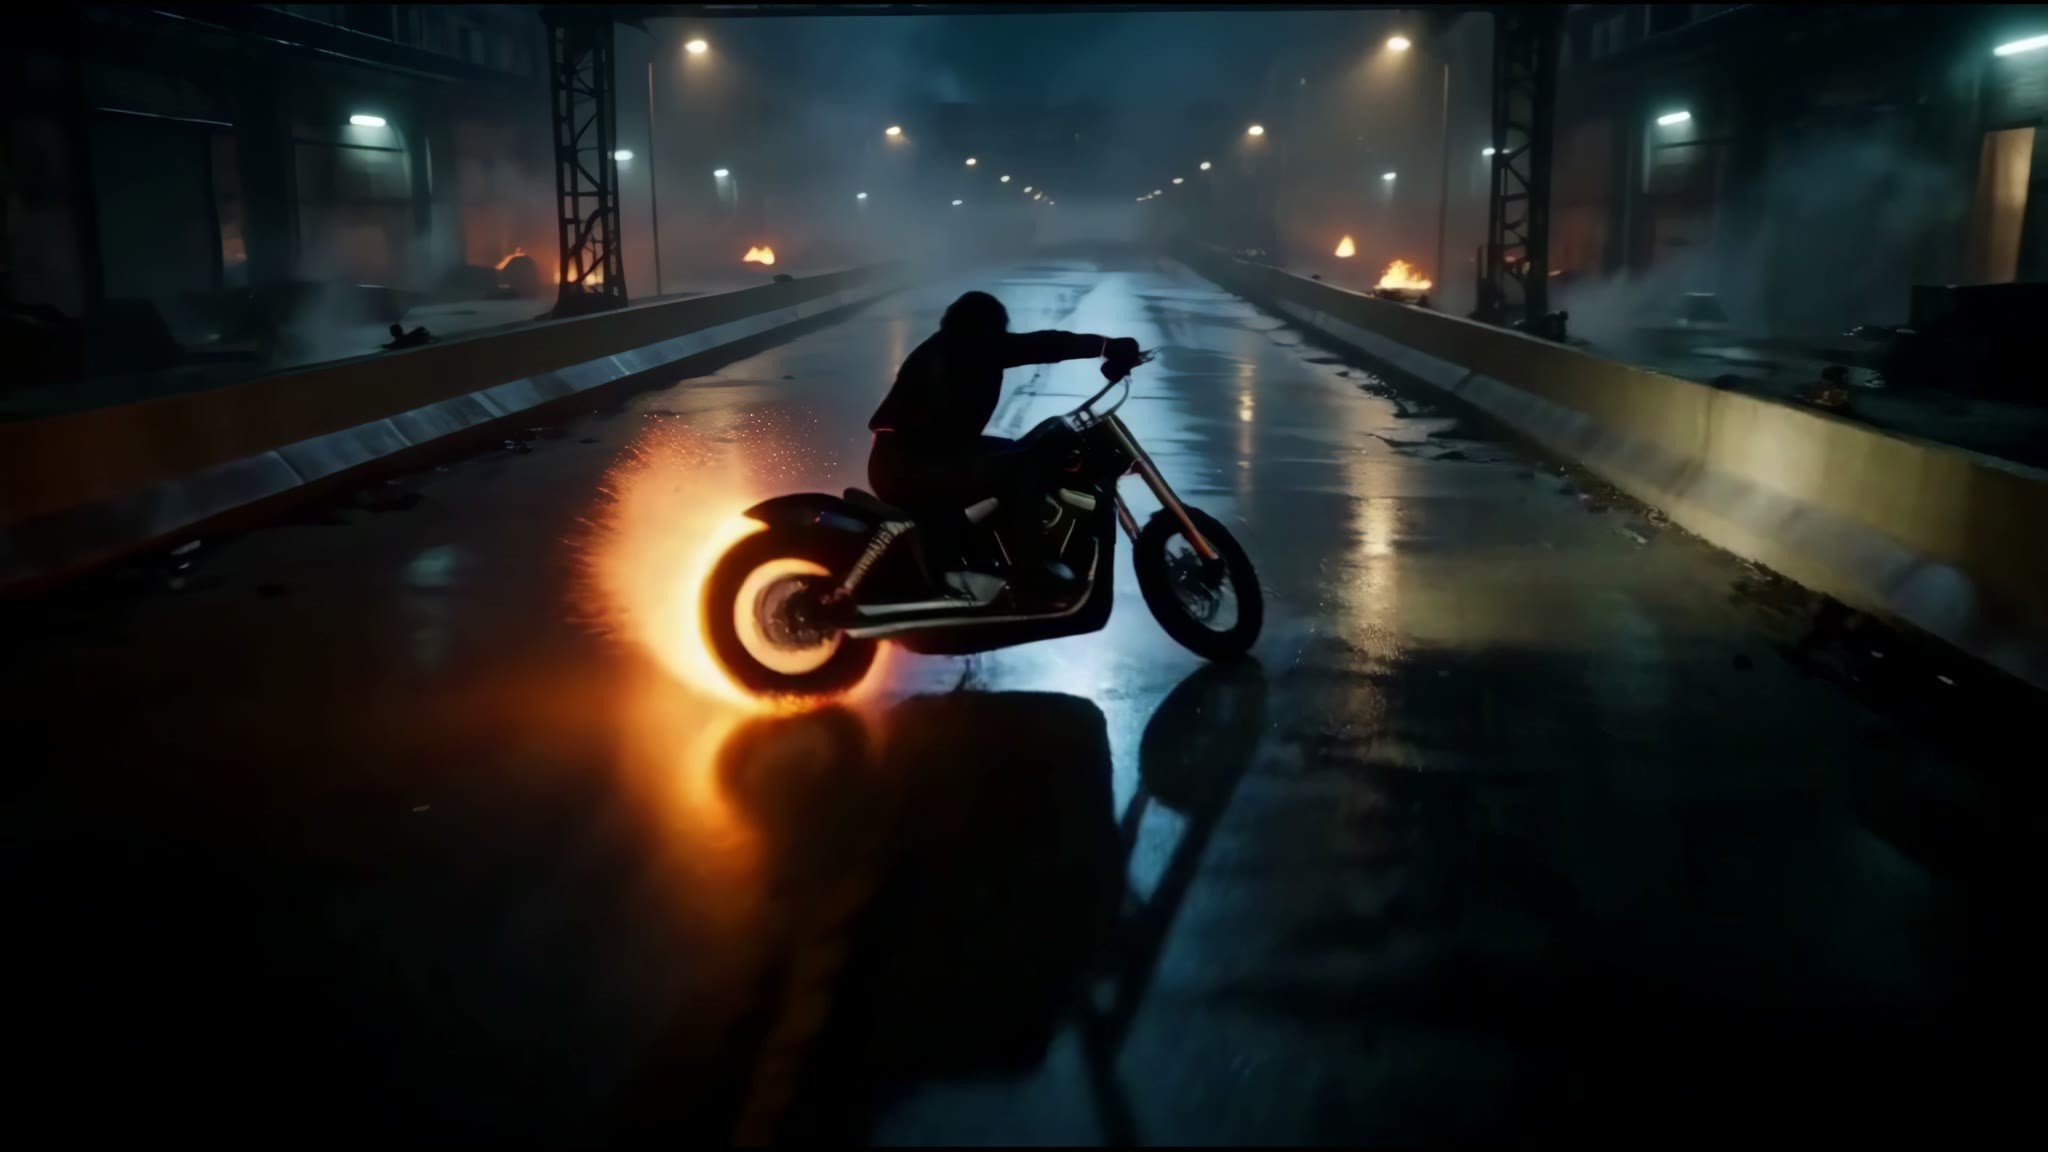
【B】KinetiX Ghost Rider Hellfire Wheels & Molten Ground Concept Slider · v1.0
LoRA · 新モデル · 作者 make676767 · 公開 10-31 11:47 · ダウンロード数 0 · 有料
正負両方向に調整可能なエフェクトスライダーLoRA:正の値ではバイク/自動車のホイールが後方へ噴き上げる地獄の炎に包まれ、路面に光る溶融した轍を刻む。負の値では炎を消し去り、冷たいスチール製の車体を復元する。テーマはゴーストライダー。
CからBへ昇格:効果、強度の段階、プロンプトが明確に記載されており、負の値で消火も可能だが、有料であり、可視サンプルは1件のみ。
画像
推奨理由
- 新モデル:作者によれば、炎はホイールと路面のみに付着し、フレームは溶けずに実体として保持される。トリガーワード不要
- 強度の段階が明確に記載:+1.8 ~ +2.0が推奨範囲、+2.5 ~ +3.5では炎と濃煙がより激しくなり、0は原状維持、-1.5 ~ -2.0では消火
- 直接コピー可能な中英文プロンプトを3つ提供(夜間道路でのバイク追跡、1969ダッジ・チャージャーの4輪炎、その場でのドリフトによる火の輪の形成)および任意の強化ワードを併記。ワークフローとリソースアーカイブも添付
- 可視サンプル動画が1件あり(4K)
使い方
- KinetiX_vfx_hellfire_cycle_h3_v1.0.safetensors(15 MB · BF16)を読み込み、strength_modelはまず+1.8 ~ +2.0で試す。blazing roaring hellfire wheels、violent centrifugal fire plumes、crackling molten scorched ground tracksなどを追加可能
- ステップ数、CFG、サンプラーについてはカードに記載なし(添付のワークフロー内に含まれている可能性あり)
リスクと制限
- 有料ダウンロード、現在のダウンロード数は0回
- 可視サンプルは1件のみで、5件のセンシティブレベルサンプルは非表示。ゴーストライダーはマーベルのキャラクターであり、商用利用には著作権リスクがある。本項目は未実行
収録のみ(7)
- VOSR Image and video over-resolution ,recommend · v1.0 — ワークフロー:VOSR2に基づく画像および動画のスーパーレゾリューション用ComfyUIワークフロー。画像ブランチは前後比較付き、動画ブランチはフレーム分割拡大後に元のフレームレートと音声で再合成。さらにRTX Video Super Resolutionによる追加拡大ルートも存在。本ワークフロー自体はH3を呼び出さない。
- MiniMax H3 RefMod Audio Reference · v1.0 — ワークフロー:H3 RefMod 6点セットの第3ステップ:音声録音を再利用可能なH3音声参考アセット(RefMod)にエンコードし、後続のApply生成ワークフローで使用可能にする。
- MiniMax H3 Multi-Reference TextEncode · v1.0 — ワークフロー:H3 RefMod 6点セットの第6ワークフロー(マルチリファレンス生成B:TextEncode):別の動画生成ルート。参考認識付きテキストエンコードノードにより参考アセットを条件に直接エンコードし、プロンプト内で各主体を指定するための<Video n> / <Picture n>参考マッピングを出力可能。
- MiniMax H3 RefMod Character Reference · v1.0 — ワークフロー:H3 RefMod 6点セットの第1ステップ:フォルダ内のキャラクター写真を再利用可能なH3人物参考アセットに事前エンコードし、後続のショットで同じ命名アセットを参照してキャラクターの外観を維持する。
- Maya Belwyn · MiniMaxH3 — LoRA:オリジナルの架空女性キャラクターMaya BelwynのH3 LoRA。モデルカードは人物紹介文(ブルッヘの名家、古書修復店主)であり、使用方法の説明はない。
- MiniMax H3 RefMod Two-View Scene · v1.0 — ワークフロー:H3 RefMod 6点セットの第4ステップ:同一場所の異なる2視点の画像を使用し、再利用可能なH3シーン参考アセットを作成して、複数ショットで同じセットを維持する。
- MiniMax H3 RefMod Motion Reference · v1.0 — ワークフロー:H3 RefMod 6点セットの第2ステップ:アクション動画をH3アクション参考アセットにエンコードし、後続の生成時にアクションプロンプトを他のキャラクターへ転写するために使用する。
データ:Civitai公開API(基盤モデル MiniMax H3)、収録期間 10-31 08:31 → 10-31 21:01(北京時間)。推奨理由は編集者によるレビュー済み。ダウンロード数は単なる注目度を示す。