Radar IA de Zhenzhen · MiniMax H3 Image · 2026-11-17 Édition du soir
Cette édition 6 nouvelles versions : fortement recommandé 1 · recommandé 2 · à suivre 1 · inclus uniquement 2
Note de l'éditeur Cette édition examine 6 nouvelles versions de H3 Image, dont 1 classées S, 2 classées A, 1 classées B et 2 classées C, toutes étant des workflows et 1 LoRA portés. La recommandation principale est le workflow tout-en-un H3 Image de YJ LAB : génération de texte-vers-image et édition d'image réunies dans un seul workflow, 4–16 MP, 6 étapes, avec extension de prompt et amélioration des détails SeedVR2 intégrées. La nouvelle version texte-vers-image du workflow d'édition réaliste utilise l'astuce de l'image vide de Kijai pour placer H3 Image dans un mode de référence propre ; l'auteur ne l'a testée que sur une carte graphique de 96 Go ; le workflow simple de texte-vers-image avec aperçu en temps réel ajoute l'amélioration des prompts et des préréglages d'échantillonnage, tous deux classés A. La version portée du LoRA de couleur pellicule, payante et fortement orientée style, est classée B ; le workflow d'édition d'image utilisant le modèle vidéo H3 et le workflow de transfert de personnage ont des descriptions très courtes et renvoient principalement vers des plateformes externes, classés C.
Fortement recommandé (1)
【S】H3 Image AIO – MiniMax H3 texte-vers-image + édition d'image, 4–16 MP, 6 étapes · v1.01
Workflow · Nouveau modèle · Auteur 1113800942188 · Publié le 11-17 10:25 · Téléchargements 62
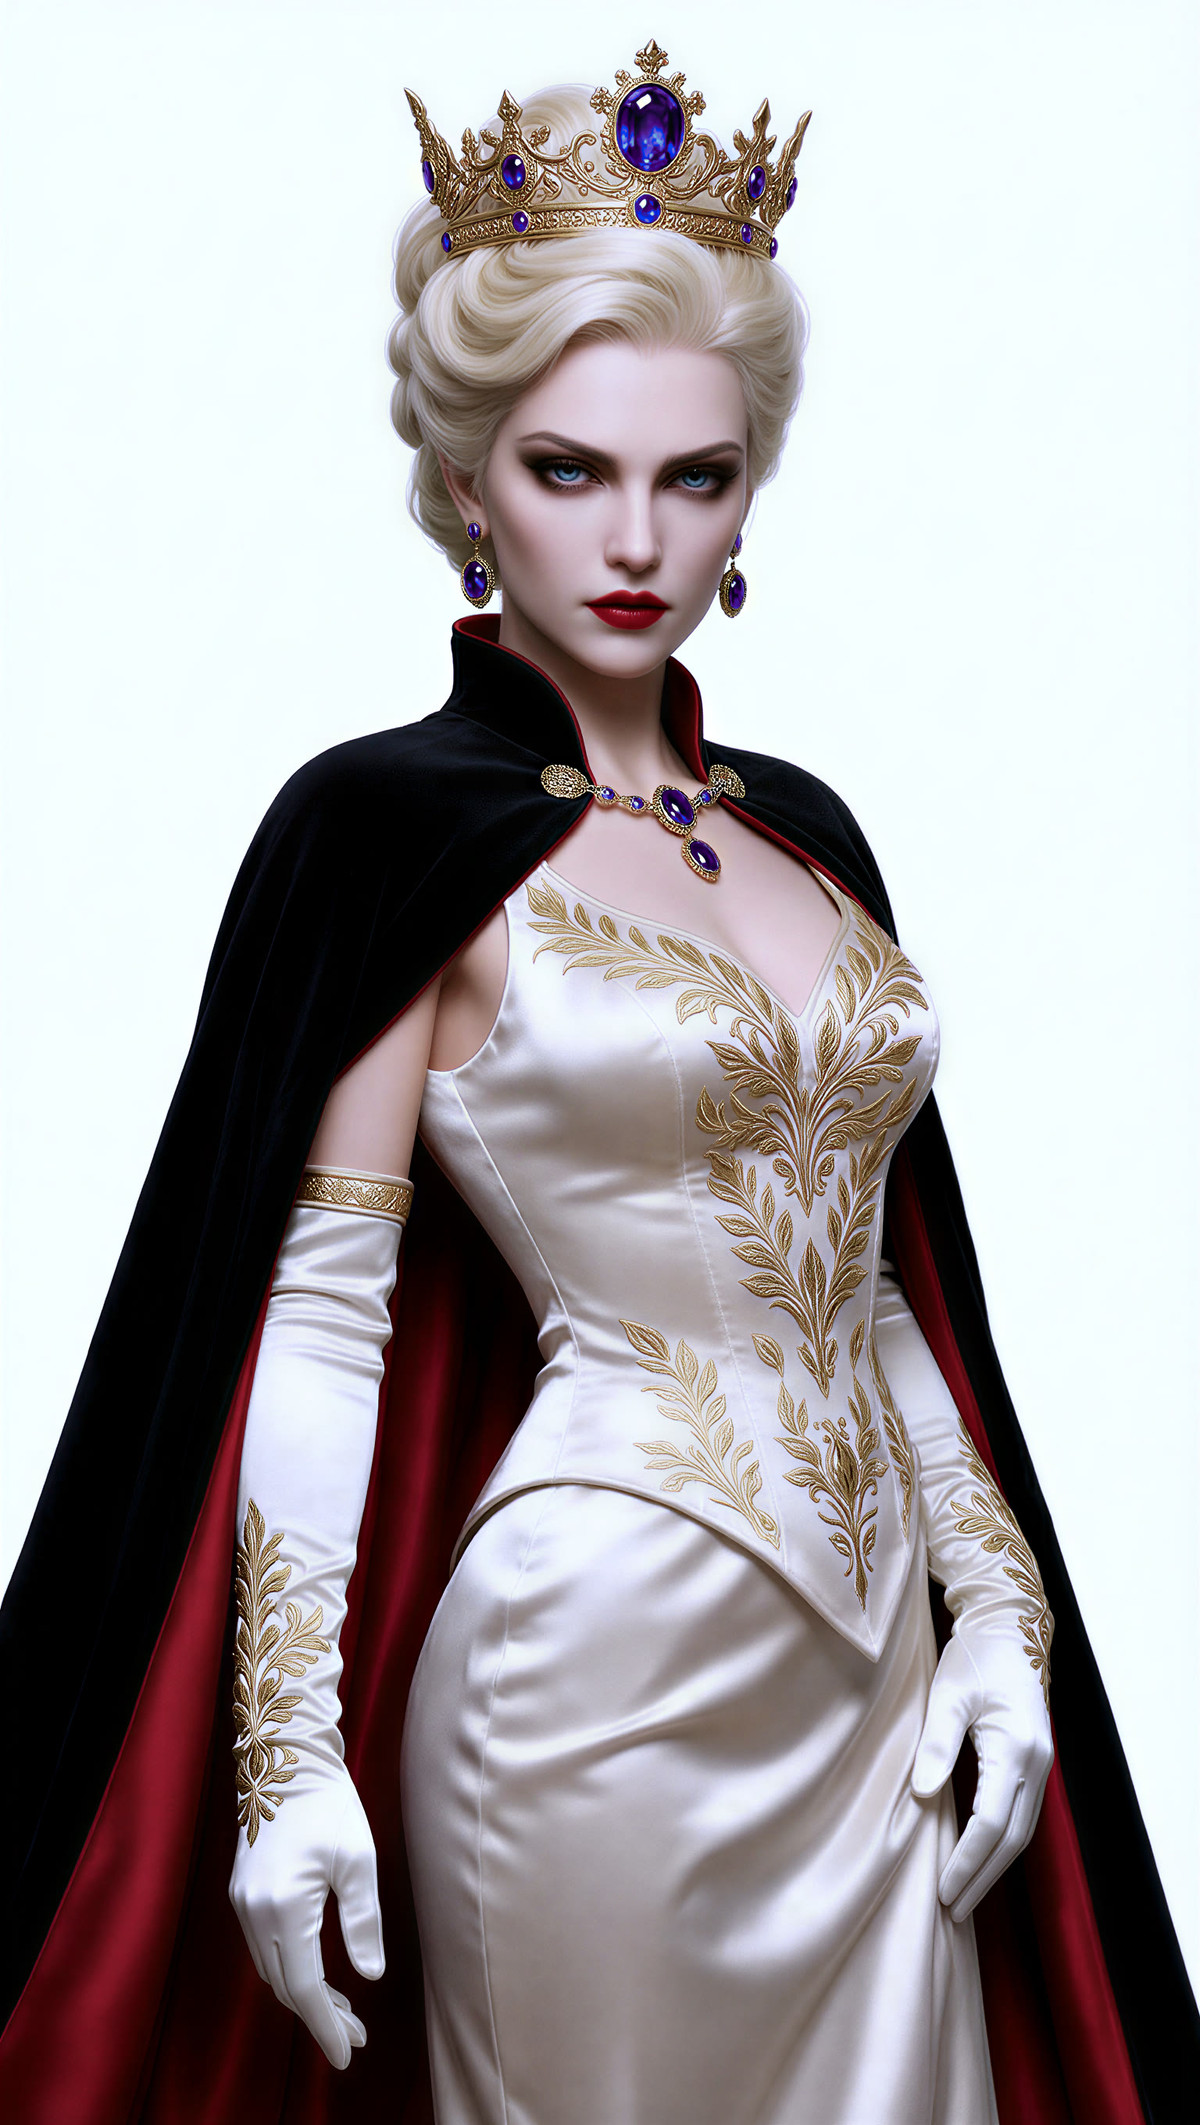
Workflow ComfyUI tout-en-un H3 Image : génération de texte-vers-image et édition d'image réunies dans un seul workflow, préréglages de résolution 4–16 MP, sortie en 6 étapes, avec extension de prompt et amélioration des détails SeedVR2 intégrées.
Illustrations
Raisons de la recommandation
- Sert deux types de tâches : génération purement textuelle et édition avec jusqu'à 6 images de référence (images ou vidéos) ; si toutes les entrées sont désactivées, c'est une génération purement textuelle
- L'auteur a documenté chaque réglage : conservez les sigmas de 6 étapes définis dans le workflow, ne modifiez pas les deux modèles système d'extension, désactivez l'extension si vous avez déjà un prompt finalisé pour accélérer
- Fournit 4 jeux de prompts d'exemple (personnage au crayon de couleur, fiche de personnage, costume xianxia, affiche avec texte), les 5 images d'exemple sont toutes visibles, gratuit
Comment l'utiliser
- Préréglages de résolution 4–16 MP, conservez les sigmas de 6 étapes sans modification
- L'auteur affirme que le LoRA d'édition apporte la plus grande amélioration, il peut être activé même en mode non-édition, le style est légèrement orienté vers l'esthétique orientale
- Gardez l'agrandissement SeedVR2 activé, réglez le facteur sur 1, pour améliorer uniquement les détails sans agrandir
- Placez les mots-clés de déclenchement et les noms propres dans les champs réservés, l'extension ne les réécrira pas ; l'auteur propose une explication vidéo dans la 6e vidéo de sa chaîne YouTube YJ LAB
Risques et limitations
- La liste des nœuds et modèles dépendants n'est pas complète dans la fiche du modèle, vérification nécessaire, cet outil n'a pas été exécuté
- La fiche du modèle n'indique pas quel LoRA d'édition est utilisé ni où le télécharger
Recommandé (2)
【A】MiniMax H3 Image : Workflows d'édition réaliste + texte-vers-image (16 MP, ComfyUI) · Texte-vers-image v1.0
Workflow · Mise à jour de version · Auteur voidhunter77 · Publié le 11-17 11:31 · Téléchargements 55
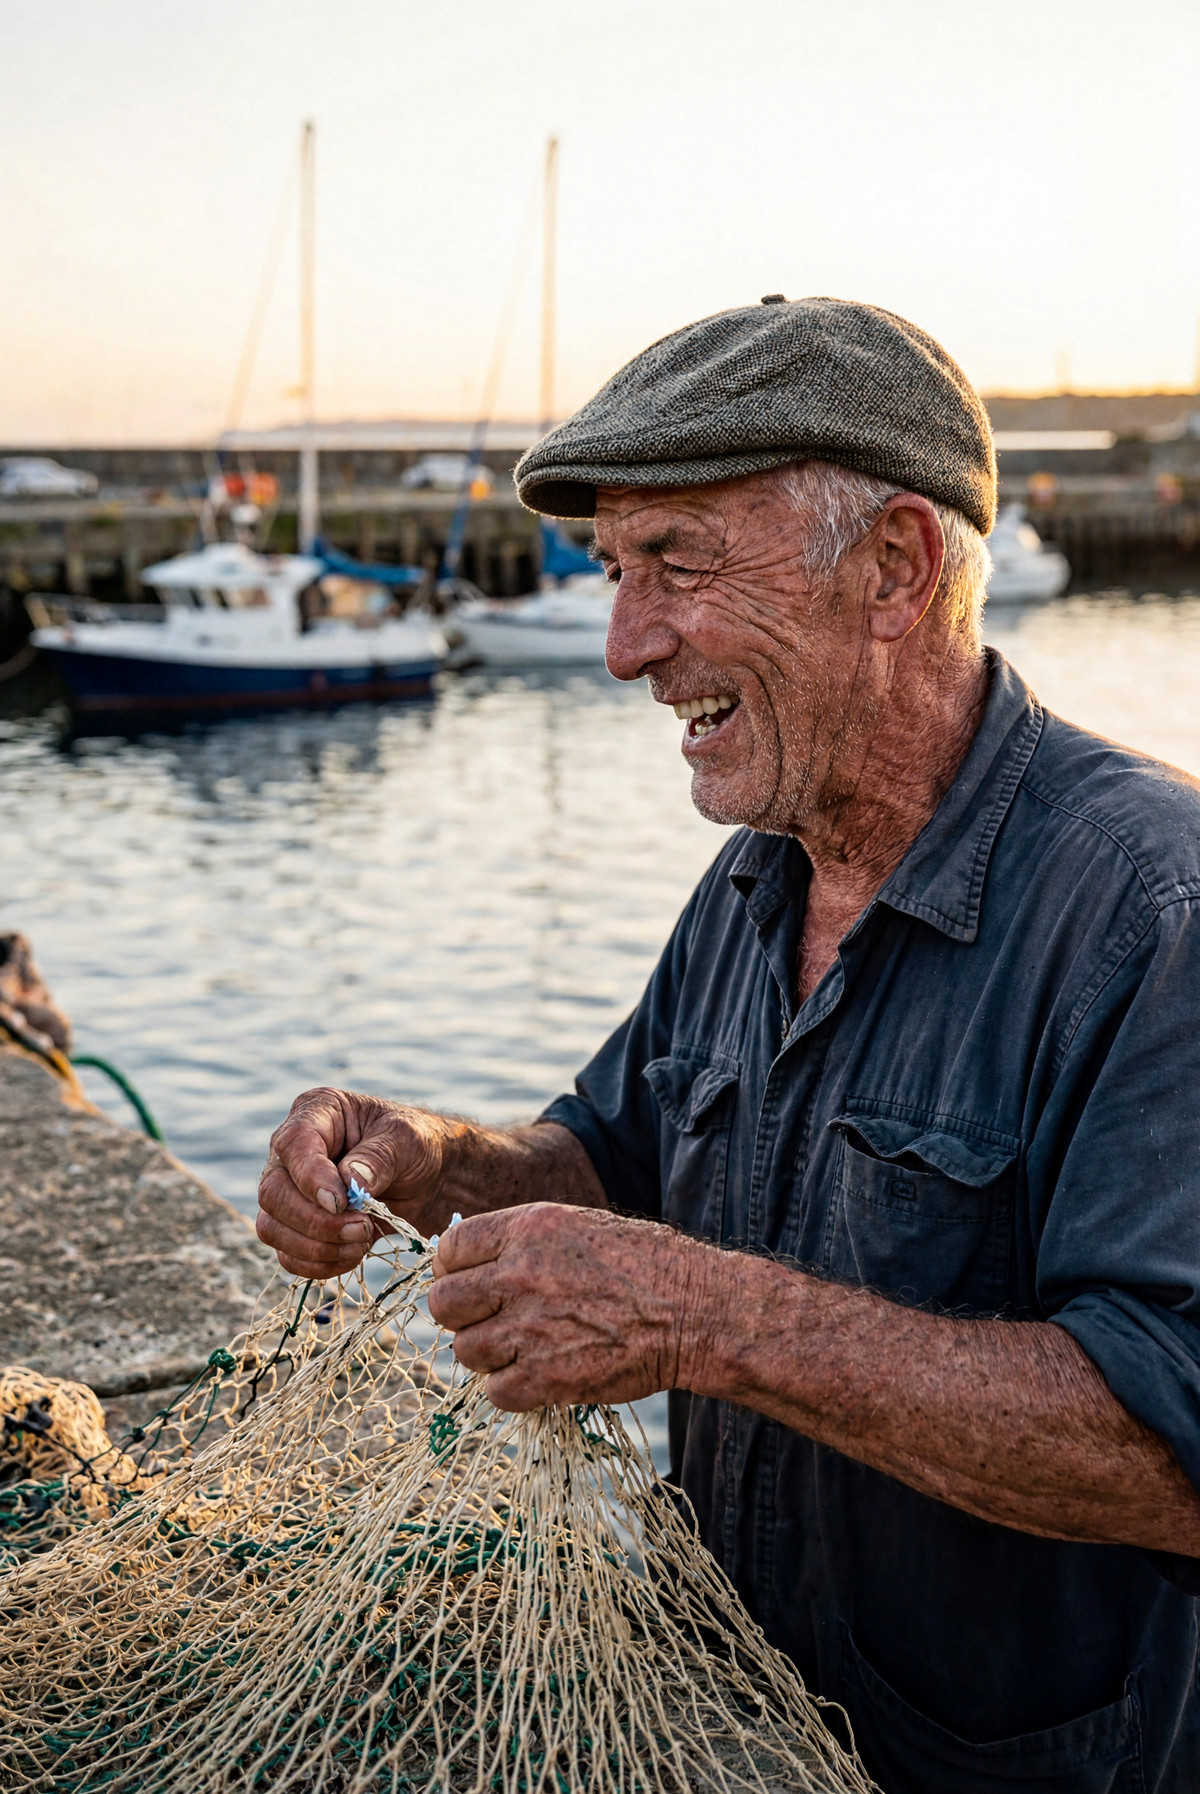
Nouvelle version texte-vers-image v1.0 ajoutée à la page du workflow d'édition réaliste : utilise les mêmes modèles et la même recette d'échantillonnage, génère des photos réalistes de 16 MP uniquement via le prompt, propose deux workflows : une version avec nœuds dédiés et une version avec nœuds natifs + RES4LYF.
Illustrations
Raisons de la recommandation
- Mise à jour de version : auparavant uniquement l'édition, maintenant la génération texte-vers-image est ajoutée ; utilise l'astuce de l'image vide de Kijai pour maintenir H3 Image dans un mode de référence plus propre, l'auteur affirme que sans condition d'image, la sortie est grossière et trop nette
- L'auteur explique la recette : H3 Image est distillé sur une grille de bruit fixe de 6 étapes, les premières étapes utilisent Euler standard pour définir la composition, les deux dernières étapes passent à un échantillonnage d'ordre deux avec un nouveau bruit pour produire les pores et les cheveux
- Chaque image d'exemple intègre le workflow, peut être glissée directement dans ComfyUI ; 7 visibles, l'auteur liste également les cas d'échec
Comment l'utiliser
- La version avec nœuds nécessite comfyui-h3-sampler 1.1 ou plus récent (faites un git pull dans son répertoire si déjà installé) ; l'autre version utilise uniquement les nœuds natifs et RES4LYF
- Conservez la première et la dernière phrase du modèle de prompt, décrivez au milieu le personnage, l'action, les vêtements, la scène et la lumière ; maintenez la résolution à 16 MP
Risques et limitations
- L'auteur ne l'a testé que sur une RTX PRO 6000 (96 Go), les exigences en VRAM sont élevées
- L'auteur affirme que les mains, les objets tenus et le texte peuvent présenter des fantômes ou des déformations, il faut générer plusieurs images pour vérifier
- 1 exemples de niveau sensible sont masqués ; comfyui-h3-sampler est sous licence GPL-3.0
【A】Simple Txt2Img avec Aperçu — Workflow H3 Image · v1.0plus
Workflow · Mise à jour de version · Auteur spacejumper2021824 · Publié le 11-17 15:19 · Téléchargements 18
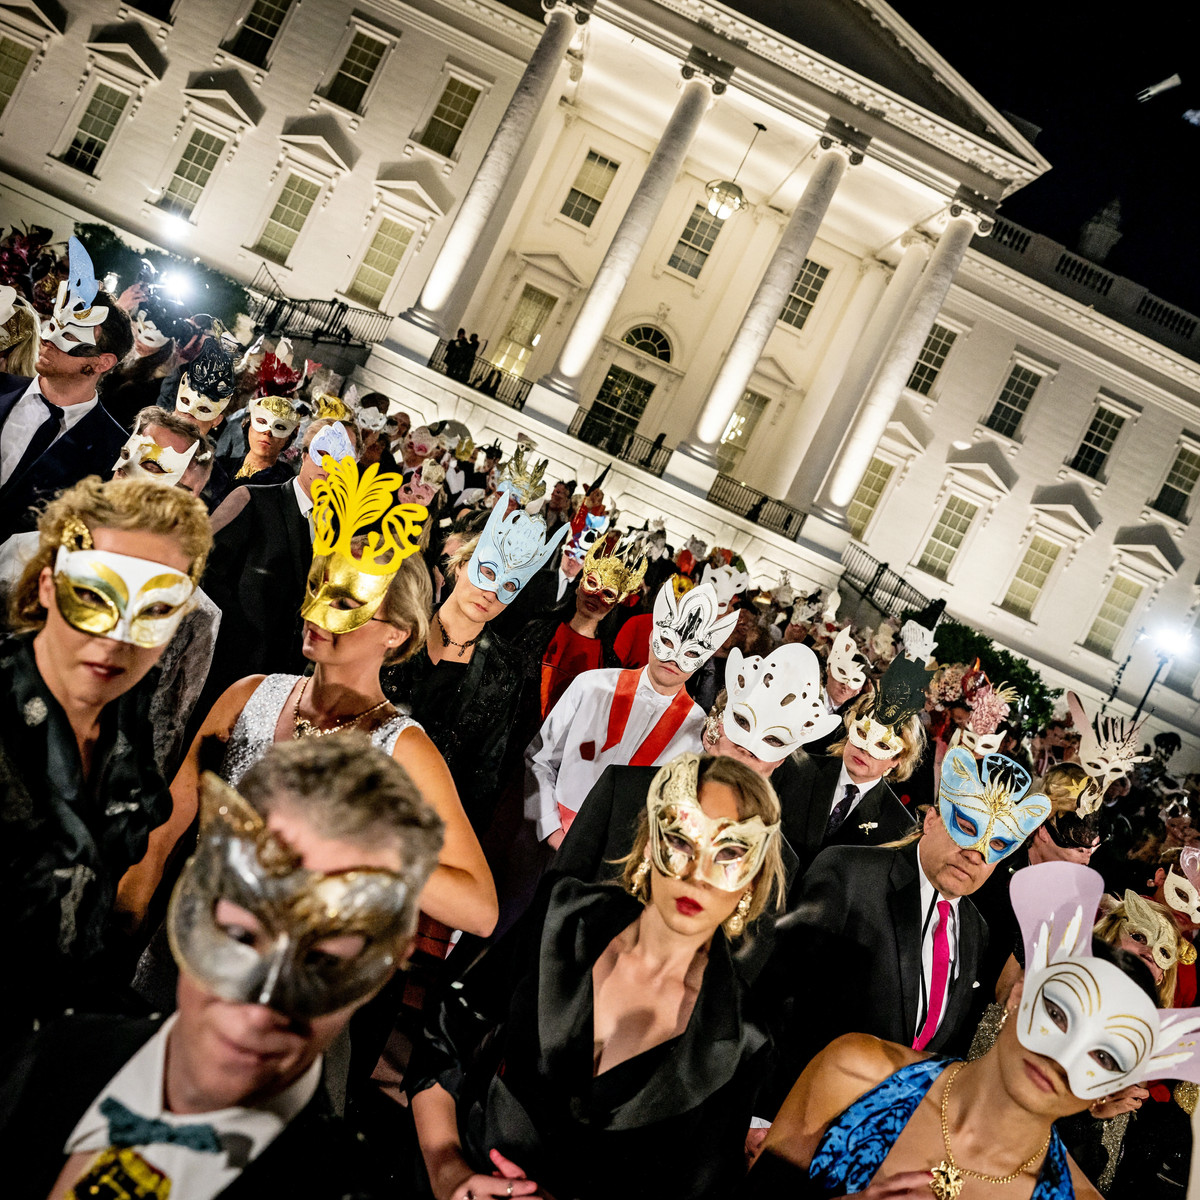
Workflow simple de texte-vers-image H3 Image avec aperçu en temps réel v1.0plus : utilise un tiny VAE pour voir la progression en temps réel pendant l'échantillonnage, cette version ajoute l'amélioration des prompts et des préréglages d'échantillonnage commutables.
Illustrations
Raisons de la recommandation
- Mise à jour de version : v1.0plus = v1.0 + amélioration des prompts + préréglages d'échantillonnage, l'amélioration peut être désactivée manuellement
- Sert les scénarios de texte-vers-image où l'on veut voir la progression pendant la génération et éliminer rapidement les mauvaises images ; les modèles et nœuds personnalisés nécessaires sont tous listés
- L'auteur propose deux échantillonnages : euler/simple/6 étapes recommandé officiellement ; si la peau semble brouillée ou bruitée, passez à sa_solver/sgm_uniform/5 étapes
Comment l'utiliser
- Installez ComfyUI-KJNodes et rgthree-comfy ; placez taeh3_image.safetensors (4.96 Mo) dans models/vae_approx/, le nœud d'aperçu échouera sans lui
- Par défaut 4096×4096 (16 MP, 1:1), modifiez avec le nœud ResolutionSelector
- L'amélioration des prompts nécessite un modèle qwen3.5_9b supplémentaire, désactivez-la si non nécessaire
Risques et limitations
- 2 exemples de niveau sensible sont masqués, seuls 2 exemples visibles
- Les nœuds et modèles dépendants doivent être vérifiés manuellement, cet outil n'a pas été exécuté
À suivre (1)
【B】Radiance Chrome Voluptuous · MiniMax-H3-Image
LoRA · Portage · Auteur AIImageStudio · Publié le 11-17 12:18 · Téléchargements 9 · Payant
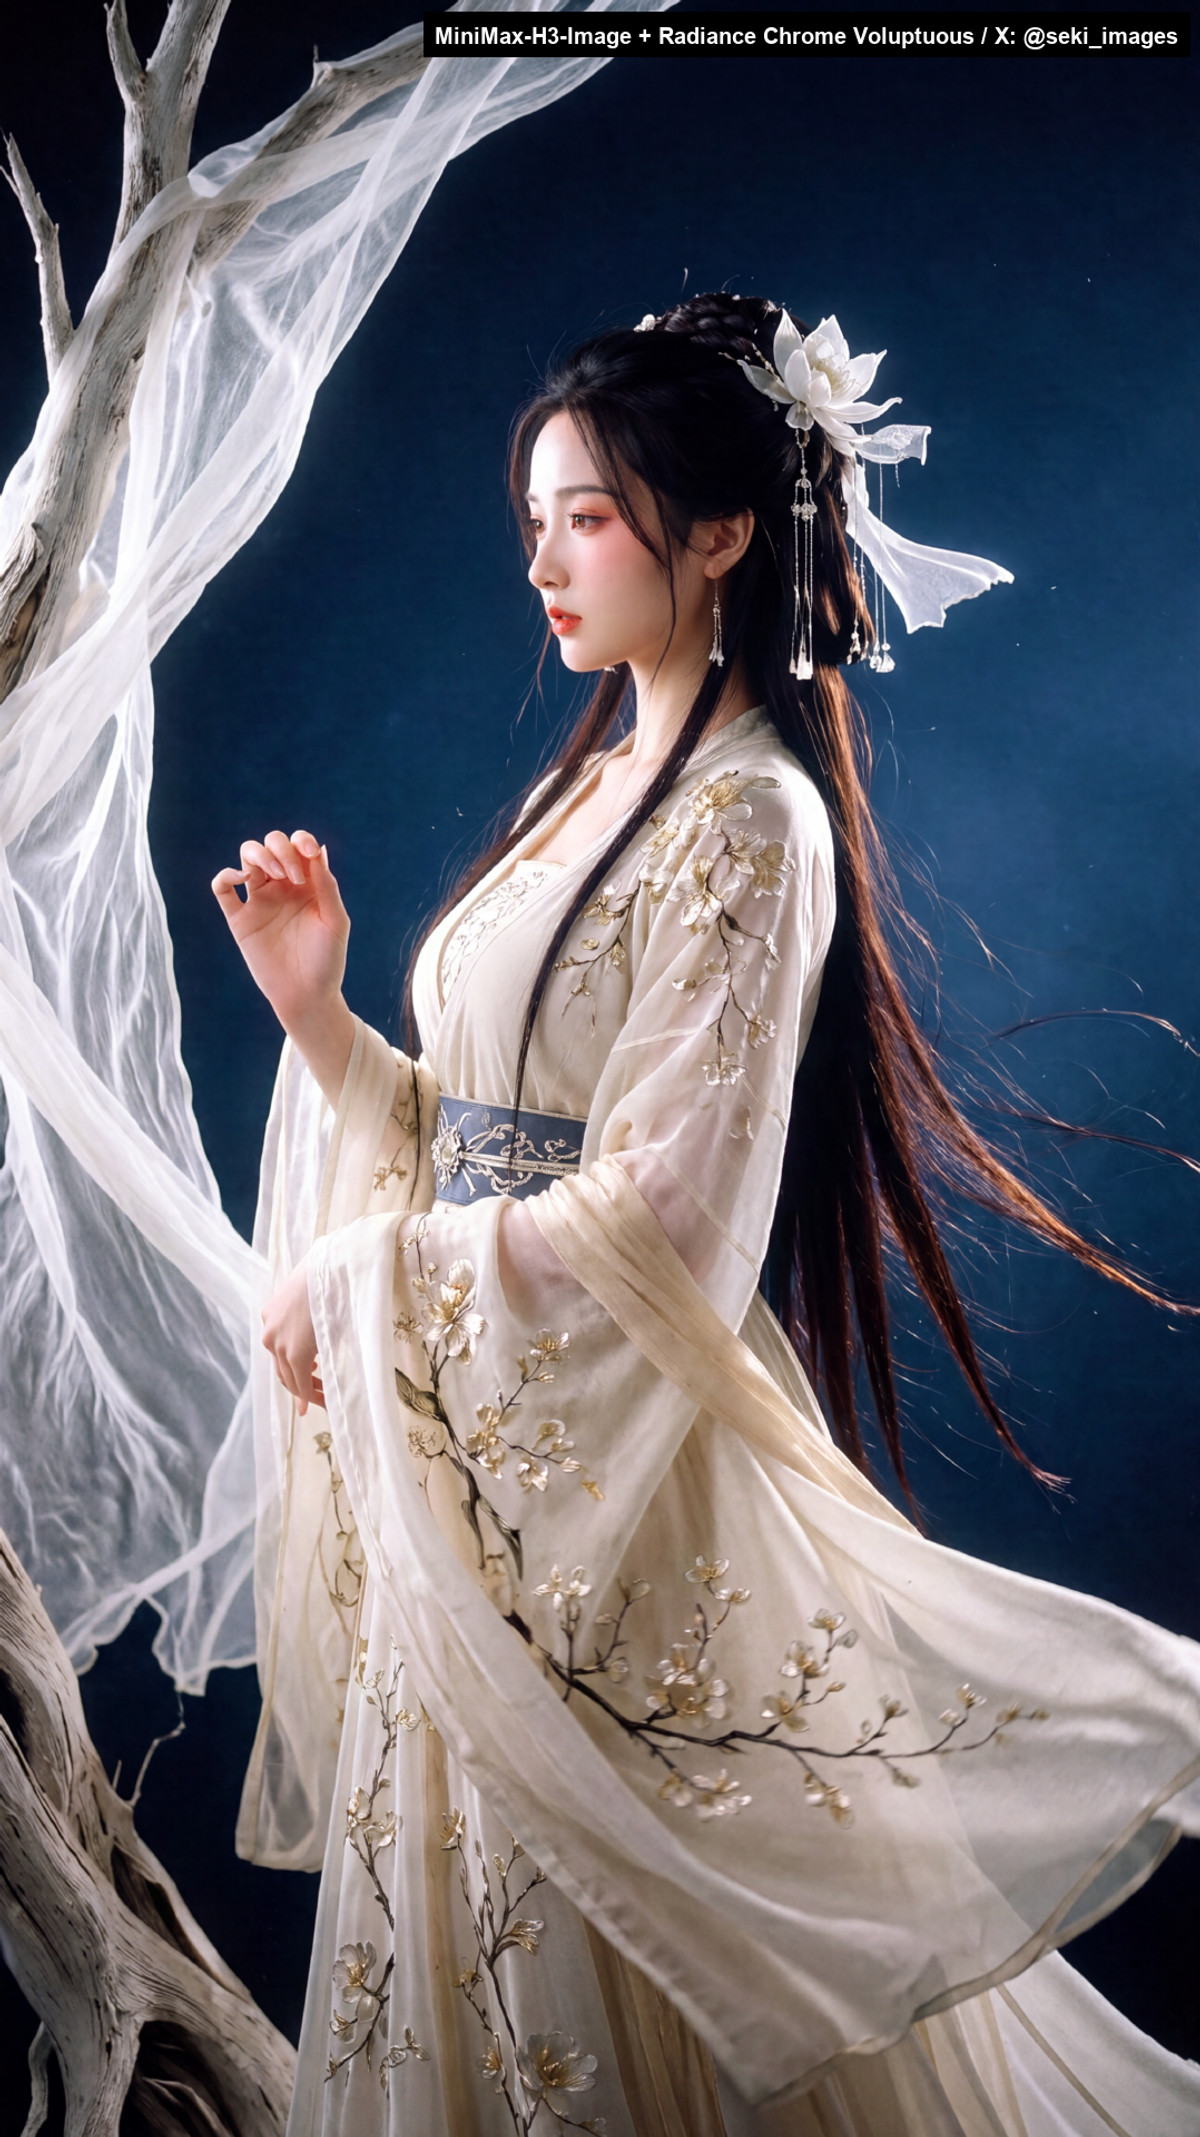
Version portée pour H3 Image de Radiance Chrome Voluptuous : style à fort contraste et haute saturation avec une texture de film inversé / diapositive, renforce la lumière du soleil et les jeux d'ombre, et réduit le grain et l'aliasing du modèle original.
Illustrations
Raisons de la recommandation
- Portage : la page contient déjà des versions pour plusieurs modèles de base comme MOSS, Flux.3 Klein, Qwen 2.1, Krea 2, cette version est explicitement indiquée par l'auteur comme destinée au modèle texte-vers-image H3 Image, et non au modèle vidéo H3
- Les paramètres sont fournis : échantillonneur, plage d'intensité, astuce de conditionnement avec image vide et recommandations de résolution
- Payant, et l'auteur précise lui-même que la préférence pour la morphologie corporelle est forte, la diversité doit être compensée par les prompts
Comment l'utiliser
- Échantillonneur euler_simple (l'auteur affirme que c'est celui utilisé pour l'entraînement) ; intensité 1.0–1.25 ; aucun mot-clé de déclenchement nécessaire
- L'auteur recommande fortement de connecter une image blanche vide (9:16 suffit avec 512 × 910) au nœud MiniMax H3 Image Conditioning pour réduire la grossièreté ; générez en 16 MP puis réduisez
Risques et limitations
- Téléchargement payant (paiement permanent)
- 15 exemples de niveau sensible sont masqués, 5 exemples visibles
- L'auteur précise que la préférence stylistique est très forte, la diversité des morphologies corporelles est difficile
Inclus uniquement (2)
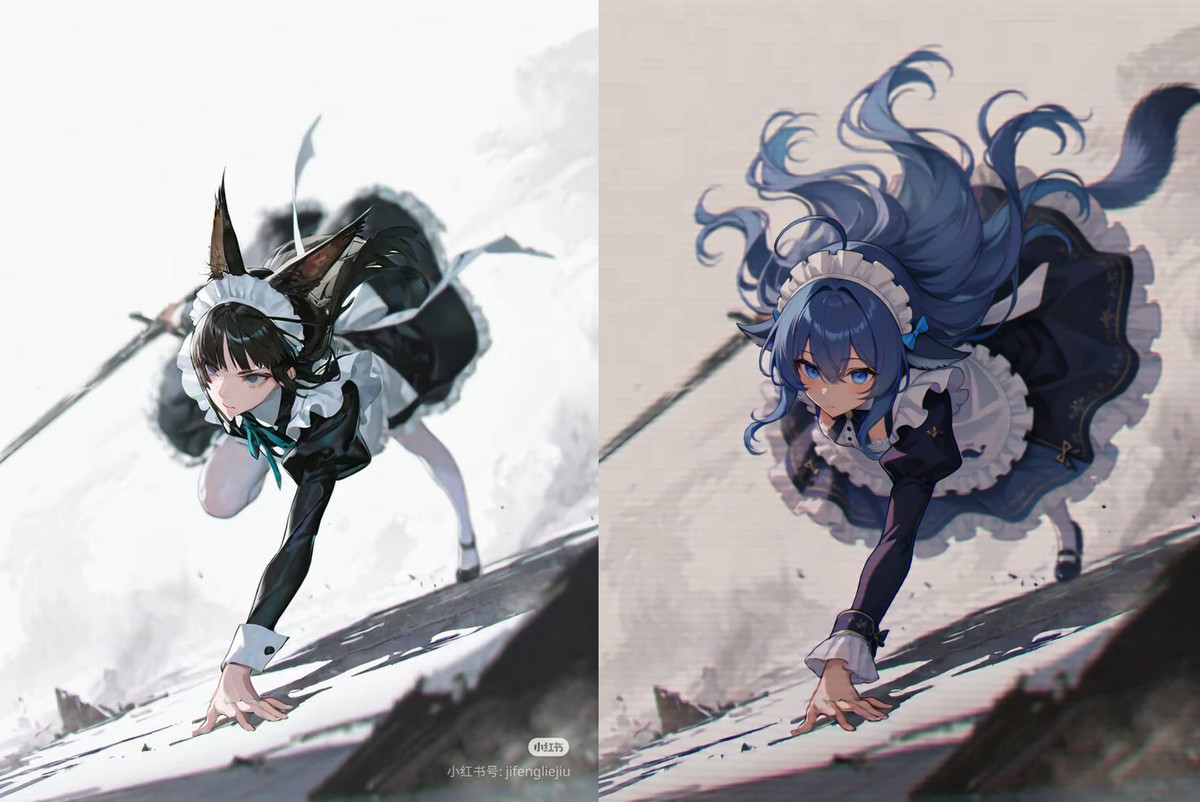
- Le modèle vidéo Minimax H3 a réalisé ce qu'aucun autre modèle d'édition d'image n'a pu faire · v1.0 — Workflow : workflow d'édition d'image utilisant le modèle vidéo H3, l'auteur affirme que les modifications à grand angle réussissent souvent, presque du premier coup.
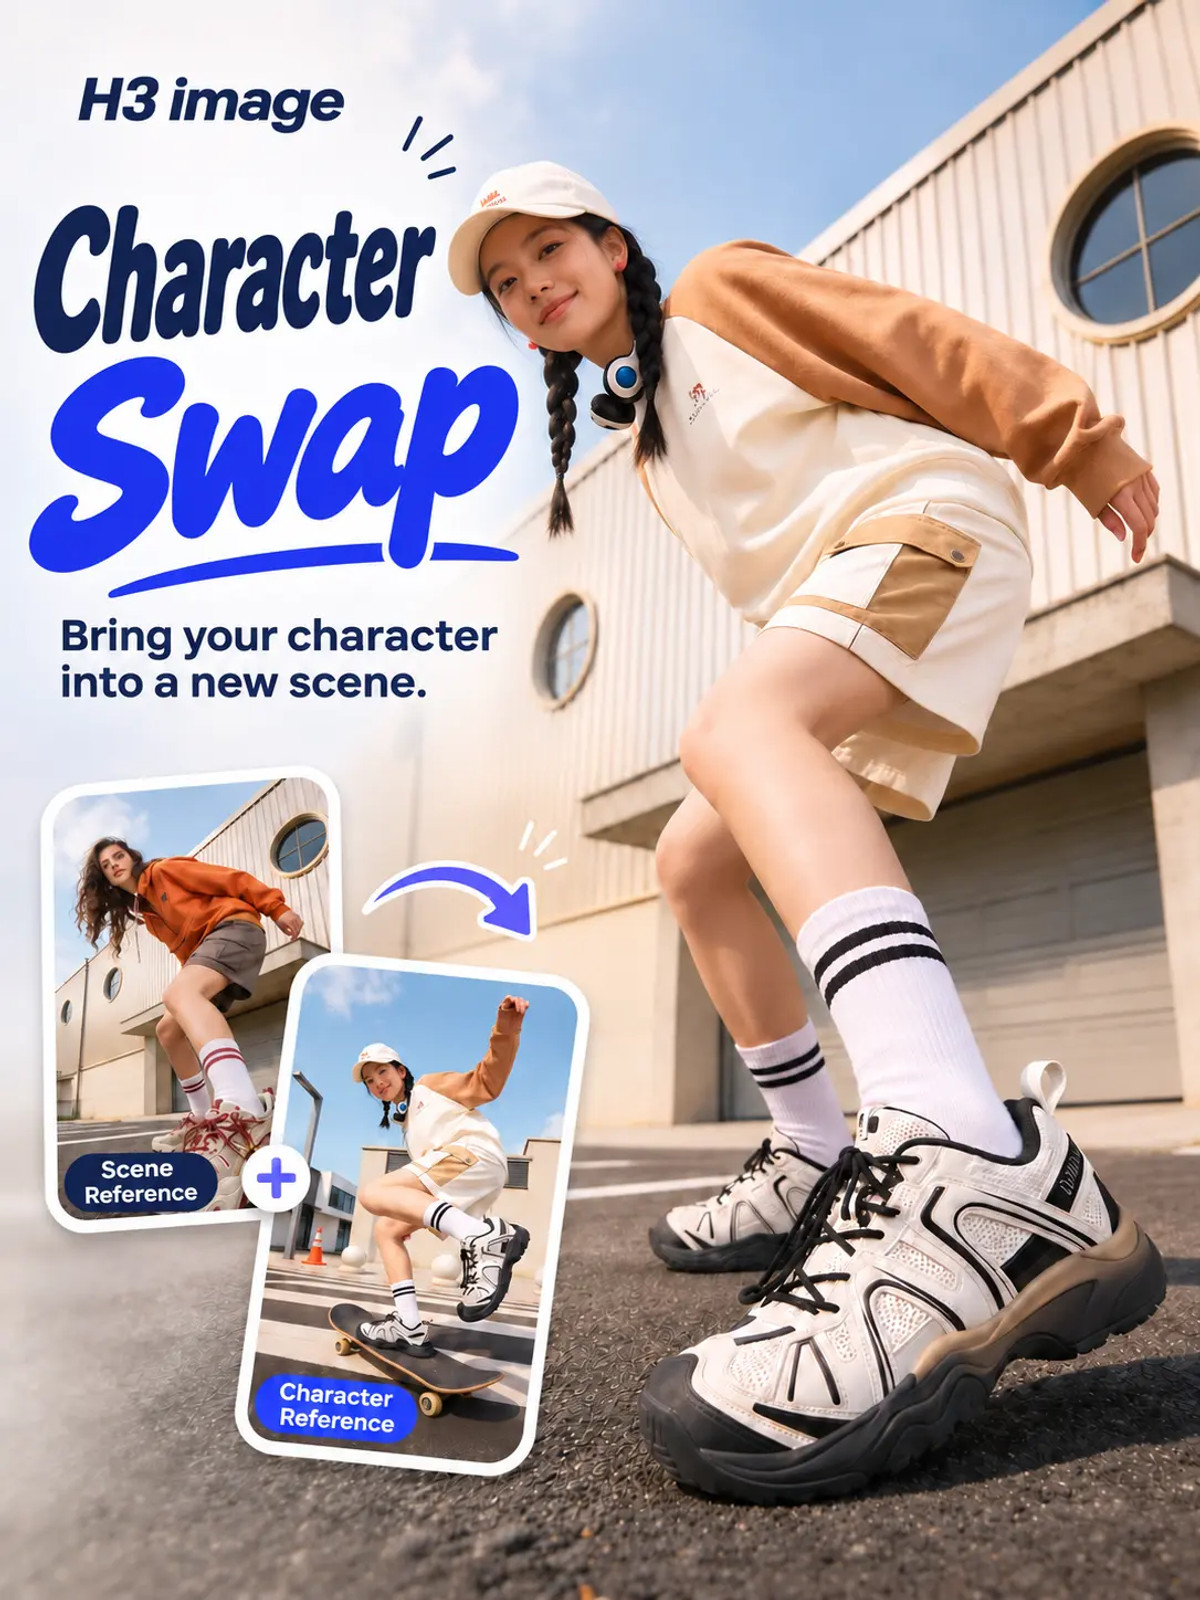
- Échange de Personnage-H3 image · v1.0 — Workflow : workflow de transfert de personnage H3 Image : remplace le visage et les caractéristiques corporelles du personnage de l'image de référence sur l'image cible, en s'adaptant au nouveau fond, à la pose et à la lumière.
Données : API publique Civitai (modèle de base MiniMax H3), fenêtre d'inclusion du 11-17 08:31 au 11-17 21:01 (heure de Pékin). Les raisons de recommandation ont été revues par l'éditeur ; le nombre de téléchargements reflète uniquement l'attention portée.