Radar AI của Trinh Trinh · MiniMax H3 Image · Bản tin buổi tối 2026-11-17
Kỳ này có 6 phiên bản mới: Rất khuyến nghị 1 · Khuyến nghị 2 · Đáng theo dõi 1 · Chỉ ghi nhận 2
Lời bình của biên tập viên Kỳ này đã xem xét 6 phiên bản mới của H3 Image, gồm 1 xếp hạng S, 2 xếp hạng A, 1 xếp hạng B và 2 xếp hạng C, tất cả đều là workflow và 1 LoRA được chuyển đổi. Ưu tiên giới thiệu workflow tích hợp H3 Image của YJ LAB: kết hợp tạo ảnh từ văn bản và chỉnh sửa ảnh trong cùng một giao diện, độ phân giải 4–16 MP, 6 bước, tích hợp sẵn tính năng mở rộng prompt và tăng cường chi tiết SeedVR2. Phiên bản tạo ảnh từ văn bản mới của workflow chỉnh sửa ảnh thực tế sử dụng kỹ thuật ảnh trống của Kijai để đưa H3 Image vào chế độ tham chiếu sạch sẽ, tác giả chỉ thử nghiệm trên card đồ họa 96 GB; workflow tạo ảnh từ văn bản đơn giản có xem trước thời gian thực đã bổ sung tính năng tăng cường prompt và các preset lấy mẫu, cả hai đều được xếp hạng A. Phiên bản chuyển đổi LoRA màu phim trả phí với phong cách đặc trưng mạnh mẽ được xếp hạng B; workflow chỉnh sửa ảnh sử dụng mô hình video H3 và workflow chuyển đổi nhân vật có phần mô tả chỉ vài dòng, chủ yếu dẫn đến các nền tảng bên ngoài, được xếp hạng C.
Rất khuyến nghị (1)
【S】H3 Image AIO – MiniMax H3 chuyển văn bản thành ảnh + chỉnh sửa ảnh, 4–16 MP, 6 bước · v1.01
Workflow · Mô hình mới · Tác giả 1113800942188 · Phát hành 11-17 10:25 · Lượt tải 62
Workflow ComfyUI tích hợp H3 Image: kết hợp tạo ảnh từ văn bản và chỉnh sửa ảnh trong cùng một giao diện, preset độ phân giải 4–16 MP, xuất ảnh sau 6 bước, tích hợp sẵn tính năng mở rộng prompt và tăng cường chi tiết SeedVR2.
Hình minh họa
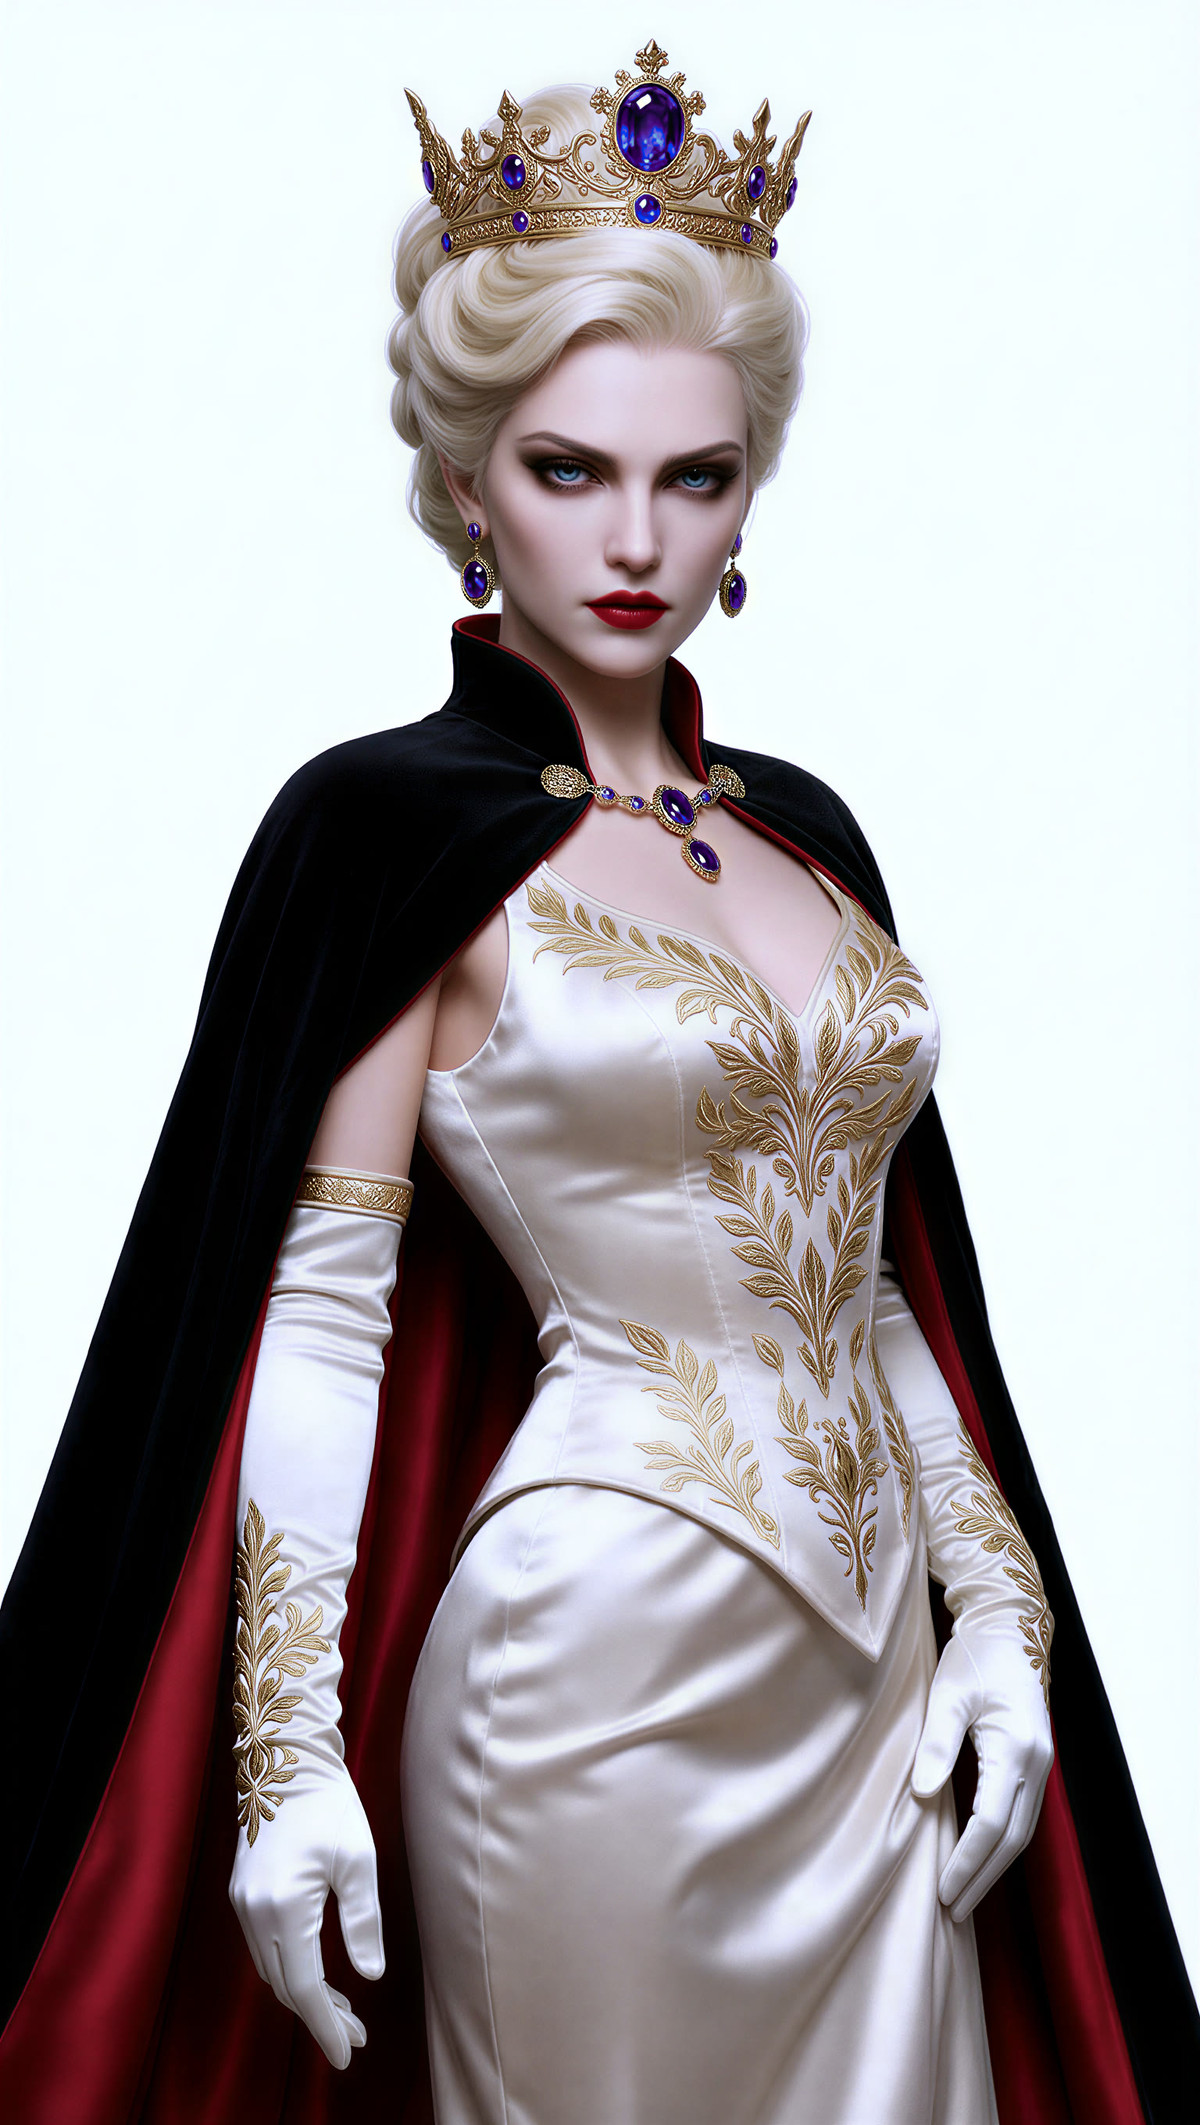
Lý do khuyến nghị
- Phục vụ hai loại tác vụ: tạo ảnh thuần túy từ văn bản và chỉnh sửa ảnh với tối đa 6 ảnh tham chiếu (hình ảnh hoặc video); nếu tắt toàn bộ đầu vào, đây sẽ là quy trình tạo ảnh từ văn bản thuần túy
- Tác giả đã ghi rõ cách thiết lập từng công tắc: giữ nguyên các sigmas 6 bước đã được cấu hình trong workflow, không thay đổi hai mẫu hệ thống mở rộng prompt, và tắt tính năng mở rộng để tăng tốc độ nếu đã có prompt hoàn chỉnh
- Kèm theo 4 bộ prompt mẫu (nhân vật vẽ chì màu, ảnh thiết kế nhân vật, trang phục tiên hiệp, poster có chữ), toàn bộ 5 hình ảnh minh họa đều hiển thị và miễn phí
Cách sử dụng
- Preset độ phân giải 4–16 MP, giữ nguyên các sigmas 6 bước không thay đổi
- Tác giả cho biết LoRA chỉnh sửa mang lại cải thiện lớn nhất, có thể bật ngay cả ở chế độ không chỉnh sửa, phong cách hơi thiên về phương Đông
- Giữ bật tính năng phóng to SeedVR2, đặt hệ số là 1, chỉ tăng cường chi tiết mà không phóng to kích thước ảnh
- Các từ khóa kích hoạt và danh từ riêng được viết trong các ô dành sẵn, tính năng mở rộng sẽ không viết lại chúng; tác giả có video hướng dẫn trong tập thứ 6 trên kênh YouTube YJ LAB
Rủi ro và hạn chế
- Danh sách các node và mô hình phụ thuộc không được liệt kê đầy đủ trong thẻ mô hình, cần tự kiểm tra, công cụ này chưa được chạy thử nghiệm
- Không ghi rõ LoRA chỉnh sửa là phiên bản nào và tải mô hình từ đâu
Khuyến nghị (2)
【A】MiniMax H3 Image: Workflow Chỉnh sửa Thực tế + Tạo ảnh từ Văn bản (16 MP, ComfyUI) · Tạo ảnh từ văn bản v1.0
Workflow · Cập nhật phiên bản · Tác giả voidhunter77 · Phát hành 11-17 11:31 · Lượt tải 55
Phiên bản tạo ảnh từ văn bản v1.0 mới được thêm vào trang workflow chỉnh sửa ảnh thực tế: sử dụng cùng bộ mô hình và công thức lấy mẫu, chỉ dựa vào prompt để xuất ảnh chụp thực tế độ phân giải 16 MP, cung cấp hai workflow gồm phiên bản node chuyên dụng và phiên bản node gốc + RES4LYF.
Hình minh họa
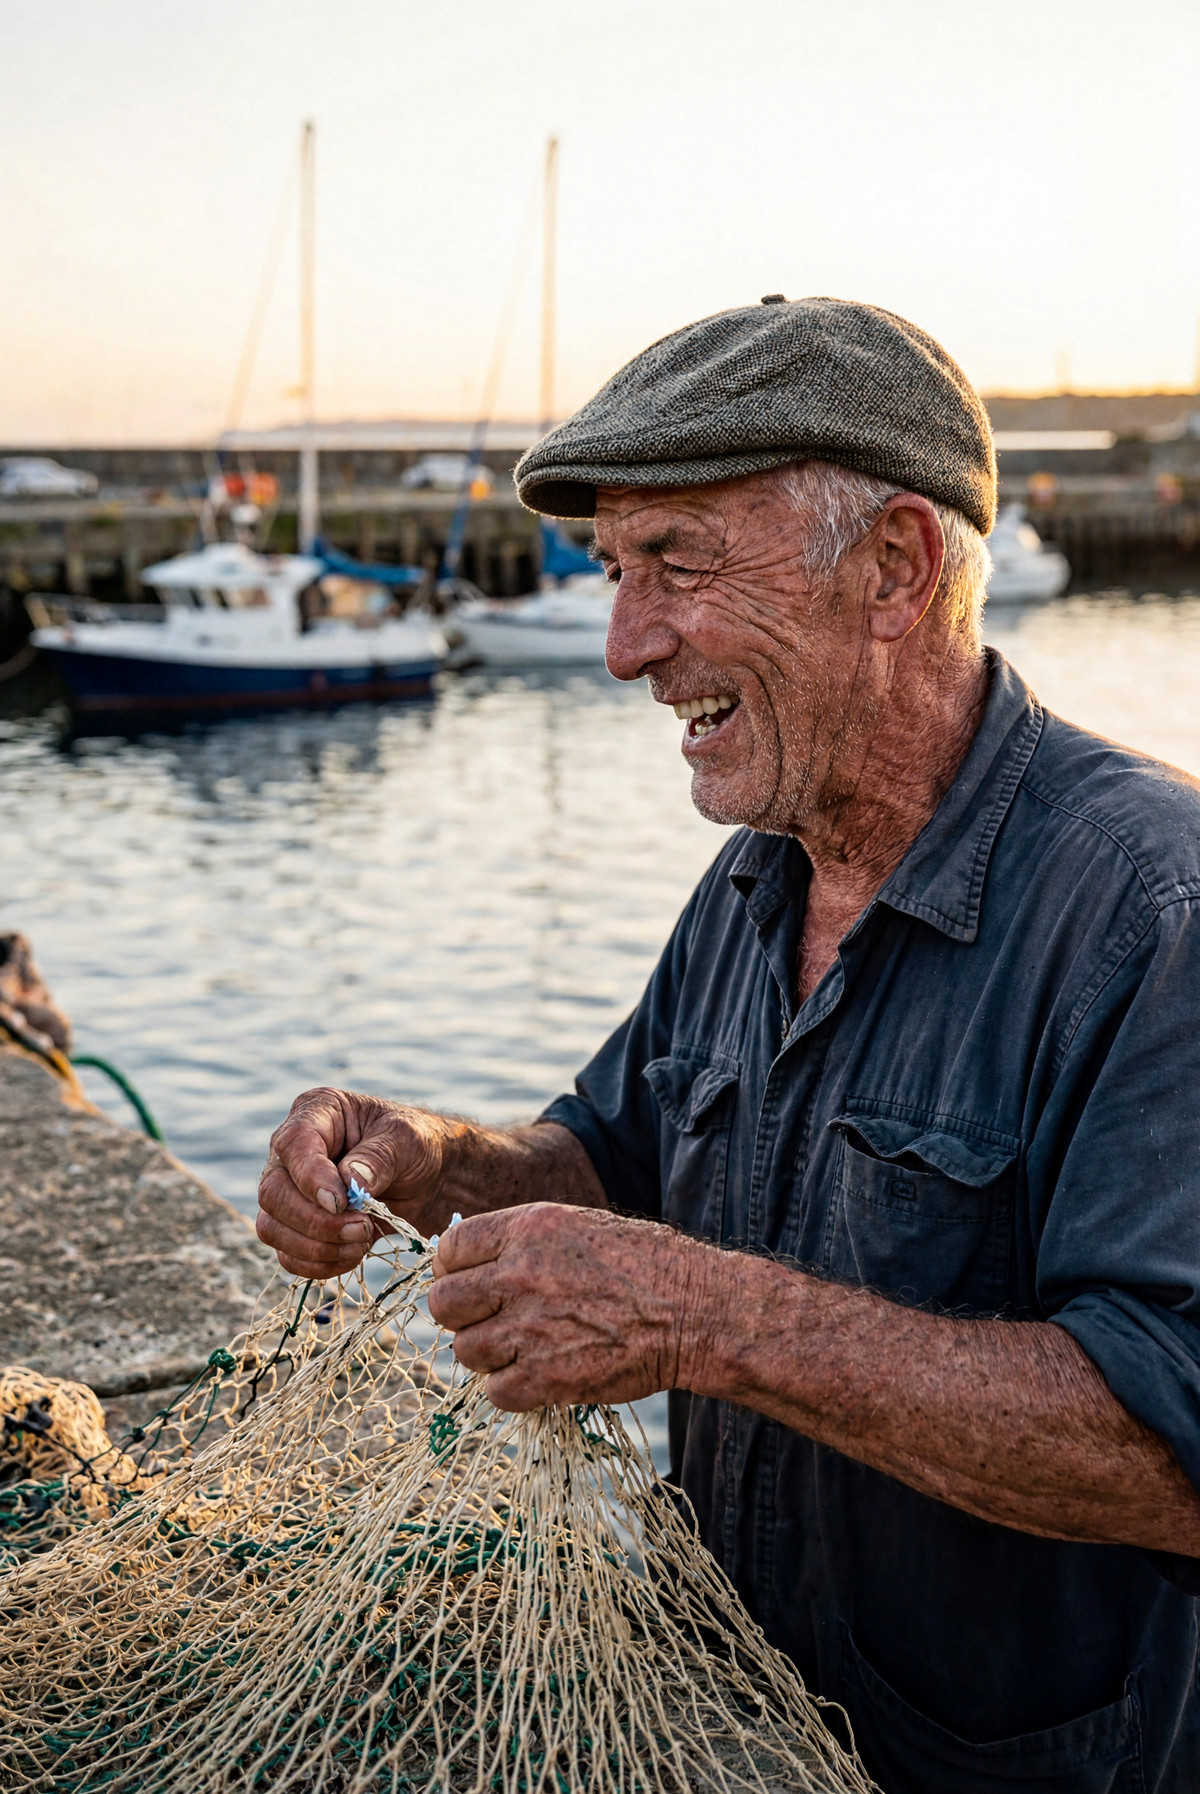
Lý do khuyến nghị
- Cập nhật phiên bản: trước đây chỉ có chỉnh sửa ảnh, nay đã bổ sung tạo ảnh từ văn bản thuần túy; sử dụng kỹ thuật ảnh trống của Kijai để giữ H3 Image ở chế độ tham chiếu sạch sẽ hơn, tác giả cho biết nếu không có điều kiện hình ảnh, ảnh xuất ra sẽ thô và quá sắc nét
- Tác giả giải thích công thức: H3 Image được chưng cất theo lưới nhiễu cố định 6 bước, các bước đầu tiên sử dụng Euler thông thường để xác định bố cục, hai bước cuối cùng chuyển sang lấy mẫu bậc hai cộng thêm nhiễu mới để tạo ra lỗ chân lông và sợi tóc
- Mỗi hình ảnh minh họa đều nhúng sẵn workflow, có thể kéo trực tiếp vào ComfyUI; 7 hình ảnh hiển thị được, tác giả cũng liệt kê các trường hợp thất bại
Cách sử dụng
- Phiên bản node yêu cầu comfyui-h3-sampler phiên bản 1.1 trở lên (nếu đã cài đặt, hãy chạy git pull trong thư mục của nó); phiên bản còn lại chỉ sử dụng các node gốc và RES4LYF
- Giữ nguyên câu đầu tiên và câu cuối cùng của mẫu prompt, phần giữa mô tả nhân vật, hành động, trang phục, bối cảnh và ánh sáng; giữ độ phân giải ở mức 16 MP
Rủi ro và hạn chế
- Tác giả chỉ thử nghiệm trên RTX PRO 6000 (96 GB), yêu cầu VRAM cao
- Tác giả cho biết bàn tay, vật cầm trên tay và chữ viết có thể bị bóng ma hoặc biến dạng, cần xuất nhiều ảnh để kiểm tra
- 1 hình ảnh minh họa cấp độ nhạy cảm đã bị ẩn; comfyui-h3-sampler được cấp phép theo GPL-3.0
【A】Simple Txt2Img with Preview — Workflow H3 Image · v1.0plus
Workflow · Cập nhật phiên bản · Tác giả spacejumper2021824 · Phát hành 11-17 15:19 · Lượt tải 18
Workflow tạo ảnh từ văn bản đơn giản H3 Image v1.0plus có xem trước thời gian thực: sử dụng tiny VAE để xem tiến độ trong quá trình lấy mẫu, phiên bản này đã bổ sung tính năng tăng cường prompt và các preset lấy mẫu có thể chuyển đổi.
Hình minh họa
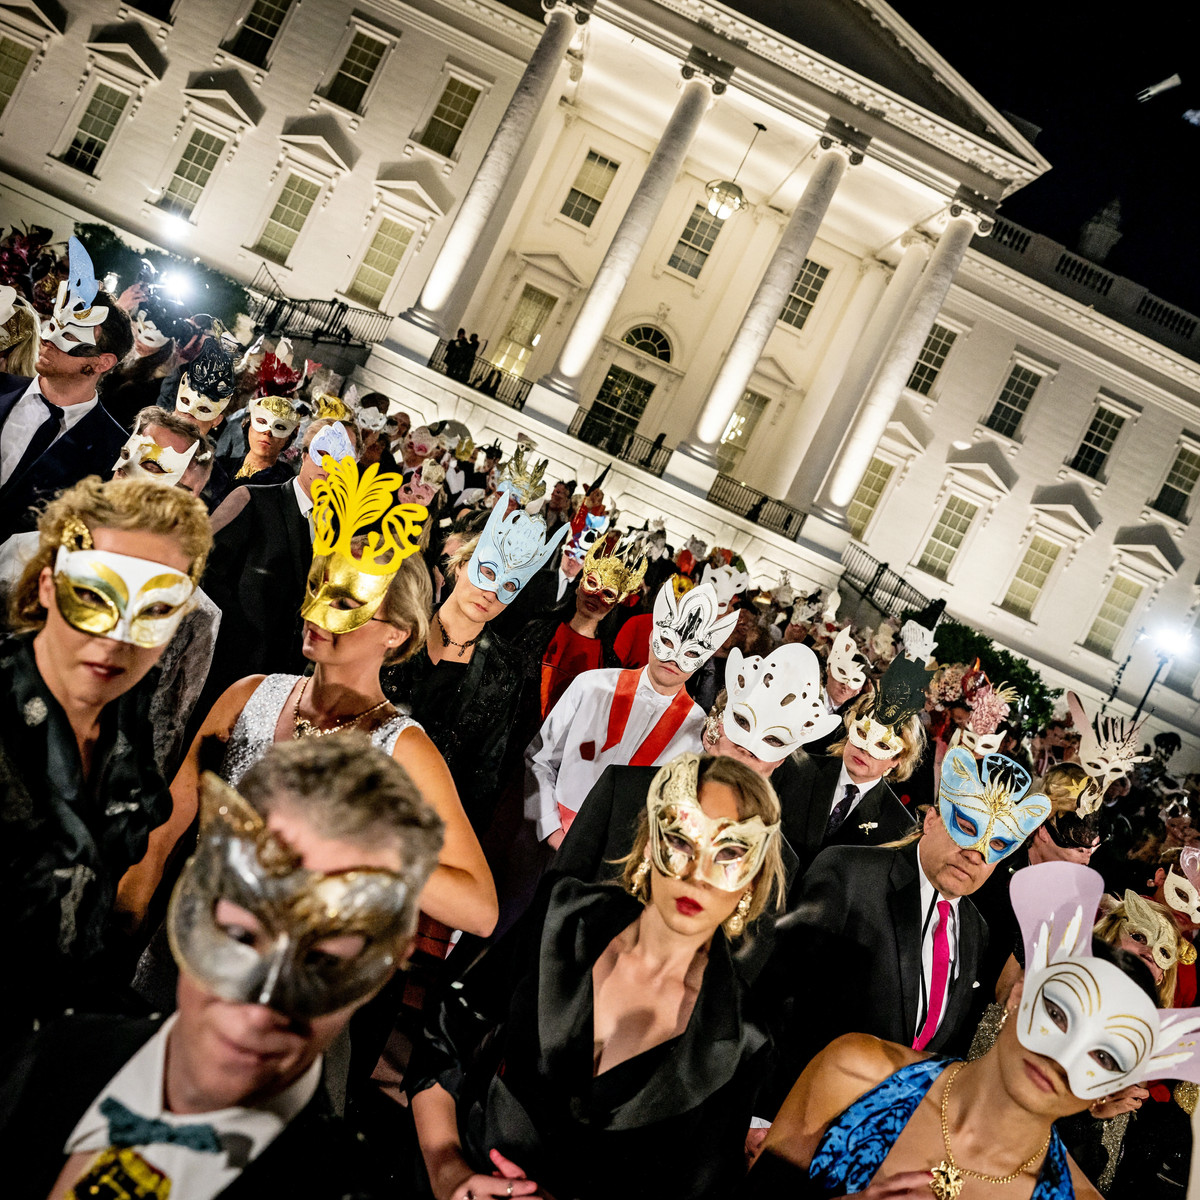
Lý do khuyến nghị
- Cập nhật phiên bản: v1.0plus = v1.0 + tăng cường prompt + tổ hợp preset lấy mẫu, tính năng tăng cường có thể tắt thủ công
- Phục vụ các kịch bản tạo ảnh từ văn bản mà người dùng muốn xem tiến độ trong khi xuất ảnh và loại bỏ sớm các ảnh lỗi; tất cả các mô hình và node tùy chỉnh cần thiết đều được liệt kê đầy đủ
- Tác giả cung cấp hai phương pháp lấy mẫu: euler/simple/6 bước theo khuyến nghị chính thức; nếu da bị mờ nhòe hoặc nhiều nhiễu, có thể chuyển sang sa_solver/sgm_uniform/5 bước
Cách sử dụng
- Cài đặt ComfyUI-KJNodes và rgthree-comfy; đặt taeh3_image.safetensors (4.96 MB) vào thư mục models/vae_approx/, node xem trước sẽ báo lỗi nếu thiếu tệp này
- Mặc định là 4096×4096 (16 MP, 1:1), sử dụng node ResolutionSelector để thay đổi
- Tính năng tăng cường prompt yêu cầu mô hình qwen3.5_9b bổ sung, có thể tắt nếu không cần thiết
Rủi ro và hạn chế
- 2 hình ảnh minh họa cấp độ nhạy cảm đã bị ẩn, chỉ có 2 hình ảnh minh họa hiển thị được
- Các node và mô hình phụ thuộc cần tự kiểm tra, công cụ này chưa được chạy thử nghiệm
Đáng theo dõi (1)
【B】Radiance Chrome Voluptuous · MiniMax-H3-Image
LoRA · Chuyển đổi · Tác giả AIImageStudio · Phát hành 11-17 12:18 · Lượt tải 9 · Trả phí
Phiên bản chuyển đổi H3 Image của Radiance Chrome Voluptuous: phong cách hình ảnh có độ tương phản cao và bão hòa màu cao với kết cấu giống phim đảo ngược / slide, tăng cường ánh nắng và hiệu ứng ánh sáng, đồng thời giảm bớt hạt và răng cưa từ mô hình gốc.
Hình minh họa
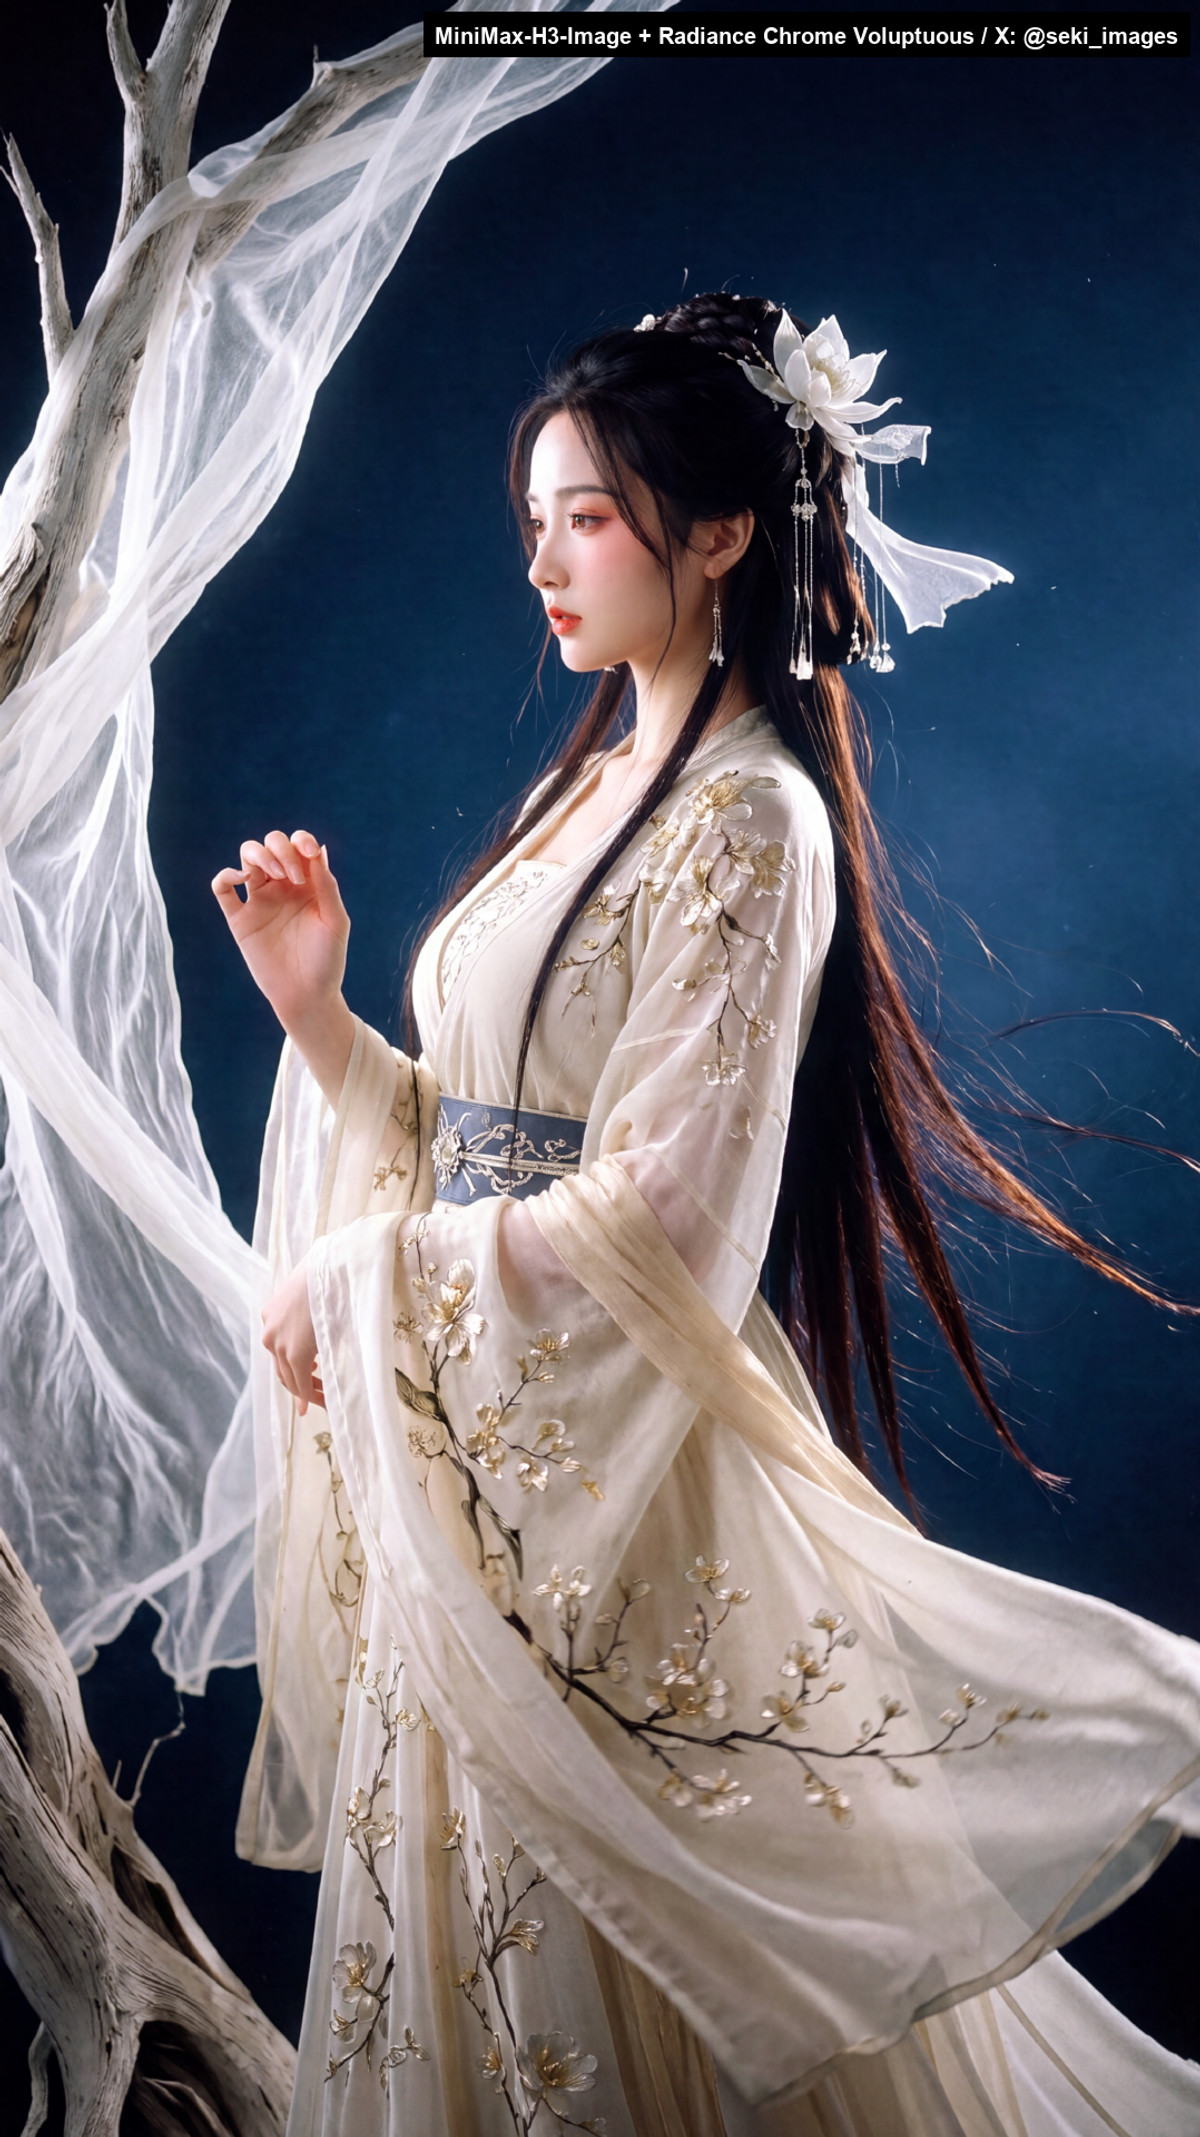
Lý do khuyến nghị
- Chuyển đổi: cùng trang đã có nhiều phiên bản cho các mô hình cơ sở như MOSS, Flux.3 Klein, Qwen 2.1, Krea 2, phiên bản này tác giả ghi rõ dành cho mô hình tạo ảnh từ văn bản H3 Image, không phải mô hình video H3
- Các tham số đã được cung cấp: bộ lấy mẫu, khoảng cường độ, kỹ thuật điều kiện ảnh trống và khuyến nghị về độ phân giải
- Trả phí, và tác giả tự ghi rõ thiên hướng về dáng người nhân vật rất mạnh, sự đa dạng phải dựa vào prompt để bổ sung
Cách sử dụng
- Bộ lấy mẫu euler_simple (tác giả cho biết đây là bộ được dùng khi huấn luyện); cường độ 1.0–1.25; không cần từ khóa kích hoạt
- Tác giả đặc biệt khuyến nghị kết nối một ảnh trắng trống (9:16 sử dụng 512 × 910 là đủ) vào node MiniMax H3 Image Conditioning để giảm độ thô ráp; xuất ảnh ở 16 MP rồi thu nhỏ lại
Rủi ro và hạn chế
- Tải xuống trả phí (trả phí vĩnh viễn)
- 15 hình ảnh minh họa cấp độ nhạy cảm đã bị ẩn, số hình ảnh hiển thị được là 5
- Tác giả ghi rõ sở thích phong cách rất mạnh mẽ, khó tạo ra sự đa dạng về dáng người nhân vật
Chỉ ghi nhận (2)
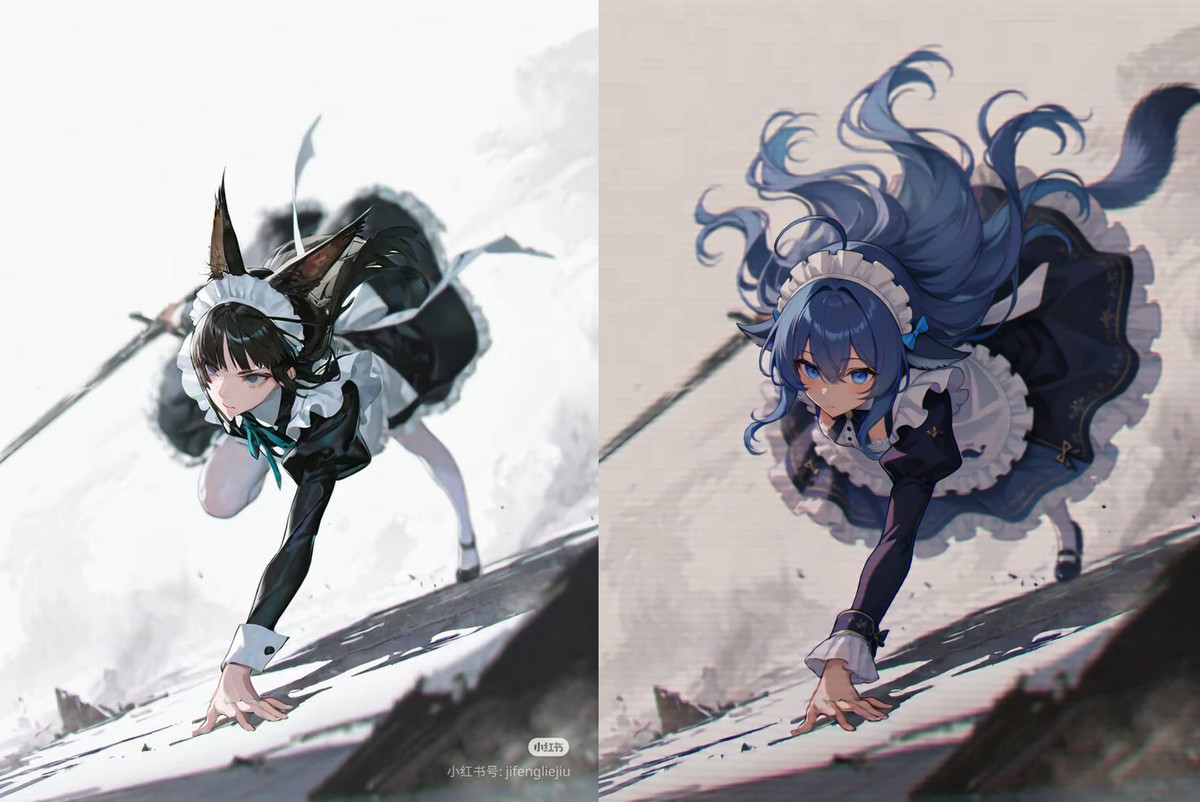
- Minimax H3 video model achieved what no other image editing model could · v1.0 — Workflow: workflow chỉnh sửa ảnh sử dụng mô hình video H3, tác giả cho biết tỷ lệ thành công khi chỉnh sửa góc độ lớn là cao, gần như đúng ngay lần đầu.
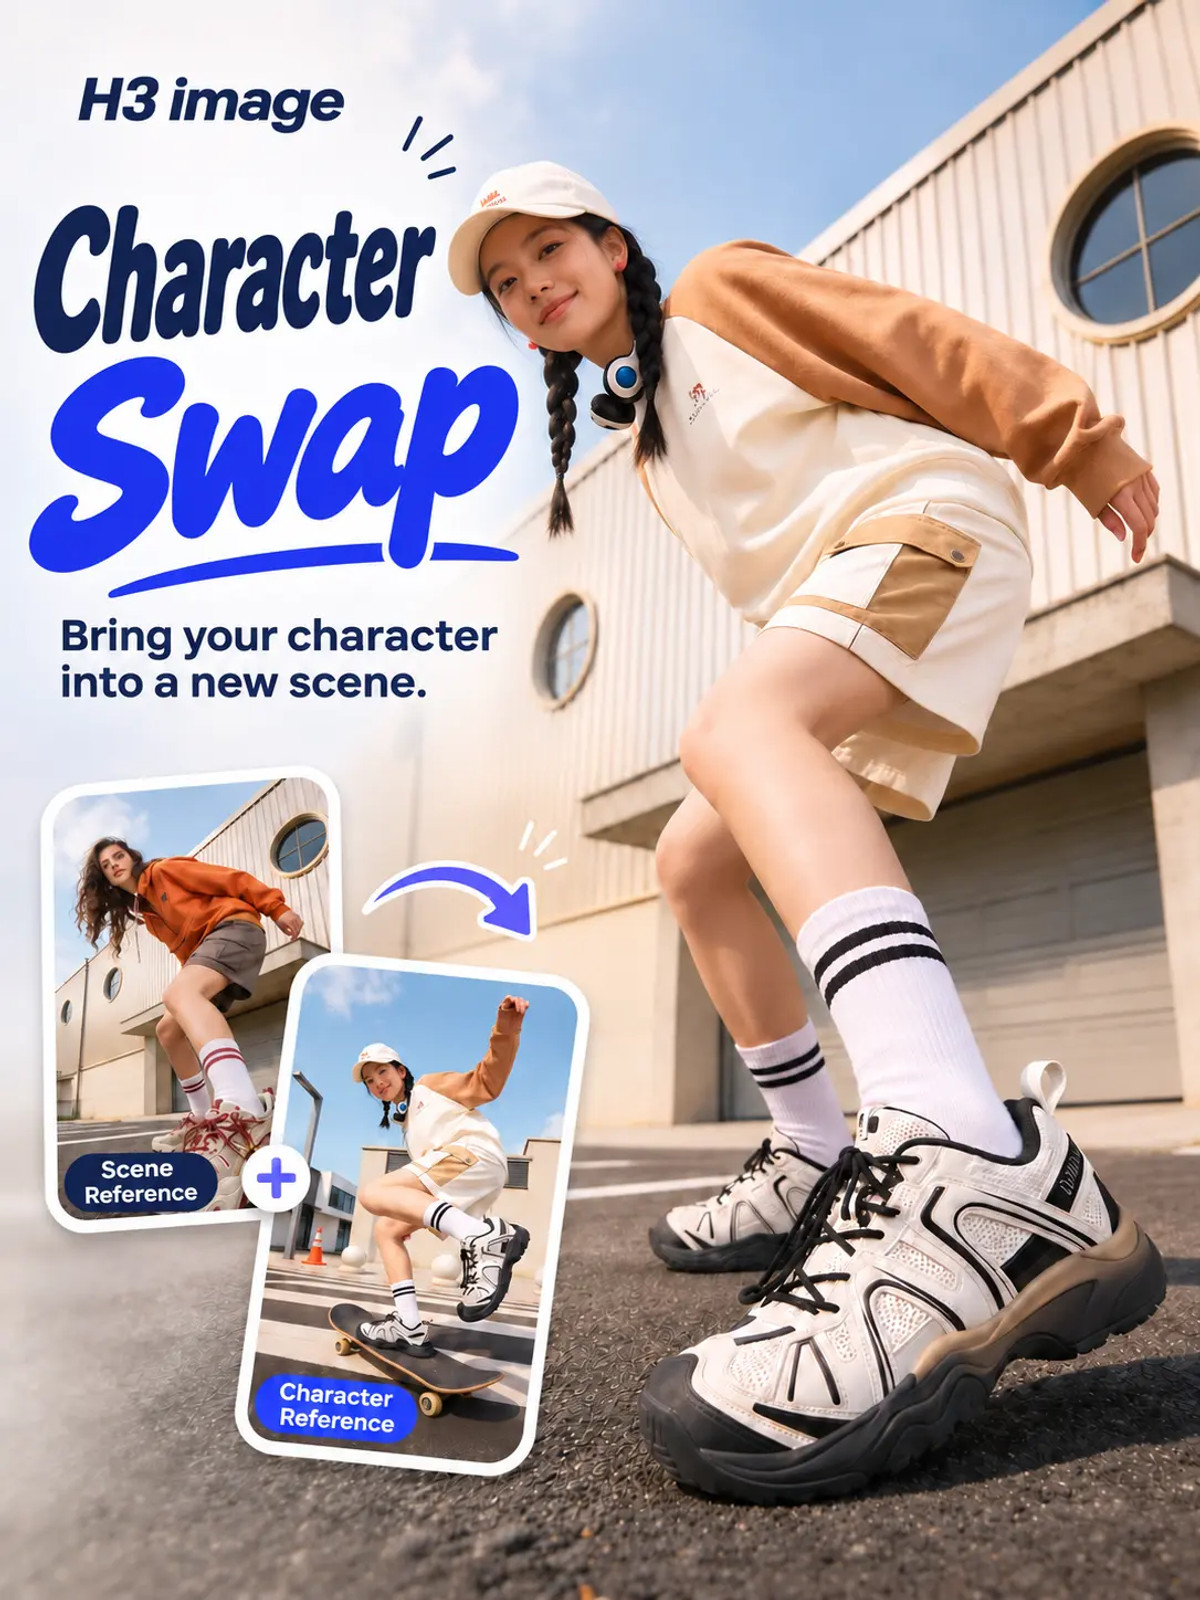
- Character Swap-H3 image · v1.0 — Workflow: workflow chuyển đổi nhân vật H3 Image: thay thế khuôn mặt và đặc điểm cơ thể của nhân vật trong ảnh tham chiếu sang khung hình mục tiêu, thích ứng với nền, tư thế và ánh sáng mới.
Dữ liệu: API công khai của Civitai (mô hình cơ sở MiniMax H3), cửa sổ ghi nhận từ 11-17 08:31 → 11-17 21:01 (giờ Bắc Kinh). Lý do khuyến nghị đã được biên tập viên xem xét; số lượt tải chỉ phản ánh mức độ quan tâm.