貞貞のAIレーダー · MiniMax H3 Image · 2026-11-17 夕刊
今号の 6 個の新バージョン:強くおすすめ 1 · おすすめ 2 · 注目すべき 1 · 収録のみ 2
編集者による按語 今号では 6 個の H3 Image 新バージョンをレビューしました。S評価が 1 個、A評価が 2 個、B評価が 1 個、C評価が 2 個で、すべてワークフローと 1 個の移植版 LoRA です。最もおすすめなのは YJ LAB の H3 Image 統合ワークフローです。テキストから画像生成と画像編集を一つのワークフローにまとめ、4–16 MP、6 ステップで、プロンプト拡張と SeedVR2 によるディテール補強を標準搭載しています。リアルな画像編集ワークフローから新たに登場したテキストから画像生成版は、Kijai の空画像テクニックを用いて H3 Image をクリーンな参照モードに導きますが、作者は 96 GB の GPU でのみテストしています。リアルタイムプレビュー付きの簡易テキストから画像生成ワークフローには、プロンプト強化とサンプリングプリセットが追加されており、これら 2 つは A 評価です。有料でスタイルの偏りが強いフィルムカラー LoRA の移植版は B 評価。H3 ビデオモデルを用いた画像編集ワークフローとキャラクター転送ワークフローは、説明が数行しかなく、主に外部プラットフォームへ誘導しているため C 評価です。
強くおすすめ(1)
【S】H3 Image AIO – MiniMax H3 text-to-image + image edit, 4–16 MP, 6 steps · v1.01
ワークフロー · 新モデル · 作者 1113800942188 · 公開 11-17 10:25 · ダウンロード 62
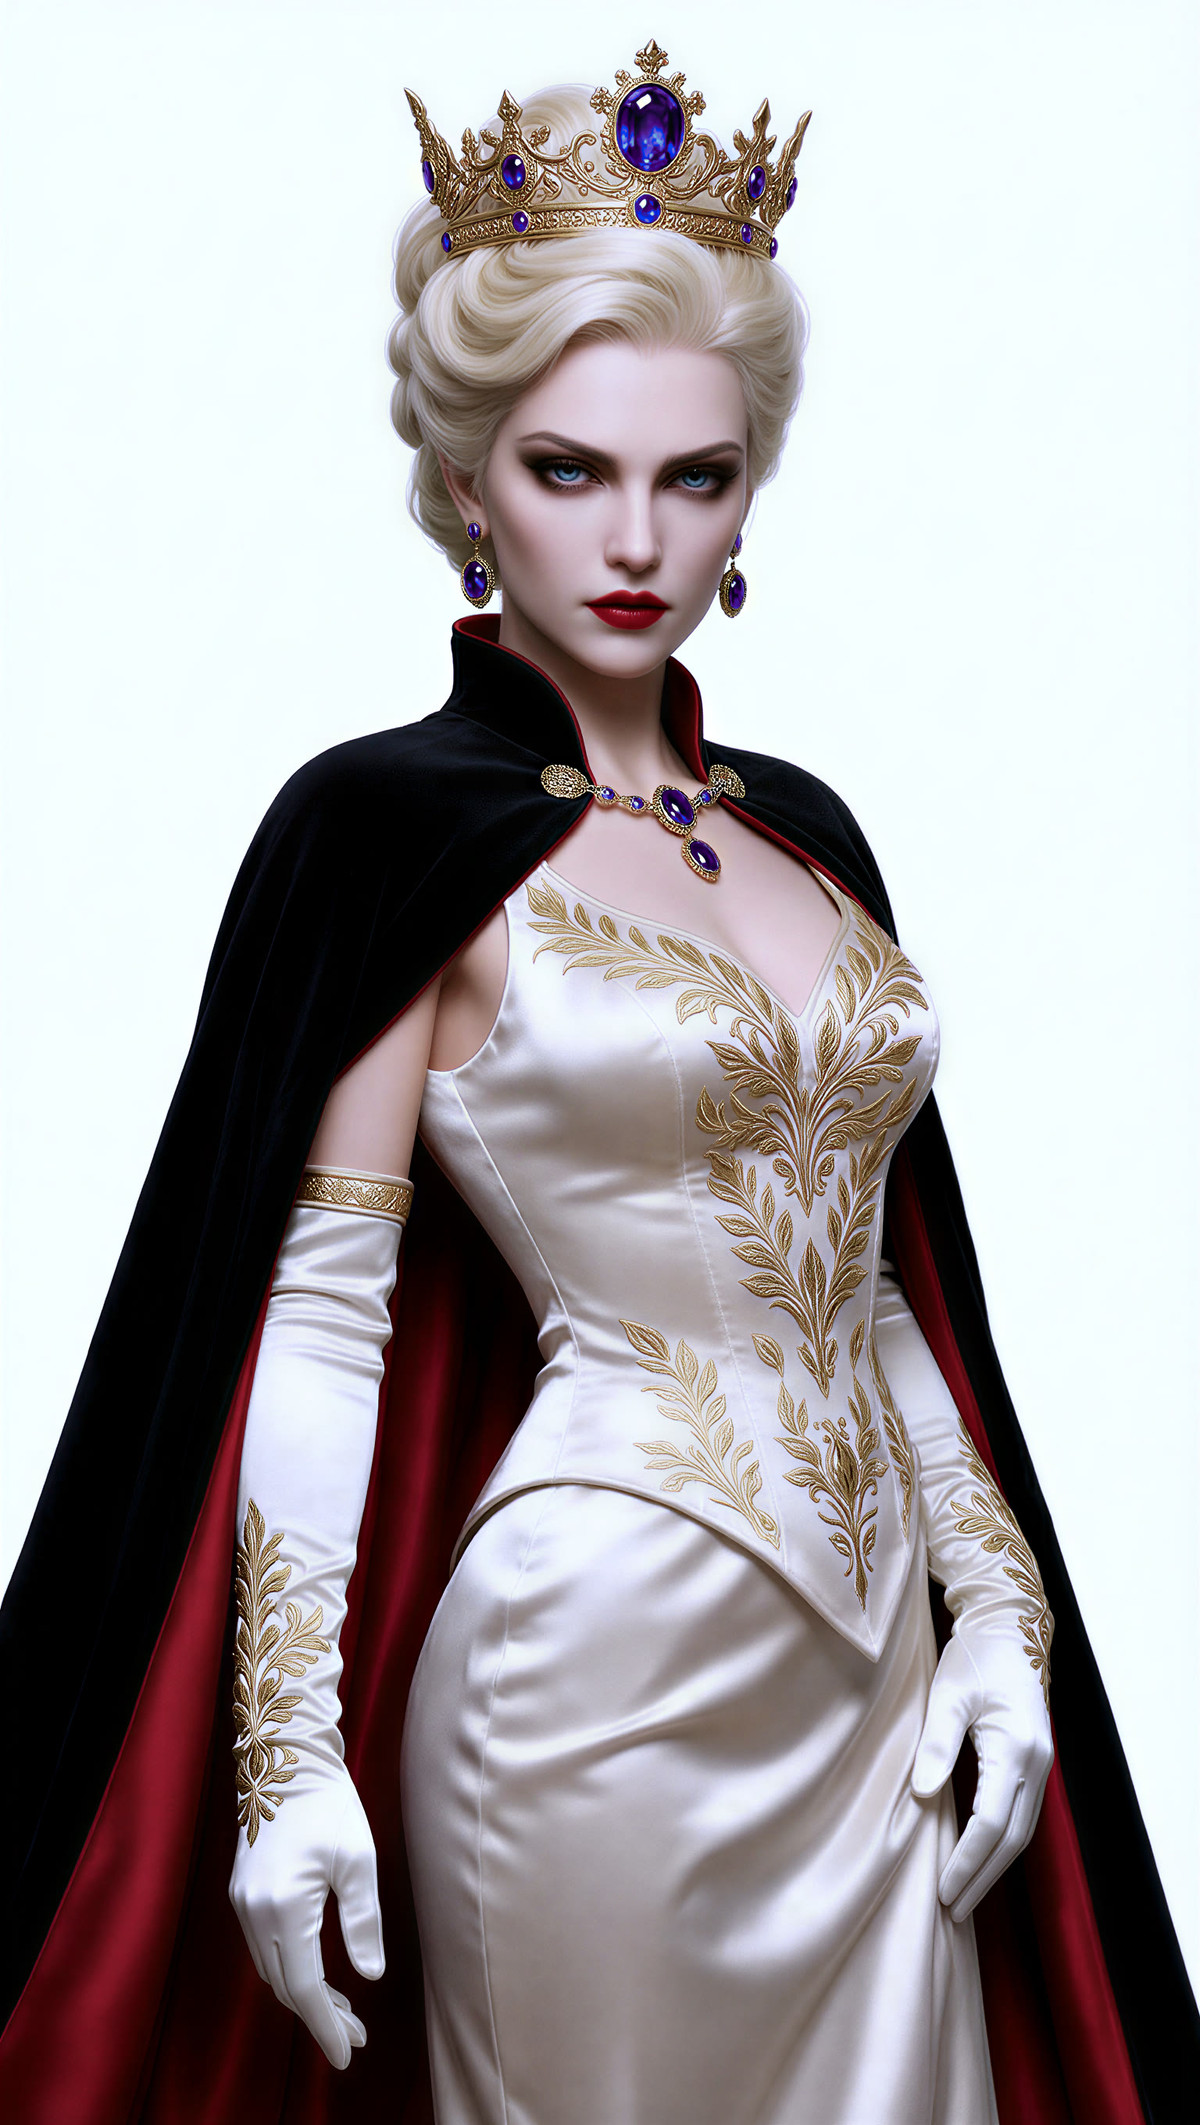
H3 Image 統合 ComfyUI ワークフロー:テキストから画像生成と画像編集を一つのワークフローにまとめ、4–16 MP の解像度プリセット、6 ステップでの出力に対応し、プロンプト拡張と SeedVR2 によるディテール補強を標準搭載しています。
サンプル画像
おすすめ理由
- 2 種類のタスクに対応:純粋なテキストからの画像生成、および最大 6 枚の参照画像(画像またはビデオ)を用いた画像編集。入力をすべてオフにすれば純粋なテキストから画像生成になります
- 作者はすべてのスイッチの設定方法を記載しています:ワークフロー内で設定済みの 6 ステップの sigmas を保持し、拡張用の 2 つのシステムテンプレートは変更せず、既存の完成したプロンプトがある場合は拡張をオフにして速度を向上させてください
- 4 種類のサンプルプロンプト(色鉛筆キャラクター、キャラクター設定画、仙侠衣装、テキスト入りポスター)と、5 枚のサンプル画像がすべて閲覧可能で、無料です
使い方
- 解像度プリセットは 4–16 MP で、6 ステップの sigmas は変更しないでください
- 編集用 LoRA は作者曰く効果が最も大きく、編集モード以外でも有効にできますが、画風がやや東洋風に寄ります
- SeedVR2 のアップスケールは有効のままにし、倍率は 1 に設定してください。ディテールの補強のみを行い、拡大はしません
- トリガーワードと固有名詞は予約済みのフィールドに記入してください。拡張機能はこれらを書き換えません。作者は YouTube チャンネル YJ LAB の第 6 回で動画解説を行っています
リスクと制限
- 依存するノードとモデルのリストがモデルカードに完全に記載されておらず、自分で確認する必要があります。本ツールでは動作確認を行っていません
- どの編集用 LoRA を使用するか、モデルのダウンロード元がモデルカードに記載されていません
おすすめ(2)
【A】MiniMax H3 Image: Realism Edit + Text to Image Workflows (16 MP, ComfyUI) · Text to image v1.0
ワークフロー · バージョン更新 · 作者 voidhunter77 · 公開 11-17 11:31 · ダウンロード 55
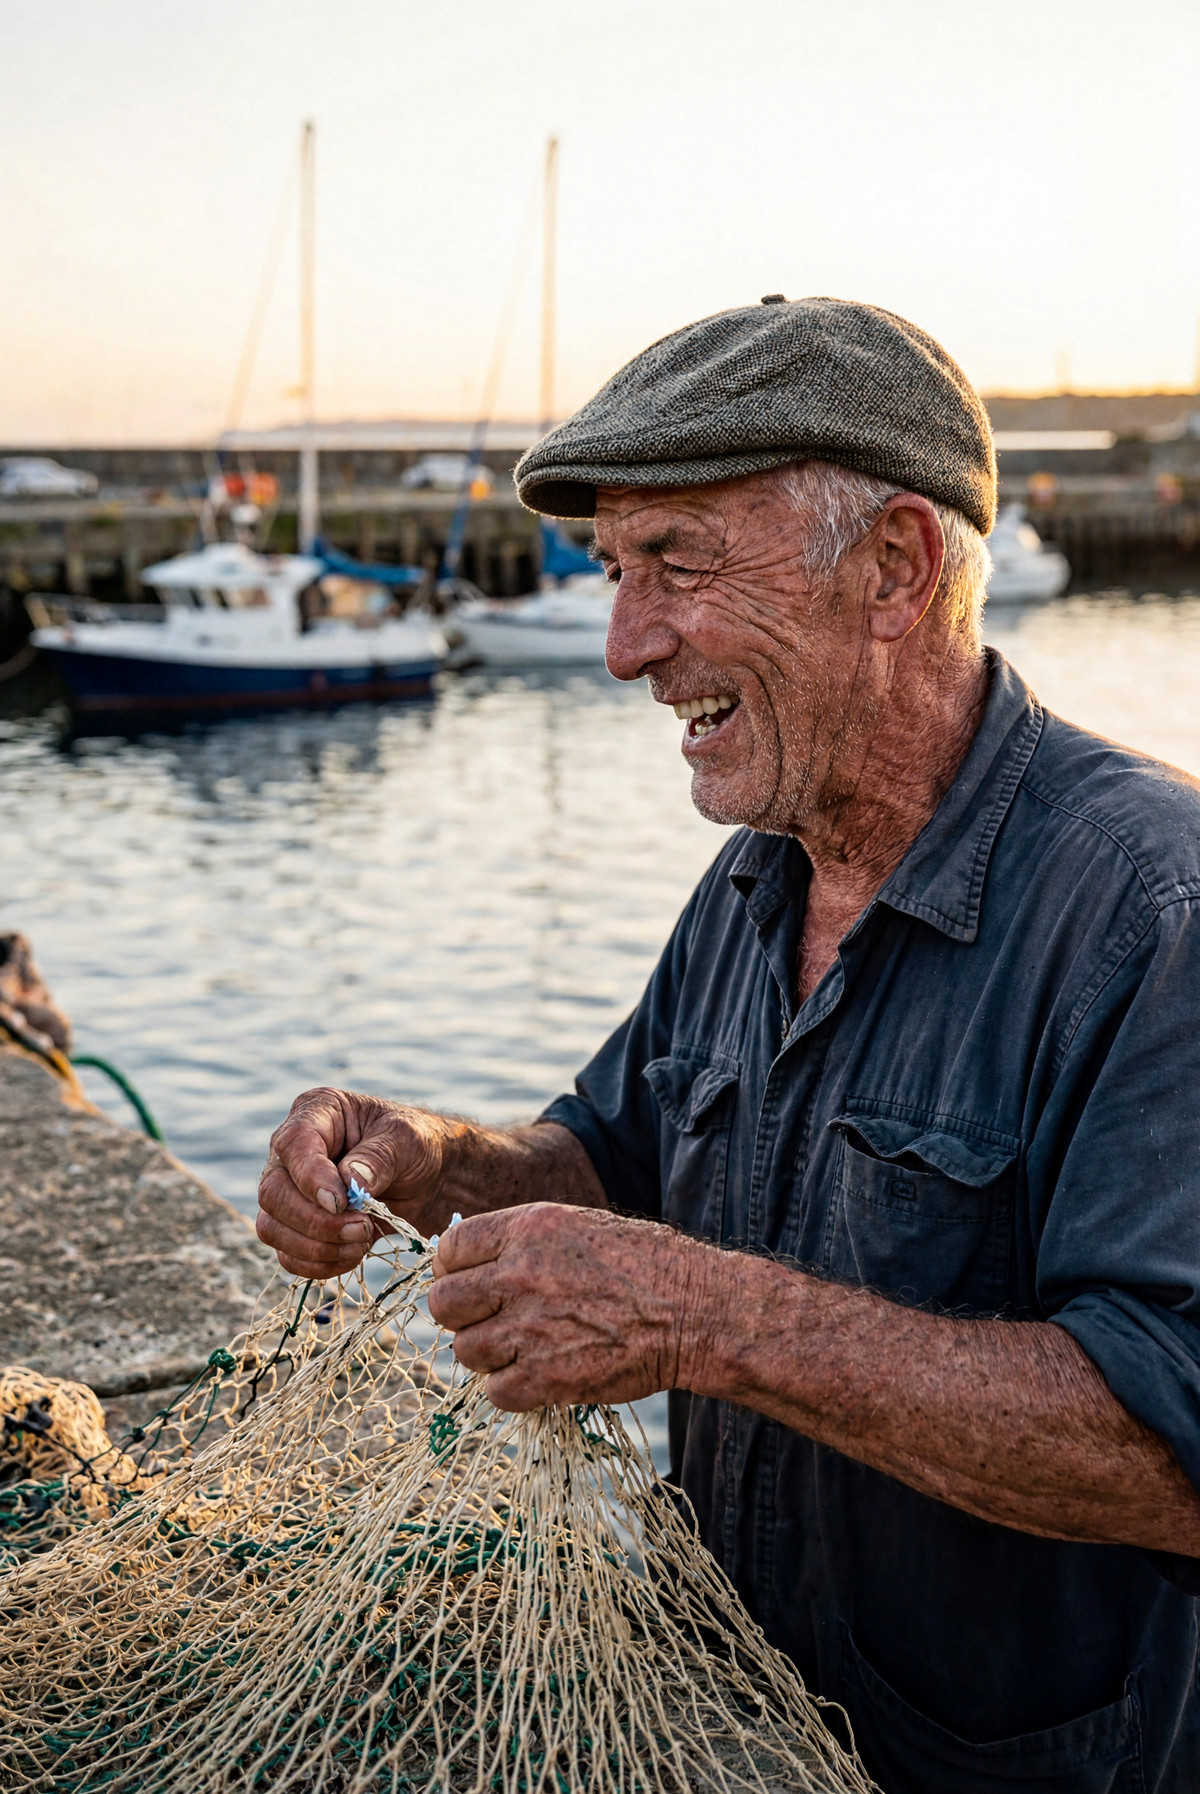
リアルな画像編集ワークフローページに新たに追加されたテキストから画像生成 v1.0:同じモデルとサンプリングレシピを使用し、プロンプトのみで 16 MP のリアルな写真を生成します。専用ノード版と、ネイティブノード + RES4LYF 版の 2 種類のワークフローを提供しています。
サンプル画像
おすすめ理由
- バージョン更新:以前は画像編集のみでしたが、純粋なテキストから画像生成が追加されました。Kijai の空画像テクニックを用いて H3 Image をよりクリーンな参照モードに保ち、画像条件がない場合の出力が粗く過度にシャープになるのを防いでいます
- 作者はレシピを説明しています:H3 Image は固定の 6 ステップのノイズグリッドで蒸留されており、最初の数ステップでは通常の Euler で構図を決め、最後の 2 ステップでは 2 次サンプリングと新しいノイズを追加して、毛穴や髪毛を生成します
- すべてのサンプル画像にワークフローが埋め込まれており、ComfyUI に直接ドラッグ&ドロップできます。7 枚が閲覧可能で、作者は失敗例もリストアップしています
使い方
- ノード版には comfyui-h3-sampler 1.1 以上が必要です(インストール済みの場合はそのディレクトリで git pull を実行してください)。もう一方のバージョンはネイティブノードと RES4LYF のみを使用します
- プロンプトテンプレートの最初の文と最後の文は保持し、中間部分で人物、動作、服装、シーン、ライティングを記述してください。解像度は 16 MP のままにしてください
リスクと制限
- 作者は RTX PRO 6000(96 GB)でのみテストしており、VRAM 要件が高いです
- 作者曰く、手、手持ちの物、テキストにゴーストや変形が発生する可能性があるため、複数枚生成して確認してください
- 1 個のセンシティブなサンプルは非表示です。comfyui-h3-sampler は GPL-3.0 ライセンスです
【A】Simple Txt2Img with Preview — H3 Image Workflow · v1.0plus
ワークフロー · バージョン更新 · 作者 spacejumper2021824 · 公開 11-17 15:19 · ダウンロード 18
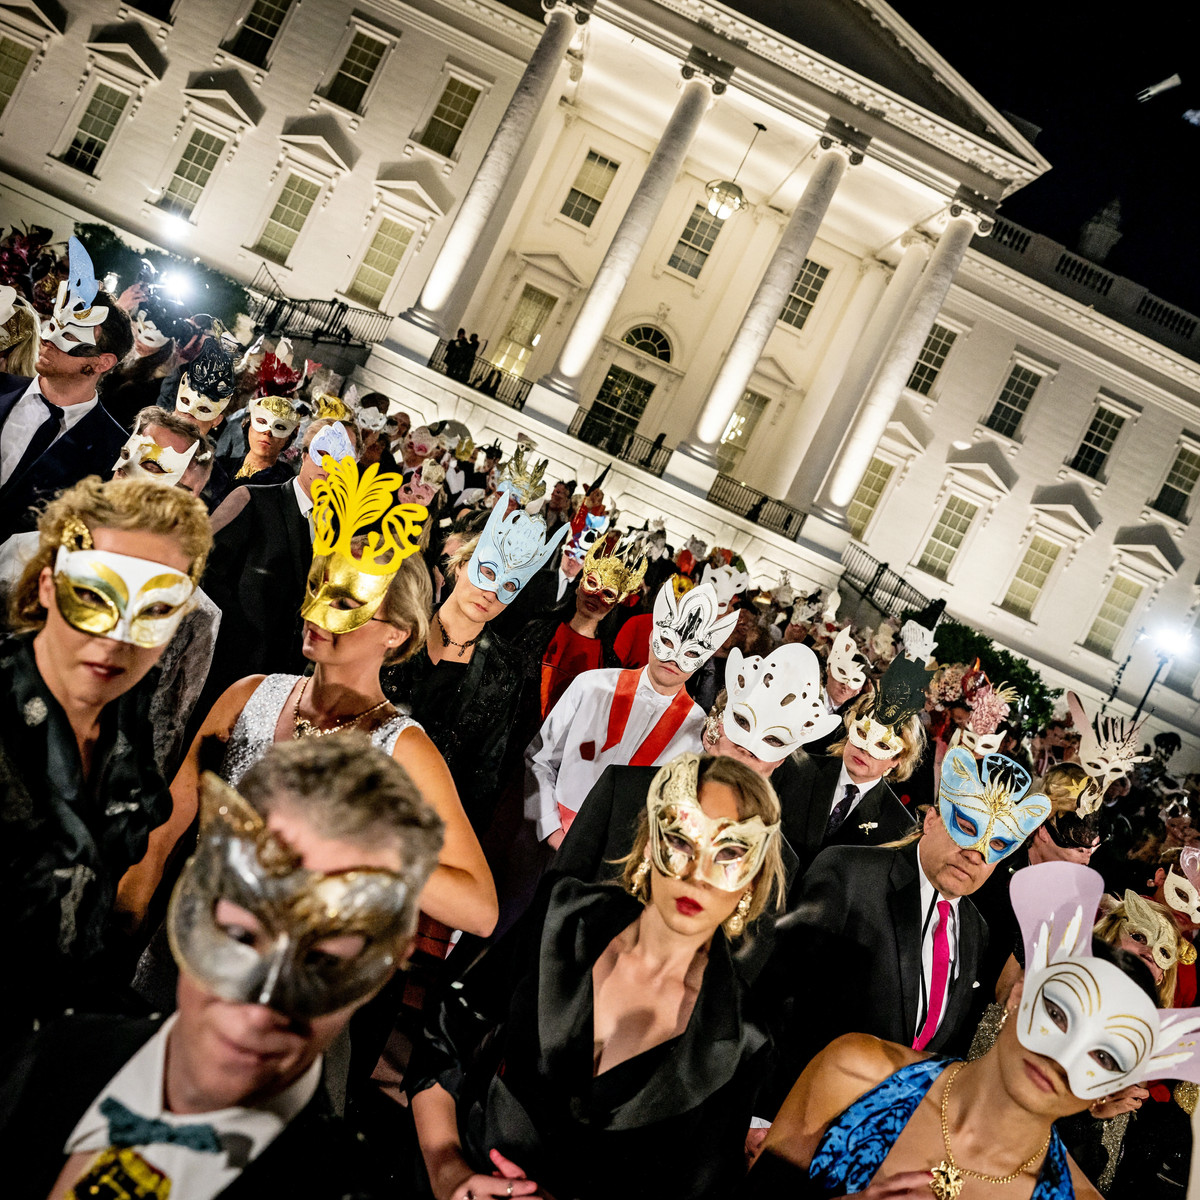
リアルタイムプレビュー付きの H3 Image 簡易テキストから画像生成ワークフロー v1.0plus:tiny VAE を使用してサンプリング中にリアルタイムで進捗を確認でき、このバージョンではプロンプト強化と切り替え可能なサンプリングプリセットが追加されました。
サンプル画像
おすすめ理由
- バージョン更新:v1.0plus = v1.0 + プロンプト強化 + サンプリングプリセットの組み合わせで、強化機能は手動で無効化できます
- 画像生成中に進捗を確認し、悪い画像を早期に破棄したいテキストから画像生成のシナリオに対応しています。必要なモデルとカスタムノードはすべてリストアップされています
- 作者は 2 種類のサンプリングを提供しています:公式推奨の euler/simple/6 ステップ。肌がぼやけたりノイズが多い場合は sa_solver/sgm_uniform/5 ステップに変更できます
使い方
- ComfyUI-KJNodes と rgthree-comfy をインストールしてください。taeh3_image.safetensors(4.96 MB)を models/vae_approx/ に配置してください。プレビューノードはこれがないとエラーになります
- デフォルトは 4096×4096(16 MP、1:1)で、ResolutionSelector ノードで変更できます
- プロンプト強化には追加の qwen3.5_9b モデルが必要ですが、不要な場合は無効にできます
リスクと制限
- 2 個のセンシティブなサンプルは非表示で、閲覧可能なサンプルは 2 枚のみです
- 依存するノードとモデルは自分で確認する必要があります。本ツールでは動作確認を行っていません
注目すべき(1)
【B】Radiance Chrome Voluptuous · MiniMax-H3-Image
LoRA · 移植 · 作者 AIImageStudio · 公開 11-17 12:18 · ダウンロード 9 · 有料
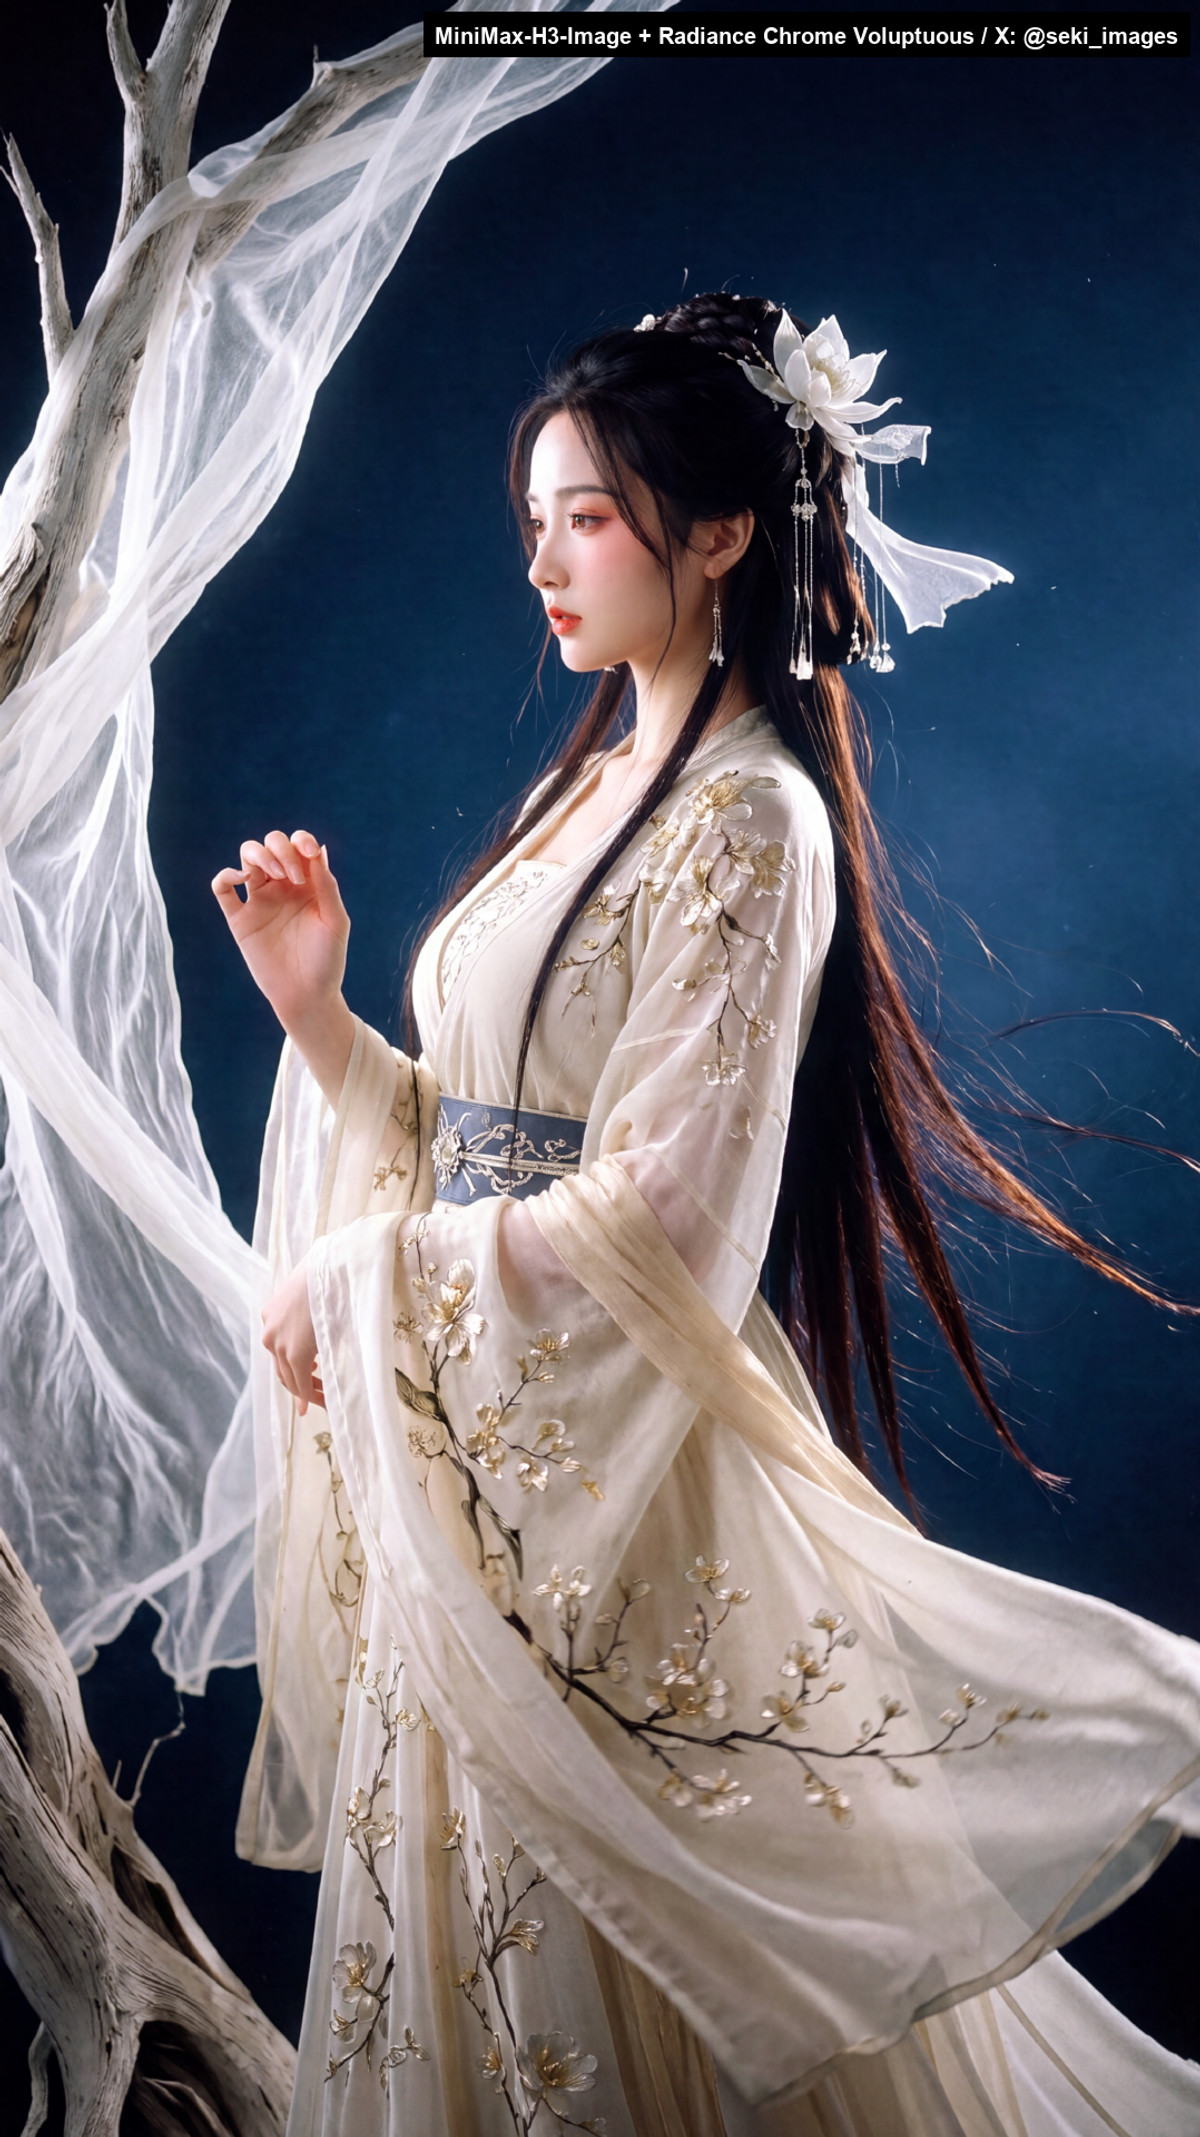
Radiance Chrome Voluptuous の H3 Image 移植版:リバーサルフィルム / スライドのような質感で、高コントラスト・高彩度の画風です。陽光と光影を強調し、元モデルの粒子感とジャギーを軽減します。
サンプル画像
おすすめ理由
- 移植:同じページにはすでに MOSS、Flux.3 Klein、Qwen 2.1、Krea 2 など複数のベースモデル版がありますが、このバージョンは作者が H3 Image テキストから画像生成モデル用であり、H3 ビデオモデル用ではないと明記しています
- パラメータが提供されています:サンプラー、強度範囲、空画像条件テクニック、解像度に関する推奨事項
- 有料であり、作者自身が人物の体型の偏りが強く、多様性はプロンプトで補う必要があると明記しています
使い方
- サンプラーは euler_simple(作者曰く訓練に使用したものです)。強度は 1.0–1.25。トリガーワードは不要です
- 作者は粗さを軽減するために、MiniMax H3 Image Conditioning ノードに白い空画像(9:16 は 512 × 910 で十分)を接続することを強く推奨しています。16 MP で生成してから縮小してください
リスクと制限
- 有料ダウンロード(永久課金)
- 15 個のセンシティブなサンプルは非表示で、閲覧可能なサンプルは 5 枚です
- 作者はスタイルの好みが非常に強く、人物の体型の多様性が難しいと明記しています
収録のみ(2)
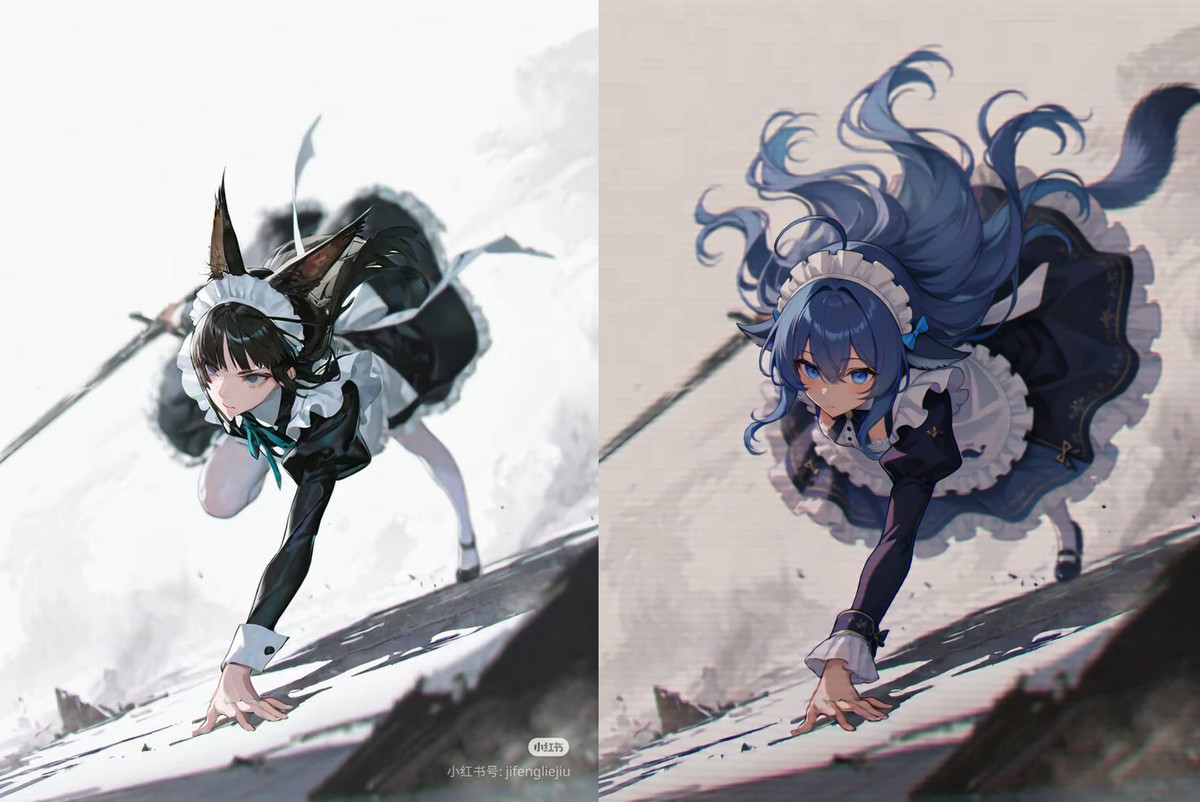
- Minimax H3 video model achieved what no other image editing model could · v1.0 — ワークフロー:H3 ビデオモデルを用いた画像編集ワークフロー。作者曰く、大きな角度の変更でも成功率が高く、ほぼ一度で成功するとのことです。
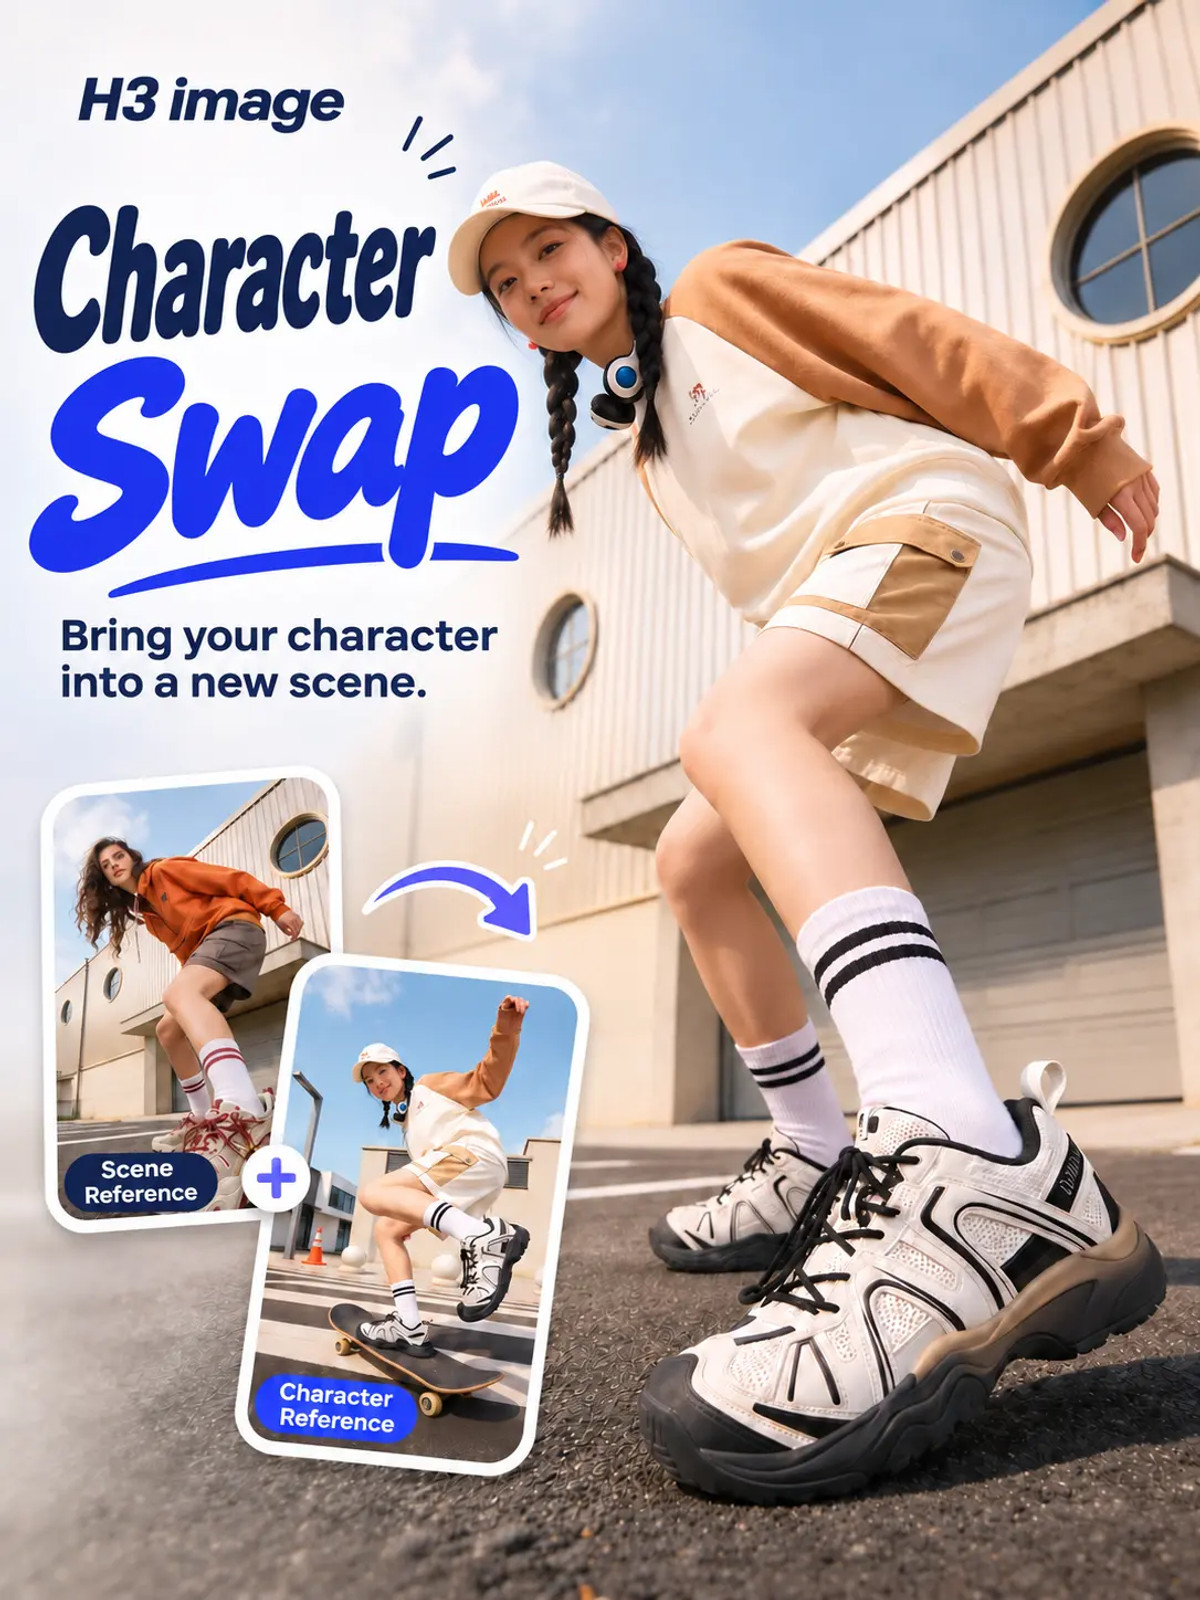
- Character Swap-H3 image · v1.0 — ワークフロー:H3 Image キャラクター転送ワークフロー:参照画像内の人物の顔と身体的特徴をターゲット画像に置き換え、新しい背景、ポーズ、ライティングに適応させます。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-17 08:31 → 11-17 21:01(北京時間)。おすすめ理由は編集者によるレビュー済み。ダウンロード数は注目度を表すに過ぎません。