貞貞のAIレーダー · MiniMax H3 · 2026-11-03 朝刊
今号の 33 個の新バージョン:強く推奨 0 · 推奨 2 · 注目 13 · 収録のみ 18
編集者按 今号では 33 個の H3 新バージョンをレビューしました。そのうち AIKSK は一度に 20 個以上のワークフローをリリースしました。トップ推薦は Hand Tie Clips 3.4 です。複数の H3 短編動画を1分以上の長編動画に繋ぎ合わせ、新たに追加された sand_tie 接続方法により、一連のクリップをシームレスな単一の動画としてレンダリングします。もう一つのA評価は UCHIJ の Ref2VA リップシンク v2.0 で、自身の音声で参照画像から動画を生成します。AIKSK シリーズの中で、量子化レベルのみを変更した 48/80 GB 版、新機能のない基本テンプレート、およびカード上の差異が不明確な R2V 変体は C 評価に下げ、リスク欄に「24 GB 版が実は bf16 フル精度である」というレベル命名の問題を明記しました。一般的な人物 LoRA と汎用プロンプトツールは C 評価としました。
推奨(2)
【A】Hand Tie Clips — マルチホップ MiniMax H3 動画+音声、単一キュー · v3.4
ワークフロー · バージョン更新 · 作者 sandpies · 公開 11-03 00:25 · ダウンロード 44
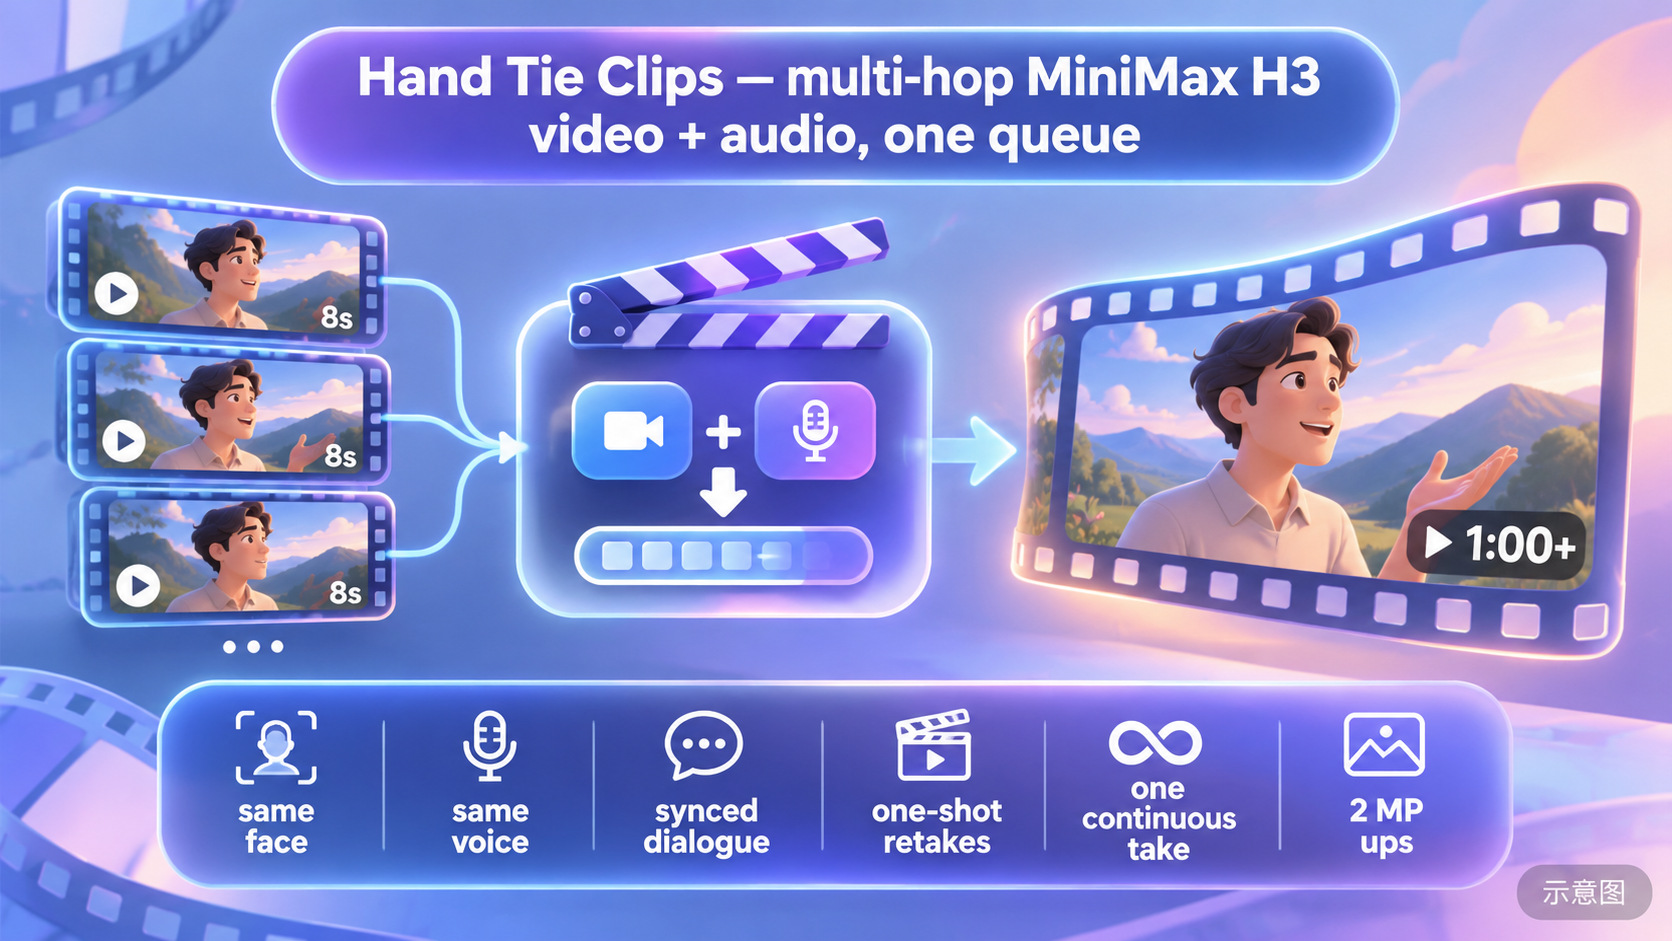
Hand Tie Clips 3.4:複数の H3 短編動画を1分以上の長編動画に繋ぎ合わせるカスタムノードパッケージです。このバージョンでは、sand_tie「ワンカット」接続方法が新たに追加され、一連のクリップを同一の動画としてレンダリングし、継ぎ目が見えなくなります。
今号で最も完成度の高い長編動画ソリューションです。新バージョンの価値は、複数クリップの継ぎ目を除去した点にあり、まず短い歌や二人の会話で sand_tie を試すのに適しています。
画像
推奨理由
- バージョン更新:新接続方法 sand_tie により、一連のホップを単一の動画としてレンダリングし、anchor: restart が記述された箇所でのみカットされます。特定のホップのみを再作成し、他を保持することが可能です。長尺ショットが明るくなりすぎるのを防ぐ tone_lock が追加されました。アップスケーラーは遠くの小さな顔をクローズアップとして再描画し、長編動画でのメモリオーバーフローを修正しました。スクリプトアシスタントには、複数人が同時に話す、食べながら話す、周囲を回るカメラワークなどのルールが追加されました。
- 長尺動画と対話に対応:同一キャラクター、同一音声で複数のショットを継続します。参照欄にキャラクター/シーンの静止画や音声クリップを配置し、@tag でスケジューリングします。また、人物/頭部を交換する SWAP モードと、内蔵の 2 MP アップスケール機能があります。
- 古い画像の保存でも読み込み可能です。3種類の接続方法(デフォルトの motion_context、新機能の sand_tie、実験的な hand_tie)にはそれぞれ適用シーンがあり、作者は各方法の上限と推奨カットポイントを記載しています。
- 無料です。このバージョンは 44 回ダウンロードされ、モデル全体では 1207 回(注目度を示すのみ)です。
使い方
- ComfyUI/custom_nodes 配下に作者のリポジトリを git clone し、再起動してブラウザを強制リフレッシュ後、workflows/HandTieClips_Starter.json をドラッグ&ドロップします。REFS の1行目にキャラクター写真を配置し、SCRIPT に絵コンテを記述してキューに入れます。
- 長尺ショットでは pin_mech: sand_tie を選択します。比較的新しい ComfyUI が必要です。作者は Wuli 8 ステップ Turbo DiT、3D 潜在空間アップスケーラー、Open-H3-Regenerate-2K LoRA を推奨しており、速度系ノードには PlagueKind / KJNodes を使用します。
リスクと制限
- このバージョンの 3 個のサンプル動画はすべて非表示になっており、Civitai ページでは映像を確認できません。作者が主張する 2:03 シングルショット MV、52 秒の二人シーンなどのデモは外部リンクにあり、検証されていません。
- sand_tie には ComfyUI v0.38.0 以上と 0.9 秒のオーバーラップが必要です。tone_lock のレベル 0.5 / 0.75 / full は完全なモデルカードでのみ確認できます。
- 依存関係が多い(Turbo DiT、アップスケーラー、Regenerate LoRA、オプションのローカル LLM スクリプト作成)。この項目は実行されていません。
- カードの画像は AI 生成の概念図であり、モデルの実際の効果ではありません。作者は公開された通常レベルのサンプルを持っていません。
【A】MiniMax H3 ref2va - Lip Sync + TURBO (v2.0) · MiniMax H3 Ref2VA v2.0
ワークフロー · バージョン更新 · 作者 UCHIJ · 公開 11-02 21:21 · ダウンロード 48
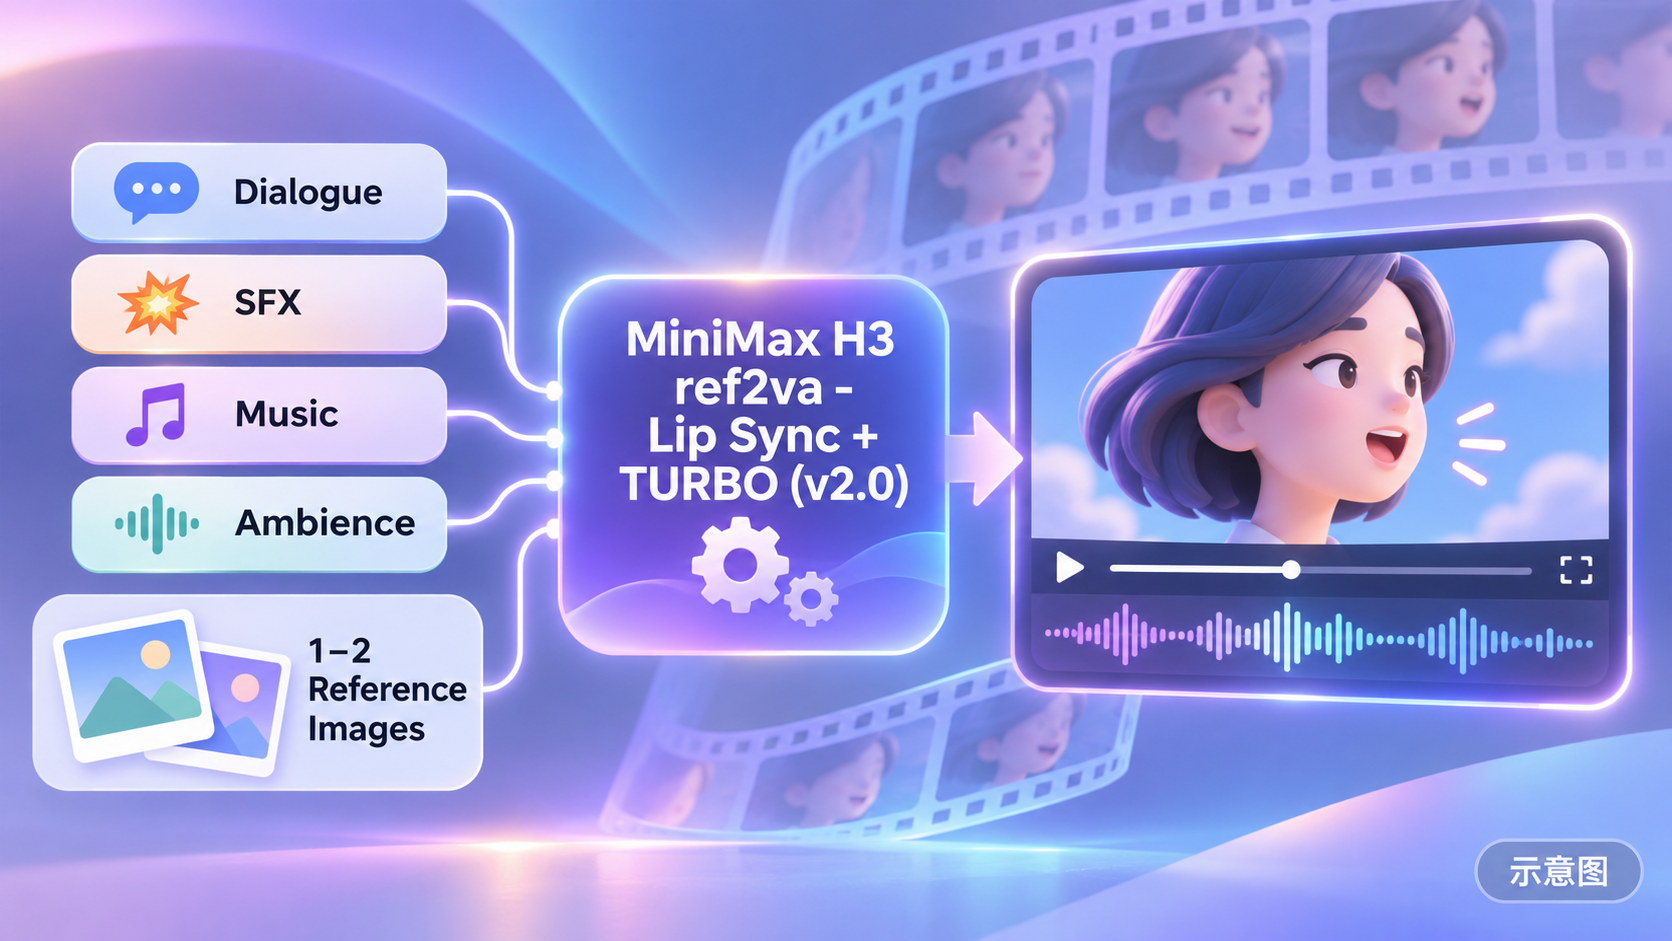
自身の音声で H3 Ref2VA を駆動するワークフロー v2.0 です。1〜2枚の参照画像+1つの対話/効果音/音楽+プロンプトで動画を生成し、音声はそのまま完成動画の音声トラックとして使用されます。オプションの Turbo LoRA によりステップ数が自動的にマッチングされます。
コアノードのみで音声駆動が可能であり、今号で最もハードルの低いリップシンクソリューションです。
画像
推奨理由
- バージョン更新:Audio Start(音声の任意の位置から開始し、動画長に自動トリミング)が追加されました。2枚目の参照画像が追加され、プロンプト内で <Picture 1> / <Picture 2> を使用します。デフォルトの長さは試走しやすいよう 5 秒に変更されました。読み込みノードの名前が変更され、内蔵の説明も同期更新されました。
- リップシンクと音声駆動に対応:ワークフローはプロンプトに自動的に <Audio 1>: fully_copy を追加し、モデルがあなたの音声を最終音声トラックとして扱うようにします(スタイル参照としてではなく)。より緩やかな追従を望む場合は、Audio Guidance 文字列ノードを変更します。
- Turbo スイッチャーは LoRA ファイル名内の 4step / 8step に基づいてステップ数を自動設定します。Turbo をオフにすると、約 20 ステップの完全なベースモデルを実行します。ComfyUI コアノードのみを使用し、カスタムノードパッケージは不要です。
- 無料です。このバージョンは 48 回ダウンロードされ、モデル全体では 623 回(注目度を示すのみ)です。
使い方
- minimax_h3_ref2va_pruned_int8_convrot ベースモデル、Qwen3-VL nvfp4_awq テキストエンコーダー、動画と音声の2つの VAE(精度は作者のリストを参照)が必要です。Turbo LoRA はオプションで、ファイル名に 4step または 8step を含める必要があります。
- 参照画像(2枚目は空でも可)と音声をアップロードし、Audio Start、解像度、長さ、フレームレートを設定します。プロンプト内で <Picture 1>、<Audio 1> を使用して入力を指します。
リスクと制限
- 1 個のサンプルのみ存在し、非表示になっているため、リップシンクの効果を確認できません。
- 作者は、低ステップ数でノイズが発生する場合、コンソールの「lora key not loaded」を確認するよう注意を促しています。Turbo LoRA が ref2va ベースモデルと互換性がない可能性があります。最初と最後のフレームの制御はなく、単回で約 15 秒が上限であり、複数クリップの連結は行いません。
- 音声の長さは「開始位置+長さ」以上である必要があります。この項目は実行されていません。
- カードの画像は AI 生成の概念図であり、モデルの実際の効果ではありません。作者は公開された通常レベルのサンプルを持っていません。
注目(13)
【B】MiniMax H3 Reference-to-Video 6x Speedup - 24 GB Edition · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-03 00:26 · ダウンロード 29
6倍高速化シリーズの参照画像から動画生成の 24 GB 版です。1枚の画像、1つの動画、1つの音声を同時に参照として受け取り、Ref2VA bf16 ベースモデル+turbo-v4 LoRA で 6 ステップを実行します。
画像
【B】MiniMax H3 Ref2VA Three-Stage 2K Multi-Reference Redraw · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 23:18 · ダウンロード 30
AIKSK の Ref2VA 三段階マルチ参照画像再描画です。第一段階でマルチ参照画像から生成し、その後2回のピクセル空間 RTX ×1.5 アップスケールを経由します。各段階で新しいサイズに基づいて再条件付けし、4 ステップの Turbo LoRA で低ノイズ除去による精修を行い、2K を目標とします。
画像
【B】MiniMax H3 Image-to-Video 6x Speedup - 24 GB Edition · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-03 00:23 · ダウンロード 26
AIKSK の「6倍高速化」シリーズの画像から動画生成の 24 GB 版です。FL2VA bf16 フル精度ベースモデル+turbo-v4 LoRA を使用し、euler + beta で 6 ステップのみ実行し、1枚の画像から動画を生成します。
画像
【B】R2V-06 Character Image + Motion Video + New Audio · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-03 00:00 · ダウンロード 21
AIKSK の R2V-06 です。キャラクター画像でアイデンティティを決定し、モーション動画で動作を与え、別途新しい音声を組み合わせることで、音声を変更したキャラクター動画を生成します。
画像
【B】MiniMax H3 LightX2V Turbo Acceleration · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-03 00:25 · ダウンロード 21
6倍高速化シリーズ内の LightX2V ルートです。単一画像から動画生成を行い、剪定された INT8 ベースモデル+LightX2V 4 ステップ Turbo LoRA(強度 0.75)を使用し、er_sde + simple で 4 ステップのみ実行します。
画像
【B】MiniMax H3 Universal Video HD Redraw (Single-Pass Upscale) · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 23:20 · ダウンロード 27
AIKSK の汎用動画高解像度再描画です。任意の動画をアップスケールした後、潜在空間を H3 に注入し、4 ステップの低ノイズ除去(0.65)で単一パス再描画によりディテールを補完します。元の動作、構図、カメラワーク、および元の音声トラックを保持します。
画像
【B】MiniMax H3 FL2VA 2段階アップスケール(先頭/末尾フレーム) · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 23:18 · ダウンロード 17
AIKSKによるH3先頭・末尾フレーム2段階アップスケールワークフロー:先頭と末尾の2枚の画像をまず8ステップのturbo LoRAで生成し、その後ピクセル空間でRTXアップスケールを行います。アップスケール後の実際のサイズに基づいて再条件付けし、4ステップのturbo LoRAで低ノイズの精細な仕上げを行います。
画像
【B】R2V-01 マルチ画像参照 · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 23:57 · ダウンロード 24
AIKSKの第288回H3全モダリティ参照動画生成シリーズのR2V 1番:4枚の静止画で人物と小道具を決定し、別途音声を入力して演技を駆動します。LoRAなしの20ステップ基本サンプリングを使用し、横画面で出力します。
画像
【B】MiniMax H3 デジタルヒューマン - 2人対話 · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 22:19 · ダウンロード 20
AIKSKによるH32人対話デジタルヒューマンワークフロー:2人のキャラクターそれぞれに画像1枚と音声1つを入力します。2つの音声をトリミングし、空白を補完して1つのタイムラインに結合・固定し、H3はそれに一致する2人の演技映像のみを生成します。
画像
【B】MiniMax H3 INT8 W4A8 高速化 · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-03 00:24 · ダウンロード 19
第291回高速化シリーズ内の量子化比較ファイル:1つのファイルに3つの並列した画像から動画への生成ブランチが含まれています。W4A8混合量子化・プルーニング済みベースモデルと、2つのINT8 convrotベースモデルを比較します。いずれもLoRAなしで、完全な20ステップを維持しています。
画像
【B】R2V-05 キャラクター画像 + 動画 + ペア音声 · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-03 00:00 · ダウンロード 20
R2Vシリーズ第5番:キャラクター画像 + 参照動画 + 動画に付随する元音声。参照クリップから映像とペアの音声を分離し、条件として使用します。自分のキャラクターに置き換え、元の動画の音声をそのまま利用します。
画像
【B】MiniMax H3 Larry Turbo 高速化 · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-03 00:25 · ダウンロード 15
第291回高速化シリーズで最も簡素な構成:単一画像から動画生成。FL2VAプルーニング済みINT8ベースモデル + turbo-v4 LoRA(強度1)、euler + betaで6ステップ、ノード数はわずか21個です。
画像
【B】MiniMax H3 + VoxCPM デジタルヒューマン - 単一キャラクター · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 22:18 · ダウンロード 18
AIKSKによるH3 + VoxCPM単一キャラクターデジタルヒューマンワークフロー:キャラクター画像1枚 + VoxCPM参考音声1つ。台本を作成し、VoxCPMでまず音声を合成します。その後、H3が固定された音声に基づいて話している映像を生成します。
画像
収録のみ(18)
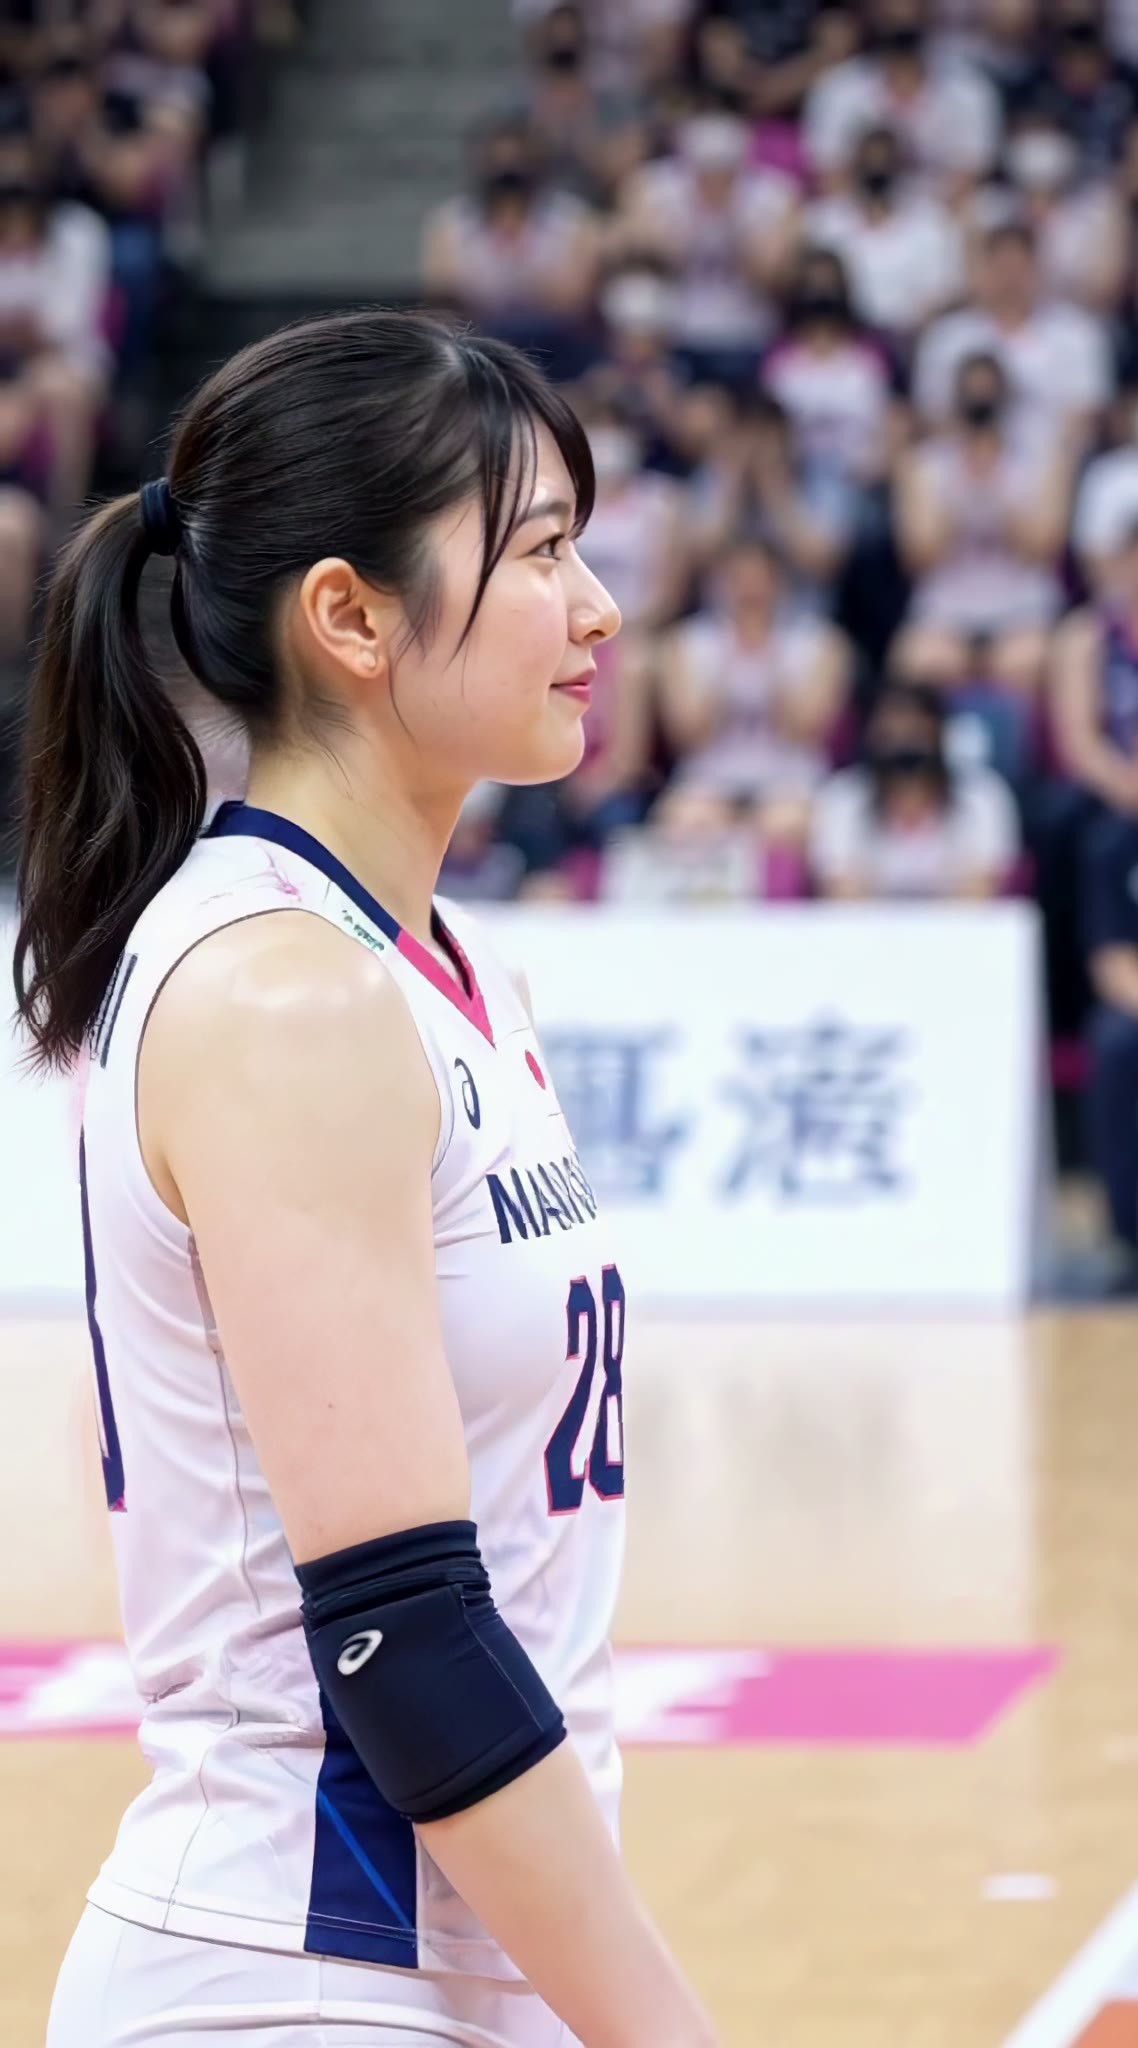
- AI Girl: Fictional Women Series39 / 架空の女性シリーズ39 MiniMax H3 · v1.0 — LoRA:shimeaji_RTX の架空人物シリーズ第 39 号:架空の日本人女性バレーボール選手キャラクターの LoRA。
- MiniMax H3 First-Frame Image-to-Video · v1.0 — ワークフロー:AIKSK の H3 最初のフレームからの画像生成動画の基本フロー:1枚の画像を最初のフレームとして使用し、FL2VA bf16 ベースモデル、LoRA なし、res_multistep + simple 20 ステップ。
- MiniMax H3 Image-to-Video 6x Speedup - 48 GB Edition · v1.0 — ワークフロー:6倍高速化された画像生成動画の 48 GB 版:24 GB 版と同じ 6 ステップの turbo-v4 サンプリングを使用し、ベースモデルのみを FL2VA INT8 convrot に、エンコーダーを nvfp4_awq に、動画 VAE を int8 に変更。
- MiniMax H3 Text-to-Video · v1.0 — ワークフロー:AIKSK の H3 テキスト生成動画の基本フロー:プロンプト入力のみ、ImageToVideo 条件ノードに画像を接続せず純粋なテキスト生成動画として使用、FL2VA bf16 ベースモデル 20 ステップ。
- MiniMax H3 Reference-to-Video 6x Speedup - 48 GB Edition · v1.0 — ワークフロー:6倍高速化された参照生成動画の 48 GB 版:24 GB 版と同様に画像 + 動画 + 音声の3系統の参照、6 ステップの turbo-v4 サンプリングを使用し、ベースモデルのみを Ref2VA INT8 convrot に、エンコーダーを nvfp4_awq に変更。
- catolf1 · v1 — LoRA:chibron のキャラクター LoRA catolf1:タグは「character」のみで、名前自体しか記載されておらず、どのようなキャラクターか判断できない。
- MiniMax H3 Image-to-Video 6x Speedup - 80 GB Edition · v1.0 — ワークフロー:6倍高速化された画像生成動画の 80 GB 版:同じ 6 ステップの turbo-v4 サンプリングを使用し、ベースモデルをプルーニングされた INT8 convrot の FL2VA に、エンコーダーを nvfp4_awq に、動画 VAE を int8 に変更。
- R2V-02 Pure Video Reference · v1.0 — ワークフロー:AIKSK の R2V-02 純粋な動画参照:アクションとリズムは静止画ではなく参照動画から取得され、Video Slice でどの部分を使用するかを決定。
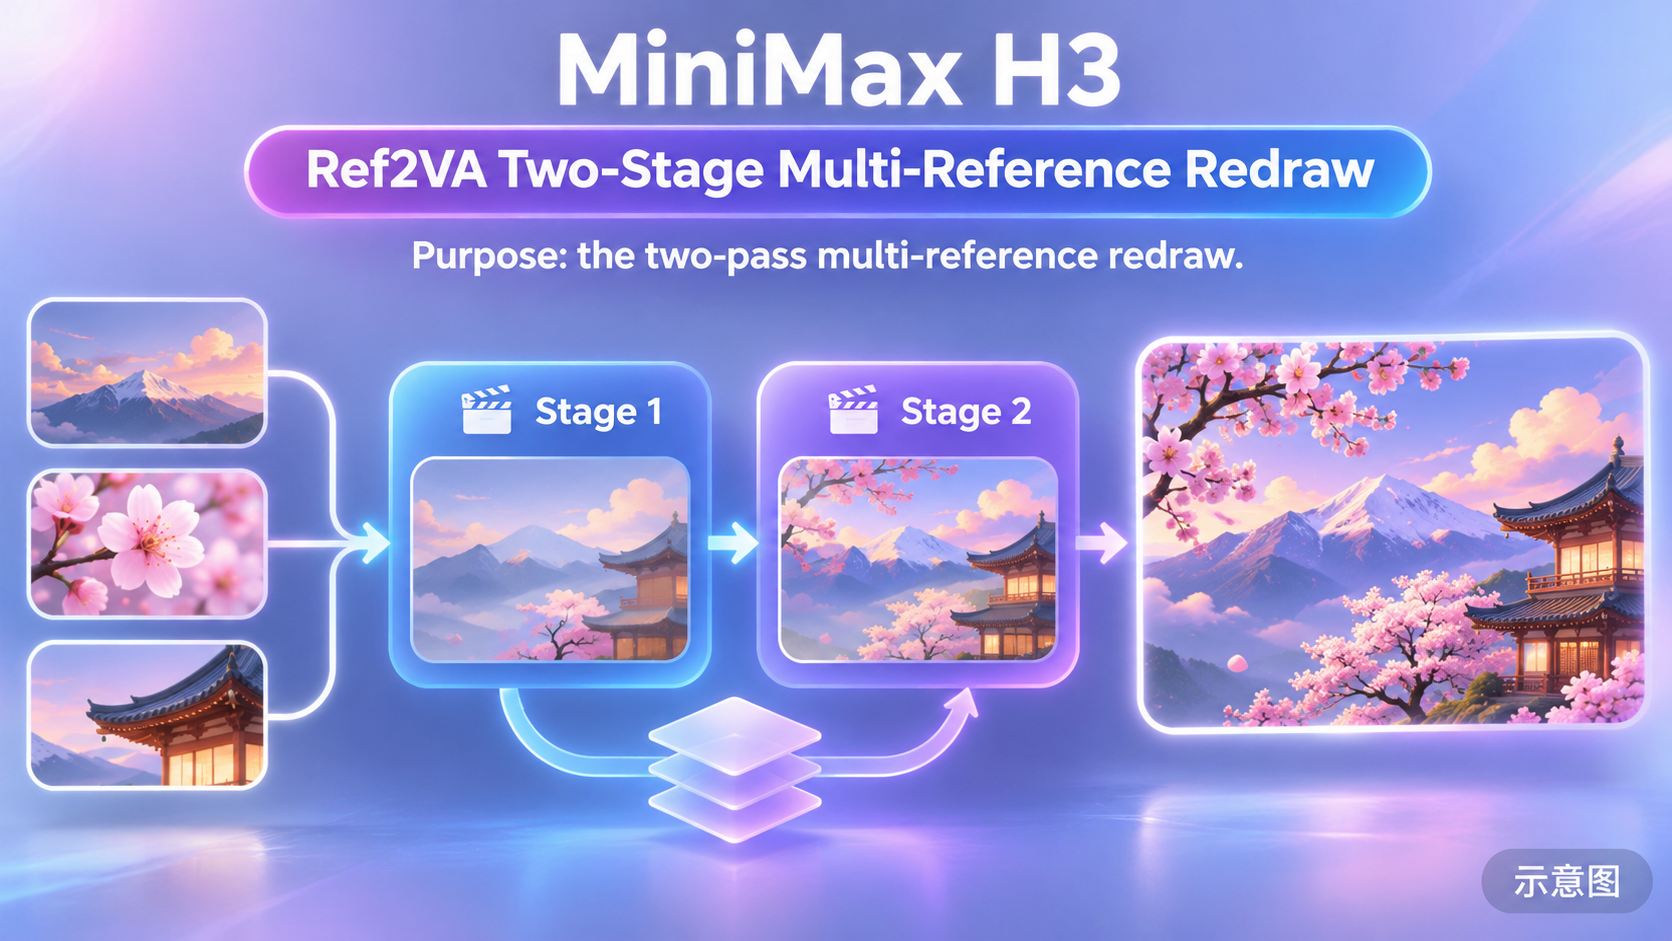
- MiniMax H3 Ref2VA Two-Stage Multi-Reference Redraw · v1.0 — ワークフロー:3段階のマルチ参照再描画の省コスト版:複数参照画像生成後、RTX ピクセル拡大を1回だけ実行し、第2段階では拡大後のサイズで再条件付け、4 ステップの低ノイズ除去でリファイン。
- R2V-04 Character Image + Standalone Audio · v1.0 — ワークフロー:R2V シリーズ第 4 弾:キャラクター画像 + 独立音声からの動画生成、4つの画像スロットとトリミングされた音声1つを接続し、参照動画は接続しない;R2V 第 1 号とほぼ同じ画像だが、アスペクト比が 9:16 の縦長画面に変更されている。
- MiniMax H3 First-and-Last-Frame Video · v1.0 — ワークフロー:AIKSK 第 288 期の H3 最初と最後のフレームからの動画生成基本版:2枚の画像でそれぞれ開始と終了を指定し、H3 が中間の動きを補完、LoRA なし、20 ステップ。
- MiniMax H3 Last-Frame Image-to-Video · v1.0 — ワークフロー:AIKSK 第 288 期の H3 最後のフレームからの画像生成動画基本版:1枚の画像を最終フレームとして与え、動画がこの画像に収束するようにする;同一ファイル内に並列で2つのブランチがあり、それぞれ 10 秒と 5 秒を出力。
- MiniMax H3 Reference-to-Video 6x Speedup - 80 GB Edition · v1.0 — ワークフロー:AIKSK 第 291 期「6 倍高速化」シリーズの参照生成動画 80 GB 版:画像 + 動画 + 音声の3系統の参照、Ref2VA プルーニング INT8 ベースモデルに turbo-v4 LoRA を組み合わせ、euler + beta で 6 ステップのみ実行。
- Prompt Studio — Give Your AI Creations a Memory · v1.21 — その他:ローカル Windows 用のプロンプトおよび作品アーカイブツール(モデルではなく、それ自体は画像を生成しない)、v1.21 でライティング示意球、人物および猫犬のポーズ、画像/動画/音声ワークベンチなどのプランニングツールを追加;H3 への専用対応はなし。
- Elizabeth WhiteMoon · MiniMaxH3 — LoRA:架空キャラクター Elizabeth WhiteMoon の人物 LoRA の H3 版、動画内でこの図書館学者風の女性キャラクターを生成するために使用。
- R2V-03 Character Image + Motion Video · v1.0 — ワークフロー:R2V シリーズ第 3 弾:キャラクター画像で外見を決定、参照動画でアクションを提供(アクション転送)、もう1つの音声入力スロットを備えるが、カードには音声がどのブランチを通るかが明確に記載されていない。
- MiniMax H3 Larry + Attention + Cache Full Acceleration · v1.0 — ワークフロー:第 291 期加速シリーズの「フルスペック」テストベンチ:3つの並列ブランチが同じ FL2VA INT8 ベースモデル + turbo-v4 LoRA(6 ステップ)上にアテンションとキャッシュパッチを重ねる。
- MiniMax H3 Larry + SageAttention Acceleration · v1.0 — ワークフロー:第 291 期加速シリーズの SageAttention テストベンチ:4つの並列ブランチが FL2VA INT8 ベースモデルと turbo-v4 LoRA(6 ステップ)を共有し、各ブランチの外側に接続されるアテンション / キャッシュパッチが異なる。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-02 20:31 → 11-03 09:01(北京時間)。推奨理由は編集者による審査済み;ダウンロード数は注目度を示すのみ。