贞贞的AI雷达 · MiniMax H3 · 2026-11-03 晨报
本期 33 个新版本:强烈推荐 0 · 推荐 2 · 可关注 13 · 仅收录 18
编辑按语 本期审阅 33 个 H3 新版本,其中 AIKSK 一次性发了 20 多个工作流。首推 Hand Tie Clips 3.4:把多段 H3 短片串成一分钟以上的长片,新增 sand_tie 接法让整串片段渲染成一个视频、没有接缝;另一个 A 是 UCHIJ 的 Ref2VA 口型同步 v2.0,用自己的音频驱动参考生视频。AIKSK 系列中只换量化档位的 48/80 GB 版、无新能力的基础模板和卡上差异说不清的 R2V 变体降为 C,并在 risks 写明“24 GB 版反而是 bf16 全精度”的档位命名问题;常规人物 LoRA 和通用提示词工具定 C。
推荐(2)
【A】Hand Tie Clips — multi-hop MiniMax H3 video + audio, one queue · v3.4
工作流 · 版本更新 · 作者 sandpies · 发布 11-03 00:25 · 下载 44
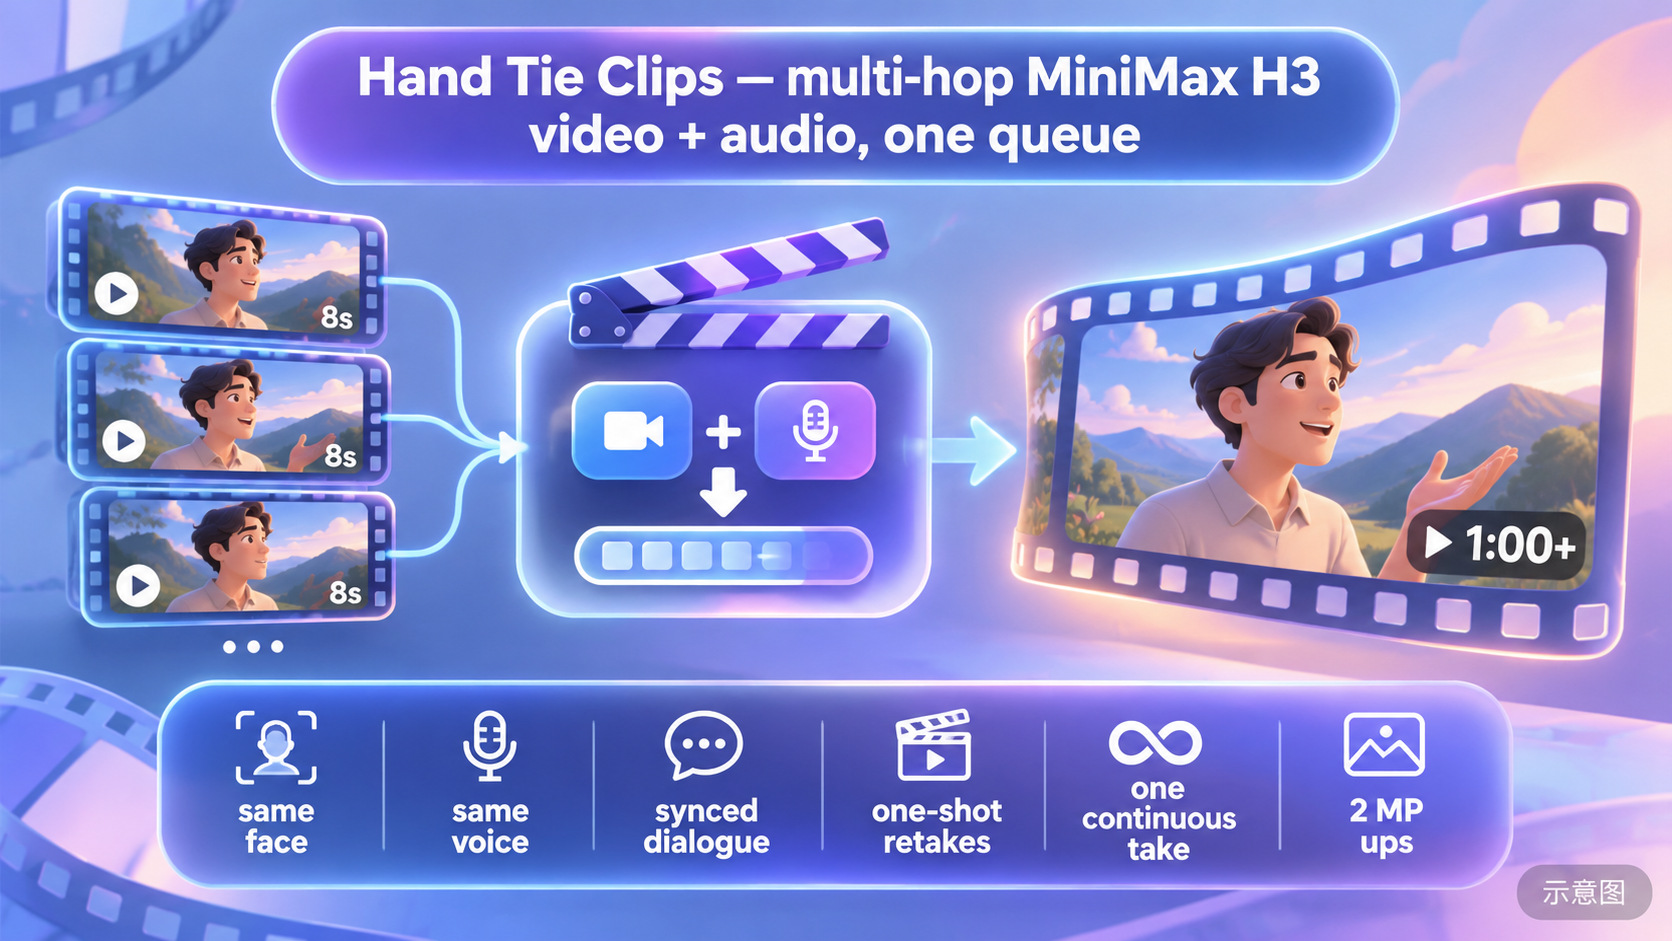
Hand Tie Clips 3.4:把多段 H3 短片串成一分钟以上长片的自定义节点包,这一版新增 sand_tie“一镜到底”接法,整串片段渲染成同一个视频、看不到接缝。
本期最完整的长片方案;新版价值在于去掉了多段拼接的接缝,适合先拿短歌或两人对话试 sand_tie。
配图
推荐理由
- 版本更新:新接法 sand_tie 让一整串 hop 作为一个视频渲染,只在写了 anchor: restart 的地方才切;可单独重做某一个 hop、其余保留;新增 tone_lock 防止长镜头越来越亮;放大器把远处小脸按特写重绘,并修了长片内存溢出;写稿助手补了多人同时说话、吃东西时说话、环绕运镜等规则
- 服务长视频与对白:同一角色、同一声音跨多个镜头延续;参考栏可放角色/场景静帧和声音片段,用 @tag 调度;另有换人/换头的 SWAP 模式和内置 2 MP 放大
- 旧图保存仍能加载;三种接法(默认 motion_context、新 sand_tie、实验性 hand_tie)各有适用场景,作者写了每种的上限和建议切点
- 免费;本版 44 次下载、整个模型 1207 次(只代表关注度)
怎么用
- 在 ComfyUI/custom_nodes 下 git clone 作者仓库,重启并强刷浏览器,拖入 workflows/HandTieClips_Starter.json;在 REFS 第一行放角色照片,在 SCRIPT 写分镜后排队
- 长镜头选 pin_mech: sand_tie,需较新的 ComfyUI;作者推荐 Wuli 8 步 Turbo DiT、3D 潜空间放大器和 Open-H3-Regenerate-2K LoRA,速度类节点用 PlagueKind / KJNodes
风险与限制
- 本版 3 段示例视频均被隐藏,Civitai 页面上看不到画面;作者称的 2:03 单镜头 MV、52 秒双人场景等演示在外链,未核验
- sand_tie 需要 ComfyUI v0.38.0 以上和 0.9 秒重叠;tone_lock 档位 0.5 / 0.75 / full 只在完整模型卡里
- 依赖多(Turbo DiT、放大器、Regenerate LoRA、可选本地 LLM 写稿);本条未运行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
【A】MiniMax H3 ref2va - Lip Sync + TURBO (v2.0) · MiniMax H3 Ref2VA v2.0
工作流 · 版本更新 · 作者 UCHIJ · 发布 11-02 21:21 · 下载 48
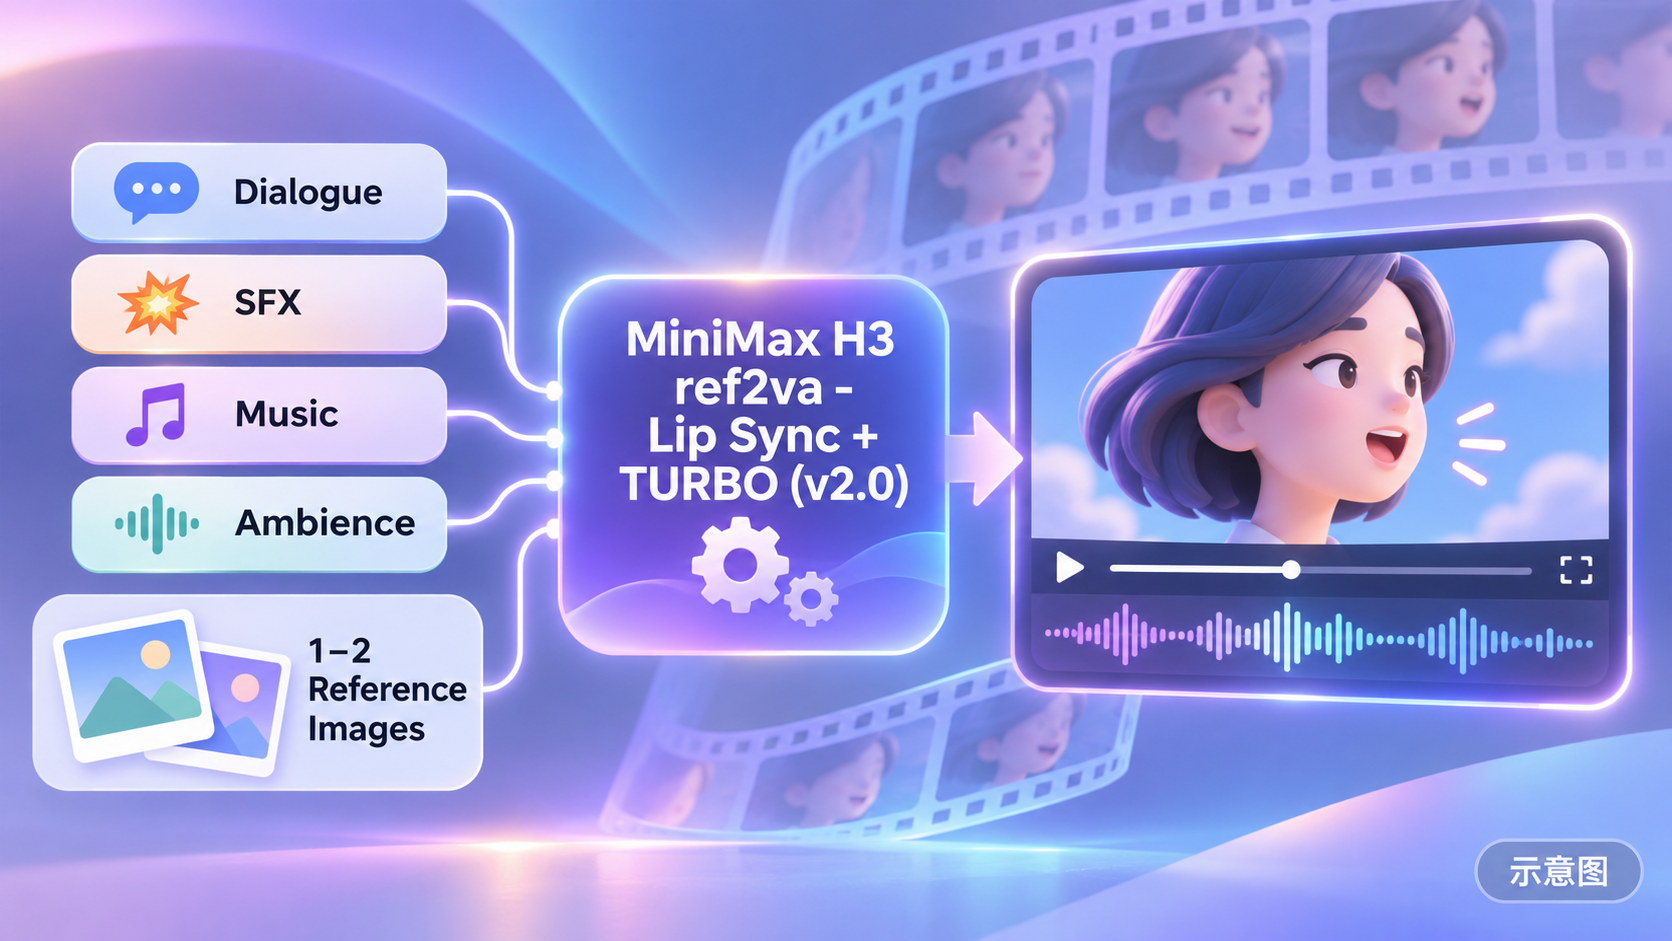
用自己的音频驱动 H3 Ref2VA 的工作流 v2.0:一到两张参考图 + 一段对白/音效/音乐 + 提示词出视频,音频原样作为成片音轨,可选 Turbo LoRA 自动匹配步数。
只靠核心节点就能做音频驱动,是本期门槛最低的对口型方案。
配图
推荐理由
- 版本更新:新增 Audio Start(从音频任意位置开始,自动裁到视频长度);新增第二张参考图,提示词里用 <Picture 1> / <Picture 2>;默认时长改为 5 秒便于试跑;加载节点改名,内置说明同步更新
- 服务对口型和音频驱动:工作流自动给提示词追加 <Audio 1>: fully_copy,让模型把你的音频当最终音轨而不是风格参考;要更松的跟随就改 Audio Guidance 字符串节点
- Turbo 切换器按 LoRA 文件名里的 4step / 8step 自动设步数,关掉 Turbo 则跑约 20 步的完整底模;只用 ComfyUI 核心节点、无需自定义节点包
- 免费;本版 48 次下载、整个模型 623 次(只代表关注度)
怎么用
- 需要 minimax_h3_ref2va_pruned_int8_convrot 底模、Qwen3-VL nvfp4_awq 文本编码器、视频和音频两个 VAE(精度见作者清单);Turbo LoRA 可选,文件名必须含 4step 或 8step
- 上传参考图(第二张可空)和音频,设 Audio Start、分辨率、时长与帧率;提示词里用 <Picture 1>、<Audio 1> 指代输入
风险与限制
- 只有 1 段示例且被隐藏,看不到口型效果
- 作者提醒低步数出噪时要看控制台“lora key not loaded”,Turbo LoRA 可能与 ref2va 底模不匹配;没有首尾帧控制,单次约 15 秒上限、不做多段串接
- 音频长度必须不少于 起点 + 时长;本条未运行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
可关注(13)
【B】MiniMax H3 Reference-to-Video 6x Speedup - 24 GB Edition · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-03 00:26 · 下载 29
六倍加速系列的参考生视频 24 GB 版:同时吃一张图、一段视频和一段音频做参考,Ref2VA bf16 底模 + turbo-v4 LoRA 跑 6 步。
配图
【B】MiniMax H3 Ref2VA Three-Stage 2K Multi-Reference Redraw · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 23:18 · 下载 30
AIKSK 的 Ref2VA 三段式多参考图重绘:第一段多参考图生成,再经两次像素空间 RTX ×1.5 放大,每段按新尺寸重新条件化、用 4 步 Turbo LoRA 低降噪精修,目标 2K。
配图
【B】MiniMax H3 Image-to-Video 6x Speedup - 24 GB Edition · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-03 00:23 · 下载 26
AIKSK“六倍加速”系列的图生视频 24 GB 版:FL2VA bf16 全精度底模 + turbo-v4 LoRA,euler + beta 只跑 6 步,一张图出视频。
配图
【B】R2V-06 Character Image + Motion Video + New Audio · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-03 00:00 · 下载 21
AIKSK 的 R2V-06:角色图定身份、动作视频给动作、另配一段全新音频,生成换了声音的角色视频。
配图
【B】MiniMax H3 LightX2V Turbo Acceleration · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-03 00:25 · 下载 21
六倍加速系列里的 LightX2V 路线:单图生视频,剪枝 INT8 底模 + LightX2V 4 步 Turbo LoRA(强度 0.75),er_sde + simple 只跑 4 步。
配图
【B】MiniMax H3 Universal Video HD Redraw (Single-Pass Upscale) · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 23:20 · 下载 27
AIKSK 的通用视频高清重绘:任意一段视频放大后把潜空间注入 H3,用 4 步低降噪(0.65)单次重绘补细节,保留原动作、构图、运镜和原音轨。
配图
【B】MiniMax H3 FL2VA Two-Stage Upscale (First/Last Frame) · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 23:18 · 下载 17
AIKSK 的 H3 首尾帧两段放大工作流:首尾两张图先用 8 步 turbo LoRA 生成,再经像素空间 RTX 放大,按放大后的实际尺寸重新条件化,用 4 步 turbo LoRA 低噪声精修。
配图
【B】R2V-01 Multi-Image Reference · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 23:57 · 下载 24
AIKSK 第 288 期 H3 全模态参考生视频系列的 R2V 1 号:四张静态图定人物和道具,另接一段音频驱动表演,走不加 LoRA 的 20 步基础采样,横屏出片。
配图
【B】MiniMax H3 Digital Human - Two-Character Dialogue · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 22:19 · 下载 20
AIKSK 的 H3 双人对话数字人工作流:两个角色各给一张图和一段音频,两段音频裁剪、补空后拼成一条时间线并锁定,H3 只生成匹配的双人表演画面。
配图
【B】MiniMax H3 INT8 W4A8 Acceleration · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-03 00:24 · 下载 19
第 291 期加速系列里的量化对比文件:一个文件三条并排的图生视频分支,W4A8 混合量化剪枝底模对比两条 INT8 convrot 底模,都不加 LoRA、保留完整 20 步。
配图
【B】R2V-05 Character Image + Video + Paired Audio · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-03 00:00 · 下载 20
R2V 系列第 5 条:角色图 + 参考视频 + 视频自带的原声;从参考片段里拆出画面和配对音频一起作为条件,换成自己的角色、沿用原片声音。
配图
【B】MiniMax H3 Larry Turbo Acceleration · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-03 00:25 · 下载 15
第 291 期加速系列里最精简的一张图:单图生视频,FL2VA 剪枝 INT8 底模 + turbo-v4 LoRA(强度 1),euler + beta 6 步,只有 21 个节点。
配图
【B】MiniMax H3 + VoxCPM Digital Human - Single Character · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 22:18 · 下载 18
AIKSK 的 H3 + VoxCPM 单人数字人工作流:一张角色图 + 一段 VoxCPM 参考音色,写好台词,VoxCPM 先合成语音,H3 再按锁定的语音生成说话画面。
配图
仅收录(18)
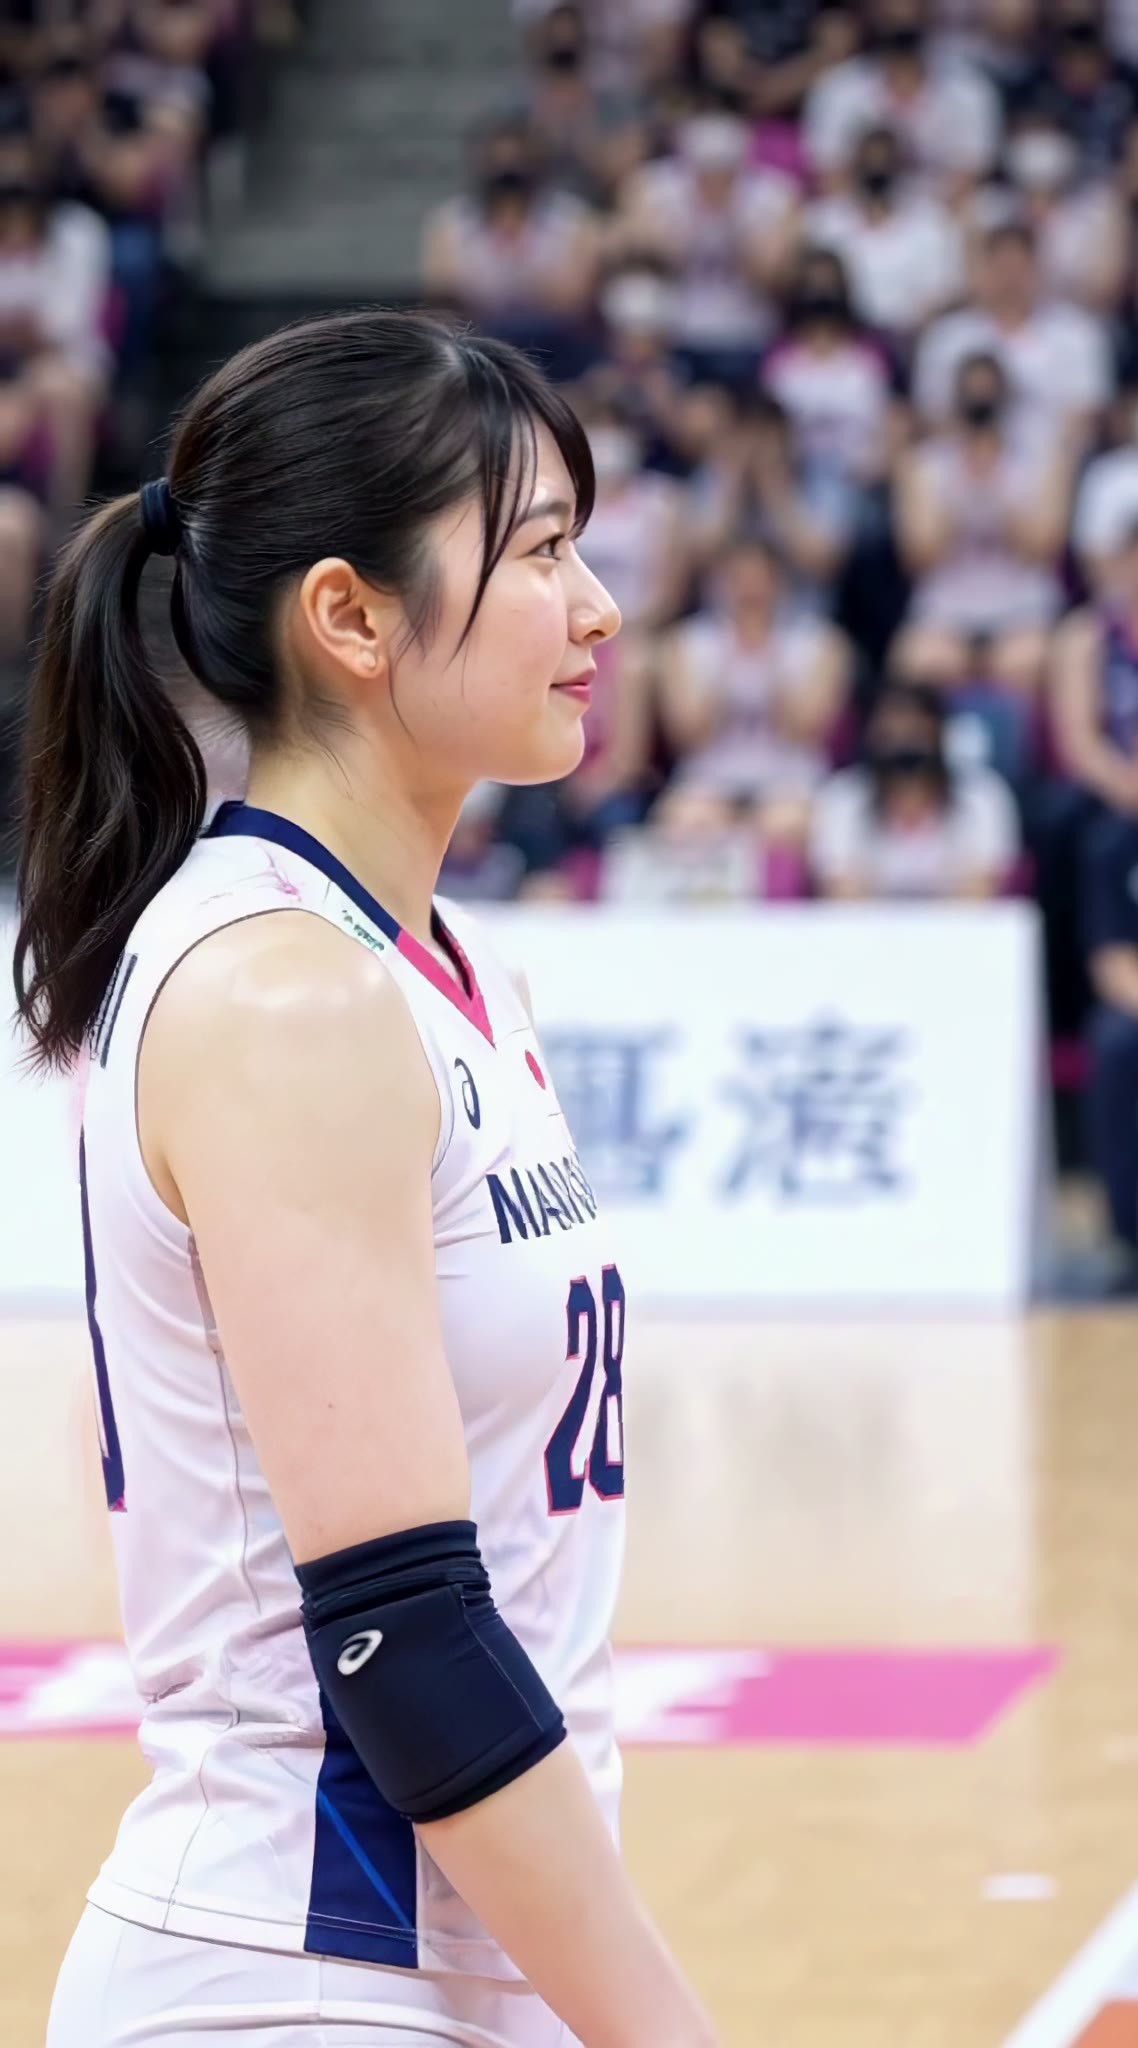
- AI Girl: Fictional Women Series39 / 架空の女性シリーズ39 MiniMax H3 · v1.0 — LoRA:shimeaji_RTX 的虚构人物系列第 39 号:一个虚构的日本女排球运动员角色 LoRA。
- MiniMax H3 First-Frame Image-to-Video · v1.0 — 工作流:AIKSK 的 H3 首帧图生视频基础流程:一张图作起始帧,FL2VA bf16 底模、不带 LoRA,res_multistep + simple 20 步。
- MiniMax H3 Image-to-Video 6x Speedup - 48 GB Edition · v1.0 — 工作流:六倍加速图生视频的 48 GB 版:与 24 GB 版同一套 6 步 turbo-v4 采样,只把底模换成 FL2VA INT8 convrot、编码器换成 nvfp4_awq、视频 VAE 换 int8。
- MiniMax H3 Text-to-Video · v1.0 — 工作流:AIKSK 的 H3 文生视频基础流程:只有提示词输入,ImageToVideo 条件节点不接图当纯文生视频用,FL2VA bf16 底模 20 步。
- MiniMax H3 Reference-to-Video 6x Speedup - 48 GB Edition · v1.0 — 工作流:六倍加速参考生视频的 48 GB 版:与 24 GB 版同样是图 + 视频 + 音频三路参考、6 步 turbo-v4 采样,只把底模换成 Ref2VA INT8 convrot、编码器换 nvfp4_awq。
- catolf1 · v1 — LoRA:chibron 的角色 LoRA catolf1:标签只写“character”,说明只有名字本身,看不出是什么角色。
- MiniMax H3 Image-to-Video 6x Speedup - 80 GB Edition · v1.0 — 工作流:六倍加速图生视频的 80 GB 版:同一套 6 步 turbo-v4 采样,底模换成剪枝 INT8 convrot 的 FL2VA,编码器 nvfp4_awq、视频 VAE int8。
- R2V-02 Pure Video Reference · v1.0 — 工作流:AIKSK 的 R2V-02 纯视频参考:动作和节奏取自一段参考视频而不是静帧,Video Slice 决定用哪一段。
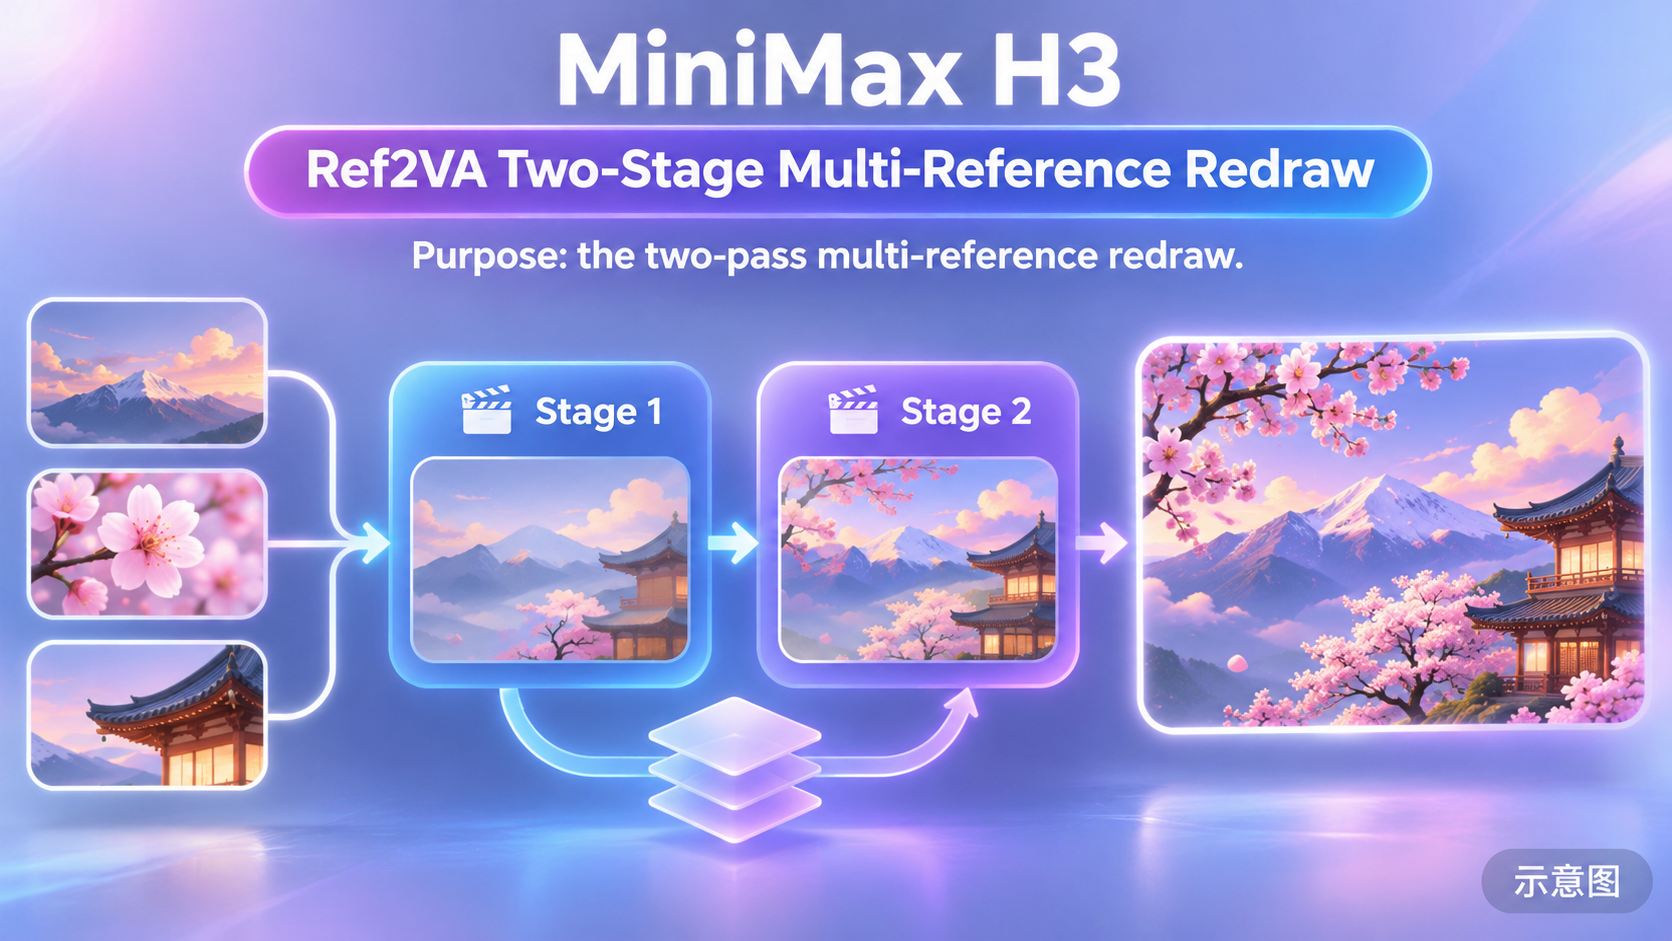
- MiniMax H3 Ref2VA Two-Stage Multi-Reference Redraw · v1.0 — 工作流:三段式多参重绘的省钱版:多参考图生成后只做一次 RTX 像素放大,第二段按放大后尺寸重新条件化、4 步低降噪精修。
- R2V-04 Character Image + Standalone Audio · v1.0 — 工作流:R2V 系列第 4 条:角色图 + 独立音频生视频,四个图片位加一段裁剪过的音频、不接参考视频;与 R2V 1 号几乎是同一张图,只是画幅改成 9:16 竖屏。
- MiniMax H3 First-and-Last-Frame Video · v1.0 — 工作流:AIKSK 第 288 期的 H3 首尾帧生视频基础版:两张图分别定开头和结尾,H3 补中间的运动,不加 LoRA、20 步。
- MiniMax H3 Last-Frame Image-to-Video · v1.0 — 工作流:AIKSK 第 288 期的 H3 尾帧图生视频基础版:给一张图作为结尾画面,让视频收束到这张图;同一文件并排两条分支,分别出 10 秒和 5 秒。
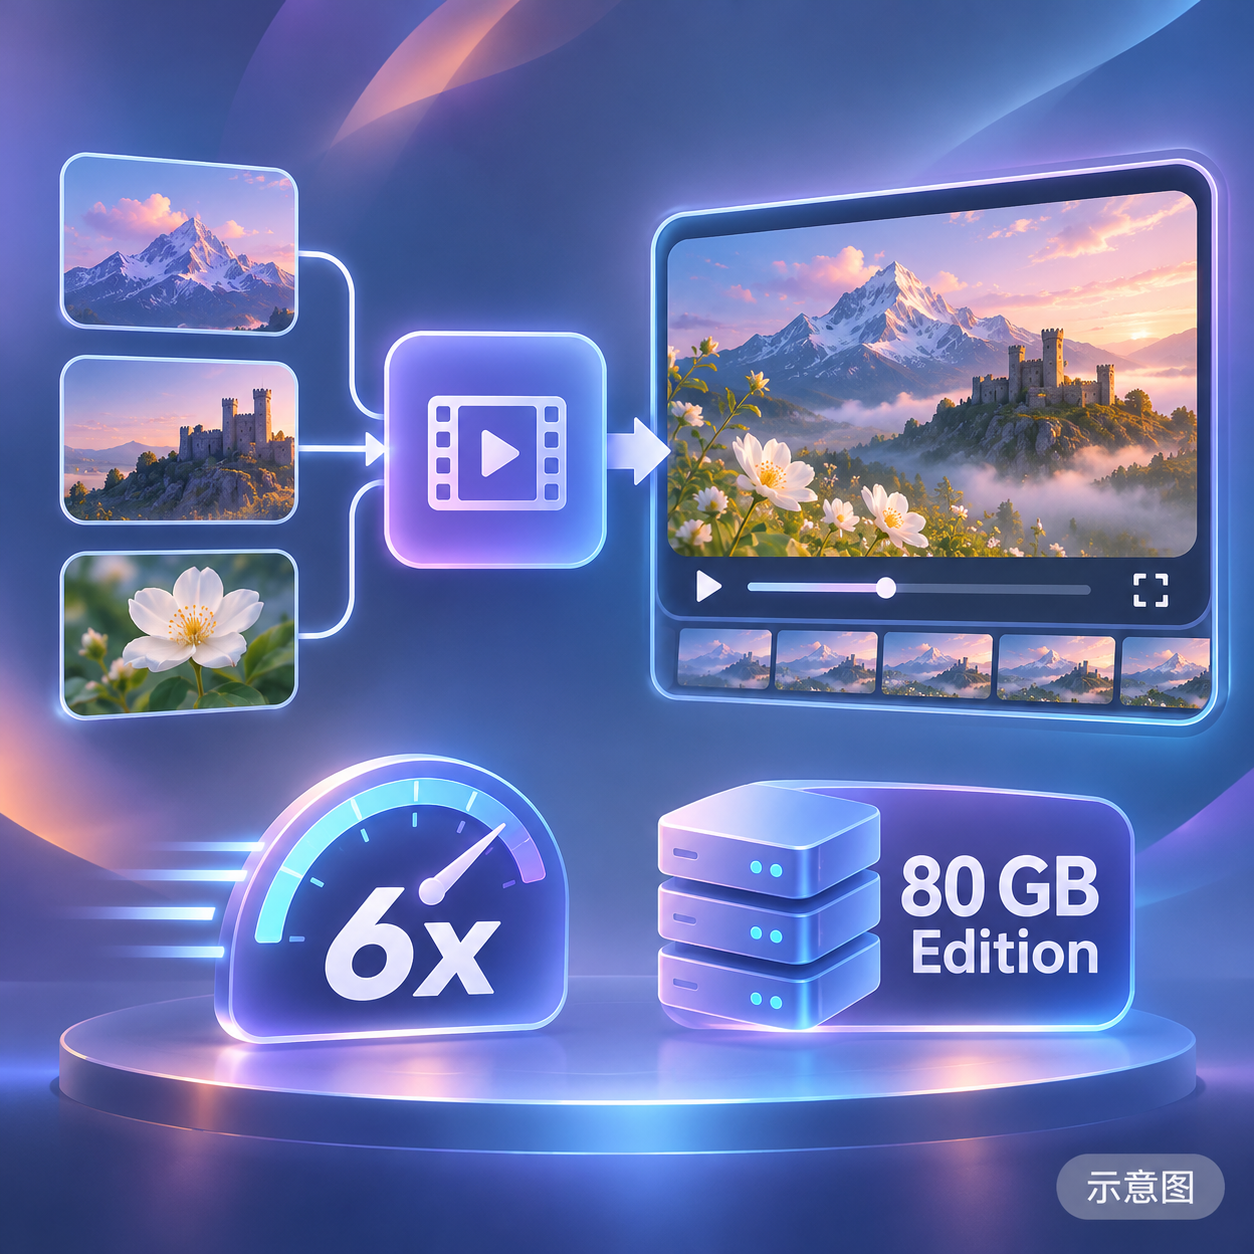
- MiniMax H3 Reference-to-Video 6x Speedup - 80 GB Edition · v1.0 — 工作流:AIKSK 第 291 期“6 倍加速”系列的参考生视频 80 GB 档:图 + 视频 + 音频三路参考,Ref2VA 剪枝 INT8 底模配 turbo-v4 LoRA,euler + beta 只跑 6 步。
- Prompt Studio — Give Your AI Creations a Memory · v1.21 — 其他:一个本地 Windows 提示词与作品归档工具(不是模型、本身不生成画面),v1.21 新增灯光示意球、人物与猫狗摆姿、图片/视频/声音工作台等规划工具;对 H3 没有专门适配。
- Elizabeth WhiteMoon · MiniMaxH3 — LoRA:虚构角色 Elizabeth WhiteMoon 的人物 LoRA 的 H3 版,用来在视频里生成这位图书馆学者造型的女性角色。
- R2V-03 Character Image + Motion Video · v1.0 — 工作流:R2V 系列第 3 条:角色图定长相、参考视频给动作(动作迁移),另带一个音频输入位,但卡上没写清音频走哪条分支。
- MiniMax H3 Larry + Attention + Cache Full Acceleration · v1.0 — 工作流:第 291 期加速系列的“全血”测试台:三条并排分支在同一 FL2VA INT8 底模 + turbo-v4 LoRA(6 步)上叠加注意力和缓存补丁。
- MiniMax H3 Larry + SageAttention Acceleration · v1.0 — 工作流:第 291 期加速系列的 SageAttention 测试台:四条并排分支共用 FL2VA INT8 底模和 turbo-v4 LoRA(6 步),差别在每条外面接的注意力 / 缓存补丁。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-02 20:31 → 11-03 09:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。