정정(貞貞)의 AI 레이더 · MiniMax H3 · 2026-11-03 모닝 브리프
이번 호 33개 신규 버전: 강력 추천 0 · 추천 2 · 주목할 만함 13 · 단순 수록 18
편집자 주 이번 호에서는 33개의 H3 신규 버전을 검토했으며, 그중 AIKSK는 한 번에 20개 이상의 워크플로우를 공개했습니다. 최우선 추천은 Hand Tie Clips 3.4입니다: 여러 개의 H3 클립을 1분 이상의 롱폼으로 연결하며, 새로운 sand_tie 연결 방식을 도입하여 전체 클립을 하나의 비디오로 렌더링하여 이음새가 없습니다. 또 다른 A급 추천은 UCHIJ의 Ref2VA 립싱크 v2.0로, 사용자의 오디오로 참조 기반 비디오 생성을 구동합니다. AIKSK 시리즈 중 양자화 단계만 변경한 48/80GB 버전, 새로운 기능이 없는 기본 템플릿, 그리고 GPU 간 차이를 명확히 설명할 수 없는 R2V 변형은 C급으로 격하했으며, 리스크 항목에 '24GB 버전이 오히려 bf16 전체 정밀도'라는 명칭 문제를 명시했습니다. 일반적인 인물 LoRA와 범용 프롬프트 도구는 C급으로 분류했습니다.
추천 (2)
【A】Hand Tie Clips — 멀티홉 MiniMax H3 비디오 + 오디오, 단일 큐 처리 · v3.4
워크플로우 · 버전 업데이트 · 작성자 sandpies · 게시일 11-03 00:25 · 다운로드 수 44
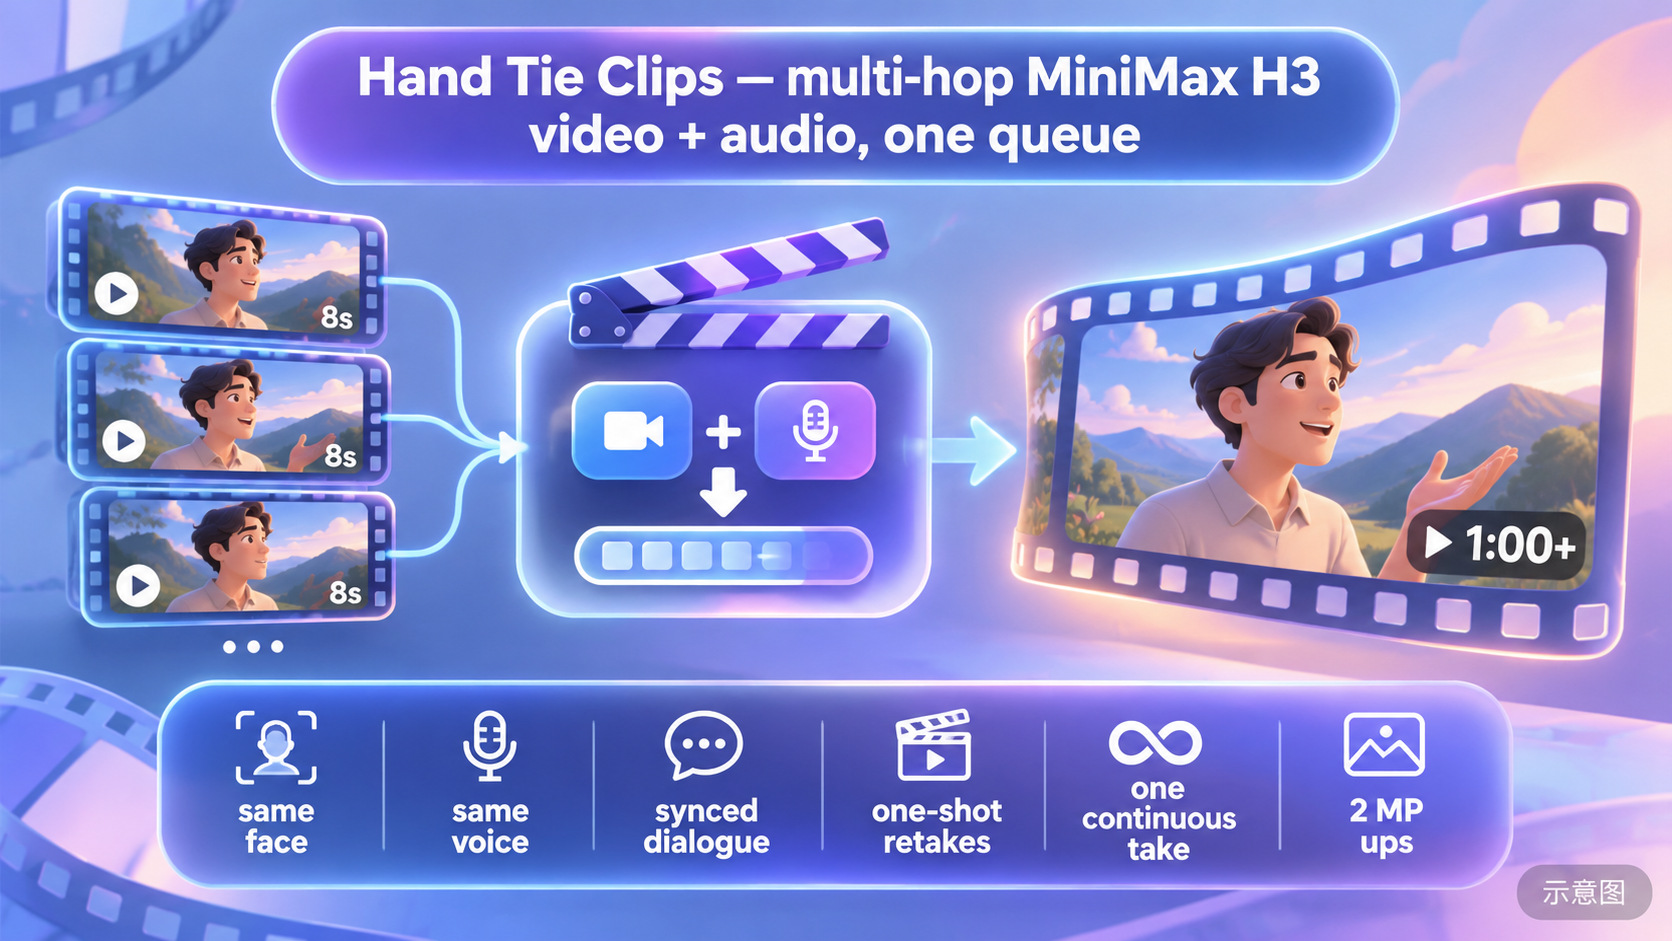
Hand Tie Clips 3.4: 여러 개의 H3 클립을 1분 이상의 롱폼으로 연결하는 커스텀 노드 팩으로, 이번 버전에서는 sand_tie '원테이크' 연결 방식이 추가되어 전체 클립이 하나의 비디오로 렌더링되며 이음새가 보이지 않습니다.
이번 호에서 가장 완성도 높은 롱폼 솔루션입니다. 새 버전의 가치는 다중 클립 연결 시의 이음새를 제거한 데 있으며, 짧은 노래나 두 사람 간의 대화로 sand_tie를 먼저 테스트해 보는 것이 좋습니다.
이미지
추천 이유
- 버전 업데이트: 새로운 연결 방식인 sand_tie를 통해 일련의 홉(hop)을 하나의 비디오로 렌더링하며, anchor: restart가 명시된 부분에서만 전환됩니다. 특정 홉만 다시 생성하고 나머지는 유지할 수 있으며, 긴 샷이 점점 밝아지는 것을 방지하는 tone_lock이 추가되었습니다. 증폭기는 원거리의 작은 얼굴을 클로즈업으로 다시 그리며, 롱폼 처리 시 메모리 오버플로우 문제를 수정했습니다. 스크립트 어시스턴트에는 여러 사람이 동시에 말하거나, 먹으면서 말하거나, 서라운드 카메라 워크 등의 규칙이 보완되었습니다.
- 롱폼 비디오 및 대화 지원: 동일한 캐릭터와 동일한 음성이 여러 샷에 걸쳐 지속됩니다. 참조 패널에 캐릭터/장면 정지 이미지와 음성 클립을 배치하고 @tag로 스케줄링할 수 있습니다. 또한 캐릭터/머리 교체 SWAP 모드와 내장된 2MP 업스케일링 기능이 있습니다.
- 이전 이미지 저장 시에도 로드 가능: 세 가지 연결 방식(기본 motion_context, 새로운 sand_tie, 실험적 hand_tie)은 각각 적용 범위가 다르며, 작성자는 각 방식의 한계와 권장 전환 지점을 문서화했습니다.
- 무료: 이번 버전은 44회 다운로드, 전체 모델은 1207회 다운로드되었습니다(관심도만 반영).
사용 방법
- ComfyUI/custom_nodes 디렉터리에서 작성자 저장소를 git clone하고, 재시작 후 브라우저를 강제 새로고침한 뒤 workflows/HandTieClips_Starter.json을 드래그하여 로드합니다. REFS의 첫 번째 줄에 캐릭터 사진을 배치하고, SCRIPT에 스토리보드를 작성한 후 큐에 넣습니다.
- 롱 샷의 경우 pin_mech: sand_tie를 선택해야 하며, 비교적 최신 버전의 ComfyUI가 필요합니다. 작성자는 Wuli 8단계 Turbo DiT, 3D 잠재 공간 증폭기, Open-H3-Regenerate-2K LoRA를 권장하며, 속도 관련 노드는 PlagueKind / KJNodes를 사용합니다.
리스크 및 제한 사항
- 이번 버전의 3개 예시 비디오는 모두 숨겨져 있어 Civitai 페이지에서 화면을 볼 수 없습니다. 작성자가 언급한 2:03개 단일 샷 MV, 52초 두 사람 장면 등의 데모는 외부 링크에 있으며 검증되지 않았습니다.
- sand_tie는 ComfyUI v0.38.0 이상과 0.9초의 오버랩이 필요합니다. tone_lock 단계 0.5 / 0.75 / full은 전체 모델 카드에만 명시되어 있습니다.
- 의존성이 많습니다(Turbo DiT, 증폭기, Regenerate LoRA, 선택적 로컬 LLM 스크립트 작성). 이 항목은 실행되지 않았습니다.
- 카드 이미지는 AI 생성 개념도이며 모델의 실제 결과가 아닙니다. 작성자는 공개된 일반 수준 예시를 제공하지 않았습니다.
【A】MiniMax H3 ref2va - 립싱크 + 터보 (v2.0) · MiniMax H3 Ref2VA v2.0
워크플로우 · 버전 업데이트 · 작성자 UCHIJ · 게시일 11-02 21:21 · 다운로드 수 48
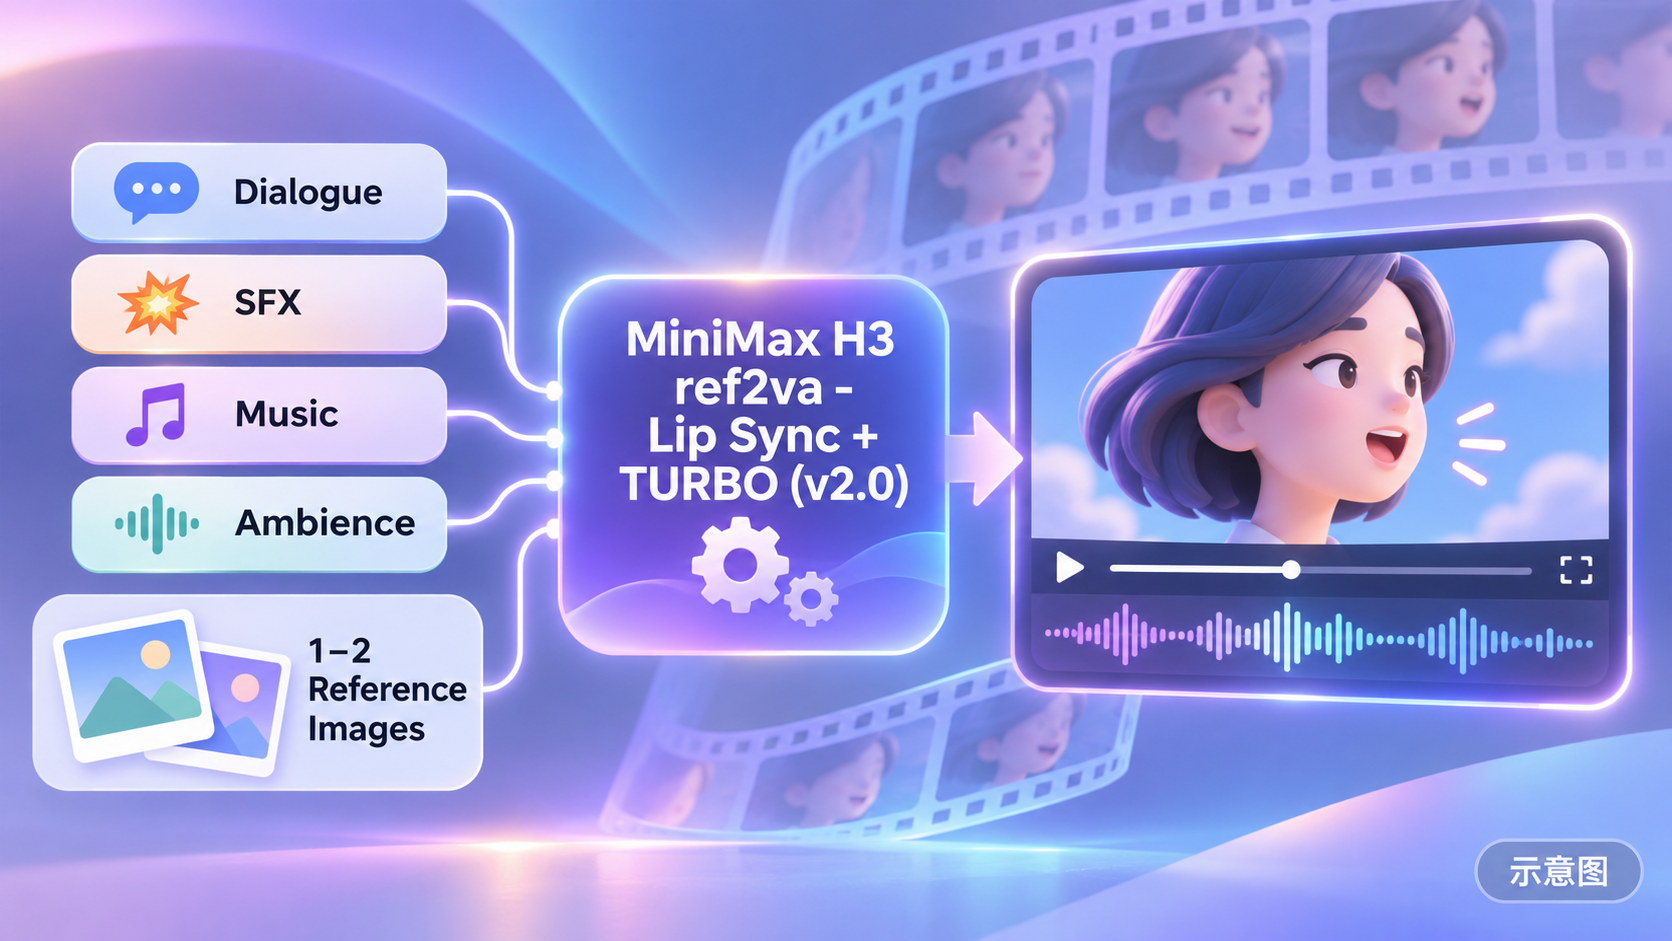
사용자의 오디오로 H3 Ref2VA를 구동하는 워크플로우 v2.0: 1~2장의 참조 이미지 + 대화/효과음/음악 클립 + 프롬프트로 비디오를 생성하며, 오디오는 최종 트랙으로 그대로 사용되고, 선택적으로 Turbo LoRA가 단계 수를 자동으로 매칭합니다.
핵심 노드만으로 오디오 구동이 가능하며, 이번 호에서 가장 진입 장벽이 낮은 립싱크 솔루션입니다.
이미지
추천 이유
- 버전 업데이트: Audio Start(오디오의 임의 지점에서 시작하여 비디오 길이에 맞춰 자동 크롭)가 추가되었습니다. 두 번째 참조 이미지가 추가되어 프롬프트에서 <Picture 1> / <Picture 2>를 사용합니다. 기본 길이는 테스트 실행을 쉽게 하기 위해 5초로 변경되었습니다. 로드 노드 이름이 변경되고 내장 설명이 동기 업데이트되었습니다.
- 립싱크 및 오디오 구동 지원: 워크플로우가 프롬프트에 자동으로 <Audio 1>: fully_copy를 추가하여 모델이 사용자의 오디오를 스타일 참조가 아닌 최종 트랙으로 인식하도록 합니다. 더 느슨한 추종을 원한다면 Audio Guidance 문자열 노드를 수정하십시오.
- Turbo 스위처는 LoRA 파일 이름의 4step / 8step에 따라 단계 수를 자동으로 설정하며, Turbo를 끄면 약 20단계의 전체 기본 모델을 실행합니다. ComfyUI 핵심 노드만 사용하며 커스텀 노드 팩이 필요 없습니다.
- 무료: 이번 버전은 48회 다운로드, 전체 모델은 623회 다운로드되었습니다(관심도만 반영).
사용 방법
- minimax_h3_ref2va_pruned_int8_convrot 기본 모델, Qwen3-VL nvfp4_awq 텍스트 인코더, 비디오 및 오디오 VAE 두 개(정밀도는 작성자 목록 참조)가 필요합니다. Turbo LoRA는 선택 사항이며 파일 이름에 4step 또는 8step이 포함되어야 합니다.
- 참조 이미지(두 번째는 비워도 됨)와 오디오를 업로드하고, Audio Start, 해상도, 길이 및 프레임 속도를 설정합니다. 프롬프트에서 <Picture 1>, <Audio 1>를 사용하여 입력을 지칭합니다.
리스크 및 제한 사항
- 1개의 예시만 있으며 숨겨져 있어 립싱크 효과를 볼 수 없습니다.
- 작성자는 낮은 단계 수에서 노이즈가 발생할 경우 콘솔의 'lora key not loaded' 메시지를 확인해야 한다고 경고합니다. Turbo LoRA가 ref2va 기본 모델과 호환되지 않을 수 있습니다. 시작/끝 프레임 제어가 없으며, 단일 실행 시 약 15초의 상한이 있고 다중 클립 연결은 지원하지 않습니다.
- 오디오 길이는 시작점 + 길이 이상이어야 합니다. 이 항목은 실행되지 않았습니다.
- 카드 이미지는 AI 생성 개념도이며 모델의 실제 결과가 아닙니다. 작성자는 공개된 일반 수준 예시를 제공하지 않았습니다.
주목할 만함 (13)
【B】MiniMax H3 참조 기반 비디오 생성 6배 가속 - 24GB 에디션 · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-03 00:26 · 다운로드 수 29
6배 가속 시리즈의 참조 기반 비디오 생성 24GB 버전: 이미지 한 장, 비디오 한 클립, 오디오 한 클립을 동시에 참조로 사용하며, Ref2VA bf16 기본 모델 + turbo-v4 LoRA로 6단계를 실행합니다.
이미지
【B】MiniMax H3 Ref2VA 3단계 2K 다중 참조 리드로우 · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-02 23:18 · 다운로드 수 30
AIKSK의 Ref2VA 3단계 다중 참조 이미지 리드로우: 첫 번째 단계에서 다중 참조 이미지로 생성한 후, 두 번의 픽셀 공간 RTX ×1.5 업스케일링을 거치며, 각 단계는 새로운 크기에 맞춰 재조건화되고 4단계 Turbo LoRA로 낮은 노이즈 감소 정밀 보정을 수행하여 2K를 목표로 합니다.
이미지
【B】MiniMax H3 이미지 기반 비디오 생성 6배 가속 - 24GB 에디션 · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-03 00:23 · 다운로드 수 26
AIKSK '6배 가속' 시리즈의 이미지 기반 비디오 생성 24GB 버전: FL2VA bf16 전체 정밀도 기본 모델 + turbo-v4 LoRA, euler + beta로 6단계만 실행하여 이미지 한 장으로 비디오를 생성합니다.
이미지
【B】R2V-06 캐릭터 이미지 + 모션 비디오 + 신규 오디오 · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-03 00:00 · 다운로드 수 21
AIKSK의 R2V-06: 캐릭터 이미지로 신원을 정의하고, 모션 비디오로 동작을 제공하며, 완전히 새로운 오디오 클립을 추가로 설정하여 음성이 변경된 캐릭터 비디오를 생성합니다.
이미지
【B】MiniMax H3 LightX2V 터보 가속 · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-03 00:25 · 다운로드 수 21
6배 가속 시리즈의 LightX2V 경로: 단일 이미지 기반 비디오 생성, 가지치기된 INT8 기본 모델 + LightX2V 4단계 Turbo LoRA(강도 0.75), er_sde + simple로 4단계만 실행합니다.
이미지
【B】MiniMax H3 범용 비디오 HD 리드로우 (단일 패스 업스케일) · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-02 23:20 · 다운로드 수 27
AIKSK의 범용 비디오 HD 리드로우: 임의의 비디오 클립을 업스케일링한 후 잠재 공간을 H3에 주입하여, 4단계 낮은 노이즈 감소(0.65)로 단일 패스 리드로우를 수행하여 디테일을 보강하고, 원본 동작, 구도, 카메라 워크 및 원본 오디오 트랙을 유지합니다.
이미지
【B】MiniMax H3 FL2VA 2단계 업스케일(첫/마지막 프레임) · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 23:18 · 다운로드 17
AIKSK의 H3 첫/마지막 프레임 2단계 업스케일 워크플로우: 첫 번째와 마지막 두 이미지를 먼저 8단계 터보 LoRA로 생성한 후, 픽셀 공간 RTX 업스케일링을 거치고, 업스케일링된 실제 크기에 따라 조건을 재설정하여 4단계 터보 LoRA로 저노이즈 정밀 보정을 수행합니다.
예시 이미지
【B】R2V-01 다중 이미지 참조 · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 23:57 · 다운로드 24
AIKSK 제 288기 H3 올모달(All-Modal) 참조 기반 영상 생성 시리즈의 R2V 1호: 4장의 정적 이미지로 인물과 소품을 확정하고, 별도의 오디오를 연결해 연기를 구동하며, LoRA를 추가하지 않은 20단계 기본 샘플링을 통해 가로형 영상을 출력합니다.
예시 이미지
【B】MiniMax H3 디지털 휴먼 - 2인 대화 · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 22:19 · 다운로드 20
AIKSK의 H3 2인 대화 디지털 휴먼 워크플로우: 두 캐릭터에 각각 이미지 한 장과 오디오 한 개를 제공하며, 두 오디오를 자르고 공백을 채운 후 하나의 타임라인으로 병합하여 고정하고, H3는 이에 부합하는 2인 연기 화면만 생성합니다.
예시 이미지
【B】MiniMax H3 INT8 W4A8 가속 · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-03 00:24 · 다운로드 19
제 291기 가속 시리즈의 정량적 비교 파일: 한 파일에 세 개의 나란한 이미지-투-비디오 브랜치가 있으며, W4A8 혼합 양자화 및 가지치기 기반 모델과 두 개의 INT8 convrot 기반 모델을 비교합니다. 모두 LoRA를 적용하지 않고 전체 20 단계를 유지합니다.
예시 이미지
【B】R2V-05 캐릭터 이미지 + 비디오 + 페어링된 오디오 · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-03 00:00 · 다운로드 20
R2V 시리즈의 5번째 항목: 캐릭터 이미지 + 참조 비디오 + 비디오에 포함된 원본 오디오; 참조 클립에서 화면과 페어링된 오디오를 분리하여 함께 조건으로 사용하며, 자신의 캐릭터로 교체하고 원본 영상의 소리를 그대로 사용합니다.
예시 이미지
【B】MiniMax H3 Larry 터보 가속 · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-03 00:25 · 다운로드 15
가속 시리즈의 291번째 에피소드에서 가장 간결한 이미지 하나: 단일 이미지에서 영상 생성, FL2VA 가지치기 INT8 기본 모델 + turbo-v4 LoRA(강도 1), euler + beta 6 단계, 노드는 단 21개뿐입니다.
예시 이미지
【B】MiniMax H3 + VoxCPM 디지털 휴먼 - 단일 캐릭터 · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 22:18 · 다운로드 18
AIKSK의 H3 + VoxCPM 단일 캐릭터 디지털 휴먼 워크플로우: 캐릭터 이미지 한 장 + VoxCPM 참조 음색 한 개를 제공하고, 대본을 작성하면 VoxCPM이 먼저 음성을 합성하고, H3는 고정된 음성에 따라 말하는 화면을 생성합니다.
예시 이미지
아카이브 전용 (18)
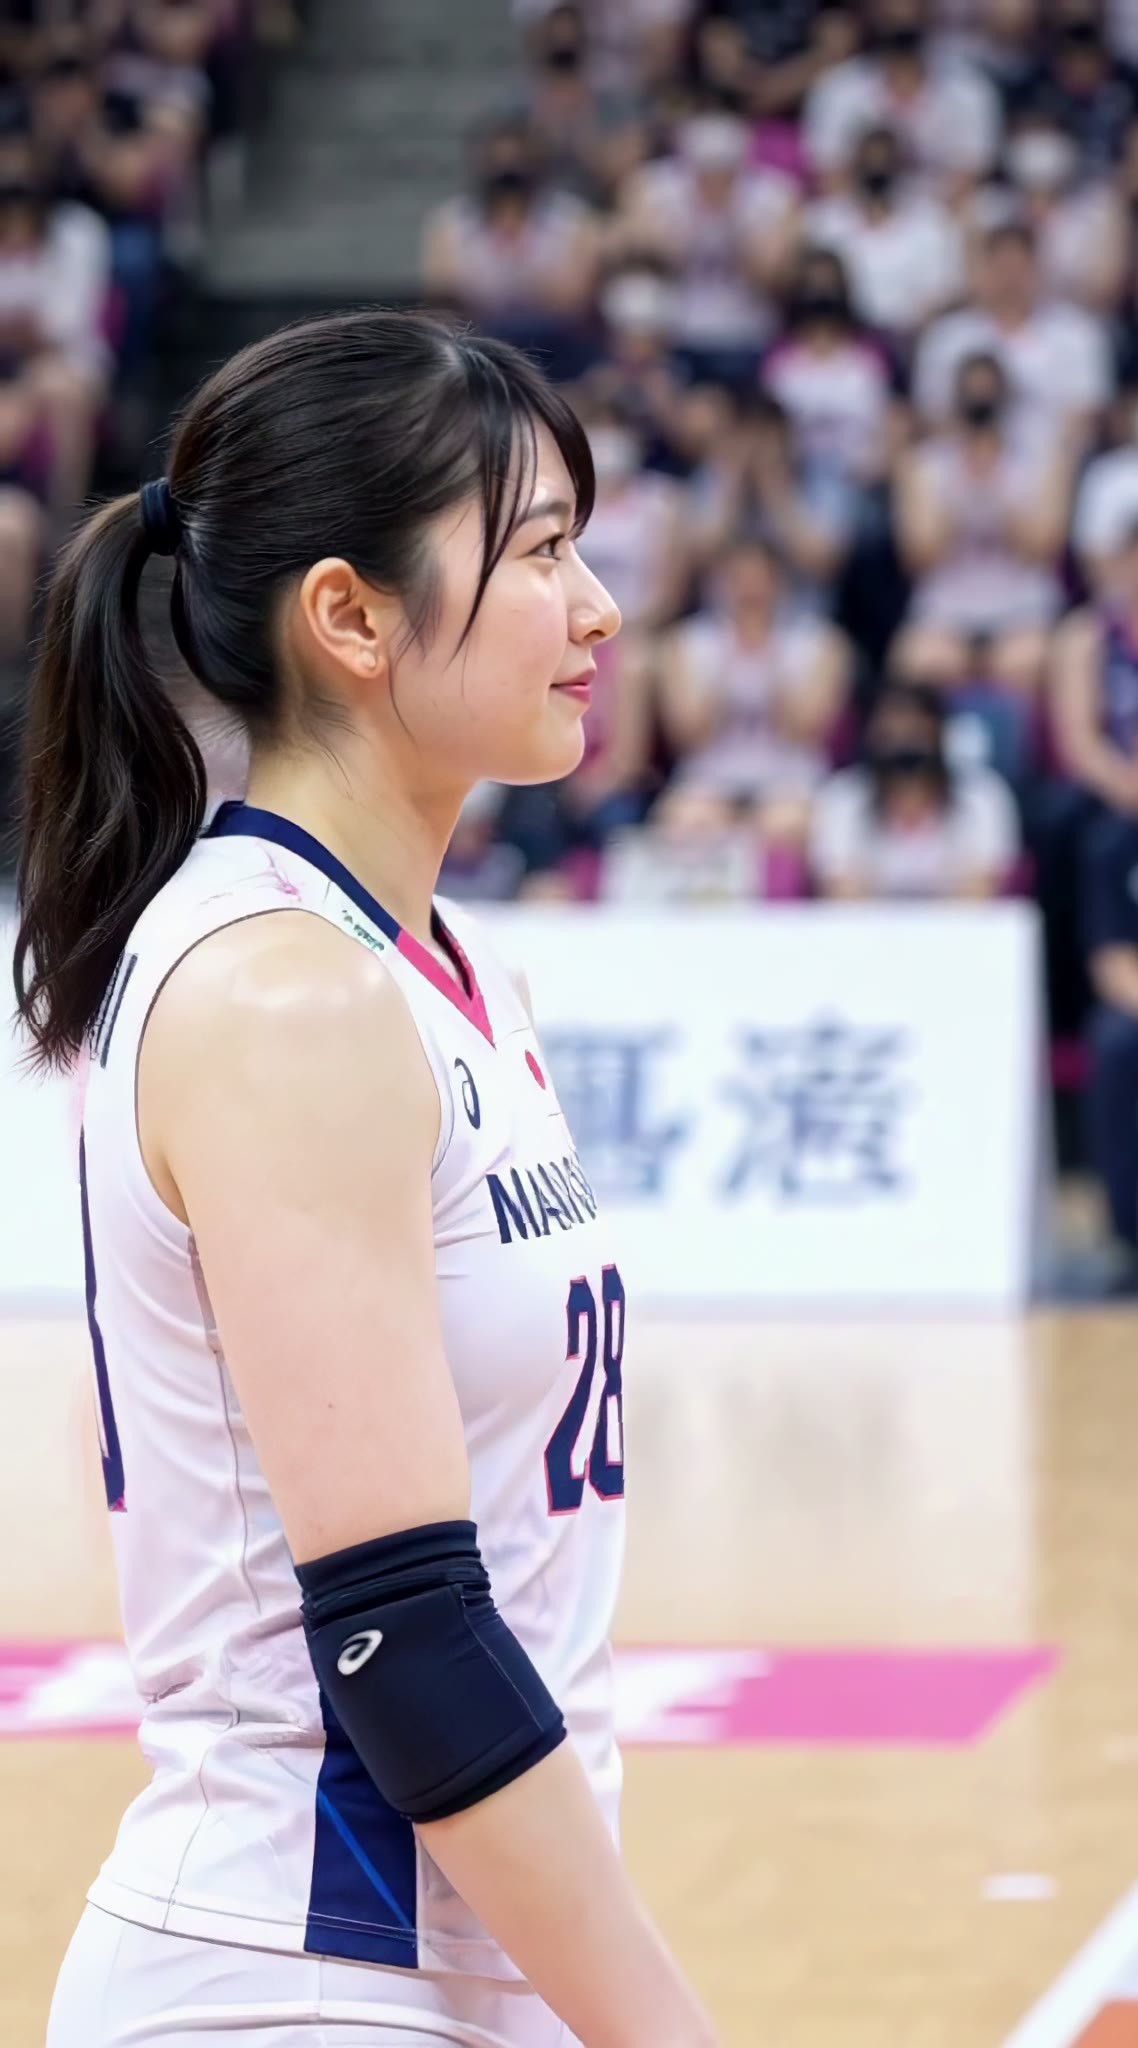
- AI Girl: Fictional Women Series39 / 가상의 여성 시리즈39 MiniMax H3 · v1.0 — LoRA: shimeaji_RTX의 가상 인물 시리즈 제 39 호: 가상 일본인 여자 배구 선수 캐릭터 LoRA.
- MiniMax H3 First-Frame Image-to-Video · v1.0 — 워크플로우: AIKSK의 H3 첫 프레임 이미지 투 비디오 기본 프로세스: 한 장의 이미지를 시작 프레임으로 사용하며, FL2VA bf16 베이스 모델과 LoRA 미사용, res_multistep + simple 20 스텝을 적용합니다.
- MiniMax H3 Image-to-Video 6x Speedup - 48 GB Edition · v1.0 — 워크플로우: 6배 가속 이미지 투 비디오의 48 GB 버전: 24 GB 버전과 동일한 6 스텝 turbo-v4 샘플링을 사용하되, 베이스 모델을 FL2VA INT8 convrot로, 인코더를 nvfp4_awq로, 비디오 VAE를 int8로 교체했습니다.
- MiniMax H3 Text-to-Video · v1.0 — 워크플로우: AIKSK의 H3 텍스트 투 비디오 기본 프로세스: 프롬프트 입력만 사용하며, ImageToVideo 조건 노드에 이미지를 연결하지 않아 순수 텍스트 기반 비디오 생성으로 동작합니다. FL2VA bf16 베이스 모델과 20 스텝을 사용합니다.
- MiniMax H3 Reference-to-Video 6x Speedup - 48 GB Edition · v1.0 — 워크플로우: 6배 가속 레퍼런스 투 비디오의 48 GB 버전: 24 GB 버전과 마찬가지로 이미지 + 비디오 + 오디오 3가지 레퍼런스를 사용하며, 6 스텝 turbo-v4 샘플링을 적용합니다. 다만 베이스 모델을 Ref2VA INT8 convrot로, 인코더를 nvfp4_awq로 교체했습니다.
- catolf1 · v1 — LoRA: chibron의 캐릭터 LoRA catolf1: 태그가 'character'로만 기재되어 있어 이름 자체는 알 수 있으나, 어떤 캐릭터인지는 명확하지 않습니다.
- MiniMax H3 Image-to-Video 6x Speedup - 80 GB Edition · v1.0 — 워크플로우: 6배 가속 이미지 투 비디오의 80 GB 버전: 동일한 6 스텝 turbo-v4 샘플링을 사용하며, 베이스 모델을 가지치기(pruning)된 INT8 convrot FL2VA로 교체했습니다. 인코더는 nvfp4_awq, 비디오 VAE는 int8입니다.
- R2V-02 Pure Video Reference · v1.0 — 워크플로우: AIKSK의 R2V-02 순수 비디오 레퍼런스: 정지 프레임이 아닌 참조 비디오에서 동작과 리듬을 가져오며, Video Slice 노드가 사용할 구간을 결정합니다.
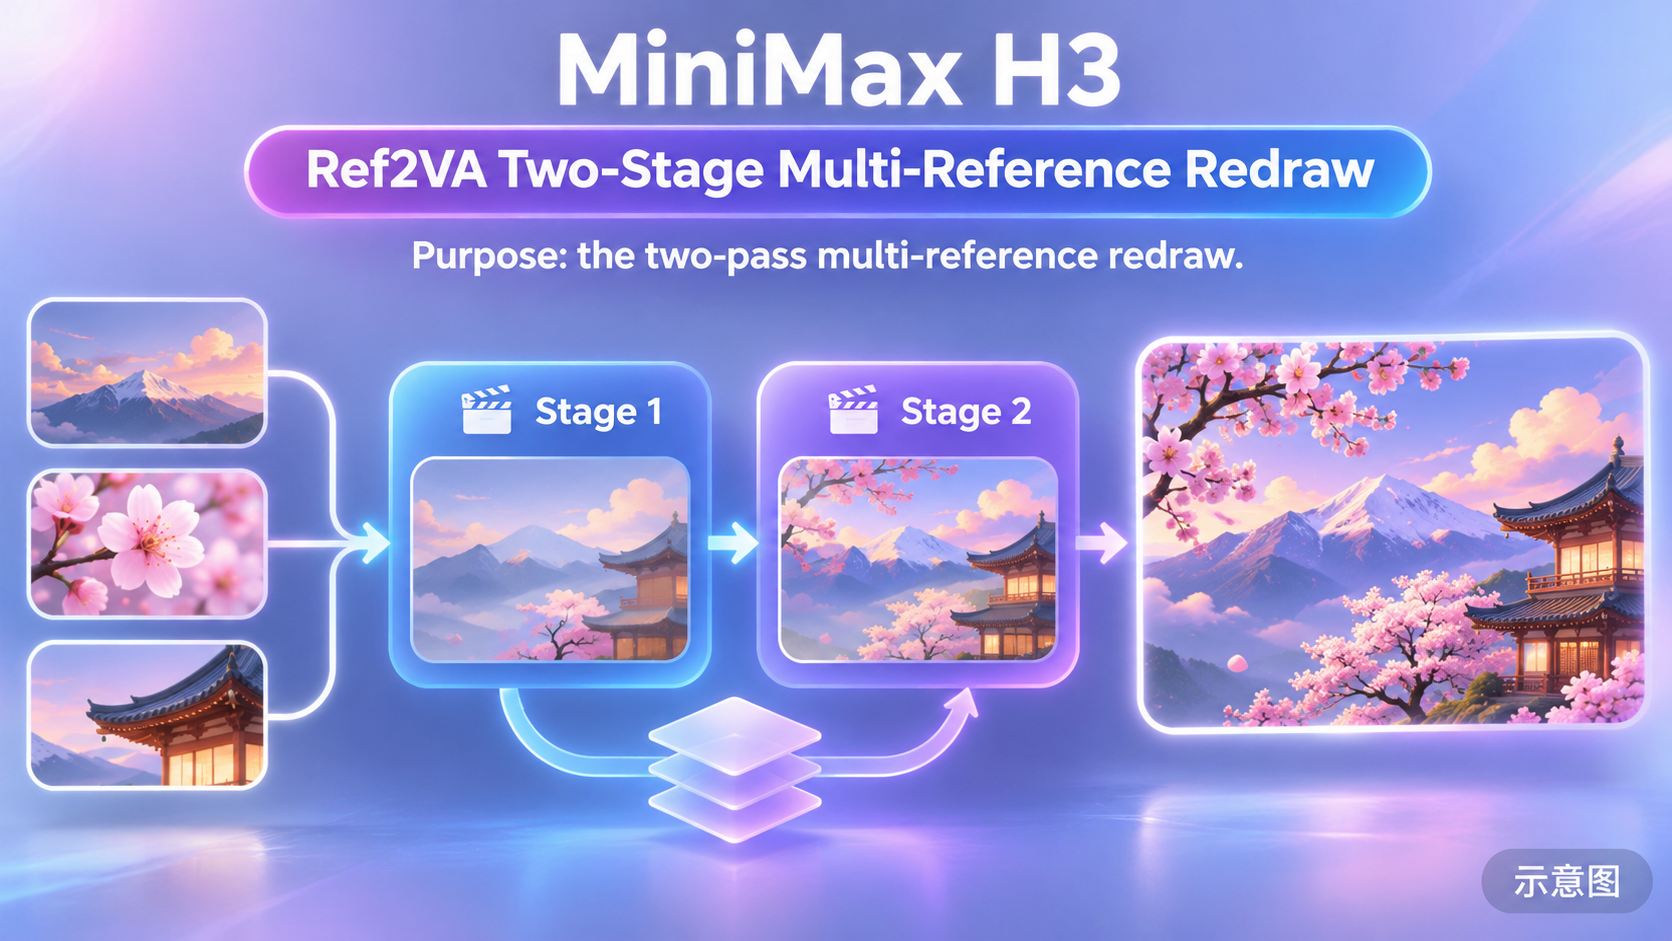
- MiniMax H3 Ref2VA Two-Stage Multi-Reference Redraw · v1.0 — 워크플로우: 3단계 다중 레퍼런스 리드로우의 절감 버전: 다중 참조 이미지 생성 후 RTX 픽셀 업스케일링을 한 번만 수행하며, 두 번째 단계에서는 업스케일된 크기에 맞춰 조건화하고 4 스텝의 낮은 노이즈 감소로 정밀하게 수정합니다.
- R2V-04 Character Image + Standalone Audio · v1.0 — 워크플로우: R2V 시리즈의 4 번째 항목: 캐릭터 이미지와 독립적인 오디오로 비디오를 생성하며, 4개의 이미지 슬롯과 잘라낸 오디오 한 개를 연결하고 참조 비디오는 사용하지 않습니다. R2V 1 호와 거의 동일한 구성이지만, 화면 비율이 9:16 세로형으로 변경되었습니다.
- MiniMax H3 First-and-Last-Frame Video · v1.0 — 워크플로우: AIKSK의 288 번째 H3 첫 및 마지막 프레임 투 비디오 기본 버전: 두 장의 이미지로 시작과 끝을 정의하고, H3가 중간 동작을 생성합니다. LoRA는 사용하지 않으며 20 스텝을 적용합니다.
- MiniMax H3 Last-Frame Image-to-Video · v1.0 — 워크플로우: AIKSK의 288 번째 H3 마지막 프레임 이미지 투 비디오 기본 버전: 한 장의 이미지를 끝 화면으로 지정하여 비디오가 해당 이미지로 수렴하도록 합니다. 동일한 파일 내에서 두 개의 분기가 나란히 배치되어 있으며, 각각 10초와 5초 길이의 영상을 생성합니다.
- MiniMax H3 Reference-to-Video 6x Speedup - 80 GB Edition · v1.0 — 워크플로우: AIKSK의 291 번째 '6배 가속' 시리즈 중 레퍼런스 투 비디오 80 GB 버전: 이미지 + 비디오 + 오디오 3가지 레퍼런스를 사용하며, Ref2VA 가지치기 INT8 베이스 모델에 turbo-v4 LoRA를 조합하고 euler + beta 샘플러로 6 스텝만 실행합니다.
- Prompt Studio — Give Your AI Creations a Memory · v1.21 — 기타: 로컬 Windows용 프롬프트 및 작품 아카이빙 도구(모델이 아니며 자체적으로 이미지를 생성하지 않음). v1.21에서는 조명 시뮬레이션 공, 인물 및 고양이/개 포즈, 이미지/비디오/사운드 워크벤치 등 계획 도구가 추가되었습니다. H3에 대한 전용 호환성은 없습니다.
- Elizabeth WhiteMoon · MiniMaxH3 — LoRA: 가상 캐릭터 Elizabeth WhiteMoon의 인물 LoRA의 H3 버전으로, 비디오에서 도서관 학자 스타일의 여성 캐릭터를 생성하는 데 사용됩니다.
- R2V-03 Character Image + Motion Video · v1.0 — 워크플로우: R2V 시리즈의 3 번째 항목: 캐릭터 이미지로 외형을 정의하고 참조 비디오로 동작(동작 전이)을 제공하며, 오디오 입력 슬롯이 하나 더 포함되어 있지만 카드 설명에는 오디오가 어떤 분기로 처리되는지 명확히 기재되지 않았습니다.
- MiniMax H3 Larry + Attention + Cache Full Acceleration · v1.0 — 워크플로우: 291 번째 가속 시리즈의 '풀 옵션' 테스트 벤치: 세 개의 나란한 분기가 동일한 FL2VA INT8 베이스 모델 + turbo-v4 LoRA(6 스텝) 위에서 어텐션 및 캐시 패치를 중첩하여 적용합니다.
- MiniMax H3 Larry + SageAttention Acceleration · v1.0 — 워크플로우: 291 번째 가속 시리즈의 SageAttention 테스트 벤치: 네 개의 나란한 분기가 FL2VA INT8 베이스 모델과 turbo-v4 LoRA(6 스텝)를 공유하며, 각 분기 외부에 연결된 어텐션 / 캐시 패치 구성이 다릅니다.
데이터: Civitai 공개 API(베이스 모델 MiniMax H3), 수집 기간 11-02 20:31 → 11-03 09:01(베이징 시간). 추천 이유는 편집자 검수를 거쳤으며, 다운로드 수는 관심도를 나타냅니다.