Radar AI của Trinh Trinh · Qwen Image 2.1 · Bản tin buổi tối 2026-11-02
Kỳ này có 4 phiên bản mới:强烈推荐 0 · 推荐 1 · 可关注 1 · 仅收录 2
Lời tựa của biên tập viên Kỳ này đã xem xét 4 phiên bản mới của Qwen 2.1. Ưu tiên hàng đầu là LoRA biểu cảm Q21 Emote: sử dụng cụm từ “make the woman + cảm xúc” để tạo ra các biểu cảm cụ thể, phục vụ truyện tranh và bảng biểu cảm nhân vật, tác giả tự nhận là bị overfitting và khuyến nghị sử dụng ở cường độ thấp. Quy trình làm việc tái tạo hình ảnh bằng lời nhắc thị giác của AIKSK có đầy đủ tham số nhưng phụ thuộc vào dịch vụ trực tuyến RunningHub, xếp hạng B; phiên bản Qwen 2.1 của LoRA chi tiết cơ giáp được tác giả tự đánh giá là kém nhất trong số các mô hình cơ sở, quy trình chuyển từ tạo ảnh bằng văn bản Qwen sang tạo video từ ảnh H3 chỉ có hai dòng mô tả, cả hai đều bị hạ xuống hạng C.
Đề xuất (1)
【A】Qwen 2.1 Emote Lora · Q21 Emote - V1
LoRA · Mô hình mới · Tác giả AirbagGuy · Phát hành 11-02 19:02 · Tải xuống 42
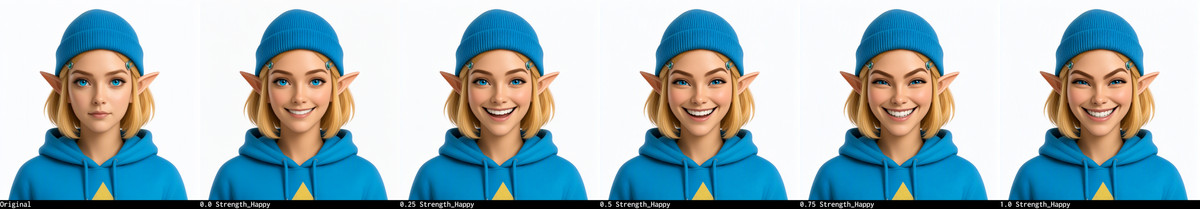
Một LoRA mẫu biểu cảm: sử dụng các cụm từ đơn giản như “make the woman + cảm xúc” để khiến Qwen 2.1 tạo ra các biểu cảm cụ thể (bực bội, xấu hổ, đảo mắt, nháy mắt, tạo hình miệng ah/oh, v.v.), được tác giả huấn luyện khi làm truyện tranh để thống nhất biểu cảm nhân vật.
Giữ hạng A: mục đích sử dụng cụ thể, cụm từ kích hoạt và khoảng cường độ đều có thể thực hiện theo, miễn phí và giấy phép rộng rãi; điểm trừ nằm ở việc tác giả tự nhận là bị overfitting và số lượng ví dụ hiển thị ít.
Hình ảnh minh họa
Lý do đề xuất
- Khả năng mới: thẻ mô hình liệt kê tất cả các biểu cảm và cụm từ kích hoạt tương ứng, có thể kết hợp trong lời nhắc và tinh chỉnh thêm; khoảng 3/5 tập dữ liệu huấn luyện là hình ảnh hoạt hình/anime, phần còn lại là hình ảnh thực tế, tác giả cho biết cả hai phong cách đều có thể sử dụng
- Phục vụ các nhiệm vụ yêu cầu tái tạo biểu cảm ổn định như phân cảnh truyện tranh, bảng biểu cảm nhân vật, so sánh nhiều cảm xúc của cùng một nhân vật
- Miễn phí, giấy phép cho phép bán và tạo tác phẩm phái sinh; phiên bản này có 42 lượt tải xuống, 5 lượt thích (chỉ đại diện cho mức độ quan tâm)
Cách sử dụng
- Tải Q21_Emote_Version 1.safetensors, viết lời nhắc với các cụm từ được liệt kê trên thẻ như “make the woman frustrated / make the woman wink / make the woman say ah”, có thể kết hợp nhiều biểu cảm
- Tác giả thường sử dụng cường độ .25 ~ .5 để tạo biểu cảm có thể kiểm soát, nếu muốn phóng đại hơn, hoạt hình hơn thì tăng lên; 1.0 sẽ rất phóng đại; tác giả không cung cấp số bước và CFG
Rủi ro và hạn chế
- Tác giả tự nhận là bị overfitting rõ rệt, là phiên bản đầu tiên, một số biểu cảm có hiệu quả kém, một số trường hợp không dùng LoRA lại tốt hơn; hình ảnh thực tế sẽ trở nên phẳng ở cường độ cao
- Tập dữ liệu huấn luyện hầu như toàn bộ là nữ, tác giả cho biết cũng có thể dùng cho nam nhưng không đưa ra ví dụ; chỉ có 2 ví dụ hiển thị (6 cấp độ nhạy cảm đã bị ẩn); mục này chưa được chạy thử
Có thể theo dõi (1)
【B】Qwen Image 2.1 — Visual-Prompt Image Reconstruction · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-02 14:35 · Tải xuống 16
Quy trình làm việc “tái tạo hình ảnh bằng lời nhắc thị giác” Qwen 2.1 của AIKSK: trước tiên để mô hình ngôn ngữ lớn trực tuyến xem ảnh gốc và viết mô tả, sau đó kết hợp với chỉ thị cố định “giữ nguyên”, vẽ lại một bức ảnh lớn hơn từ không gian tiềm ẩn trống; đây không phải là trình phóng đại giữ nguyên pixel.
Giữ hạng B: quy trình và tham số được viết rõ ràng, hạn chế được viết thẳng thắn, nhưng phụ thuộc vào dịch vụ trực tuyến bên ngoài và không có kết quả hiển thị nào.
Hình ảnh minh họa
Lý do đề xuất
- Quy trình làm việc mới: ảnh gốc chỉ được gửi đến nút LLM của RunningHub (lưu trữ gemini-3.1-flash-lite-preview) để tạo mô tả, đầu ra không gian tiềm ẩn của bộ mã hóa không được kết nối, bộ lấy mẫu bắt đầu từ EmptyLatentImage, vì vậy đây là “vẽ lại theo mô tả”, bố cục và chi tiết không đảm bảo giống với ảnh gốc
- Phục vụ nhu cầu sử dụng Qwen 2.1 để tạo lại một phiên bản độ phân giải cao cho ảnh cũ, ảnh nhỏ; tác giả đã thẳng thắn ghi trên thẻ rằng chỉ thị giữ nguyên không đảm bảo danh tính, văn bản, logo hoặc hình học không thay đổi
- Tham số được ghi đầy đủ: LoRA chi tiết khoảng 0.5, 25 bước, CFG 1, Euler/simple, denoise 1; kích thước được thu phóng theo ngân sách diện tích min(4, sqrt(2048²/(rộng×cao)))
Cách sử dụng
- Nhập qwenImage21Visual_v10.json, chuẩn bị đầy đủ qwen_image_2.1_bf16, qwen3vl_8b_fp8_scaled, qwen_image_2.1_vae_bf16 và elusarcas-qwen2-1-detailer-v1; đặt ảnh gốc vào nút 514
- Nút mô tả LLM phụ thuộc vào dịch vụ RunningHub, cần cấu hình sẵn cục bộ hoặc thay thế bằng nút khác để xem ảnh và viết mô tả; sau đó sử dụng nút so sánh ảnh gốc/kết quả đi kèm để kiểm tra
Rủi ro và hạn chế
- Phụ thuộc vào dịch vụ LLM trực tuyến RunningHub, cần tự xác nhận tài khoản, phí và điều khoản dữ liệu
- Tác giả tự nhận là chưa xác minh suy luận, không có ví dụ hiển thị (1 đã bị ẩn); giấy phép không cho phép tạo tác phẩm phái sinh; mục này chưa được chạy thử
- Hình ảnh minh họa trên thẻ là hình minh họa do AI tạo, không phải hiệu quả thực tế của mô hình; tác giả không có ví dụ cấp độ bình thường công khai
Chỉ bao gồm (2)
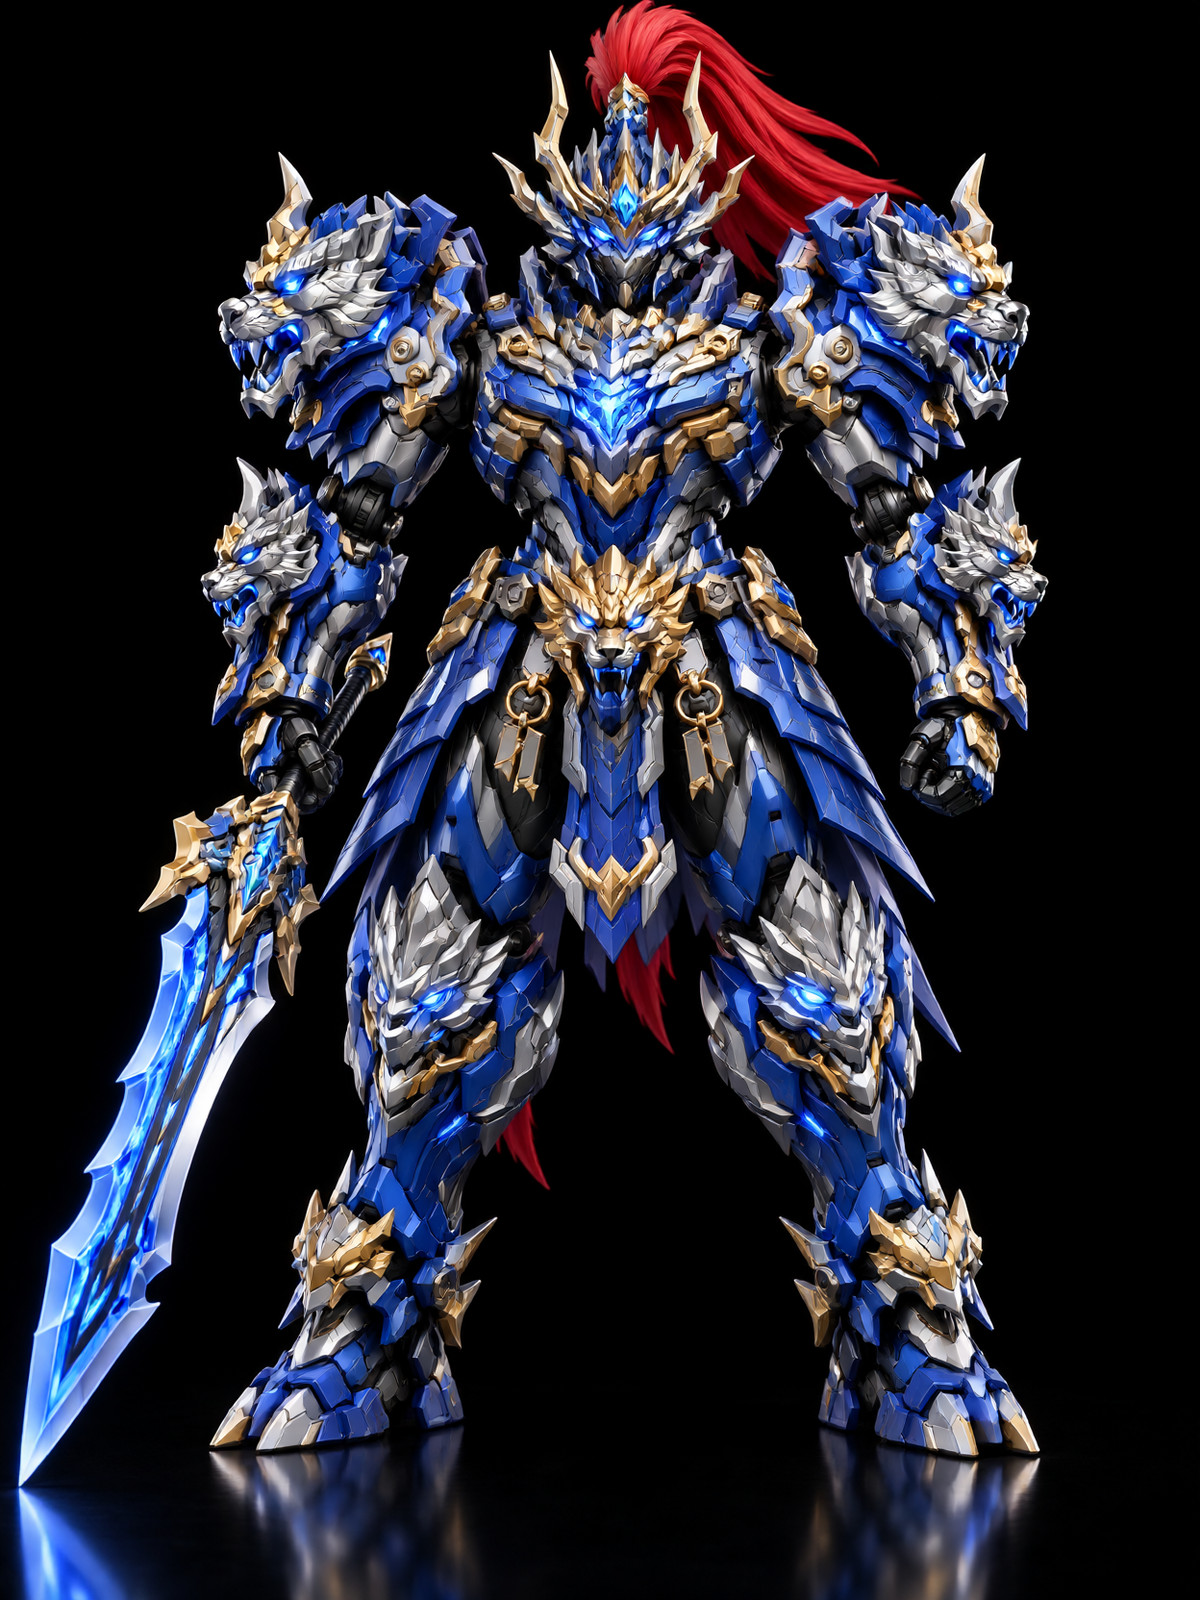
- Mecha Engrave · qwen-image2.1-v1 — LoRA: phiên bản Qwen 2.1 của LoRA tăng cường chi tiết cơ giáp: tác giả cho biết có thể làm dày các lớp áo giáp, tăng cường các trang trí như đầu thú và gai nhọn, tăng cường các bộ phận năng lượng phát sáng.
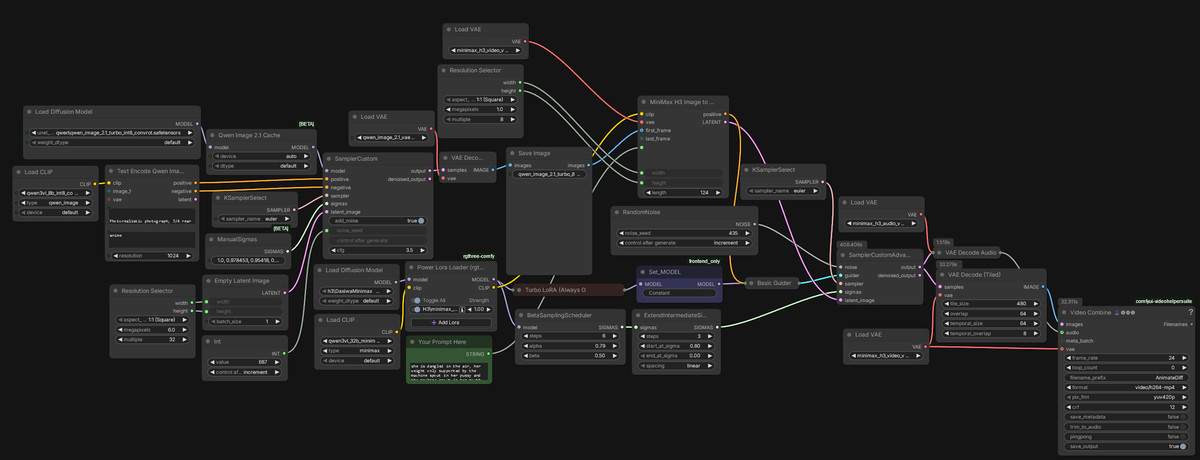
- qwen t2i to H3 i2v workflow · v1.0 — Quy trình làm việc: quy trình làm việc bộ nhớ thấp được kết nối một chạm: trước tiên sử dụng Qwen để tạo ảnh từ văn bản, sau đó đưa ảnh này vào H3 để tạo video từ ảnh, tác giả sử dụng trên 4070 với 12G VRAM.
Dữ liệu: API công khai của Civitai (mô hình cơ sở Qwen 2.1), cửa sổ thu thập 11-02 10:15 → 11-02 21:01 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ đại diện cho mức độ quan tâm.