Radar IA de Zhenzhen · Qwen Image 2.1 · Soirée 2026-10-30
Cette édition compte 2 nouvelles versions : fortement recommandé 0 · recommandé 1 · à suivre 1 · inclus uniquement 0
Note de l'éditeur Cette édition examine 2 nouvelles versions de Qwen 2.1. La recommandation principale est un flux de travail de génération en quatre étapes pour Qwen 2.1 nécessitant 8 Go de VRAM : utilisation du modèle de base Q4 GGUF, chargement et déchargement séparés de l'encodeur de texte, et LoRA lightning en 4 étapes. L'auteur affirme qu'une carte de 8 Go sur un ordinateur portable génère une image 1024x1024 en environ 20 secondes ; il ne s'agit que d'un flux de travail, et l'auteur rappelle que la licence du modèle de base Qwen 2.1 est limitée à un usage non commercial, ce qui maintient la note A.
Recommandé (1)
【A】Qwen-Image 2.1 4-Step — 8 Go de VRAM (1024² en 20s) · v1.0
Flux de travail · Nouveau modèle · Auteur tinytensor · Publié le 10-30 17:56 · Téléchargements 21
Un flux de travail ComfyUI permettant à Qwen 2.1 de générer des images 1024x1024 en 4 étapes avec 8 Go de VRAM, grâce au modèle de base Q4 GGUF, à un encodeur de texte chargé séparément et à un LoRA lightning en 4 étapes ; ce n'est pas un nouveau poids en soi.
Maintien de la note A : explications claires et réalisables, utile pour les utilisateurs disposant de peu de VRAM ; mais ce n'est qu'un flux de travail, et la licence du modèle de base limite l'usage commercial.
Illustration
Raisons de la recommandation
- Nouveau modèle : résout le problème de l'impossibilité d'exécuter Qwen 2.1 lorsque la VRAM est limitée à 8 Go. L'auteur explique le principe : l'encodeur de texte de 9.35 Go ne tient pas dans une carte graphique de 8 Go, il doit être chargé séparément via CLIPLoader, puis déchargé vers la mémoire après le calcul ; combiné aux poids Q4 GGUF et à la distillation en 4 étapes, cela permet de faire tenir le tout.
- L'auteur affirme qu'avec une carte RTX 3070 Ti de 8 Go sur un ordinateur portable et 32 Go de RAM, la première exécution prend 32 secondes (chargement inclus), puis environ 20 secondes par image.
- Réalisable : les noms de fichiers, les tailles et les répertoires de destination des quatre fichiers de modèle, ainsi que les paramètres d'échantillonnage clés, sont indiqués sur la fiche, ainsi que les pannes courantes (du bruit indique que le LoRA n'est pas connecté).
Comment l'utiliser
- Installez ComfyUI-GGUF ; placez qwen-image-2.1-UC-Q4_K_M.gguf (4.6 Go) dans models/diffusion_models, qwen3vl_8b_int8_convrot.safetensors (9.35 Go) dans models/text_encoders, qwen_image_2.1_vae_bf16.safetensors dans models/vae, et qwen-image-2.1-lightning-4step.safetensors dans models/loras.
- Téléchargez qwenImage214Step8GBVRAM_v10.zip et importez le flux de travail ; configurez l'échantillonnage sur 4 étapes, CFG 1.0, euler, simple, denoise 1.0. Avec un CFG de 1.0, le prompt négatif n'a pas d'effet, ce que l'auteur décrit comme normal.
Risques et limitations
- L'auteur rappelle sur la fiche : le modèle de base Qwen-Image 2.1 est publié sous la licence Qwen Research License, limitée à la recherche et à un usage non commercial ; un usage commercial nécessite une autorisation séparée de Tongyi ; la licence commerciale cochée sur la page Civitai ne concerne que ce fichier de flux de travail.
- Nécessite 32 Go de mémoire système ; il ne s'agit que d'un JSON de flux de travail, pas de nouveaux poids ; 3 images d'exemple, cette entrée n'a pas été exécutée.
- La fiche fait la promotion de la collection de flux de travail payants de l'auteur sur Gumroad ; cette entrée ne contient qu'un seul flux de travail gratuit.
À suivre (1)
【B】Q21 - Changement cohérent d'angle vertical · v1.0
LoRA · Nouveau modèle · Auteur blo01 · Publié le 10-30 11:27 · Téléchargements 178
Un LoRA de changement de caméra pour l'édition Qwen 2.1 : entrez une image et utilisez une instruction pour modifier la même scène en vue de dessus ou de dessous ; l'auteur affirme que cela aide à maintenir la cohérence de la structure corporelle et de la scène.
Maintien de la note B : la phrase de déclenchement est directement utilisable et l'usage est clair, mais il n'y a aucun exemple visible.
Illustration
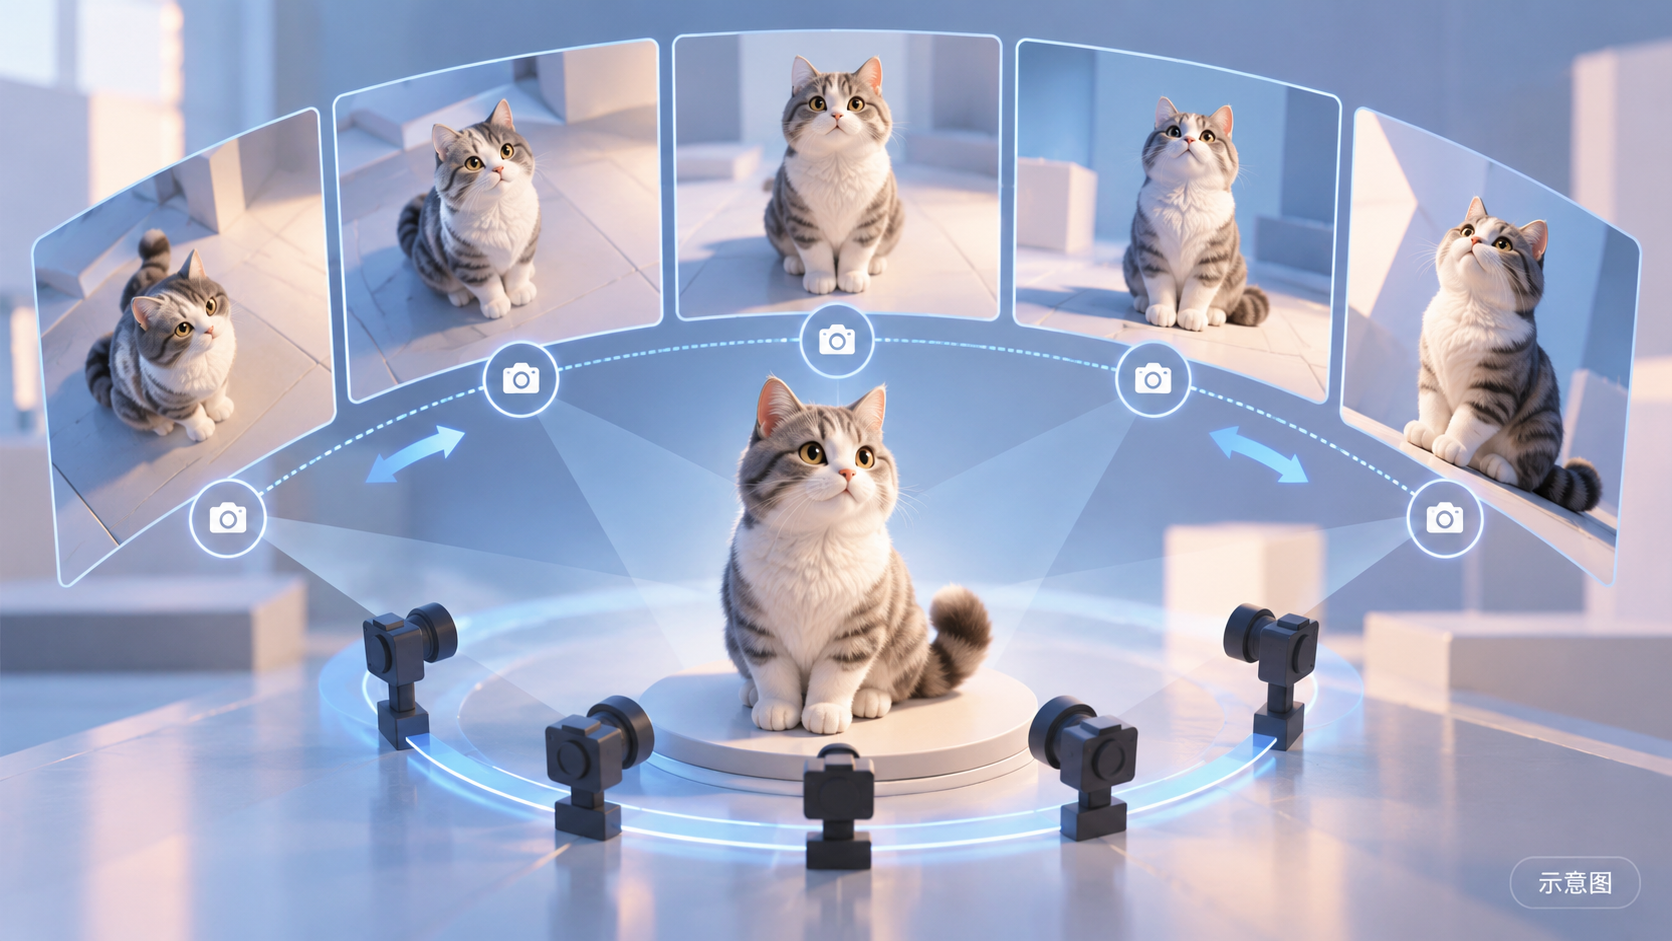
Raisons de la recommandation
- Nouveau modèle : répond au besoin de « changer l'angle vertical de la même scène » dans l'édition d'images, sans avoir à régénérer l'image ; les phrases de déclenchement sont divisées en deux types : vue de dessus (high angle view) et vue de dessous (low angle view).
- L'utilisation indique une plage d'intensité et suggère d'ajouter d'autres mots-clés affectant la caméra ; gratuit, la licence permet la génération, la location et la vente de fusions.
- Environ 10 heures après la publication, 178 téléchargements et 21 likes, ce qui en fait la version la plus téléchargée de cette édition (représentant uniquement l'attention).
Comment l'utiliser
- Dans un flux de travail d'édition Qwen 2.1, chargez qwen2.1-consistent_vertical_angle_change.safetensors (BF16), avec une intensité de 0.7–1.0.
- Pour la vue de dessus, écrivez « change <image1> to show scene viewed from top , high angle view » ; pour la vue de dessous, écrivez « change <image1> to show scene viewed from below , low angle view » ; le nombre d'étapes et le CFG ne sont pas fournis par l'auteur.
Risques et limitations
- Les 7 exemples sont tous de niveau sensible et masqués, il n'y a donc aucun exemple visible pour juger de la qualité du changement d'angle et de la cohérence.
- La fiche du modèle ne contient que trois lignes, sans mention des données d'entraînement ni des types de scènes applicables.
- L'illustration de la fiche est un schéma généré par IA, et non le résultat réel du modèle ; l'auteur ne propose pas d'exemples publics de niveau standard.
Mots-clés de déclenchement : change <image1> to show scene viewed from top , high angle view、change <image1> to show scene viewed from below , low angle view
Données : API publique Civitai (modèle de base Qwen 2.1), fenêtre d'inclusion du 10-30 08:31 au 10-30 21:01 (heure de Pékin). Les raisons de la recommandation ont été examinées par la rédaction ; le nombre de téléchargements reflète uniquement l'attention.