貞貞のAIレーダー · MiniMax H3 · 2026-11-09 朝刊
今号の新バージョンは 15 個です。強くおすすめ:1 · おすすめ:3 · 注目すべき:6 · 掲載のみ:5
編集者によるコメント 今号では 16 個の H3 新バージョンをレビューしました。内訳は S が 1 個、A が 3 個、B が 6 個、C が 6 個です。おすすめは Lipsync / TLF2VA の統合ワークフローです。既存の楽曲やセリフに合わせて参考画像でリップシンクを行ったり、テキストや画像からシーンごとに音声・動画を生成したりできます。各セグメントは保存されるため、続きから実行したり、特定のセグメントから再生成したりすることが可能です。その他の注目点として、1つのノードで多カット短編映画全体を記述できる Showrunner ワークフロー、CROWN の五指で剣を握るポーズや二人が交差して入れ替わる LoRA、画像内の 1~4 人の人物を一括置換する H3 画像編集ワークフローなどが挙げられます。1980s のスタイル統合 LoRA と Stone And Gold の移植版はトリガーワードや強度設定がないため B ランクに下げました。DaSiWa の新しい統合ベースモデル2種と CROWN の一人称視点 LoRA は確認可能なサンプルがないため B ランク、3つの架空人物 LoRA、動画リンクのみが提供される画像生成ワークフロー、説明が一文しかない MOSS ワークフロー、有料の「顔面を叩く」アクション LoRA は C ランクとしました。
強くおすすめ(1)
【S】MiniMaxH3 Lipsync / TLF2VA · Nova.1
ワークフロー · 新モデル · 作者 Rvage · 公開 11-09 02:10 · ダウンロード数 43
H3 用の統合ワークフローです。既存の楽曲やセリフなどの録音に合わせて参考画像でリップシンクを行ったり、テキスト、最初のフレーム、最初と最後のフレーム、または参考画像からシーンごとに音声・動画を生成したりできます。各セグメントは保存されるため、続きから実行したり、特定のセグメントから再生成したり、あるいは既存の結果を読み込んで字幕を追加したりすることが可能です。
説明は今号で最も充実しています。「続きから実行 / 第 N セグメントから再生成」という保存メカニズムは、長尺動画において最も実用的です。
画像
おすすめ理由
- 新モデル(ワークフロー)。リップシンク MV やセリフ付き動画、およびテキスト生成、画像生成、最初と最後のフレーム指定による多シーン長尺動画に対応しています。
- 2つのパスが1つのセグメントレンダリングループを共有します。各シーンごとにプロンプトを設定し、プレビューを累積表示できます。参考動画の解析による自動シーン分割とアクション記述も可能です。YuE2 / MiniMax Music 3 による音楽生成、歌詞抽出、動的字幕はオプショングループです。
- パラメータが完全に記載されています。ネイティブ H3 プリセットは Euler / simple、CFG 1、8 ステップです。リップシンクプリセットは 4 ステップで、2つの高速化 LoRA を有効にします。作者は ComfyUI 0.42.1 環境で構築したと明記しており、初回テストでは短いクリップを使用し、音楽と字幕を無効化し、一度に1セグメントのみ出力することを推奨しています。
- 1 本の動画と 1 枚の画像のサンプルが確認可能です。公開後約 7 時間で 43 回のダウンロードがありました(これは注目度を示すに過ぎません)。
使い方
- Eclipse Nova 1.0.30、SmartLLM Nova 1.1.12、Smart Model Loader Nova 1.0.11 をインストールまたは更新し、MMH3_Unified.json をインポートしてください。
- START HERE で Lip-sync または Native H3 を選択し、Smart Model Loader と LoRA Stack で対応するプリセットを選択してください(両方で手動切り替えが必要です)。リップシンクの場合:Images と Audio override を有効にし、画像と録音を読み込み、New run、Disk + Keep in output を選択し、一度に 1 セグメント出力します。
- 続きから実行する場合:保存された実行を選択し、Resume saved run に変更、Restart part を 0 に設定します。第 N セグメントから再生成する場合:Restart part を N に設定し、シードを変更します。
リスクと制限
- 依存関係が多いです。3 個の Nova ノードパッケージが必要で、オプショングループには sol-attn や音声分離ノードも必要です。H3 拡散モデル、Qwen3-VL 32B テキストエンコーダ、動画および音声 VAE を各自で用意する必要があります。リップシンクにはさらに wav2vec2 音声エンコーダが必要です。
- ネイティブパスで保存されるベースモデルはコミュニティの統合モデルであり、各自の H3 モデルと対応するサンプリング設定に置き換える必要があります。
- ライセンスにより商用利用および派生物の公開が禁止されています。1 個のサンプルはレーティングにより非表示になっています。
- 完全な説明には、長いシーンは複数の独立したレンダリングに分割され、継ぎ目での動作や音声の連続性は保証されない旨が記載されています。本項目は実行されていません。
おすすめ(3)
【A】MiniMax Showrunner: Pro-Grade Video Director | 専門級ビデオディレクター. · V2.5.2 Release Copy
ワークフロー · 新モデル · 作者 lonecatone23 · 公開 11-09 04:29 · ダウンロード数 67
H3 用の多カット「ディレクター」ワークフローです。1つのノード内でキャラクター、シーン、各カットを記述し、一度の実行で全カットを順次生成し、音声やセリフとともに1本の短編映画として結合します。
画像
おすすめ理由
- 新モデル(ワークフロー)。固定されたキャラクターとシーンを持つ多カットナラティブ短編映画向けで、テキスト生成、最初/最後のフレーム固定のカットに使用できます。
- 作者によると、Keep rolling 機能により次のカットが前のカットのカメラ位置から継続し、音声もカット間で接続されます。顔写真と服装画像で人物の一貫性を保ち、360 パノラマ画像で同じ部屋内のカメラ位置を変えても様子が崩れません。個別のカットは再生成可能で、個別に LoRA を適用できます。レンダリング前に、各カットで実際に H3 に送られるテキストと警告が表示されます。
- ポストプロセッシンググループでは、48 fps へのフレーム補間、RTX によるぼけ除去とアップスケールを行います。ノードのコメントには中国語など多言語が含まれています。
- 1 本の動画と 1 枚の画像のサンプルが確認可能です。公開後約 5 時間で 67 回のダウンロード、12 件のいいねがありました(これは注目度を示すに過ぎません)。
使い方
- MMH3 Showrunner V2.5.2.json をインポートし、不足しているノードは作者の GitHub(lonecatone23)にある ComfyUI_LC_AV_nodes からインストールしてください。まず何も変更せずに同梱のサンプルストーリーを直接 Run し、その後 Vision Assistant → Tour の順に試してください。
- 各キャラクター用に顔写真1枚と服装画像1枚、各シーン用に部屋画像または 360 パノラマ画像を1枚用意してください。サンプリングステップ数などのパラメータは作者がカード上に記載していないため、User Guide を参照してください。
リスクと制限
- 作者自身のノードパッケージに依存しており、作者によるとComfy Managerへの掲載は約1日遅れる可能性がある
- 「シームレス、音声に問題なし、人物の一貫性が保たれている」というのは作者の主張であり、1件のサンプルはレーティングにより非表示になっている
- バージョン名に「Release Copy」と含まれており、ページにはこのバージョンのみが存在するが、作者の以前のバージョンとの関係性は説明されていない
- ライセンスは画像生成とサイト内でのレンタルのみを許可しており、本項目は動作確認を行っていない
【A】CROWN 3D Spatial Crossing & Five-Finger Hilt Grip Master | MiniMax H3 · v1.0 - VideoOnly r64
LoRA · 新モデル · 作者 NineCrowns · 公開 11-09 08:38 · ダウンロード 16
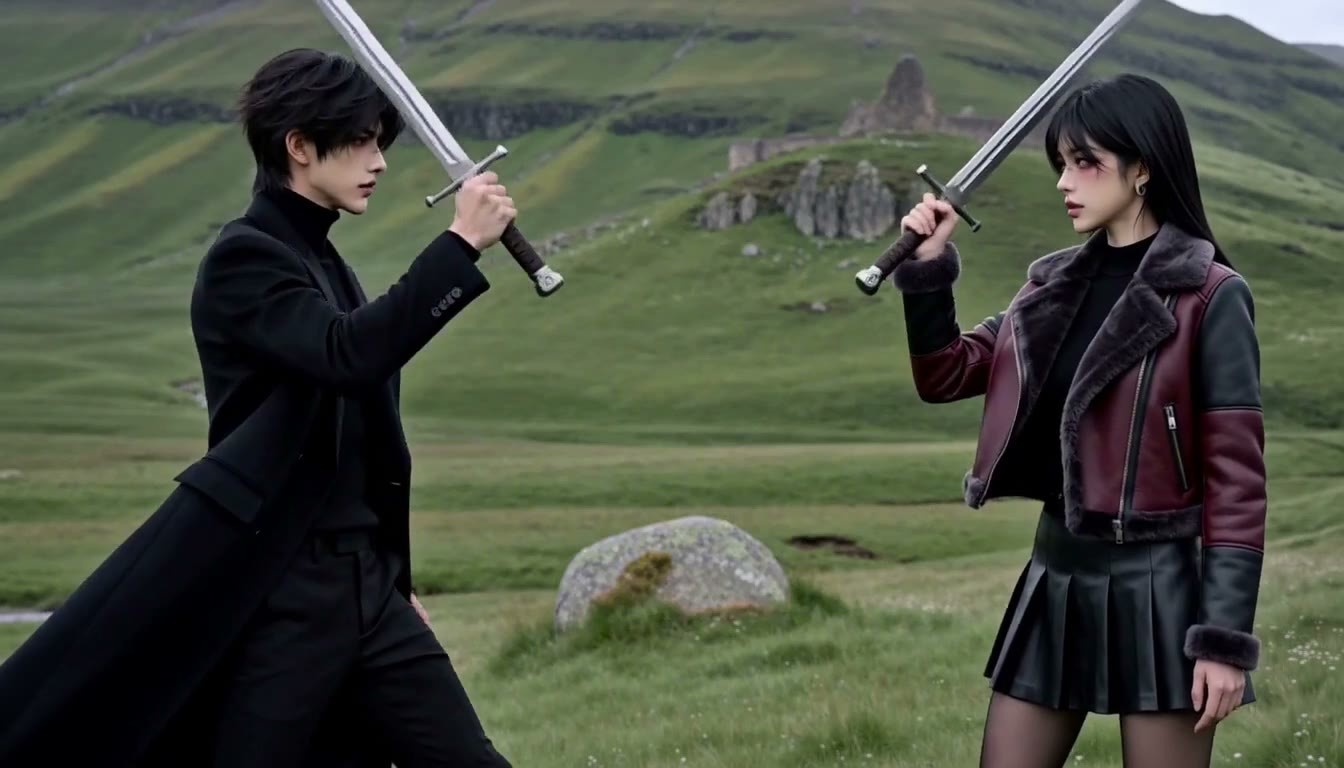
CROWNの武器アクション用LoRA:人物が剣柄の鍔の下を五指で握り、剣を振るう際に剣身が真っ直ぐ保たれ、さらに2人のキャラクターが前景と背景で交差・入れ替わる際に顔や衣装が混ざらないようにする。
同一作者の前回の特殊効果戦闘用LoRAとは方向性が補完的:あちらは速度と特殊効果を担当し、こちらは剣の握り方と2人の立ち位置(走位)を担当する。
画像
推奨理由
- 新モデル;剣術戦闘や2人の立ち位置のカメラワークに対応し、作者はRef2VA / I2VA / T2VAのサポートを明記している
- 2つのトリガーワードがそれぞれ異なる機能を担う:crown_gripは剣の握りと剣身の剛性を、crown_spatialは2人のX字型の交差・入れ替わりを担当する;crown_spatial_gripは両者を併用する
- 動画層のみを学習(Rank 64、Blocks 10–49);作者はテスト設定を全て公開している:ref2vaベースモデル、25ステップ euler + beta、CFG 1.0、MiniMaxH3SigmaShift(shift_video 12.0、shift_audio 3.0)
- ライセンスは商用での画像生成と販売を許可している
使い方
- プロンプトに crown_grip / crown_spatial / crown_spatial_grip を記述し、本LoRA単体での強度は 0.65–0.75(作者のサンプル動画では 0.65 を使用);25ステップ euler + beta、CFG 1.0、shift_video 12.0、shift_audio 3.0
リスクと制限
- 動画サンプルは 1 本のみ;「100% で顔立ちと衣装を保持し、0 で顔が混ざらない」というのは作者の主張
- 公開から 1 時間未満であり、ダウンロード数ではまだ何も判断できない;本項目は動作確認を行っていない
トリガーワード:crown_spatial_grip、crown_grip、crown_spatial
【A】H3 Minimax Multi-character swap (1-4) · v1.3
ワークフロー · 新モデル · 作者 yorgash · 公開 11-09 06:07 · ダウンロード 50
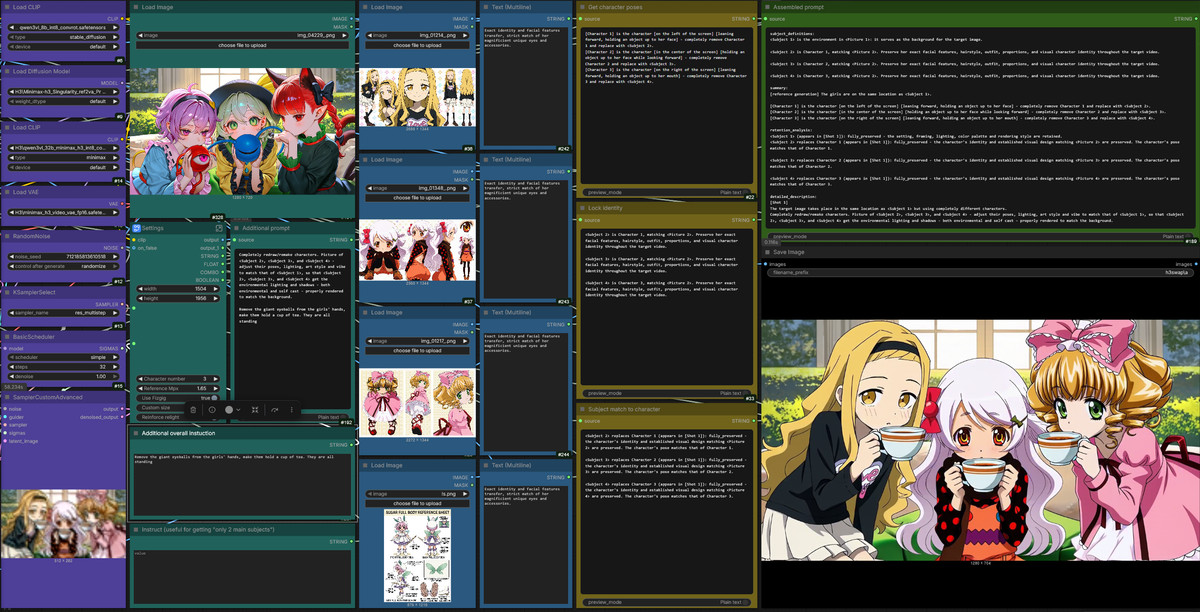
H3を用いた画像編集による人物置換ワークフロー:元の画像1枚とキャラクター参照画像 1–4 枚を与えると、画面内の 1–4 人の人物を参照画像のキャラクターに一度で置き換える。
画像
推奨理由
- 新モデル(ワークフロー);ポスター、集合写真、スチール写真内の複数人物の置換に対応し、入力は動画ではなく単一の画像
- 内蔵の「ワークノード」が人物を自動で比較し、編集指示を組み立てる;モデルがどの人物を認識したか(通常は左から右へ)をプレビューでき、最終的な指示も確認可能
- 全体の指示を追加して修復、ポーズ変更、背景交換が可能;各キャラクターに備考(例:小さくする、老けさせる)を追加できる;Reinforce relightにより、人物を画面に馴染ませるための再ライティングの指示が自動で追加される
- 表示可能なサンプルは 2 件;公開から約 3 時間で 50 回のダウンロード(注目度のみを示す);ライセンスは商用利用と販売を許可している
使い方
- H3 Replacer v1.3.json をインポートし、メインテキストエンコーダー、拡散モデル、およびプロンプト組み立て用の補助エンコーダー(作者は qwen3vl_8b_int8_convrot を推奨)を選択する
- Settings で人物数 1–4(必須)と参照画像サイズを設定する;fizgigを使用しない場合は単一の潜在変数となり、作者によると約 20% 高速化されるが、人物が増えるほど加速効果は薄れる;サンプリングステップ数などの詳細は作者から提供されていない
リスクと制限
- 人物の順序認識が変動する可能性があり、作者は毎回プレビューを確認することを推奨;人物置換は肖像権に関わるため、許諾を得た画像のみで使用すること
- サンプリングパラメータは作者から提供されていない;1 件のサンプルはレーティングにより非表示;本項目は動作確認を行っていない
注目すべき項目(6)
【B】⛩️💀 DaSiWa MiniMax H3 💀⛩️ · DaSiWa GXS v5 Turbo
ベースモデル / Checkpoint · バージョン更新 · 作者 Darksidewalker · 公開 11-09 06:46 · ダウンロード 146
DaSiWa GXS v5 の Turbo 蒸留版:同一の Graviton マージに Pika-H3-Flex-HD-Turbo(REF2VA)を追加し、4〜8 ステップで出力可能。
画像
推奨理由
- バージョン更新:更新説明によると、v4 × v5 × Singularity v2 のマージ基础上に Pika-H3-Flex-HD-Turbo を追加。前バージョンは GXS v5 の非蒸留版
- 作者がステップ数の段階を提示:4 ステップで高速プレビュー(音声品質は低下)、6 ステップで基本、8 ステップで高品質。Turbo では euler / simple または LCM / simple を推奨。Shift Video 6-12、Shift Audio 3-5
- INT8、W4A8、W6A8 の3種類の量子化を提供。本バージョンは約 3 時間で 146 回のダウンロード(注目度のみを示す)
使い方
- H3 ref2va のベースモデルとして置き換えて読み込み、euler / simple または LCM / simple を使用。まず 4 ステップでプレビューを確認し、正式出力は 8 ステップで行う。Shift Video 6-12、Shift Audio 3-5
リスクと制限
- 表示可能なサンプルなし(1 件がレーティングにより非表示)。4 ステップで音声品質が低下することは作者自身が明記
- ファイルサイズが大きい。作者は MiniMax から書面による許可を取得済みと主張しているが、ユーザーは依然として H3 コミュニティライセンスの制約を受ける。本項目は未実行
- カードの画像は AI 生成のイメージ図であり、モデルの実際の効果ではない。作者は一般レーティングの公開サンプルを持っていない
【B】⛩️💀 DaSiWa MiniMax H3 💀⛩️ · DaSiWa GXS v5
ベースモデル / チェックポイント · バージョン更新 · 作者 Darksidewalker · 公開 11-09 06:46 · ダウンロード 189
DaSiWa H3 ベースモデルの新マージ版 GXS v5(非蒸留):DaSiWa v4、v5、Singularity v2 を統合した ref2va の完全な重み。
画像
推奨理由
- バージョン更新:更新説明によると、DaSiWa v4 × DaSiWa v5 × Singularity v2 の Graviton マージ。前バージョンは Hybrid v4
- 作者が推奨設定を提示:res_multistep または euler / simple、Shift Video 10-12、Shift Audio 3-5、20-25 ステップ
- INT8、W4A8、W6A8 の3種類の量子化を提供。同ページ累計 71904 回のダウンロード、本バージョンは約 3 時間で 189 回(注目度のみを示す)
使い方
- H3 ref2va のベースモデルとして置き換えて読み込み(ダウンロードドロップダウンで量子化を選択)、res_multistep / simple または euler / simple、20-25 ステップ、Shift Video 10-12、Shift Audio 3-5。依存関係は作者のワークフロー説明を参照
リスクと制限
- 表示可能なサンプルなし(1 件がレーティングにより非表示)。マージ後の変化について作者は「告知を参照」とのみ記載
- ファイルサイズが大きい。作者は MiniMax から書面による許可を取得済みと主張しているが、ユーザーは依然として H3 コミュニティライセンスおよび利用ポリシーの制約を受ける
- 本項目は未実行
- カードの画像は AI 生成のイメージ図であり、モデルの実際の効果ではない。作者は一般レーティングの公開サンプルを持っていない
【B】CROWN True First-Person Subjective POV & Interactive Gaze | MiniMax H3 · v2.0 - VideoOnly r64
LoRA · 新モデル · 作者 NineCrowns · 公開 11-09 08:39 · ダウンロード 40
CROWN の一人称主観視点 LoRA:「自分の手」が画面下辺から入り込んで酒を注いだりカップを持ったりする表現を可能にし、ワンカットでの見下ろし・見上げカメラワークに対応。
画像
推奨理由
- 新モデル。一人称 Vlog やインタラクティブな恋愛系主観ショット向け。作者は Ref2VA / I2VA / T2VA に対応と明記
- 解決する問題が具体的:H3 でよくある腕が横から伸びてくる、またはキャラクターに余分な第三の手が生じる現象。作者は本 LoRA により手が画面真下からのみ入ると主張
- 動画層のみを学習(Rank 64、Blocks 10–49)。テスト設定が完備:25 ステップ euler + beta、CFG 1.0、shift_video 12.0、shift_audio 3.0
使い方
- プロンプトに crown_pov を記述し、強度 0.80–0.85。25 ステップ euler + beta、CFG 1.0、MiniMaxH3SigmaShift で shift_video 12.0、shift_audio 3.0 を設定
リスクと制限
- 唯一のサンプルがレーティングにより非表示で、効果を確認できない。機能説明はすべて作者の主張に基づく
- バージョン名は v2.0 だが、ページにはこのバージョンのみがあり、比較用の v1 がない。本項目は未実行
- カードの画像は AI 生成のイメージ図であり、モデルの実際の効果ではない。作者は一般レーティングの公開サンプルを持っていない
トリガーワード:crown_pov
【B】1980s Movies AiO LoRA · v1.0 - Minimax H3
LoRA · 新モデル · 作者 neph1 · 公開 11-09 03:42 · ダウンロード 113
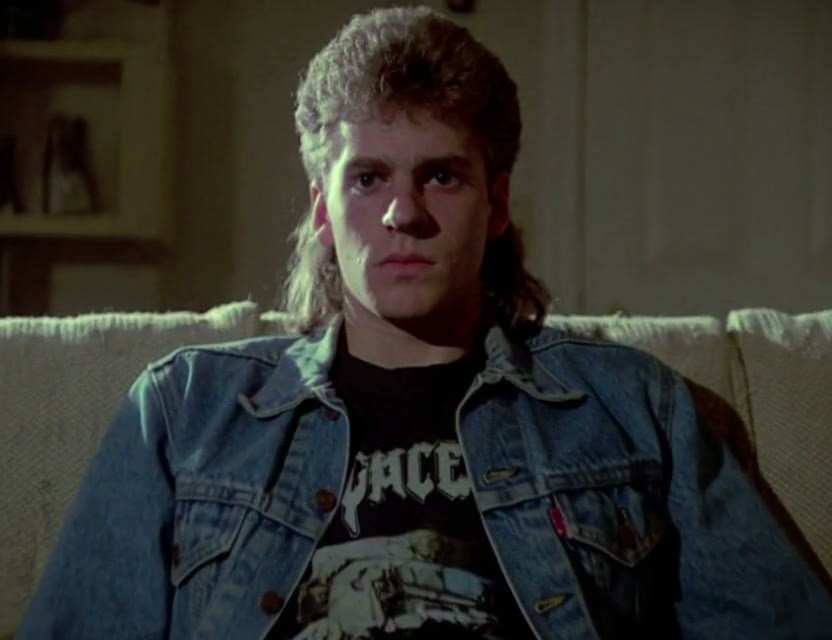
作者の3つの 1980 年代映画風 H3 LoRA を DARE TIES で統合したスタイル LoRA。
画像
推奨理由
- 新モデル。古い映画やテレビの質感を持つ動画制作向け。1つのファイルで3つの LoRA を代替
- 作者は統合後、個々の概念は元のバージョンほど強くならない可能性があるが、スタイルとしては良好と主張。サンプルは比較しやすくするため同じプロンプトと設定を使用
- 公開後約 6 時間で 113 回のダウンロード。今期の非センシティブカテゴリでは注目度が高い(注目度のみを示す)。ライセンスは商用利用と販売を許可
使い方
- 1980s_aio_dare_ties_0_8.safetensors を読み込み。トリガーワードと強度は作者が提供していないため、サンプルのプロンプトを参照
リスクと制限
- 説明が短く、トリガーワード、強度、サンプリングパラメータがない
- 表示可能な動画は 1 本のみで、2 本はレーティングにより非表示。本項目は未実行
【B】Stone And Gold · MiniMaxH3
LoRA · ポート · 作者 MisterMR · 公開 11-09 01:45 · ダウンロード 39
「石と金」マテリアルスタイル LoRA の H3 ポート版:画面内の物体を粗い石材に金装飾を埋め込んだ質感に変換。
元版は SD 1.5 時代の古い LoRA で、説明の形容詞はそのまま流用されている。H3 版の具体的な効果はサンプルでのみ確認可能。
画像
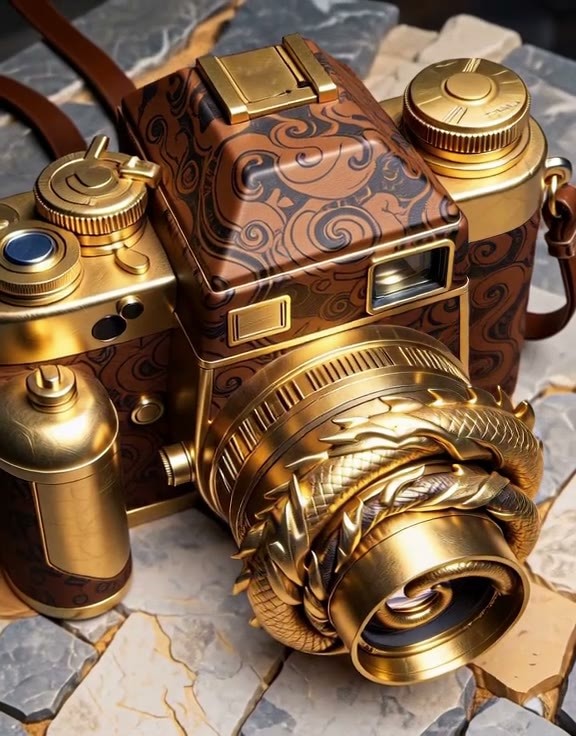
推奨理由
- ポート:同ページには既に SD 1.5、SDXL 1.0、Krea 2、ZImageTurbo 版があり、これは新たに追加された H3 動画版。説明は元版のプロモーション文言を流用しており、H3 版の違いは記載されていない
- マテリアルスタイル化されたテキスト生成 / 画像生成動画向け。同ページ累計 754 回のダウンロード(元シリーズの注目度のみを示す)
- 複数の表示可能な動画サンプルがあり、サンプルを確認してから決定できる
使い方
- MisterMR_StoneAndGold_MiniMaxH3.safetensors を読み込み。トリガーワード、強度、サンプリングパラメータは作者が提供していないため、サンプルを参照
リスクと制限
- 説明はスタイル描写のみで、使用パラメータが一切ない
- 8 件のサンプルがレーティングにより非表示。ライセンスはサイト内でのレンタルのみ許可し、派生物の作成は禁止。本項目は未実行
【B】MInimax H3 Studio, Pixel Upscale Optimized for NVIDIA ONLY · v2.0
ワークフロー · 新モデル · 作者 hRUSTIN474 · 公開 11-09 00:10 · ダウンロード 70
H3 マルチシーン「スタジオ」ワークフロー v2.0:計画に基づきシーンごとにテキスト生成 / 画像生成 / 参考画像生成動画を作成し、各セグメントを個別に超解像・カラーグレーディングして最終出力。NVIDIA GPU のみ対応。
画像
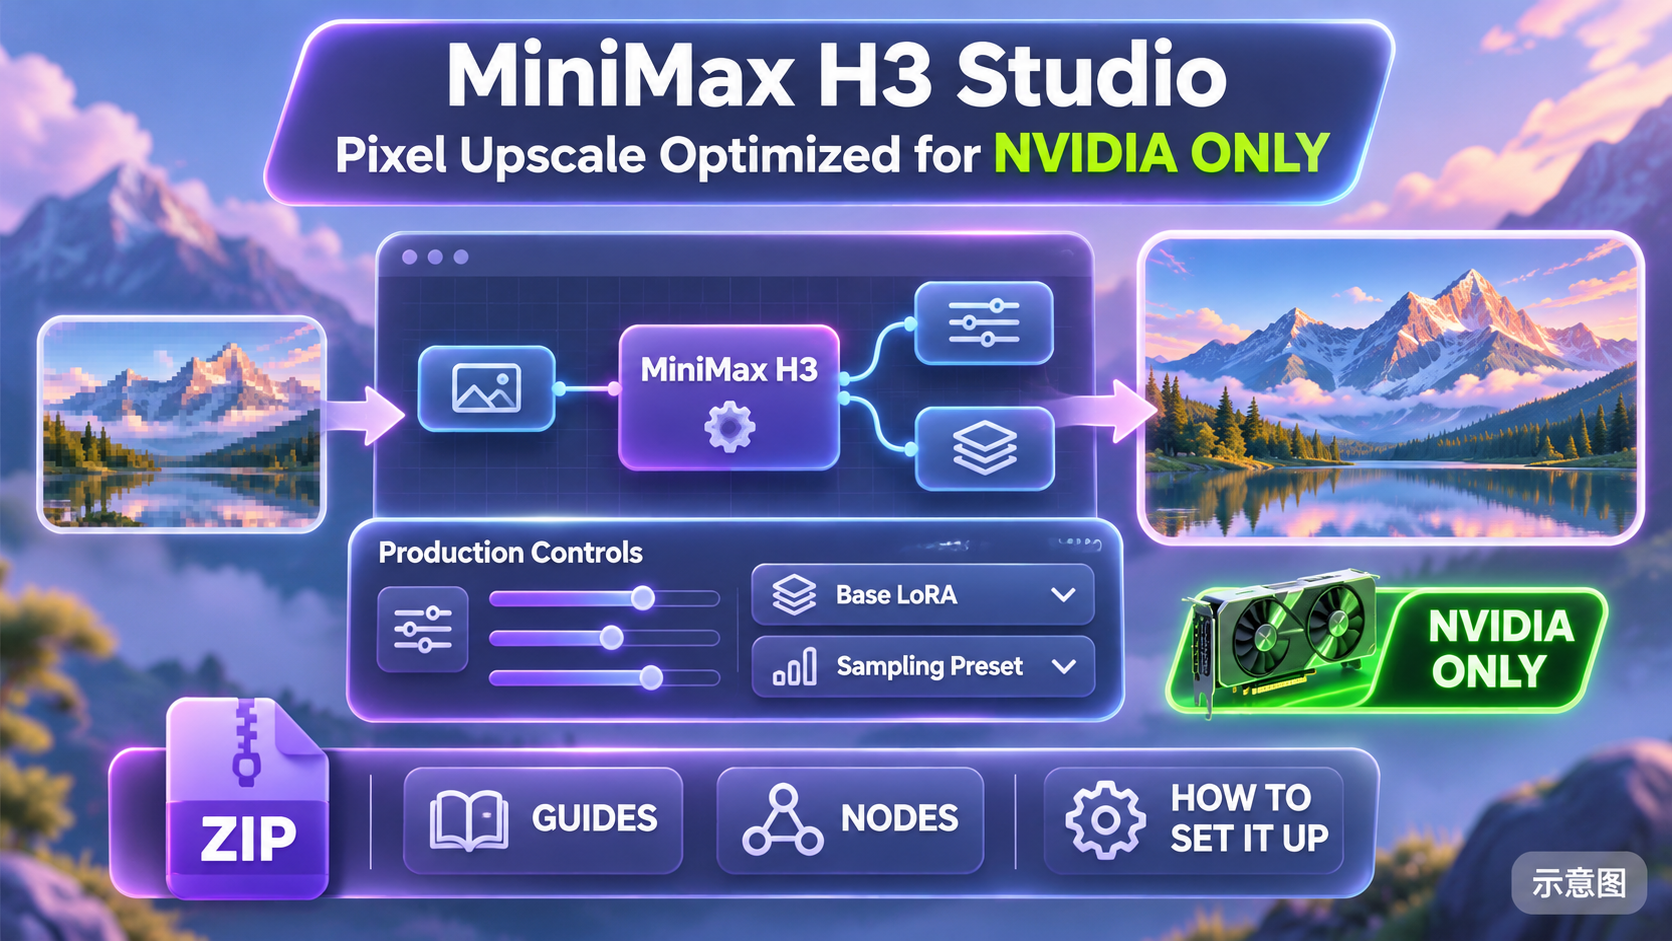
推奨理由
- 新モデル(ワークフロー)。本バージョンの説明では潜在空間アップスケールを削除し、RelayVSR を使用して各セグメントを個別にアップスケールする方式に変更と明記
- 長尺動画制作向け:計画 / 編集ノードで各シーンごとにセグメント化し、長さ、シード、順序を確認可能。ローカルライティングモデルによるプロンプト自動書き換えも選択可。セリフは文ごとに言語を明示(例:[English])
- 圧縮ファイルには設定ガイドとノードが付属。既存動画の個別超解像用サブワークフローも含まれる
使い方
- 解凍後、パッケージ内のガイドに従ってノードをインストール。Production Controls でモデル、対応アクセラレーション LoRA、サンプリングプリセットを選択し、初回テストはデフォルト値を使用。T2V は画像なし、I2V は最初のフレーム画像を配置、REF2V は参考画像を接続し、各画像が何を供給するかをプロンプトに明記
リスクと制限
- NVIDIA のみ対応。後処理チェーン(RelayVSR、DLSS、RTX HDR)への依存度が高い。完全な説明では HDR 変換を行うと記載されており、元の HDR を保持するわけではない
- 2 件のサンプルすべてがレーティングにより非表示で、効果を確認できない
- バージョン名は v2.0 だが、圧縮ファイル名は v1.0 Beta。さらに説明のない txt ファイルが付属。ライセンスは派生物の作成を禁止。本項目は未実行
- カードの画像は AI 生成のイメージ図であり、モデルの実際の効果ではない。作者は一般レーティングの公開サンプルを持っていない
収録のみ(5)
- Sophie Whitemoon · MiniMaxH3 — LoRA:架空の女性キャラクター Sophie Whitemoon の H3 キャラクター LoRA(スチームパンクなアーカイブ管理者の設定)。
- MiniMax H3 画像生成&編集ワークフロー · v1.0 — ワークフロー:H3 による画像生成と編集のワークフローの圧縮パッケージ。説明には YouTube チュートリアルへのリンクのみが含まれています。
- Lillian Roccabruna · MiniMaxH3 — LoRA:架空のキャラクター Lillian Roccabruna(フィレンツェのグラフィックデザイナーの設定)の H3 移植版キャラクター LoRA。
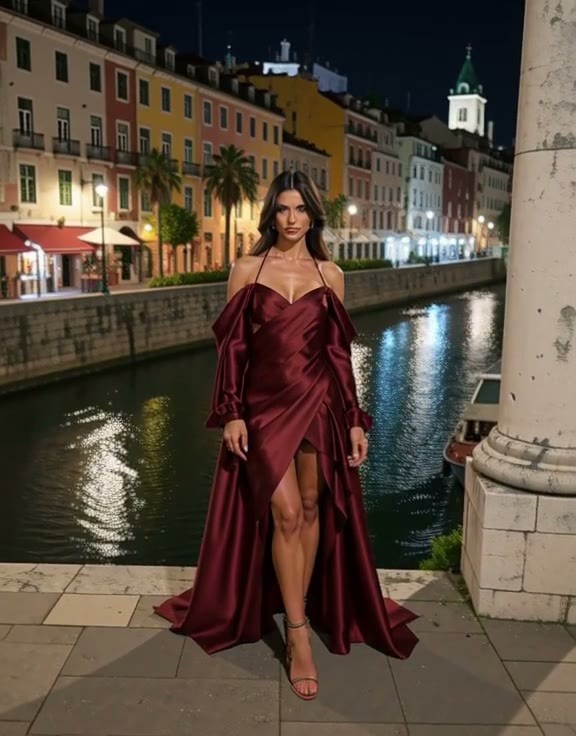
- Peyton Belwyn · MiniMaxH3 — LoRA:架空のキャラクター Peyton Belwyn(ブルッヘのワインセラーのオーナーの設定)の H3 移植版キャラクター LoRA。
- Qwen クリップを用いた自動ボックス描画による MOSS BBOX プレイグラウンド · v1.0 — ワークフロー:「MOSS レイアウトプレイグラウンド」ワークフロー:Qwen テキストエンコーダーを使用して自動的にボックスを描画し、ボックスに従って画面レイアウトを制御します。
データ:Civitai 公開 API(基盤モデル MiniMax H3)、収集期間 11-08 20:31 → 11-09 09:18(北京時間)。推奨理由は編集者によるレビュー済み。ダウンロード数は注目度を表すに過ぎません。