진진의 AI 레이더 · MiniMax H3 · 2026-11-09 모닝 브리프
이번 호 15개 신규 버전: 강력 추천 1 · 추천 3 · 주목할 만함 6 · 단순 수록 5
편집자 주 이번 호에서는 16개의 H3 신규 버전을 검토했으며, S급 1개, A급 3개, B급 6개, C급 6개를 선정했습니다. 최우선 추천은 Lipsync / TLF2VA 통합 워크플로우입니다. 기존 노래나 대사에 맞춰 참고 이미지의 입술 움직임을 동기화하거나, 텍스트와 이미지를 사용해 장면별로 오디오·비디오를 생성할 수 있습니다. 각 세그먼트가 저장되어 이어 실행하거나 특정 세그먼트부터 다시 생성할 수 있습니다. 기타 하이라이트로는 단일 노드에서 여러 컷의 단편 영화 전체를 작성하는 Showrunner 워크플로우, CROWN의 다섯 손가락 검자루 잡기 및 두 인물 교차 위치 변경 LoRA, 이미지 내 1–4명의 인물을 한 번에 교체하는 H3 이미지 편집 워크플로우가 있습니다. 1980s 스타일 병합 LoRA와 Stone And Gold 이식판은 트리거 워드와 강도 설정이 없어 B급으로 강등했으며, DaSiWa의 신규 병합 베이스 모델 2종과 CROWN 1인칭 시점 LoRA는 공개된 예시가 없어 B급으로 분류했습니다. 세 개의 가상 인물 LoRA, 영상 링크만 제공된 이미지 생성 워크플로우, 설명이 한 문장뿐인 MOSS 워크플로우, 유료인 '얼굴 때리기' 동작 LoRA는 C급으로 분류했습니다.
강력 추천 (1)
【S】MiniMaxH3 립싱크 / TLF2VA · Nova.1
워크플로우 · 신규 모델 · 작성자 Rvage · 게시일 11-09 02:10 · 다운로드 수 43
H3 통합 워크플로우 세트: 기존 노래, 대사 등 녹음된 오디오에 맞춰 참고 이미지의 입술 움직임을 동기화합니다. 또한 텍스트, 첫 프레임, 첫·마지막 프레임 또는 참고 이미지를 사용해 장면별로 오디오·비디오를 생성할 수 있으며, 각 세그먼트가 저장되어 이어 실행하거나 특정 세그먼트부터 다시 생성하거나, 기존 결과를 불러와 자막을 추가할 수 있습니다.
설명서가 이번 호에서 가장 충실하게 작성되었습니다. '이어 실행 / N번째 세그먼트부터 다시 생성'이라는 저장 메커니즘은 긴 영상 작업에 가장 실용적입니다.
예시 이미지
추천 이유
- 신규 모델(워크플로우); 립싱크 MV/대사 영상 및 텍스트 생성, 이미지 생성, 첫·마지막 프레임 기반의 다중 장면 장편 영상에 적합
- 두 경로가 하나의 세그먼트 렌더링 루프를 공유: 각 장면마다 프롬프트 하나, 누적 미리보기 제공, 선택적으로 참고 영상 분석을 통해 장면을 자동 분할하고 동작을 설명; YuE2 / MiniMax Music 3 배경음악, 가사 추출 및 동적 자막은 선택적 그룹
- 파라미터가 모두 명시됨: 네이티브 H3 프리셋은 Euler / simple, CFG 1, 8 스텝; 립싱크 프리셋은 4 스텝이며 두 개의 가속 LoRA를 활성화; 작성자는 ComfyUI 0.42.1 환경에서 구축했다고 명시했으며, 첫 테스트 시 짧은 클립 사용, 배경음악 및 자막 비활성화, 한 번에 한 세그먼트만 생성할 것을 권장
- 1개의 비디오 + 1개의 이미지 예시 공개; 게시 후 약 7시간 동안 43회 다운로드(관심도만 반영)
사용 방법
- Eclipse Nova 1.0.30, SmartLLM Nova 1.1.12, Smart Model Loader Nova 1.0.11를 설치/업데이트하고 MMH3_Unified.json을 가져오세요
- START HERE에서 Lip-sync 또는 Native H3를 선택하고, Smart Model Loader와 LoRA Stack에서 해당 프리셋을 선택하세요(두 곳 모두 수동으로 전환 필요); 립싱크의 경우 Images와 Audio override를 열고 이미지와 녹음 파일을 불러온 뒤, New run, Disk + Keep in output을 선택하고 한 번에 1세그먼트 생성
- 이어 실행하려면: 저장된 실행을 선택하고 Resume saved run으로 변경한 뒤, Restart part를 0으로 설정; N번째 세그먼트부터 다시 생성하려면: Restart part를 N으로 설정하고 시드 변경
리스크 및 제한 사항
- 의존성이 많음: 3개의 Nova 노드 패키지 필요, 선택적 그룹에는 sol-attn, 오디오 분리 노드도 필요; H3 확산 모델, Qwen3-VL 32B 텍스트 인코더, 비디오 및 오디오 VAE를 직접 준비해야 하며, 립싱크에는 wav2vec2 오디오 인코더도 필요
- 네이티브 경로에 저장된 베이스 모델은 커뮤니티 병합 모델이므로, 사용자의 H3 모델과 이에 맞는 샘플링 설정으로 교체해야 함
- 라이선스상 상업적 사용 및 파생 작품 배포가 금지됨; 1개의 예시가 등급 제한으로 숨겨짐
- 전체 설명서에 따르면 긴 장면은 여러 번의 독립적인 렌더링으로 분할되며, 이음새 부분의 동작과 소리 연속성은 보장되지 않음; 본 항목은 실행되지 않음
추천 (3)
【A】MiniMax Showrunner: Pro-Grade Video Director | 전문급 비디오 디렉터. · V2.5.2 Release Copy
워크플로우 · 신규 모델 · 작성자 lonecatone23 · 게시일 11-09 04:29 · 다운로드 수 67
H3 다중 컷 '디렉터' 워크플로우: 단일 노드에서 캐릭터, 장면 및 각 컷을 작성하면, 한 번의 실행으로 모든 컷을 순서대로 생성하고 소리와 대사를 포함해 하나의 단편 영화로 합성합니다.
예시 이미지
추천 이유
- 신규 모델(워크플로우); 고정된 캐릭터와 장면을 가진 다중 컷 서사 단편 영상에 적합하며, 텍스트 생성 및 첫/마지막 프레임 고정 컷에 사용 가능
- 작성자 주장: Keep rolling 기능으로 다음 컷이 이전 컷의 카메라 위치에서 이어지고, 소리가 컷 간에 연결되며, 얼굴 사진 + 의상 이미지로 캐릭터 일관성을 유지하고, 360 파노라마 이미지로 같은 방에서 카메라 각도를 바꿔도 변형되지 않음; 개별 컷은 다시 생성하거나 개별 LoRA를 적용할 수 있으며, 렌더링 전 각 컷이 H3에 실제로 전달하는 텍스트와 경고가 표시됨
- 후처리 그룹에서 48 fps로 프레임 보간, RTX 디블러 및 업스케일링 수행; 노드 주석에는 중국어 등 다국어 지원 포함
- 1개의 비디오 + 1개의 이미지 예시 공개; 게시 후 약 5시간 동안 67회 다운로드, 12개 좋아요(관심도만 반영)
사용 방법
- MMH3 Showrunner V2.5.2.json을 가져오고, 누락된 노드는 작성자의 GitHub(lonecatone23)에서 ComfyUI_LC_AV_nodes를 설치하세요; 아무것도 수정하지 않고 기본 예제 스토리를 Run한 뒤, Vision Assistant → Tour 순서로 진행하세요
- 각 캐릭터마다 얼굴 사진과 의상 이미지를 하나씩, 각 장면마다 방 이미지나 360 파노라마 이미지를 하나씩 준비하세요; 샘플링 스텝 등 파라미터는 작성자가 카드에 명시하지 않았으므로 User Guide를 참고하세요
리스크 및 제한 사항
- 작성자 자신의 노드 패키지에 의존하며, 작성자는 Comfy Manager 등록이 약 하루 정도 지연될 수 있다고 언급함
- '이음새 없음, 소리 문제 없음, 캐릭터 일관성 유지'는 모두 작성자의 주장임; 1개의 예시가 등급 제한으로 숨겨짐
- 버전명에 Release Copy가 포함되며, 페이지에는 이 버전만 존재하고 작성자의 이전 버전과의 관계는 명시되지 않음
- 라이선스는 이미지 생성 및 사이트 내 대여만 허용; 본 항목은 실행되지 않음
【A】CROWN 3D 공간 교차 & 다섯 손가락 검자루 잡기 마스터 | MiniMax H3 · v1.0 - VideoOnly r64
LoRA · 신규 모델 · 작성자 NineCrowns · 게시일 11-09 08:38 · 다운로드 수 16
CROWN의 무기 동작 LoRA: 캐릭터가 검자루 가드 아래를 다섯 손가락으로 잡고, 검을 휘두를 때 검신이 곧게 유지되도록 하며, 두 캐릭터가 전경과 배경을 교차하며 위치를 바꿀 때 얼굴이나 의상이 섞이지 않도록 합니다.
같은 작성자의 이전 호 특수 효과 전투 LoRA와 방향이 보완적입니다: 그쪽은 속도와 특수 효과를 담당하고, 이쪽은 검 잡기와 두 인물의 동선을 담당합니다.
예시 이미지
추천 이유
- 신규 모델; 검술 전투, 두 인물 동선 컷에 적합하며, 작성자는 Ref2VA / I2VA / T2VA 지원을 명시함
- 두 개의 트리거 워드가 각각 다른 역할을 담당: crown_grip은 검 잡기와 검신 강성을, crown_spatial은 두 인물의 X자형 교차 위치 변경을 담당; crown_spatial_grip은 두 기능을 결합
- 비디오 레이어만 학습됨(Rank 64, Blocks 10–49); 작성자는 테스트 구성을 모두 공개함: ref2va 베이스 모델, 25 스텝 euler + beta, CFG 1.0, MiniMaxH3SigmaShift(shift_video 12.0, shift_audio 3.0)
- 라이선스는 상업적 이미지 생성 및 판매를 허용
사용 방법
- 프롬프트에 crown_grip / crown_spatial / crown_spatial_grip을 입력하고, 본 LoRA만 단독으로 사용할 경우 강도 0.65–0.75 설정(작성자의 예시 영상은 0.65 사용); 25 스텝 euler + beta, CFG 1.0, shift_video 12.0, shift_audio 3.0
리스크 및 제한 사항
- 1개의 비디오 예시만 존재; '100% 얼굴과 의상 보존, 0 얼굴 섞임'은 작성자의 주장임
- 게시 후 1시간이 채 되지 않아 다운로드 수로는 판단할 수 없음; 본 항목은 실행되지 않음
트리거 워드: crown_spatial_grip, crown_grip, crown_spatial
【A】H3 Minimax 다중 인물 교체 (1-4) · v1.3
워크플로우 · 신규 모델 · 작성자 yorgash · 게시일 11-09 06:07 · 다운로드 수 50
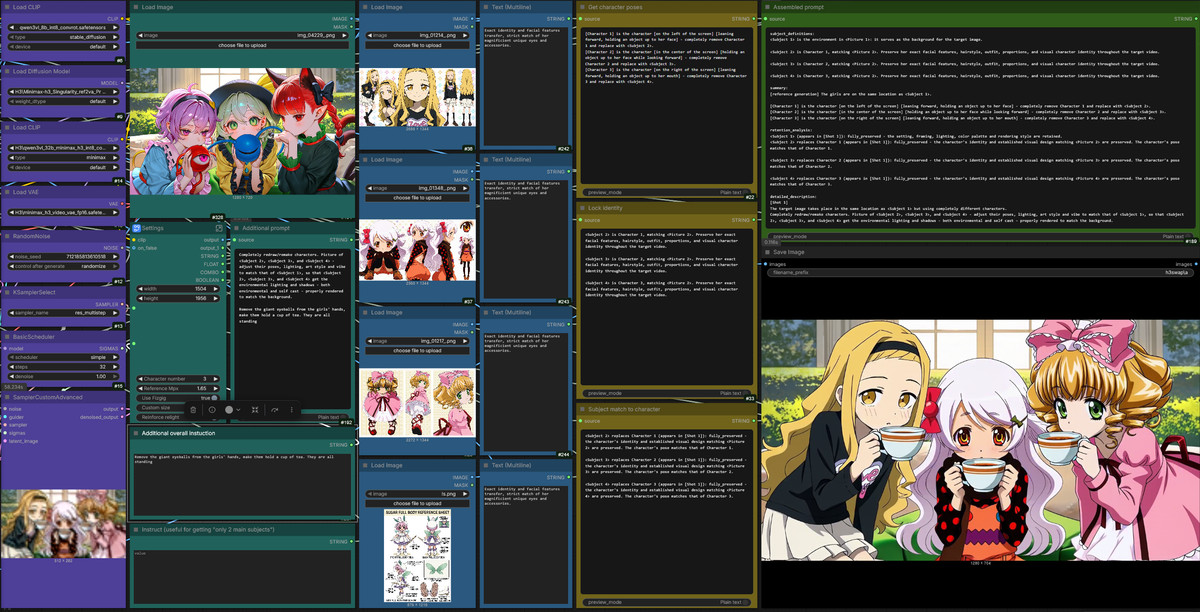
H3를 사용한 이미지 편집 인물 교체 워크플로우: 원본 이미지와 1–4장의 캐릭터 참고 이미지를 입력하면, 화면 내 1–4명의 인물을 참고 이미지의 캐릭터로 한 번에 교체합니다.
예시 이미지
추천 이유
- 신규 모델(워크플로우); 포스터, 단체 사진, 스틸 컷의 다중 인물 교체에 적합하며, 입력은 비디오가 아닌 단일 이미지
- 내장된 '워크 노드'가 인물을 자동으로 비교하고 편집 지시를 조립; 모델이 어떤 인물들을 인식했는지(보통 왼쪽에서 오른쪽 순서) 미리보기 가능, 최종 지시 확인 가능
- 전체 지시를 추가해 복원, 포즈 변경, 배경 교체 가능; 각 캐릭터마다 메모(예: 축소, 노화) 추가 가능; Reinforce relight는 인물이 화면에 자연스럽게 녹아들도록 재조명 지시를 자동으로 추가
- 2개의 공개 예시; 게시 후 약 3시간 동안 50회 다운로드(관심도만 반영); 라이선스는 상업적 사용 및 판매를 허용
사용 방법
- H3 Replacer v1.3.json을 가져오고, 주 텍스트 인코더, 확산 모델 및 프롬프트 조립용 보조 인코더(작성자는 qwen3vl_8b_int8_convrot을 권장)를 선택하세요
- Settings에서 인물 수 1–4(필수)와 참고 이미지 크기를 설정하세요; fizgig를 사용하지 않으면 단일 잠재 변수로 처리되며, 작성자는 약 20% 빠르다고 주장하지만 인물이 많을수록 가속 효과는 감소; 샘플링 스텝 등은 작성자가 제공하지 않음
리스크 및 제한 사항
- 인물 순서 인식이 변경될 수 있으므로 작성자는 매번 미리보기를 먼저 확인할 것을 권장; 인물 교체는 초상권과 관련되므로, 라이선스가 있는 이미지에만 사용하세요
- 샘플링 파라미터는 작성자가 제공하지 않음; 1개의 예시가 등급 제한으로 숨겨짐; 본 항목은 실행되지 않음
주목할 만함 (6)
【B】⛩️💀 DaSiWa MiniMax H3 💀⛩️ · DaSiWa GXS v5 Turbo
베이스 모델 / 체크포인트 · 버전 업데이트 · 작성자 Darksidewalker · 게시일 11-09 06:46 · 다운로드 수 146
DaSiWa GXS v5의 Turbo 증류 버전: 동일한 Graviton 병합에 Pika-H3-Flex-HD-Turbo(REF2VA)를 추가했으며, 4~8 스텝으로 영상을 생성합니다.
이미지
추천 이유
- 버전 업데이트: 업데이트 노트에 v4 × v5 × Singularity v2 병합을 기반으로 Pika-H3-Flex-HD-Turbo를 추가했다고 명시되어 있으며, 이전 버전은 GXS v5 비증류 버전이었습니다.
- 저자가 스텝 단계를 제시했습니다: 4 스텝 빠른 미리보기(오디오 품질 저하), 6 스텝 기본, 8 스텝 고품질; Turbo는 euler / simple 또는 LCM / simple을 권장하며, Shift Video 6-12, Shift Audio 3-5를 사용합니다.
- INT8, W4A8, W6A8 세 가지 양자화 버전을 제공합니다; 이 버전은 약 3시간 동안 146회 다운로드되었습니다(관심도만 반영).
사용 방법
- H3 ref2va 기본 모델로 교체하여 로드하고, euler / simple 또는 LCM / simple을 사용하며, 먼저 4 스텝으로 미리보기를 확인한 후 정식 생성 시 8 스텝을 사용하고, Shift Video 6-12, Shift Audio 3-5를 설정합니다.
리스크 및 제한 사항
- 공개된 예시가 없습니다(1개는 등급으로 인해 숨겨져 있음); 4 스텝에서 오디오 품질이 저하된다는 점은 저자가 직접 명시한 내용입니다.
- 파일 용량이 큽니다; 저자는 MiniMax로부터 서면 허가를 받았다고 주장하지만, 사용자는 여전히 H3 커뮤니티 라이선스의 제약을 받습니다; 이 항목은 실행되지 않았습니다.
- 카드 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아닙니다; 저자에게 공개된 일반 등급의 예시가 없습니다.
【B】⛩️💀 DaSiWa MiniMax H3 💀⛩️ · DaSiWa GXS v5
기본 모델 / 체크포인트 · 버전 업데이트 · 저자 Darksidewalker · 게시일 11-09 06:46 · 다운로드 수 189
DaSiWa H3 기본 모델의 새로운 병합 버전인 GXS v5(비증류): DaSiWa v4, v5 및 Singularity v2를 결합한 ref2va 전체 가중치입니다.
이미지
추천 이유
- 버전 업데이트: 업데이트 노트에 DaSiWa v4 × DaSiWa v5 × Singularity v2의 Graviton 병합이라고 명시되어 있으며, 이전 버전은 Hybrid v4이었습니다.
- 저자가 권장 설정을 제시했습니다: res_multistep 또는 euler / simple, Shift Video 10-12, Shift Audio 3-5, 20-25 스텝.
- INT8 및 W4A8, W6A8 세 가지 양자화 버전을 제공합니다; 동일 페이지 누적 다운로드 수는 71904회이며, 이 버전은 약 3시간 동안 189회 다운로드되었습니다(관심도만 반영).
사용 방법
- H3 ref2va 기본 모델로 교체하여 로드하고(드롭다운 메뉴에서 양자화 버전 선택), res_multistep / simple 또는 euler / simple을 사용하며, 20-25 스텝, Shift Video 10-12, Shift Audio 3-5를 설정합니다; 의존성은 저자의 워크플로우 설명을 참조하세요.
리스크 및 제한 사항
- 공개된 예시가 없습니다(1개는 등급으로 인해 숨겨져 있음), 병합 후 변화에 대해 저자는 '공지사항 참조'라고만 기재했습니다.
- 파일 용량이 큽니다; 저자는 MiniMax로부터 서면 허가를 받았다고 주장하지만, 사용자는 여전히 H3 커뮤니티 라이선스 및 사용 정책의 제약을 받습니다.
- 이 항목은 실행되지 않았습니다.
- 카드 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아닙니다; 저자에게 공개된 일반 등급의 예시가 없습니다.
【B】CROWN True First-Person Subjective POV & Interactive Gaze | MiniMax H3 · v2.0 - VideoOnly r64
LoRA · 신규 모델 · 저자 NineCrowns · 게시일 11-09 08:39 · 다운로드 수 40
CROWN의 1인칭 주관 시점 LoRA: 화면 하단에서 '자기 손'이 들어와 술을 따르거나 컵을 집는 동작을 지원하며, 원샷 롱테이크의 고개 숙임 및 들기 카메라 워크를 지원합니다.
이미지
추천 이유
- 신규 모델; 1인칭 브이로그, 인터랙티브 로맨스류의 주관적 카메라 워크를 지원하며, 저자는 Ref2VA / I2VA / T2VA를 지원한다고 명시했습니다.
- 해결하려는 문제가 구체적입니다: H3에서 흔히 발생하는 팔이 옆에서 가로로 들어오거나 캐릭터 몸에 세 번째 손이 생기는 문제를 지적하며, 저자는 이 LoRA가 손이 화면 정하단에서만 들어가도록 한다고 주장합니다.
- 비디오 레이어만 학습했습니다(Rank 64, Blocks 10–49); 테스트 설정이 완비되어 있습니다: 25 스텝 euler + beta, CFG 1.0, shift_video 12.0, shift_audio 3.0.
사용 방법
- 프롬프트에 crown_pov를 입력하고 강도를 0.80–0.85로 설정하세요; 25 스텝 euler + beta, CFG 1.0을 사용하며, MiniMaxH3SigmaShift에서 shift_video 12.0, shift_audio 3.0를 설정합니다.
리스크 및 제한 사항
- 유일한 예시가 등급으로 인해 숨겨져 있어 효과를 확인할 수 없습니다; 기능 설명은 모두 저자의 주장입니다.
- 버전명은 v2.0이지만 페이지에는 이 버전만 존재하며 비교할 v1가 없습니다; 이 항목은 실행되지 않았습니다.
- 카드 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아닙니다; 저자에게 공개된 일반 등급의 예시가 없습니다.
트리거 워드: crown_pov
【B】1980s Movies AiO LoRA · v1.0 - Minimax H3
LoRA · 신규 모델 · 저자 neph1 · 게시일 11-09 03:42 · 다운로드 수 113
저자의 세 가지 1980년대 영화 스타일 H3 LoRA를 DARE TIES 방식으로 하나의 스타일 LoRA로 병합한 모델입니다.
이미지
추천 이유
- 신규 모델; 빈티지 영화 / 올드 TV 질감의 영상을 제작하는 데 사용되며, 하나의 파일로 세 개의 LoRA를 대체합니다.
- 저자는 병합 후 개별 개념이 각각의 원본보다 강하지 않을 수 있다고 설명하지만, 스타일적으로는 괜찮다고 주장합니다; 예시는 비교를 위해 동일한 프롬프트와 설정을 의도적으로 사용했습니다.
- 게시 후 약 6시간 동안 113회 다운로드되었으며, 이번 호의 비민감 등급 중 관심도가 상위권입니다(관심도만 반영); 라이선스는 상업적 이용 및 판매를 허용합니다.
사용 방법
- 1980s_aio_dare_ties_0_8.safetensors 파일을 로드하세요; 트리거 워드와 강도는 저자가 제공하지 않았으므로 예시 프롬프트를 참조하세요.
리스크 및 제한 사항
- 설명이 매우 짧으며, 트리거 워드, 강도 및 샘플링 매개변수가 없습니다.
- 공개된 비디오는 1개뿐이며, 2개는 등급으로 인해 숨겨져 있습니다; 이 항목은 실행되지 않았습니다.
【B】Stone And Gold · MiniMaxH3
LoRA · 포팅 · 저자 MisterMR · 게시일 11-09 01:45 · 다운로드 수 39
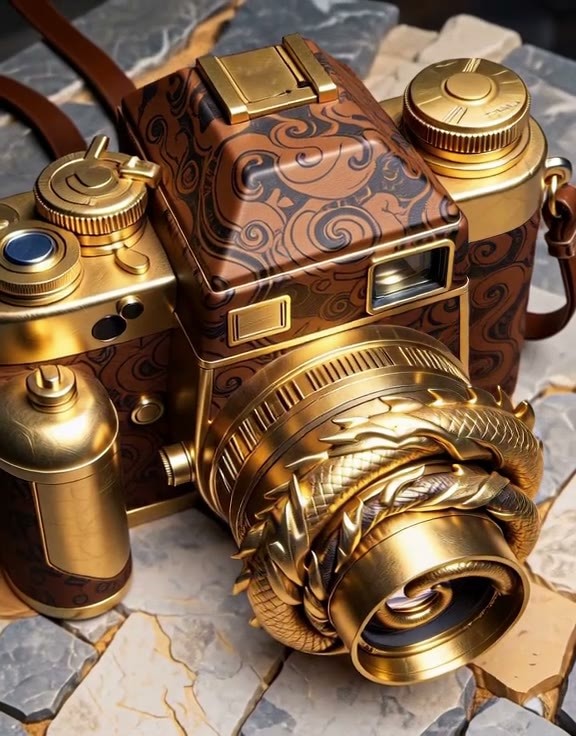
'돌과 금' 소재 스타일 LoRA의 H3 포팅 버전: 화면 내 물체를 거친 석재에 금 장식이 박힌 질감으로 표현합니다.
원본은 SD 1.5 시대의 오래된 LoRA이며, 설명서의 형용사는 그대로 가져왔으므로 H3 버전의 구체적인 효과는 예시를 통해 확인해야 합니다.
이미지
추천 이유
- 포팅: 동일 페이지에 이미 SD 1.5, SDXL 1.0, Krea 2, ZImageTurbo 버전이 있으며, 이는 새로 추가된 H3 비디오 버전입니다; 설명은 원본의 홍보 문구를 그대로 사용했으며, H3 버전의 차이점은 기재하지 않았습니다.
- 소재 스타일화의 텍스트-투-비디오 / 이미지-투-비디오를 지원합니다; 동일 페이지 누적 다운로드 수는 754회입니다(원본 시리즈의 관심도만 반영).
- 여러 개의 공개된 비디오 예시가 있어, 예시를 먼저 확인한 후 결정할 수 있습니다.
사용 방법
- MisterMR_StoneAndGold_MiniMaxH3.safetensors 파일을 로드하세요; 트리거 워드, 강도 및 샘플링 매개변수는 저자가 제공하지 않았으므로 예시를 참조하세요.
리스크 및 제한 사항
- 설명에는 스타일 묘사만 있으며 사용법 매개변수가 전혀 없습니다.
- 8개의 예시가 등급으로 인해 숨겨져 있습니다; 라이선스는 사이트 내 대여만 허용하며 파생 작품은 금지합니다; 이 항목은 실행되지 않았습니다.
【B】MInimax H3 Studio, Pixel Upscale Optimized for NVIDIA ONLY · v2.0
워크플로우 · 신규 모델 · 저자 hRUSTIN474 · 게시일 11-09 00:10 · 다운로드 수 70
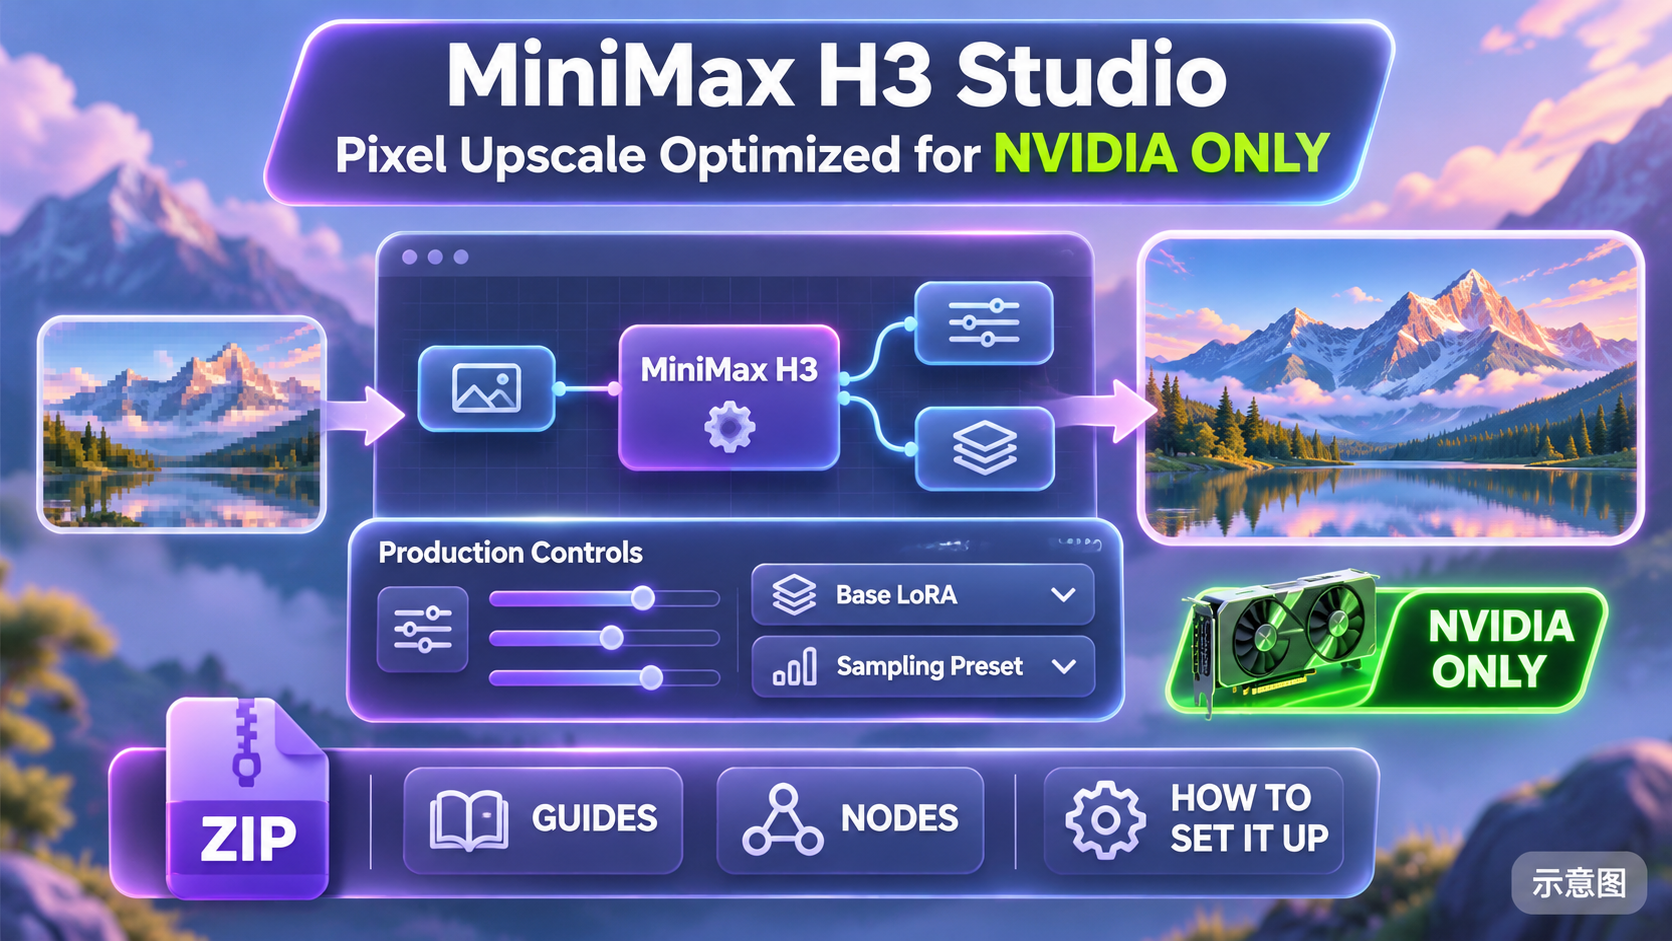
H3 멀티 시나리오 '스튜디오' 워크플로우 v2.0: 계획에 따라 시나리오별로 텍스트-투-비디오 / 이미지-투-비디오 / 참조-투-비디오를 생성한 후, 각 세그먼트를 개별적으로 업스케일링하고 색보정하여 최종 영상을 출력합니다; NVIDIA 그래픽 카드만 지원합니다.
이미지
추천 이유
- 신규 모델(워크플로우); 이 버전의 설명에는 잠재 공간 업스케일링을 제거하고 RelayVSR을 사용하여 각 세그먼트를 개별적으로 업스케일링하도록 변경했다고 명시되어 있습니다.
- 장편 영상 제작을 지원합니다: 계획 / 편집 노드에서 각 시나리오별로 한 단계를 생성하며, 길이, 시드 및 순서를 확인할 수 있습니다; 로컬 라이터 모델을 선택하여 프롬프트를 자동으로 재작성할 수도 있으며, 대사는 문장별로 언어를 표기해야 합니다(예: [English]).
- 압축 파일에 설정 가이드와 노드가 포함되어 있습니다; 또한 기존 영상에 대해 개별적으로 업스케일링을 수행하는 하위 워크플로우도 제공합니다.
사용 방법
- 압축 해제 후 패키지 내 가이드에 따라 노드를 설치하세요; Production Controls에서 모델, 호환 가속 LoRA 및 샘플링 프리셋을 선택하고, 첫 테스트에는 기본값을 사용하세요; T2V는 이미지를 사용하지 않으며, I2V는 첫 프레임 이미지를 배치하고, REF2V는 참조 이미지를 연결한 후 프롬프트에서 각 이미지가 제공하는 내용을 명시해야 합니다.
리스크 및 제한 사항
- NVIDIA만 지원합니다; 후반부 파이프라인(RelayVSR, DLSS, RTX HDR)의 의존성이 많으며, 전체 설명에는 HDR 변환을 수행한다고 기재되어 있어 원본 HDR을 보존하는 것이 아닙니다.
- 2개의 예시가 모두 등급으로 인해 숨겨져 있어 효과를 확인할 수 없습니다.
- 버전명은 v2.0이지만 압축 파일 이름은 v1.0 Beta이며, 설명이 불분명한 txt 파일이 하나 더 포함되어 있습니다; 라이선스는 파생 작품을 금지합니다; 이 항목은 실행되지 않았습니다.
- 카드 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아닙니다; 저자에게 공개된 일반 등급의 예시가 없습니다.
미수록 (5)
- 소피 화이트문 · MiniMaxH3 — LoRA: 가상 여성 캐릭터 소피 화이트문(스팀펑크 아카이브 관리자 설정)의 H3 캐릭터 LoRA입니다.
- MiniMax H3 이미지 생성 및 편집 워크플로 · v1.0 — 워크플로: H3의 이미지 생성 및 편집용 워크플로 압축 파일이며, YouTube 튜토리얼 링크 하나만 포함되어 있습니다.
- 릴리안 로카브루나 · MiniMaxH3 — LoRA: 가상 캐릭터 릴리안 로카브루나(피렌체 그래픽 디자이너 설정)의 H3 이식 버전 캐릭터 LoRA입니다.
- 페이튼 벨윈 · MiniMaxH3 — LoRA: 가상 캐릭터 페이튼 벨윈(브뤼헤 와인 저장소 주인 설정)의 H3 이식 버전 캐릭터 LoRA입니다.
- Qwen 클립을 사용한 자동 박스 그리기 기능이 포함된 MOSS BBOX 플레이그라운드 · v1.0 — 워크플로: 'MOSS 레이아웃 플레이그라운드' 워크플로입니다. Qwen 텍스트 인코더를 사용하여 자동으로 상자를 그리고, 해당 상자에 따라 화면 레이아웃을 제어합니다.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수집 기간 11-08 20:31 → 11-09 09:18(베이징 시간). 추천 이유는 편집자가 검토했으며, 다운로드 수는 관심도를 나타냅니다.