Radar AI của Trinh Trinh · MiniMax H3 · Bản tin buổi sáng 2026-11-09
Kỳ này có 15 phiên bản mới: Đề xuất mạnh mẽ 1 · Đề xuất 3 · Đáng chú ý 6 · Chỉ ghi nhận 5
Lời bình của biên tập viên Kỳ này đã xem xét 16 phiên bản mới của H3, gồm 1 cái hạng S, 3 cái hạng A, 6 cái hạng B, 6 cái hạng C. Đề xuất hàng đầu là quy trình làm việc hợp nhất Lipsync / TLF2VA: cho phép một ảnh tham chiếu khớp khẩu hình với bài hát hoặc đoạn hội thoại có sẵn, hoặc tạo video và âm thanh theo từng cảnh từ văn bản và hình ảnh, lưu lại từng đoạn, có thể chạy tiếp hoặc làm lại từ một đoạn bất kỳ. Các điểm nổi bật khác: quy trình làm việc Showrunner viết toàn bộ phim ngắn nhiều cảnh quay trong một node, LoRA CROWN cầm kiếm bằng năm ngón tay và đổi chỗ xen kẽ giữa hai nhân vật, quy trình chỉnh sửa hình ảnh H3 thay thế 1–4 nhân vật trong ảnh chỉ trong một lần. LoRA phong cách hợp nhất của 1980s và bản chuyển thể Stone And Gold không có từ kích hoạt và cường độ, bị hạ xuống hạng B; hai mô hình cơ sở hợp nhất mới của DaSiWa và LoRA góc nhìn thứ nhất của CROWN không có ví dụ trực quan, xếp hạng B; ba LoRA nhân vật hư cấu, quy trình tạo ảnh chỉ cung cấp liên kết video, quy trình làm việc MOSS với mô tả chỉ một câu và LoRA hành động tát mặt trả phí xếp hạng C.
Đề xuất mạnh mẽ (1)
【S】MiniMaxH3 Lipsync / TLF2VA · Nova.1
Quy trình làm việc · Mô hình mới · Tác giả Rvage · Phát hành 11-09 02:10 · Tải xuống 43
Một quy trình làm việc hợp nhất H3: cho phép một ảnh tham chiếu khớp khẩu hình với các bản thu âm có sẵn như bài hát, đoạn hội thoại; cũng có thể tạo video và âm thanh theo từng cảnh từ văn bản, khung hình đầu, khung hình đầu/cuối hoặc ảnh tham chiếu, lưu lại từng đoạn, có thể chạy tiếp, làm lại từ một đoạn bất kỳ, hoặc trực tiếp tải kết quả cũ để thêm phụ đề.
Phần mô tả là bản hoàn chỉnh nhất trong kỳ này, cơ chế lưu trữ “chạy tiếp / làm lại từ đoạn thứ N” rất hữu ích cho video dài.
Hình minh họa
Lý do đề xuất
- Mô hình mới (quy trình làm việc); phục vụ MV khớp khẩu hình / video hội thoại, cũng như video dài nhiều cảnh từ văn bản, hình ảnh, khung hình đầu/cuối
- Hai phương pháp chia sẻ một vòng lặp kết xuất phân đoạn: mỗi cảnh một lời nhắc, xem trước tích lũy, tùy chọn phân tích video tham chiếu để tự động cắt cảnh và mô tả hành động; nhạc nền YuE2 / MiniMax Music 3, trích xuất lời bài hát và phụ đề động là các nhóm tùy chọn
- Tham số được cung cấp đầy đủ: preset H3 gốc Euler / simple, CFG 1, 8 bước; preset khớp khẩu hình 4 bước và bật hai LoRA tăng tốc; tác giả ghi rõ được xây dựng trên ComfyUI 0.42.1, và khuyến nghị thử nghiệm đầu tiên bằng các đoạn ngắn, tắt nhạc nền và phụ đề, mỗi lần chỉ xuất một đoạn
- 1 đoạn video + 1 hình ảnh có ví dụ trực quan; phát hành khoảng 7 giờ với 43 lượt tải xuống (chỉ phản ánh mức độ quan tâm)
Cách sử dụng
- Trước tiên cài đặt / cập nhật Eclipse Nova 1.0.30, SmartLLM Nova 1.1.12, Smart Model Loader Nova 1.0.11, nhập MMH3_Unified.json
- Chọn Lip-sync hoặc Native H3 trong START HERE, và chọn preset tương ứng trong Smart Model Loader và LoRA Stack (cả hai đều phải chuyển đổi thủ công); khớp khẩu hình: bật Images và Audio override, tải một hình ảnh và bản thu âm, chọn New run, Disk + Keep in output, mỗi lần xuất 1 đoạn
- Để chạy tiếp: chọn lần chạy đã lưu và đổi thành Resume saved run, đặt Restart part là 0; để làm lại từ đoạn thứ N: đặt Restart part là N và đổi seed
Rủi ro và hạn chế
- Phụ thuộc nhiều: 3 gói node Nova, các nhóm tùy chọn còn cần sol-attn, node tách âm thanh; cần tự chuẩn bị mô hình khuếch tán H3, bộ mã hóa văn bản Qwen3-VL 32B, VAE video và âm thanh, khớp khẩu hình còn cần bộ mã hóa âm thanh wav2vec2
- Mô hình cơ sở được lưu trong phương pháp gốc là một mô hình hợp nhất cộng đồng, cần thay thế bằng mô hình H3 của riêng bạn và các cài đặt lấy mẫu tương ứng
- Giấy phép không cho phép sử dụng thương mại, cũng không cho phép phát hành các tác phẩm phái sinh; 1 ví dụ bị ẩn do phân loại
- Mô tả đầy đủ có ghi rằng các cảnh dài sẽ được chia thành nhiều lần kết xuất độc lập, chuyển động và âm thanh tại các điểm nối không được đảm bảo liên tục; mục này chưa được chạy thử
Đề xuất (3)
【A】MiniMax Showrunner: Pro-Grade Video Director | Đạo diễn video chuyên nghiệp. · Bản sao phát hành V2.5.2
Quy trình làm việc · Mô hình mới · Tác giả lonecatone23 · Phát hành 11-09 04:29 · Tải xuống 67
Quy trình làm việc “đạo diễn” H3 nhiều cảnh quay: viết nhân vật, bối cảnh và từng cảnh quay trong một node, một lần chạy sẽ tạo ra tất cả các cảnh quay theo thứ tự và ghép lại thành một bộ phim ngắn hoàn chỉnh cùng với âm thanh và hội thoại.
Hình minh họa
Lý do đề xuất
- Mô hình mới (quy trình làm việc); phục vụ phim ngắn tự sự nhiều cảnh quay với nhân vật và bối cảnh cố định, có thể dùng cho các cảnh quay từ văn bản, khung hình đầu / cuối cố định
- Tác giả tuyên bố: Keep rolling giúp cảnh quay tiếp theo tiếp tục từ vị trí máy quay của cảnh trước, âm thanh kết nối giữa các cảnh, sử dụng ảnh chân dung + ảnh trang phục để duy trì sự nhất quán của nhân vật, ảnh toàn cảnh 360 giúp thay đổi vị trí máy quay trong cùng một phòng mà không bị biến dạng; từng cảnh quay riêng lẻ có thể làm lại hoặc gắn LoRA riêng, hiển thị văn bản thực tế gửi đến H3 và cảnh báo cho từng cảnh quay trước khi kết xuất
- Nhóm hậu kỳ thực hiện nội suy khung hình lên 48 fps, khử mờ và phóng to bằng RTX; chú thích node có nhiều ngôn ngữ bao gồm tiếng Trung
- 1 đoạn video + 1 hình ảnh có ví dụ trực quan; phát hành khoảng 5 giờ với 67 lượt tải xuống, 12 lượt thích (chỉ phản ánh mức độ quan tâm)
Cách sử dụng
- Nhập MMH3 Showrunner V2.5.2.json, cài đặt các node còn thiếu từ ComfyUI_LC_AV_nodes trên GitHub của tác giả (lonecatone23); trước tiên hãy chạy trực tiếp câu chuyện mẫu đi kèm mà không thay đổi bất cứ thứ gì, sau đó đi qua Vision Assistant → Tour
- Chuẩn bị một ảnh chân dung và một ảnh trang phục cho mỗi nhân vật, một ảnh phòng hoặc ảnh toàn cảnh 360 cho mỗi bối cảnh; các tham số như số bước lấy mẫu không được tác giả liệt kê trên thẻ, hãy xem User Guide của họ
Rủi ro và hạn chế
- Phụ thuộc vào gói node của riêng tác giả, tác giả cho biết việc lên Comfy Manager có thể chậm khoảng một ngày
- “Không có mối nối, âm thanh không có vấn đề, nhân vật luôn nhất quán” đều là tuyên bố của tác giả; 1 ví dụ bị ẩn do phân loại
- Tên phiên bản có chữ Release Copy, trang chỉ có phiên bản này, mối quan hệ với các phiên bản trước của tác giả không được giải thích
- Giấy phép chỉ cho phép tạo ảnh và cho thuê trong trang web; mục này chưa được chạy thử
【A】CROWN 3D Spatial Crossing & Five-Finger Hilt Grip Master | MiniMax H3 · v1.0 - VideoOnly r64
LoRA · Mô hình mới · Tác giả NineCrowns · Phát hành 11-09 08:38 · Tải xuống 16
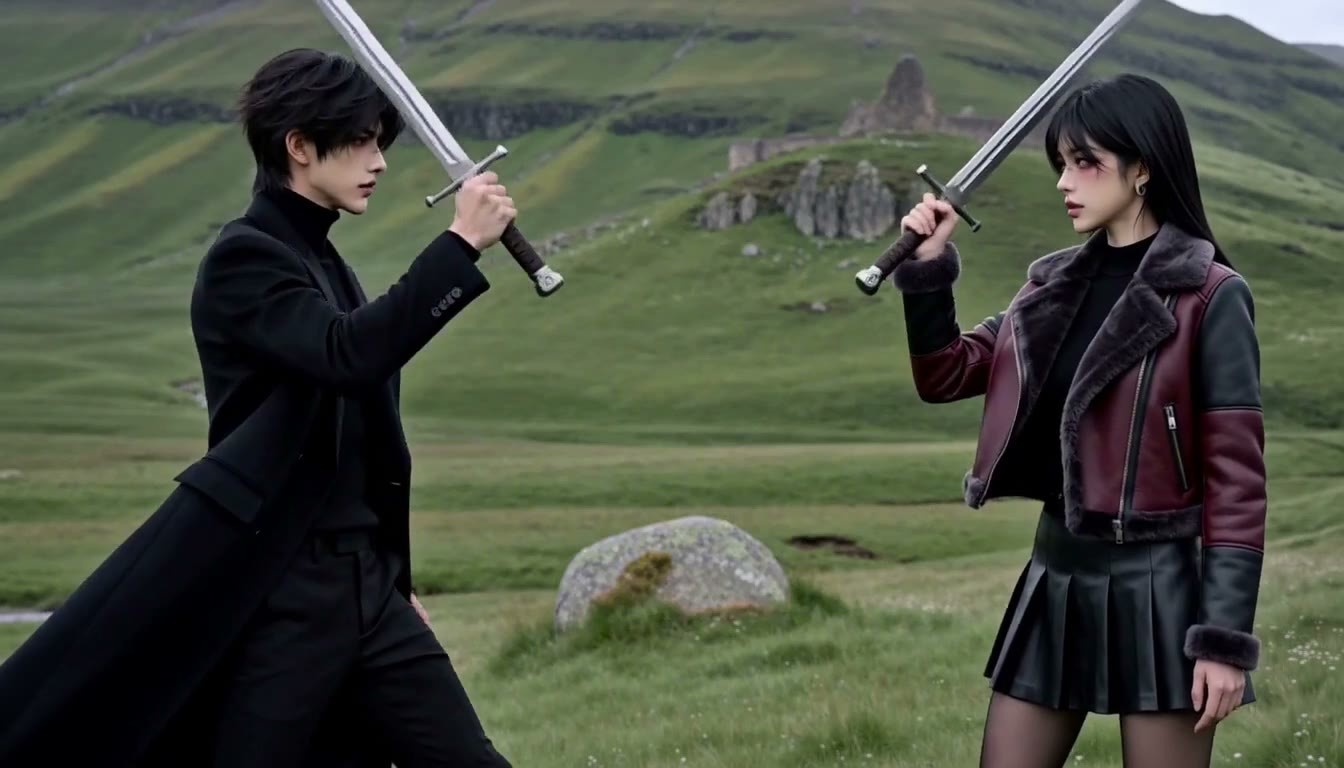
LoRA hành động vũ khí của CROWN: khiến nhân vật cầm kiếm bằng năm ngón tay dưới phần bảo vệ tay cầm, giữ lưỡi kiếm thẳng khi vung, và khi hai nhân vật đổi chỗ xen kẽ giữa tiền cảnh và hậu cảnh thì không bị lẫn mặt, không bị lẫn quần áo.
Bổ sung cho LoRA chiến đấu hiệu ứng đặc biệt của cùng tác giả trong kỳ trước: cái đó quản lý tốc độ và hiệu ứng, cái này quản lý cách cầm kiếm và di chuyển của hai người.
Hình minh họa
Lý do đề xuất
- Mô hình mới; phục vụ các cảnh quay chiến đấu bằng kiếm, di chuyển của hai người, tác giả ghi rõ hỗ trợ Ref2VA / I2VA / T2VA
- Hai từ kích hoạt quản lý hai việc riêng biệt: crown_grip quản lý cách cầm kiếm và độ cứng của lưỡi kiếm, crown_spatial quản lý việc đổi chỗ xen kẽ hình chữ X giữa hai người; crown_spatial_grip dùng kết hợp
- Chỉ huấn luyện lớp video (Rank 64, Blocks 10–49); tác giả cung cấp đầy đủ cấu hình thử nghiệm: mô hình cơ sở ref2va, 25 bước euler + beta, CFG 1.0, MiniMaxH3SigmaShift (shift_video 12.0, shift_audio 3.0)
- Giấy phép cho phép sử dụng thương mại và bán ảnh
Cách sử dụng
- Viết crown_grip / crown_spatial / crown_spatial_grip trong lời nhắc, chỉ gắn LoRA này với cường độ 0.65–0.75 (video ví dụ của tác giả dùng 0.65); 25 bước euler + beta, CFG 1.0, shift_video 12.0, shift_audio 3.0
Rủi ro và hạn chế
- Chỉ có 1 đoạn video ví dụ; “100% giữ nguyên ngũ quan và trang phục, 0 bị lẫn mặt” là tuyên bố của tác giả
- Phát hành chưa đến 1 giờ, số lượt tải xuống chưa nói lên điều gì; mục này chưa được chạy thử
Từ kích hoạt: crown_spatial_grip, crown_grip, crown_spatial
【A】H3 Minimax Multi-character swap (1-4) · v1.3
Quy trình làm việc · Mô hình mới · Tác giả yorgash · Phát hành 11-09 06:07 · Tải xuống 50
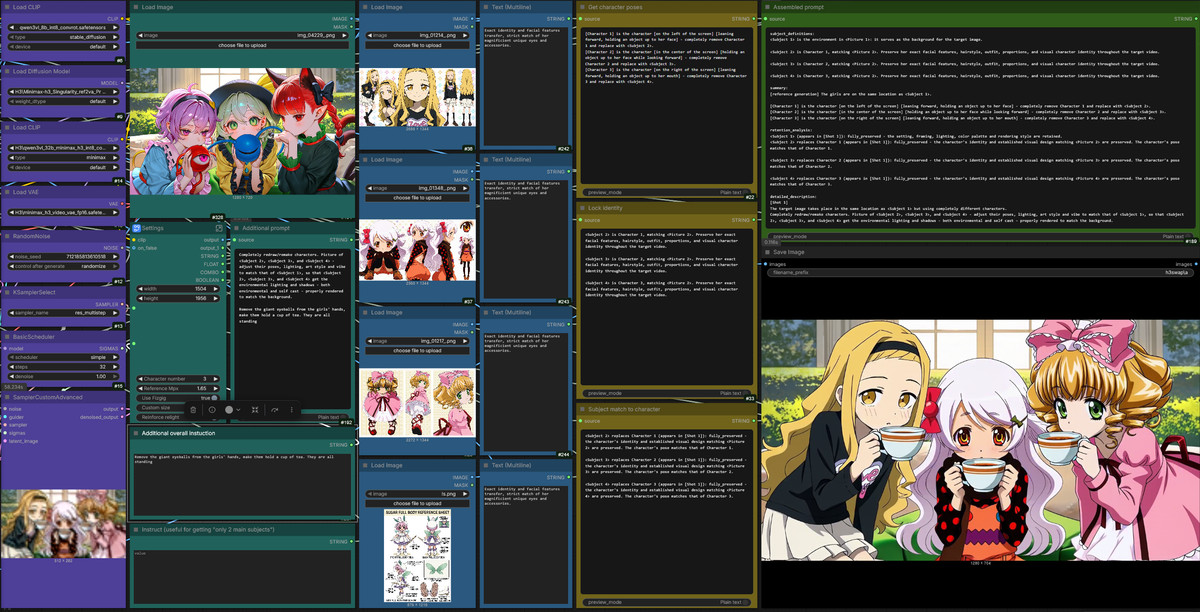
Quy trình làm việc thay thế nhân vật bằng chỉnh sửa hình ảnh H3: cung cấp một ảnh gốc và 1–4 ảnh tham chiếu nhân vật, thay thế 1–4 nhân vật trong khung hình bằng các nhân vật trong ảnh tham chiếu chỉ trong một lần.
Hình minh họa
Lý do đề xuất
- Mô hình mới (quy trình làm việc); phục vụ thay thế nhiều nhân vật trong áp phích, ảnh chụp chung, ảnh tĩnh, đầu vào là hình ảnh đơn lẻ chứ không phải video
- “Node công việc” tích hợp tự động so sánh nhân vật, lắp ráp lệnh chỉnh sửa; có thể xem trước mô hình đã nhận ra những nhân vật nào (thường là từ trái sang phải), lệnh cuối cùng có thể xem được
- Có thể thêm lệnh tổng thể để sửa chữa, thay đổi tư thế, đổi nền; mỗi nhân vật có thể thêm ghi chú (như thu nhỏ, già đi); Reinforce relight tự động thêm một câu chiếu sáng lại để nhân vật hòa nhập vào khung hình
- 2 ví dụ trực quan; phát hành khoảng 3 giờ với 50 lượt tải xuống (chỉ phản ánh mức độ quan tâm); giấy phép cho phép sử dụng thương mại và bán
Cách sử dụng
- Nhập H3 Replacer v1.3.json, chọn bộ mã hóa văn bản chính, mô hình khuếch tán và bộ mã hóa phụ trợ để lắp ráp lời nhắc (tác giả khuyến nghị qwen3vl_8b_int8_convrot)
- Đặt số lượng nhân vật 1–4 (bắt buộc) và kích thước ảnh tham chiếu trong Settings; khi không dùng fizgig thì là một biến tiềm ẩn đơn lẻ, tác giả cho biết nhanh hơn khoảng 20%, càng thêm nhiều nhân vật thì mức tăng tốc càng giảm; các tham số như số bước lấy mẫu không được tác giả cung cấp
Rủi ro và hạn chế
- Thứ tự nhận dạng nhân vật có thể thay đổi, tác giả khuyến nghị xem trước mỗi lần; việc thay thế nhân vật liên quan đến quyền hình ảnh, chỉ sử dụng cho các hình ảnh có sự cho phép
- Tham số lấy mẫu không được tác giả cung cấp; 1 ví dụ bị ẩn do phân loại; mục này chưa được chạy thử
Đáng chú ý (6)
【B】⛩️💀 DaSiWa MiniMax H3 💀⛩️ · DaSiWa GXS v5 Turbo
Mô hình cơ sở / Checkpoint · Cập nhật phiên bản · Tác giả Darksidewalker · Phát hành 11-09 06:46 · Tải xuống 146
Phiên bản Turbo Distilled của DaSiWa GXS v5: Cùng một bản hợp nhất Graviton nhưng thêm Pika-H3-Flex-HD-Turbo (REF2VA), xuất video trong 4 đến 8 bước.
Hình minh họa
Lý do đề xuất
- Cập nhật phiên bản: Ghi chú cập nhật nêu rõ việc thêm Pika-H3-Flex-HD-Turbo trên cơ sở hợp nhất v4 × v5 × Singularity v2; phiên bản trước là GXS v5 không distilled
- Tác giả cung cấp các mức bước: 4 bước để xem nhanh (chất lượng âm thanh sẽ giảm), 6 bước cơ bản, 8 bước cho chất lượng cao; Turbo khuyến nghị dùng euler / simple hoặc LCM / simple, Shift Video 6-12, Shift Audio 3-5
- Cũng cung cấp ba loại lượng tử hóa: INT8, W4A8, W6A8; phiên bản này có khoảng 3 giờ với 146 lượt tải xuống (chỉ phản ánh mức độ quan tâm)
Cách sử dụng
- Tải dưới dạng mô hình gốc ref2va của H3, dùng euler / simple hoặc LCM / simple, trước tiên dùng 4 bước để xem bản xem trước, khi xuất chính thức dùng 8 bước, Shift Video 6-12, Shift Audio 3-5
Rủi ro và hạn chế
- Không có ví dụ hiển thị được (1 ví dụ bị ẩn do phân loại); việc âm thanh giảm chất lượng ở 4 bước là do chính tác giả ghi chú
- Dung lượng tệp lớn; tác giả tuyên bố đã có giấy phép bằng văn bản từ MiniMax, nhưng người dùng vẫn phải tuân thủ giấy phép cộng đồng H3; mục này chưa được chạy thử
- Hình minh họa trên thẻ là hình do AI tạo, không phải hiệu quả thực tế của mô hình; tác giả không có ví dụ công khai ở mức bình thường
【B】⛩️💀 DaSiWa MiniMax H3 💀⛩️ · DaSiWa GXS v5
Mô hình gốc / Checkpoint · Cập nhật phiên bản · Tác giả Darksidewalker · Phát hành 11-09 06:46 · Tải xuống 189
Phiên bản hợp nhất mới GXS v5 (không distilled) của mô hình gốc DaSiWa H3: Hợp nhất DaSiWa v4, v5 và Singularity v2 thành trọng số đầy đủ ref2va.
Hình minh họa
Lý do đề xuất
- Cập nhật phiên bản: Ghi chú cập nhật nêu rõ đây là bản hợp nhất Graviton của DaSiWa v4 × DaSiWa v5 × Singularity v2; phiên bản trước là Hybrid v4
- Tác giả cung cấp cài đặt khuyến nghị: res_multistep hoặc euler / simple, Shift Video 10-12, Shift Audio 3-5, 20-25 bước
- Cung cấp ba loại lượng tử hóa: INT8, W4A8, W6A8; trang này tích lũy 71904 lượt tải xuống, phiên bản này có khoảng 3 giờ với 189 lượt (chỉ phản ánh mức độ quan tâm)
Cách sử dụng
- Tải dưới dạng mô hình gốc ref2va của H3 (chọn loại lượng tử hóa trong menu tải xuống), dùng res_multistep / simple hoặc euler / simple, 20-25 bước, Shift Video 10-12, Shift Audio 3-5; xem hướng dẫn quy trình làm việc của tác giả để biết các phụ thuộc
Rủi ro và hạn chế
- Không có ví dụ hiển thị được (1 ví dụ bị ẩn do phân loại), những thay đổi sau khi hợp nhất chỉ được tác giả ghi là "xem thông báo"
- Dung lượng tệp lớn; tác giả tuyên bố đã có giấy phép bằng văn bản từ MiniMax, nhưng người dùng vẫn phải tuân thủ giấy phép cộng đồng H3 và chính sách sử dụng
- Mục này chưa được chạy thử
- Hình minh họa trên thẻ là hình do AI tạo, không phải hiệu quả thực tế của mô hình; tác giả không có ví dụ công khai ở mức bình thường
【B】CROWN True First-Person Subjective POV & Interactive Gaze | MiniMax H3 · v2.0 - VideoOnly r64
LoRA · Mô hình mới · Tác giả NineCrowns · Phát hành 11-09 08:39 · Tải xuống 40
LoRA góc nhìn chủ quan ngôi thứ nhất của CROWN: Cho phép "đôi tay của chính mình" đưa vào từ cạnh dưới màn hình để rót rượu, cầm ly, và hỗ trợ quay một cảnh liên tục với động tác cúi đầu, ngẩng đầu.
Hình minh họa
Lý do đề xuất
- Mô hình mới; phục vụ vlog ngôi thứ nhất, các cảnh quay chủ quan kiểu hẹn hò tương tác, tác giả ghi rõ hỗ trợ Ref2VA / I2VA / T2VA
- Giải quyết vấn đề cụ thể: H3 thường gặp lỗi cánh tay đưa ngang từ bên vào, hoặc nhân vật thừa ra bàn tay thứ ba; tác giả tuyên bố LoRA này giúp tay chỉ đưa vào từ chính giữa cạnh dưới màn hình
- Chỉ huấn luyện lớp video (Rank 64, Blocks 10–49); cấu hình thử nghiệm đầy đủ: 25 bước euler + beta, CFG 1.0, shift_video 12.0, shift_audio 3.0
Cách sử dụng
- Viết prompt với từ khóa crown_pov, cường độ 0.80–0.85; 25 bước euler + beta, CFG 1.0, đặt shift_video 12.0, shift_audio 3.0 trong MiniMaxH3SigmaShift
Rủi ro và hạn chế
- Ví dụ duy nhất bị ẩn do phân loại, không thể xem hiệu quả; mô tả chức năng đều là tuyên bố của tác giả
- Tên phiên bản là v2.0, nhưng trang chỉ có phiên bản này, không có v1 để so sánh; mục này chưa được chạy thử
- Hình minh họa trên thẻ là hình do AI tạo, không phải hiệu quả thực tế của mô hình; tác giả không có ví dụ công khai ở mức bình thường
Từ khóa kích hoạt: crown_pov
【B】1980s Movies AiO LoRA · v1.0 - Minimax H3
LoRA · Mô hình mới · Tác giả neph1 · Phát hành 11-09 03:42 · Tải xuống 113
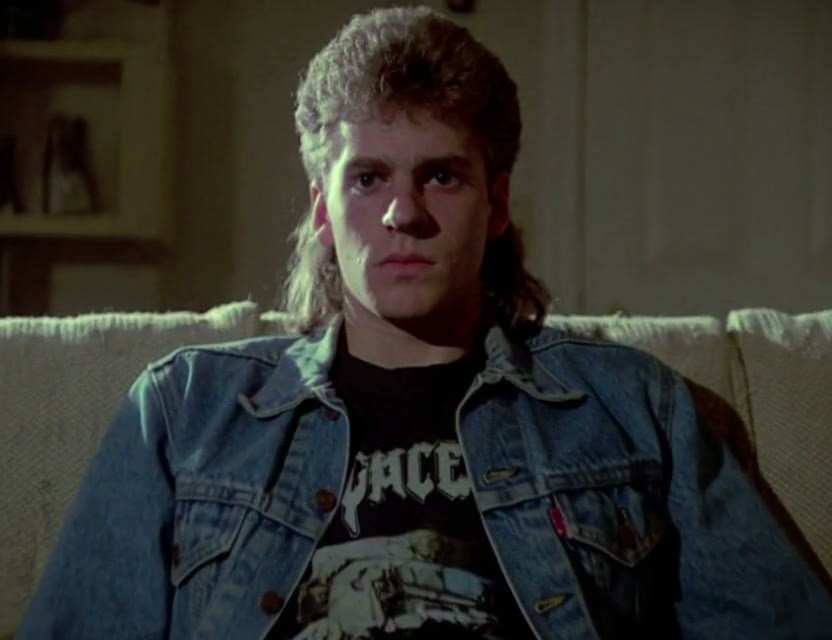
LoRA phong cách hợp nhất ba LoRA H3 phong cách điện ảnh thập niên 1980 của tác giả bằng phương pháp DARE TIES.
Hình minh họa
Lý do đề xuất
- Mô hình mới; phục vụ video mang phong cách phim cũ / TV cổ điển, một tệp thay thế cho ba LoRA
- Tác giả giải thích rằng sau khi hợp nhất, các khái niệm đơn lẻ có thể không mạnh bằng bản gốc riêng biệt, nhưng về phong cách thì tác giả cho là ổn; ví dụ cố ý dùng cùng prompt và cài đặt để dễ so sánh
- Phát hành khoảng 6 giờ với 113 lượt tải xuống, nằm trong nhóm có mức độ quan tâm cao trong số các mục không nhạy cảm kỳ này (chỉ phản ánh mức độ quan tâm); giấy phép cho phép sử dụng thương mại và bán
Cách sử dụng
- Tải tệp 1980s_aio_dare_ties_0_8.safetensors; tác giả không cung cấp từ khóa kích hoạt và cường độ, hãy tham khảo prompt trong ví dụ
Rủi ro và hạn chế
- Mô tả rất ngắn, không có từ khóa kích hoạt, cường độ và tham số lấy mẫu
- Chỉ có 1 đoạn video hiển thị được, 2 đoạn bị ẩn do phân loại; mục này chưa được chạy thử
【B】Stone And Gold · MiniMaxH3
LoRA · Chuyển đổi · Tác giả MisterMR · Phát hành 11-09 01:45 · Tải xuống 39
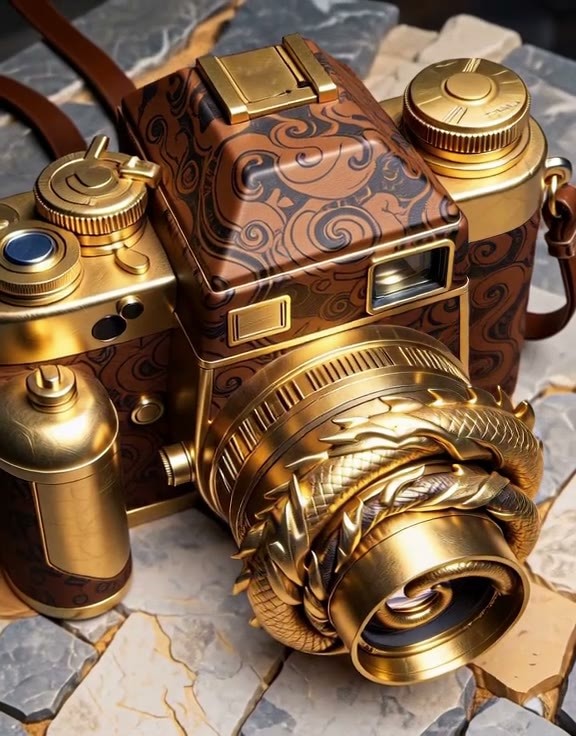
Phiên bản chuyển đổi H3 của LoRA phong cách vật liệu "Đá và Vàng": Tạo hiệu ứng các vật thể trong khung hình có kết cấu đá thô khảm vàng.
Bản gốc là LoRA cũ từ thời SD 1.5, các tính từ trong mô tả được sao chép nguyên văn, hiệu quả cụ thể của phiên bản H3 chỉ có thể xem qua ví dụ.
Hình minh họa
Lý do đề xuất
- Chuyển đổi: Trang này đã có các phiên bản SD 1.5, SDXL 1.0, Krea 2, ZImageTurbo, đây là phiên bản video H3 mới thêm; mô tả沿用 (sử dụng lại) văn bản quảng cáo của bản gốc, không nêu rõ phiên bản H3 khác biệt thế nào
- Phục vụ tạo video từ văn bản / hình ảnh với phong cách vật liệu hóa; trang này tích lũy 754 lượt tải xuống (chỉ phản ánh mức độ quan tâm của loạt gốc)
- Có nhiều đoạn video ví dụ hiển thị được, có thể xem ví dụ trước khi quyết định
Cách sử dụng
- Tải tệp MisterMR_StoneAndGold_MiniMaxH3.safetensors; tác giả không cung cấp từ khóa kích hoạt, cường độ và tham số lấy mẫu, hãy tham khảo ví dụ
Rủi ro và hạn chế
- Mô tả chỉ có mô tả phong cách, không có bất kỳ tham số sử dụng nào
- 8 ví dụ bị ẩn do phân loại; giấy phép chỉ cho phép cho thuê trong trang, không cho phép tạo phái sinh; mục này chưa được chạy thử
【B】MInimax H3 Studio, Pixel Upscale Optimized for NVIDIA ONLY · v2.0
Quy trình làm việc · Mô hình mới · Tác giả hRUSTIN474 · Phát hành 11-09 00:10 · Tải xuống 70
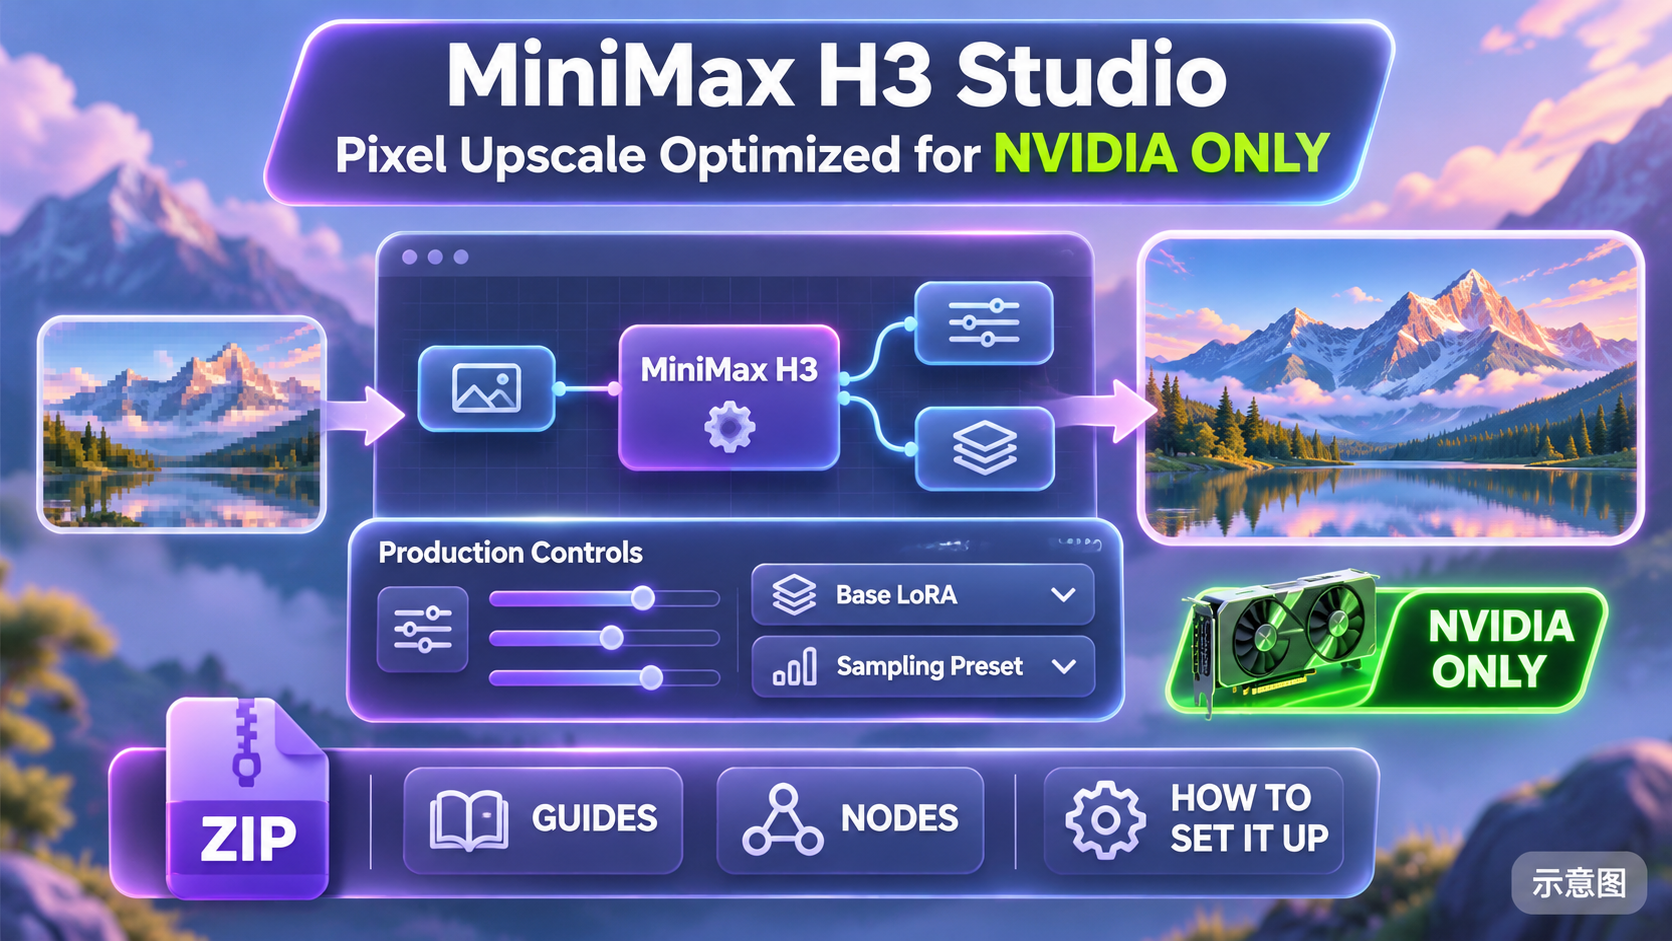
Quy trình làm việc "Studio" đa cảnh H3 phiên bản v2.0: Tạo video từ văn bản / hình ảnh / hình tham chiếu theo từng cảnh theo kế hoạch, sau đó siêu phân giải và chỉnh màu riêng cho từng đoạn để xuất thành phim; chỉ hỗ trợ card đồ họa NVIDIA.
Hình minh họa
Lý do đề xuất
- Mô hình mới (quy trình làm việc); mô tả phiên bản này nêu rõ đã loại bỏ phóng đại không gian tiềm ẩn (latent space upscale), thay bằng RelayVSR để phóng đại riêng cho từng đoạn
- Phục vụ sản xuất video dài: mỗi cảnh là một đoạn trong nút kế hoạch / chỉnh sửa, có thể kiểm tra thời lượng, seed và thứ tự; tùy chọn dùng mô hình viết cục bộ để tự động viết lại prompt; đối thoại cần đánh dấu ngôn ngữ cho từng câu (ví dụ: [English])
- Gói nén kèm theo hướng dẫn cài đặt và các nút; cũng có quy trình làm việc con để siêu phân giải riêng cho video có sẵn
Cách sử dụng
- Sau khi giải nén, cài đặt các nút theo hướng dẫn trong gói; chọn mô hình, LoRA tăng tốc đi kèm và preset lấy mẫu trong Production Controls, dùng giá trị mặc định cho lần thử đầu tiên; T2V không dùng hình, I2V đặt hình khung đầu tiên, REF2V nối hình tham chiếu và ghi rõ trong prompt mỗi hình cung cấp gì
Rủi ro và hạn chế
- Chỉ hỗ trợ NVIDIA; chuỗi xử lý hậu kỳ (RelayVSR, DLSS, RTX HDR) phụ thuộc nhiều, mô tả đầy đủ ghi sẽ thực hiện chuyển đổi HDR, không phải giữ nguyên HDR gốc
- 2 ví dụ đều bị ẩn do phân loại, không thể xem hiệu quả
- Tên phiên bản là v2.0 nhưng tên tệp trong gói nén là v1.0 Beta, kèm theo một tệp txt không rõ mục đích; giấy phép không cho phép tạo phái sinh; mục này chưa được chạy thử
- Hình minh họa trên thẻ là hình do AI tạo, không phải hiệu quả thực tế của mô hình; tác giả không có ví dụ công khai ở mức bình thường
Chỉ liệt kê (5)
- Sophie Whitemoon · MiniMaxH3 — LoRA: LoRA nhân vật Sophie Whitemoon, một nhân vật nữ hư cấu (theo thiết lập thủ thư lưu trữ phong cách steampunk) cho H3.
- Quy trình tạo và chỉnh sửa ảnh MiniMax H3 · v1.0 — Quy trình làm việc: Một gói nén quy trình làm việc cho việc tạo và chỉnh sửa ảnh trên H3, chỉ kèm theo một liên kết hướng dẫn trên YouTube.
- Lillian Roccabruna · MiniMaxH3 — LoRA: Phiên bản LoRA nhân vật được chuyển thể cho H3 của nhân vật hư cấu Lillian Roccabruna (theo thiết lập nhà thiết kế đồ họa tại Florence).
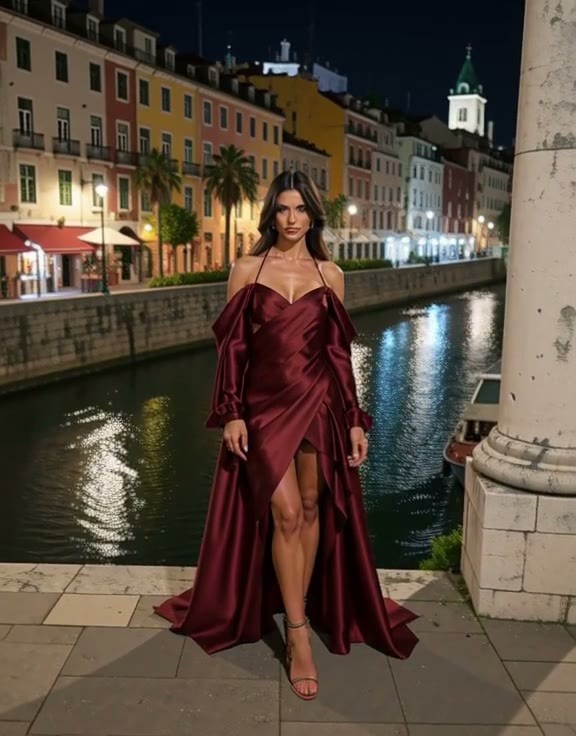
- Peyton Belwyn · MiniMaxH3 — LoRA: Phiên bản LoRA nhân vật được chuyển thể cho H3 của nhân vật hư cấu Peyton Belwyn (theo thiết lập chủ hầm rượu tại Bruges).
- Vòng chơi MOSS BBOX với tính năng tự động vẽ khung bằng các đoạn clip Qwen · v1.0 — Quy trình làm việc: Một quy trình làm việc "Vòng chơi bố cục MOSS": sử dụng bộ mã hóa văn bản Qwen để tự động vẽ khung, kiểm soát bố cục hình ảnh theo khung.
Dữ liệu: API công khai của Civitai (mô hình cơ sở MiniMax H3), khoảng thời gian thu thập từ 11-08 20:31 đến 11-09 09:18 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ phản ánh mức độ quan tâm.