貞貞のAIレーダー · MiniMax H3 · 2026-11-14 朝刊
今号の 16 個の新バージョン:強く推奨 2 · 推奨 5 · 注目 3 · 収録のみ 6
編集者按語 今号では 16 個の H3 新バージョンをレビューしました。評価は S が 2 個、A が 5 個、B が 3 個、C が 6 個です。初回特集は AusBoss 氏の Pika Remix です。最大4枚の画像と1本の動画をそれぞれ用途別に設定でき、@1 を使ったプロンプト作成で、参考画像からの動画生成、人物の入れ替え、物体の変更、動作の模倣、動画の続きの生成などが可能です。Low VRAM モードは 8 GB から対応しています。もう一つの S 評価は Ultimate 12GB です。ドロップダウンメニュー一つで 8 種類の H3 モードを切り替えられ、コアノードのみを使用します。Viggle のキャラクター置き換え、Relight の再ライティング、Person Swap v1.1、Unified Nova.4 は A 評価です。Singularity の顔交換は、53.2 GB のダウンロードサイズ、2つのカスタムノードパッケージ、肖像権の同意問題により S から A に格下げされました。Easy MH3 v2.0 は B に格下げ、FastH3 のリップシンク(有料パッケージの無料サンプル)、Lora-Daddy V4 と Self Lift(説明不足)、EZ Cinematrix(サンプルがすべて非表示)は C に格下げ、2つの MikoGoblin キャラクター移植は C のまま維持されました。
強く推奨(2)
【S】MiniMax H3 Pika Remix | High + Low VRAM, 8 GB+ · v1.0
ワークフロー · 新モデル · 作者 AusBoss · 公開 11-14 05:53 · ダウンロード数 67
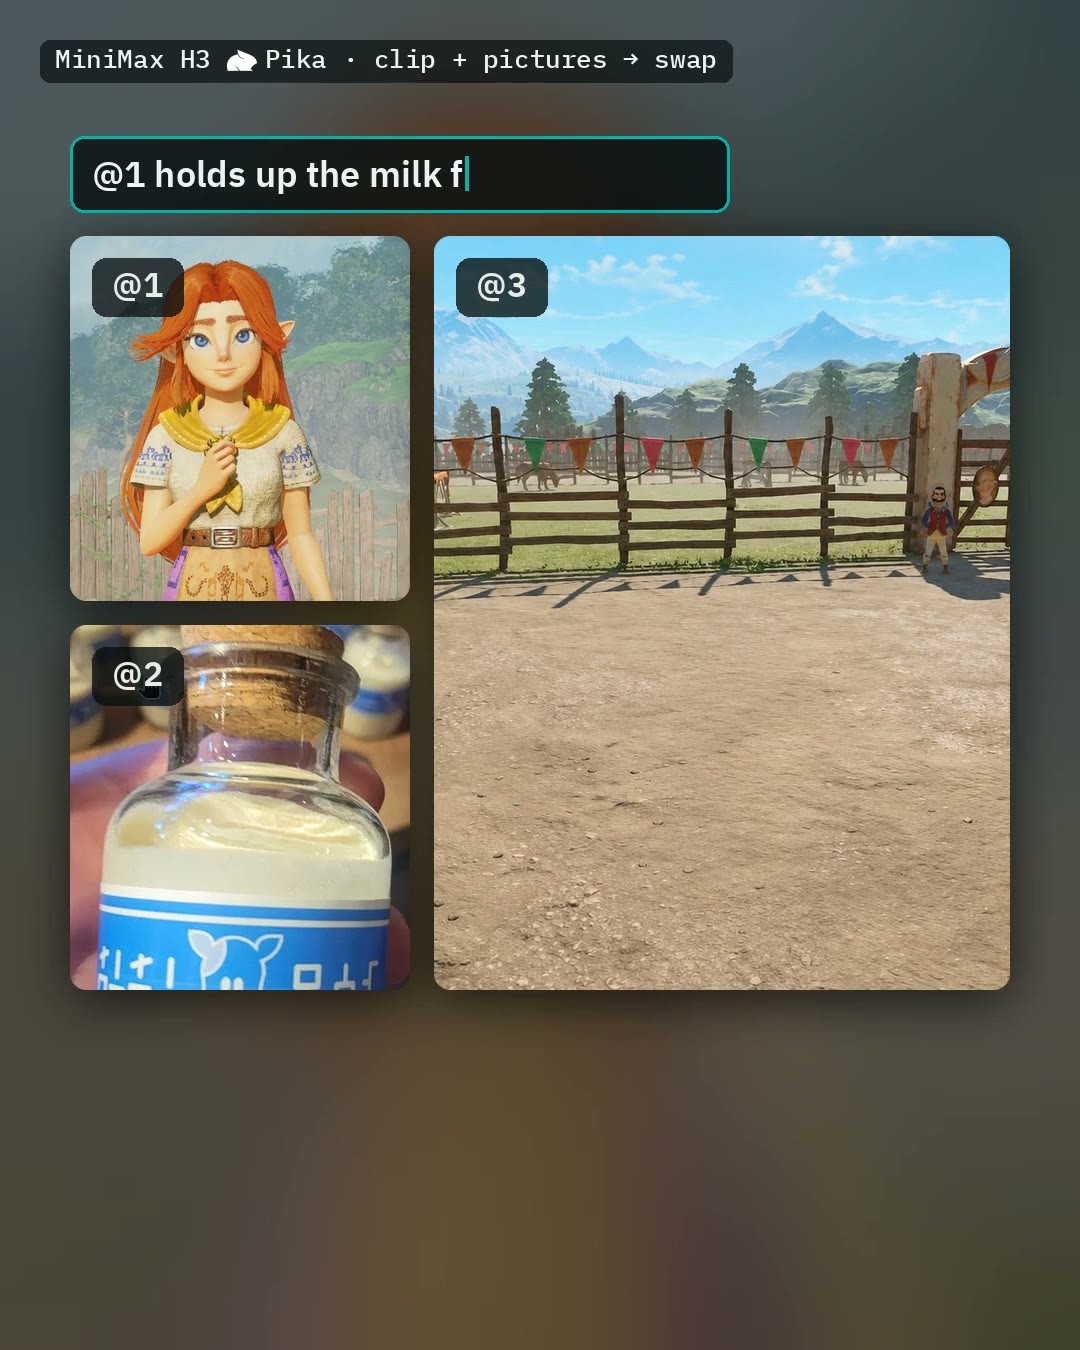
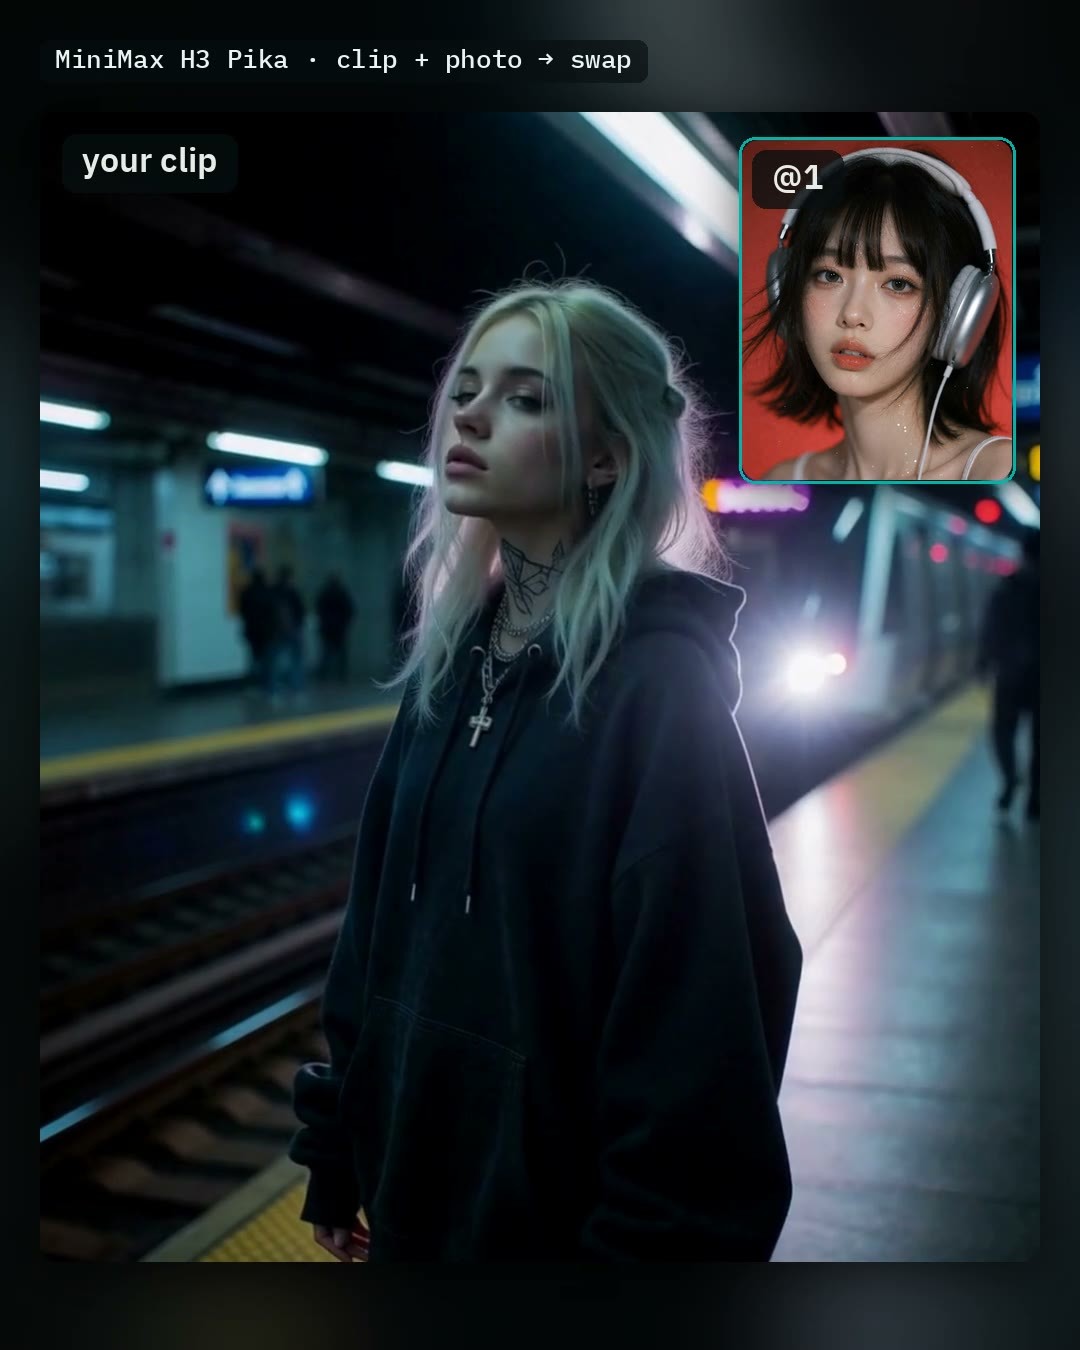
H3 + Pika の多目的ワークフローです。最大4枚の画像と1本の動画を使用し、各素材に用途を指定することで、参考画像からの動画生成、動画内の人物入れ替え、動画内の特定物体の変更、動作の模倣、動画の続きの生成などが可能です。
画像
推奨理由
- 新しいツールで、参考画像からの動画生成と動画編集を1つのワークフローでカバーします。各画像で人物 / シーン / 服装 / 物を指定し、プロンプト内で @1、@2 を使用して参照します。動画では「人物入れ替え」「特定物体の変更」「動作の模倣」「続きの生成」を選択でき、元の音声、ボーカル、音楽の追加も可能です
- VRAM に配慮しています。High VRAM は 24 GB 以上向け、Low VRAM は 8 から 24 GB まで対応します(より小さいメインモデルと VAE を使用)。スイッチには Fast preview、Auto prompt、および完成動画を2倍に拡大しシャープ化する FlashVSR が含まれます
- サンプルが充実しています。5 本の動画と 1 枚の画像がすべて表示され、作者の YouTube 解説動画も添付されています。人物入れ替えのみを行う場合は、同じ作者によるより軽量な Person Swap を使用できます
使い方
- Picture 1 で画像を読み込み、H3 Prompt Writer で用途を選択 → 各アクションを1行ずつ記述(例:@1 walks to the window and looks out)→ Seconds で長さを設定 → High / Low VRAM を選択 → Run
- Pika LoRA の強度は 1 のままにしてください。Turbo や Lightning LoRA を重ね掛けしないでください(Pika 自体が加速機能を持っています)。ComfyUI 0.38.0 以上(8 GB カードでは 0.45 以上、Auto prompt には 0.42.0 以上)と AusBoss ノード 2.25.2 以上が必要です
リスクと制限
- 必須モデルは約 44.5 GB です(ref2va int8 メインモデル 21.0 GB、Qwen3-VL 32B テキストエンコーダー 15.7 GB など)。Auto prompt と FlashVSR は別途ダウンロードが必要です
- 作者によると、8 GB カードでは Low VRAM を選択し、動画長を 10 秒以下に抑え、システムメモリは約 32 GB 必要です。人物、シーン、物体を同時に一度に変更すると、元の人物が途中で現れることがあるため、一度に一つだけ変更することを推奨します
- 人物入れ替えと動作の模倣では他人の肖像を使用します。同意を得た人物のみで使用し、肖像権にご注意ください
- ベースモデルは MiniMax H3 コミュニティライセンスの制約を受けます
【S】MiniMax H3 Ultimate 12GB — T2V/I2V/FFLF/R2V/Multiframe/ControlNet/Extend, one dropdown, with audio · v2.3.0
ワークフロー · 新モデル · 作者 The_frizzy1 · 公開 11-13 23:51 · ダウンロード数 55
ドロップダウンメニュー一つで 8 種類のローカル H3 モードを切り替えるワークフローです。テキストから動画、最初のフレーム、最後のフレーム、最初と最後のフレーム、参考画像、マルチフレームガイド、ControlNet ポーズ、動画の続き生成に対応し、すべて音声付きです。
画像
推奨理由
- 新しいツールで、H3 の主要タスクをカバーします。テキストから動画、画像から動画、最初と最後のフレーム、参考画像(プロンプトに <Picture 1> と記述)、マルチフレームガイド、ポーズ制御、続き生成に対応します。ComfyUI コアノードのみを使用し、カスタムノードのインストールは不要です
- v2.3.0 で「続き生成時に元の動画の音声を保持する」機能が追加されました。元の動画の最後の 0.9 秒分の音声と最後の 22 フレームを一緒に送ることで、継ぎ目での音声の途切れを防ぎます
- 作者は RTX 3060 12 GB 環境での VRAM ピーク値 11.3–11.6 GB、システムメモリピーク値 17–22 GB を報告しています。9 本の動画と 2 枚の画像サンプルが表示されています
使い方
- ComfyUI 0.39.2(v2.3.0)が必要です。ノードの Mode ドロップダウンでモードを選択し、そのモードで使用される入力のバイパスを解除します(選択後 Ctrl+B)。それ以外はバイパスのままにしてください
- Turbo LoRA はデフォルトで有効です。FL2VA は 8 ステップ、Ref2VA は 4 ステップです。Turbo を無効にする場合は 20 ステップを使用します。長さは秒単位で入力し、ワークフローが自動的に有効なフレーム数に変換します
リスクと制限
- すべての 10 個のモデルで約 69 GB です。テキストから動画 / 画像から動画 / 最初と最後のフレーム / 続き生成のみを行う場合は、そのうち 5 個、約 42 GB で済みます
- 作者によると、12 GB カードでは解像度を 0.4 または 0.9 MP に保つ必要があります。1.5 MP では VRAM が溢れます。使用しない入力をバイパスしていない場合、実行前に Invalid image file エラーが発生します
- 長い動画は Extend を手動で繰り返し実行する必要があります。全体の人物入れ替えモードは含まれていません(別途 Viggle ワークフローがあります)
- 9 個のサンプルが非表示です(混合コンテンツ)
推奨(5)
【A】MiniMax H3 Singularity V2 Face Swap 12GB — one photo into your video, lip-sync, sound and room kept · v1.0.0
ワークフロー · 新モデル · 作者 The_frizzy1 · 公開 11-14 00:02 · ダウンロード数 71
1枚の写真を使って動画内の実在人物を写真の人物に置き換えます。部屋、カメラワーク、元の音声は保持され、全体を一括で生成します。リップシンクも可能です。
画像
推奨理由
- 新しいツールで、動画内の人物入れ替えに対応します。SAM 3.1 で置き換える人物を追跡し、ポーズ、手、口型を保持したグレーのシルエットに変換します。その後、Singularity V2(H3 Ref2VA ファインチューニング)が写真に基づいてマスク領域のみを描き直します
- Qwen3-VL 8B が4フレームを見てカメラワークの説明を一文作成します。作者によると、この説明がない場合、Singularity はグレーのシルエットを無視し、画面中央に巨大な頭部を描画してしまいます
- 作者は RTX 3060 12 GB、32 GB メモリ環境での動作を確認しています。VRAM ピーク値は 11,598–11,731 MiB です。5 本の動画が表示されています
使い方
- App モードで開いてください。入力には 24 fps、鏡のない動画(最大 15 秒)、顔が大きく背景がシンプルな鮮明な写真、置き換える対象(例:person や bald man)、新しい人物の外見説明が必要です。Seconds はまず 3 秒で試すことを推奨します
- カスタムノードパッケージ comfyui-h3-oneclick-swap と ComfyUI-Fantastic-MiniMaxH3-PromptBuilder の2つが必要です。作者は ComfyUI 0.43.1 を使用しています。内部設定では ref2v turbo LoRA 強度 1.0、6 ステップ、euler / simple が指定されています
リスクと制限
- 人物入れ替えツールです。本人または同意を得た人物のみで使用し、肖像権にご注意ください。実在人物のなりすましには使用しないでください
- 必須ファイルは 7 個で合計 53.2 GB です。作者による最大のダウンロードセットです。システムメモリピーク値は 22–23 GB です
- 作者によると、全身ショットでは頭部が依然として大きくなることがあります。写真が腰までしかない場合は、説明にズボンと靴を追加してください。一度に一人のみ置き換え、鏡や反射には対応していません
- 12 個のサンプルが非表示です(混合コンテンツ)。自動評価は S でしたが、ダウンロードサイズが大きく、2つのカスタムノードパッケージへの依存、肖像権の同意問題があるため A に格下げされました
【A】Viggle-Animate (MiniMax H3) 12GB — character replacement in video, 4 steps, the driving clip's audio kept · v2.0.0
ワークフロー · 新モデル · 作者 The_frizzy1 · 公開 11-14 05:39 · ダウンロード数 29
キャラクターの静止画1枚を使って動画内の人物を置き換えます。動作、カメラワーク、背景、駆動動画の元の音声はすべて保持され、4 ステップで出力されます。
画像
推奨理由
- 新しいツールで、動画内のキャラクター置き換え / 動作転送に対応します。Viggle の H3 Ref2VA 33B ファインチューニングに基づいています。モードは一つのみで、駆動動画1本とキャラクター画像1枚を使用します
- 作者は RTX 3060 12 GB 環境での VRAM ピーク値 11.2–11.6 GB を報告し、必要な 4 個のモデルファイルと保存ディレクトリをリストアップしています
使い方
- Comfy registry の comfyui-viggle-animate-h3 v1.3.2 をインストールし、ComfyUI は 0.37.4 以上を使用してください。ビデオ VAE には、他の H3 ワークフローでよく使われる int8 版ではなく、fp16 版の minimax_h3_video_vae_fp16 を使用します
- The_frizzy1_viggle-animate-h3_v2.0.0.json を読み込み、駆動ビデオとキャラクター画像を配置して Run を実行します。ステップ数は 4 に固定されています
リスクと制限
- 作者によると、このワークフローにはまだ独自のデモ動画がなく、公開されている動画は一般的な使用チュートリアルです。また、3 枚の画像が表示可能で、3 件のサンプルが非表示になっています
- 5 秒、解像度 480x864 / 832x480 のクリップでのみテスト済みです。VRAM はほぼ 12 GB を使い切っており、より長い・より大きなサイズは未テストです。作者は v2.0.0 が v1 から何を変更したかについて記載していません
- メインモデルのサイズは 21.0 GB です
- 顔交換ツール:本人または同意を得た人物にのみ使用し、肖像権に注意してください。実在の人物になりすますために使用しないでください
【A】MiniMax H3 Pika Person Swap | High + Low VRAM, 8 GB+ · v1.1
ワークフロー · バージョン更新 · 作者 AusBoss · 公開日 11-14 05:53 · ダウンロード数 93
写真内の人物を動画に挿入して元の人物と置き換えます。シーン、動作、カメラワーク、音声は保持されます。v1.1 では 8 GB の GPU がサポートされており、最終的なアップスケールには FlashVSR を使用します。
画像
推奨理由
- バージョン更新:Low VRAM モードは 8 から 24 GB の VRAM をカバーします。作者によると、8 GB のカードでもシステムメモリが 32 GB あれば、起動パラメータなし(ComfyUI 0.45)で最長 8 秒のクリップをフルサイズで実行可能です
- 最終的なアップスケールを SeedVR2 から FlashVSR に変更しました。よりシャープになり、2倍に拡大でき、モデルはわずか 3.5 GB です。機能しなかった「Steer the mouths」スイッチを削除しました。「Keep the clip's sound」を有効にした場合でも、新しい人物の口元は元の音声に追従します
- 「Describe @1 for me」(写真から外見の説明を自動生成)は、作者によるとシステムメモリ 32 GB 内で完結できるようになりました。また、他の H3 ノードパッケージによって引き起こされる latent エラーも修正されました
使い方
- 「Video - Your clip」でクリップを読み込み、1つのショットに切り出します(最長 10 秒)→「Picture 1」に新しい人物の写真を配置 → プロンプトを2行記述します。1行目で誰を置き換えるか指定し(例:Replace the man in the red shirt with @1)、2行目で @1 looks like … と髪型や顔の特徴を説明します → High(24 GB 以上)または Low VRAM を選択して Run を実行します
- AusBoss ノード 2.25.2 以上、ComfyUI 0.38.0 以上が必要です
リスクと制限
- 顔交換ツール:本人または同意を得た人物にのみ使用し、肖像権に注意してください。実在の人物になりすますために使用しないでください
- 作者によると、顔が小さすぎる場合や後ろを向いている場合、H3 は元の動画の顔を保持したまま髪型と服だけを変更する可能性があります。2行目の説明を書かない場合、交換が遅れるか、まったく交換されないことがあります
- メインモデル 21.0 GB、テキストエンコーダ 15.7 GB などは別途用意する必要があります。公開されているサンプルは動画 1 本と画像 1 枚です
【A】MiniMax H3 Relight 12GB — relight any video from a light sphere, Full HD 1088p, up to 60 s, original sound · v1.0.0
ワークフロー · 新モデル · 作者 The_frizzy1 · 公開日 11-14 05:39 · ダウンロード数 25
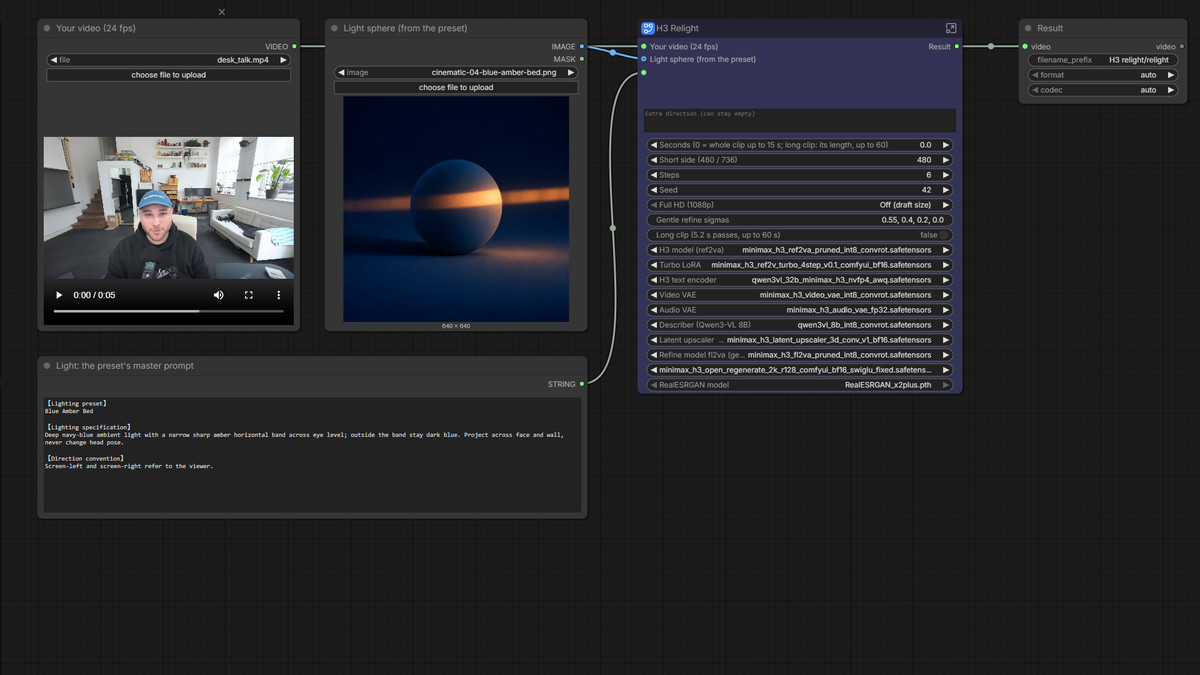
既存の動画に再ライティングを施します。入力動画、ライティングボール画像、ライティング説明文を入力すると、同じショットで新しい光効果を持つ出力が得られます。人物、部屋、カメラ位置、リズム、元の音声は変更されません。
画像
推奨理由
- 動画ポストプロダクションのライティング調整向けの新しいツールです。Sirio Berati が元々 80 GB のレンタル GPU 向けに作成したオープンソースの relight を、12 GB の GPU でローカルに再現します。H3 Ref2VA int8 と ref2v turbo LoRA に基づいています
- ComfyUI のコアノードのみを使用します。オプションで Full HD(H3 による穏やかなリペイントまたは RealESRGAN x2、短辺を 1088p に)や、Long clip による分割処理(最長 60 s)が利用可能です
- 作者は RTX 3060 12 GB 環境での VRAM ピーク値 11,841–11,945 MiB およびシステムメモリピーク値 21.4–22.6 GB を提供しています
使い方
- ライティングプリセットとボール画像は sirioberati/relight-open-source(MIT)から取得します。ボール画像を「Light sphere」入力に配置し、presets.json 内の対応する master テキストを「Light text」入力に配置します
- ComfyUI 0.44 以上が必要です。動画は 24 fps で読み込まれ、単一実行の最長は 15 s です。短辺については高速モードまたは高シャープモードを選択できます。turbo LoRA を使用する場合、作者はステップ数を 6 に設定しています
リスクと制限
- 必須ファイルは 6 個で合計 51.5 GB です。Full HD の穏やかなリペイントを有効にするとさらに 23.7 GB 必要になります
- 作者によると、Long clip とワークフロー内の RealESRGAN はまだ GPU で実際にレンダリングされておらず、所要時間のデータはありません。736 の短辺で穏やかなリペイントを行い 5.2 s のクリップを処理する場合、31:48 かかります
- サンプル動画はなく、画像が 1 枚あるのみです
【A】MiniMax H3 Unified (Lip-sync, Scene Prompts and Resumable Video) · Nova.4
ワークフロー · バージョン更新 · 作者 Rvage · 公開日 11-14 05:10 · ダウンロード数 26
統合型 H3 長尺動画ワークフロー Nova.4 です。キャラクター画像を使って既存の曲やセリフにリップシンクさせることも、シーンプロンプトに基づいてテキスト/画像/最初と最後のフレームから音声付き動画を生成することも可能です。分割レンダリングに対応し、中断からの再開や特定セグメントからの再実行ができます。
画像
推奨理由
- バージョン更新:リップシンクの最初のセグメントで隠しウォームアップを個別に設定でき、最終動画では完全な音声トラックとタイミングが保持されます。複数のリップシンク画像それぞれに対応するシーンプロンプトを設定できます。1枚の画像でも手動で複数のカットポイントを指定可能です。Scene Detector は短いディゾルブ内の外見変化も追加でチェックします
- オプションの最終アップスケールグループ(字幕追加と保存の前)が新規追加されました。Smart LM モードバーでは、フリーズした言語モデルとその Ollama/Docker バックエンドをワンクリックで停止できます。Eclipse Nova を 1.0.36 に、SmartLLM Nova を 1.1.17 に更新する必要があります
- 長尺動画やミュージックビデオ向けです。参照動画の分析によりシーンを切り出し動作を記述でき、レンダリング前に Prompt Review でプロンプトを修正できます。YuE2 または MiniMax Music 3 を接続して BGM を生成でき、歌詞抽出と動的字幕に対応しています
使い方
- Eclipse Nova、Smart Model Loader Nova、SmartLLM Nova の3つのノードパッケージをインストールします(H3 パッチと Diff-Aid は ComfyUI-sol-attn から取得し、音声分離には Audio Separation Nodes を使用しますが、最初はミュートして使用しないことも可能です)
- START HERE で Lip-sync または Native H3 を選択し、Smart Model Loader と LoRA Stack で対応するプリセットを選択します。H3 は 24 FPS に維持してください。作者のリップシンクサンプルでは Euler / beta、CFG 1、ステップ数 8、turbo LoRA 強度 1 が使用されています
- ストレージ設定で Disk + Keep in output を選択します。中断後は Resume saved run で再開し、Restart part で再実行するセグメントを指定します
リスクと制限
- ライセンスにより商用利用と派生物の作成が禁止されています
- 依存関係が多いです:3つの Nova ノードパッケージに加え複数のオプションパッケージが必要で、リップシンクにはさらに wav2vec2 オーディオエンコーダが必要です。更新後は ComfyUI を再起動し、シーン分析を再実行する必要があります
- 公開されているサンプルは画像 1 枚のみで、1 件が非表示です(混合コンテンツ)。作者によると、急激なポーズ変化や背景が類似しているクリップでは検出漏れが発生する可能性があります
注目すべき項目(3)
【B】Easy MH3 (video generation + upscale using chunking + 60 FPS) (low VRAM support) · v2.0
ワークフロー · バージョン更新 · 作者 Crimson009 · 公開日 11-14 00:50 · ダウンロード数 39
H3 生成とチャンク分割アップスケールを組み合わせた2段階ワークフロー v2.0 です。まず動画を生成し、次にチャンク分割してアップスケールした後、RIFE でフレーム補間を行い 60 FPS にします。低 VRAM 環境に配慮しています。
画像
推奨理由
- バージョン更新(モデルカードに記載、バージョン説明は空欄):紫色のスイッチで単一セグメントまたは2セグメントのプロセスを選択します。各セグメントに画質優先/リソース節約オプションが追加されました。両方のセグメントで最初と最後のフレームを保存でき(次のセグメントへの接続用)、音声なしバージョンも保存可能です
- デフォルトでは Temporal chunk と RIFE を使用して VRAM を節約し、最終動画を 60 FPS に補間します。VRAM がさらに少ない場合は Spatial Chunk を有効にしてより細かく分割できます。各セグメントの終了後、Free VRAM ノードで VRAM を解放します
使い方
- 「Prompt, Loras and References」グループにプロンプトと素材を入力 → 第1段階で Video duration と Video settings を調整 → 第2段階で Upscale Resolution Selector を選択して Run を実行します。赤いノードは一度きりのモデル設定用です
- 必要なモデルファイル、VRAM、ステップ数については作者から提供されていません
リスクと制限
- 公開されているサンプルは画像 2 枚のみで、3 件が非表示です。動画はありません。本バージョンの変更は主にスイッチと保存オプションであり、自動評価は A から B に降格されました
- バージョン説明は空欄であり、依存するカスタムノードもリストされていません
【B】HyperFlow H3 Flash — Fast Video with Sound in 4–8 Steps (ComfyUI) · v1.0
ワークフロー · 新モデル · 作者 lahcenbensalah19488 · 公開日 11-14 01:24 · ダウンロード数 36
HyperFlow H3 Flash の無料テキストから動画へのプリセット:作者が 13.7B と呼ぶ圧縮版の H3 を使用し、4 ステップで 5.2 秒のステレオ音声付きドラフトを生成し、最終版では 6 または 8 ステップに切り替えます。
画像
推奨理由
- プロンプトの高速試行向けの新しいツールです。FastDraft プリセットではまず 4 ステップでカメラワークと音声アイデアを確認し、その後 6 ステップ(バランス)または 8 ステップ(品質)で最終版を作成します
- 依存関係が明確に記述されています:ComfyUI 0.43.0 以上に加え、ComfyUI-GGUF と ComfyUI-HyperFlow-Flash ノードが必要です。作者によるとピーク VRAM は約 21 GiB です
使い方
- Civitai_HyperFlow_H3Flash.zip を解凍してワークフローを読み込みます。モデルファイル(約 28 GB)はパッケージに含まれていないため、別途用意する必要があります。ステップ数は 4 / 6 / 8 です
リスクと制限
- これは著者 $39 の完全パッケージの無料サンプルです。モデルカードの大半は購入リンクと割引コードで占められており、モデルファイルのダウンロード先は記載されていません
- 24 GB の GPU が必要です。確認できるサンプルは 1 枚の画像のみで、動画はありません
- 著者からの注意喚起:H3 コミュニティライセンスの下では、米国、EU、英国、韓国でのセルフホスト利用には事前の申請が必要です
【B】MMH3 I2V/T2V ワークフロー(潜在空間アップスケールとコンテキスト継続付き) · v1.0
ワークフロー · 新モデル · 著者 bvga · 公開 11-13 23:42 · ダウンロード 47
画像生成/テキスト生成動画の2段階ワークフロー:まず低解像度で出力して選別し、次に潜在空間でアップスケールして第2のサンプラーに渡してディテールを補完します。この2段階のサンプリングにおいて、コンテキストの継続生成を組み込んでいます。
参考画像
推奨理由
- 迅速な試行錯誤と動画の継続生成に対応する新ツール:低解像度のクリップから気に入ったものを選び、第2のサンプラーで著者曰く、ディテールと動きのクリーンアップおよび補完が可能
- 著者は、2つのサンプリング間で2つのコンテキストを渡す継続生成手法を構築しました。これはノードが本来サポートしていない機能です
使い方
- ワークフロー内のコメントに従って、あるノードのコード数行を修正する必要があります(潜在空間上のピンを上書きすることを許可)。モデル、ステップ数、強度については著者から提供されていません
リスクと制限
- ノードのソースコードを手動で修正する必要があり、ノードの更新後に機能しなくなる可能性があります
- 唯一のサンプルは非公開で、確認できるサンプルがありません。モデルカードには簡潔な紹介文しかありません
- カードの参考画像はAI生成の概念図であり、モデルの実際の出力結果ではありません。著者は一般公開向けのサンプルを公開していません
収録のみ(6)
- Lora-Daddy H3 Studio - Now Free <3 · V4 — ワークフロー:Lora-Daddy の H3 Studio ノードパッケージとワークフロー V4(v4.0 Hydrogen)。このバージョンから無料になりました。
- FastH3 Omni Lip-Sync — Portrait + Voice Line to Talking Video (ComfyUI) · v1.0 — ワークフロー:1枚のポートレート画像と1本の音声ラインから、5 秒間のリップシンク対応の会話動画アバターを生成する無料ワークフローサンプル。
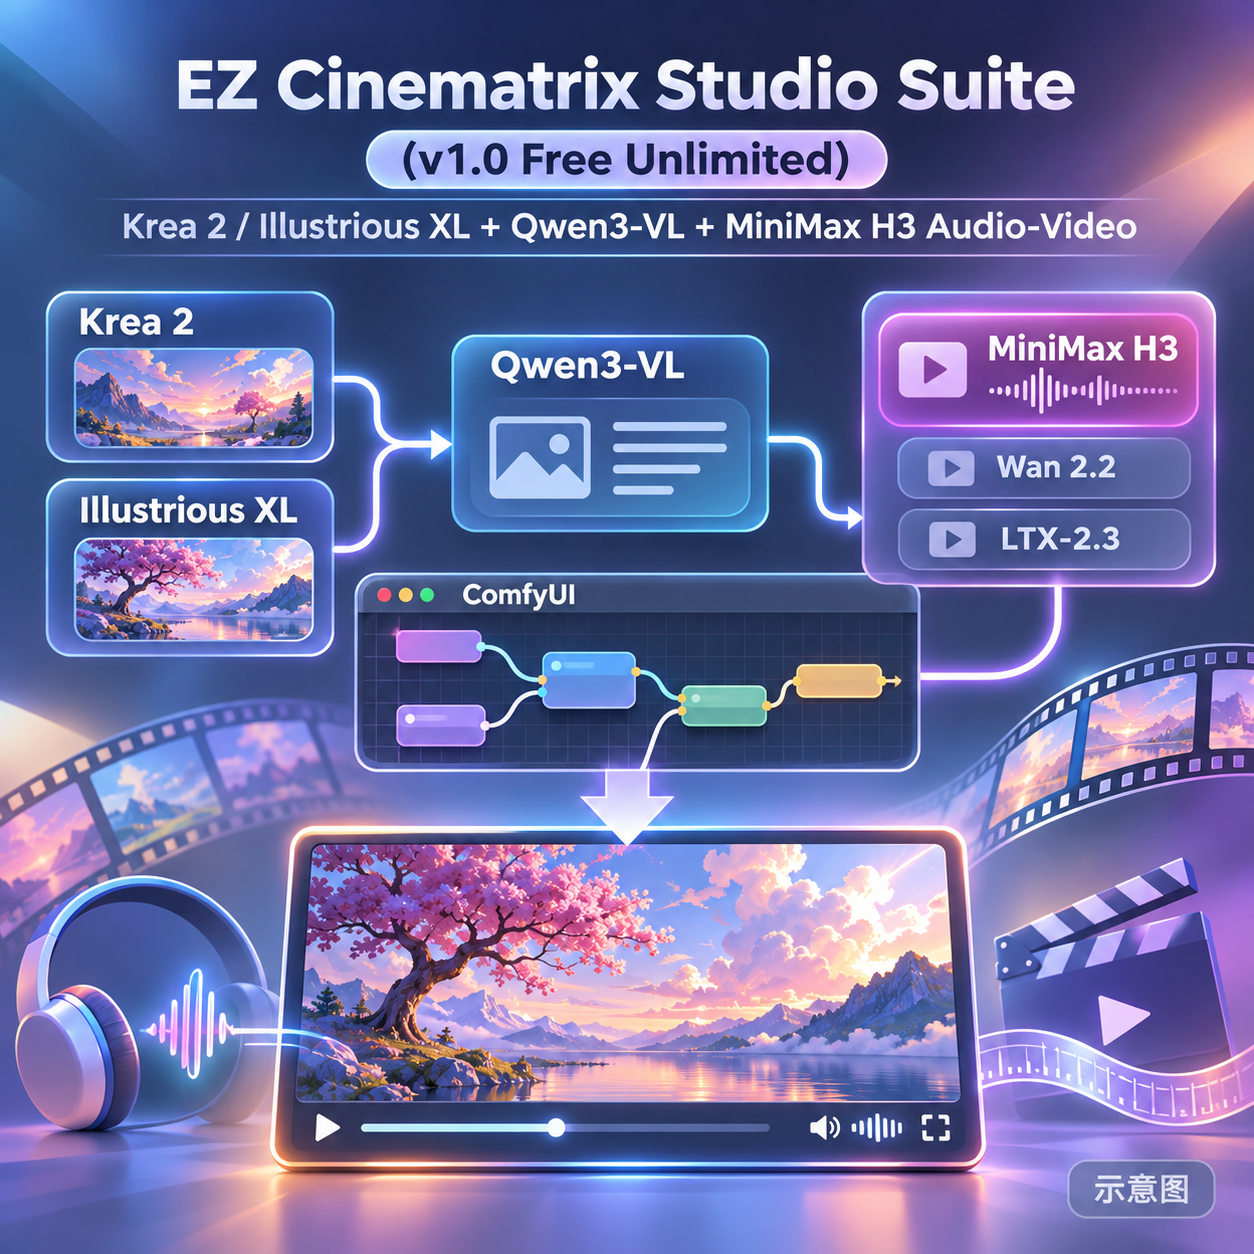
- EZ Cinematrix Studio Suite (v1.0 Free Unlimited) — Krea 2 / Illustrious XL + Qwen3-VL + MiniMax H3 Audio-Video · v1.0 — ワークフロー:複数の基盤モデルに対応した ComfyUI ノードスイート:Krea 2 / Illustrious XL でキーフレームを生成し、Qwen3-VL でプロンプトを作成、その後 MiniMax H3(または Wan 2.2、LTX-2.3)に渡して音声付き動画を生成します。ミュージックビデオの制作も可能です。
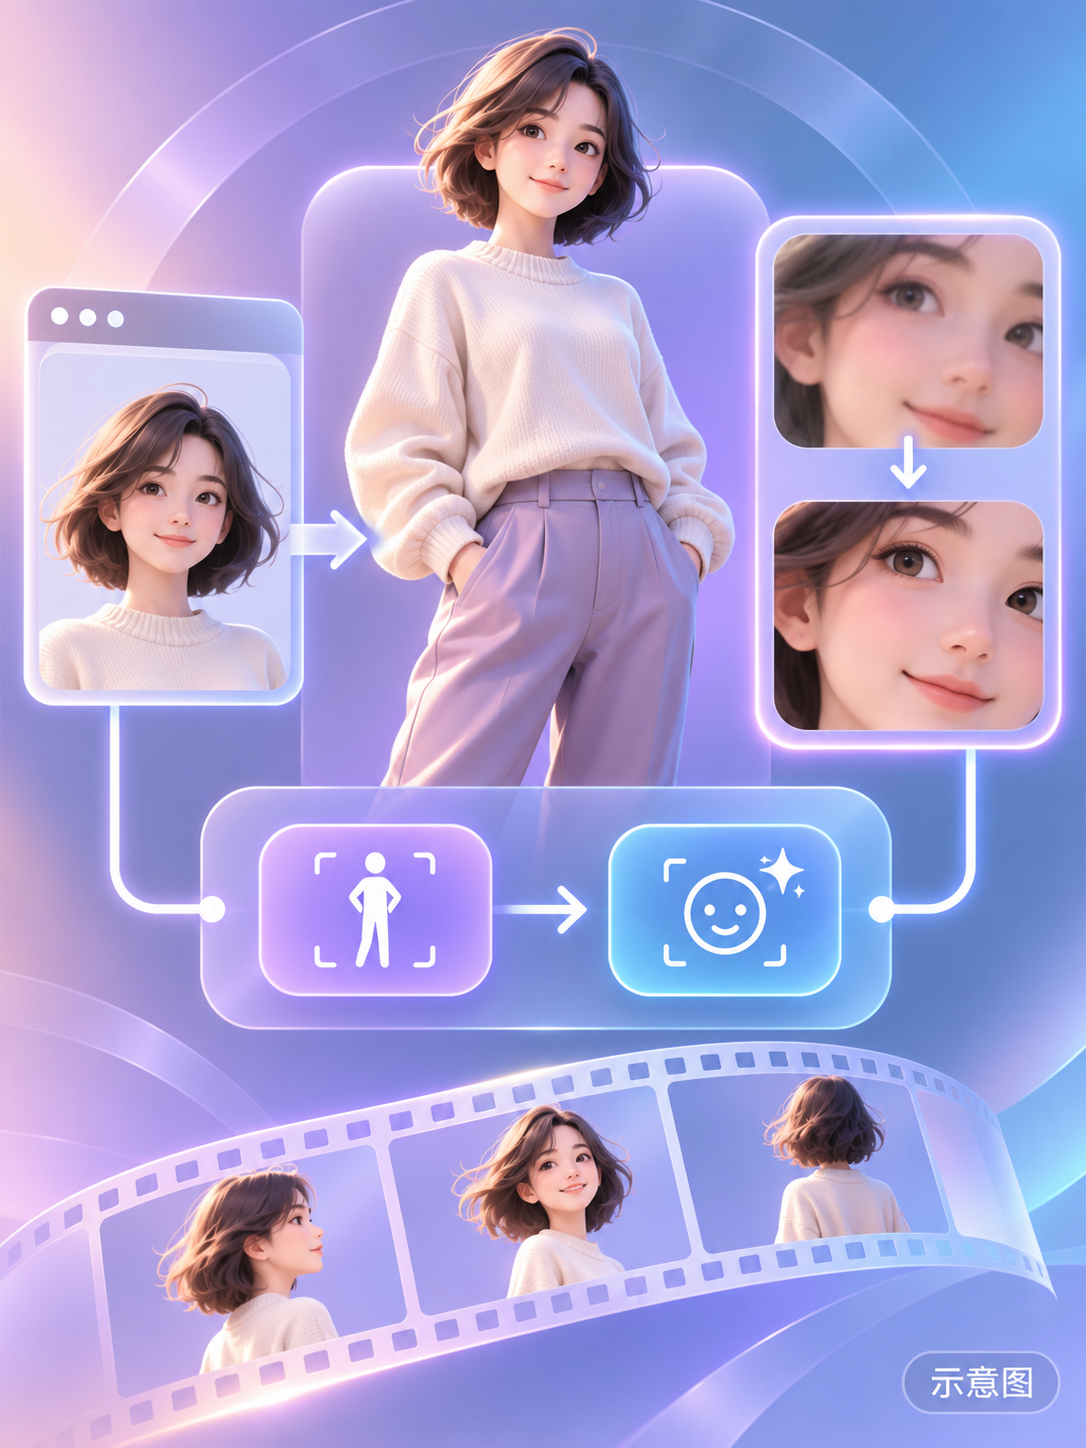
- MiniMax H3 Self Lift Avatar + Face Refinement Workflow · v1.0 — ワークフロー:MiniMax H3 Self Lift Avatar と顔の精修処理を連携させたワークフロー。
- Sister Hazel · v1.0 H3 — LoRA:オリジナルのシスター・ヘーゼル(花栗鼠の修道女キャラクター)のキャラクター LoRA。Krea 2 などのバージョンから H3 へ移植されました。
- Doctor Penny · v2.0 H3 — LoRA:オリジナルのペスト医師装扮キャラクター「Doctor Penny」のキャラクター LoRA。Krea 2 などのバージョンから H3 へ移植されました。
データ:Civitai 公開 API(基盤モデル MiniMax H3)、収録期間 11-13 20:31 → 11-14 09:18(北京時間)。推奨理由は編集者によるレビュー済み。ダウンロード数は注目度を表すに過ぎません。