Radar AI của Trinh Trinh · MiniMax H3 · Bản tin buổi sáng 2026-11-14
Kỳ này có 16 phiên bản mới: Đề xuất mạnh mẽ 2 · Đề xuất 5 · Đáng theo dõi 3 · Chỉ ghi nhận 6
Lời bình của biên tập viên Kỳ này đã xem xét 16 phiên bản mới của H3, gồm 2 hạng S, 5 hạng A, 3 hạng B và 6 hạng C. Đề xuất hàng đầu là Pika Remix của AusBoss: tối đa bốn hình ảnh và một đoạn video, mỗi thứ đều có mục đích riêng, chỉ cần dùng @1 để viết prompt là có thể tạo video từ hình ảnh tham chiếu, thay đổi nhân vật, chỉnh sửa vật thể, sao chép chuyển động hoặc quay tiếp. Mức VRAM Thấp bắt đầu từ 8 GB. Một hạng S khác là Ultimate 12GB, cho phép chuyển đổi giữa 8 chế độ H3 bằng một trình đơn thả xuống và chỉ sử dụng các node lõi; Viggle thay đổi nhân vật, Relight chiếu sáng lại, Person Swap v1.1, Unified Nova.4 được xếp hạng A, còn Singularity face swap bị hạ từ S xuống A do yêu cầu tải xuống 53.2 GB, hai gói node tùy chỉnh và các vấn đề về sự đồng thuận hình ảnh. Easy MH3 v2.0 bị hạ xuống B, FastH3 lip-sync (mẫu miễn phí của gói trả phí), Lora-Daddy V4 và Self Lift (quá ít mô tả), EZ Cinematrix (tất cả ví dụ đều bị ẩn) bị hạ xuống C, hai bản port nhân vật MikoGoblin vẫn giữ hạng C.
Đề xuất mạnh mẽ (2)
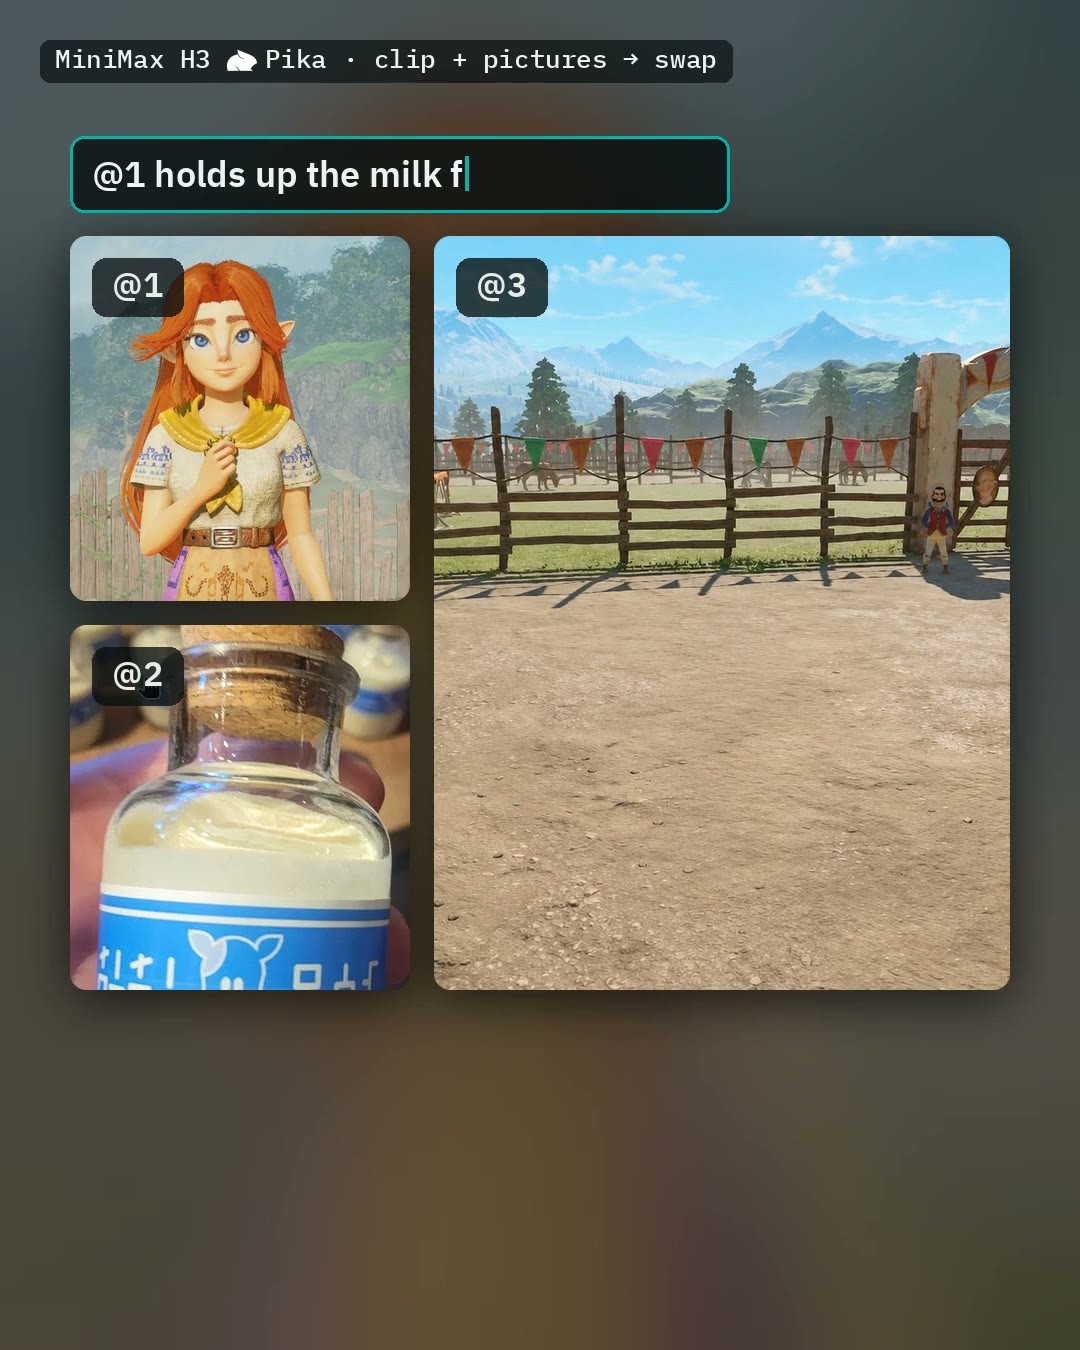
【S】MiniMax H3 Pika Remix | VRAM Cao + Thấp, 8 GB+ · v1.0
Workflow · Mô hình mới · Tác giả AusBoss · Phát hành 11-14 05:53 · Tải xuống 67
Workflow đa năng kết hợp H3 + Pika: tối đa bốn hình ảnh và một đoạn video, mỗi tài liệu tự chọn mục đích sử dụng, có thể tạo video từ hình ảnh tham chiếu, thay đổi nhân vật trong video, chỉnh sửa một vật thể trong video, sao chép chuyển động hoặc quay tiếp từ điểm dừng.
Hình ảnh minh họa
Lý do đề xuất
- Công cụ mới, một workflow bao phủ cả việc tạo video từ hình ảnh tham chiếu và chỉnh sửa video: chọn nhân vật / bối cảnh / trang phục / vật thể cho mỗi hình ảnh, dùng @1 và @2 để chỉ định trong prompt; video có thể chọn “thay đổi nhân vật”, “chỉnh sửa một vật thể”, “sao chép chuyển động”, “quay tiếp”, cũng có thể thêm âm thanh gốc, giọng nói hoặc bài hát
- Tối ưu hóa VRAM: VRAM Cao dành cho trên 24 GB, VRAM Thấp bao phủ từ 8 đến 24 GB (sử dụng mô hình chính và VAE nhỏ hơn); trong các công tắc còn có Fast preview, Auto prompt, và FlashVSR để phóng to video thành phẩm gấp đôi và làm sắc nét
- Ví dụ đầy đủ: 5 đoạn video và 1 hình ảnh đều hiển thị, kèm theo video hướng dẫn trên YouTube của tác giả; nếu chỉ cần thay đổi nhân vật, có thể sử dụng Person Swap nhỏ hơn của cùng tác giả
Cách sử dụng
- Tải hình ảnh vào Picture 1 và chọn mục đích trong H3 Prompt Writer → viết một dòng cho mỗi hành động (ví dụ: @1 walks to the window and looks out) → chọn thời lượng trong Seconds → chọn High / Low VRAM → Run
- Giữ cường độ Pika LoRA ở mức 1, không chồng thêm LoRA Turbo hoặc Lightning (Pika vốn đã là tăng tốc); yêu cầu ComfyUI 0.38.0 trở lên (card 8 GB cần 0.45 trở lên, Auto prompt cần 0.42.0 trở lên) và AusBoss nodes 2.25.2 trở lên
Rủi ro và hạn chế
- Các mô hình bắt buộc khoảng 44.5 GB (mô hình chính ref2va int8 21.0 GB, bộ mã hóa văn bản Qwen3-VL 32B 15.7 GB, v.v.), Auto prompt và FlashVSR yêu cầu tải xuống riêng
- Tác giả cho biết card 8 GB cần chọn Low VRAM, độ dài video không quá 10 giây, bộ nhớ hệ thống khoảng 32 GB; khi thay đổi nhân vật, bối cảnh và vật thể cùng lúc, nhân vật gốc sẽ xuất hiện trở lại giữa chừng, khuyến nghị chỉ thay đổi một thứ mỗi lần
- Thay đổi nhân vật và sao chép chuyển động liên quan đến hình ảnh của người khác: chỉ sử dụng cho những người đã đồng ý, chú ý quyền hình ảnh
- Mô hình cơ bản chịu ràng buộc bởi giấy phép cộng đồng MiniMax H3
【S】MiniMax H3 Ultimate 12GB — T2V/I2V/FFLF/R2V/Multiframe/ControlNet/Extend, một trình đơn thả xuống, có âm thanh · v2.3.0
Workflow · Mô hình mới · Tác giả The_frizzy1 · Phát hành 11-13 23:51 · Tải xuống 55
Một workflow chuyển đổi giữa 8 chế độ H3 cục bộ bằng một trình đơn thả xuống: tạo video từ văn bản, khung hình đầu, khung hình cuối, khung hình đầu và cuối, hình ảnh tham chiếu, hướng dẫn đa khung, điều khiển tư thế ControlNet và mở rộng video, tất cả đều có âm thanh.
Hình ảnh minh họa
Lý do đề xuất
- Công cụ mới, bao phủ các tác vụ chính của H3: tạo video từ văn bản, tạo video từ hình ảnh, khung hình đầu và cuối, hình ảnh tham chiếu (viết <Picture 1> trong prompt), hướng dẫn đa khung, điều khiển tư thế, mở rộng; chỉ sử dụng các node lõi của ComfyUI, không cài đặt node tùy chỉnh
- v2.3.0 thêm tính năng “giữ âm thanh gốc khi mở rộng”: âm thanh của 0.9 giây cuối cùng và 22 khung hình cuối cùng của video gốc được đưa vào cùng nhau, âm thanh tại điểm nối không bị giật
- Tác giả cung cấp mức đỉnh VRAM 11.3–11.6 GB và mức đỉnh bộ nhớ hệ thống 17–22 GB trên RTX 3060 12 GB; 9 đoạn video và 2 hình ảnh ví dụ đều hiển thị
Cách sử dụng
- Yêu cầu ComfyUI 0.39.2 (v2.3.0); chọn chế độ trong trình đơn thả xuống Mode của node, chỉ bỏ qua bypass cho các đầu vào được sử dụng trong chế độ đó (chọn rồi nhấn Ctrl+B), giữ nguyên bypass cho các đầu vào còn lại
- Turbo LoRA được bật theo mặc định: FL2VA 8 bước, Ref2VA 4 bước, tắt Turbo thì dùng 20 bước; nhập thời lượng theo giây, workflow tự động chuyển đổi thành số khung hình hợp lệ
Rủi ro và hạn chế
- Tất cả 10 mô hình khoảng 69 GB; chỉ cần 5 mô hình trong số đó, khoảng 42 GB, nếu chỉ làm tạo video từ văn bản / hình ảnh / khung hình đầu và cuối / mở rộng
- Tác giả cho biết card 12 GB nên giữ độ phân giải ở 0.4 hoặc 0.9 MP, 1.5 MP sẽ tràn VRAM; nếu các đầu vào không sử dụng không được bypass, sẽ báo lỗi Invalid image file trước khi chạy
- Video dài chỉ có thể chạy lại thủ công nhiều lần với Extend; chế độ thay đổi toàn bộ nhân vật không có trong đó (có workflow Viggle riêng)
- 9 ví dụ bị ẩn (nội dung hỗn hợp)
Đề xuất (5)
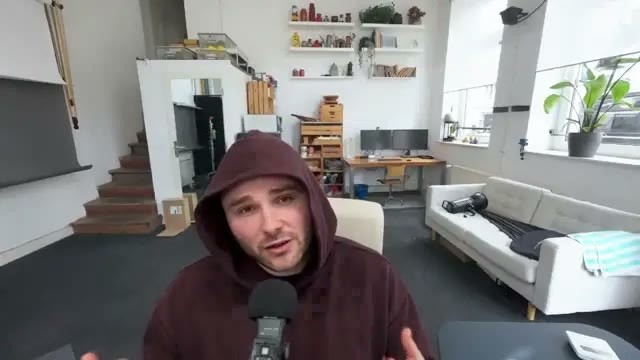
【A】MiniMax H3 Singularity V2 Face Swap 12GB — một bức ảnh vào video của bạn, đồng bộ môi, giữ nguyên âm thanh và phòng · v1.0.0
Workflow · Mô hình mới · Tác giả The_frizzy1 · Phát hành 11-14 00:02 · Tải xuống 71
Dùng một bức ảnh để thay thế một người thật trong video bằng người trong ảnh: giữ nguyên phòng, chuyển động máy quay và âm thanh gốc, tạo toàn bộ đoạn video trong một lần, có thể đồng bộ môi.
Hình ảnh minh họa
Lý do đề xuất
- Công cụ mới, phục vụ thay đổi nhân vật trong video: SAM 3.1 theo dõi người cần thay thế, biến người đó thành hình người màu xám giữ nguyên tư thế, tay và hình dạng miệng, sau đó Singularity V2 (H3 Ref2VA fine-tuned) chỉ vẽ lại vùng mặt nạ dựa trên bức ảnh
- Qwen3-VL 8B xem bốn khung hình và viết một mô tả cảnh quay; tác giả cho biết nếu không có câu này, Singularity sẽ bỏ qua hình người màu xám và vẽ một cái đầu khổng lồ ở giữa khung hình
- Tác giả đã chạy thành công trên RTX 3060 12 GB, bộ nhớ 32 GB, mức đỉnh VRAM 11,598–11,731 MiB; 5 đoạn video hiển thị
Cách sử dụng
- Mở ở chế độ App; nhập video 24 fps, không có gương (dài nhất 15 s), một bức ảnh rõ nét với khuôn mặt lớn và nền đơn giản, đối tượng cần thay thế (ví dụ: person hoặc bald man) và một mô tả ngoại hình mới cho nhân vật; khuyến nghị thử 3 giây cho Seconds
- Yêu cầu hai gói node tùy chỉnh comfyui-h3-oneclick-swap và ComfyUI-Fantastic-MiniMaxH3-PromptBuilder, tác giả sử dụng ComfyUI 0.43.1; cài đặt tích hợp sẵn là cường độ ref2v turbo LoRA 1.0, 6 bước, euler / simple
Rủi ro và hạn chế
- Công cụ thay đổi nhân vật: chỉ sử dụng cho chính mình hoặc những người đã đồng ý, chú ý quyền hình ảnh, không dùng để giả mạo người thật
- Yêu cầu 7 tệp tổng cộng 53.2 GB, là bộ tải xuống lớn nhất của tác giả; mức đỉnh bộ nhớ hệ thống 22–23 GB
- Tác giả cho biết trong các cảnh toàn thân, đầu vẫn có thể quá lớn, nếu ảnh chỉ đến eo thì cần bổ sung quần và giày trong mô tả; chỉ thay đổi một người mỗi lần, không xử lý gương và phản chiếu
- 12 ví dụ bị ẩn (nội dung hỗn hợp); tự động xếp hạng S, nhưng bị hạ xuống A do khối lượng tải xuống lớn, phụ thuộc vào hai gói node tùy chỉnh và vấn đề đồng thuận hình ảnh
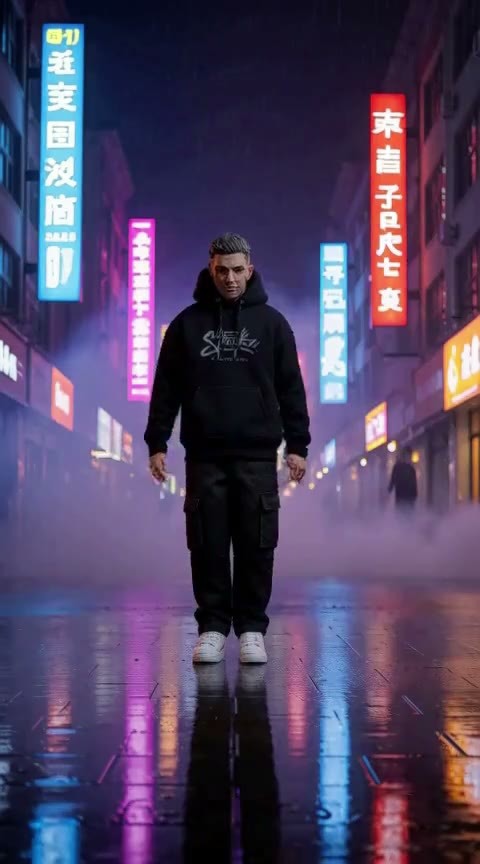
【A】Viggle-Animate (MiniMax H3) 12GB — thay thế nhân vật trong video, 4 bước, giữ nguyên âm thanh của clip điều khiển · v2.0.0
Workflow · Mô hình mới · Tác giả The_frizzy1 · Phát hành 11-14 05:39 · Tải xuống 29
Thay thế nhân vật trong video bằng một khung hình tĩnh của nhân vật: giữ nguyên chuyển động, máy quay, bối cảnh và âm thanh gốc của video điều khiển, tạo video trong 4 bước.
Hình ảnh minh họa
Lý do đề xuất
- Công cụ mới, phục vụ thay đổi nhân vật / chuyển giao chuyển động trong video: dựa trên bản fine-tune 33B của Viggle cho H3 Ref2VA, chỉ có một chế độ — một đoạn video điều khiển và một hình ảnh nhân vật
- Tác giả cung cấp mức đỉnh VRAM 11.2–11.6 GB trên RTX 3060 12 GB, và liệt kê 4 tệp mô hình cần thiết cùng thư mục lưu trữ
Cách sử dụng
- Cài đặt comfyui-viggle-animate-h3 v1.3.2 từ Comfy registry, yêu cầu ComfyUI 0.37.4 trở lên; Video VAE phải dùng phiên bản fp16 minimax_h3_video_vae_fp16, không phải phiên bản int8 thường dùng trong các workflow H3 khác
- Tải The_frizzy1_viggle-animate-h3_v2.0.0.json, đưa video điều khiển và ảnh nhân vật vào rồi chạy Run, cố định 4 bước
Rủi ro và hạn chế
- Tác giả cho biết workflow này chưa có video demo riêng, đoạn video có thể xem được là hướng dẫn sử dụng chung; có 3 hình ảnh hiển thị và 3 ví dụ bị ẩn
- Chỉ kiểm thử trên các đoạn video dài 5 giây, độ phân giải 480x864 / 832x480, VRAM gần như chiếm hết 12 GB, chưa kiểm thử với video dài hơn hoặc độ phân giải lớn hơn; tác giả không ghi rõ v2.0.0 thay đổi gì so với v1
- Mô hình chính nặng 21.0 GB
- Công cụ đổi người: chỉ dùng cho bản thân hoặc người đã đồng ý, chú ý quyền hình ảnh, không dùng để giả mạo người thật
【A】MiniMax H3 Pika Person Swap | VRAM cao + thấp, 8 GB+ · v1.1
Workflow · Cập nhật phiên bản · Tác giả AusBoss · Đăng tải 11-14 05:53 · Tải xuống 93
Đưa người từ một bức ảnh vào video để thay thế nhân vật gốc, giữ nguyên bối cảnh, hành động, góc quay và âm thanh; v1.1 hỗ trợ card đồ họa 8 GB, phần phóng to cuối cùng chuyển sang dùng FlashVSR.
Hình minh họa
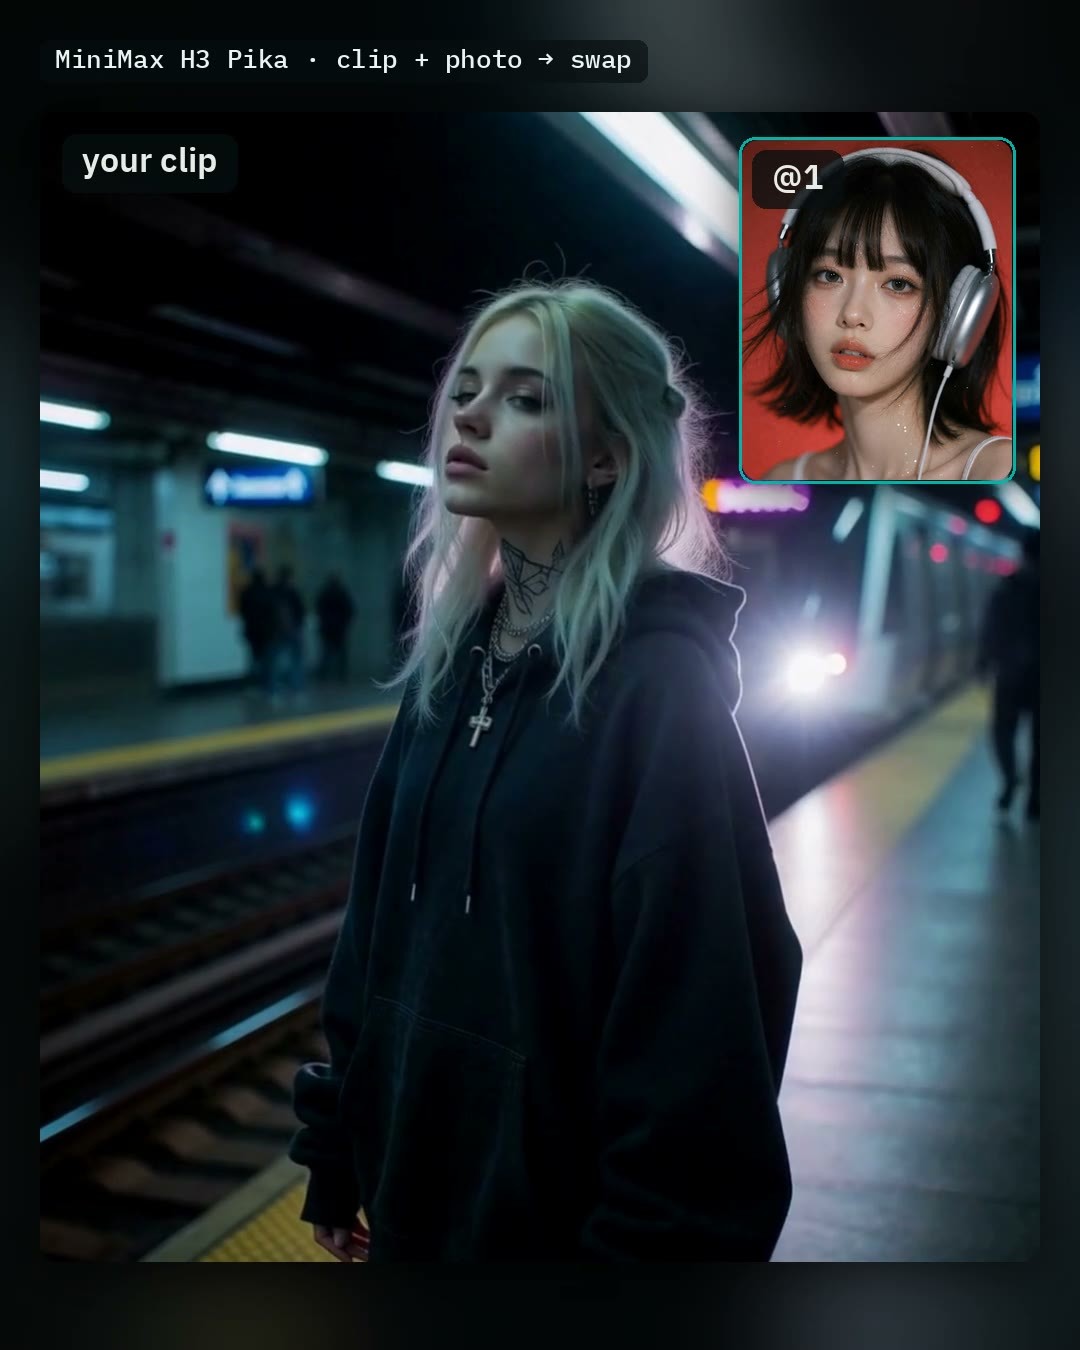
Lý do đề xuất
- Cập nhật phiên bản: Chế độ Low VRAM bao phủ từ 8 đến 24 GB, tác giả cho biết card 8 GB có thể chạy toàn bộ kích thước với đoạn video dài tối đa 8 giây khi RAM hệ thống là 32 GB, không cần tham số khởi động (ComfyUI 0.45)
- Phần phóng to cuối cùng chuyển từ SeedVR2 sang FlashVSR: sắc nét hơn, phóng to gấp đôi, chỉ cần một mô hình 3.5 GB; loại bỏ công tắc Steer the mouths chưa bao giờ hoạt động, khi bật Keep the clip's sound, hình dạng miệng của nhân vật mới vẫn khớp với âm thanh gốc
- Tính năng Describe @1 for me (tự động viết mô tả ngoại hình dựa trên ảnh) tác giả cho biết đã có thể chạy xong trong RAM hệ thống 32 GB; đồng thời sửa lỗi latent do các gói node H3 khác gây ra
Cách sử dụng
- Tải đoạn video vào Video - Your clip và cắt thành một cảnh (dài tối đa 10 giây) → Đưa ảnh nhân vật mới vào Picture 1 → Viết hai dòng prompt: dòng đầu ghi rõ thay ai (Replace the man in the red shirt with @1), dòng sau viết @1 looks like … để mô tả kiểu tóc và khuôn mặt → Chọn High (trên 24 GB) hoặc Low VRAM → Run
- Yêu cầu node AusBoss phiên bản 2.25.2 trở lên, ComfyUI phiên bản 0.38.0 trở lên
Rủi ro và hạn chế
- Công cụ đổi người: chỉ dùng cho bản thân hoặc người đã đồng ý, chú ý quyền hình ảnh, không dùng để giả mạo người thật
- Tác giả cho biết khi khuôn mặt quá nhỏ hoặc quay lưng về phía camera, H3 có thể giữ lại khuôn mặt của video gốc, chỉ thay đổi kiểu tóc và quần áo; nếu không viết dòng mô tả thứ hai, việc thay đổi có thể diễn ra muộn hoặc không xảy ra
- Mô hình chính 21.0 GB, bộ mã hóa văn bản 15.7 GB, v.v. cần tự chuẩn bị; có 1 đoạn video và 1 hình ảnh làm ví dụ hiển thị
【A】MiniMax H3 Relight 12GB — chiếu sáng lại bất kỳ video nào từ một quả cầu ánh sáng, Full HD 1088p, tối đa 60 giây, giữ nguyên âm thanh gốc · v1.0.0
Workflow · Mô hình mới · Tác giả The_frizzy1 · Đăng tải 11-14 05:39 · Tải xuống 25
Chiếu sáng lại video hiện có: nhập video, một ảnh quả cầu ánh sáng và một câu mô tả ánh sáng, đầu ra là hiệu ứng ánh sáng mới cho cùng một cảnh quay, giữ nguyên nhân vật, căn phòng, vị trí máy quay, nhịp độ và âm thanh gốc.
Hình minh họa
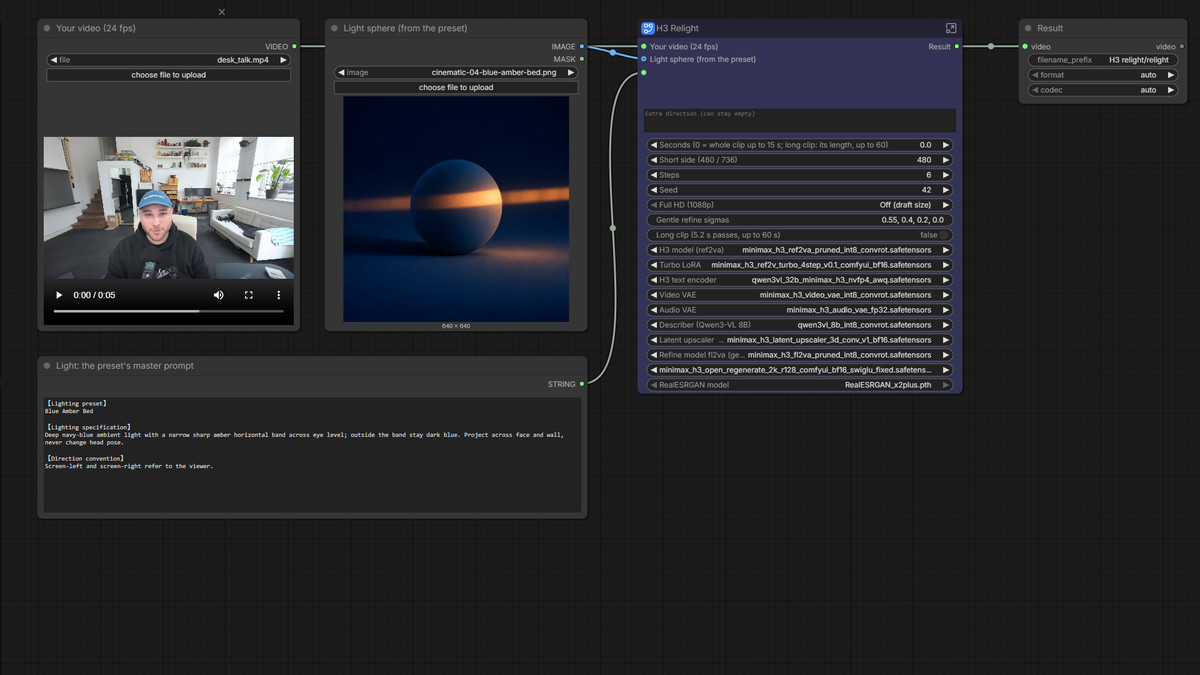
Lý do đề xuất
- Công cụ mới, phục vụ chỉnh ánh sáng hậu kỳ video: tái tạo cục bộ trên card đồ họa 12 GB bản relight mã nguồn mở mà Sirio Berati ban đầu viết cho một card thuê 80 GB, dựa trên H3 Ref2VA int8 cộng với ref2v turbo LoRA
- Chỉ sử dụng các node lõi của ComfyUI; tùy chọn Full HD (H3 vẽ lại nhẹ nhàng hoặc RealESRGAN x2, cạnh ngắn đạt 1088p), Long clip xử lý phân đoạn tối đa 60 giây
- Tác giả cung cấp mức đỉnh VRAM 11,841–11,945 MiB và mức đỉnh RAM hệ thống 21.4–22.6 GB trên RTX 3060 12 GB
Cách sử dụng
- Preset ánh sáng và ảnh quả cầu lấy từ sirioberati/relight-open-source (MIT): đặt ảnh quả cầu vào đầu vào Light sphere, đặt văn bản master tương ứng trong presets.json vào đầu vào Light text
- Yêu cầu ComfyUI phiên bản 0.44 trở lên; video được đọc ở 24 fps, tối đa 15 giây mỗi lần; cạnh ngắn có thể chọn chế độ nhanh hoặc chế độ sắc nét hơn, với turbo LoRA tác giả đặt 6 bước
Rủi ro và hạn chế
- Bắt buộc có 6 tệp tổng cộng 51.5 GB, bật Full HD vẽ lại nhẹ nhàng sẽ thêm 23.7 GB
- Tác giả cho biết Long clip và RealESRGAN trong workflow chưa được render thực tế trên GPU, không có dữ liệu thời gian; xử lý một đoạn video 5.2 giây với cạnh ngắn 736 cộng vẽ lại nhẹ nhàng mất 31:48
- Không có video mẫu, chỉ có 1 hình ảnh
【A】MiniMax H3 Unified (Lip-sync, Scene Prompts and Resumable Video) · Nova.4
Workflow · Cập nhật phiên bản · Tác giả Rvage · Đăng tải 11-14 05:10 · Tải xuống 26
Workflow video dài H3 tích hợp Nova.4: vừa có thể làm khớp khẩu hình cho ảnh nhân vật theo bài hát hoặc lời thoại có sẵn, vừa có thể tạo video có âm thanh từ văn bản / hình ảnh / khung hình đầu-cuối theo cảnh, render phân đoạn, có thể tiếp tục chạy và chạy lại từ một đoạn cụ thể.
Hình minh họa
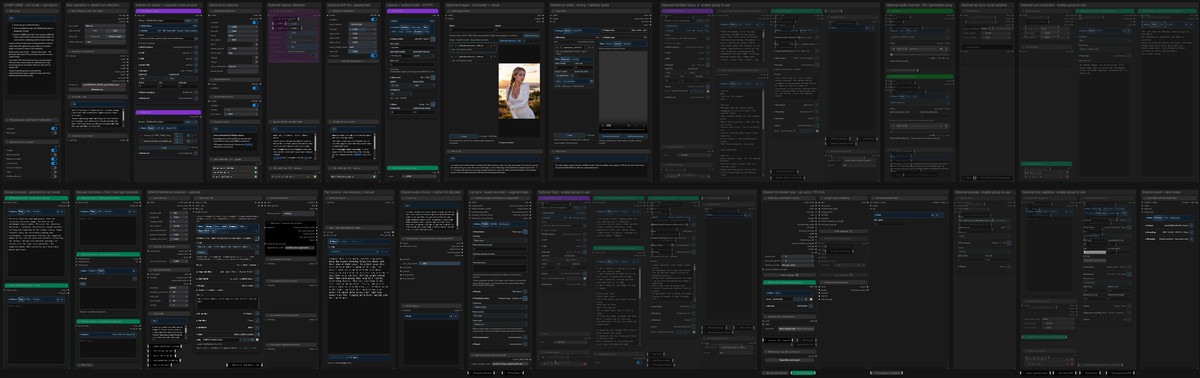
Lý do đề xuất
- Cập nhật phiên bản: đoạn đầu tiên của khớp khẩu hình có thể thiết lập riêng quá trình khởi động ẩn, video thành phẩm giữ nguyên toàn bộ âm thanh và thời gian; nhiều ảnh khớp khẩu hình tương ứng với từng prompt cảnh; một ảnh cũng có thể thiết lập thủ công nhiều điểm cắt; Scene Detector kiểm tra thêm sự thay đổi ngoại hình trong các cảnh chuyển mờ ngắn
- Thêm mới nhóm phóng to video thành phẩm tùy chọn (trước khi thêm phụ đề và lưu); thanh chế độ Smart LM có thể dừng ngay lập tức mô hình ngôn ngữ bị treo và backend Ollama/Docker của nó; cần cập nhật Eclipse Nova lên 1.0.36, SmartLLM Nova lên 1.1.17
- Phục vụ video dài và video âm nhạc: phân tích video tham chiếu có thể cắt cảnh và mô tả hành động, có thể sửa prompt trong Prompt Review trước khi render; có thể kết nối YuE2 hoặc MiniMax Music 3 để tạo nhạc nền, kèm trích lời bài hát và phụ đề động
Cách sử dụng
- Cài đặt ba gói node Eclipse Nova, Smart Model Loader Nova, SmartLLM Nova (bản vá H3 và Diff-Aid lấy từ ComfyUI-sol-attn, tách giọng hát dùng Audio Separation Nodes, có thể tắt tiếng trước nếu không cần)
- Tại START HERE chọn Lip-sync hoặc Native H3, và chọn preset tương ứng trong Smart Model Loader và LoRA Stack; H3 giữ nguyên 24 FPS; ví dụ khớp khẩu hình của tác giả dùng Euler / beta, CFG 1, 8 bước, cường độ turbo LoRA 1
- Chọn lưu trữ là Disk + Keep in output, sau khi bị gián đoạn dùng Resume saved run để tiếp tục, dùng Restart part để chỉ định chạy lại từ đoạn nào
Rủi ro và hạn chế
- Giấy phép cấm sử dụng thương mại, cấm tạo tác phẩm phái sinh
- Phụ thuộc nhiều: ba gói node Nova cộng nhiều gói tùy chọn, khớp khẩu hình cần thêm bộ mã hóa âm thanh wav2vec2; sau khi cập nhật phải khởi động lại ComfyUI và chạy lại phân tích cảnh
- Ví dụ hiển thị chỉ có 1 hình ảnh, 1 cái bị ẩn (nội dung hỗn hợp); tác giả cho biết các cảnh cắt có thay đổi tư thế nhanh và nền tương tự nhau vẫn có thể bị bỏ sót
Có thể quan tâm (3)
【B】Easy MH3 (tạo video + phóng to bằng cách chia khối + 60 FPS) (hỗ trợ VRAM thấp) · v2.0
Workflow · Cập nhật phiên bản · Tác giả Crimson009 · Đăng tải 11-14 00:50 · Tải xuống 39
Workflow hai giai đoạn v2.0 cho H3 gồm tạo video và phóng to theo khối: trước tiên tạo video, sau đó phóng to theo khối và nội suy khung hình bằng RIFE lên 60 FPS, phù hợp với VRAM thấp.
Hình minh họa
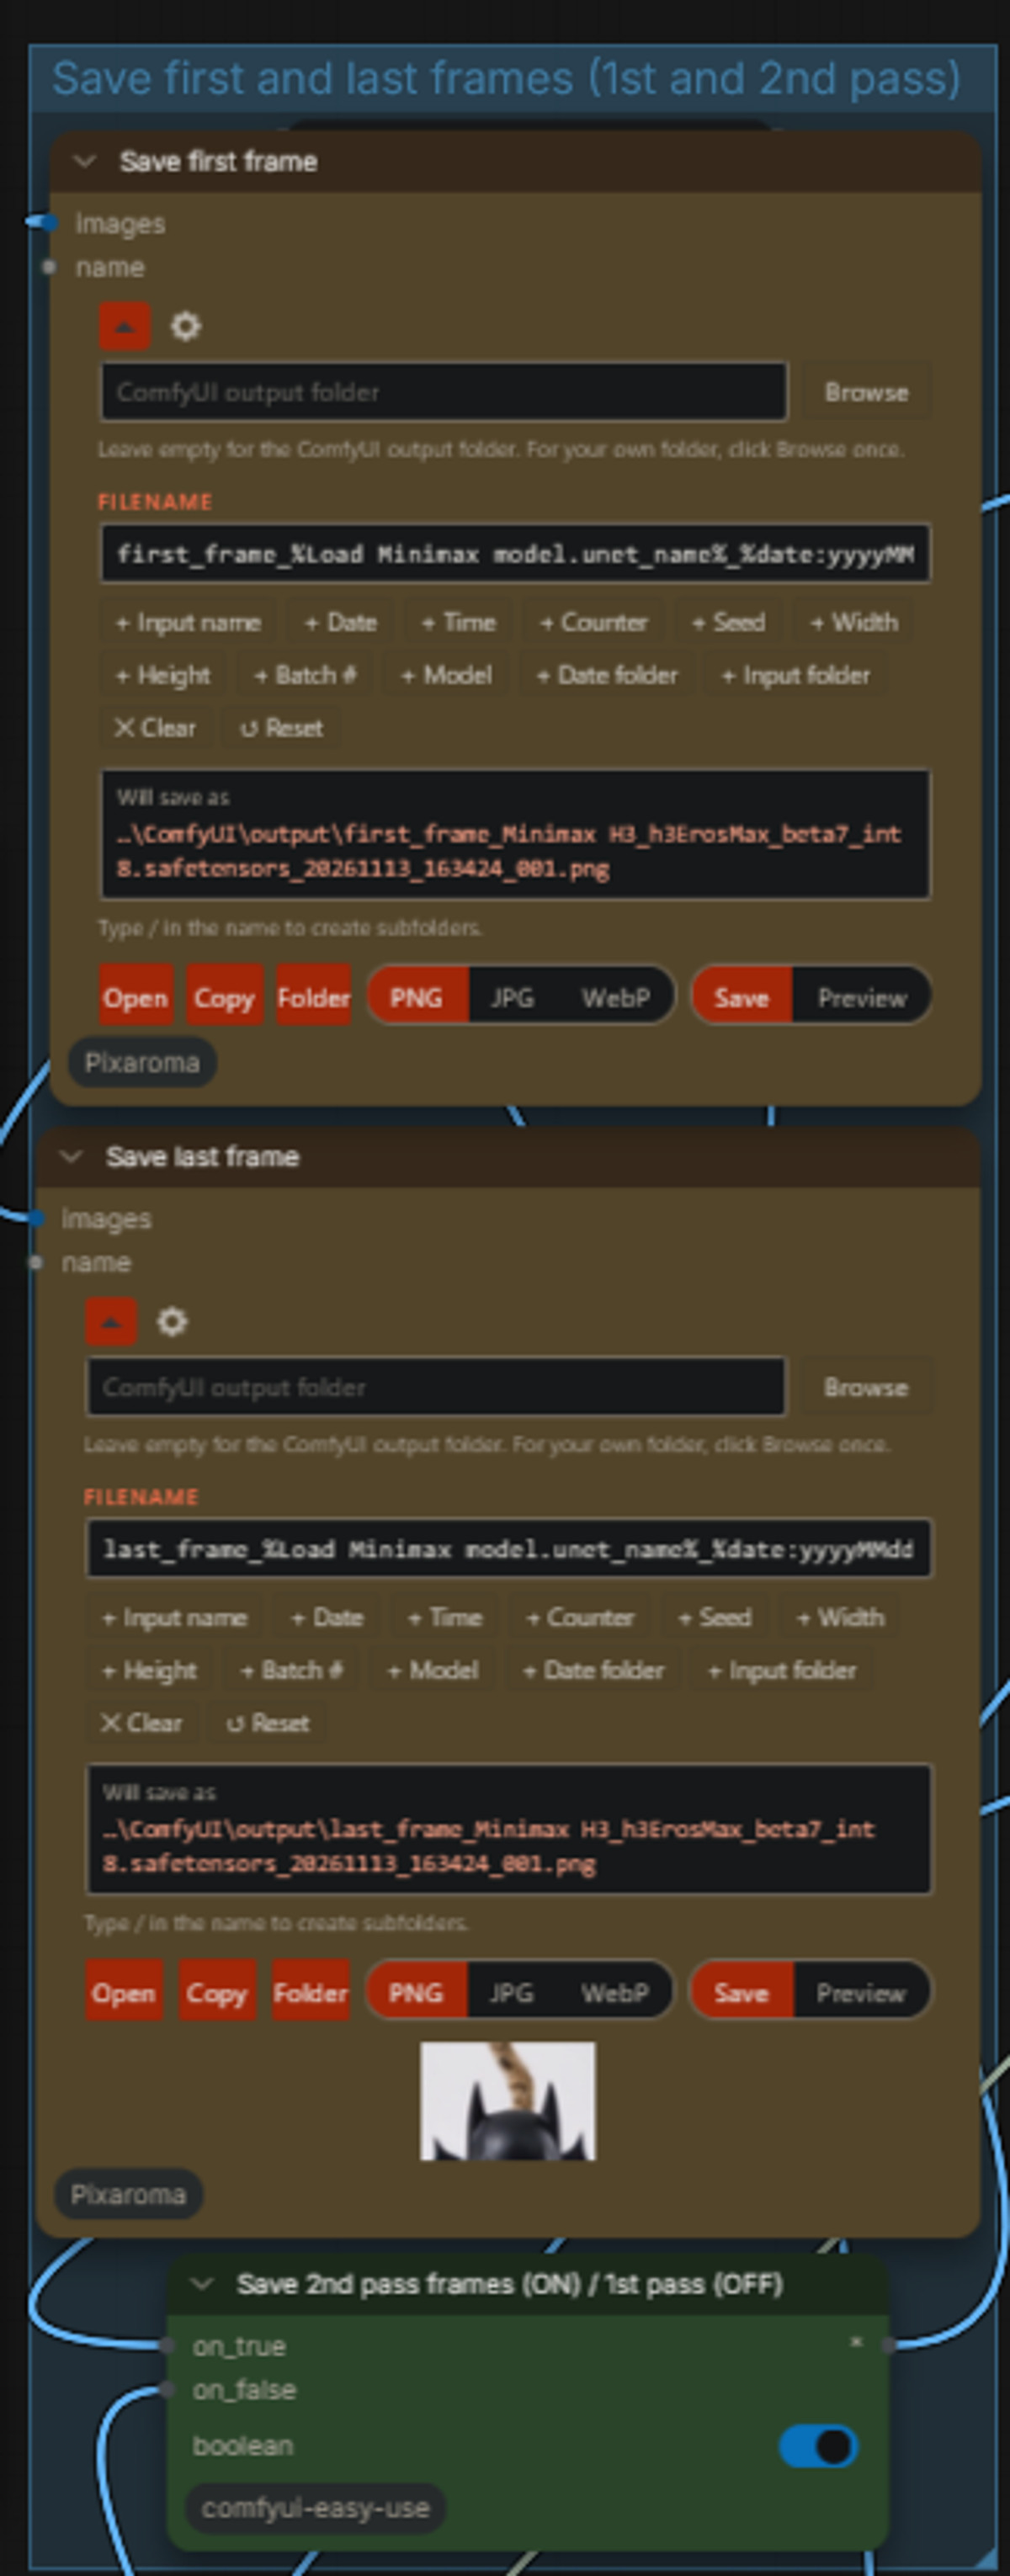
Lý do đề xuất
- Cập nhật phiên bản (ghi trong thẻ mô hình, ghi chú phiên bản trống): dùng công tắc màu tím để chọn quy trình một giai đoạn hoặc hai giai đoạn; thêm tùy chọn chất lượng / tiết kiệm tài nguyên cho giai đoạn một và giai đoạn hai; cả hai giai đoạn đều có thể lưu khung hình đầu và cuối (để nối tiếp giai đoạn sau) và phiên bản bỏ âm thanh
- Mặc định dùng Temporal chunk và RIFE để tiết kiệm VRAM và nội suy video thành phẩm lên 60 FPS; khi VRAM thấp hơn có thể bật Spatial Chunk để chia nhỏ thêm; sau mỗi giai đoạn dùng node Free VRAM để giải phóng VRAM
Cách sử dụng
- Điền prompt và tài nguyên vào nhóm Prompt, Loras and References → Điều chỉnh Video duration và Video settings ở giai đoạn một → Chọn Upscale Resolution Selector ở giai đoạn hai → Run; các node màu đỏ là cấu hình mô hình một lần
- Tác giả không cung cấp thông tin về tệp mô hình cần thiết, VRAM và số bước
Rủi ro và hạn chế
- Ví dụ hiển thị chỉ có 2 hình ảnh, 3 cái bị ẩn, không có video hiển thị; thay đổi của phiên bản này chủ yếu là công tắc và tùy chọn lưu, tự động hạ từ A xuống B
- Ghi chú phiên bản trống, cũng không liệt kê các node tùy chỉnh phụ thuộc
【B】HyperFlow H3 Flash — Video nhanh có âm thanh trong 4–8 bước (ComfyUI) · v1.0
Workflow · Mô hình mới · Tác giả lahcenbensalah19488 · Đăng tải 11-14 01:24 · Tải xuống 36
Preset tạo video từ văn bản miễn phí của HyperFlow H3 Flash: sử dụng phiên bản nén H3 13.7B mà tác giả gọi là, tạo ra một bản nháp dài 5.2 giây có âm thanh nổi trong 4 bước, khi chốt bản cuối cùng thì chuyển sang 6 hoặc 8 bước.
Hình minh họa
Lý do đề xuất
- Công cụ mới, phục vụ thử nghiệm prompt nhanh: preset FastDraft dùng 4 bước trước để xem ý tưởng về góc quay và âm thanh, sau đó chỉnh sang 6 bước (cân bằng) hoặc 8 bước (chất lượng) để tạo bản cuối cùng
- Phụ thuộc được ghi rõ: ComfyUI phiên bản 0.43.0 trở lên cộng với các node ComfyUI-GGUF và ComfyUI-HyperFlow-Flash, tác giả cho biết VRAM đỉnh khoảng 21 GiB
Cách sử dụng
- Giải nén Civitai_HyperFlow_H3Flash.zip và tải workflow; các tệp mô hình (khoảng 28 GB) không có trong gói, cần tự chuẩn bị; số bước 4 / 6 / 8
Rủi ro và hạn chế
- Đây là mẫu miễn phí của gói đầy đủ từ tác giả $39, phần lớn thẻ mô hình là các liên kết mua hàng và mã giảm giá; thẻ mô hình không cung cấp địa chỉ tải xuống tệp mô hình
- Cần card đồ họa 24 GB; chỉ có 1 hình ảnh minh họa có thể xem, không có video
- Tác giả lưu ý: Theo giấy phép cộng đồng H3, việc tự triển khai (self-hosted) tại Mỹ, EU, Anh và Hàn Quốc cần phải đăng ký trước
【B】Quy trình làm việc MMH3 I2V/T2V với Phóng to Tiềm ẩn và Tiếp nối Ngữ cảnh · v1.0
Quy trình làm việc · Mô hình mới · Tác giả bvga · Phát hành 11-13 23:42 · Tải xuống 47
Quy trình làm việc hai giai đoạn từ hình ảnh sang video / từ văn bản sang video: đầu tiên tạo video ở độ phân giải thấp để chọn lọc, sau đó phóng to trong không gian tiềm ẩn (latent) và đưa vào bộ lấy mẫu thứ hai để bổ sung chi tiết, đồng thời tích hợp tính năng tiếp nối ngữ cảnh trong quy trình lấy mẫu hai giai đoạn này.
Hình minh họa
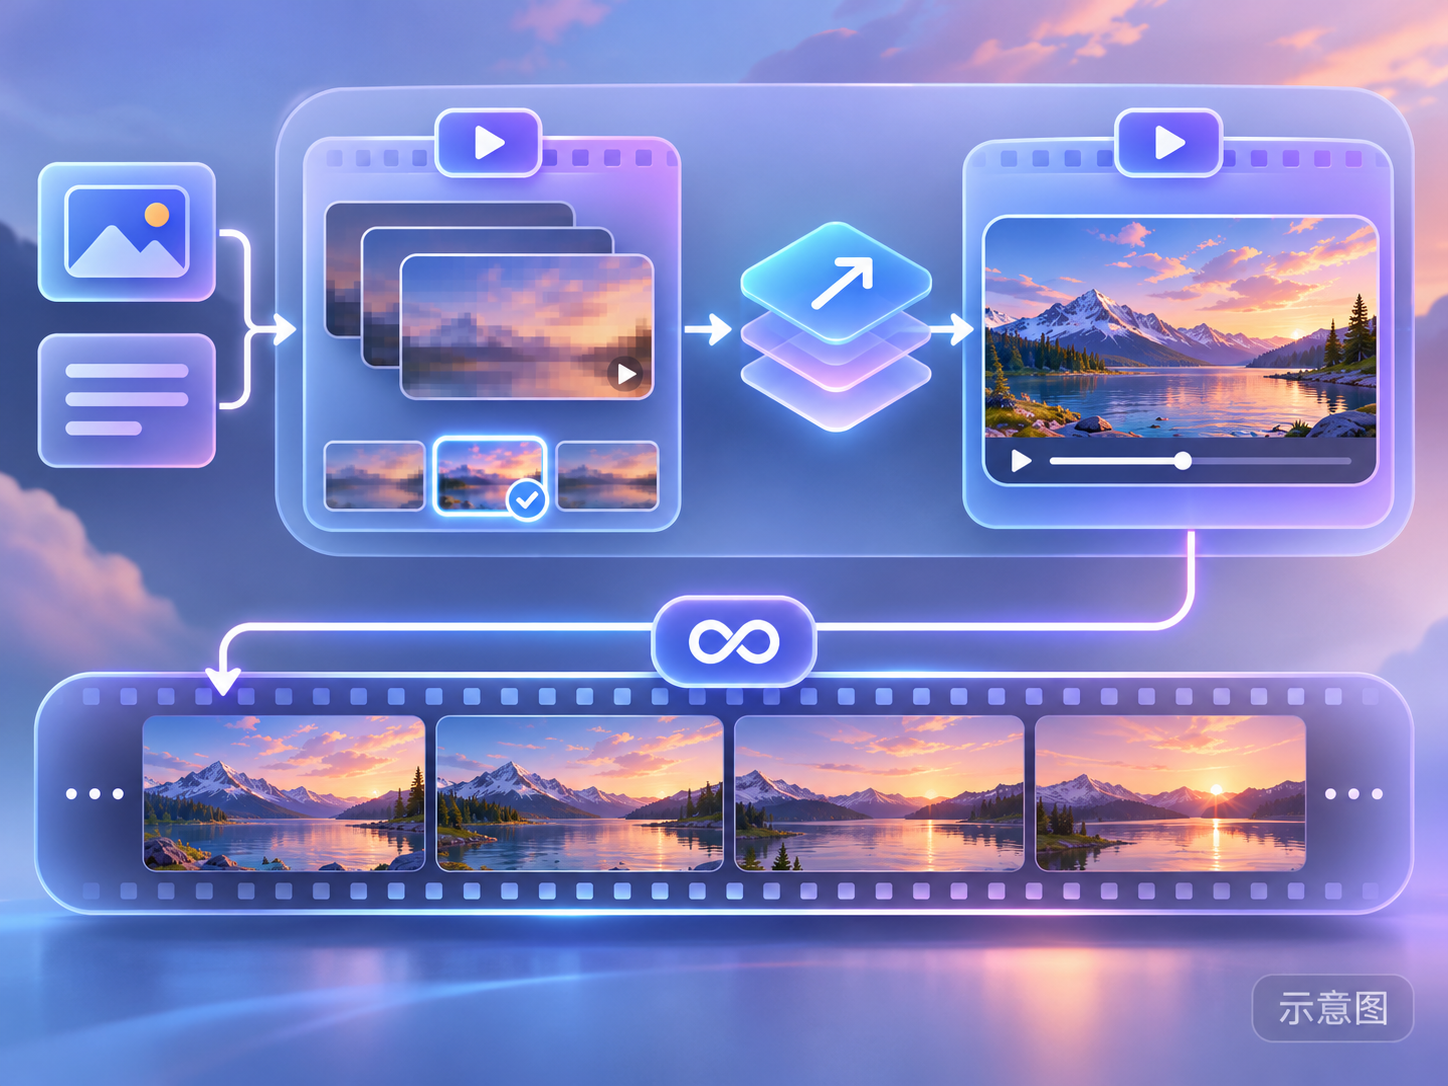
Lý do đề xuất
- Công cụ mới, phục vụ thử nghiệm nhanh và tiếp nối video: chọn các đoạn video độ phân giải thấp trước, tác giả cho biết bộ lấy mẫu thứ hai có thể làm sạch và bổ sung chi tiết cũng như chuyển động
- Tác giả đã xây dựng phương pháp tiếp nối bằng cách truyền hai phần ngữ cảnh giữa hai giai đoạn lấy mẫu, điều mà các nút (node) gốc không hỗ trợ
Cách sử dụng
- Cần sửa đổi vài dòng mã trong một nút theo chú thích trong quy trình làm việc (cho phép ghi đè các pin trên latent); tác giả không cung cấp thông tin về mô hình, số bước và cường độ
Rủi ro và hạn chế
- Cần sửa đổi mã nguồn của nút thủ công, có thể bị lỗi khi nút được cập nhật
- Mẫu duy nhất bị ẩn, không có mẫu nào có thể xem; thẻ mô hình chỉ có phần giới thiệu ngắn gọn
- Hình minh họa trên thẻ là hình ảnh minh họa do AI tạo, không phải hiệu ứng thực tế của mô hình; tác giả không có mẫu cấp độ bình thường (normal-level) công khai
Chỉ liệt kê (6)
- Lora-Daddy H3 Studio - Now Free \ <3 · V4 — Quy trình làm việc: Gói nút H3 Studio của Lora-Daddy cùng quy trình làm việc V4 (v4.0 Hydrogen), miễn phí từ phiên bản này.
- FastH3 Omni Lip-Sync — Portrait + Voice Line to Talking Video (ComfyUI) · v1.0 — Quy trình làm việc: Mẫu quy trình làm việc miễn phí tạo video chân dung nói chuyện với đồng bộ môi trong 5 giây từ một ảnh chân dung và một đoạn âm thanh lời thoại.
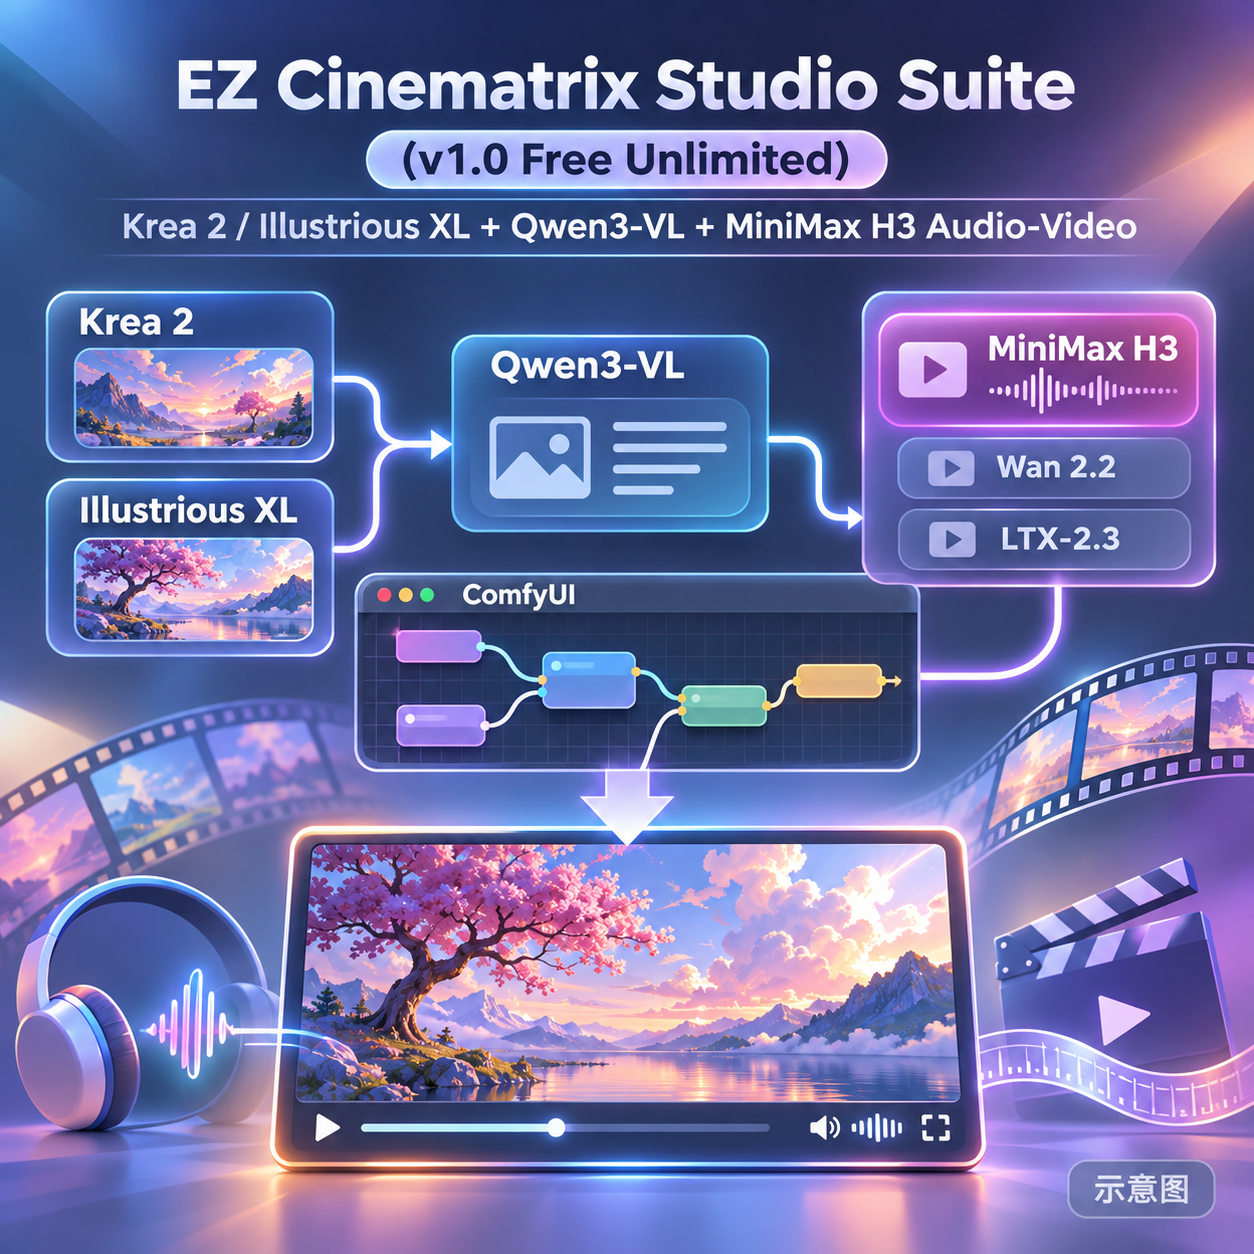
- EZ Cinematrix Studio Suite (v1.0 Free Unlimited) — Krea 2 / Illustrious XL + Qwen3-VL + MiniMax H3 Audio-Video · v1.0 — Quy trình làm việc: Bộ công cụ nút ComfyUI đa mô hình nền: Krea 2 / Illustrious XL tạo khung hình chính, Qwen3-VL viết prompt, sau đó chuyển cho MiniMax H3 (hoặc Wan 2.2, LTX-2.3) để tạo video có âm thanh, có thể làm video ca nhạc.
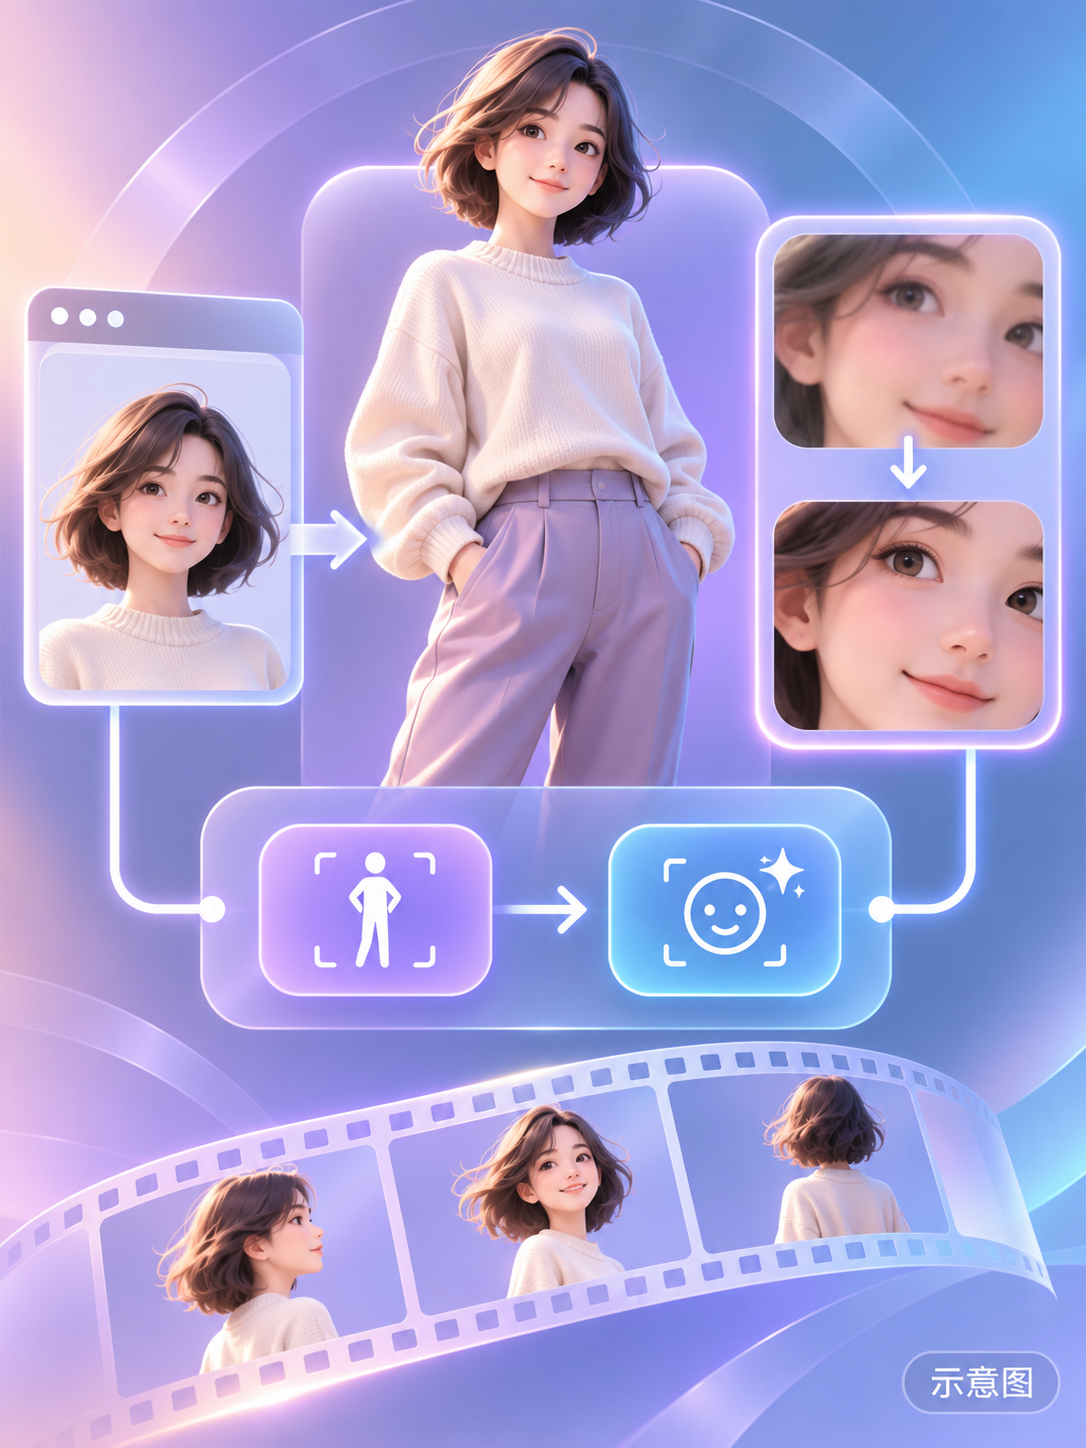
- MiniMax H3 Self Lift Avatar + Face Refinement Workflow · v1.0 — Quy trình làm việc: Quy trình làm việc kết nối MiniMax H3 Self Lift Avatar với tinh chỉnh khuôn mặt.
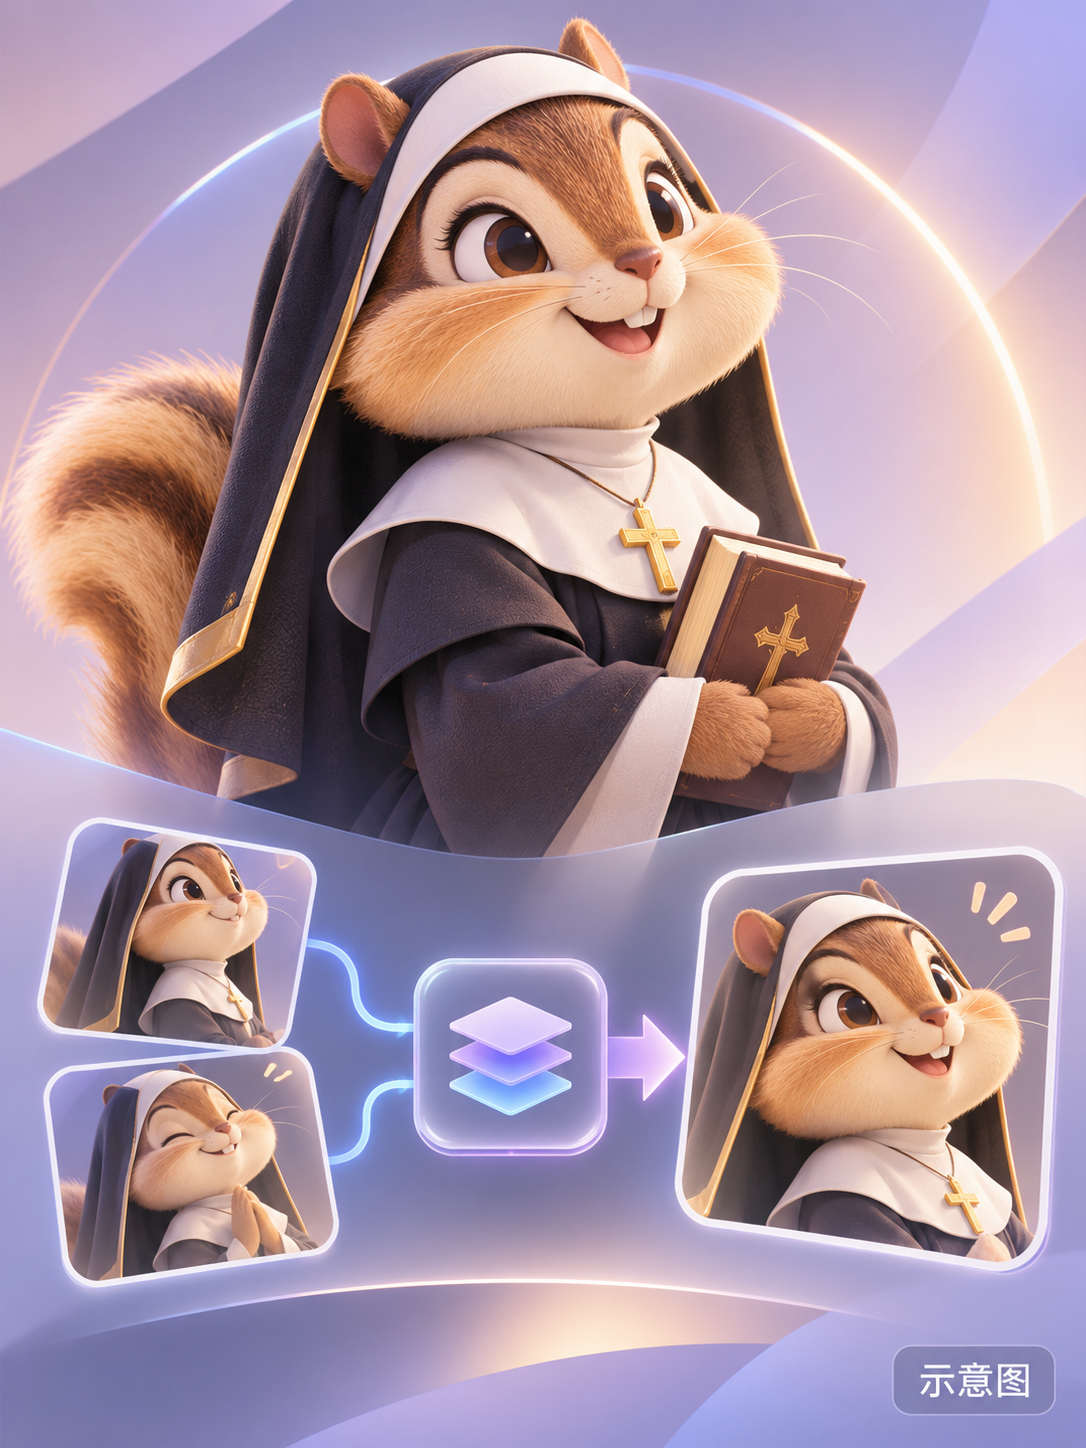
- Sister Hazel · v1.0 H3 — LoRA: LoRA nhân vật Sister Hazel, một nhân vật nữ tu sóc chuột (chipmunk) nguyên bản, được chuyển đổi từ các phiên bản Krea 2 sang H3.
- Doctor Penny · v2.0 H3 — LoRA: LoRA nhân vật Doctor Penny, một nhân vật nguyên bản trong trang phục bác sĩ dịch, được chuyển đổi từ các phiên bản Krea 2 sang H3.
Dữ liệu: API công khai của Civitai (mô hình nền MiniMax H3), cửa sổ thu thập từ 11-13 20:31 → 11-14 09:18 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ phản ánh mức độ quan tâm.