정정(貞貞)의 AI 레이더 · MiniMax H3 · 2026-11-14 모닝 브리프
이번 호 16개 신규 버전: 강력 추천 2 · 추천 5 · 관심 가질 만함 3 · 단순 수록 6
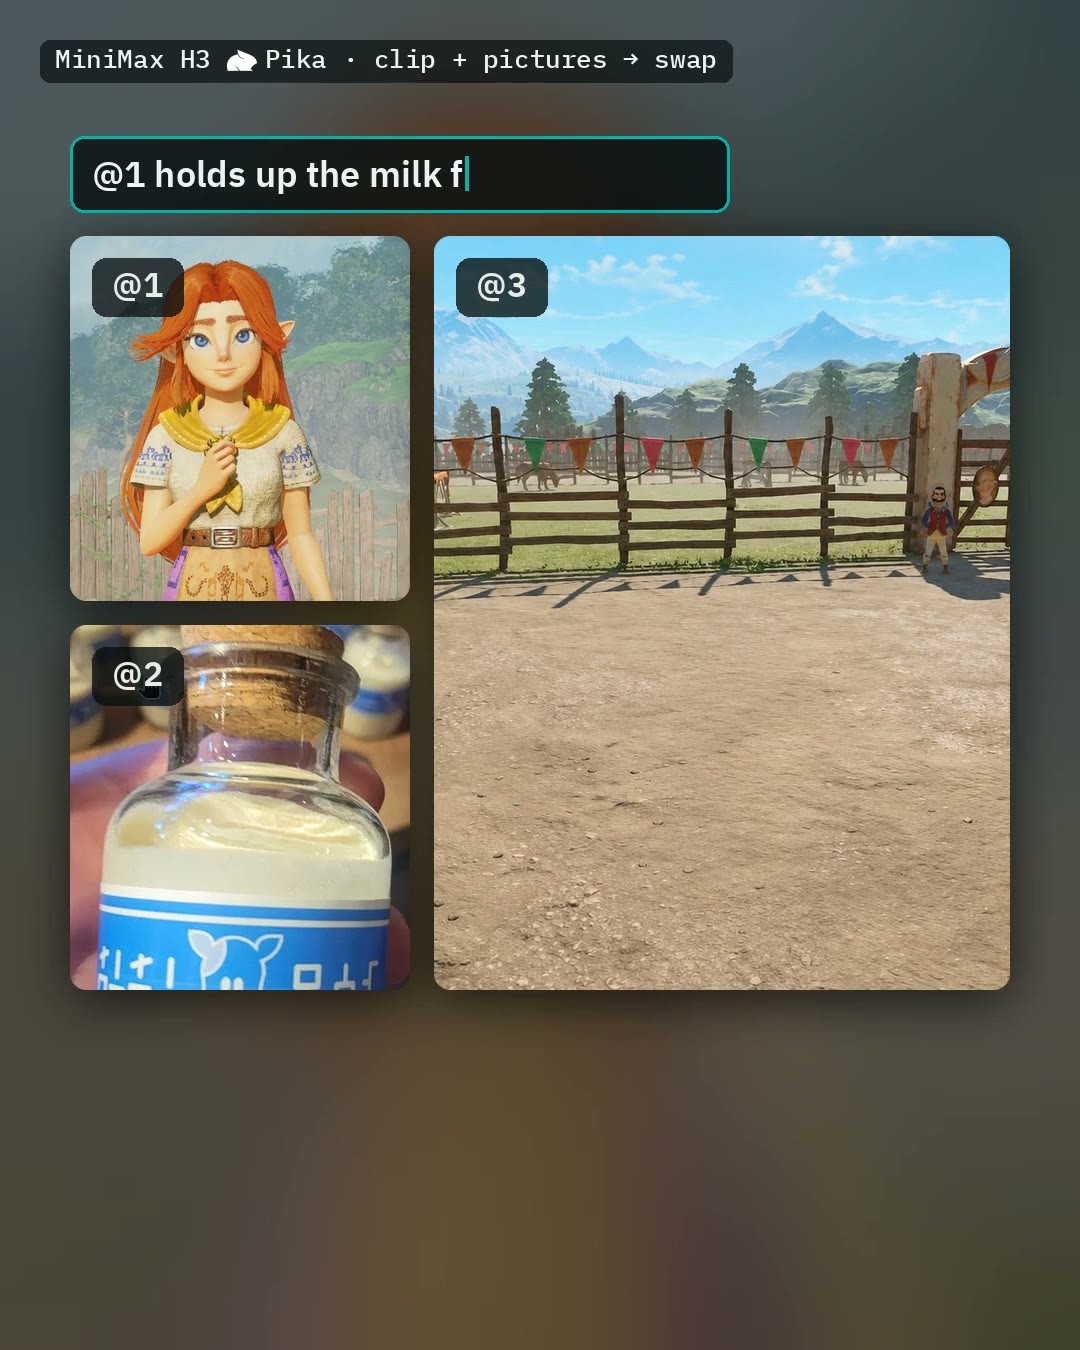
편집자 주 이번 호에서는 H3의 새로운 버전 16개를 검토했으며, S등급 2개, A등급 5개, B등급 3개, C등급 6개로 분류했습니다. 최신 추천은 AusBoss의 Pika Remix입니다: 최대 4장의 이미지와 1개의 영상을 각각의 용도에 맞게 설정하고, @1를 사용하여 프롬프트를 작성하면 참조 이미지 기반 영상 생성, 인물 교체, 물체 변경, 동작 모방 또는 영상 연장 등이 가능합니다. Low VRAM 설정은 8 GB부터 지원됩니다. 또 다른 S등급은 Ultimate 12GB로, 하나의 드롭다운 메뉴로 8가지 H3 모드를 전환하며 핵심 노드만 사용합니다. Viggle 캐릭터 교체, Relight 재조명, Person Swap v1.1, Unified Nova.4는 A등급으로 분류했으며, Singularity 얼굴 교체는 53.2 GB의 다운로드 용량, 두 개의 커스텀 노드 패키지 및 초상권 동의 문제로 인해 S등급에서 A등급으로 하향 조정했습니다. Easy MH3 v2.0는 B등급으로 하향 조정했으며, FastH3 립싱크(유료 패키지의 무료 샘플), Lora-Daddy V4 및 Self Lift(설명 부족), EZ Cinematrix(예시 모두 숨김 처리)는 C등급으로 하향 조정했고, 두 개의 MikoGoblin 캐릭터 포팅은 C등급을 유지했습니다.
강력 추천 (2)
【S】MiniMax H3 Pika Remix | High + Low VRAM, 8 GB+ · v1.0
워크플로우 · 신규 모델 · 저자 AusBoss · 게시일 11-14 05:53 · 다운로드 수 67
H3 + Pika의 다목적 워크플로우: 최대 4장의 이미지와 1개의 영상을 사용하며, 각 소재의 용도를 선택하여 참조 이미지 기반 영상 생성, 영상 내 인물 교체, 영상 내 특정 물체 변경, 동작 모방 또는 영상 연장 등이 가능합니다.
이미지
추천 이유
- 신규 도구로, 하나의 워크플로우에서 참조 이미지 기반 영상 생성과 영상 편집을 모두 지원합니다: 각 이미지에서 인물 / 배경 / 의상 / 물체를 선택하고, 프롬프트에서 @1, @2로 참조합니다; 영상은 '인물 교체', '물체 변경', '동작 모방', '영상 연장'을 선택할 수 있으며, 원본 영상의 소리, 음성 또는 노래를 추가할 수도 있습니다
- VRAM 고려: High VRAM은 24 GB 이상에서 사용하며, Low VRAM은 8에서 24 GB까지 커버합니다(더 작은 메인 모델과 VAE로 교체); 스위치에는 Fast preview, Auto prompt 및 최종 영상을 2배로 확대하고 선명도를 높이는 FlashVSR가 포함되어 있습니다
- 예시 완비: 5개의 영상과 1장의 이미지가 모두 공개되어 있으며, 저자의 YouTube 사용 가이드 영상도 첨부되어 있습니다; 인물 교체만 필요한 경우 동일 저자의 더 가벼운 Person Swap을 사용할 수 있습니다
사용 방법
- Picture 1에서 이미지를 불러오고 H3 Prompt Writer에서 용도를 선택 → 각 항목에 대해 한 줄씩 작성(예: @1 walks to the window and looks out) → Seconds에서 길이 선택 → High / Low VRAM 선택 → Run 실행
- Pika LoRA 강도는 1로 유지하며, Turbo 또는 Lightning LoRA를 추가로 적용하지 마십시오(Pika 자체가 가속화됨); ComfyUI 0.38.0 이상(8 GB 카드는 0.45 이상, Auto prompt는 0.42.0 이상) 및 AusBoss 노드 2.25.2 이상이 필요합니다
리스크 및 제한 사항
- 필수 모델은 약 44.5 GB입니다(ref2va int8 메인 모델 21.0 GB, Qwen3-VL 32B 텍스트 인코더 15.7 GB 등), Auto prompt와 FlashVSR는 별도 다운로드가 필요합니다
- 저자에 따르면 8 GB 카드는 Low VRAM을 선택하고, 영상 길이는 10초 이하로 제한하며, 시스템 메모리는 약 32 GB가 필요합니다; 인물, 배경, 물체를 동시에 교체할 경우 원본 인물이 중간에 다시 나타날 수 있으므로 한 번에 하나씩만 변경하는 것을 권장합니다
- 인물 교체와 동작 모방은 타인의 초상권을 사용합니다: 동의가 있는 인물에게만 사용하며 초상권에 유의하십시오
- 기본 모델은 MiniMax H3 커뮤니티 라이선스의 제약을 받습니다
【S】MiniMax H3 Ultimate 12GB — T2V/I2V/FFLF/R2V/Multiframe/ControlNet/Extend, one dropdown, with audio · v2.3.0
워크플로우 · 신규 모델 · 저자 The_frizzy1 · 게시일 11-13 23:51 · 다운로드 수 55
하나의 드롭다운 메뉴로 8가지 로컬 H3 모드를 전환하는 워크플로우: 텍스트-영상, 첫 프레임, 마지막 프레임, 첫/마지막 프레임, 참조 이미지, 멀티 프레임 가이드, ControlNet 포즈 및 영상 연장 기능을 모두 오디오와 함께 제공합니다.
이미지
추천 이유
- 신규 도구로 H3의 주요 작업을 모두 커버합니다: 텍스트-영상, 이미지-영상, 첫/마지막 프레임, 참조 이미지(프롬프트에 <Picture 1 입력), 멀티 프레임 가이드, 포즈 제어, 영상 연장; ComfyUI 핵심 노드만 사용하며 커스텀 노드는 설치하지 않습니다
- v2.3.0에서 '연장 시 원본 오디오 유지' 기능이 추가되었습니다: 원본 영상의 마지막 0.9초 오디오와 마지막 22프레임을 함께 입력하여 이음새 부분의 오디오가 끊기지 않도록 합니다
- 저자는 RTX 3060 12 GB 환경에서 VRAM 피크 11.3–11.6 GB, 시스템 메모리 피크 17–22 GB를 기록했으며, 9개의 영상과 2장의 이미지 예시가 공개되어 있습니다
사용 방법
- ComfyUI 0.39.2(v2.3.0)이 필요합니다; 노드의 Mode 드롭다운에서 모드를 선택하고, 해당 모드에서 사용하는 입력만 바이패스 해제(선택 후 Ctrl+B)하며 나머지는 바이패스 상태로 유지합니다
- Turbo LoRA는 기본적으로 활성화됩니다: FL2VA 8 스텝, Ref2VA 4 스텝이며, Turbo를 끄면 20 스텝을 사용합니다; 길이는 초 단위로 입력하면 워크플로우가 자동으로 유효한 프레임 수로 변환합니다
리스크 및 제한 사항
- 전체 10개 모델은 약 69 GB입니다; 텍스트-영상 / 이미지-영상 / 첫/마지막 프레임 / 연장만 수행하려면 그중 5개, 약 42 GB가 필요합니다
- 저자에 따르면 12 GB 카드는 해상도를 0.4 또는 0.9 MP로 유지해야 하며, 1.5 MP는 VRAM을 초과합니다; 사용하지 않는 입력을 바이패스하지 않으면 실행 전 Invalid image file 오류가 발생합니다
- 긴 영상은 Extend를 수동으로 반복 실행해야 합니다; 전체 영상 인물 교체 모드는 포함되어 있지 않습니다(별도의 Viggle 워크플로우 존재)
- 9개의 예시가 숨겨져 있습니다(혼합 콘텐츠)
추천 (5)
【A】MiniMax H3 Singularity V2 Face Swap 12GB — one photo into your video, lip-sync, sound and room kept · v1.0.0
워크플로우 · 신규 모델 · 저자 The_frizzy1 · 게시일 11-14 00:02 · 다운로드 수 71
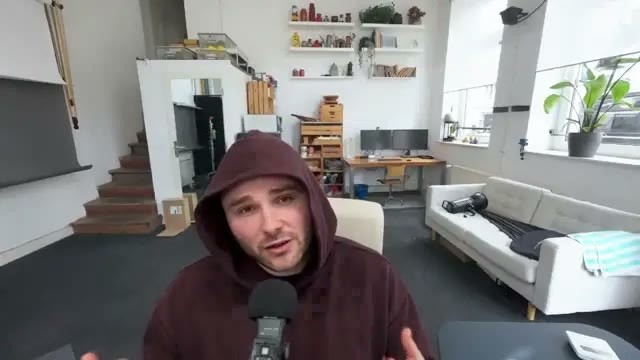
사진 한 장으로 영상 속 실제 인물을 사진 속 인물로 교체합니다: 방, 카메라 움직임 및 원본 소리는 유지되며, 전체 영상을 한 번에 생성하고 립싱크 동기화를 적용할 수 있습니다.
이미지
추천 이유
- 신규 도구로 영상 인물 교체를 지원합니다: SAM 3.1가 교체할 인물을 추적하여 포즈, 손 및 입 모양을 유지한 회색 인체 형상으로 변환한 후, Singularity V2(H3 Ref2VA 미세 조정)가 사진에 따라 마스크 영역만 다시 그립니다
- Qwen3-VL 8B가 4프레임을 보고 한 문장의 카메라 설명을 작성합니다; 저자에 따르면 이 설명이 없으면 Singularity가 회색 인체 형상을 무시하고 화면 중앙에 거대한 머리를 그립니다
- 저자는 RTX 3060 12 GB, 32 GB 메모리 환경에서 실행에 성공했으며, VRAM 피크는 11,598–11,731 MiB입니다; 5개의 영상이 공개되어 있습니다
사용 방법
- App 모드로 열기; 입력: 24 fps, 거울이 없는 영상(최대 15초), 얼굴이 크고 배경이 깔끔한 선명한 사진 한 장, 교체 대상(예: person 또는 bald man) 및 새 인물 외모에 대한 한 문장 설명; Seconds는 먼저 3초로 시도해 보는 것을 권장합니다
- 두 개의 커스텀 노드 패키지 comfyui-h3-oneclick-swap과 ComfyUI-Fantastic-MiniMaxH3-PromptBuilder가 필요하며, 저자는 ComfyUI 0.43.1을 사용했습니다; 내장 설정은 ref2v turbo LoRA 강도 1.0, 6 스텝, euler / simple입니다
리스크 및 제한 사항
- 인물 교체 도구: 본인 또는 동의가 있는 인물에게만 사용하며 초상권에 유의하고, 실제 인물을 사칭하는 데 사용하지 마십시오
- 필수 파일 7개는 총 53.2 GB로, 저자의 가장 큰 다운로드 세트입니다; 시스템 메모리 피크는 22–23 GB입니다
- 저자에 따르면 전신 샷에서도 머리가 여전히 크게 보일 수 있으며, 사진이 허리까지만 있을 경우 설명에 바지와 신발을 추가해야 합니다; 한 번에 한 명만 교체하며, 거울과 반사는 처리하지 않습니다
- 12개의 예시가 숨겨져 있습니다(혼합 콘텐츠); 자동 평가는 S등급이었으나, 대용량 다운로드, 두 개의 커스텀 노드 패키지 의존성 및 초상권 동의 문제로 인해 A등급으로 하향 조정되었습니다
【A】Viggle-Animate (MiniMax H3) 12GB — character replacement in video, 4 steps, the driving clip's audio kept · v2.0.0
워크플로우 · 신규 모델 · 저자 The_frizzy1 · 게시일 11-14 05:39 · 다운로드 수 29
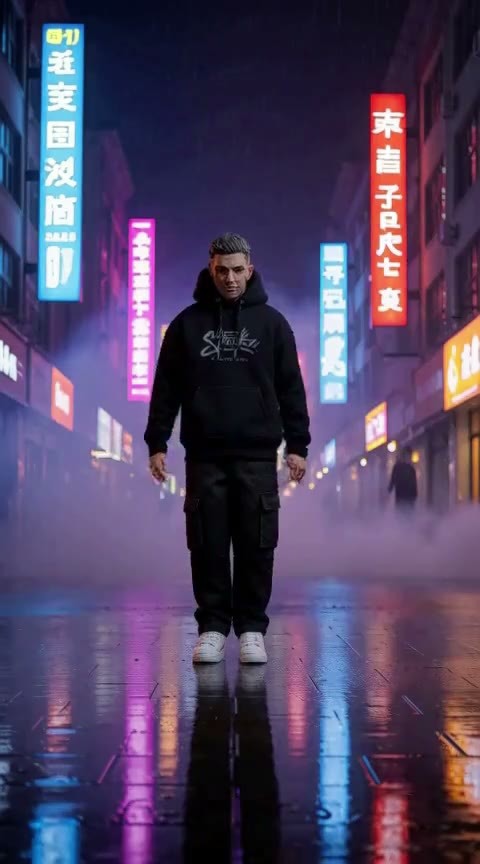
캐릭터 정지 이미지 한 장으로 영상 속 인물을 교체합니다: 동작, 카메라, 배경 및 구동 영상의 원본 소리는 모두 유지되며, 4 스텝으로 결과물을 생성합니다.
이미지
추천 이유
- 신규 도구로 영상 캐릭터 교체 / 동작 이관을 지원합니다: H3 Ref2VA에 대한 Viggle의 33B 미세 조정을 기반으로 하며, 하나의 모드만 존재합니다—구동 영상 하나와 캐릭터 이미지 한 장
- 저자는 RTX 3060 12 GB 환경에서의 VRAM 피크 11.2–11.6 GB를 제공했으며, 필요한 4개 모델 파일과 저장 디렉터리를 나열했습니다
사용 방법
- Comfy registry에서 comfyui-viggle-animate-h3 v1.3.2 설치, ComfyUI 0.37.4 이상; 비디오 VAE는 fp16 버전의 minimax_h3_video_vae_fp16를 사용해야 하며, 다른 H3 워크플로우에서 흔히 사용하는 int8 버전이 아님
- The_frizzy1_viggle-animate-h3_v2.0.0.json을 불러오고, 구동 비디오와 캐릭터 이미지를 넣은 후 Run을 실행하며, 고정 4 스텝
리스크 및 제한 사항
- 저자는 이 워크플로우에 자체 데모 비디오가 아직 없으며, 보이는 비디오는 일반적인 사용 튜토리얼이라고 언급함. 또한 3개의 이미지가 보이고, 3개의 예시가 숨겨져 있음
- 5초, 480x864 / 832x480 클립만 테스트했으며, VRAM이 거의 12 GB를 가득 채움. 더 길고 큰 클립은 테스트되지 않았음. 저자는 v2.0.0이 v1에 비해 무엇을 변경했는지 명시하지 않음
- 메인 모델 21.0 GB
- 얼굴 교체 도구: 본인 또는 동의가 있는 인물에게만 사용하며, 초상권에 유의하고 실제 인물을 사칭하는 데 사용하지 마세요
【A】MiniMax H3 Pika Person Swap | High + Low VRAM, 8 GB+ · v1.1
워크플로우 · 버전 업데이트 · 저자 AusBoss · 게시일 11-14 05:53 · 다운로드 93
사진 속 인물을 비디오에 넣어 원본 인물을 교체하며, 장면, 동작, 카메라 앵글 및 소리는 유지됩니다. v1.1는 8 GB 그래픽 카드를 지원하며, 최종 업스케일링은 FlashVSR을 사용합니다.
이미지
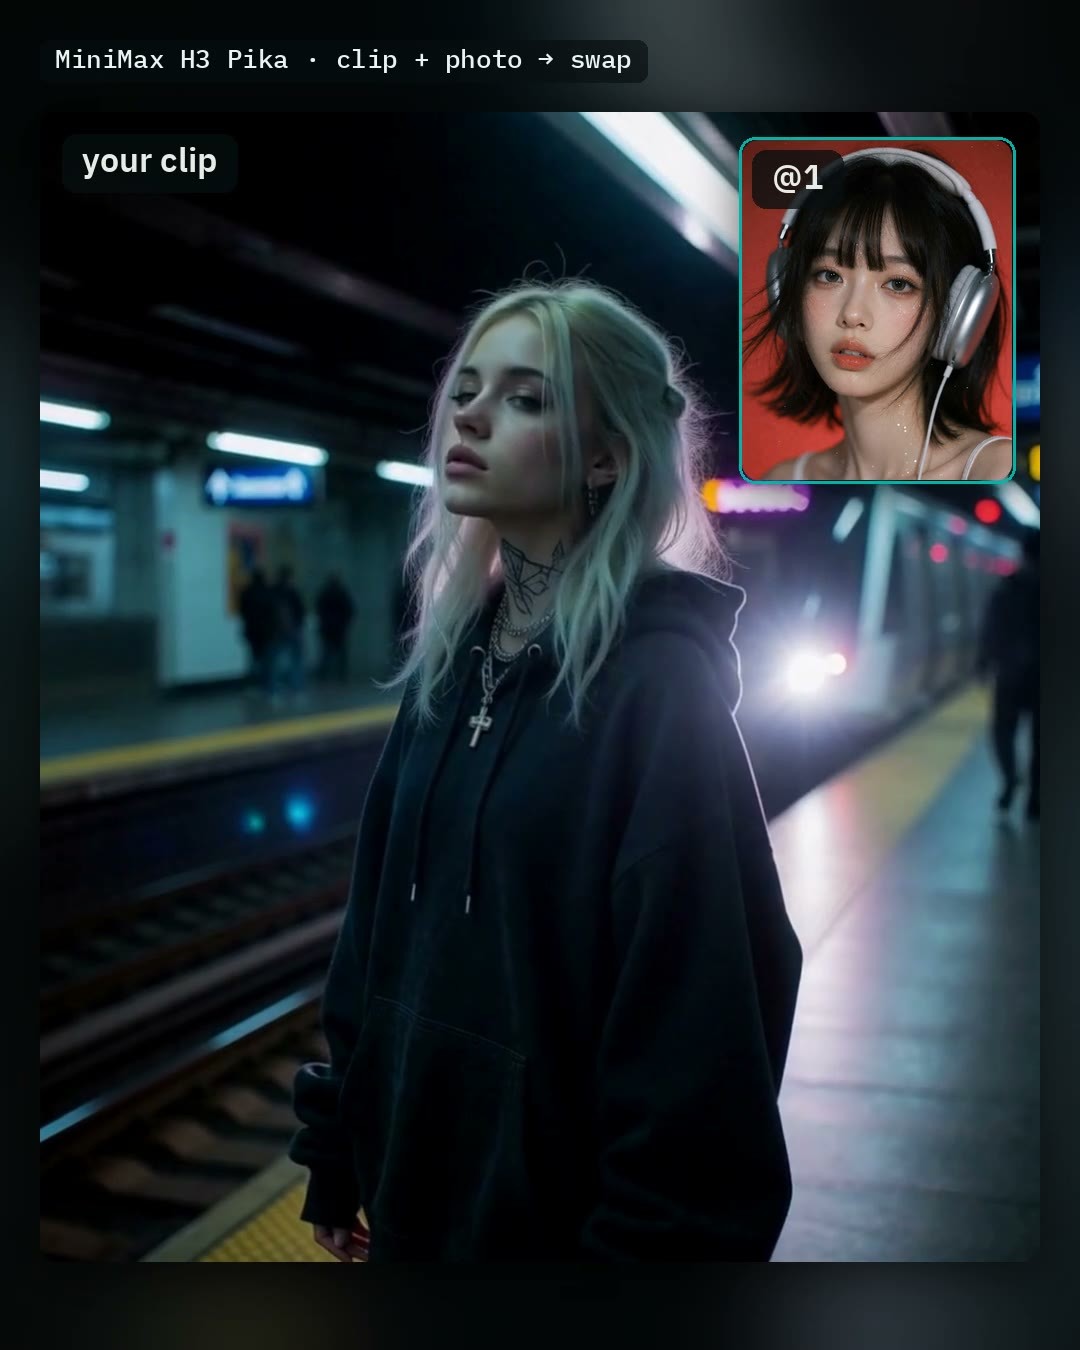
추천 이유
- 버전 업데이트: Low VRAM은 8에서 24 GB까지 커버하며, 저자는 8 GB 카드가 32 GB 시스템 메모리에서 시작 매개변수 없이(ComfyUI 0.45) 최대 8초 길이의 클립을 전체 크기로 실행할 수 있다고 주장함
- 최종 업스케일링을 SeedVR2에서 FlashVSR로 변경: 더 선명해지고, 2배 업스케일링되며, 하나의 3.5 GB 모델만 필요함. 효과가 없었던 Steer the mouths 스위치를 제거했으며, Keep the clip's sound를 활성화하면 새 인물의 입 모양이 원본 소리를 계속 따름
- Describe @1 for me(사진에 따라 외모 설명 자동 생성)는 저자가 32 GB 시스템 메모리 내에서 실행 완료할 수 있다고 주장함. 또한 다른 H3 노드 패키지로 인한 latent 오류를 수정함
사용 방법
- Video - Your clip에서 클립을 불러와 한 장면으로 편집(최대 10초) → Picture 1에 새 인물 사진 배치 → 프롬프트 두 줄 작성: 먼저 교체 대상 지정(Replace the man in the red shirt with @1), 그 다음 @1 looks like …로 헤어스타일과 얼굴 묘사 → High(24 GB 이상) 또는 Low VRAM 선택 → Run 실행
- AusBoss 노드 2.25.2 이상, ComfyUI 0.38.0 이상 필요
리스크 및 제한 사항
- 얼굴 교체 도구: 본인 또는 동의가 있는 인물에게만 사용하며, 초상권에 유의하고 실제 인물을 사칭하는 데 사용하지 마세요
- 저자는 얼굴이 너무 작거나 카메라를 등지고 있을 경우 H3가 원본 영상의 얼굴을 유지하고 헤어스타일과 의상만 교체할 수 있으며, 두 번째 줄 설명을 작성하지 않으면 교체가 늦게 일어나거나 아예 일어나지 않을 수 있다고 언급함
- 메인 모델 21.0 GB, 텍스트 인코더 15.7 GB 등은 직접 준비해야 함. 보이는 예시는 1개의 비디오와 1개의 이미지임
【A】MiniMax H3 Relight 12GB — relight any video from a light sphere, Full HD 1088p, up to 60 s, original sound · v1.0.0
워크플로우 · 새 모델 · 저자 The_frizzy1 · 게시일 11-14 05:39 · 다운로드 25
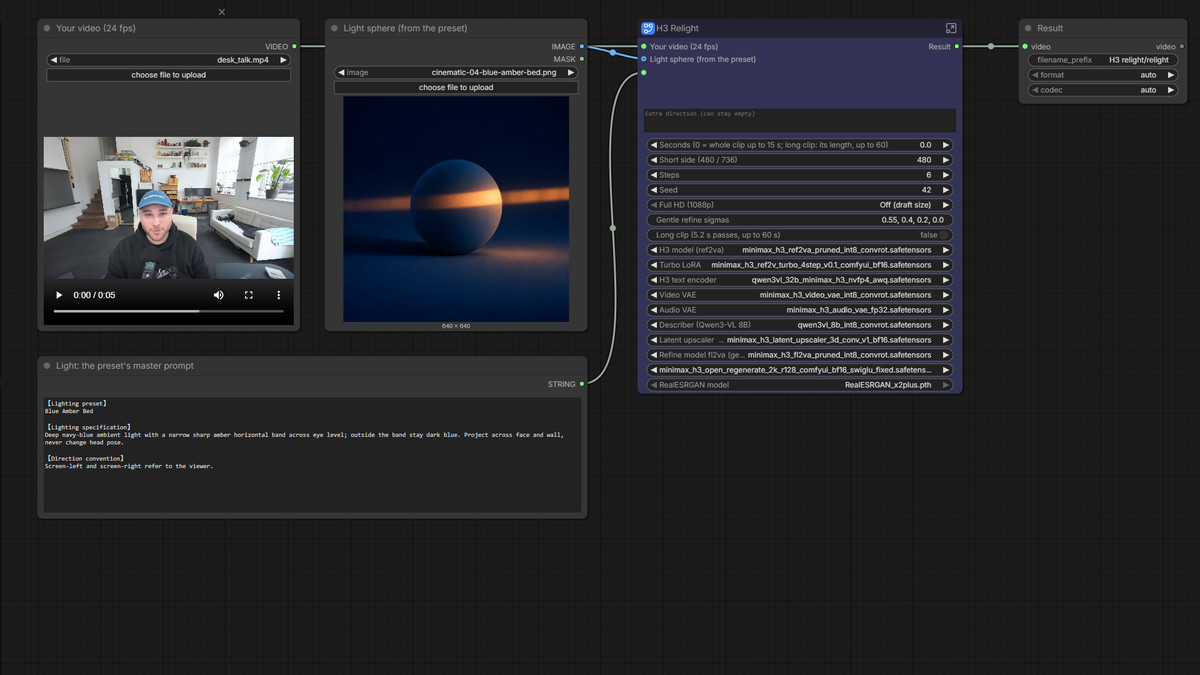
기존 비디오에 재조명: 입력 비디오, 조명 구(light sphere) 이미지, 조명 설명 문장을 입력하면 동일한 장면의 새로운 조명 효과를 출력하며, 인물, 방, 카메라 위치, 리듬 및 원본 소리는 변하지 않습니다.
이미지
추천 이유
- 새 도구, 비디오 후반 작업 조명 조정용: 12 GB 그래픽 카드에서 Sirio Berati가 원래 80 GB 렌탈 그래픽 카드용으로 작성한 오픈소스 relight를 로컬에서 복제하며, H3 Ref2VA int8와 ref2v turbo LoRA 기반
- ComfyUI 핵심 노드만 사용; Full HD 선택 가능(H3 부드러운 리페인팅 또는 RealESRGAN x2, 짧은 변을 1088p로), Long clip을 통해 최대 60 s까지 분할 처리
- 저자는 RTX 3060 12 GB에서의 VRAM 피크 11,841–11,945 MiB, 시스템 메모리 피크 21.4–22.6 GB를 제공함
사용 방법
- 조명 프리셋과 구 이미지는 sirioberati/relight-open-source(MIT)에서 가져옴: 구 이미지는 Light sphere 입력에, presets.json의 해당 master 텍스트는 Light text 입력에 배치
- ComfyUI 0.44 이상 필요; 비디오는 24 fps로 읽으며, 단일 실행 최대 15 s; 짧은 변은 빠른 모드 또는 더 선명한 모드를 선택할 수 있으며, turbo LoRA에서 저자는 6 스텝으로 설정함
리스크 및 제한 사항
- 필수 파일 6개 총 51.5 GB, Full HD 부드러운 리페인팅 활성화 시 추가 23.7 GB
- 저자는 Long clip과 워크플로우 내의 RealESRGAN이 아직 GPU에서 실제 렌더링되지 않았으며 소요 시간 데이터가 없다고 언급함. 736 짧은 변에 부드러운 리페인팅을 적용하여 5.2 s 클립을 처리하는 데 31:48이 소요됨
- 예시 비디오가 없으며, 이미지 1개만 있음
【A】MiniMax H3 Unified (Lip-sync, Scene Prompts and Resumable Video) · Nova.4
워크플로우 · 버전 업데이트 · 저자 Rvage · 게시일 11-14 05:10 · 다운로드 26
통합 H3 장편 비디오 워크플로우 Nova.4: 캐릭터 이미지가 기존 노래나 대사에 맞춰 립싱크를 하거나, 장면 텍스트/이미지/시작 및 끝 프레임 생성을 통해 소리가 포함된 비디오를 생성할 수 있으며, 분할 렌더링, 재개 실행, 특정 부분부터 재실행이 가능합니다.
이미지
추천 이유
- 버전 업데이트: 립싱크 동기화의 첫 번째 부분을 개별적으로 숨겨진 워밍업으로 설정할 수 있으며, 최종 영상은 전체 오디오 트랙과 시간을 유지함. 여러 장의 립싱크 이미지는 각각 하나의 장면 프롬프트에 해당함. 한 장의 이미지로도 여러 컷 포인트를 수동으로 설정할 수 있음. Scene Detector는 짧은 디졸브에서의 외형 변화를 추가로 확인함
- 또한 선택 가능한 최종 영상 업스케일링 그룹(자막 추가 및 저장 전)이 추가되었으며, Smart LM 모드 바에서 멈춘 언어 모델 및 해당 Ollama/Docker 백엔드를 원클릭으로 중지할 수 있음. Eclipse Nova를 1.0.36으로, SmartLLM Nova를 1.1.17로 업데이트해야 함
- 장편 비디오 및 뮤직 비디오용: 참조 비디오 분석으로 장면을 잘라내고 동작을 묘사할 수 있으며, 렌더링 전 Prompt Review에서 프롬프트를 수정할 수 있음. YuE2 또는 MiniMax Music 3를 연결하여 배경 음악을 생성할 수 있으며, 가사 추출 및 동적 자막을 포함함
사용 방법
- Eclipse Nova, Smart Model Loader Nova, SmartLLM Nova 세 개의 노드 패키지 설치(H3 패치와 Diff-Aid는 ComfyUI-sol-attn에서, 음성 분리는 Audio Separation Nodes를 사용하며, 먼저 음소거 상태로 사용 가능)
- START HERE에서 Lip-sync 또는 Native H3를 선택하고, Smart Model Loader와 LoRA Stack에서 해당 프리셋을 선택; H3는 24 FPS 유지; 저자의 립싱크 예제는 Euler / beta, CFG 1, 8 스텝, turbo LoRA 강도 1을 사용함
- 저장은 Disk + Keep in output을 선택하고, 중단 후 Resume saved run으로 재개 실행하며, Restart part로 특정 부분부터 재실행 지정
리스크 및 제한 사항
- 라이선스상 상업적 사용 및 파생 작업 금지
- 의존성이 많음: 세 개의 Nova 노드 패키지 및 여러 선택적 패키지, 립싱크 동기화는 wav2vec2 오디오 인코더가 추가로 필요함; 업데이트 후 ComfyUI를 재시작하고 장면 분석을 다시 실행해야 함
- 보이는 예시는 이미지 1개뿐이며, 1개는 숨겨져 있음(혼합 콘텐츠); 저자는 빠른 자세 변화와 배경이 유사한 클립은 여전히 감지되지 않을 수 있다고 언급함
주목할 점 (3)
【B】Easy MH3 (video generation + upscale using chunking + 60 FPS) (low VRAM support) · v2.0
워크플로우 · 버전 업데이트 · 저자 Crimson009 · 게시일 11-14 00:50 · 다운로드 39
H3 생성 및 분할 업스케일링을 위한 2단계 워크플로우 v2.0: 먼저 비디오를 생성한 후, 분할하여 업스케일링하고 RIFE로 60 FPS까지 프레임 보간하여 저용량 VRAM을 고려합니다.
이미지
추천 이유
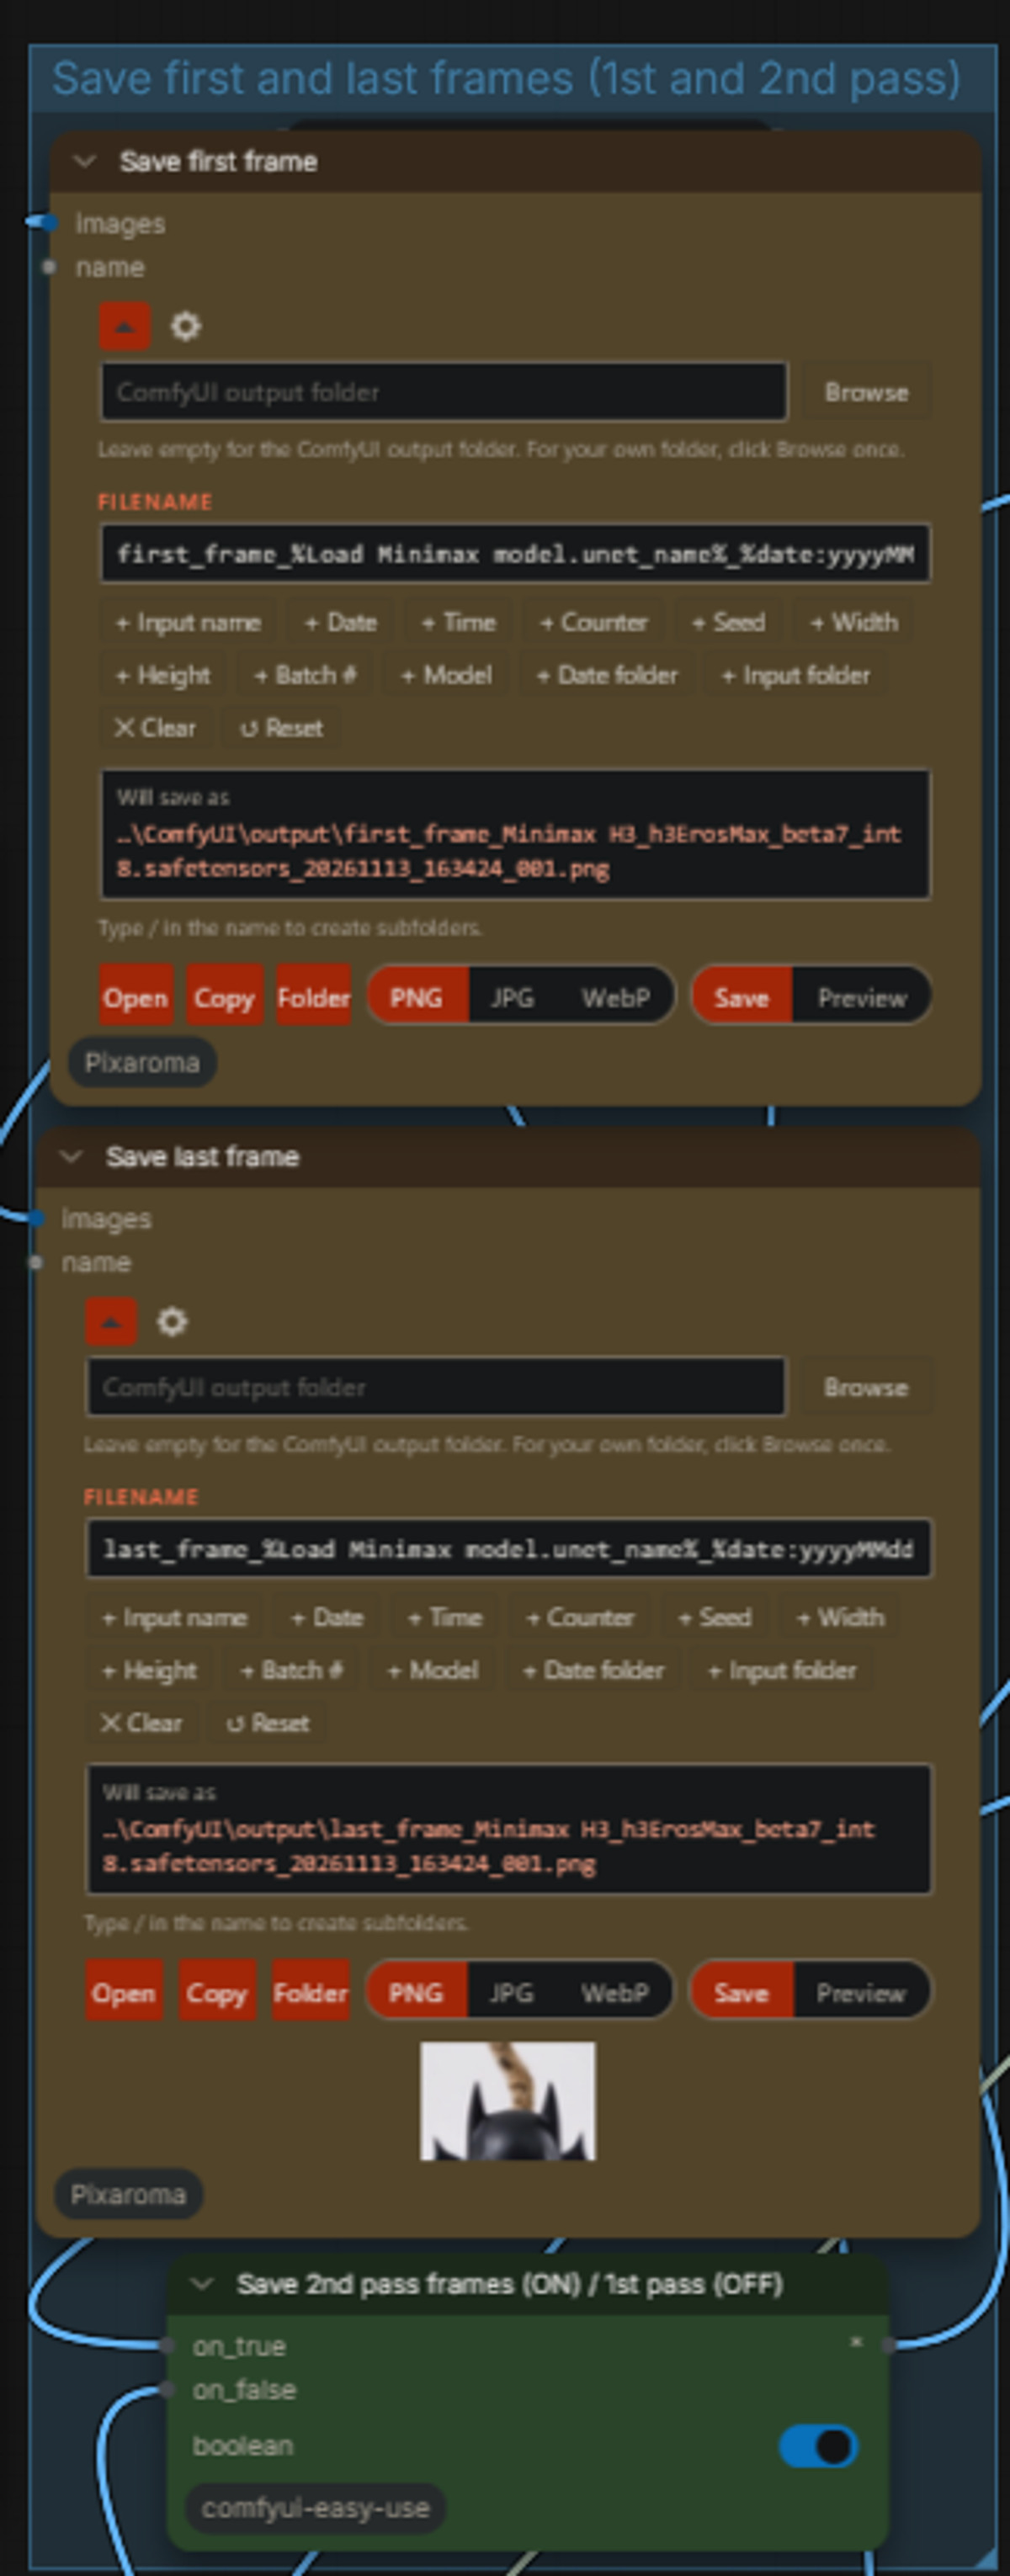
- 버전 업데이트(모델 카드에 기재, 버전 노트는 비어 있음): 보라색 스위치로 단일 단계 또는 2단계 프로세스를 선택; 단일 단계와 두 번째 단계에 각각 화질/리소스 절약 옵션 추가; 두 단계 모두 시작 및 끝 프레임 저장(다음 단계 연결용) 및 오디오 제거 버전 저장 가능
- 기본값은 Temporal chunk와 RIFE를 사용하여 VRAM을 절약하고 최종 영상을 60 FPS로 보간함; VRAM이 더 낮을 경우 Spatial Chunk를 활성화하여 추가 분할 가능; 각 단계 종료 후 Free VRAM 노드로 VRAM 해제
사용 방법
- Prompt, Loras and References 그룹에 프롬프트와 자료 입력 → 첫 번째 단계에서 Video duration과 Video settings 조정 → 두 번째 단계에서 Upscale Resolution Selector 선택 → Run 실행; 빨간색 노드는 일회성 모델 구성임
- 필요한 모델 파일, VRAM 및 스텝 수는 저자가 제공하지 않음
리스크 및 제한 사항
- 보이는 예시는 이미지 2개뿐이며, 3개는 숨겨져 있고, 보이는 비디오는 없음; 이 버전의 변경 사항은 주로 스위치와 저장 옵션에 집중되어 있어 자동 A 등급이 B로 강등됨
- 버전 노트가 비어 있으며, 의존하는 커스텀 노드도 나열되지 않음
【B】HyperFlow H3 Flash — Fast Video with Sound in 4–8 Steps (ComfyUI) · v1.0
워크플로우 · 새 모델 · 저자 lahcenbensalah19488 · 게시일 11-14 01:24 · 다운로드 36
HyperFlow H3 Flash의 무료 텍스트-비디오 프리셋: 저자가 주장하는 13.7B 압축 버전의 H3를 사용하여, 4 스텝으로 5.2초 길이의 스테레오 오디오 트랙이 포함된 초안을 생성하고, 최종본은 6 또는 8 스텝으로 전환합니다.
이미지
추천 이유
- 새 도구, 빠른 프롬프트 테스트용: FastDraft 프리셋은 먼저 4 스텝으로 카메라 앵글과 소리 아이디어를 확인한 후, 6 스텝(균형) 또는 8 스텝(품질)으로 최종본을 생성
- 의존성이 명확히 기재됨: ComfyUI 0.43.0 이상 및 ComfyUI-GGUF와 ComfyUI-HyperFlow-Flash 노드 필요, 저자는 피크 VRAM이 약 21 GiB라고 주장함
사용 방법
- Civitai_HyperFlow_H3Flash.zip을 압축 해제하여 워크플로우를 불러옴; 모델 파일(약 28 GB)은 패키지에 포함되지 않으며 직접 준비해야 함; 스텝 수 4 / 6 / 8
리스크 및 제한 사항
- 이것은 저자 $39의 전체 패키지 무료 샘플이며, 모델 카드에는 대부분 구매 링크와 할인 코드만 포함되어 있고 모델 파일 다운로드 주소는 제공되지 않습니다
- 24 GB의 GPU가 필요하며, 공개된 예시는 1장의 이미지뿐이고 영상은 없습니다
- 저자 경고: H3 커뮤니티 라이선스 하에서 미국, EU, 영국, 한국에서의 자체 호스팅 사용은 사전 신청이 필요합니다
【B】MMH3 I2V/T2V 워크플로우 (잠재 공간 업스케일 및 컨텍스트 연속성 포함) · v1.0
워크플로우 · 신규 모델 · 저자 bvga · 게시일 11-13 23:42 · 다운로드 47
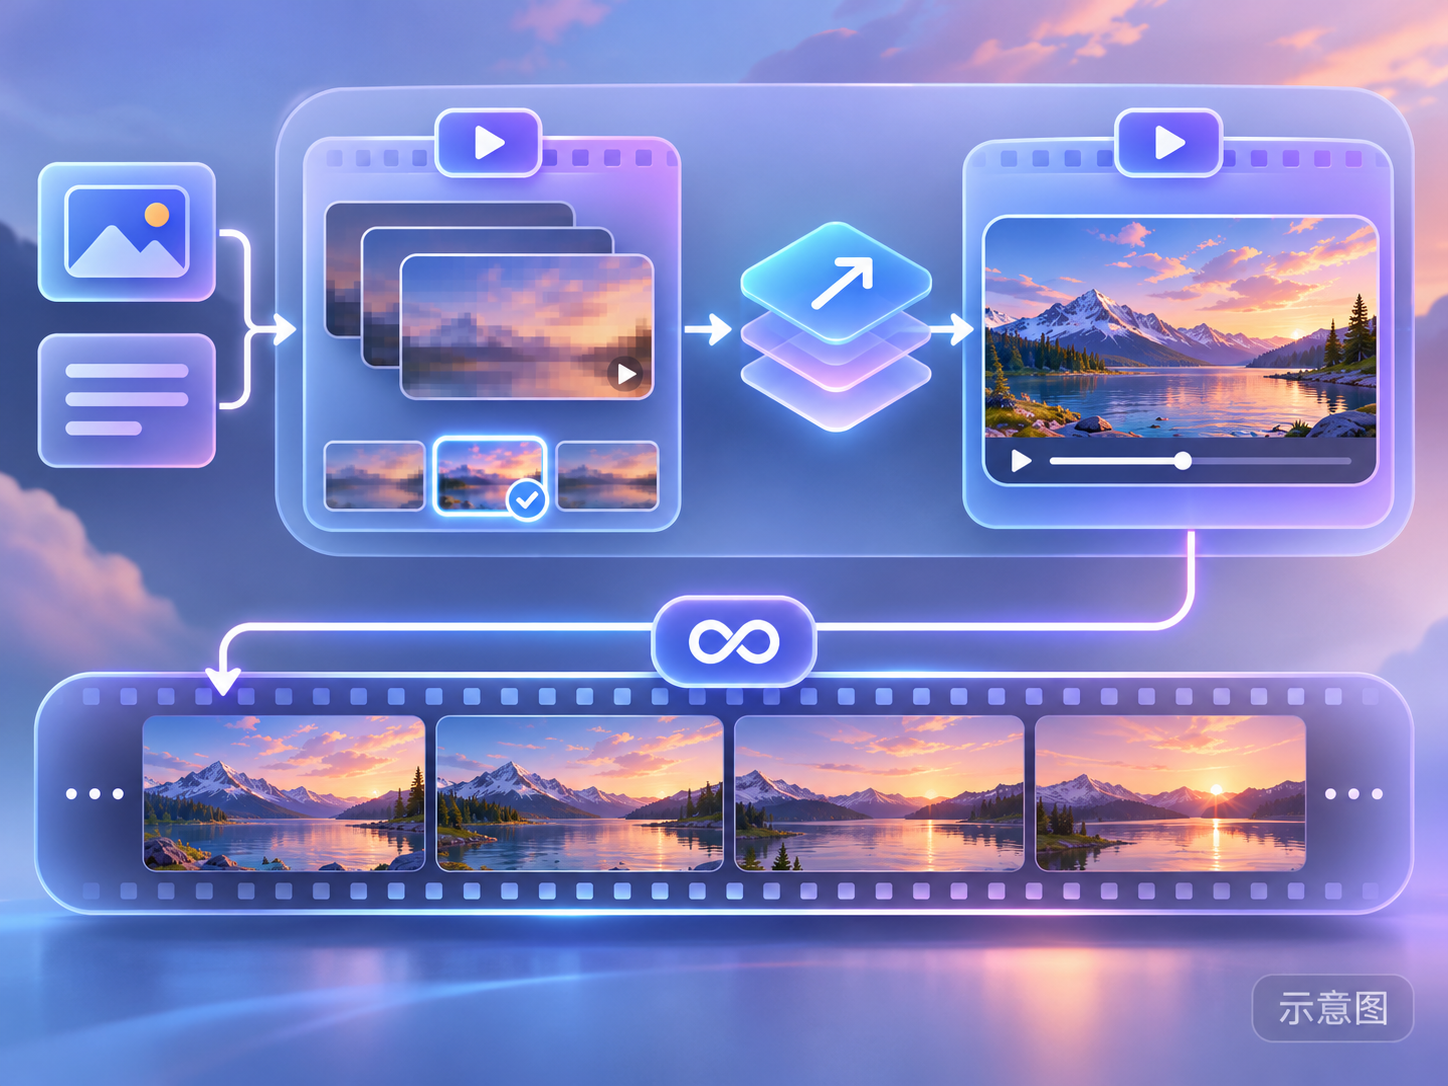
이미지-투-비디오 / 텍스트-투-비디오 2단계 워크플로우: 먼저 저해상도로 영상을 생성하여 선택한 후, 잠재 공간 업스케일링을 통해 두 번째 샘플러로 보내 디테일을 보강하며, 이 2단계 샘플링 과정에서 컨텍스트 연속성을 연결했습니다.
참고 이미지
추천 이유
- 빠른 실험 및 비디오 연속성을 위한 신규 도구: 저해상도 클립 중 만족스러운 것을 먼저 선택하면, 저자에 따르면 두 번째 샘플러가 디테일과 동작을 정리하고 보강할 수 있습니다
- 저자는 두 샘플링 단계 간에 두 개의 컨텍스트를 전달하는 연속성 방법을 구현했으며, 이는 원래 노드가 지원하지 않는 기능입니다
사용 방법
- 워크플로우 내 주석에 따라 특정 노드의 몇 줄 코드를 수정해야 합니다(latent의 pins 덮어쓰기 허용); 모델, 스텝 수, 강도에 대한 정보는 저자가 제공하지 않았습니다
리스크 및 제한 사항
- 노드 소스 코드를 수동으로 수정해야 하며, 노드 업데이트 시 기능이 중단될 수 있습니다
- 유일한 예시가 숨겨져 있어 공개된 예시가 없으며, 모델 카드에는 간단한 소개만 있습니다
- 카드의 참고 이미지는 AI로 생성된 개념도일 뿐 모델의 실제 결과가 아니며, 저자는 공개된 일반 등급의 예시를 제공하지 않았습니다
참고용만 수록 (6)
- Lora-Daddy H3 Studio - Now Free <3 · V4 — 워크플로우: Lora-Daddy의 H3 Studio 노드 패키지 및 워크플로우 V4(v4.0 Hydrogen), 이 버전부터 무료입니다.
- FastH3 Omni Lip-Sync — Portrait + Voice Line to Talking Video (ComfyUI) · v1.0 — 워크플로우: 인물 사진 한 장과 대사 오디오 한 개를 사용하여 5초 길이의 립싱크 대화형 아바타 영상을 생성하는 무료 워크플로우 샘플입니다.
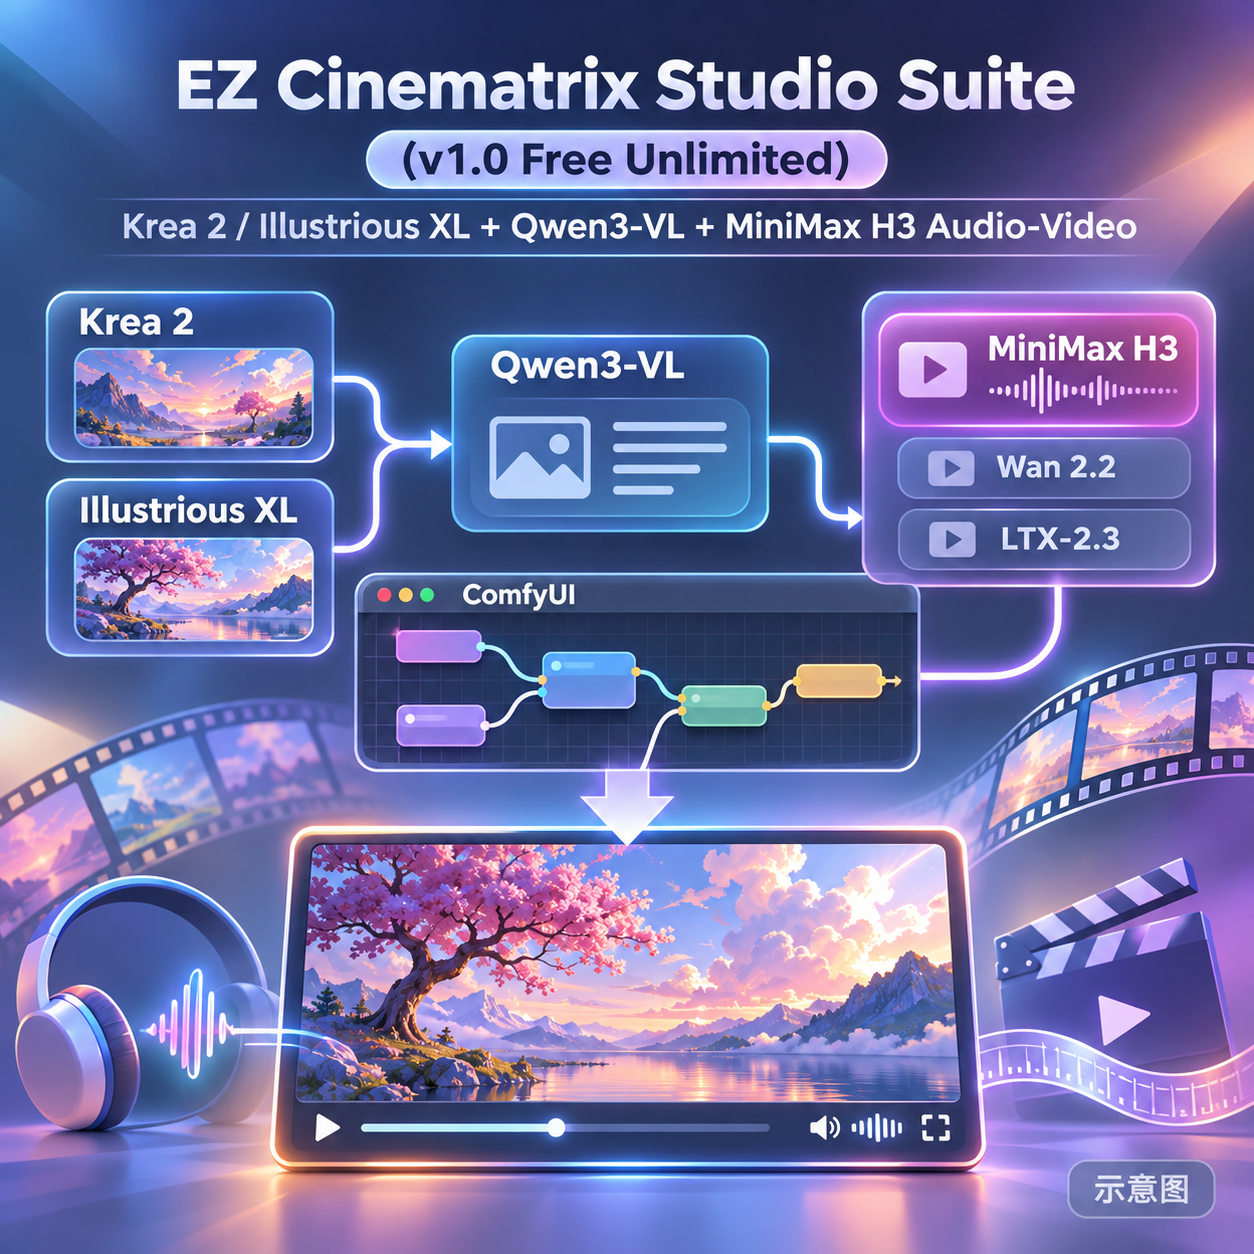
- EZ Cinematrix Studio Suite (v1.0 Free Unlimited) — Krea 2 / Illustrious XL + Qwen3-VL + MiniMax H3 Audio-Video · v1.0 — 워크플로우: 다중 기반 모델용 ComfyUI 노드 키트: Krea 2 / Illustrious XL로 키프레임을 생성하고, Qwen3-VL로 프롬프트를 작성한 후, MiniMax H3(또는 Wan 2.2, LTX-2.3)에 전달하여 오디오가 포함된 영상을 생성하며, 뮤직비디오 제작도 가능합니다.
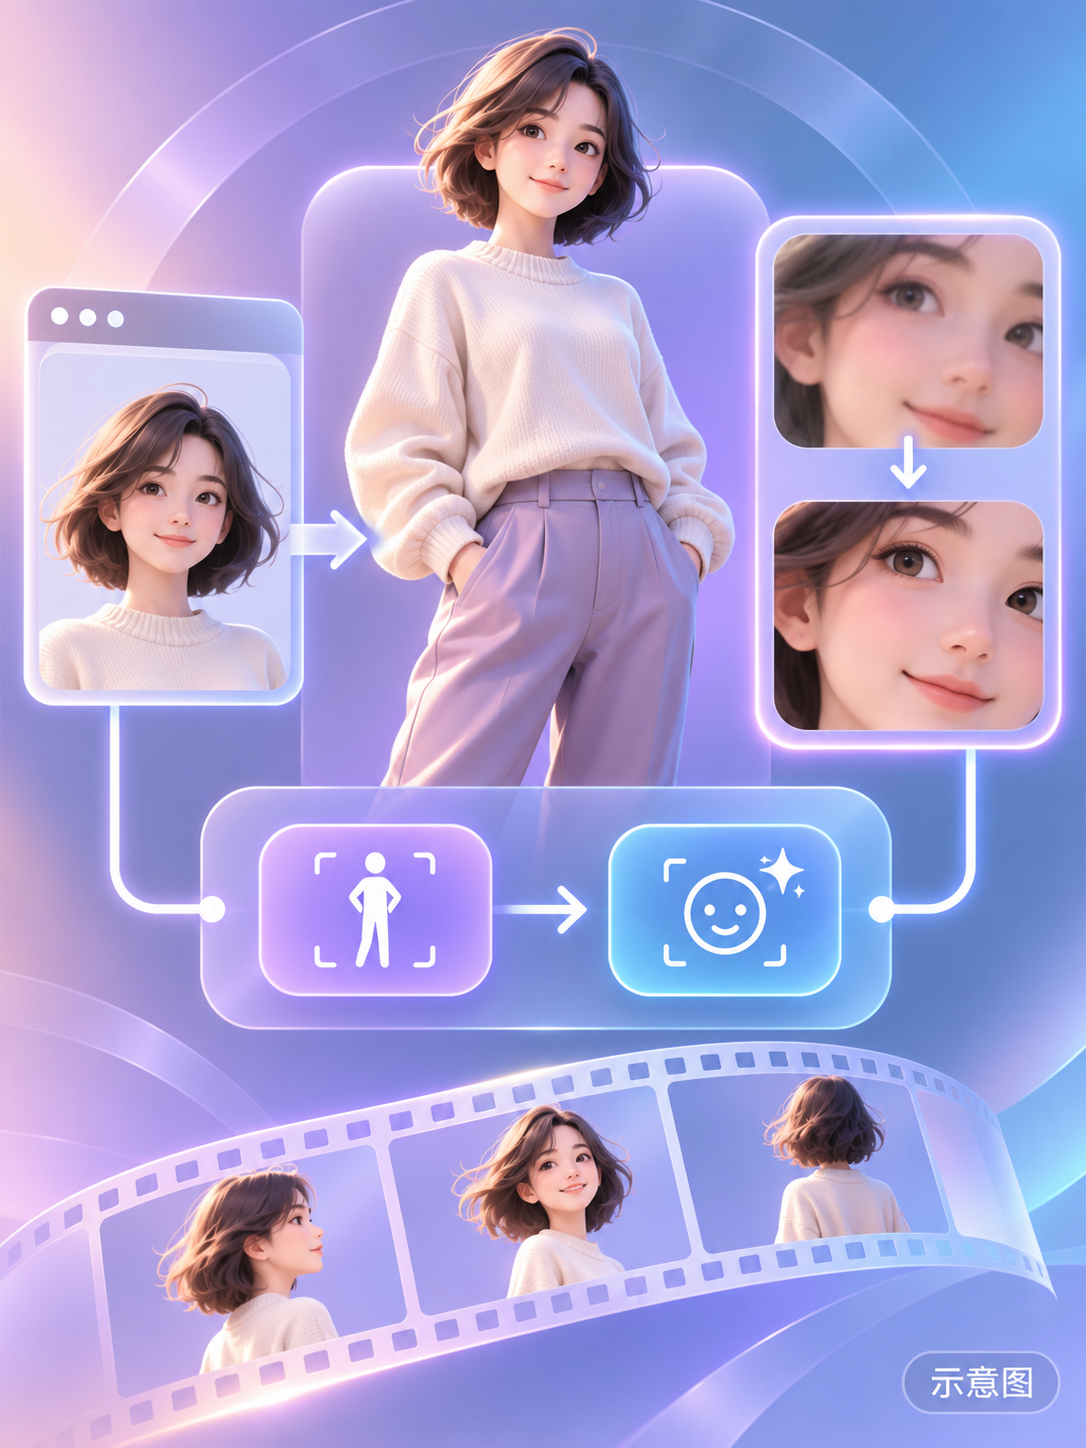
- MiniMax H3 Self Lift Avatar + Face Refinement Workflow · v1.0 — 워크플로우: MiniMax H3 Self Lift Avatar와 얼굴 정제 기능을 연결한 워크플로우입니다.
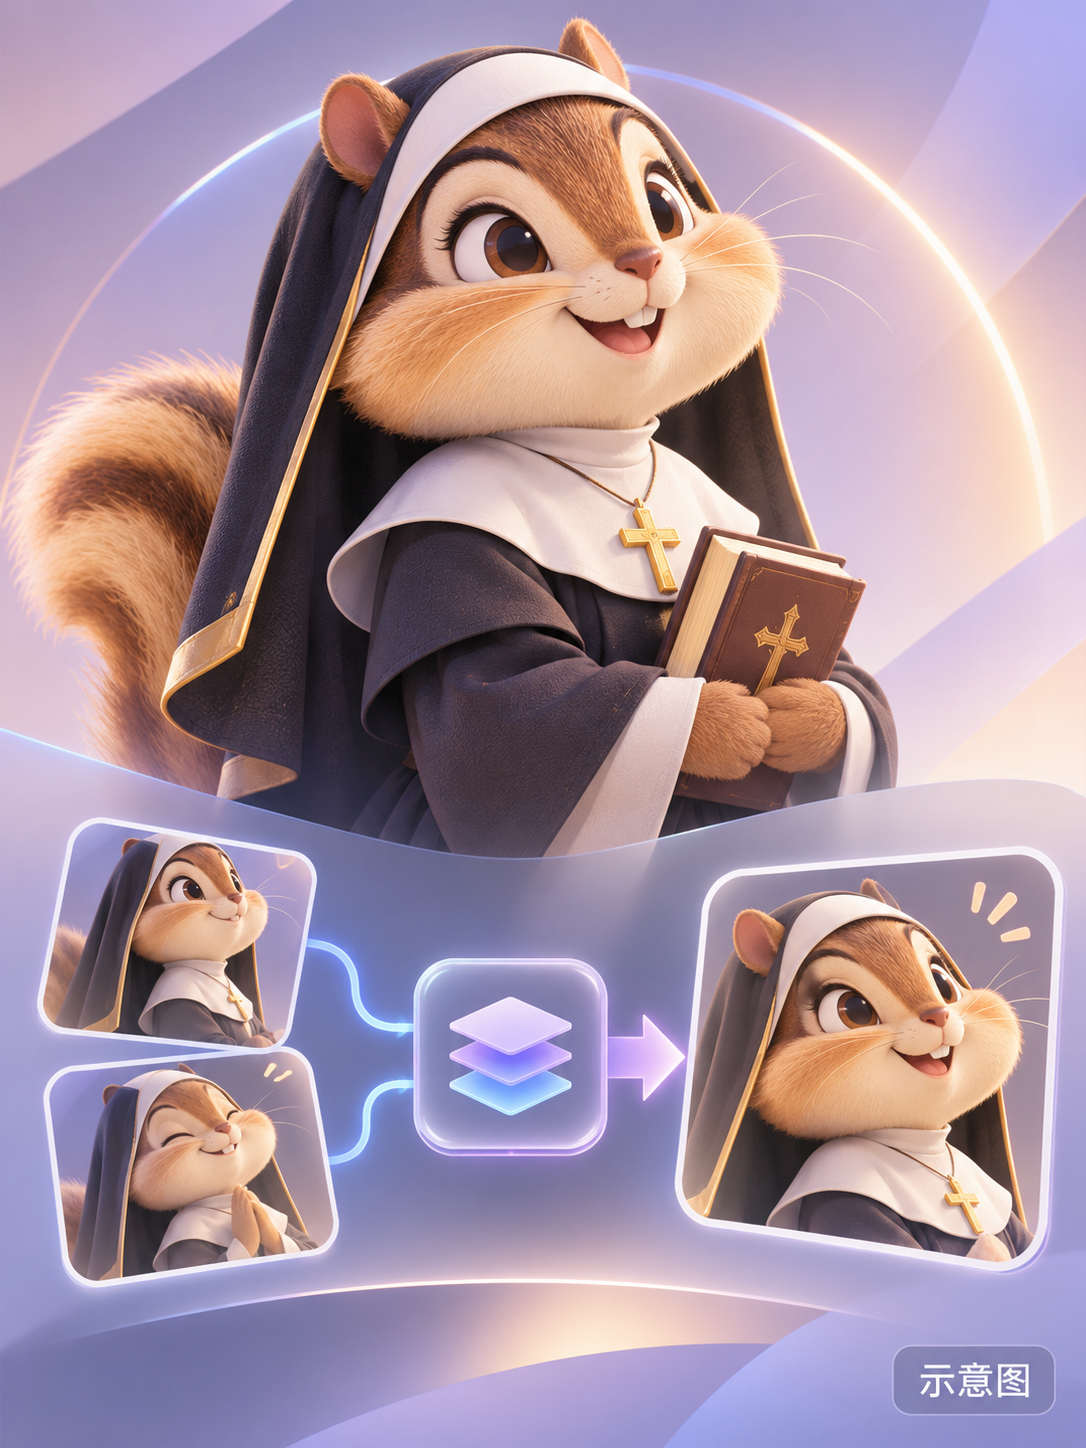
- Sister Hazel · v1.0 H3 — LoRA: 오리지널 다람쥐 수녀 캐릭터 Sister Hazel의 인물 LoRA로, Krea 2 등 버전에서 H3으로 이식되었습니다.
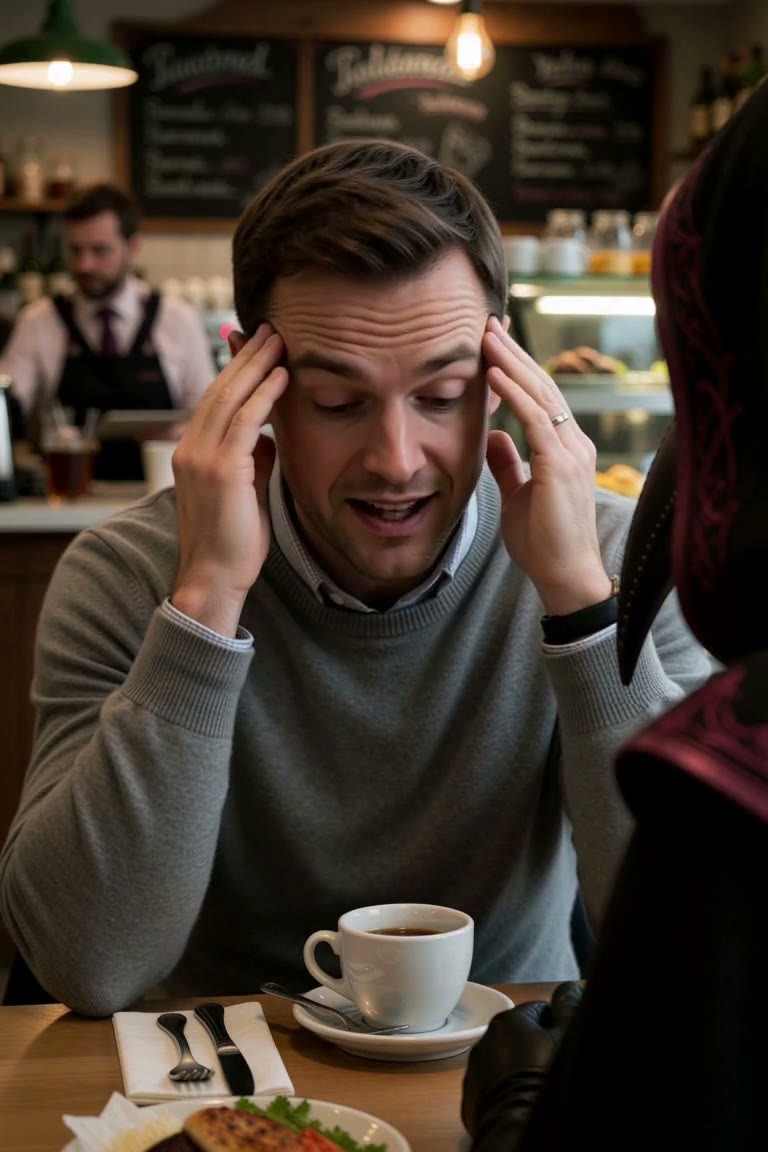
- Doctor Penny · v2.0 H3 — LoRA: 오리지널 페스트 닥터 복장 캐릭터 Doctor Penny의 인물 LoRA로, Krea 2 등 버전에서 H3으로 이식되었습니다.
데이터: Civitai 공개 API(기반 모델 MiniMax H3), 수집 기간 11-13 20:31 → 11-14 09:18(베이징 시간). 추천 이유는 편집 검수를 거쳤으며, 다운로드 수는 관심도를 나타냅니다.