贞贞的AI雷达 · MiniMax H3 · 2026-11-14 晨报
本期 16 个新版本:强烈推荐 2 · 推荐 5 · 可关注 3 · 仅收录 6
编辑按语 本期审阅 16 个 H3 新版本,2 个 S、5 个 A、3 个 B、6 个 C。首推 AusBoss 的 Pika Remix:最多四张图加一段视频各配用途,用 @1 写提示词就能做参考图生视频、换人、改物、抄动作或续拍,Low VRAM 档从 8 GB 起。另一个 S 是 Ultimate 12GB,一个下拉框切 8 种 H3 模式且只用核心节点;Viggle 换角色、Relight 重打光、Person Swap v1.1、Unified Nova.4 列 A,Singularity 换脸因 53.2 GB 下载、两个自定义节点包和肖像同意问题由 S 降为 A。Easy MH3 v2.0 降为 B,FastH3 口型(付费包的免费样品)、Lora-Daddy V4 与 Self Lift(说明过少)、EZ Cinematrix(示例全隐藏)降为 C,两个 MikoGoblin 角色移植维持 C。
强烈推荐(2)
【S】MiniMax H3 Pika Remix | High + Low VRAM, 8 GB+ · v1.0
工作流 · 新模型 · 作者 AusBoss · 发布 11-14 05:53 · 下载 67
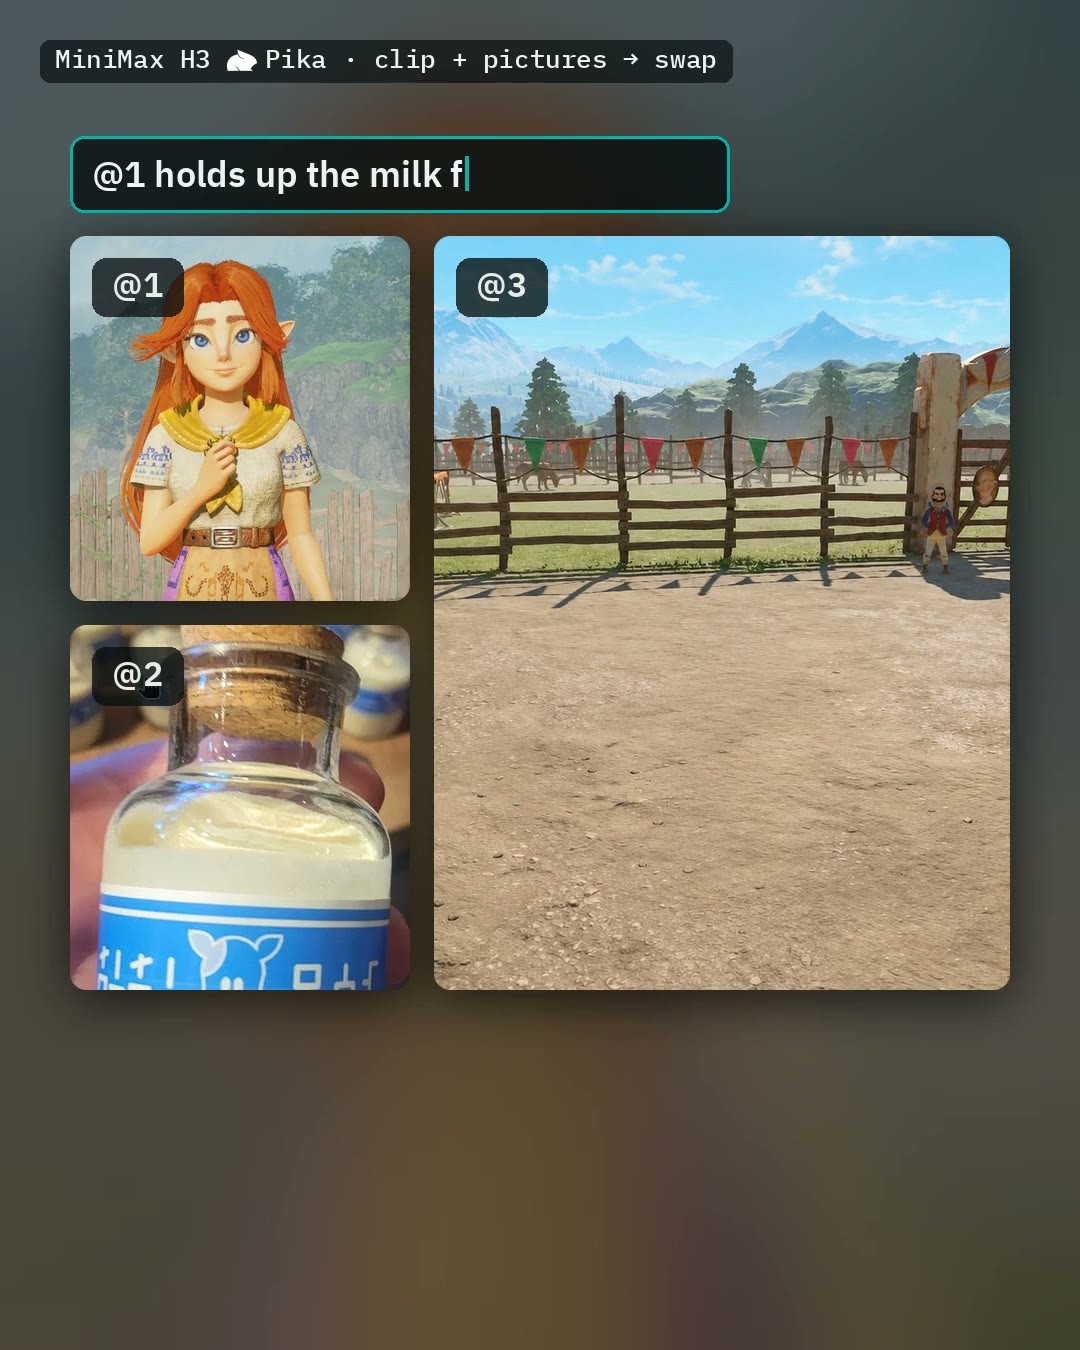
H3 + Pika 的多用途工作流:最多四张图加一段视频,每份素材自选用途,可做参考图生视频、视频换人、改视频里的一样东西、照抄动作或接着往下拍。
配图
推荐理由
- 新工具,一个工作流覆盖参考图生视频和视频编辑:每张图选人物 / 场景 / 服装 / 物品,提示词里用 @1、@2 指代;视频可选“换人”“改一样东西”“照抄动作”“接着拍”,也能加入原片声音、人声或歌曲
- 照顾显存:High VRAM 用于 24 GB 以上,Low VRAM 覆盖 8 到 24 GB(换用较小的主模型和 VAE);开关里另有 Fast preview、Auto prompt,以及把成片放大两倍并锐化的 FlashVSR
- 示例齐:5 段视频加 1 张图全部可见,另附作者的 YouTube 操作视频;只需换人时可用同作者更小的 Person Swap
怎么用
- Picture 1 载入图片并在 H3 Prompt Writer 选用途 → 每件事写一行(如 @1 walks to the window and looks out)→ 在 Seconds 选时长 → 选 High / Low VRAM → Run
- Pika LoRA 强度保持 1,不要再叠 Turbo 或 Lightning LoRA(Pika 本身就是加速);需要 ComfyUI 0.38.0 以上(8 GB 卡要 0.45 以上,Auto prompt 要 0.42.0 以上)和 AusBoss 节点 2.25.2 以上
风险与限制
- 必需模型约 44.5 GB(ref2va int8 主模型 21.0 GB、Qwen3-VL 32B 文本编码器 15.7 GB 等),Auto prompt 和 FlashVSR 另需下载
- 作者称 8 GB 卡要选 Low VRAM、片长不超过 10 秒、系统内存约 32 GB;一次同时换人、换场景、换物品时原人物会中途回来,建议一次只改一样
- 换人和照抄动作会用到他人肖像:只用于已获同意的人物,注意肖像权
- 底模受 MiniMax H3 社区许可约束
【S】MiniMax H3 Ultimate 12GB — T2V/I2V/FFLF/R2V/Multiframe/ControlNet/Extend, one dropdown, with audio · v2.3.0
工作流 · 新模型 · 作者 The_frizzy1 · 发布 11-13 23:51 · 下载 55
一个下拉框切换 8 种本地 H3 模式的工作流:文生视频、首帧、尾帧、首尾帧、参考图、多帧引导、ControlNet 姿态和视频续写,全部带声音。
配图
推荐理由
- 新工具,覆盖 H3 的主要任务:文生视频、图生视频、首尾帧、参考图(提示词里写 <Picture 1>)、多帧引导、姿态控制、续写;只用 ComfyUI 核心节点,不装自定义节点
- v2.3.0 新增“续写时保留原片声音”:原片最后 0.9 秒音频和最后 22 帧一起送入,接缝处声音不跳
- 作者给了 RTX 3060 12 GB 上的显存峰值 11.3–11.6 GB、系统内存峰值 17–22 GB;9 段视频加 2 张图示例可见
怎么用
- 需要 ComfyUI 0.39.2(v2.3.0);在节点的 Mode 下拉框选模式,只对本模式用到的输入取消旁路(选中后 Ctrl+B),其余保持旁路
- Turbo LoRA 默认开启:FL2VA 8 步、Ref2VA 4 步,关掉 Turbo 用 20 步;时长按秒填,工作流自动换算成合法帧数
风险与限制
- 全部 10 个模型约 69 GB;只做文生 / 图生 / 首尾帧 / 续写需其中 5 个、约 42 GB
- 作者称 12 GB 卡分辨率保持 0.4 或 0.9 MP,1.5 MP 会溢出显存;没用到的输入若未旁路,开跑前会报 Invalid image file
- 长视频只能手动反复跑 Extend;整段换人模式不在其中(另有 Viggle 工作流)
- 9 个示例被隐藏(混合内容)
推荐(5)
【A】MiniMax H3 Singularity V2 Face Swap 12GB — one photo into your video, lip-sync, sound and room kept · v1.0.0
工作流 · 新模型 · 作者 The_frizzy1 · 发布 11-14 00:02 · 下载 71
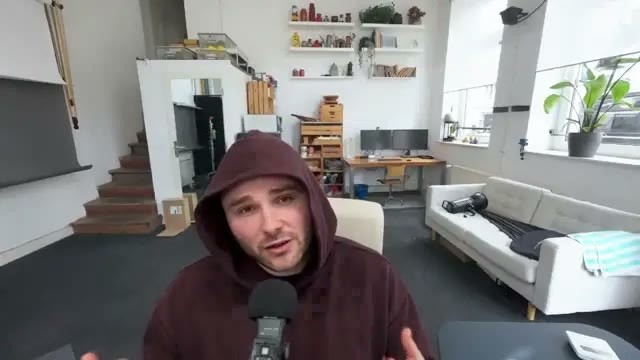
用一张照片把视频里的一个真人换成照片中的人:房间、镜头运动和原声保留,整段一次生成,可开口型同步。
配图
推荐理由
- 新工具,服务视频换人:SAM 3.1 跟踪要换的人,把人变成保留姿势、手和嘴型的灰色人形,再由 Singularity V2(H3 Ref2VA 微调)按照片只重绘遮罩区域
- Qwen3-VL 8B 看四帧写一句镜头描述;作者称没有这句时 Singularity 会无视灰色人形、在画面中央画出巨大的头
- 作者在 RTX 3060 12 GB、32 GB 内存上跑通,显存峰值 11,598–11,731 MiB;5 段视频可见
怎么用
- 以 App 模式打开;输入 24 fps、没有镜子的视频(最长 15 s)、一张脸大且背景素净的清晰照片、要替换的对象(如 person 或 bald man)和一句新人物外观描述;Seconds 建议先试 3 秒
- 需要两个自定义节点包 comfyui-h3-oneclick-swap 和 ComfyUI-Fantastic-MiniMaxH3-PromptBuilder,作者用 ComfyUI 0.43.1;内置设定为 ref2v turbo LoRA 强度 1.0、6 步、euler / simple
风险与限制
- 换人工具:只用于本人或已获同意的人物,注意肖像权,不要用来冒充真人
- 必需 7 个文件共 53.2 GB,是作者最大的一套下载;系统内存峰值 22–23 GB
- 作者称全身镜头里头部仍可能偏大,照片只到腰部时要在描述里补上裤子和鞋;一次只换一个人,不处理镜子和倒影
- 12 个示例被隐藏(混合内容);自动评级 S,因下载量大、依赖两个自定义节点包和肖像同意问题降为 A
【A】Viggle-Animate (MiniMax H3) 12GB — character replacement in video, 4 steps, the driving clip's audio kept · v2.0.0
工作流 · 新模型 · 作者 The_frizzy1 · 发布 11-14 05:39 · 下载 29
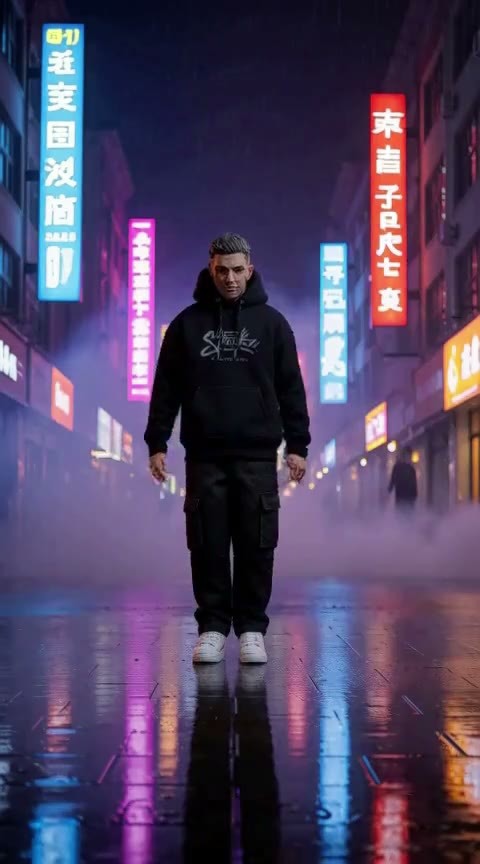
用一张角色静帧替换视频里的人物:动作、镜头、背景和驱动视频的原声都保留,4 步出片。
配图
推荐理由
- 新工具,服务视频换角色 / 动作迁移:基于 Viggle 对 H3 Ref2VA 的 33B 微调,只有一个模式——一段驱动视频加一张角色图
- 作者给了 RTX 3060 12 GB 上的显存峰值 11.2–11.6 GB,并列出需要的 4 个模型文件和存放目录
怎么用
- 安装 Comfy registry 上的 comfyui-viggle-animate-h3 v1.3.2,ComfyUI 0.37.4 以上;视频 VAE 要用 fp16 版 minimax_h3_video_vae_fp16,不是其他 H3 工作流常用的 int8 版
- 载入 The_frizzy1_viggle-animate-h3_v2.0.0.json,放入驱动视频和角色图后 Run,固定 4 步
风险与限制
- 作者称这个工作流还没有自己的演示视频,可见的那段视频是通用使用教程;另有 3 张图可见、3 个示例被隐藏
- 只测过 5 秒、480x864 / 832x480 的片段,显存几乎吃满 12 GB,更长更大未测;作者未写 v2.0.0 相对 v1 改了什么
- 主模型 21.0 GB
- 换人工具:只用于本人或已获同意的人物,注意肖像权,不要用来冒充真人
【A】MiniMax H3 Pika Person Swap | High + Low VRAM, 8 GB+ · v1.1
工作流 · 版本更新 · 作者 AusBoss · 发布 11-14 05:53 · 下载 93
把一张照片里的人放进视频替换原人物,场景、动作、镜头和声音保留;v1.1 支持 8 GB 显卡,收尾放大改用 FlashVSR。
配图
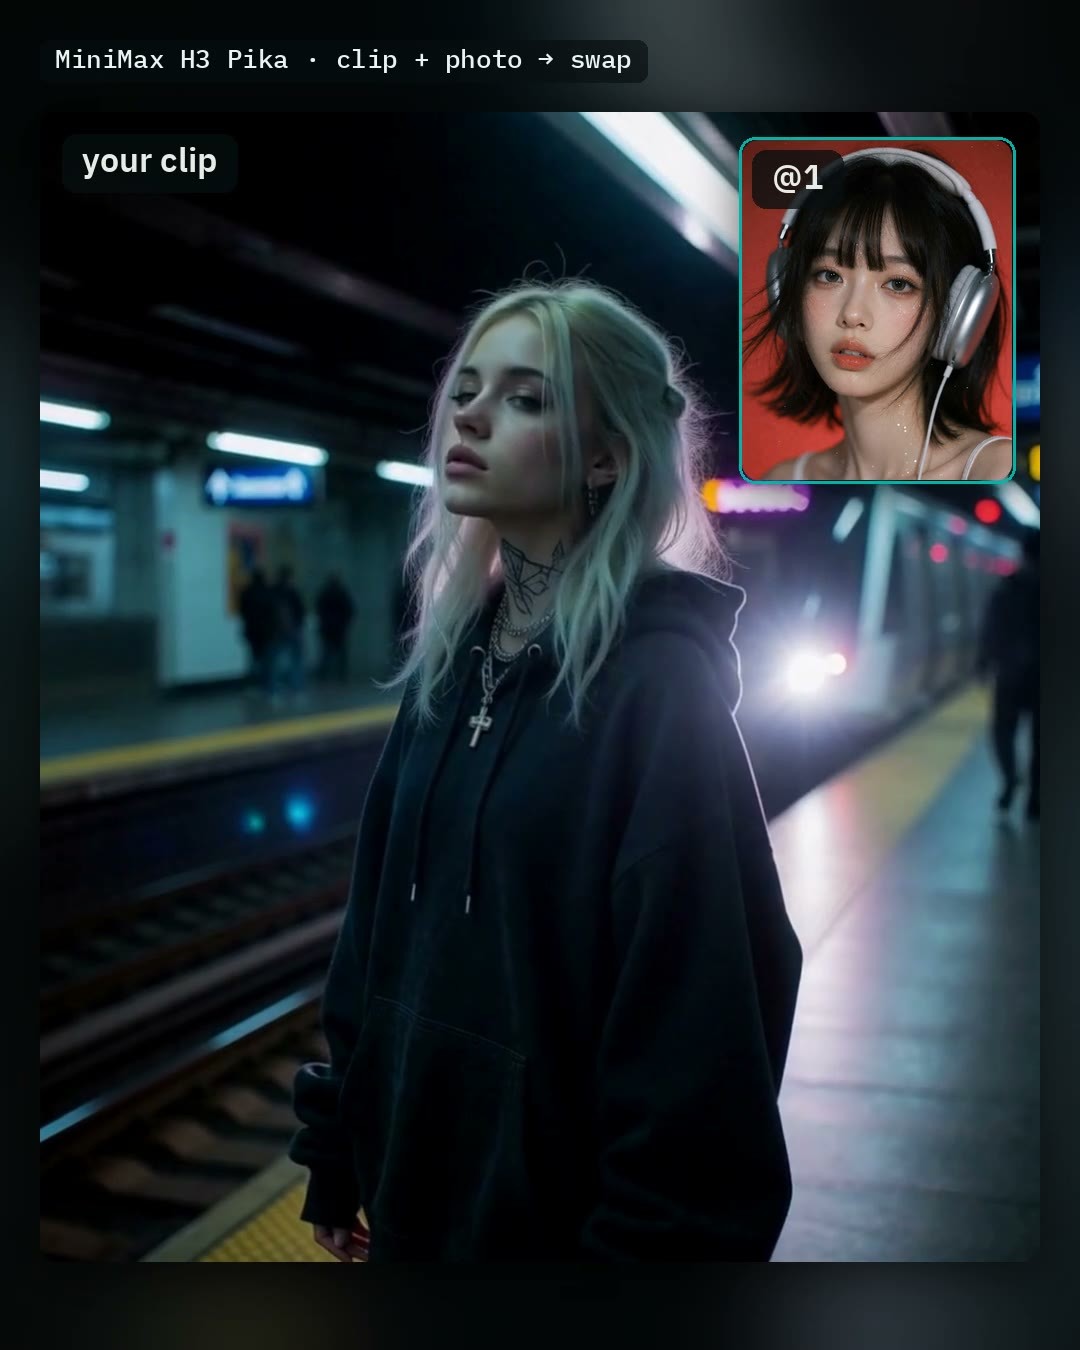
推荐理由
- 版本更新:Low VRAM 覆盖 8 到 24 GB,作者称 8 GB 卡在 32 GB 系统内存下可全尺寸跑最长 8 秒的片段,无需启动参数(ComfyUI 0.45)
- 收尾放大从 SeedVR2 换成 FlashVSR:更锐、放大两倍、只需一个 3.5 GB 模型;去掉了从没起作用的 Steer the mouths 开关,开 Keep the clip's sound 时新人物嘴型仍跟随原声
- Describe @1 for me(按照片自动写外观描述)作者称已能在 32 GB 系统内存内跑完;另修了其他 H3 节点包引起的 latent 报错
怎么用
- 在 Video - Your clip 载入片段并剪成一个镜头(最长 10 秒)→ Picture 1 放新人物照片 → 提示词两行:先写换谁(Replace the man in the red shirt with @1),再写 @1 looks like … 描述发型和脸 → 选 High(24 GB 以上)或 Low VRAM → Run
- 需要 AusBoss 节点 2.25.2 以上、ComfyUI 0.38.0 以上
风险与限制
- 换人工具:只用于本人或已获同意的人物,注意肖像权,不要用来冒充真人
- 作者称脸太小或背对镜头时 H3 可能保留原片的脸、只换发型和衣服;不写第二行描述时可能换得晚或不换
- 主模型 21.0 GB、文本编码器 15.7 GB 等需自备;可见示例 1 段视频加 1 张图
【A】MiniMax H3 Relight 12GB — relight any video from a light sphere, Full HD 1088p, up to 60 s, original sound · v1.0.0
工作流 · 新模型 · 作者 The_frizzy1 · 发布 11-14 05:39 · 下载 25
给现有视频重新打光:输入视频、一张光照球图和一句光照描述,输出同一镜头的新光效,人物、房间、机位、节奏和原声不变。
配图
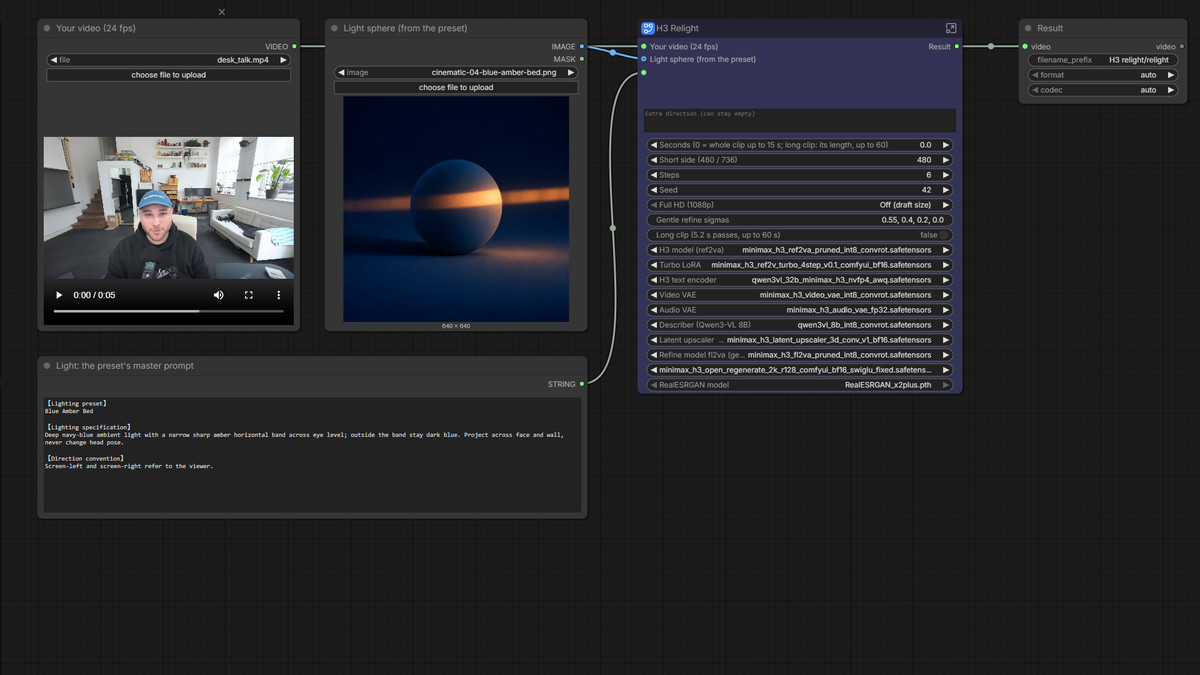
推荐理由
- 新工具,服务视频后期调光:在 12 GB 显卡上本地复刻 Sirio Berati 原本为一块 80 GB 租用显卡写的开源 relight,基于 H3 Ref2VA int8 加 ref2v turbo LoRA
- 只用 ComfyUI 核心节点;可选 Full HD(H3 温和重绘或 RealESRGAN x2,短边到 1088p),Long clip 分段处理最长 60 s
- 作者给了 RTX 3060 12 GB 上的显存峰值 11,841–11,945 MiB、系统内存峰值 21.4–22.6 GB
怎么用
- 光照预设和球图取自 sirioberati/relight-open-source(MIT):球图放 Light sphere 输入,presets.json 里对应的 master 文本放 Light text 输入
- 需要 ComfyUI 0.44 以上;视频按 24 fps 读,单次最长 15 s;短边可选快速档或更锐档,turbo LoRA 下作者设 6 步
风险与限制
- 必需 6 个文件共 51.5 GB,开 Full HD 温和重绘再加 23.7 GB
- 作者称 Long clip 和工作流内的 RealESRGAN 还没在 GPU 上实际渲染过,没有耗时数据;736 短边加温和重绘处理一段 5.2 s 片段要 31:48
- 没有示例视频,只有 1 张图
【A】MiniMax H3 Unified (Lip-sync, Scene Prompts and Resumable Video) · Nova.4
工作流 · 版本更新 · 作者 Rvage · 发布 11-14 05:10 · 下载 26
一体化 H3 长视频工作流 Nova.4:既能让角色图对着现成歌曲或台词做口型,也能按场景文生 / 图生 / 首尾帧生成带声音的视频,分段渲染,可续跑、可从某一段起重做。
配图
推荐理由
- 版本更新:口型同步的第一段可单独设隐藏预热,成片保留完整音轨和时间;多张口型图各对应一个场景提示词;一张图也能手动设多个切点;Scene Detector 多检查短溶解里的外观变化
- 还新增可选的成片放大组(在加字幕和保存之前),Smart LM 模式栏可一键停止卡住的语言模型及其 Ollama/Docker 后端;需把 Eclipse Nova 更新到 1.0.36、SmartLLM Nova 更新到 1.1.17
- 服务长视频和音乐视频:参考视频分析可切出场景并描述动作,渲染前可在 Prompt Review 改提示词;可接 YuE2 或 MiniMax Music 3 生成配乐,带歌词提取和动态字幕
怎么用
- 安装 Eclipse Nova、Smart Model Loader Nova、SmartLLM Nova 三个节点包(H3 补丁和 Diff-Aid 来自 ComfyUI-sol-attn,人声分离用 Audio Separation Nodes,可先静音不用)
- START HERE 选 Lip-sync 或 Native H3,并在 Smart Model Loader 和 LoRA Stack 选对应预设;H3 保持 24 FPS;作者的口型示例用 Euler / beta、CFG 1、8 步、turbo LoRA 强度 1
- 存储选 Disk + Keep in output,中断后用 Resume saved run 续跑,用 Restart part 指定从哪一段重做
风险与限制
- 许可禁止商用、禁止衍生
- 依赖多:三个 Nova 节点包加多个可选包,口型同步另需 wav2vec2 音频编码器;更新后要重启 ComfyUI 并重跑场景分析
- 可见示例只有 1 张图,1 个被隐藏(混合内容);作者称快速姿态变化和背景相近的剪辑仍可能漏检
可关注(3)
【B】Easy MH3 (video generation + upscale using chunking + 60 FPS) (low VRAM support) · v2.0
工作流 · 版本更新 · 作者 Crimson009 · 发布 11-14 00:50 · 下载 39
H3 生成加分块放大的两段式工作流 v2.0:先生成视频,再分块放大并用 RIFE 插帧到 60 FPS,照顾低显存。
配图
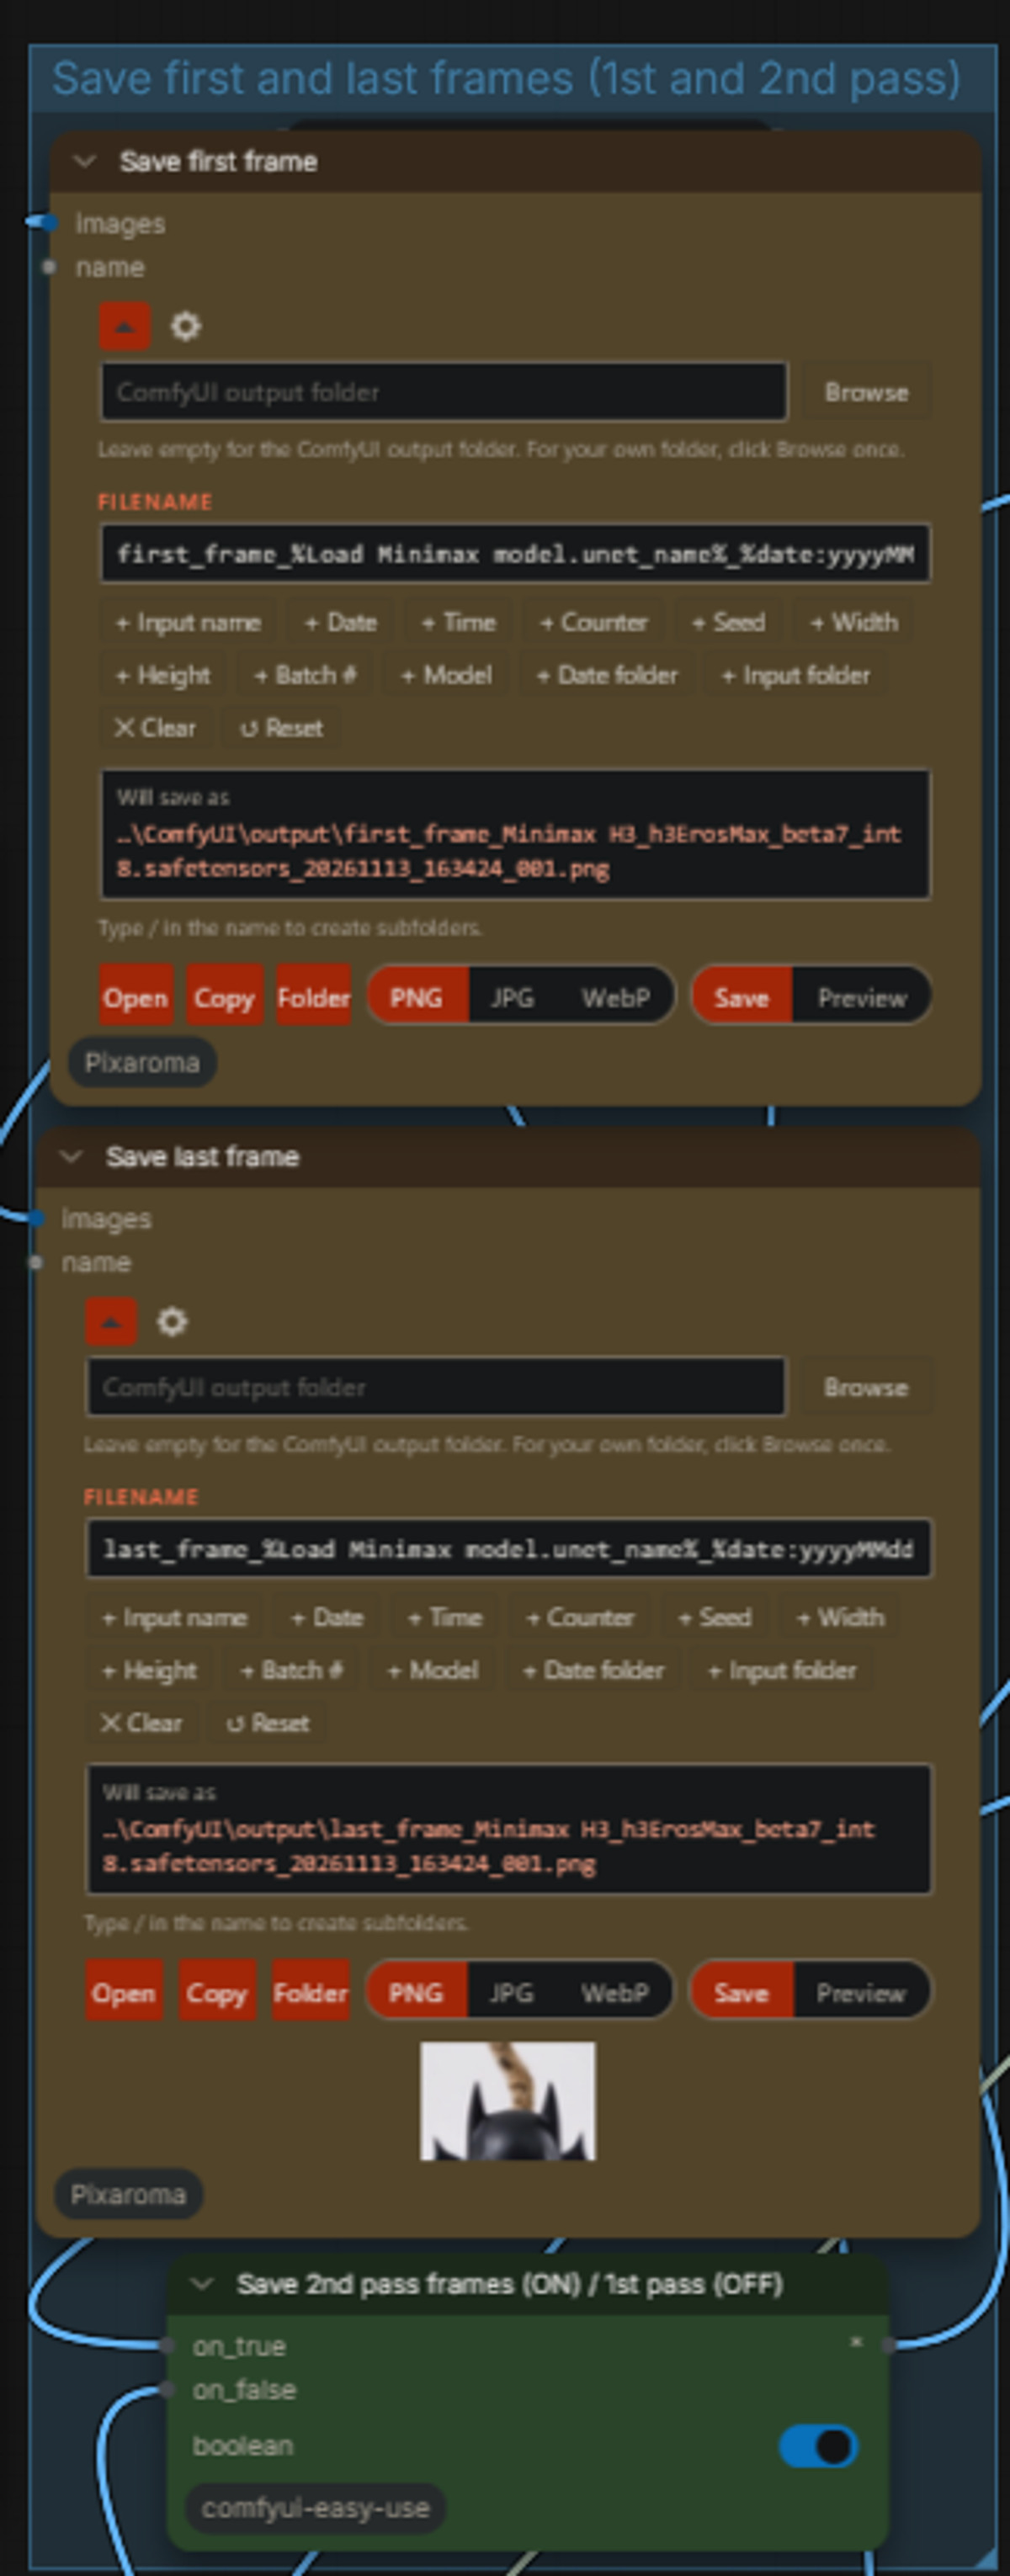
推荐理由
- 版本更新(写在模型卡里,版本说明为空):用紫色开关选单段或两段流程;单段和第二段各加画质 / 省资源选项;两段都能保存首尾帧(用来接下一段)和去掉音频的版本
- 默认用 Temporal chunk 和 RIFE 省显存并把成片插到 60 FPS;显存更低时可开 Spatial Chunk 进一步切分;每段结束后用 Free VRAM 节点释放显存
怎么用
- 在 Prompt, Loras and References 组填提示词和素材 → 在第一段调 Video duration 和 Video settings → 在第二段选 Upscale Resolution Selector → Run;红色节点是一次性模型配置
- 需要的模型文件、显存和步数作者未给
风险与限制
- 可见示例只有 2 张图,3 个被隐藏,没有可见视频;本版改动以开关和保存选项为主,自动 A 降为 B
- 版本说明为空,也没有列出依赖的自定义节点
【B】HyperFlow H3 Flash — Fast Video with Sound in 4–8 Steps (ComfyUI) · v1.0
工作流 · 新模型 · 作者 lahcenbensalah19488 · 发布 11-14 01:24 · 下载 36
HyperFlow H3 Flash 的免费文生视频预设:用作者称的 13.7B 压缩版 H3,4 步出一段 5.2 秒、带立体声音轨的草稿,定稿再切 6 或 8 步。
配图
推荐理由
- 新工具,服务快速试提示词:FastDraft 预设先用 4 步看镜头和声音想法,再改 6 步(平衡)或 8 步(质量)出终版
- 依赖写得清楚:ComfyUI 0.43.0 以上加 ComfyUI-GGUF 和 ComfyUI-HyperFlow-Flash 节点,作者称峰值显存约 21 GiB
怎么用
- 解压 Civitai_HyperFlow_H3Flash.zip 载入工作流;模型文件(约 28 GB)不在包里,需自备;步数 4 / 6 / 8
风险与限制
- 这是作者 $39 完整包的免费样品,模型卡大半是购买链接和折扣码;模型卡没有给出模型文件下载地址
- 需要 24 GB 显卡;可见示例只有 1 张图,没有视频
- 作者提醒:H3 社区许可下,美国、欧盟、英国、韩国的自托管使用需先申请
【B】MMH3 I2V/T2V Workflow with Latent Upscale and Context Continuation · v1.0
工作流 · 新模型 · 作者 bvga · 发布 11-13 23:42 · 下载 47
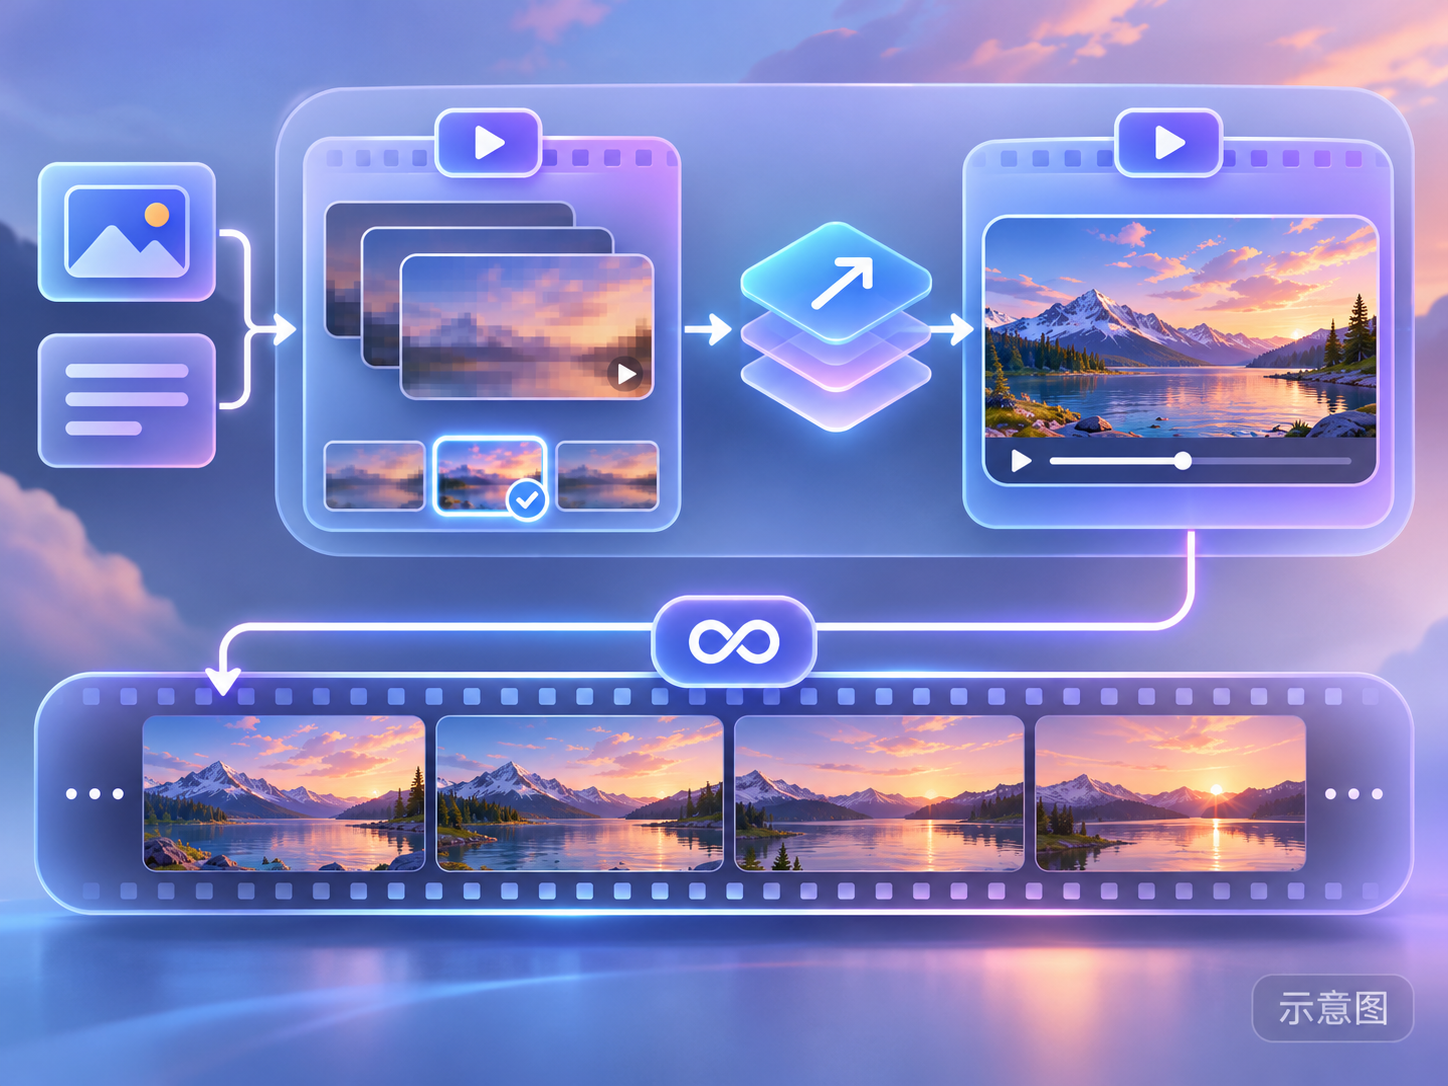
图生 / 文生视频两段式工作流:先低分辨率出片挑选,再做潜空间放大送入第二个采样器补细节,并在这套两段采样里接上了上下文续写。
配图
推荐理由
- 新工具,服务快速试错和视频续写:低分辨率片段先挑满意的,第二个采样器作者称能清理并补充细节和动作
- 作者拼出了在两段采样之间传递两份上下文的续写方法,这是节点原本不支持的
怎么用
- 需按工作流里的注释改某个节点的几行代码(允许覆盖 latent 上的 pins);模型、步数、强度作者未给
风险与限制
- 需要手改节点源码,节点更新后可能失效
- 唯一的示例被隐藏,没有可见示例;模型卡只有简短介绍
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
仅收录(6)
- Lora-Daddy H3 Studio - Now Free <3 · V4 — 工作流:Lora-Daddy 的 H3 Studio 节点包加工作流 V4(v4.0 Hydrogen),从本版起免费。
- FastH3 Omni Lip-Sync — Portrait + Voice Line to Talking Video (ComfyUI) · v1.0 — 工作流:一张人像加一段台词音频,生成 5 秒口型同步说话头像视频的免费工作流样品。
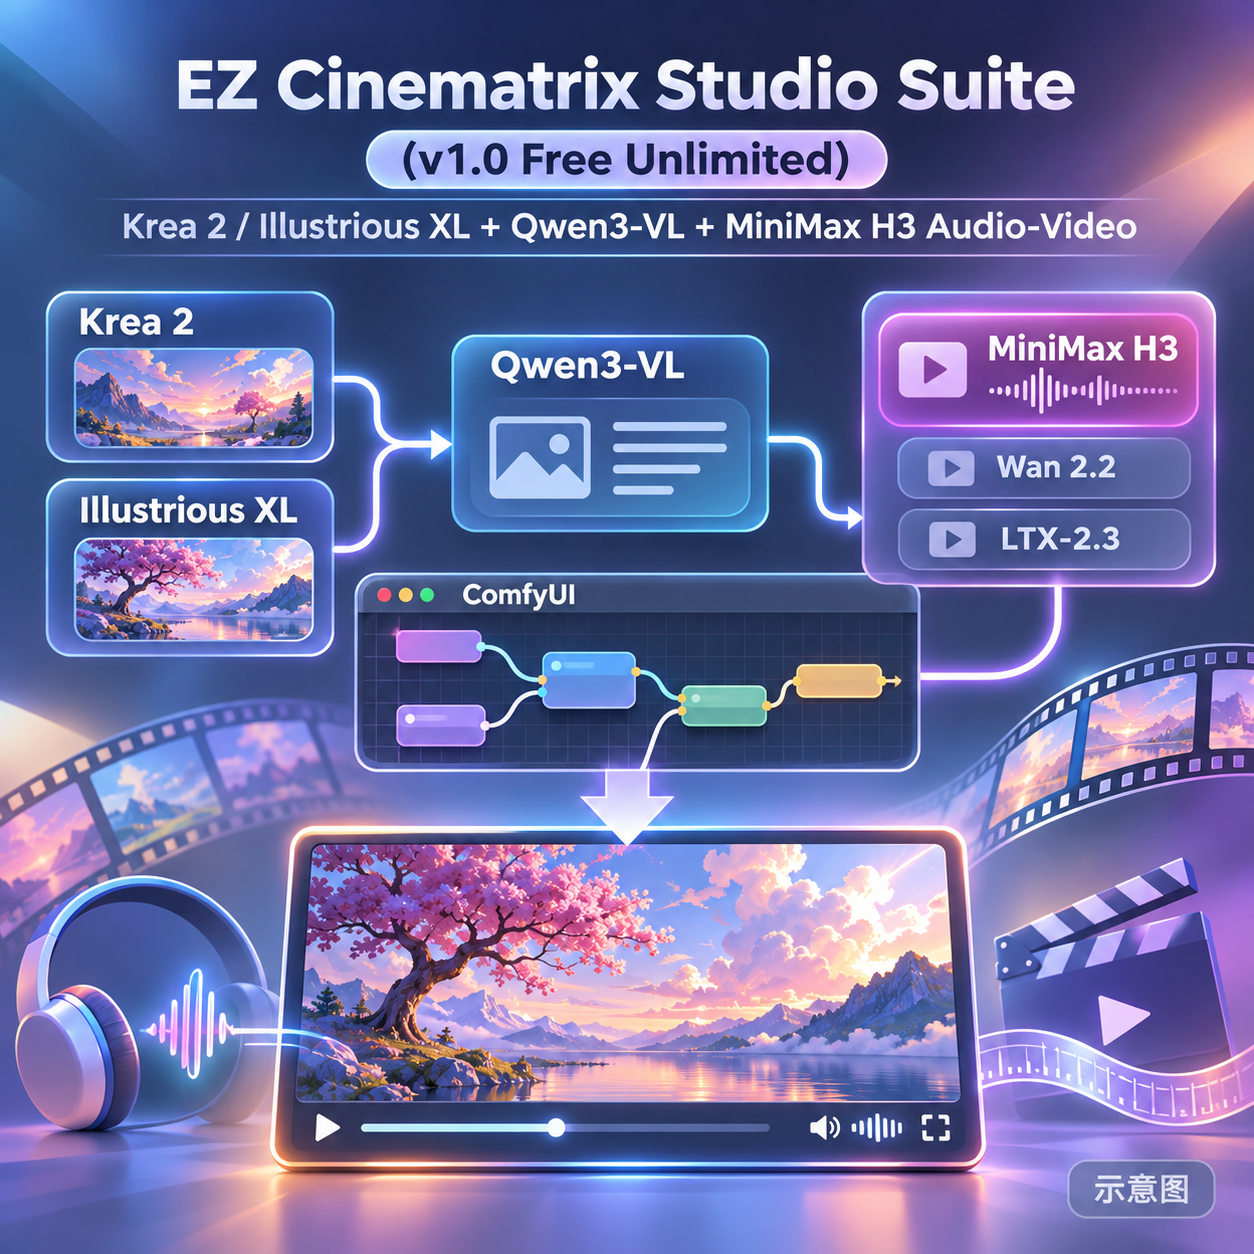
- EZ Cinematrix Studio Suite (v1.0 Free Unlimited) — Krea 2 / Illustrious XL + Qwen3-VL + MiniMax H3 Audio-Video · v1.0 — 工作流:多基模的 ComfyUI 节点套件:Krea 2 / Illustrious XL 出关键帧、Qwen3-VL 写提示,再交给 MiniMax H3(或 Wan 2.2、LTX-2.3)生成带声音的视频,可做音乐视频。
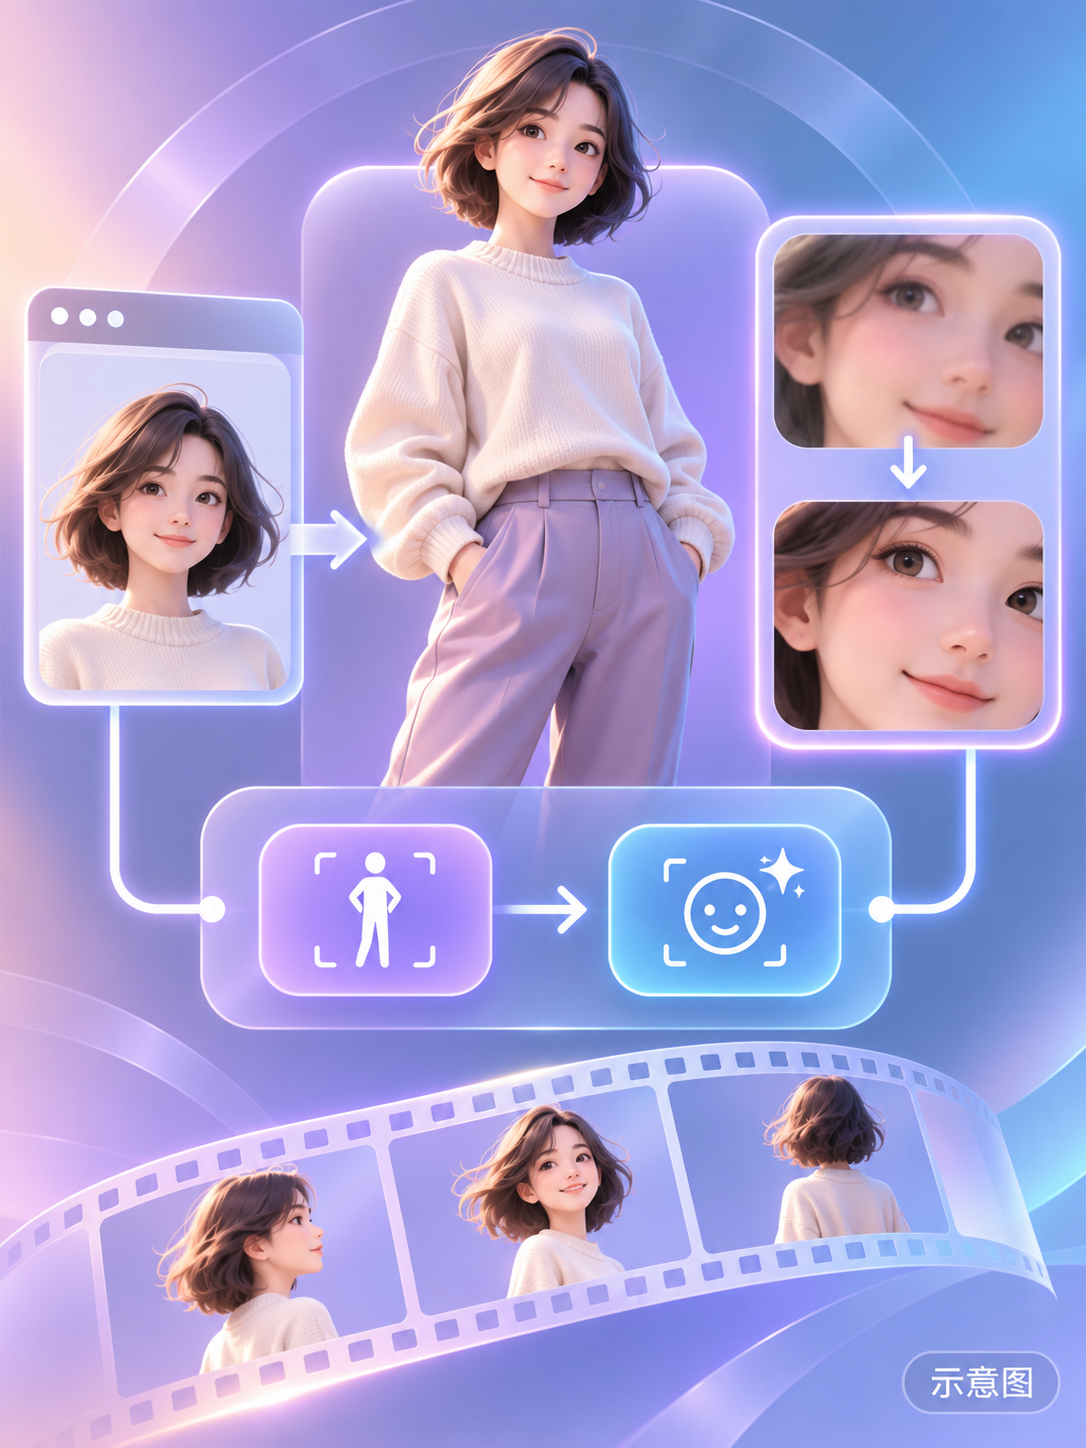
- MiniMax H3 Self Lift Avatar + Face Refinement Workflow · v1.0 — 工作流:把 MiniMax H3 Self Lift Avatar 和脸部精修串在一起的工作流。
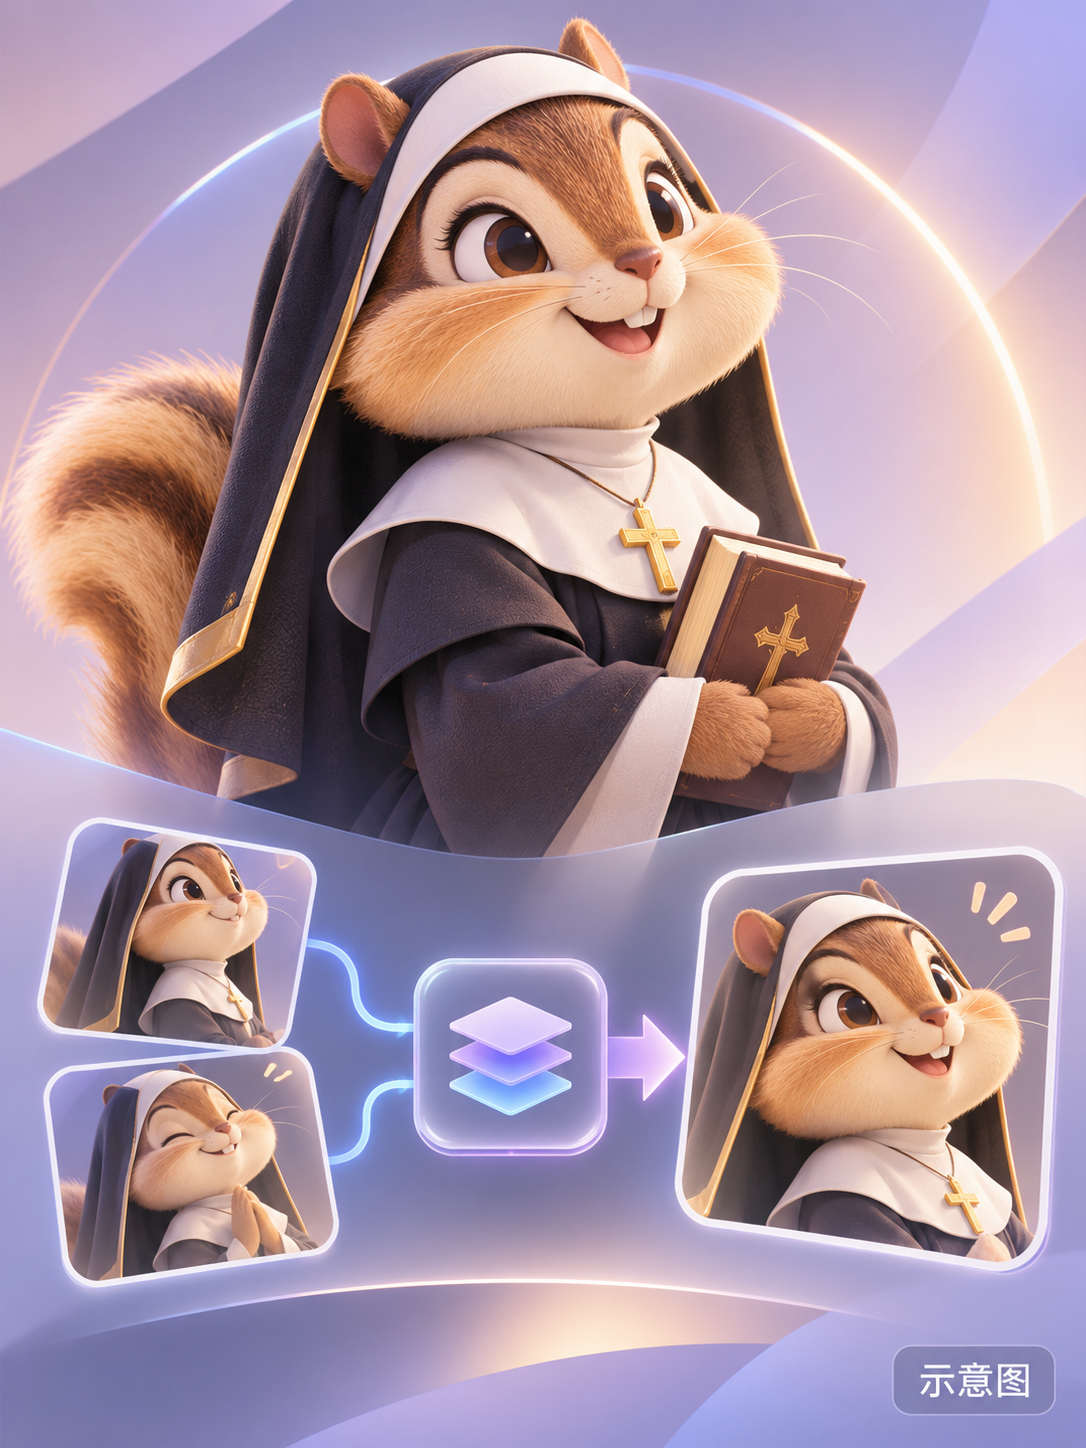
- Sister Hazel · v1.0 H3 — LoRA:原创花栗鼠修女角色 Sister Hazel 的人物 LoRA,从 Krea 2 等版本移植到 H3。
- Doctor Penny · v2.0 H3 — LoRA:原创瘟疫医生装扮角色 Doctor Penny 的人物 LoRA,从 Krea 2 等版本移植到 H3。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-13 20:31 → 11-14 09:18(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。